PH热榜 | 2026-08-01
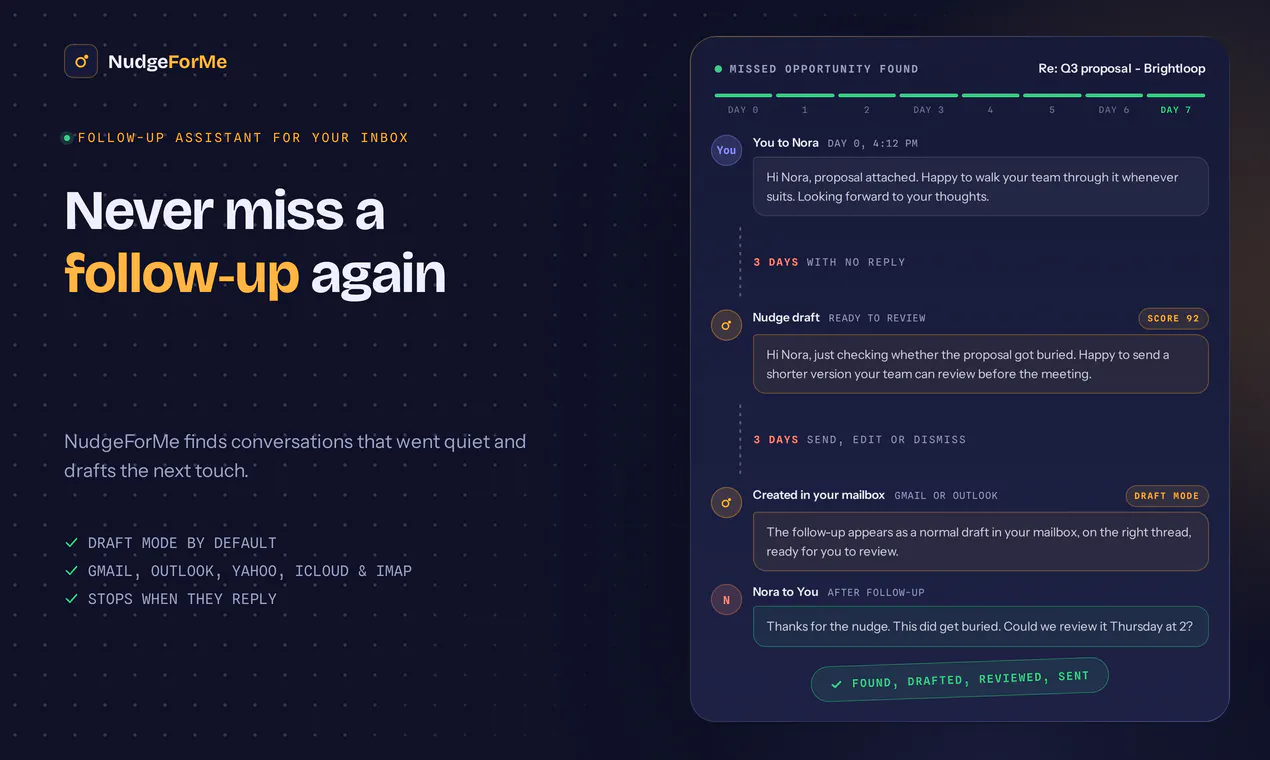
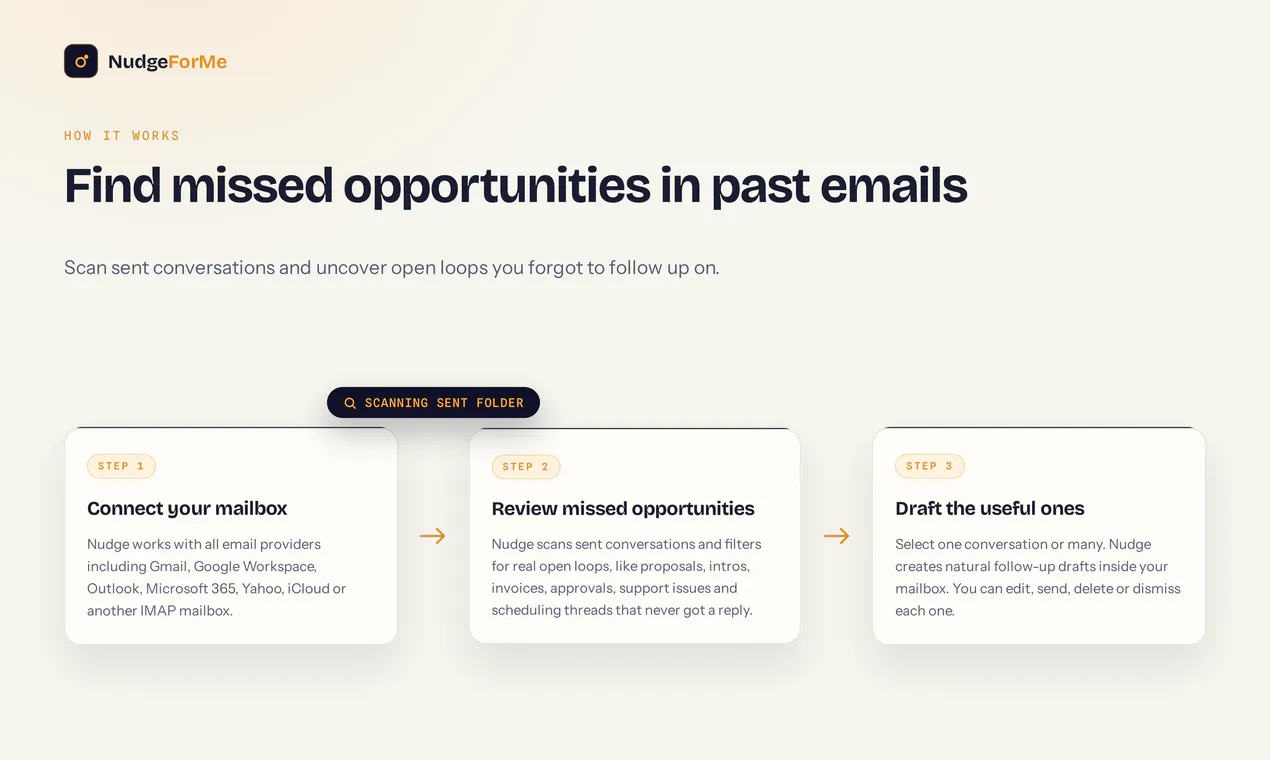
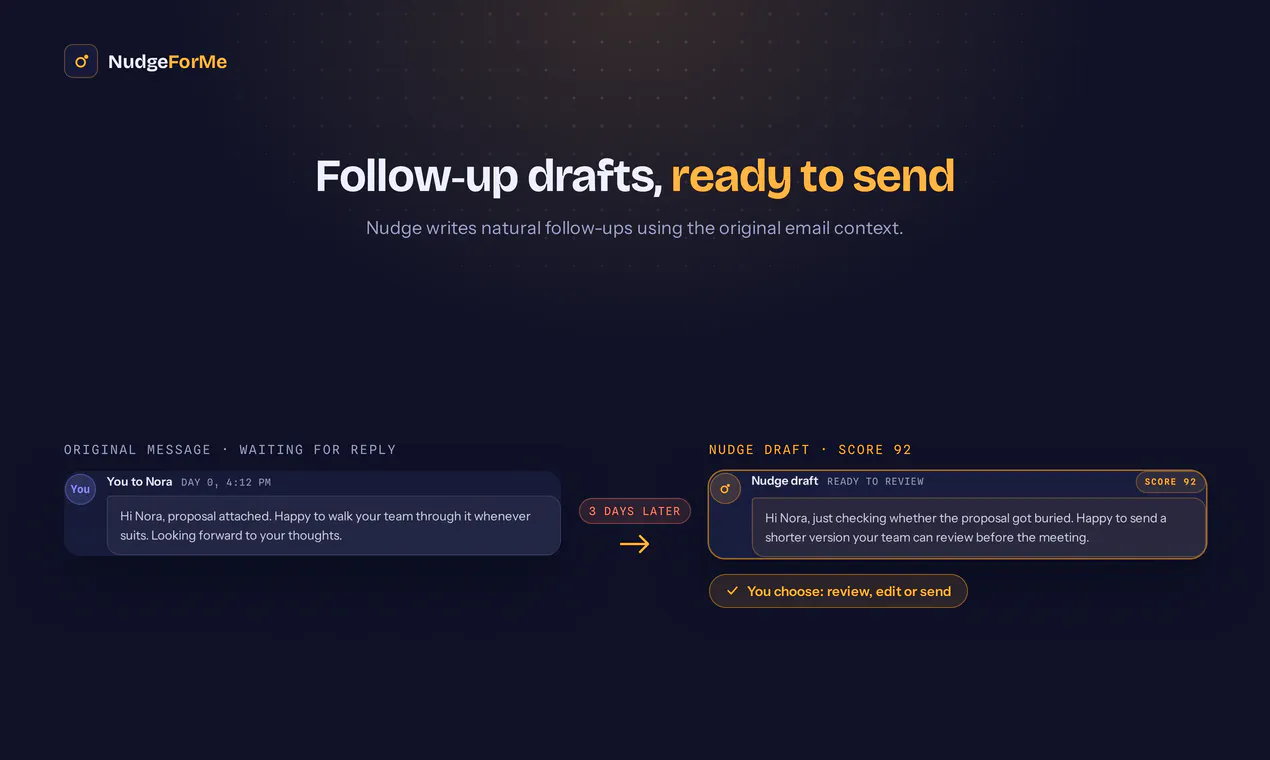
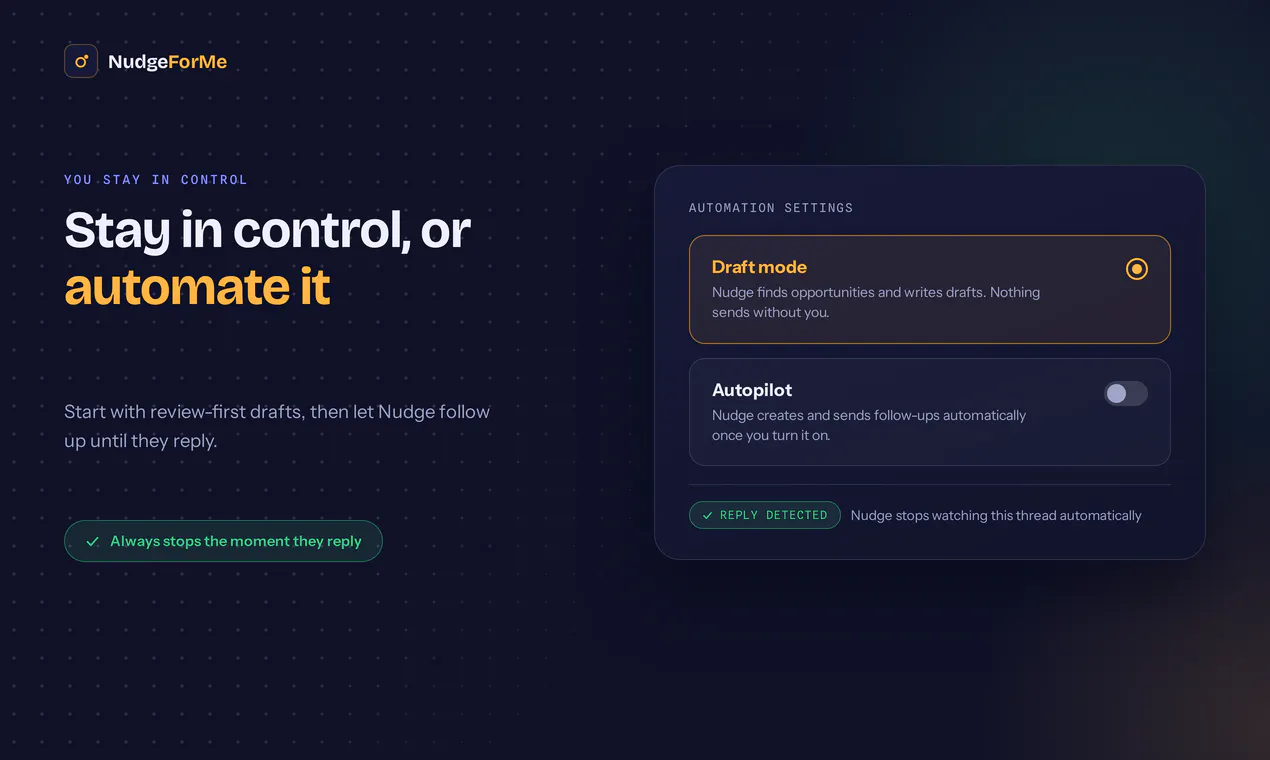
一句话介绍:NudgeForMe是一款AI跟进助手,自动扫描你的已发送邮件,找出未获回复的潜在商机,并在邮箱内生成自然语气、可控可发的跟进草稿,帮你避免潜在客户和合作伙伴悄悄流失。
Email
Productivity
Artificial Intelligence
AI邮件跟进
邮件提醒
销售效率工具
邮箱集成(Gmail/Outlook)
CRM替代方案
商机管理
智能草稿
邮件自动化
SaaS工具
生产力提升
用户评论摘要:用户普遍认可“草稿模式”和解决真实痛点。核心问题集中在:如何判断对话是否需要跟进(避免误判“谢谢,再聊”);AI是否理解上下文而非只靠时间触发;数据隐私与内容是否被保留或用于训练;能否自定义跟进模板。有用户强调精准度优先,宁可每周2条有效提醒,也不愿面对15条“可能有用”的草稿。
AI 锐评
NudgeForMe切中的痛点真实且高频——邮件跟进是销售和客户成功中最容易被忽视、却直接决定收入转化效率的环节。产品逻辑上,它避开了“重造收件箱”的陷阱,选择寄生在已有邮箱内,以草稿模式降低用户信任成本,这一策略在SaaS冷启动阶段是明智的。
但评论区的拷问恰恰暴露了它的行业共性软肋:所谓的“智能识别”是否真的能区分“期待回复”与“自然结束”的对话?如果引擎只是基于“发件人提出直接问题+沉默N天”这类规则,那它并没有比一个智能过滤器强多少,甚至可能因误判而快速消耗用户信任——而信任恰恰是此类工具的生命线。
更关键的问题是“AI是否读懂上下文”。从评论区可以看出,用户真正期待的是“AI知道我和对方聊了什么、业务是什么、对方潜在需求是什么”,从而生成有具体价值钩子的跟进文案,而非“Hi, just following up”的套话模板。这需要产品在邮件内容理解与业务知识注入上做更重的投入,远超出扫描“已发送”的逻辑范畴。
此外,数据隐私问题虽被官方回应了一轮,但“读取整个已发送文件夹并交由LLM分析”的质询在评论中并未获得足够有说服力的正面回答。对企业客户,尤其是涉及合同和客户数据的岗位,这一问题无法通过“SOC2合规”抹平。
整体而言,NudgeForMe是优秀的“痛点修复型”产品,具有商业价值,但距离“智能跟进引擎”还有相当距离。若它停留在“通知+草稿”层面,很容易被邮箱原生AI或大型销售平台(如Outreach、Salesloft)快速覆盖。现阶段的价值更接近“高效提醒器”,而非“智能助理”。其能否长跑,取决于团队在上下文理解、精准过滤和内容生成质量上的真实投入,而不是发布时的运气。
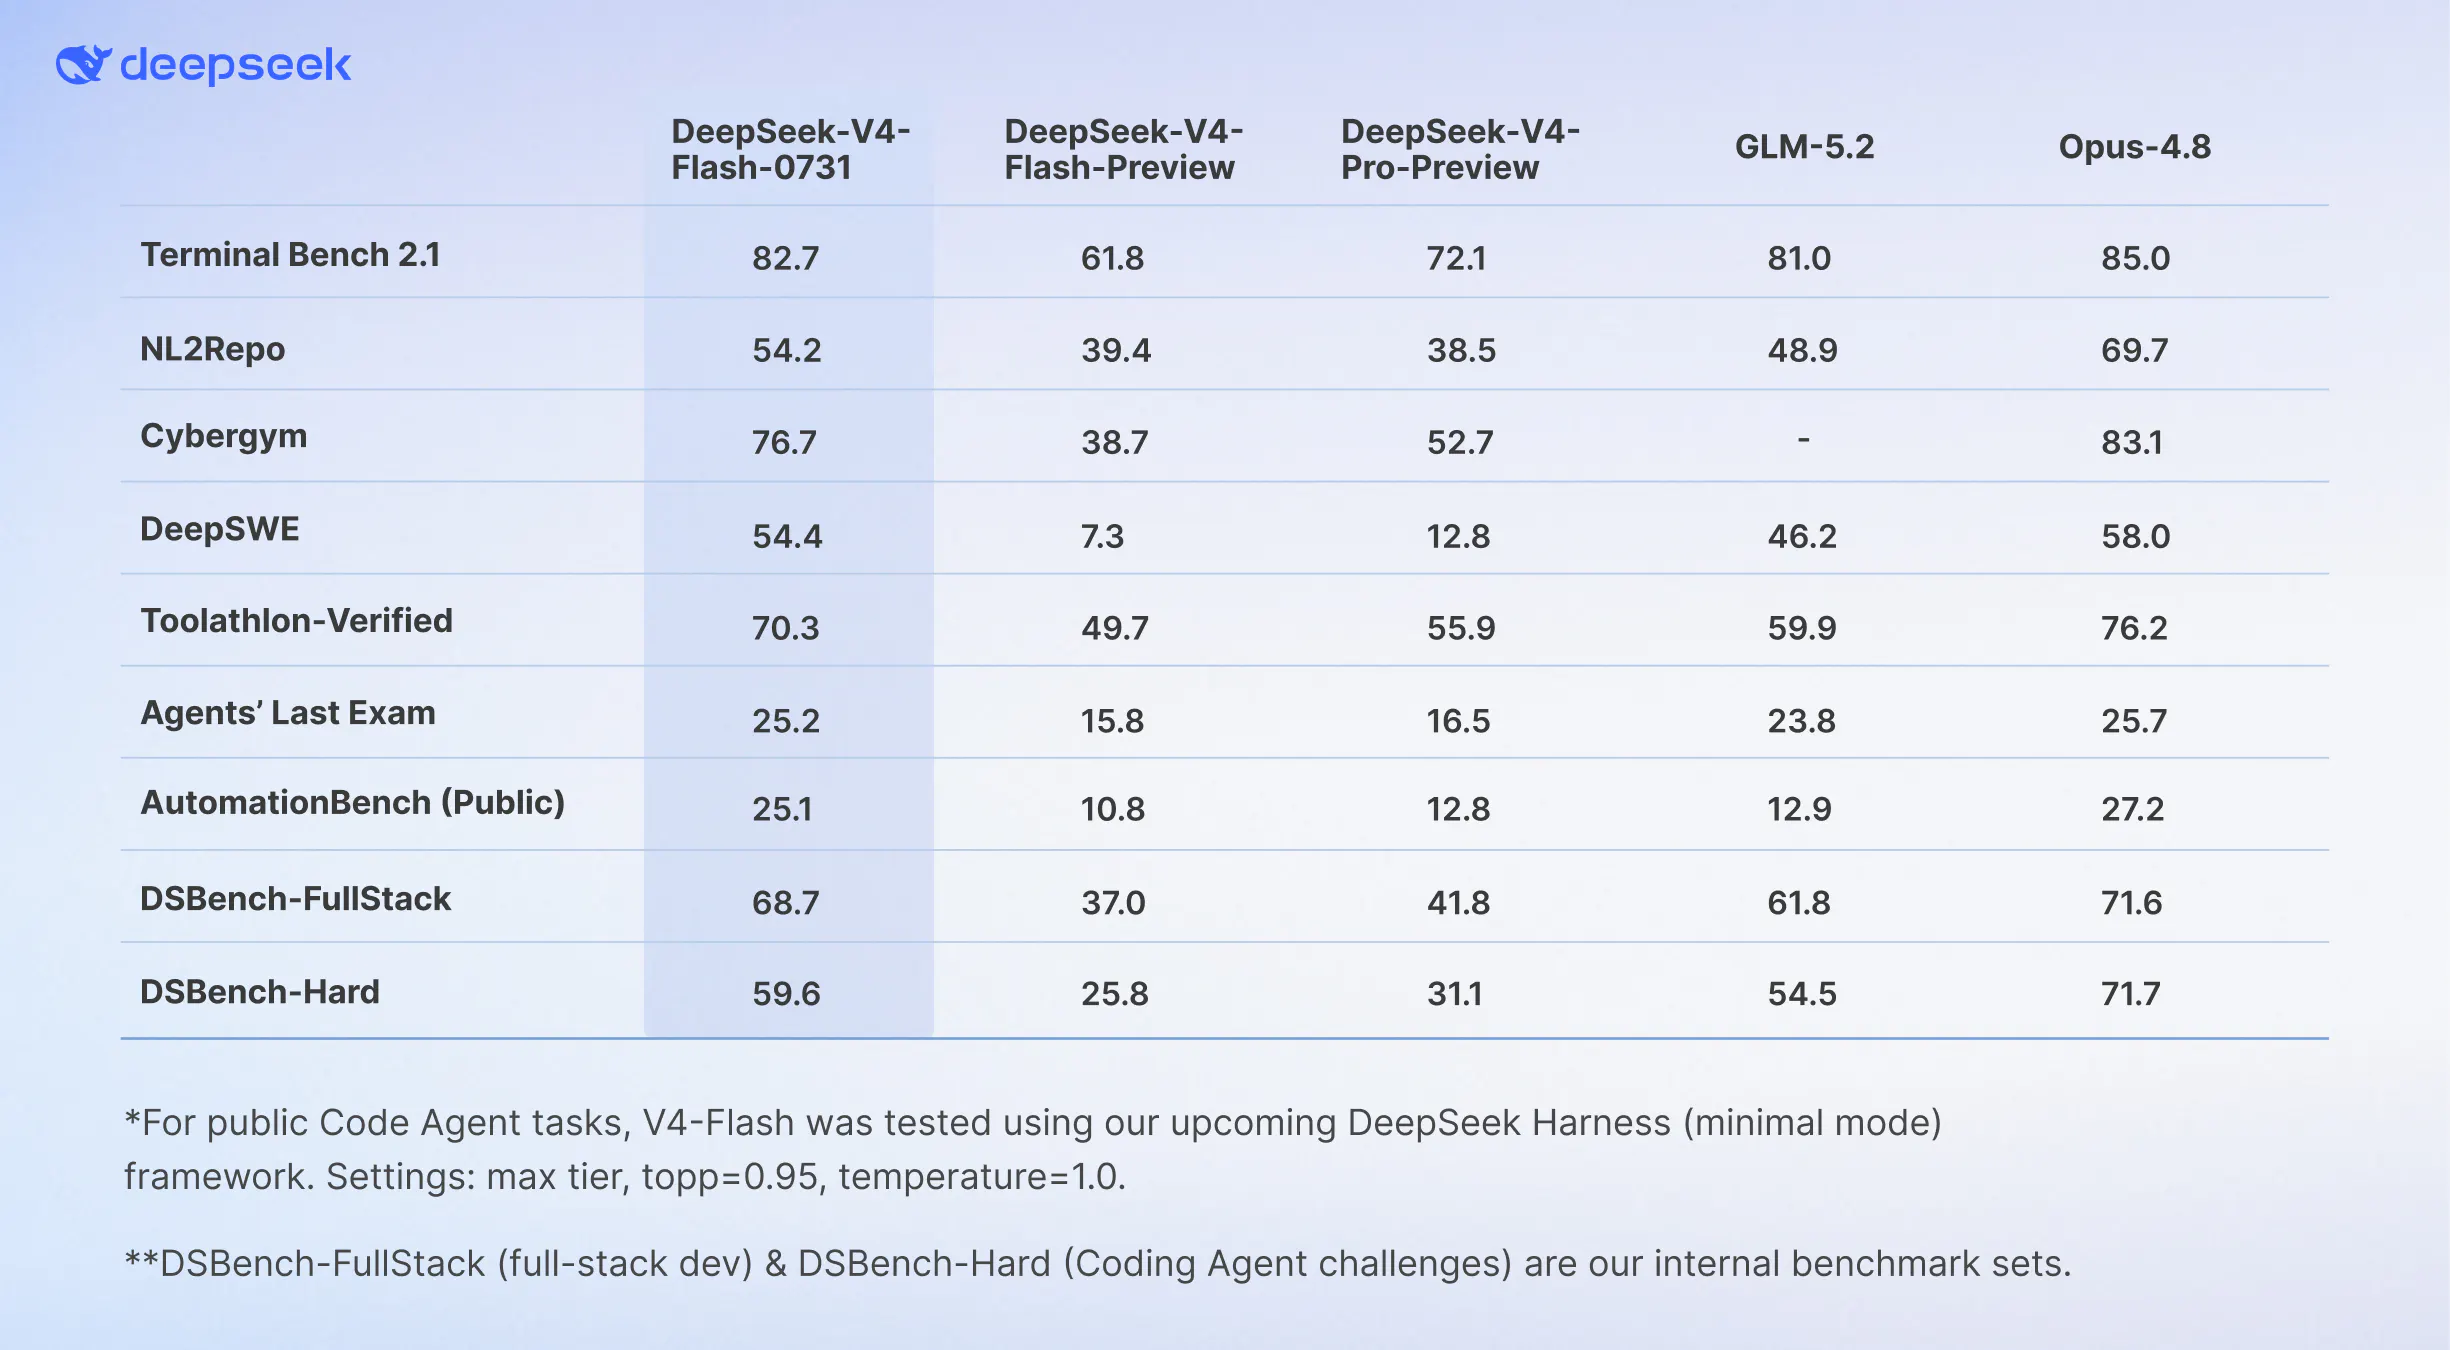
一句话介绍:DeepSeek-V4-Flash-0731 是一款以“Flash”价格提供前沿智能体能力的轻量级大模型,通过原生支持 Responses API 与 Codex CLI 适配,解决开发者“高性能模型成本过高”与“轻量模型智能不足”的双重痛点,让顶级推理在真实工程场景中实现低成本大规模落地。
API
Open Source
Artificial Intelligence
AI大模型
智能体
开发者工具
API服务
开源模型
代码生成
自动化代理
成本优化
推理加速
DeepSeek
用户评论摘要:用户普遍认可其性价比与智能体任务性能跃升,但核心质疑集中在评测可信度:有评论指出Terminal-Bench与DeepSWE分数提升幅度不对称,疑似格式遵循度提升而非真实推理能力增长,且第三方复现缺失;另有用户关注长期任务实际表现与缓存输入成本,强调应关注“单任务完成成本”而非裸token价格。
AI 锐评
DeepSeek这波发布,表面上是一次“加量不加价”的例行升级,实则是一次精心设计的行业定价权宣示。但我们必须撕开“性能暴涨”的营销外衣,直视几个关键事实。
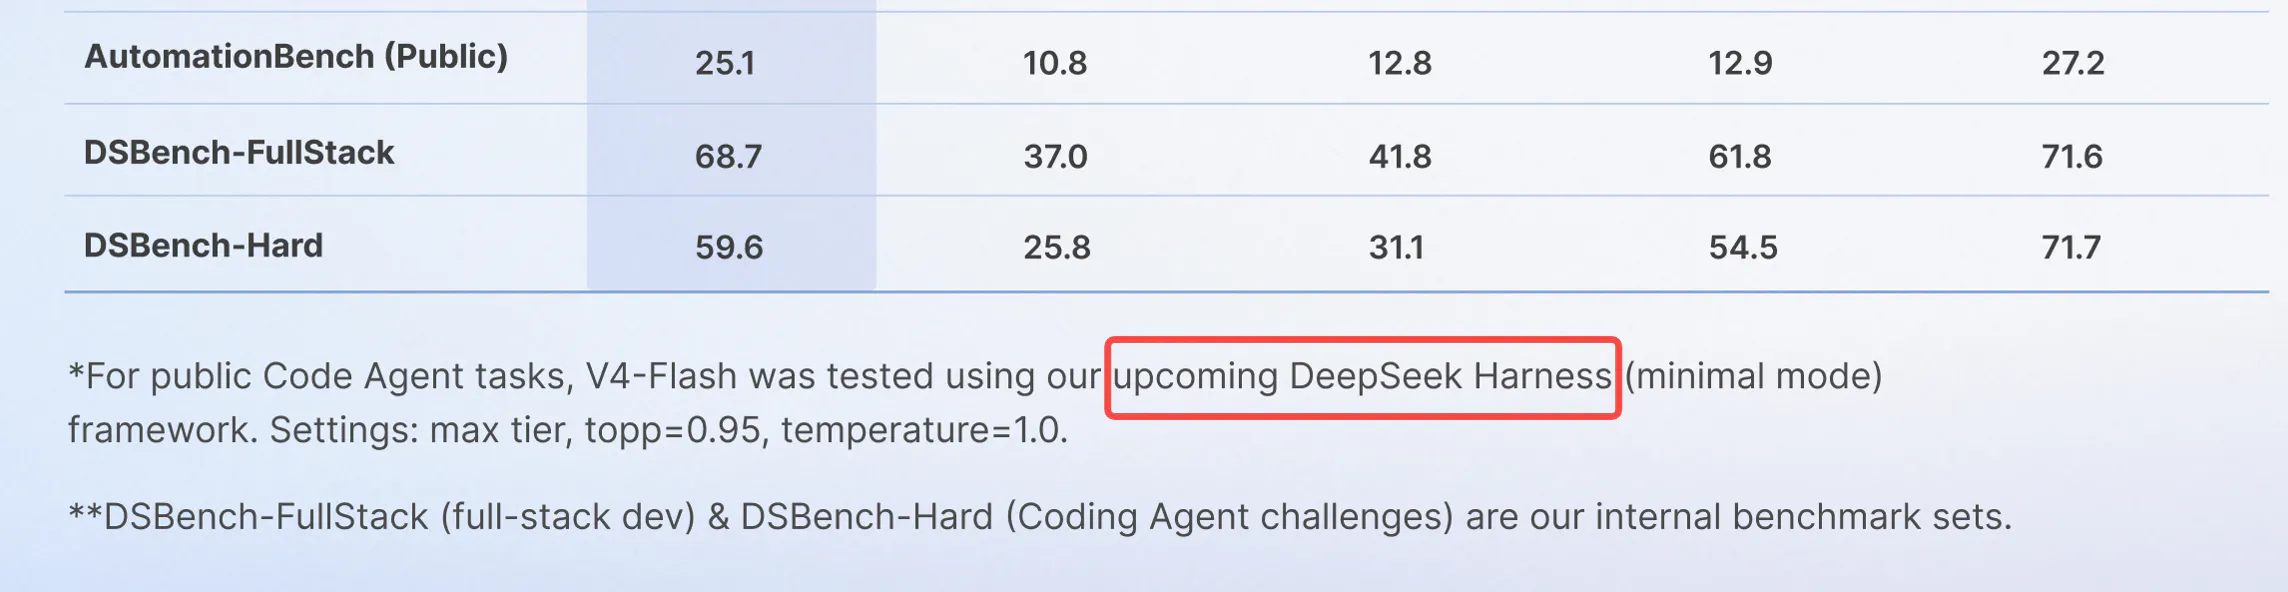
第一,评测数字的“魔幻跳变”极具迷惑性。DeepSWE从7.3飙到54.4,而Terminal-Bench只从61.8涨到82.7——同一架构、同一参数量,这种不对称增幅在技术逻辑上几乎不可能源于基础推理能力的突变。评论区一针见血:这大概率是工具调用与格式遵循度的提升,是“对齐工程”的胜利,而非智能本体的进化。这种提升对依赖特定Agent循环的开发者有效,但换一个工作流框架,增益可能大幅缩水。DeepSeek开放了MIT权重,这值得肯定,但在第三方独立harness复现之前,这份成绩单只能打五折。
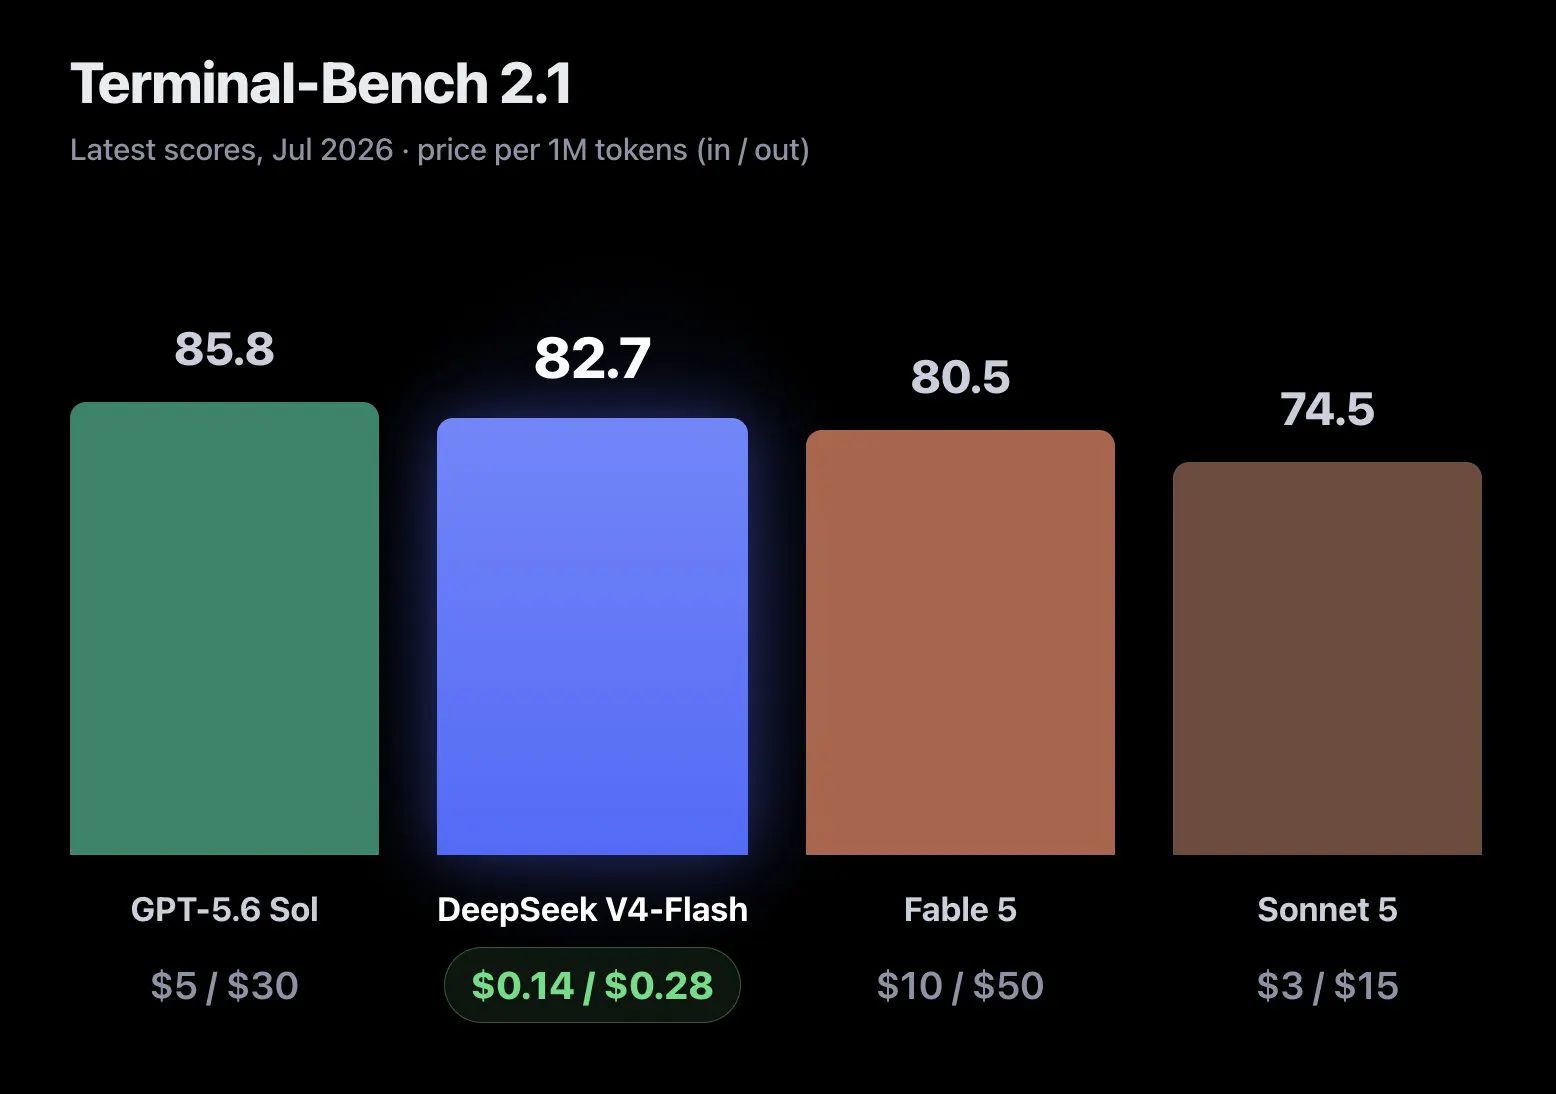
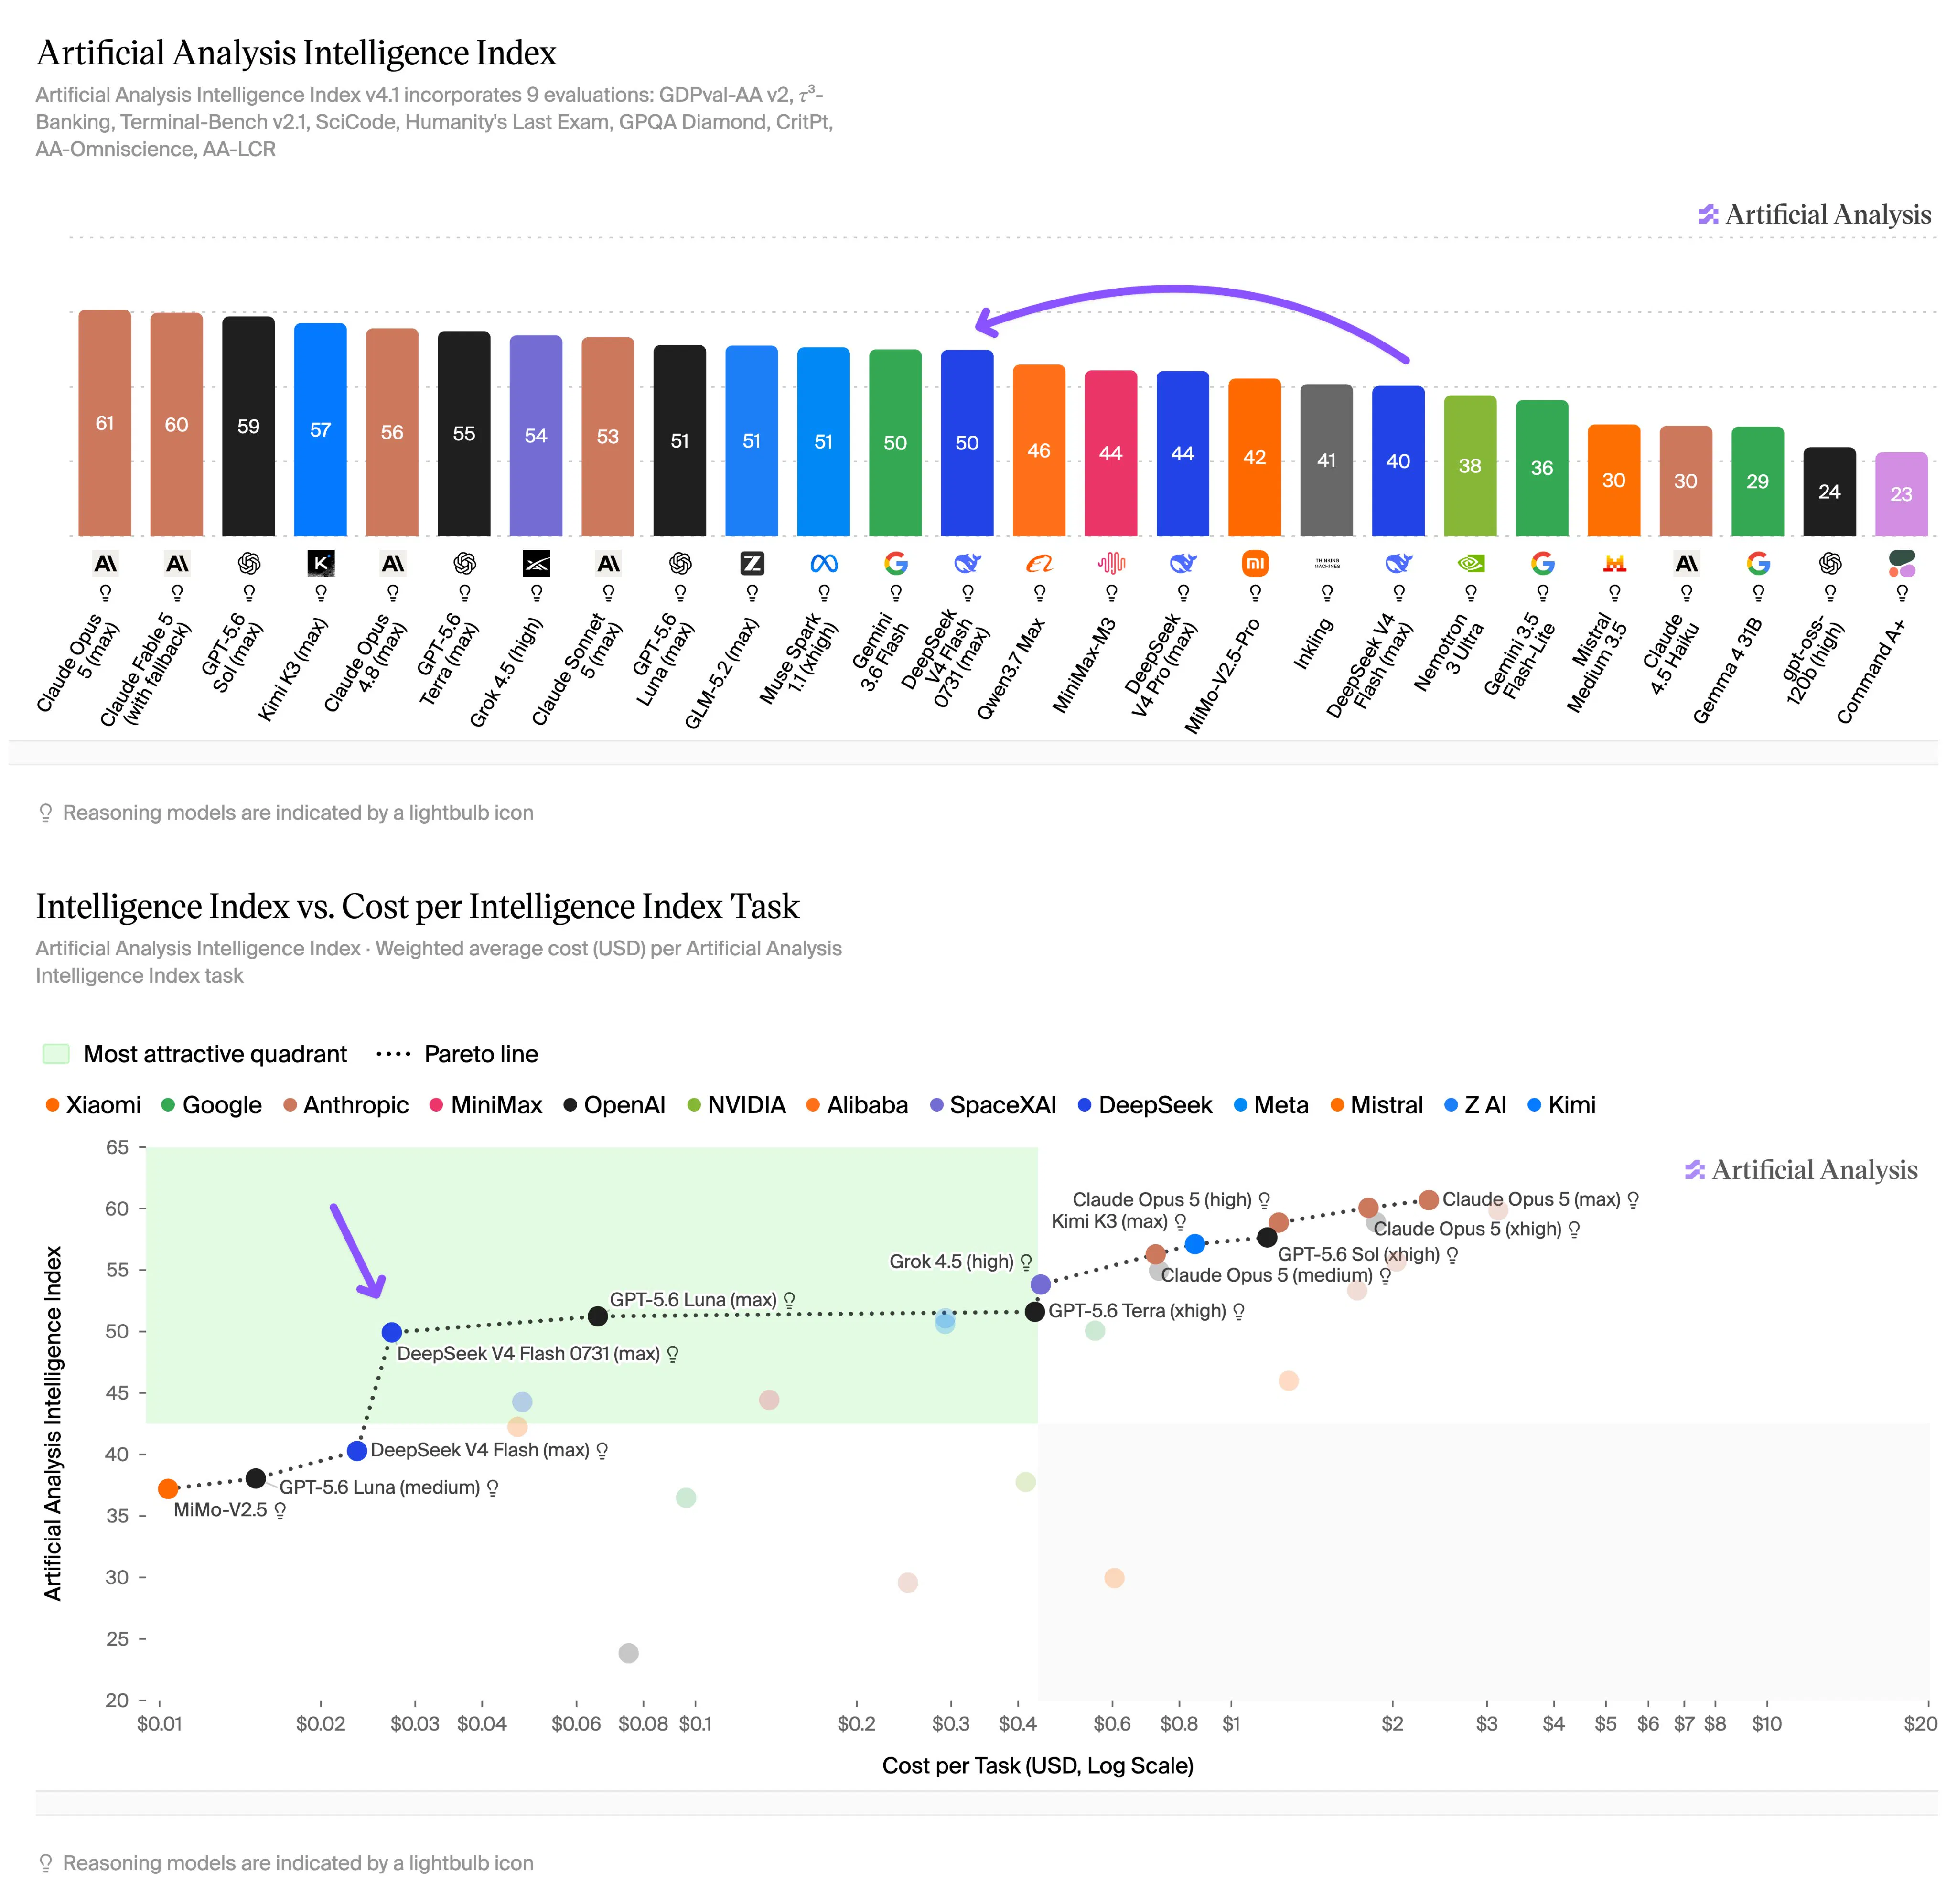
第二,真正的杀招不是性能,而是定价策略。$0.14/M输入、$0.28/M输出,配合缓存输入的低价,直接刺穿了OpenAI和Anthropic的利润护城河。然而,用户已经聪明地指出:低价token不等于低价任务。Agent场景中一次失败的重试可能消耗十倍于成功路径的token。模型在长时程任务中的鲁棒性——而非基准分数——才是决定账单的关键。目前没有任何数据证明Flash在每任务成本上优于V4-Pro或GPT-5.6系列。
第三,MIT开源+API低价的组合拳,本质是DeepSeek在复制当年安卓对抗iOS的路径:用开放生态换取开发者心智,用规模摊薄成本。但这也意味着企业客户的数据隐私与合规成本将转嫁给下游。吹捧“智能成为商品”之前,请先确认你的Agent不会在关键任务上因为“性价比模型”的隐性不稳定而返工。
结论:这是一款值得严肃评估的工程产品,但不要被“Flash价格、Pro性能”的叙事绑架。在第三方评测和三周以上生产环境压测数据出来之前,理性选择是混合调用——将重复性高、容错率高的流量切给Flash,核心决策链路保留更高价的可靠模型。真正的革命不是“智能免费”,而是“智能分层”——谁先摸清每层的能力边界,谁才是在这轮价格战中真正受益的人。
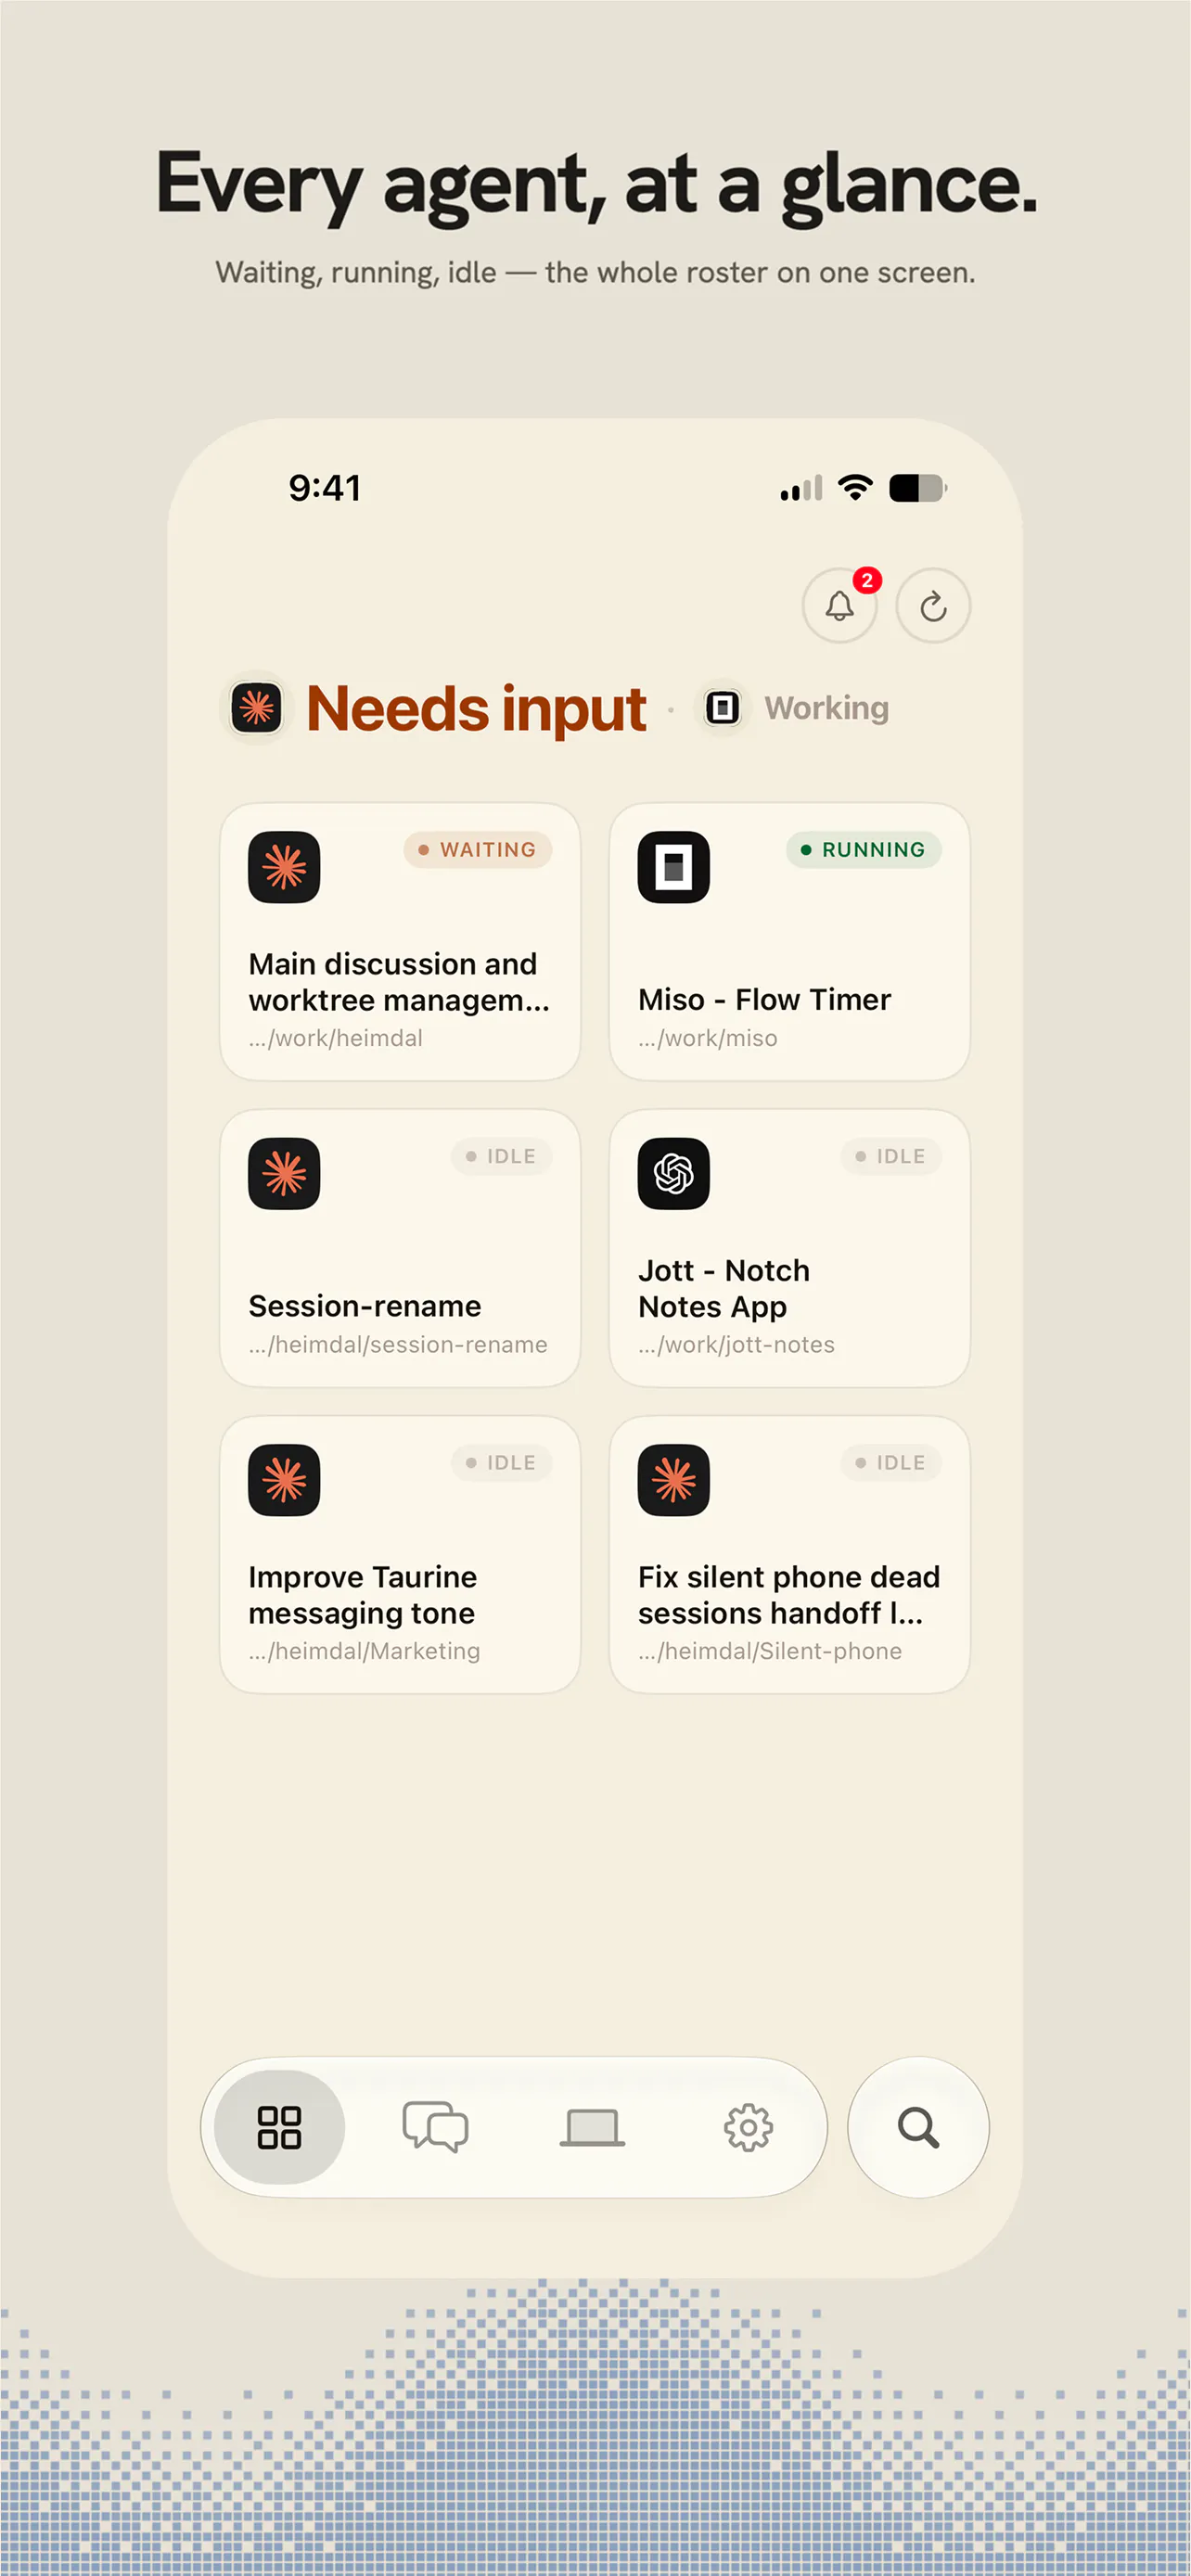
一句话介绍:Port22 是一款将 Mac 上正在运行的 Claude Code、Codex 等编码代理(Agent)实时投射到手机上的工具,解决开发者离开电脑后,代理因等待审批而长时间空转、打断心流的痛点,让你在手机上看到真实选项并一键批准。
iOS
Developer Tools
Artificial Intelligence
编码代理
移动端控制
SSH
审批流
Claude Code
Codex
远程开发
效率工具
开发者工具
Agent编排
用户评论摘要:用户普遍认可“读取真实选项而非模拟回车键”的安全性。核心质疑聚焦于审批卡片是否提供足够的代码上下文(如Diff预览)以供决策,以及能否在蜂窝网络下通过中继稳定连接。有用户建议增加按项目预设的默认审批策略,以减少低频打扰,开发者回应称已支持查看变更代码,且自动审批功能在规划中。
AI 锐评
Port22 的切入点精准且克制,它没有去造一个新的 Agent 编排器,而是选择做“最后一公里”的移动审批端。这在产品策略上非常聪明,避开了与 Codex 或 Claude Code 原生移动应用的正面竞争,反而利用了多 Agent 并行的碎片化管理痛点。
其真正的价值锚点在于“信任”。评论中反复出现的“浏览真实选项而非发送回车键”是产品灵魂,这直接击中了远程审批工具“静默失败”的致命缺陷——模拟按键可能会在六选一的提示符下误选第一个,导致整个任务走向失控。读取活动会话的渲染文本,本质上是在保留“上下文透明性”,这比单纯的远程控制高出一个维度。
然而,锐评需指出其潜在风险:首先,若审批卡片不能展示足量的 Diff 上下文,它只会将“等待打断”变成“莽撞确认”,这是从“时间浪费”滑向“结果错误”的滑坡,目前仅靠点击后查看代码是不够的。其次,通过中继服务器加密虽解决隐私,但无疑是核心链路上的延迟与故障单点。在 Agent 原生化移动操作系统的浪潮下,Port22 的护城河不在于技术壁垒,而在于对“审批心理”的深度洞察和 UI 细节的极致打磨。倘若它能进化成一种“条件化审批规则引擎”,其长期黏性将远超当前版本。建议团队聚焦于提升审批卡片的决策信息密度,这才是留住重度用户的关键。
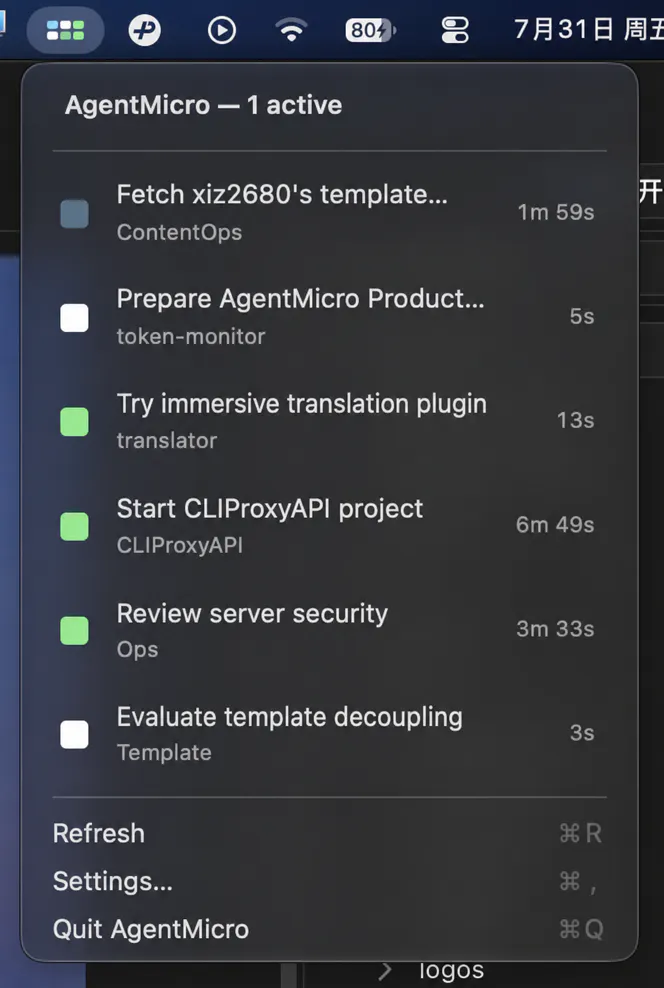
一句话介绍:AgentMicro 是一款本地优先的 macOS 菜单栏工具,让开发者在一眼之间掌握多个并行 Codex 任务的实时状态(思考中、已完成、需介入、报错),并一键跳转回对应任务窗口,解决多任务切换时“丢失上下文”和“注意力分散”的痛点。
Open Source
Developer Tools
Menu Bar Apps
macOS菜单栏
Codex任务管理
本地优先
AI编程助手
开发者工具
开源
隐私保护
任务状态监控
并行任务管理
效率工具
用户评论摘要:用户普遍认可本地优先和隐私保护设计,并赞赏“橙=行动”这一低噪音状态。核心争议点在于:一是“需输入”状态在无辅助功能权限时易与长时间工具调用混淆,需明确超时阈值;二是缺少“状态未知”的区分,空闲与数据过期视觉混淆;三是建议用“状态持续时间”来替代单纯计时器,以识别卡死而非长任务。
AI 锐评
AgentMicro 精准切中了 AI 编程时代一个真实且日益尖锐的痛点:并行智能体的“注意力管理”。它没有试图成为另一个控制面板或自动化中心,而是选择做一个“观察哨”,用五个颜色状态和一键跳转来压缩信息噪声,这个克制且务实的定位是其最聪明的设计决定。158 票的认可度证明,开发者确实需要这种轻量级“任务哨兵”。
但从评论区的高质量反馈来看,它的核心假设——“状态可被清晰定义”——正在遭遇现实的挑战。最尖锐的问题在于状态语义的模糊性:在无辅助功能权限的基础模式下,“橙色(需输入)”只能是靠超时阈值推断出来的概率事件。一个 90 秒的长网页抓取与一个等待确认的提示符在元数据层面无法区分,这直接动摇了“五个状态”体系的可靠性。用户真正需要的不是更多的状态颜色,而是“状态持续时间”这一轴,即“思考中”状态下已经持续了多久。如果 AgentMicro 能引入基于 p90(90百分位)的自学习超时阈值,让“橙色”可以自我升级,而不仅仅是一个静态计时器,它就能从“会叫的看门狗”进化为“懂业务的守夜人”。
此外,评论中关于“未知/丢失”状态的缺失值得警惕。当菜单栏安静时,用户无法区分“一切正常”与“Codex 已崩溃或失联”。这种“安静的毒性”是监控工具的通病,处理不当会让整个监控体系在关键时刻失去信用。AgentMicro 的长期价值不在于它目前能显示什么,而在于它如何随 Codex 生态的元数据进化而进化。它现在是一个讨巧的菜单栏配件,但只有跨过“状态确定性与时间衰减”这道坎,才能成为 AI 开发工作流中不可或缺的底层基础设施。目前,它值得尝试,但请务必在 README 中清晰标注每个状态阈值的时间参数,否则当用户质疑“橙色为何错误亮起”时,将是其口碑崩坏的开始。
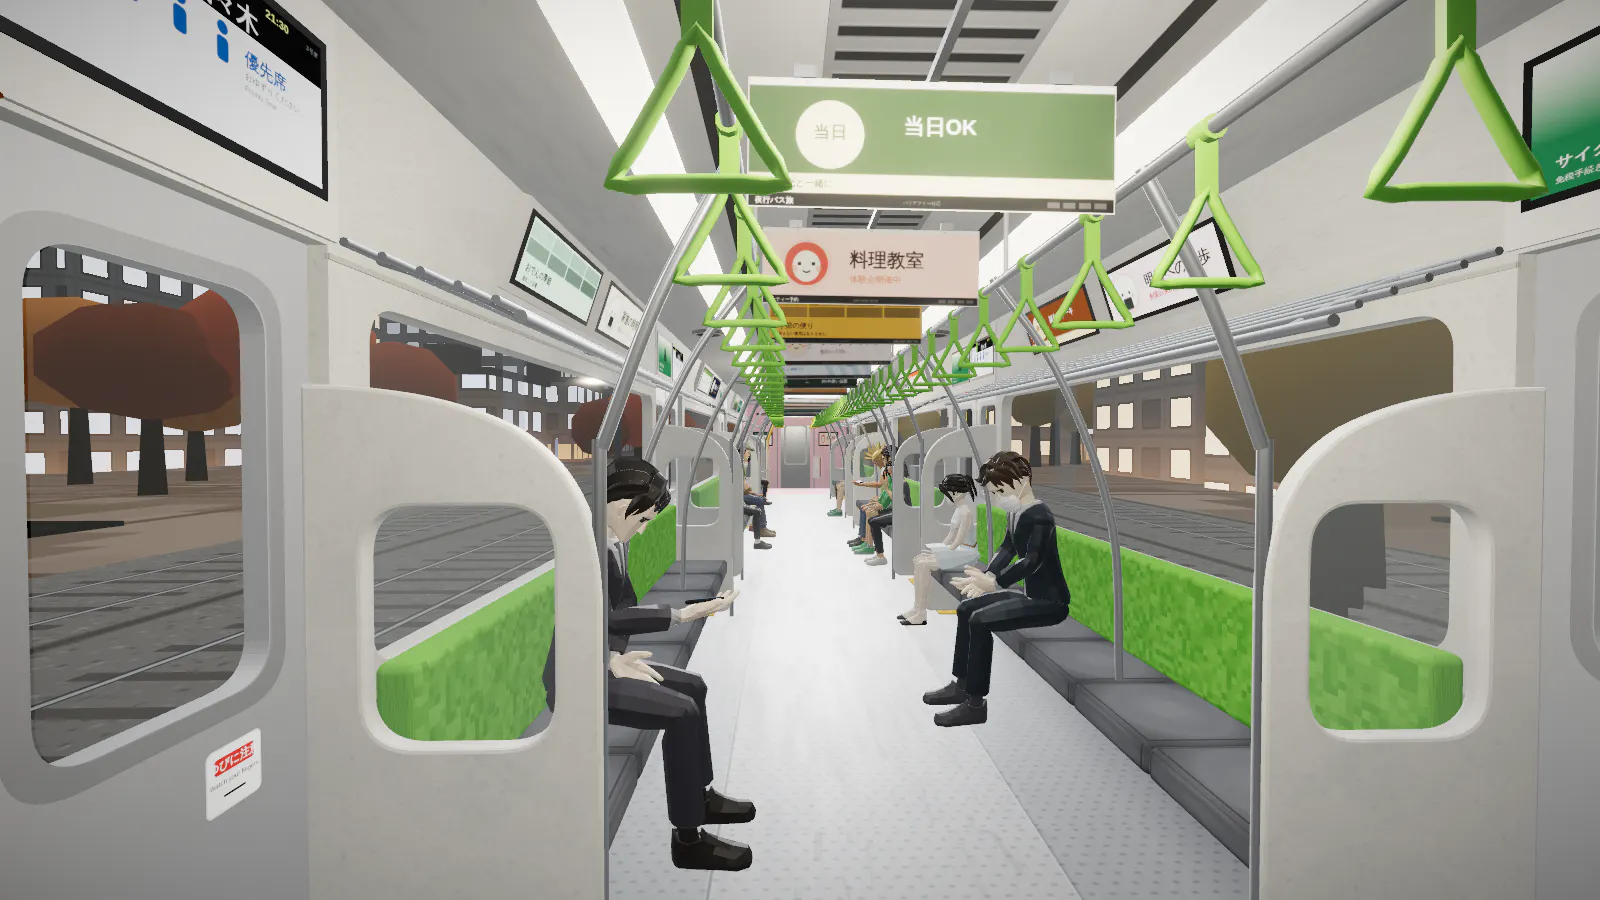
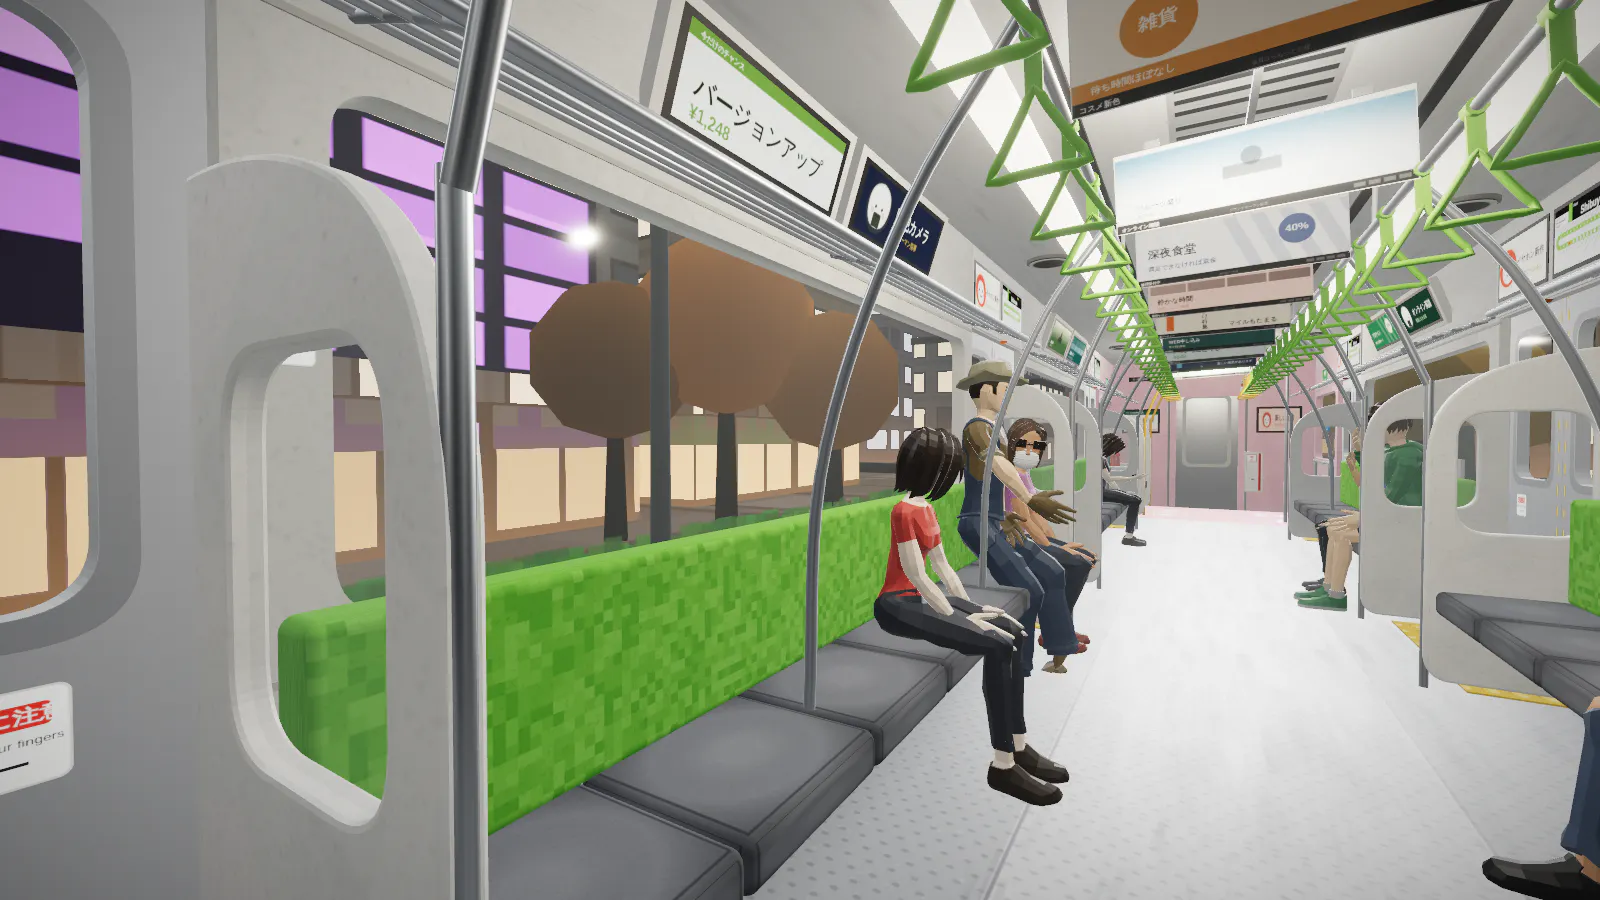
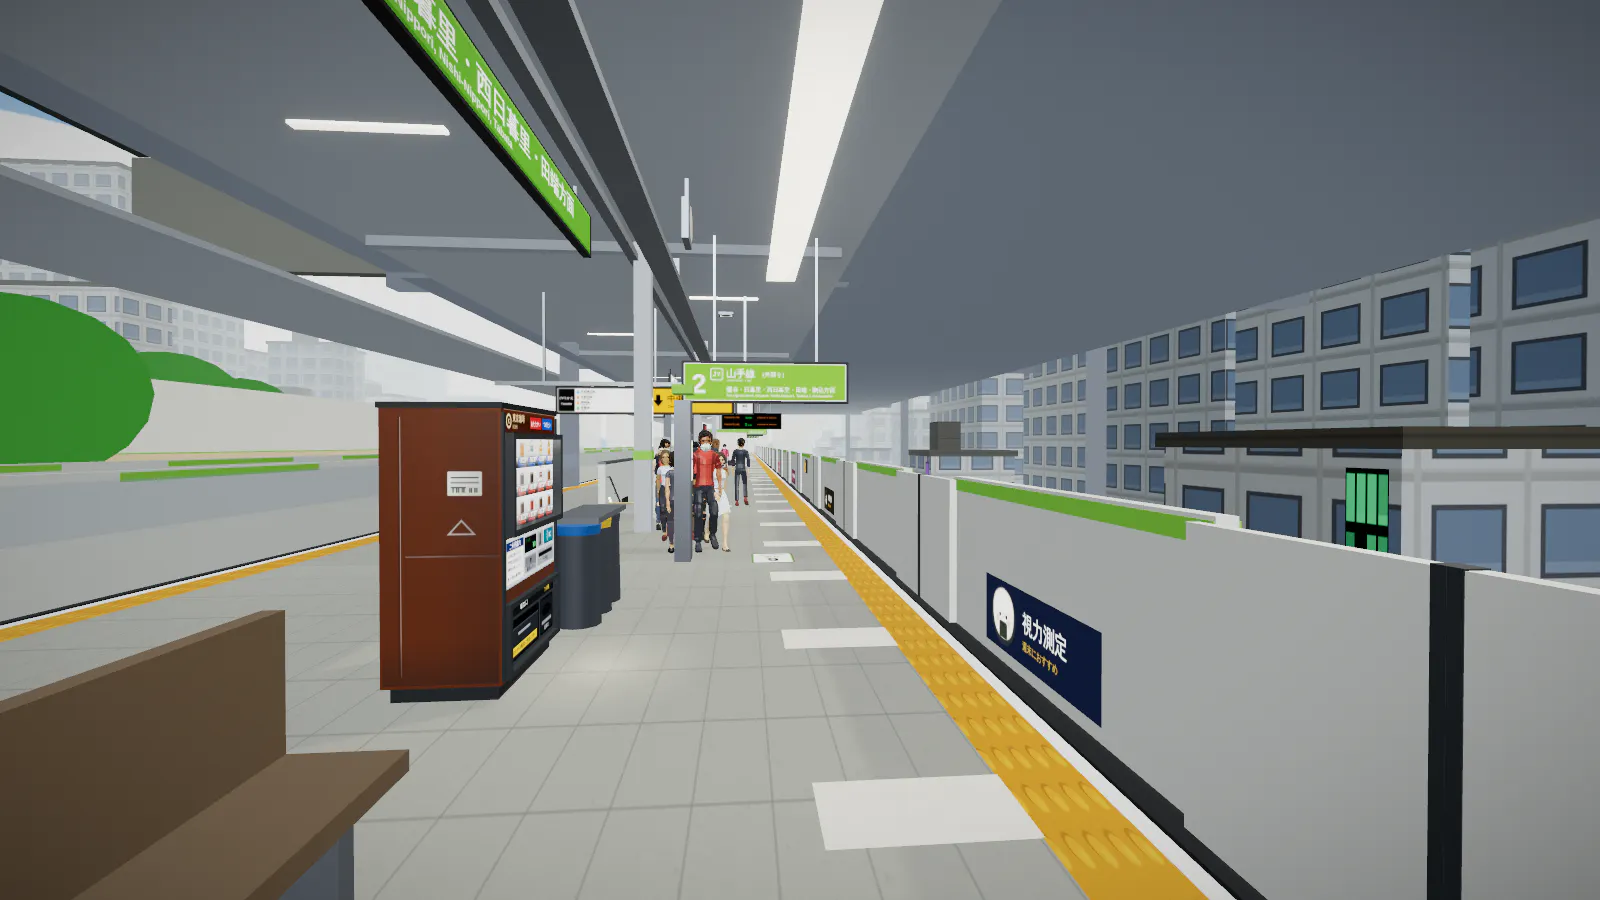
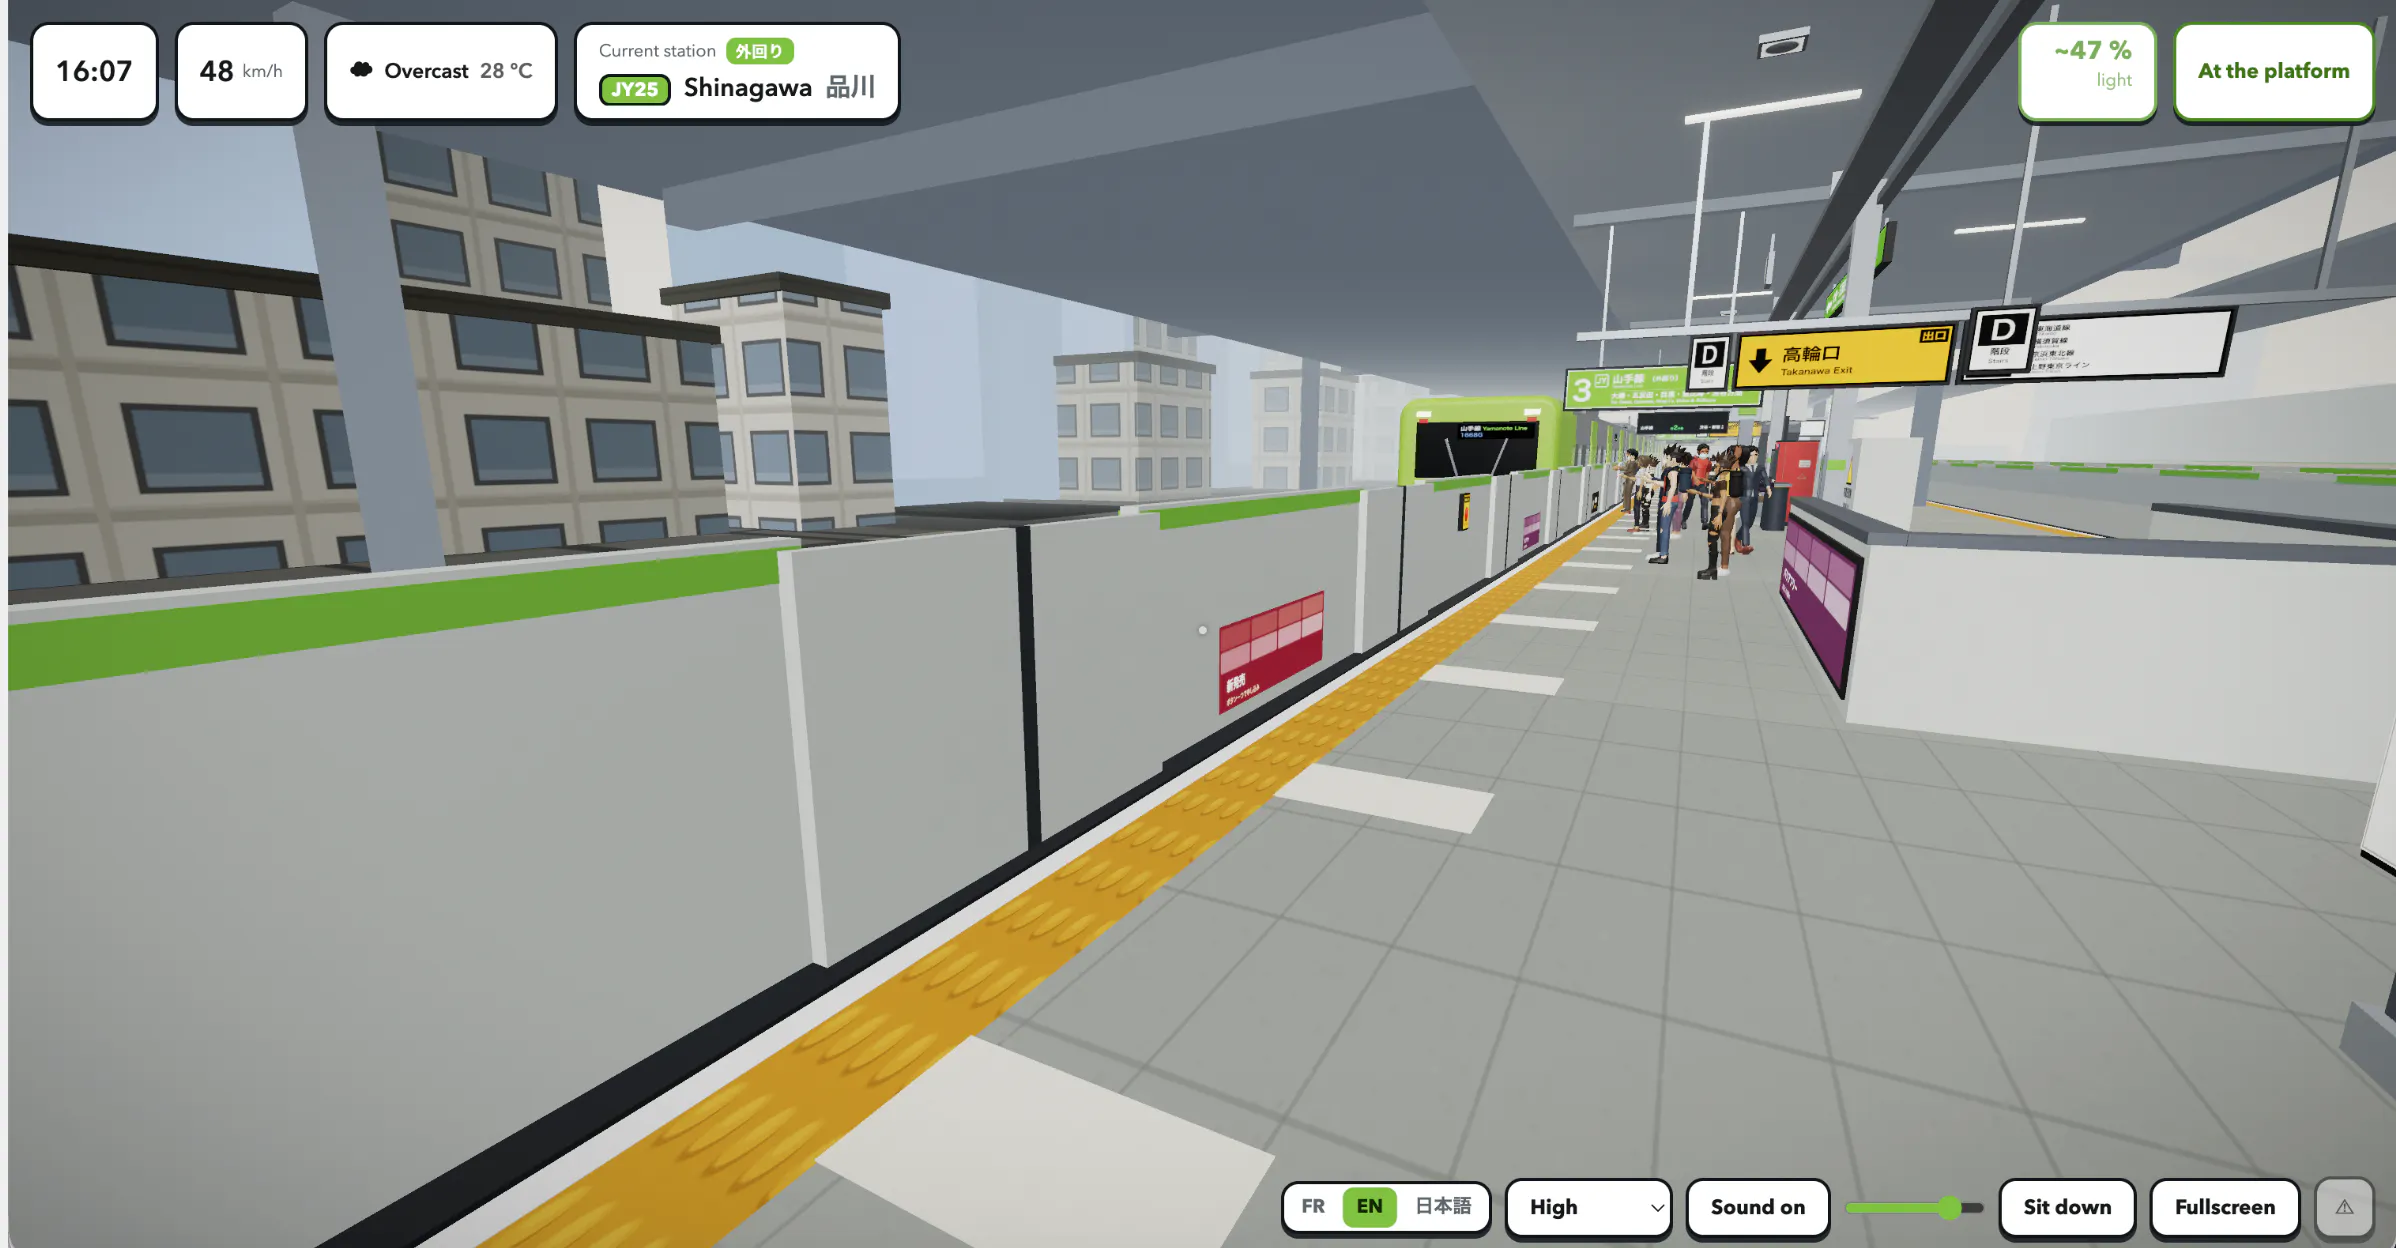
一句话介绍:Yamanote 3D 是一款免费浏览器端的 3D 东京山手线沉浸式漫游体验,让你在办公或学习时,以可探索的列车环境替代背景视频或白噪音。
Web App
Simulation Games
GitHub
Animation
3D 沉浸式体验
浏览器应用
东京山手线
环境白噪音
放松专注
虚拟漫游
轨道交通模拟
氛围音景
免费工具
独立开发
用户评论摘要:用户普遍认可其氛围感与真实感,称赞无缝循环设计巧妙;主要疑问集中在后台标签页是否暂停渲染、可否同步真实东京时间,以及是否永久循环(回应称彻底停止渲染,时间/天气同步真实,线路本身为闭环,永不终止)。部分用户提出性能与风扇噪音顾虑。
AI 锐评
Yamanote 3D 的巧妙之处在于利用了山手线物理上的闭环属性,彻底消解了传统白噪音循环的“听感裂缝”——这不是技术上的炫技,而是对背景音产品本质的洞察:用户要的不是声音,而是“不间断的、可信的环境”。它用 3D 可探索性替代了视频的被动性,用实时东京时间、天气与拥挤度赋予场景呼吸感,这比单纯的音效生成器高出一个维度。
但它的天花板也很明显:首先是场景深度不足。目前“可探索”仅限车厢内走动与下车看站台,缺乏东京城市肌理的实质交互,一旦新鲜感消退,它很容易沦为“高级屏保”。其次,性能优化是硬伤——开发者在评论中承认,只要浏览器窗口可见(即使不在前台),场景便全速运行,这直接违背了“学习/办公背景”的核心使用场景,电池与风扇噪音会瞬间打破用户期望的“宁静”。这暴露了产品设计中的一个典型矛盾:为了保留“可随时看两眼”的临场感,牺牲了真正的后台低功耗运行。
评论中反复出现的“会否停止”“如何循环”问题,实则反映出用户对“陪伴感”的深层需求——他们要的不是一个“玩具”,而是一个“永远在运行的世界”。目前 Yamanote 3D 只是这条路上的原型:它的交互是单薄的,缺乏天气突变、列车延误、乘客对话等动态叙事;它的盈利模式(买咖啡)也暗示了独立开发者的资源局限,这决定了其后续迭代大概率是修修补补而非质变。
真正值得兴奋的方向,是如果它能引入 WebGPU 优化,实现真正的后台低功耗渲染,并接驳实时城市数据(如车站人流、事件通知、甚至让用户上传自己的歌单作为车内背景音乐),那么它就不只是一个白噪音工具,而是一个“个人东京通勤舱”——但那需要从“场景复刻”转向“生活服务”的思维跨越。目前它赢在巧思,也困在巧思。
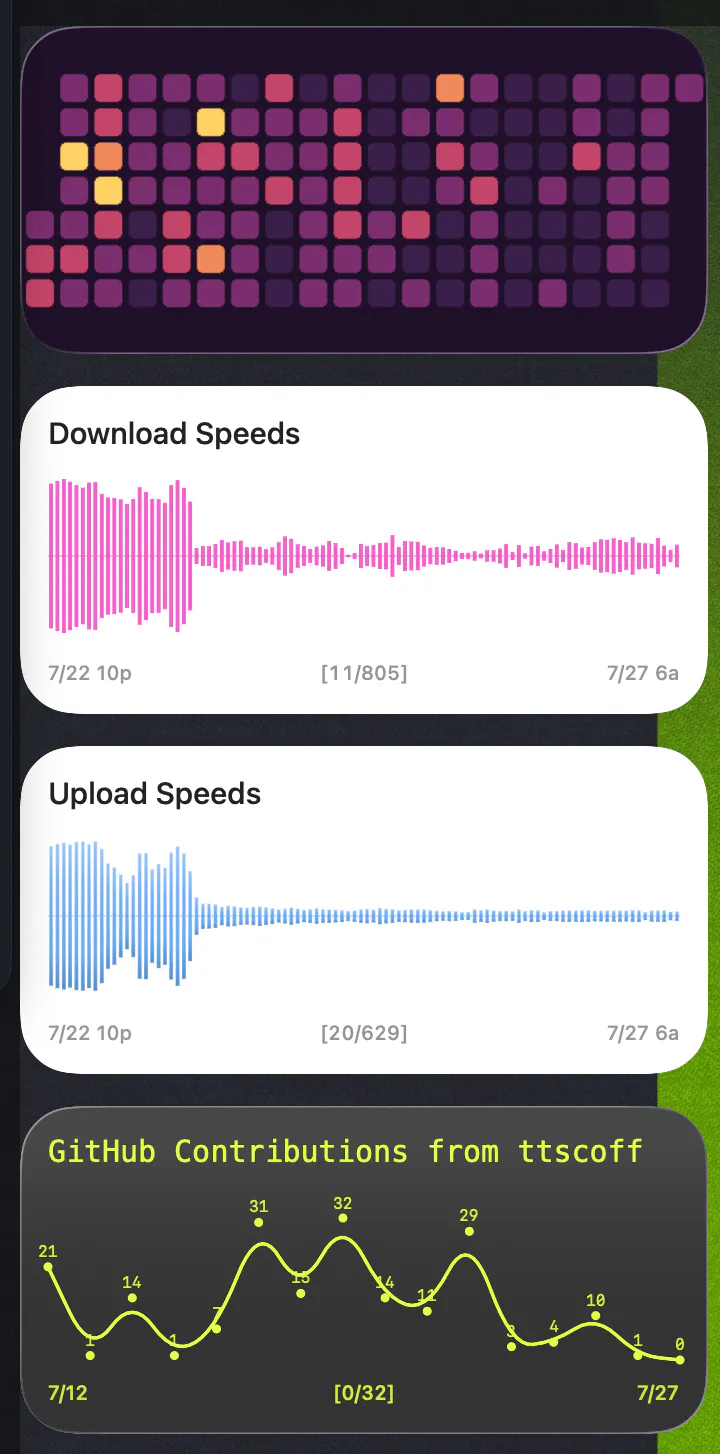
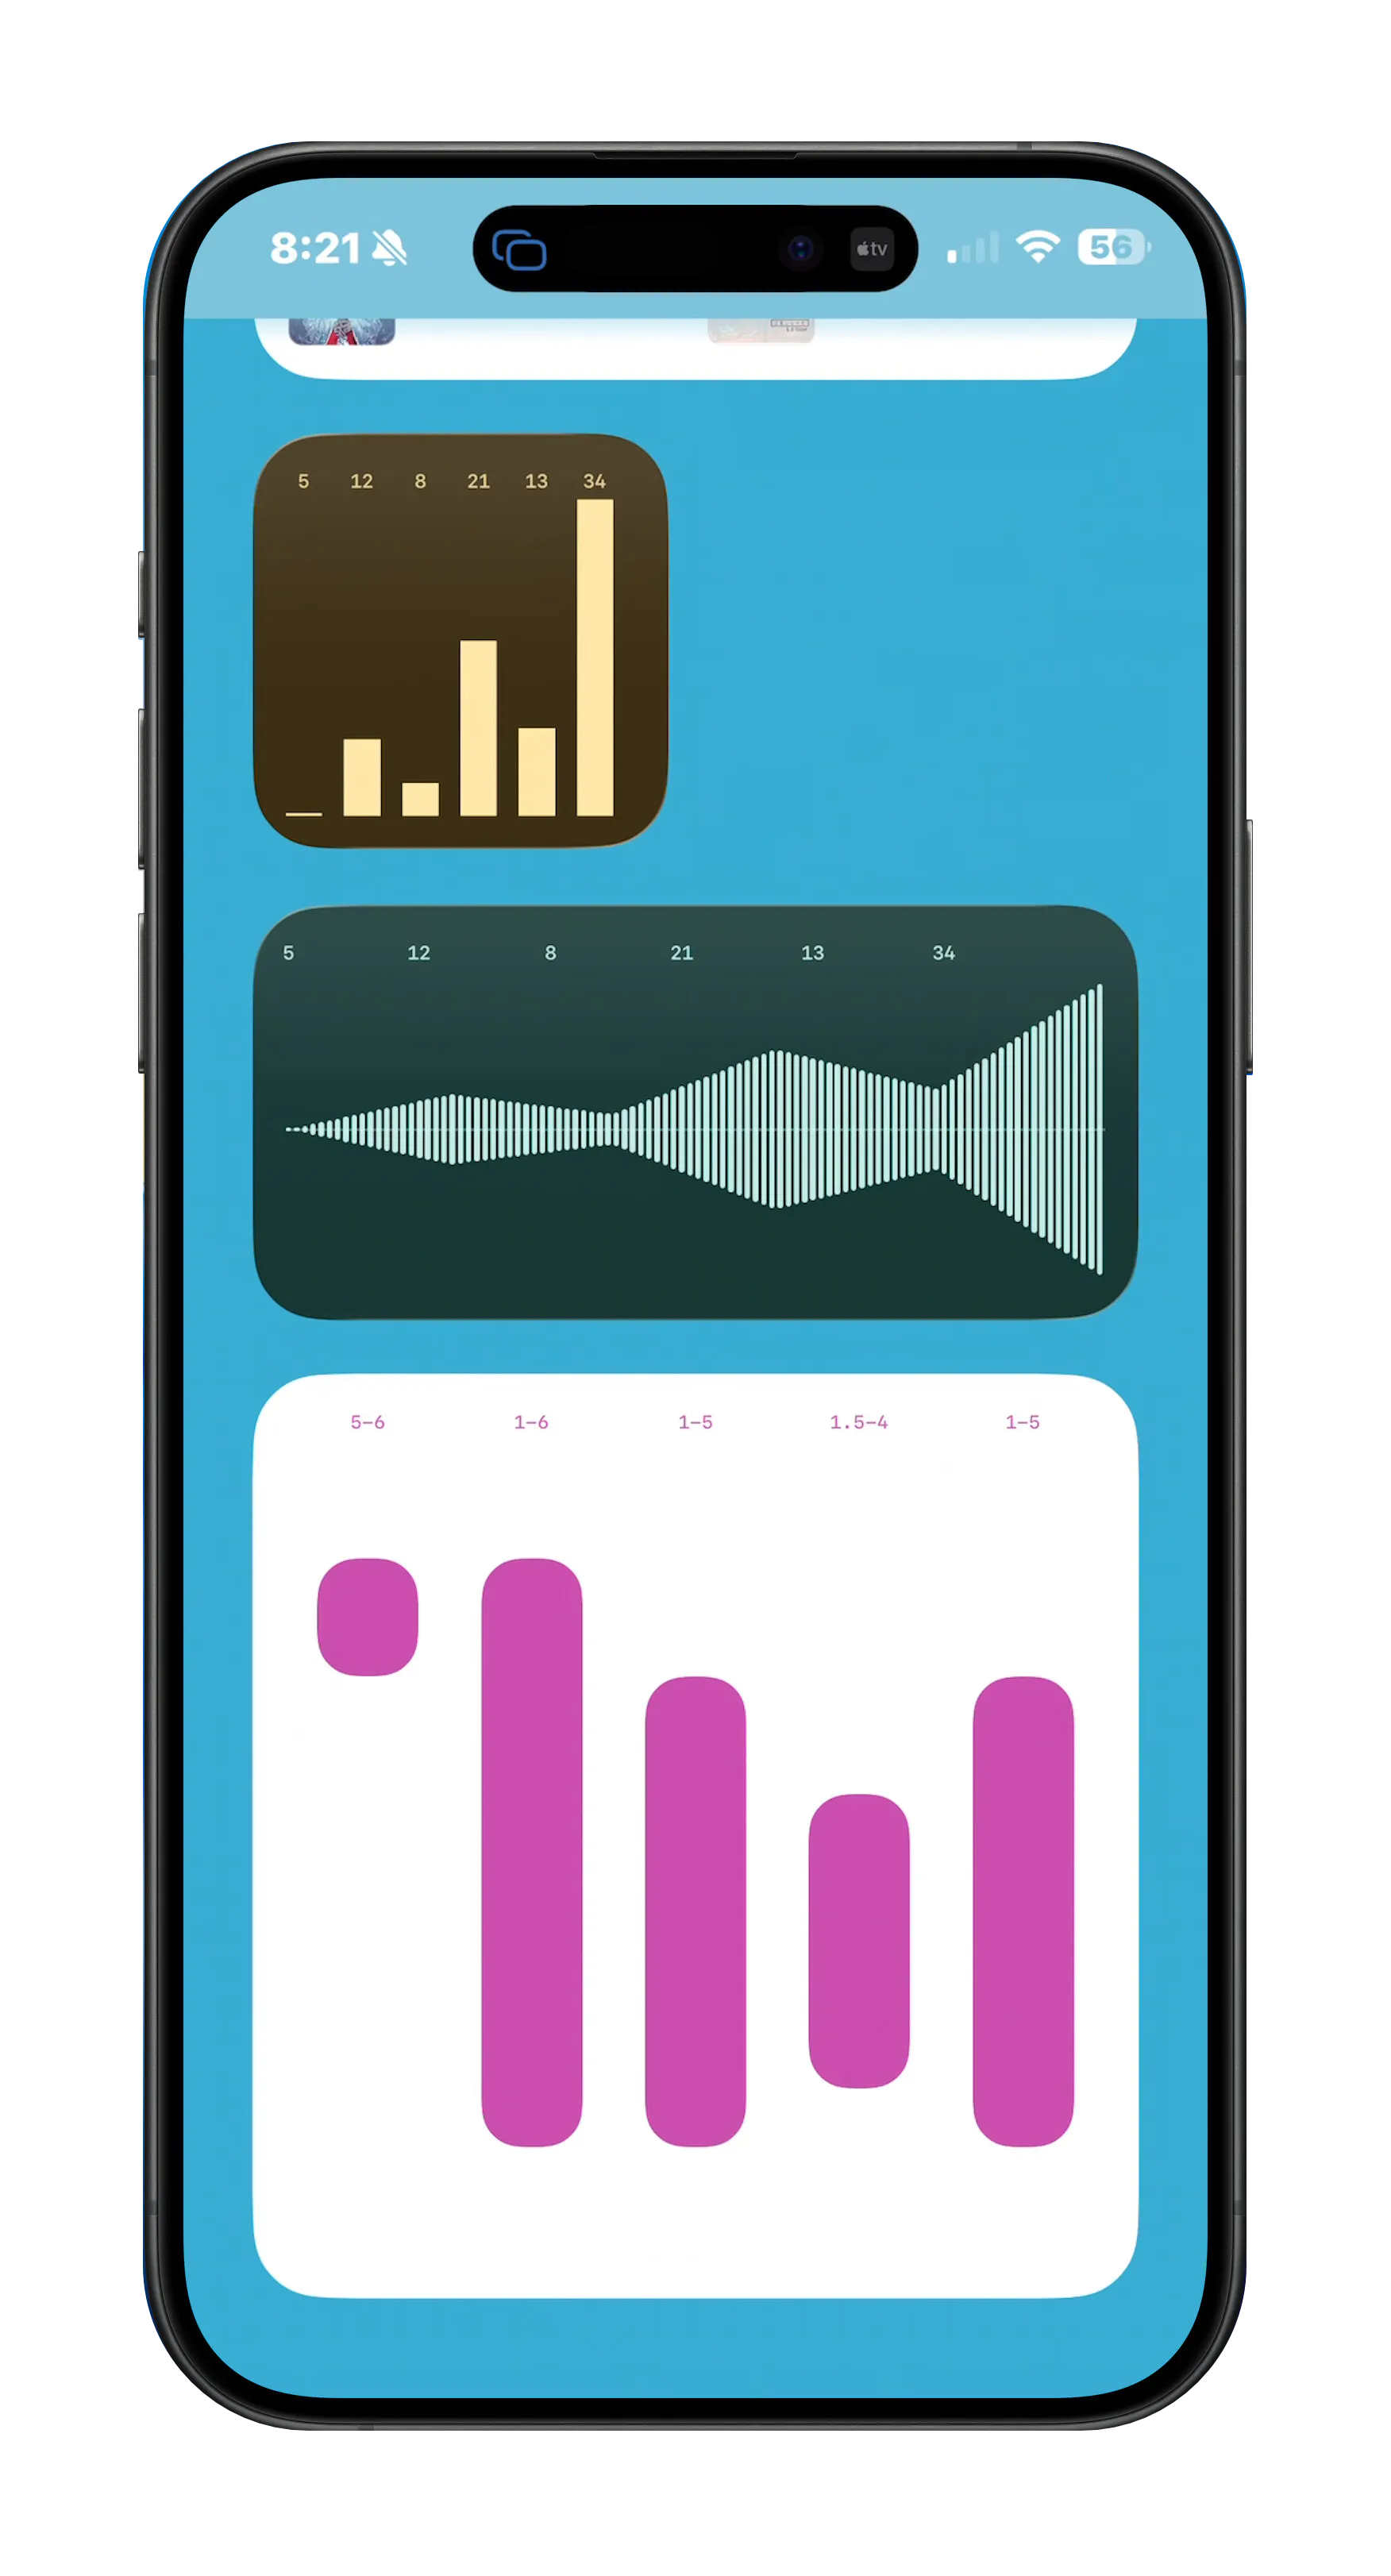
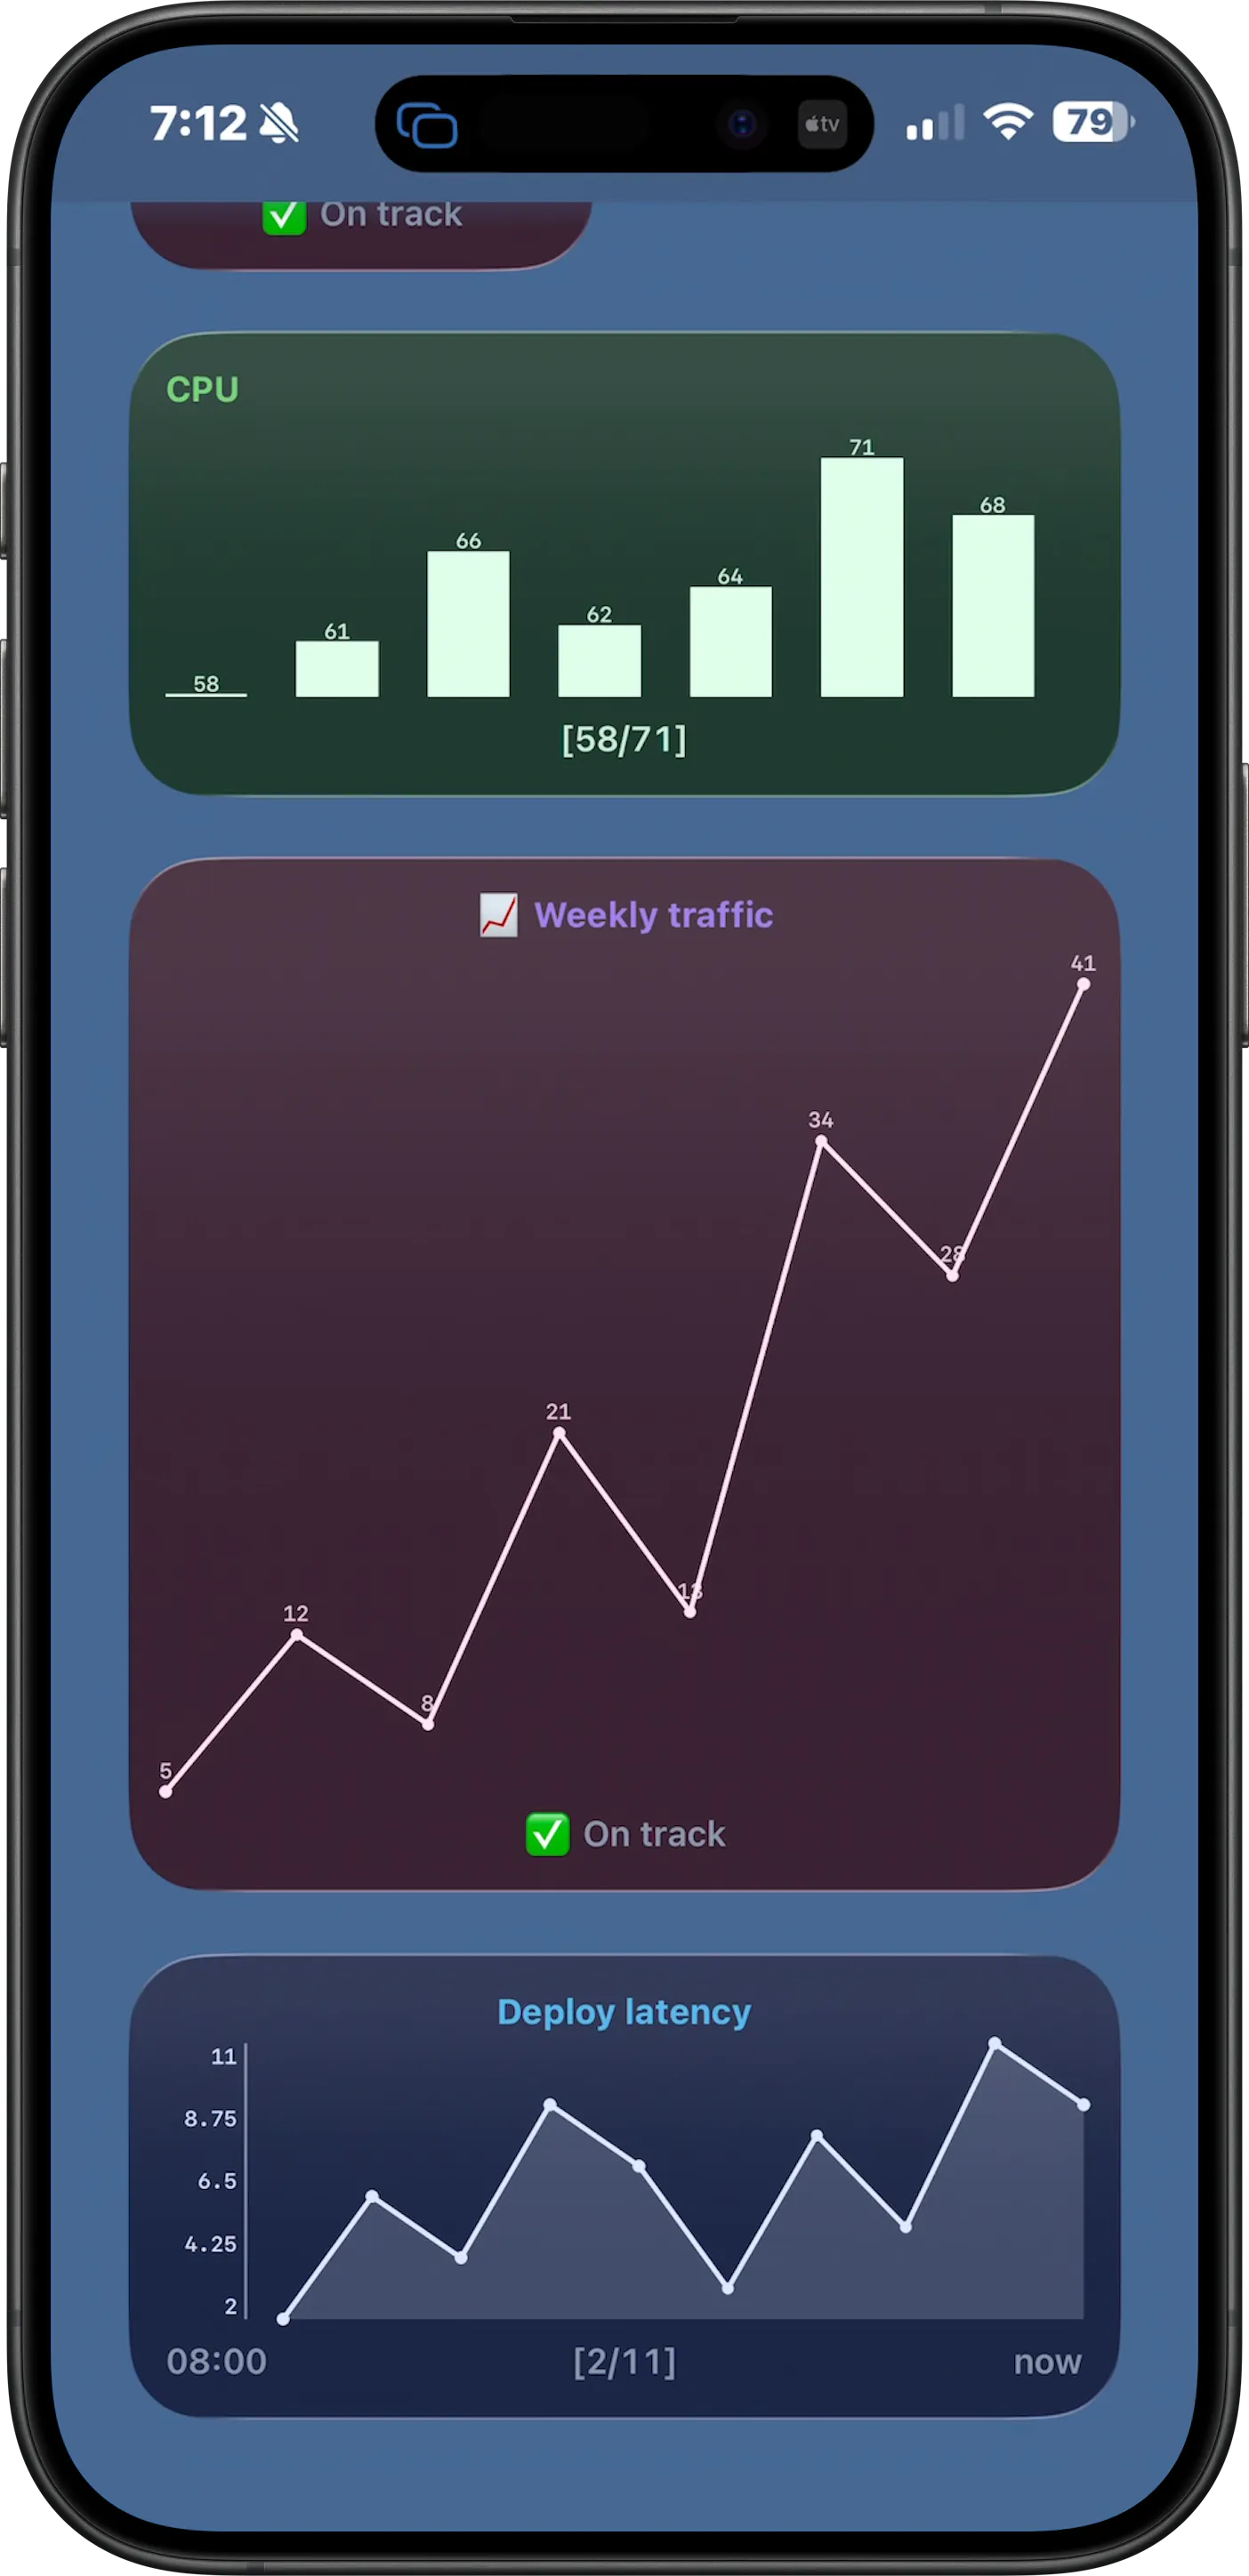
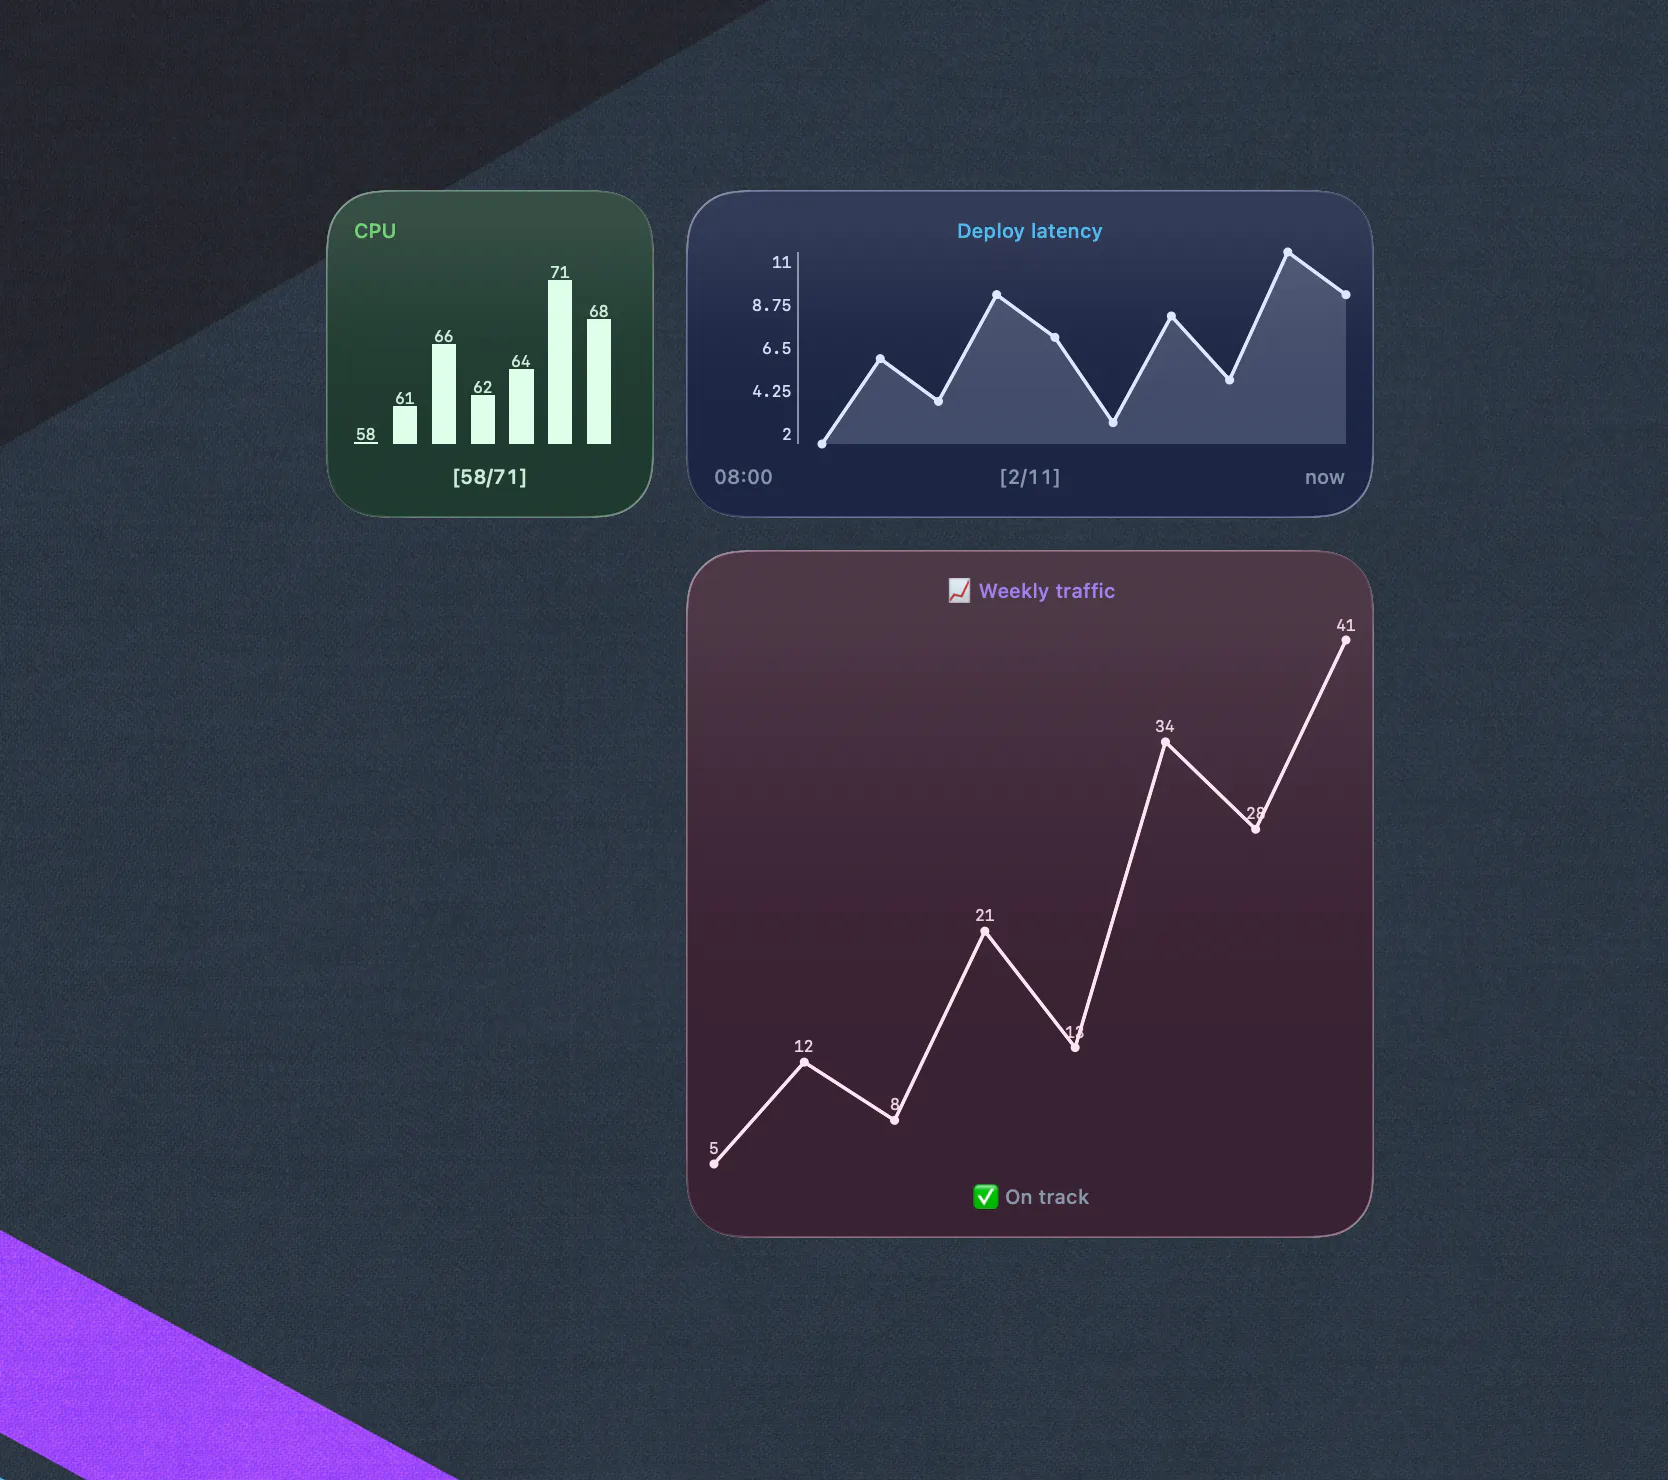
一句话介绍:TerminalWidget 是一款将终端脚本输出(如命令结果、进度、迷你趋势图及图片)直接呈现在 macOS、iOS 和 iPadOS 桌面或主屏小组件上的通用应用,解决用户需要频繁切换窗口查看数据更新、却缺乏轻量可视化看板的痛点。
Productivity
Developer Tools
Apple
桌面小组件
脚本可视化
终端输出
效率工具
数据监控
图表组件
跨平台同步
买断制
开发者工具
状态看板
用户评论摘要:用户高度认可“迷你趋势图”和买断制;核心疑虑集中在脚本运行环境(是否继承.zshrc/PATH)、沙箱权限及凭据存储;尖锐指出“陈旧数据”风险——脚本失败后旧值持续显示会误报健康,呼吁增加“数据时效/腐坏”视觉提示,而非仅靠刷新间隔。
AI 锐评
TerminalWidget 巧妙地在“极客脚本”与“苹果生态优雅”之间架了一座桥,本质上是将 Unix 哲学(单一输出)与 iOS 的 WidgetKit 刷新机制做了一次痛苦的联姻。它的价值并非取代仪表盘,而是把“信息主动推给眼睛”这件事做到了极简——这是它 135 票的来源,也确实是刚需。但评论区的真正工程师思维已经挖出了它的命门:这不是一个渲染工具,而是一个监控系统。当脚本非零退出时,Widget 上那个“昨天下午2点的绿灯”比没有数据更致命。开发者目前的回应是“输出由你决定”,这等于把数据新鲜度监控的责任推回给了用户——用一堆 Shell 命令去给 Widget 做防腐层,这本身就是一种新负担。它真正的天花板不在于画趋势图,而在于是否敢于定义“数据陈旧即失败”的语义层,并尝试接管密钥存储与调度权限(尽管这在 iOS 沙盒下极难)。如果它只停留在“漂亮的 cat 命令转储器”,那它会被 AI 原生 Agent 的主动推送迅速替代;若它能成为“脚本的诚实显示器”,它能吃掉一大块轻量运维监控市场。买断制是聪明的商业策略,但用户为“解决痛点”付费,而非为“避免订阅”付费——目前它解决的痛点真实,却尚未触及评论中反复出现的“信任与时效”这一深层价值。
一句话介绍:Terminal Candy 是一款将 macOS 终端“皮肤化”的原生应用,让你把终端窗口直接绘制在 Game Boy、磁带机或任意图片上,并通过智能代理提醒功能,减少你在 Claude Code / Codex 等 AI 编程工具旁的无谓等待。
Mac
Productivity
Developer Tools
macOS终端
终端美化
皮肤主题
开发者工具
AI编程助手
生产力工具
原生应用
自定义界面
CRT特效
订阅替代
用户评论摘要:用户普遍认可“Skin Builder”与“Agent 提醒”为真正价值点,但提出多终端并行时 dock 提醒无法区分具体窗口;另有评论建议将“Agent 提醒”作为核心卖点前置,而皮肤只是引流工具;maker 回应会调整文案顺序。
AI 锐评
Terminal Candy 的聪明之处在于把“丑”和“等”两个终端痛点做成了卖点。皮肤化是钩子,但真正让用户掏钱的是“Agent 提醒”——它精准击中了 AI 编程时代的新焦虑:当你同时跑多个 Claude Code 或 Codex 实例时,时间被碎片化切碎,而传统终端不会告诉你哪个窗口在等你。这个功能本质上是一个“注意力路由器”,比任何主题都更贴近生产力刚需。
但产品的天花板也在这里。皮肤化是强个性化需求,社区驱动虽然能降低官方设计成本,却难以形成持续粘性——用户玩腻 Game Boy 后,留存率存疑。而“多代理区分提醒”目前只做了单一 dock 弹跳,没有窗口级标识,这在多任务场景下是明显短板,评论里已有人踩到。如果后续不升级为“按代理/项目分离信号”,这个核心功能会停留在“可用”而非“可靠”。
商业模式上,一次性 $10 定价相当克制,配合“发 10 个皮肤免单”的机制,其实是在低成本买社区内容——算得精。但终究是工具类应用的通病:功能可以被系统原生或开源替代品抄袭(比如 iTerm2 + 脚本),皮肤也不能构成护城河。Terminal Candy 的价值锚点在于“把终端变成你愿意待的空间”,但“空间”一旦新鲜感过去,剩下的只有效率。建议团队把精力从皮肤转移到“终端智能感知层”——比如根据当前 AI 任务的输出自动切换界面提醒方式,这才是从玩具到工具的分水岭。
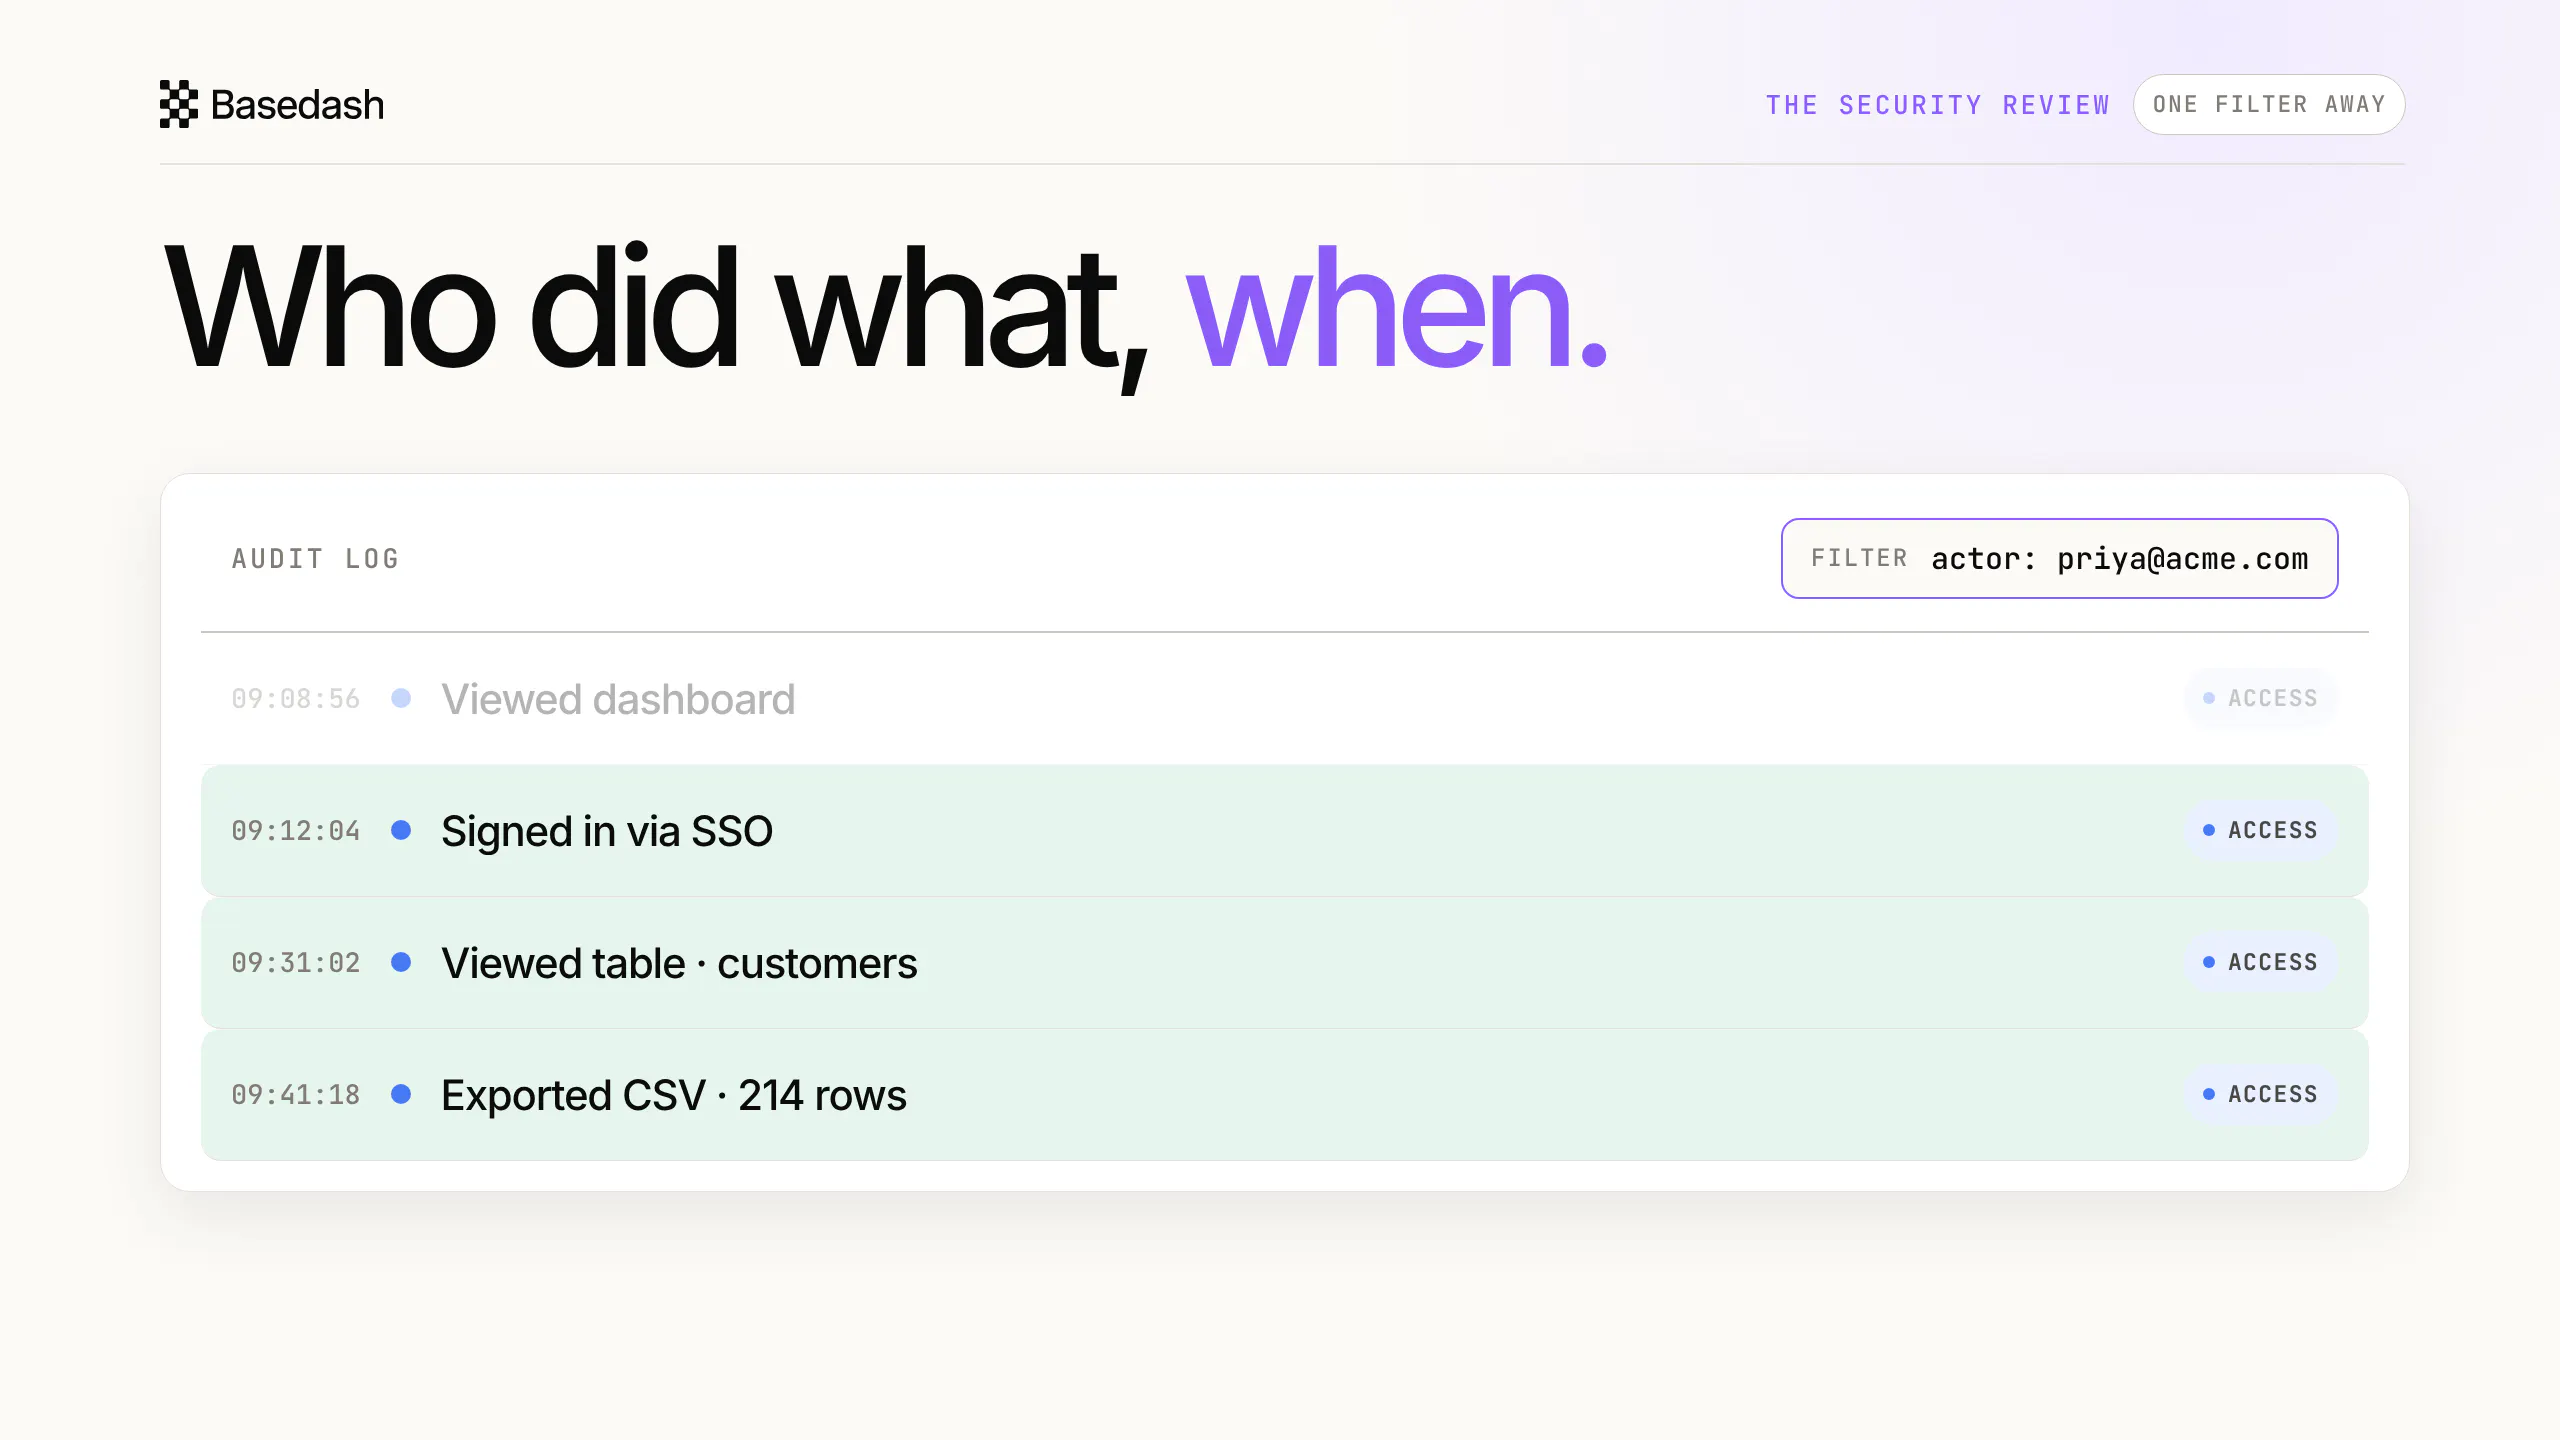
一句话介绍:Basedash Audit Logs为BI工具提供原生审计日志,记录登录、查询(含AI查询)和配置变更,解决企业在安全审查与合规审计时“谁在何时看了什么”难以追溯的痛点。
Artificial Intelligence
Data & Analytics
Business Intelligence
审计日志
BI工具
企业安全
合规审查
AI查询追踪
SIEM集成
数据溯源
权限管理
日志留存
企业级SaaS
用户评论摘要:用户高度关注审计粒度和AI查询细节,追问是否记录完整SQL文本而非仅元数据;质疑日志留存策略与PII数据删除合规冲突;建议将AI生成的文字回答与SQL并列存储,以便追溯决策依据;整体认可功能填补了安全审查关键缺口。
AI 锐评
Basedash Audit Logs本质上是在给“会犯错的AI”上保险,踩中了企业采购中“安全审查一票否决”的命门。其核心卖点不是日志本身,而是将AI从“黑箱操作者”降格为“可审计的执行者”——这个定位精准且狠辣。但评论区暴露了两大致命悬而未决的问题:其一,日志在SIEM导出场景下是否包含完整SQL原文?若仅提供哈希或ID,面对“某条数据为何在报告中异常”的追溯需求,安全团队依旧要回到产品内二次查询,这削弱了“流式导出”的运维价值。其二,也是最关键的合规悖论:日志为满足“保留最低时限”而长期存储富含PII的查询文本,与GDPR等法规要求的“删除权”和“数据最小化”直接冲突。若产品只提供全局留存策略而无字段级脱敏或按数据分类的差异化留存,那么这套系统在金融、医疗等强监管行业反而会成为新的合规风险点,而非“保险”。此外,用户一针见血地指出:产品记录“AI执行了什么”,却未保存“AI说了什么”。在真实决策链路中,错误的自然语言总结比错误的SQL更具破坏性,且难以事后核查。若Basedash不补上“推理-查询-答复”的完整快照链,其审计价值就只完成了一半——它证明了AI“做过”,却无法证明AI“说对”。在竞品纷纷以AI能力为卖点时,Basedash选择以“AI的 accountability”切入,方向正确,但产品成熟度仍需向真正的“企业级可证伪性”迈进。目前它是一把好用的梳子,但距离企业合规所需的“显微镜”,还有两三个关键迭代的距离。
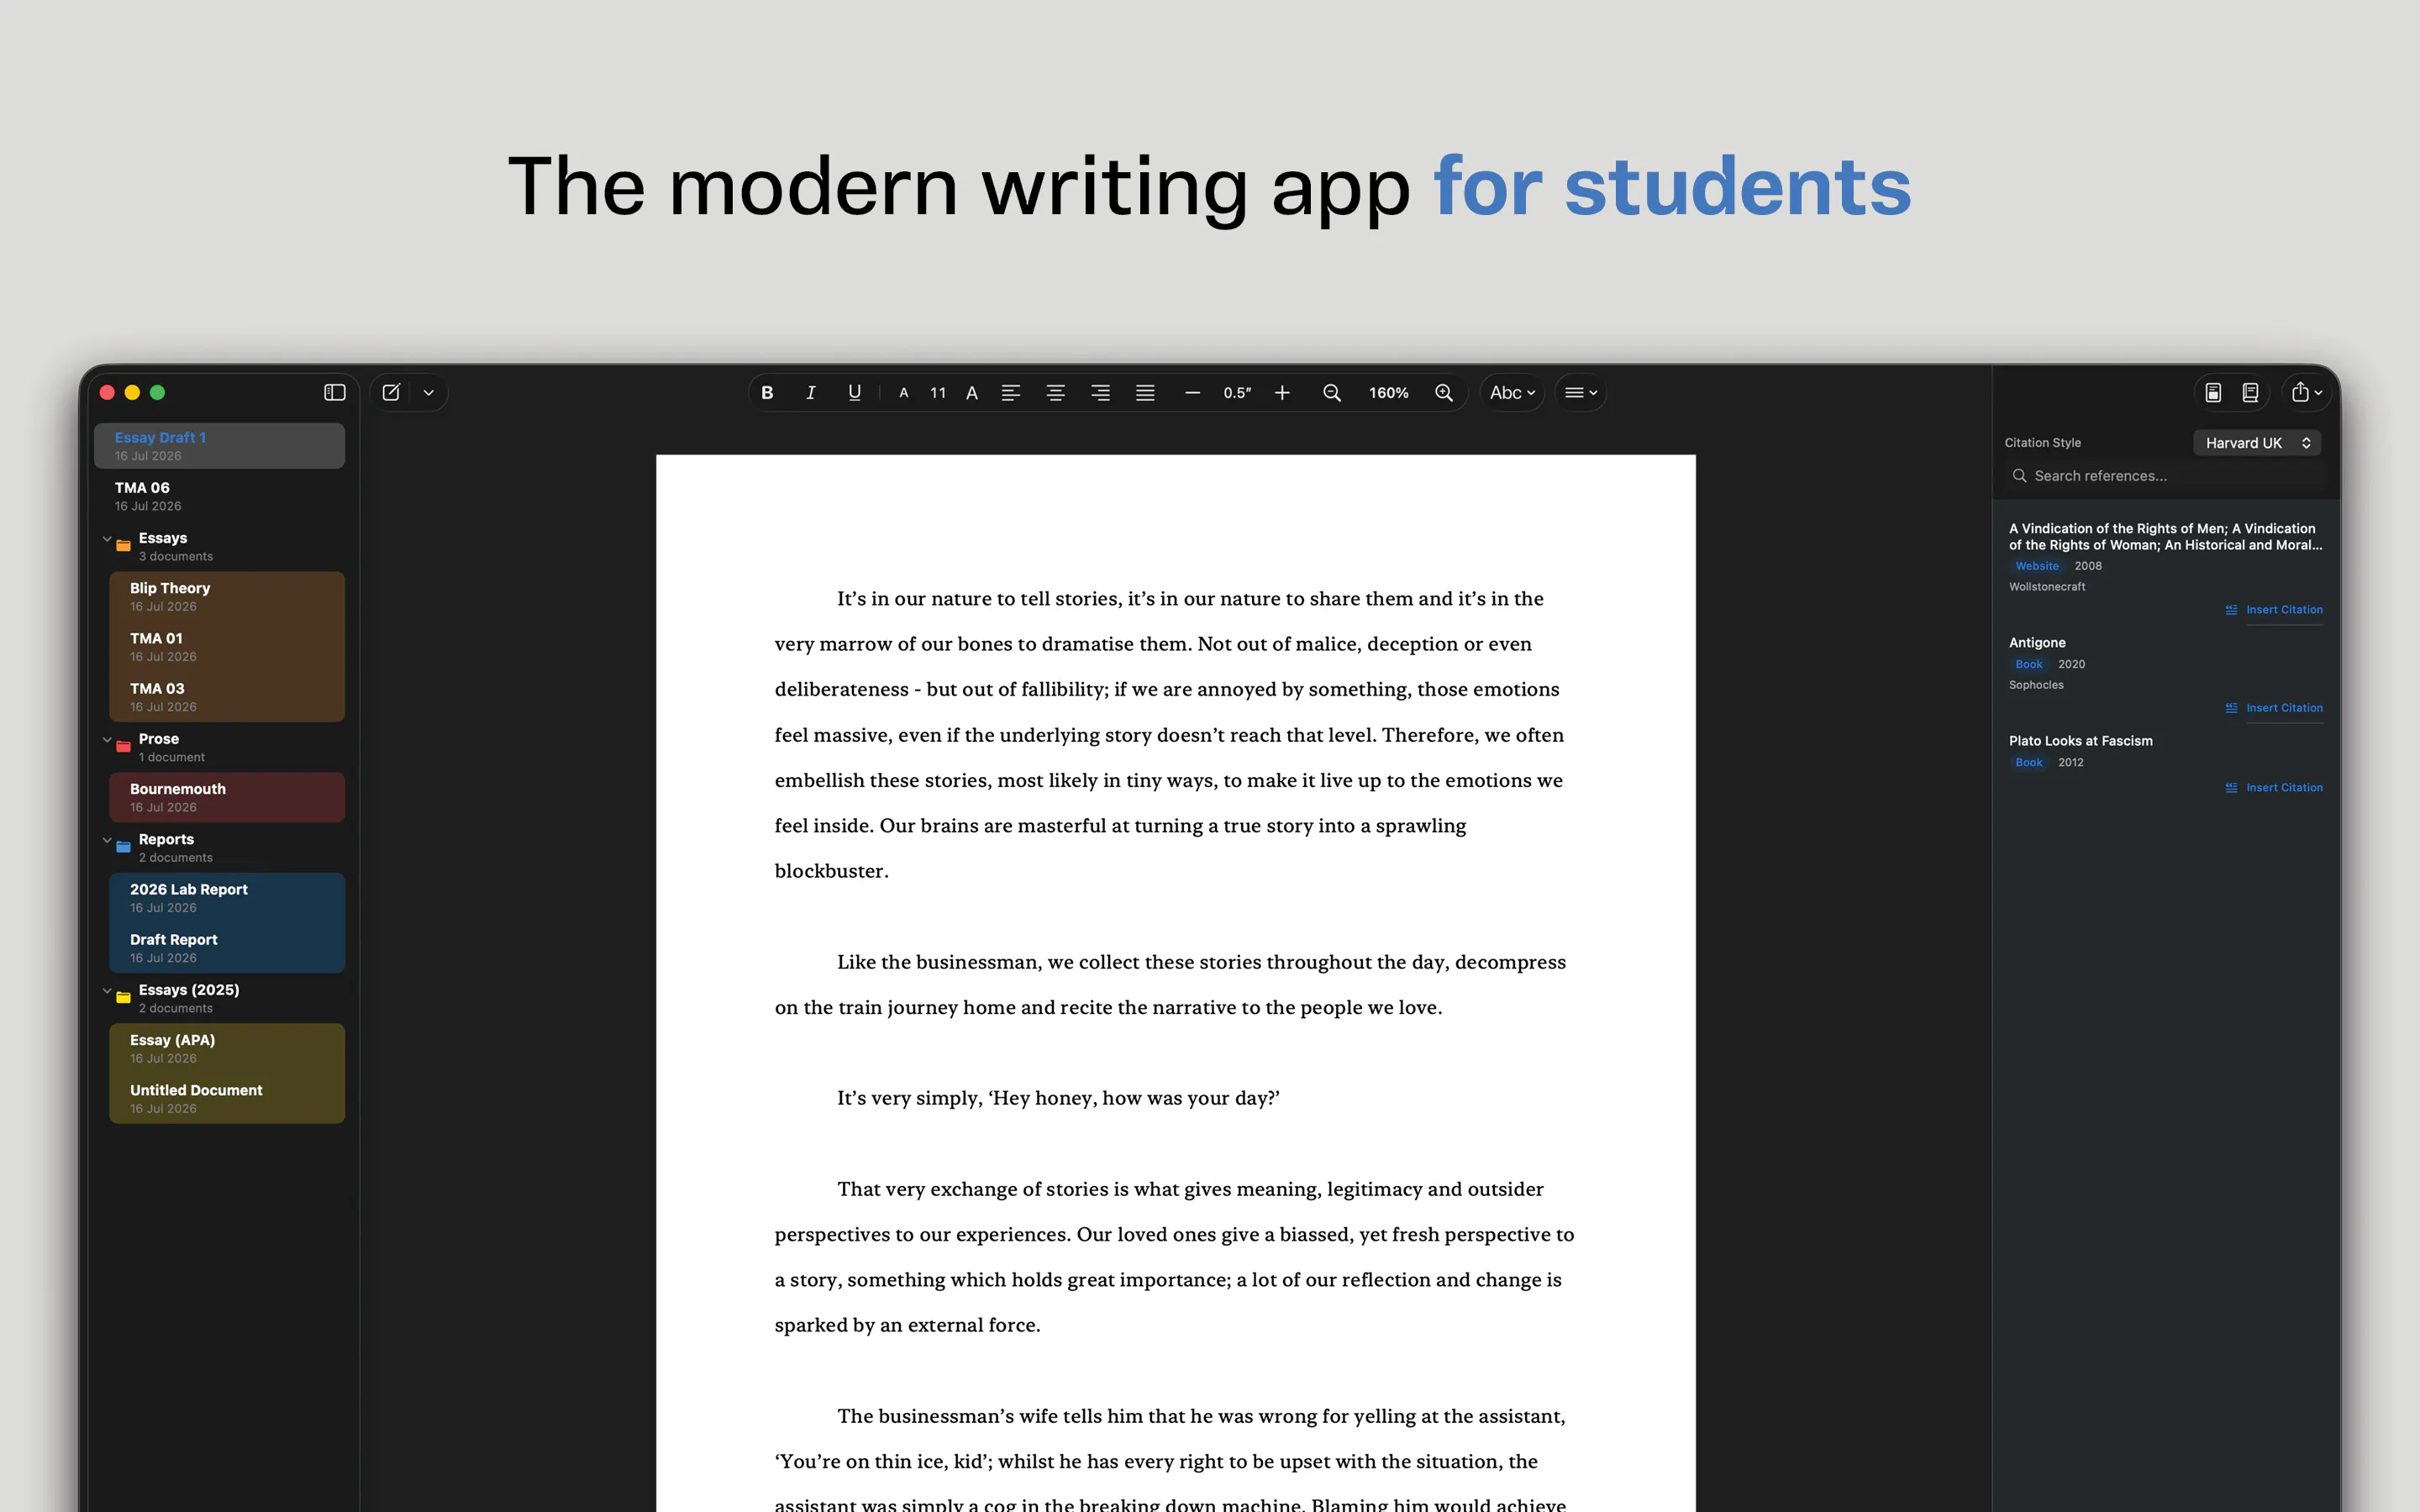
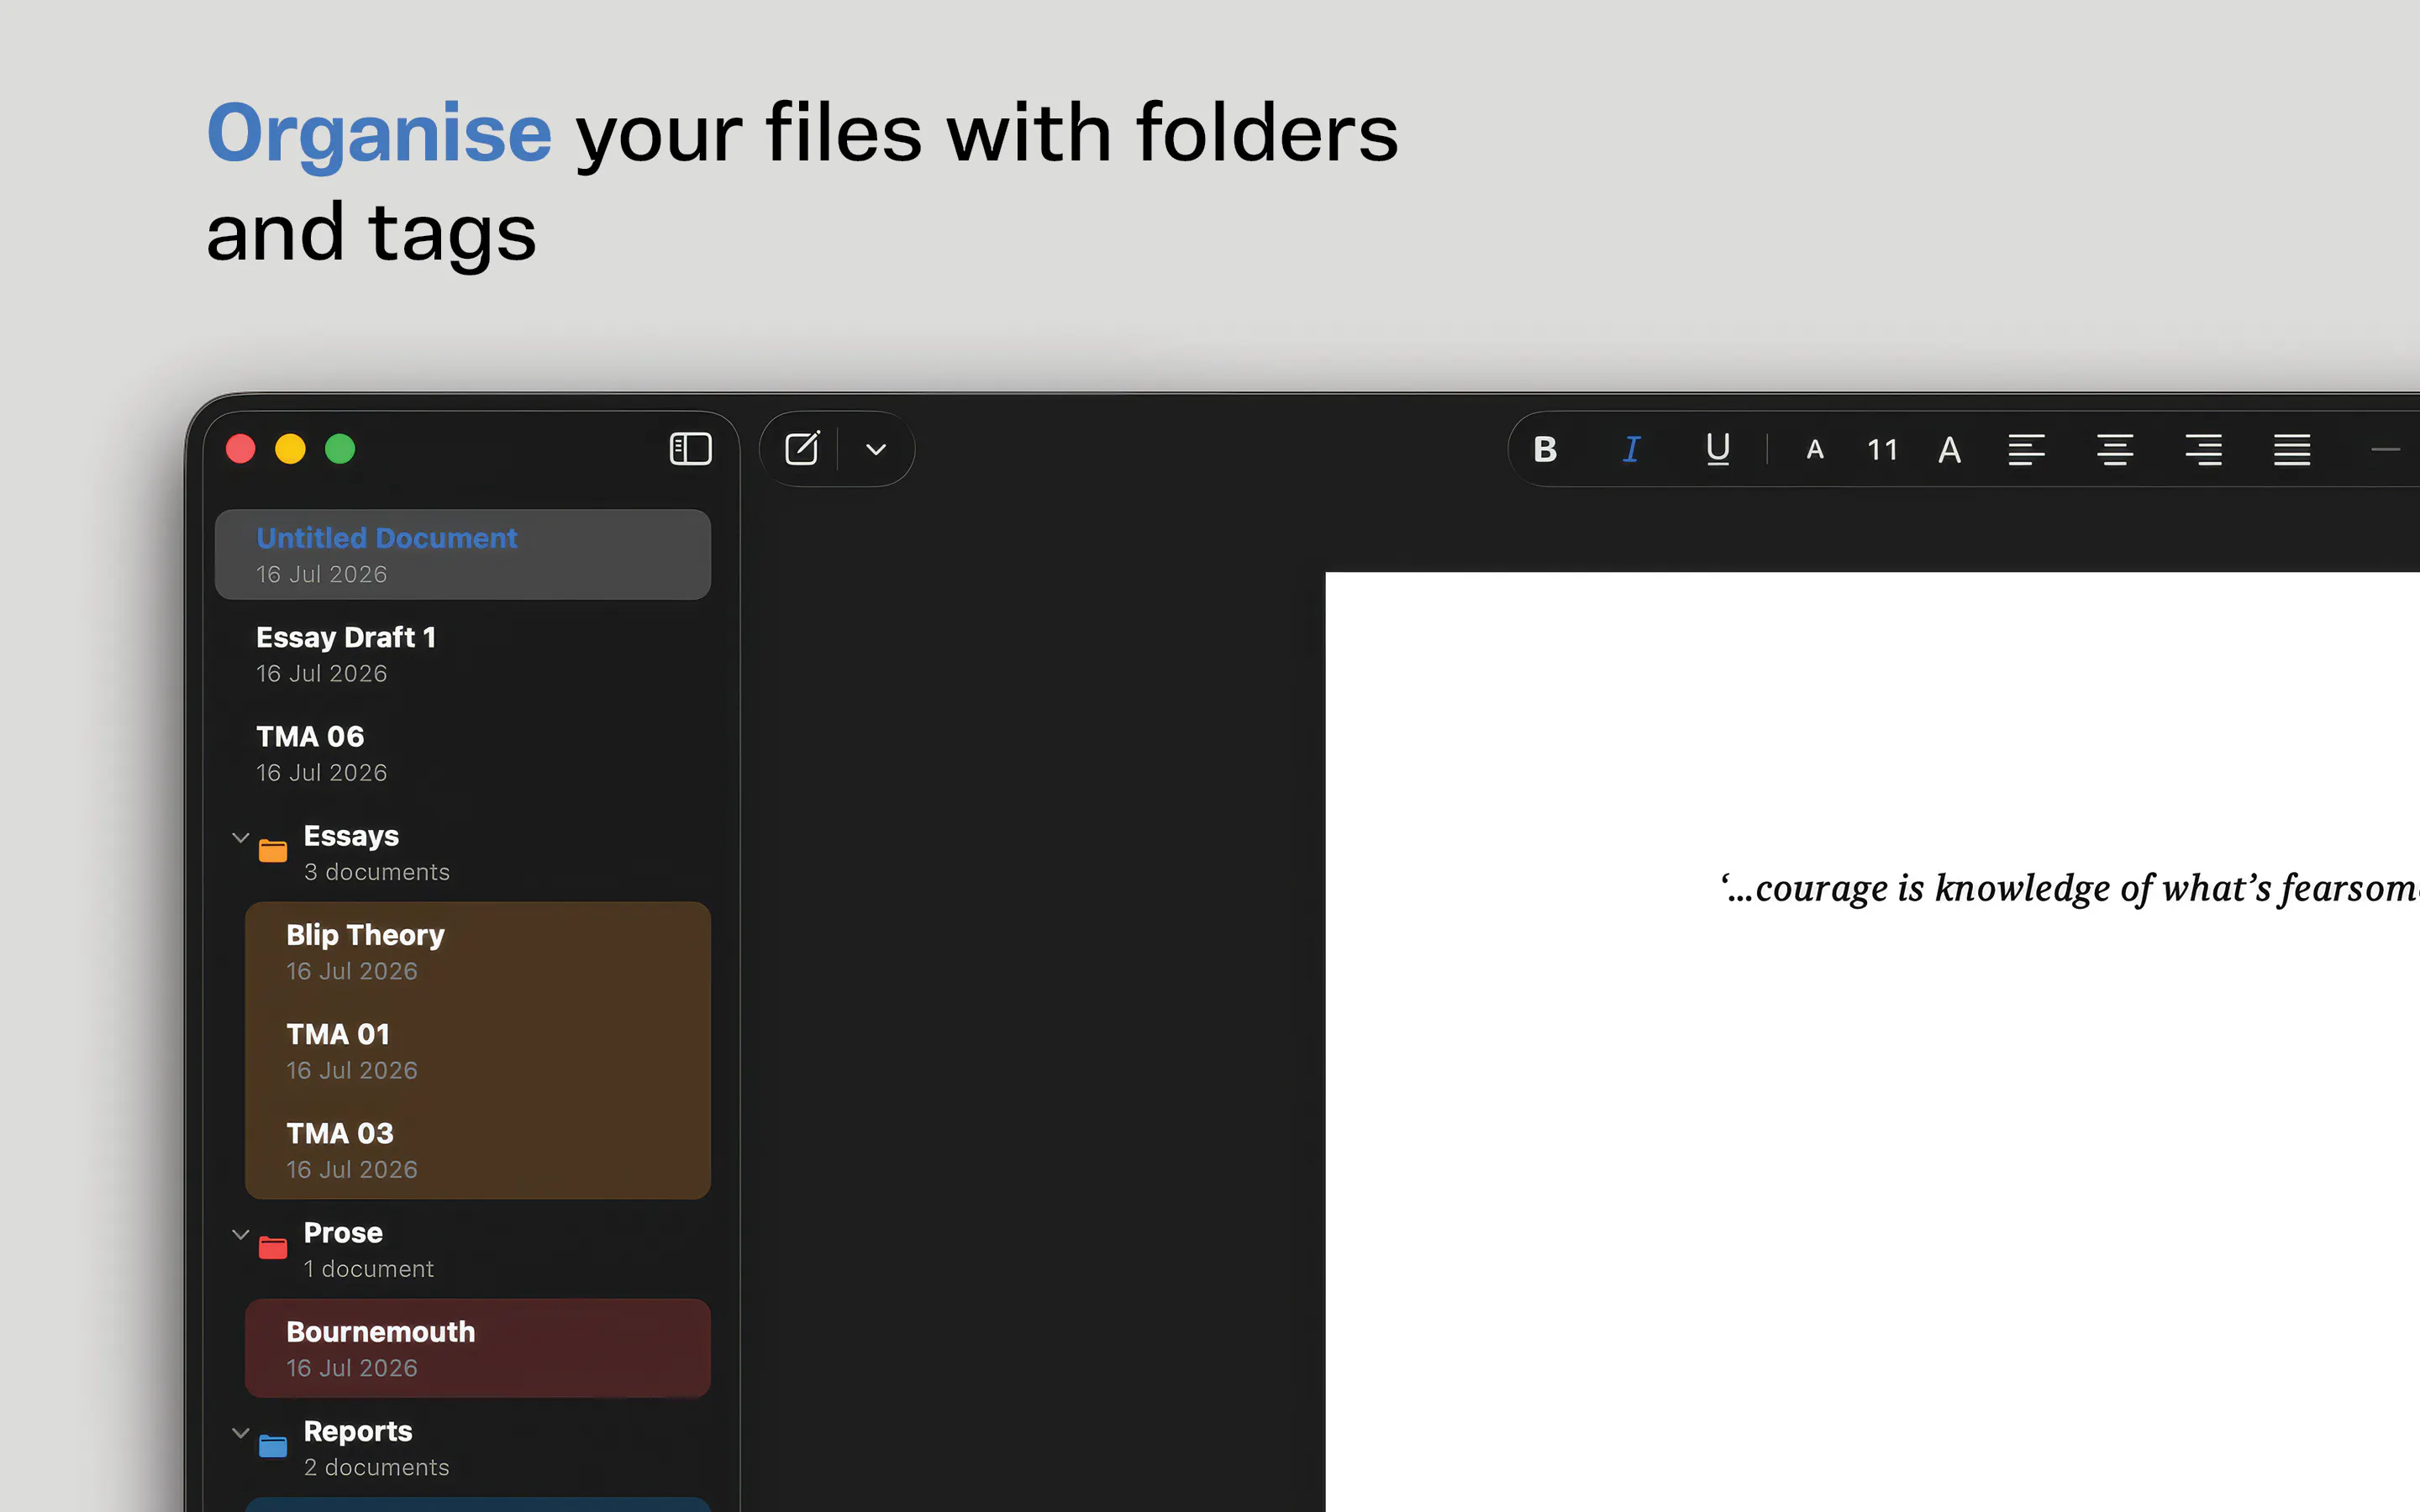
一句话介绍:EssayKraft 是一款专为学生打造的 Mac 和 iPad 原生写作应用,将长篇写作、文献管理、自动引用与导出功能整合于一处,解决学术写作中工具割裂与引用管理的繁琐痛点。
Writing
Education
Apple
学术写作
文献管理
自动引用
原生应用
Mac
iPad
学生工具
买断制
无订阅
专注写作
用户评论摘要:用户普遍认可原生体验与买断制,认为“无账号无订阅”是学生真实需求。主要疑问集中在引用格式的更新机制(如APA/MLA改版如何跟进)以及iCloud同步是否自动、是否打断写作流。开发者回应确认文档保存即同步。另有用户称赞自研引用管理器的思路,以及开发者在读期间自学Swift的诚意。
AI 锐评
EssayKraft 的切入点很聪明:它没有试图再造一个“更好的Word”,而是精准切走学术写作中“引用管理”这一根硬刺,并用“原生+买断”构建了明确的价值锚点。对于学生群体,订阅疲劳和工具碎片化是真实痛点,因此“无账号无订阅”不是营销话术,而是有效竞争力。但产品的生死线在于引用引擎的可靠性——评论中已有用户尖锐指出:当APA或MLA在学业中途改版时,买断制下的更新周期是否跟得上?这不仅是技术债问题,更是信任问题。若格式逻辑完全硬编码,那么每一次规范更新都是对“买断即终身”承诺的消耗;若引入云端规则库,则又可能违背其“无账号”的纯粹性。此外,iCloud同步虽是“保存即触发”,但iCloud本身在复杂文档上的冲突历史并不光彩,长篇论文场景下的版本回滚与批注协作仍是空白。总体而言,EssayKraft 展示了独立开发者的精准嗅觉,但“文献管理”是学术工具里最容错率最低的领域——学生可以忍受界面简陋,但绝无法接受毕业前夜格式错误。买断制可以是商业模式的创新,却不应成为更新惰性的借口。它目前更像一个优秀的“写作环境”,而非可靠的“学术基础设施”。若想真正立足,需要在引用规则的可维护性上给出透明、可验证的更新承诺,否则只能停留在“小而美”的舒适区。
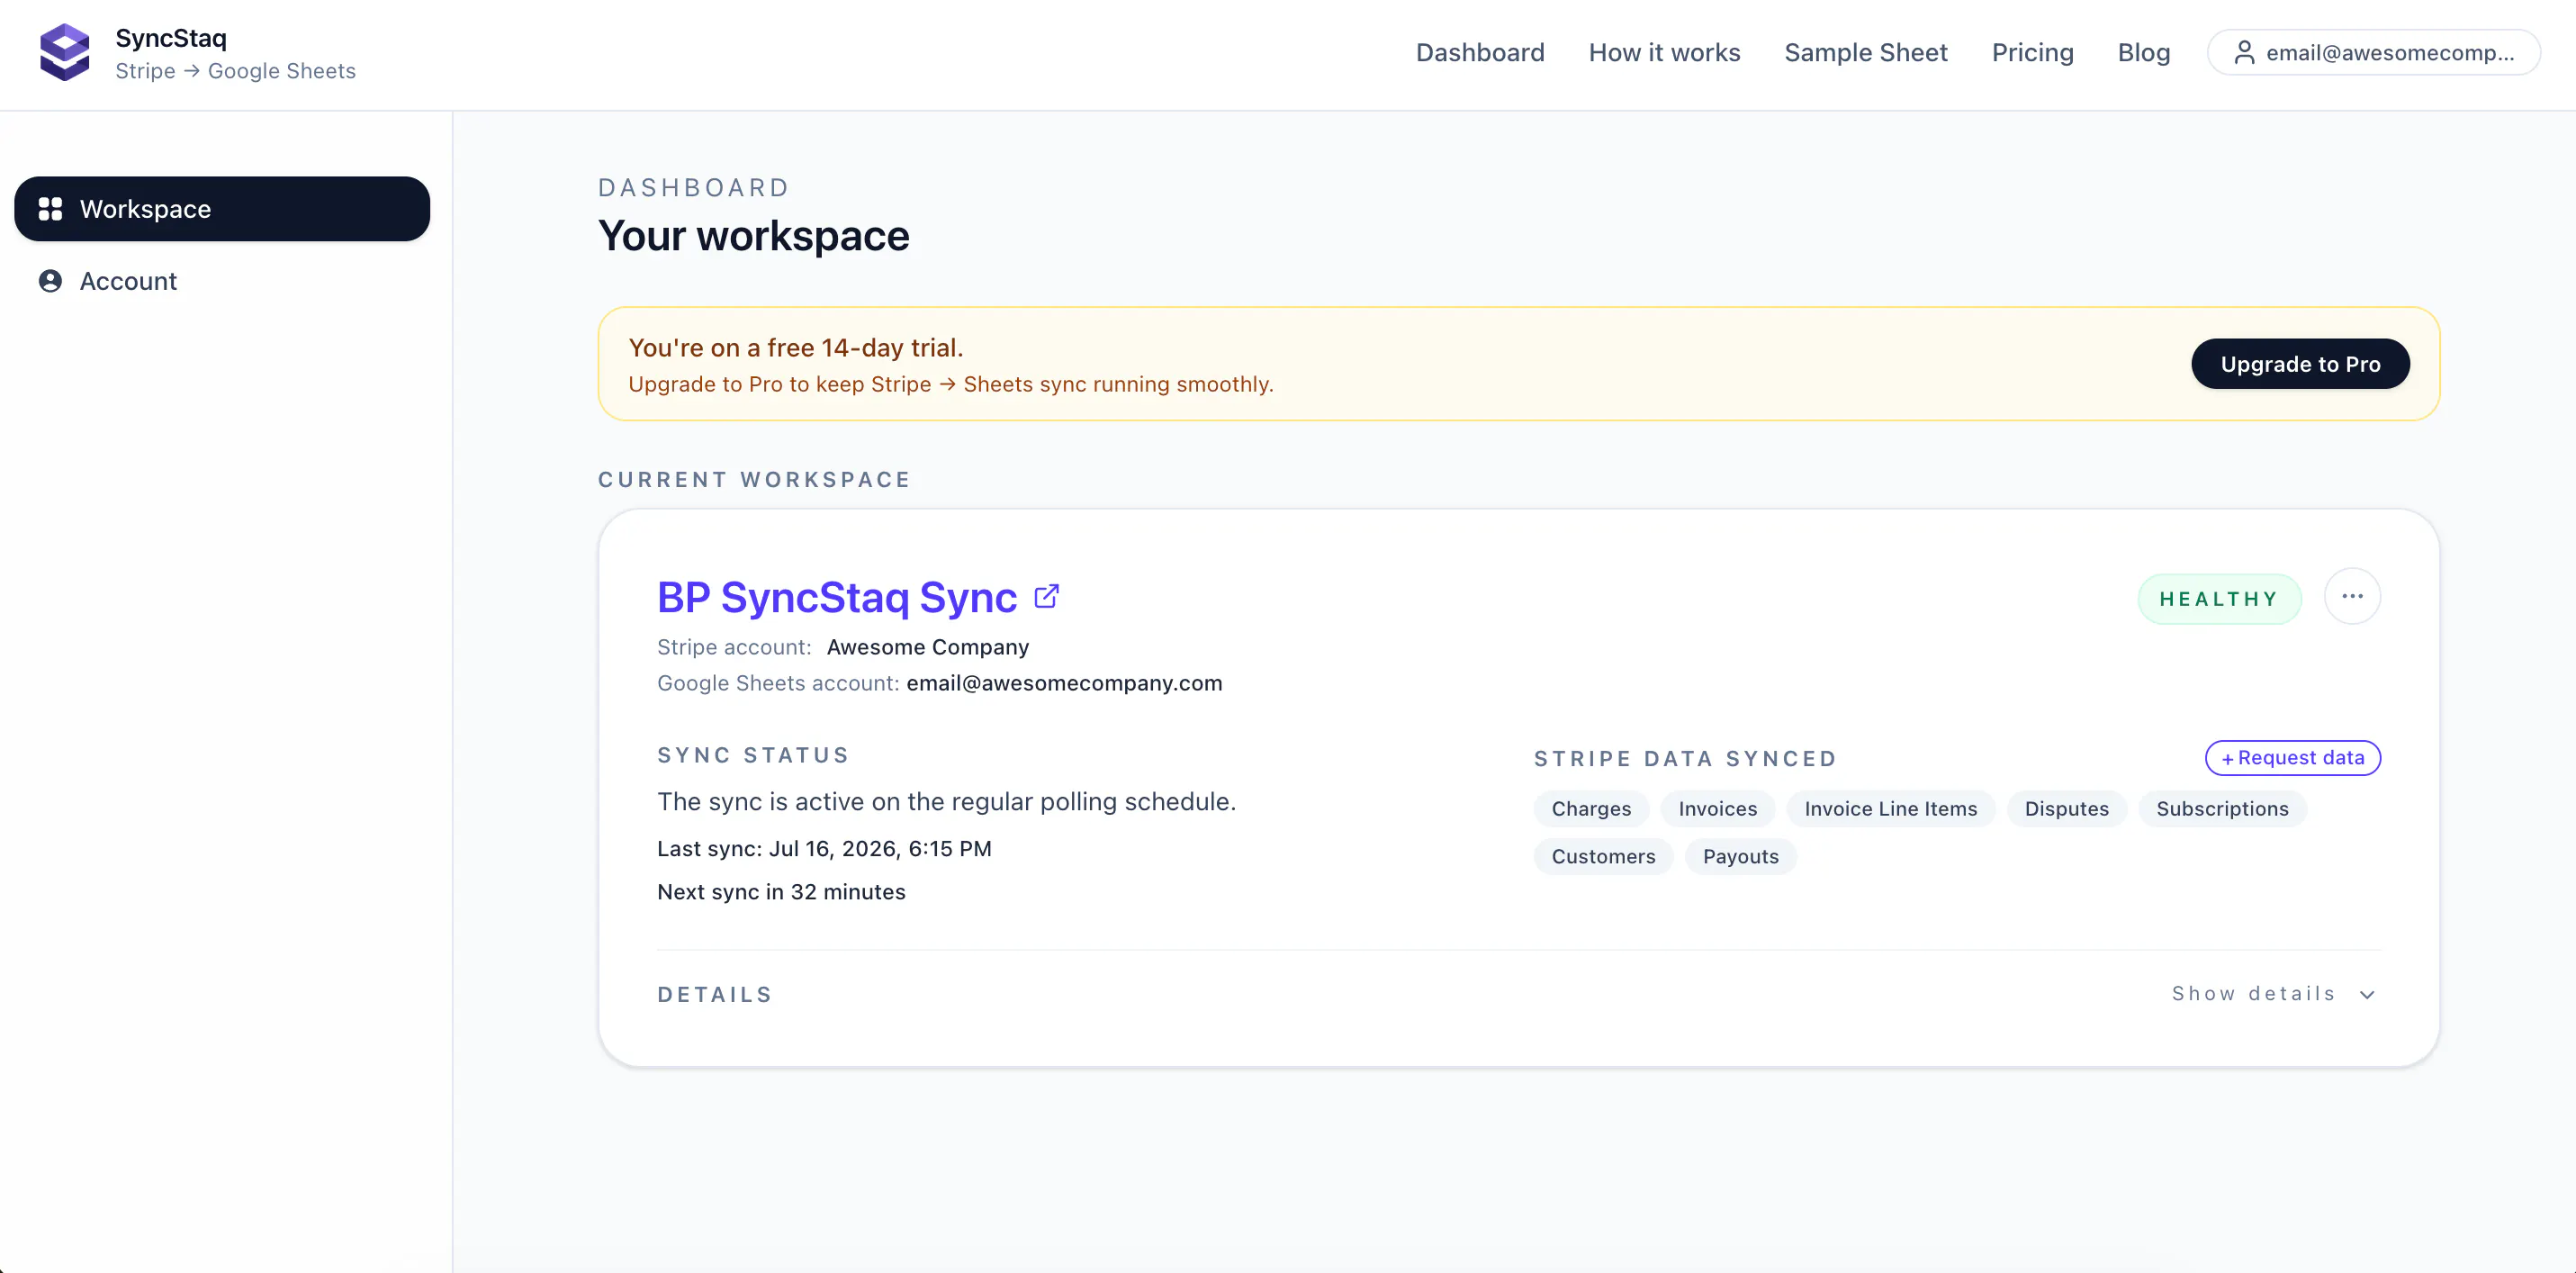
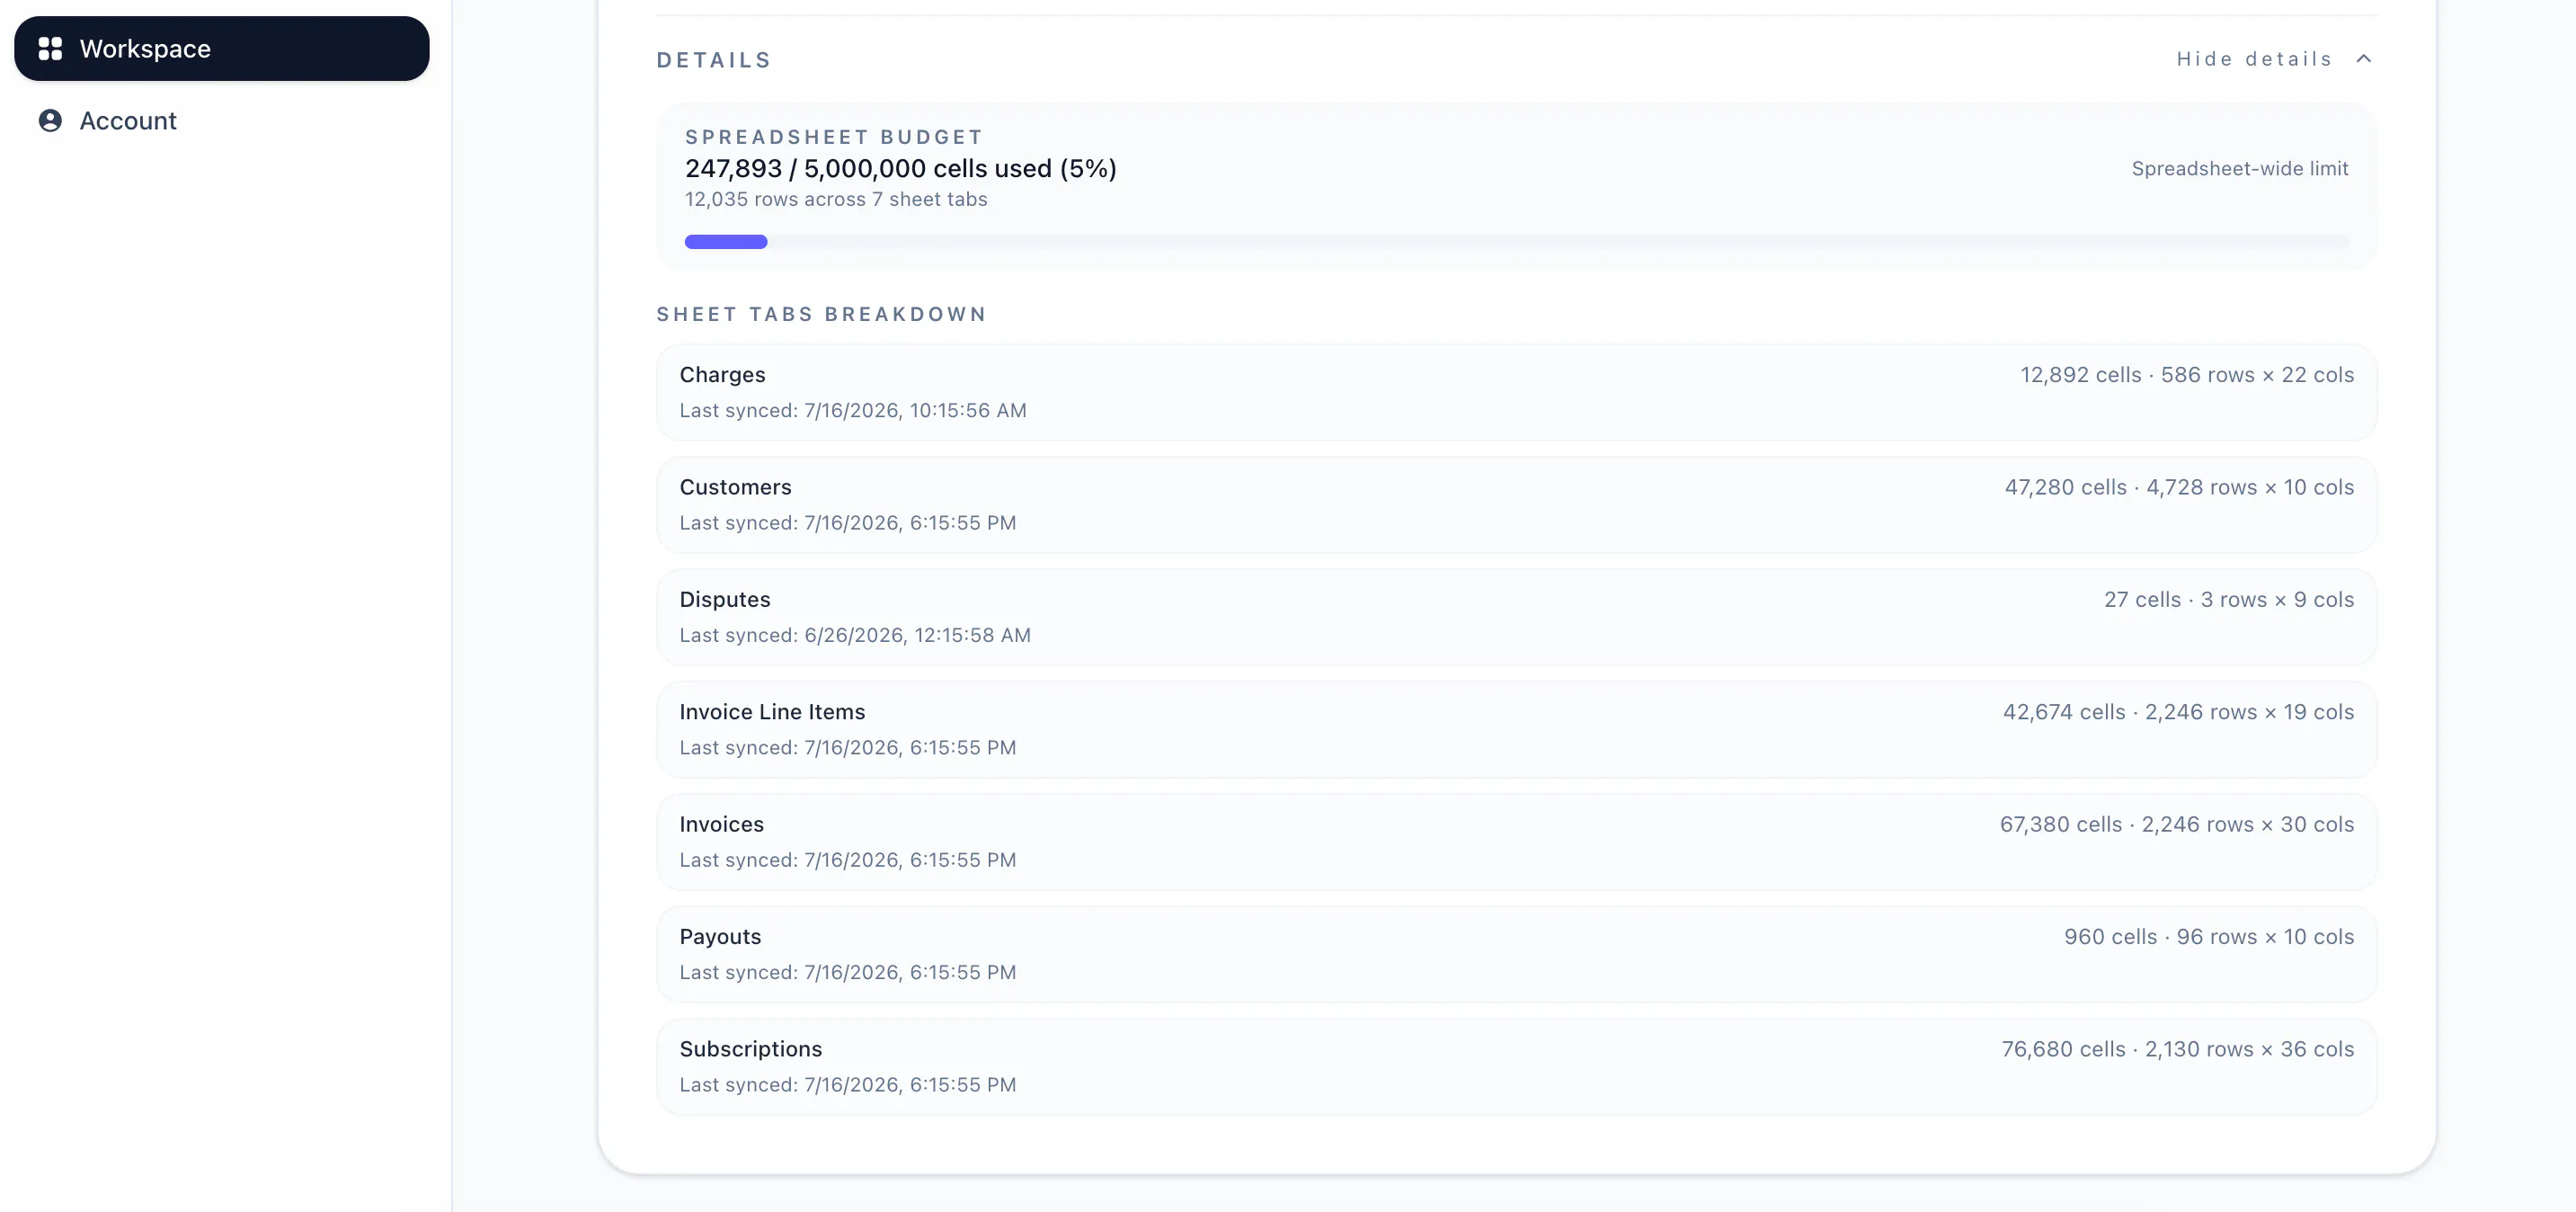
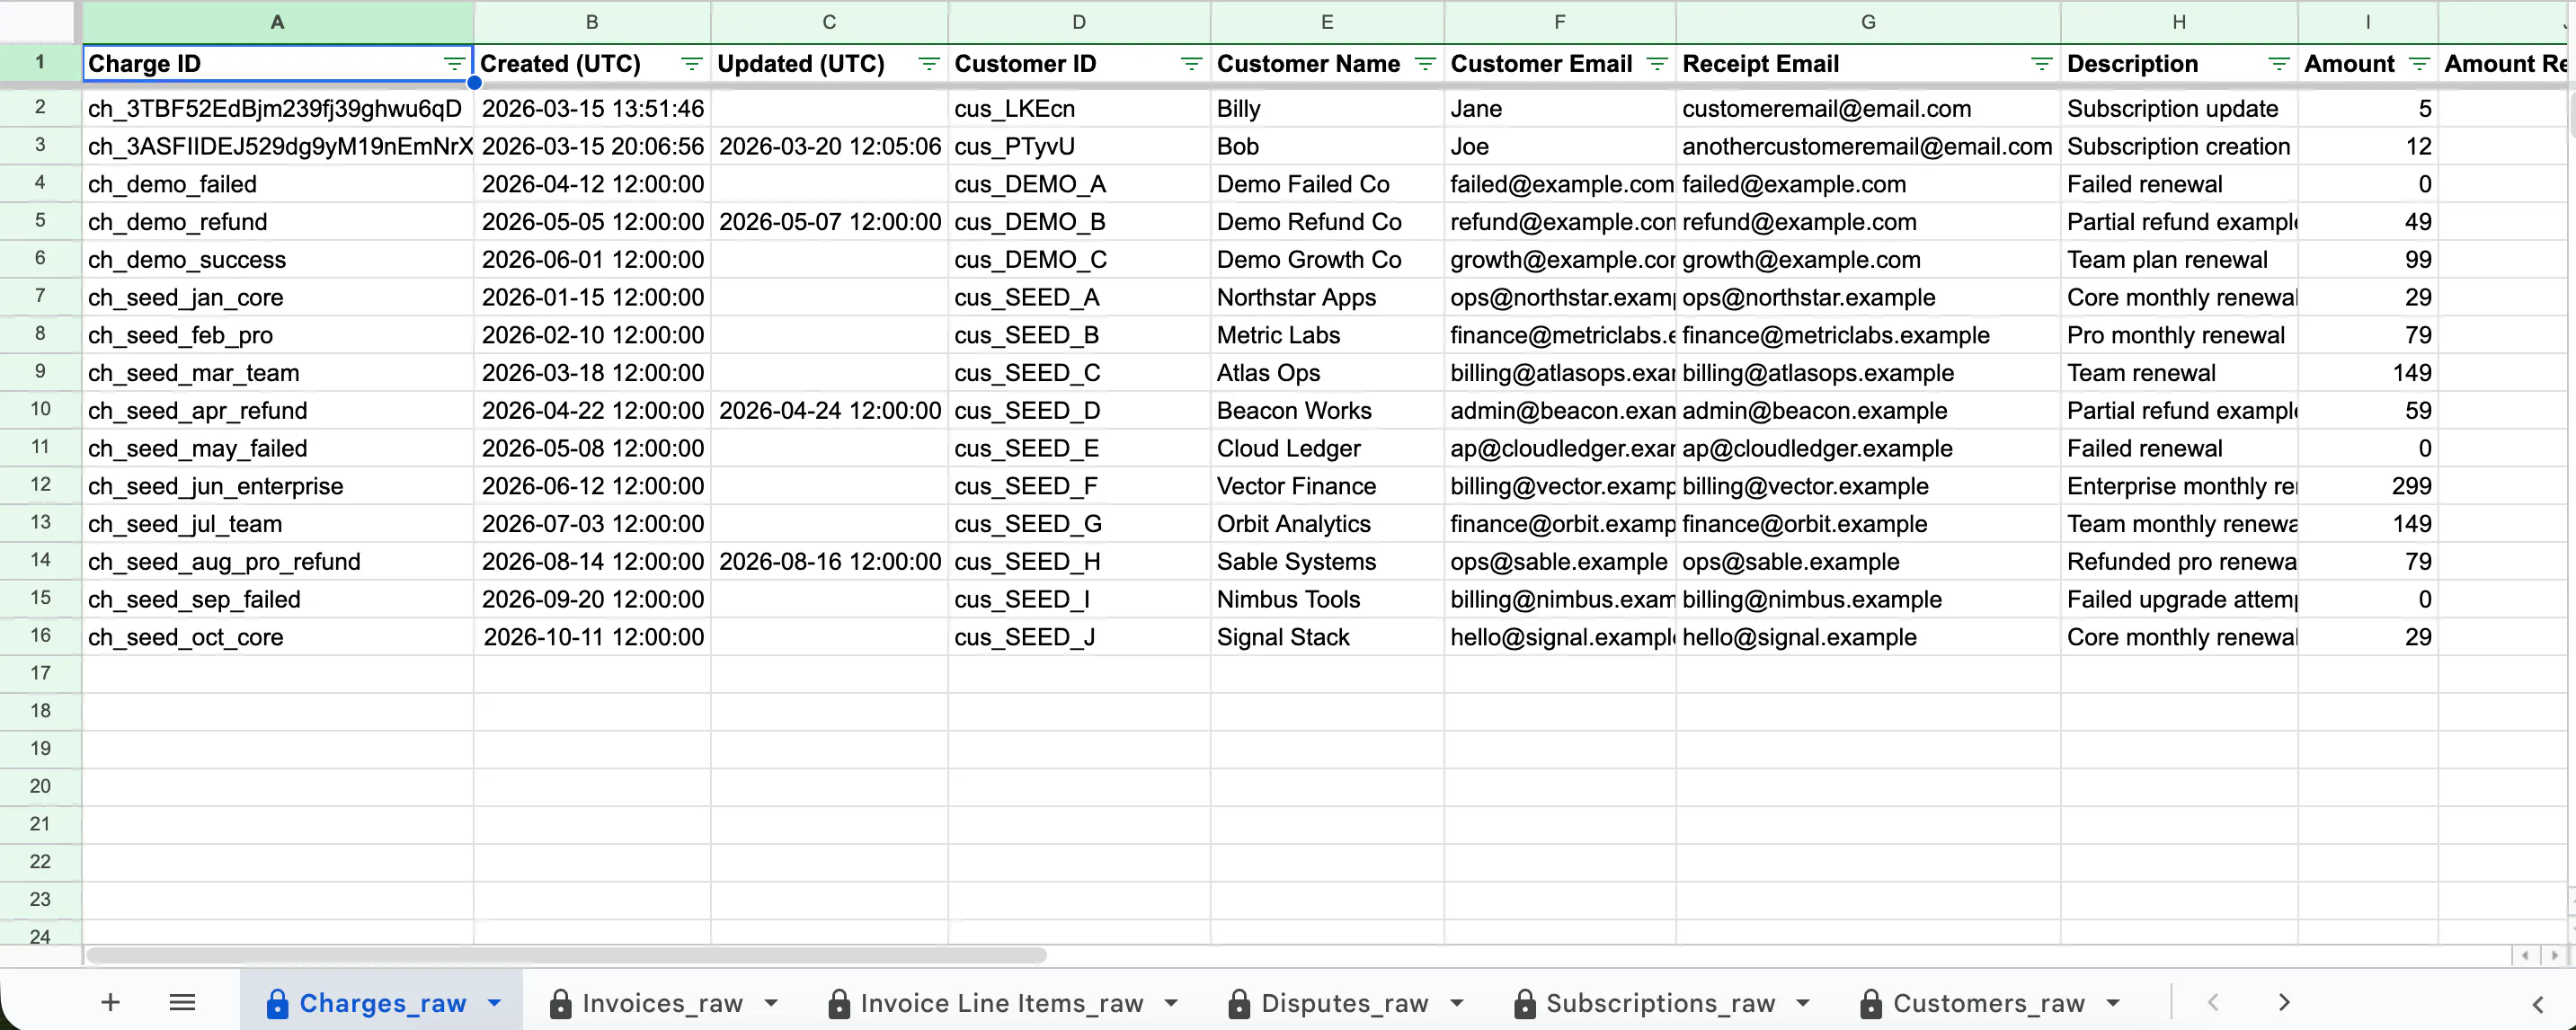
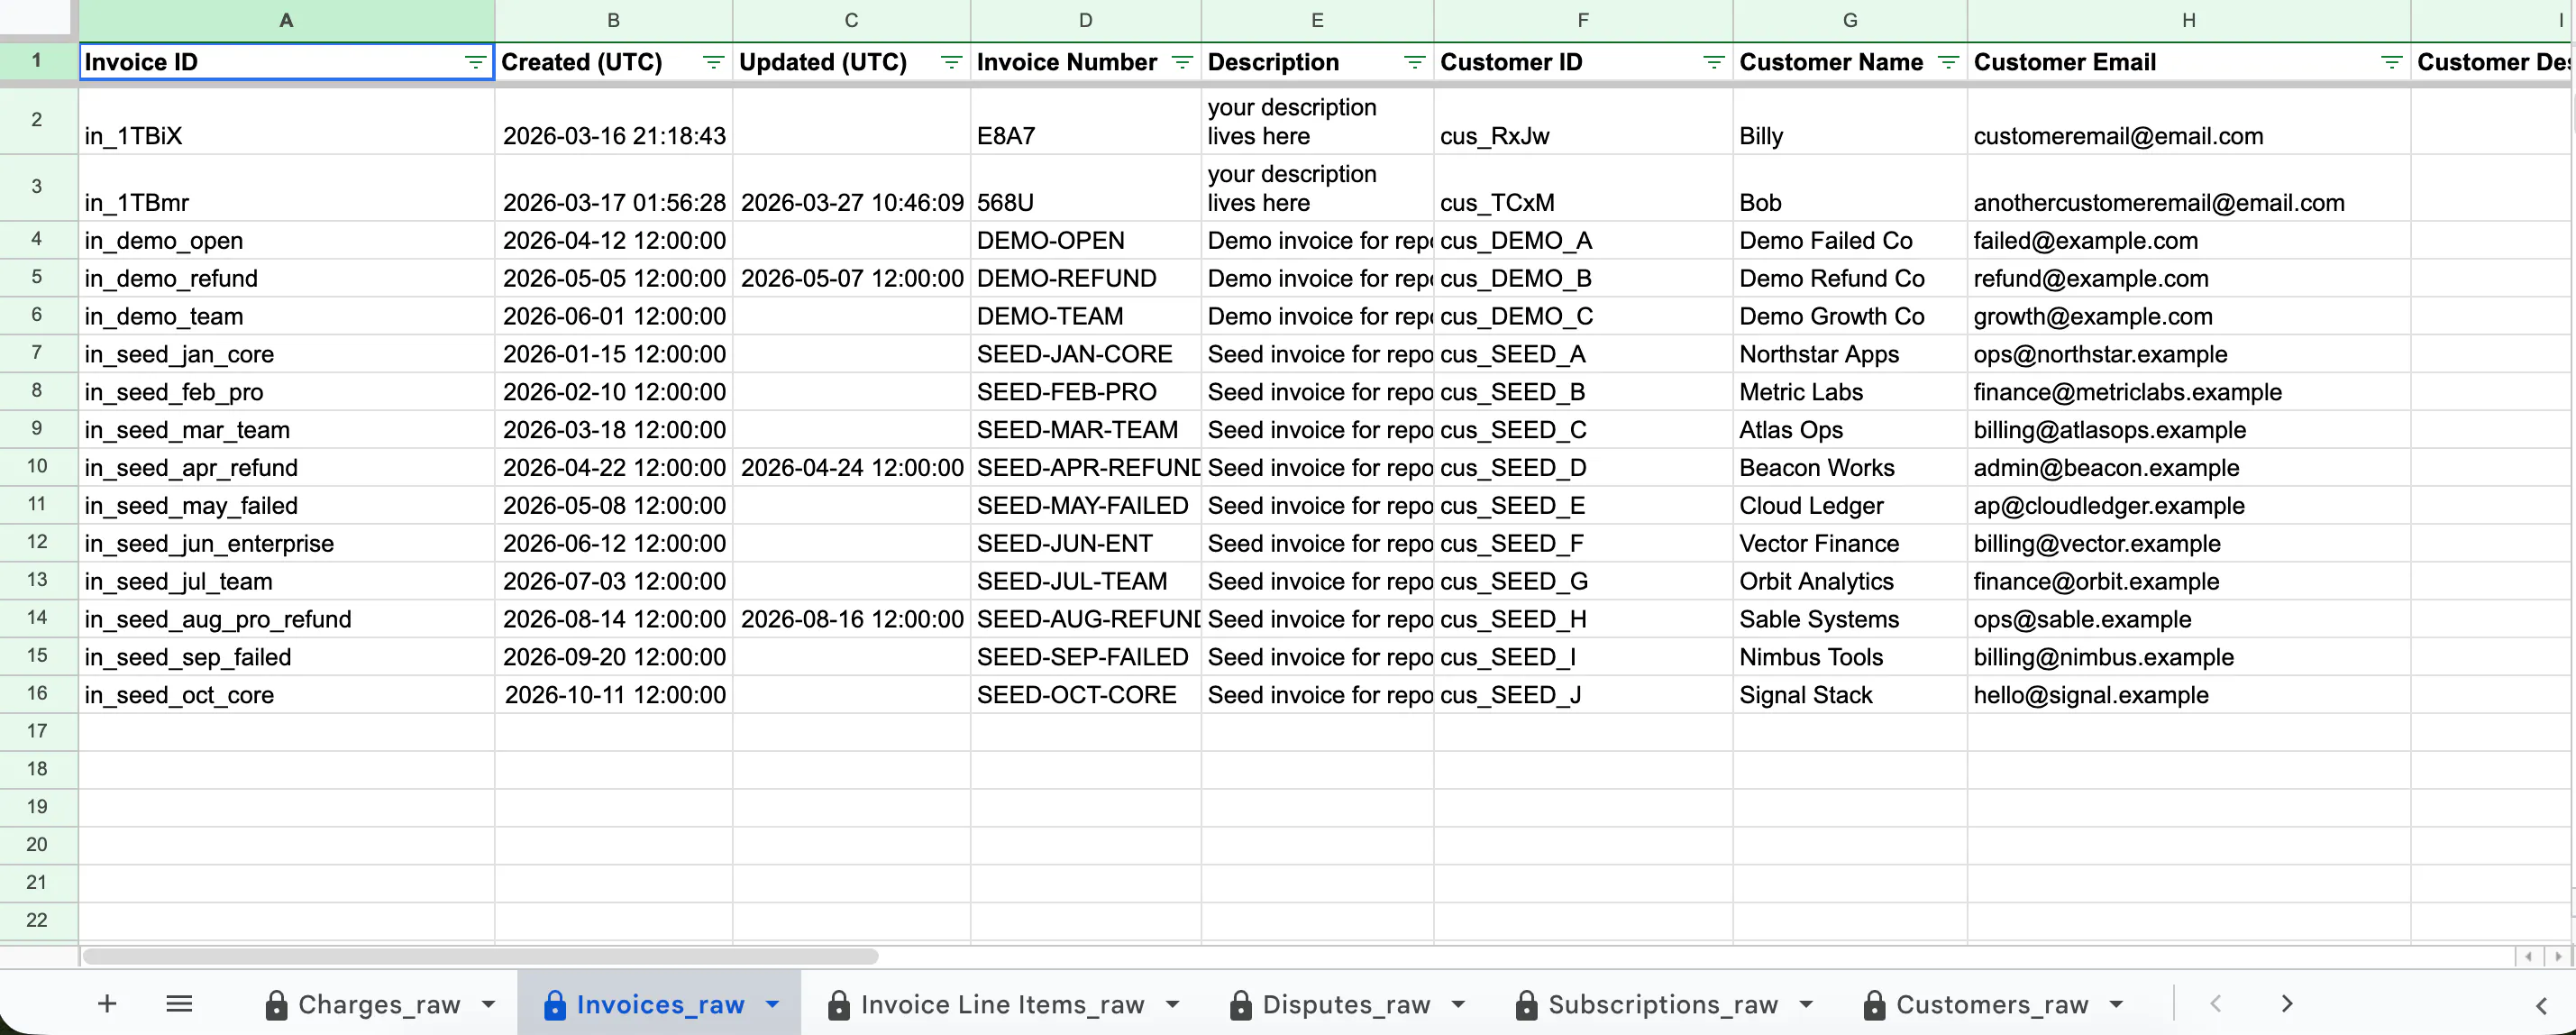
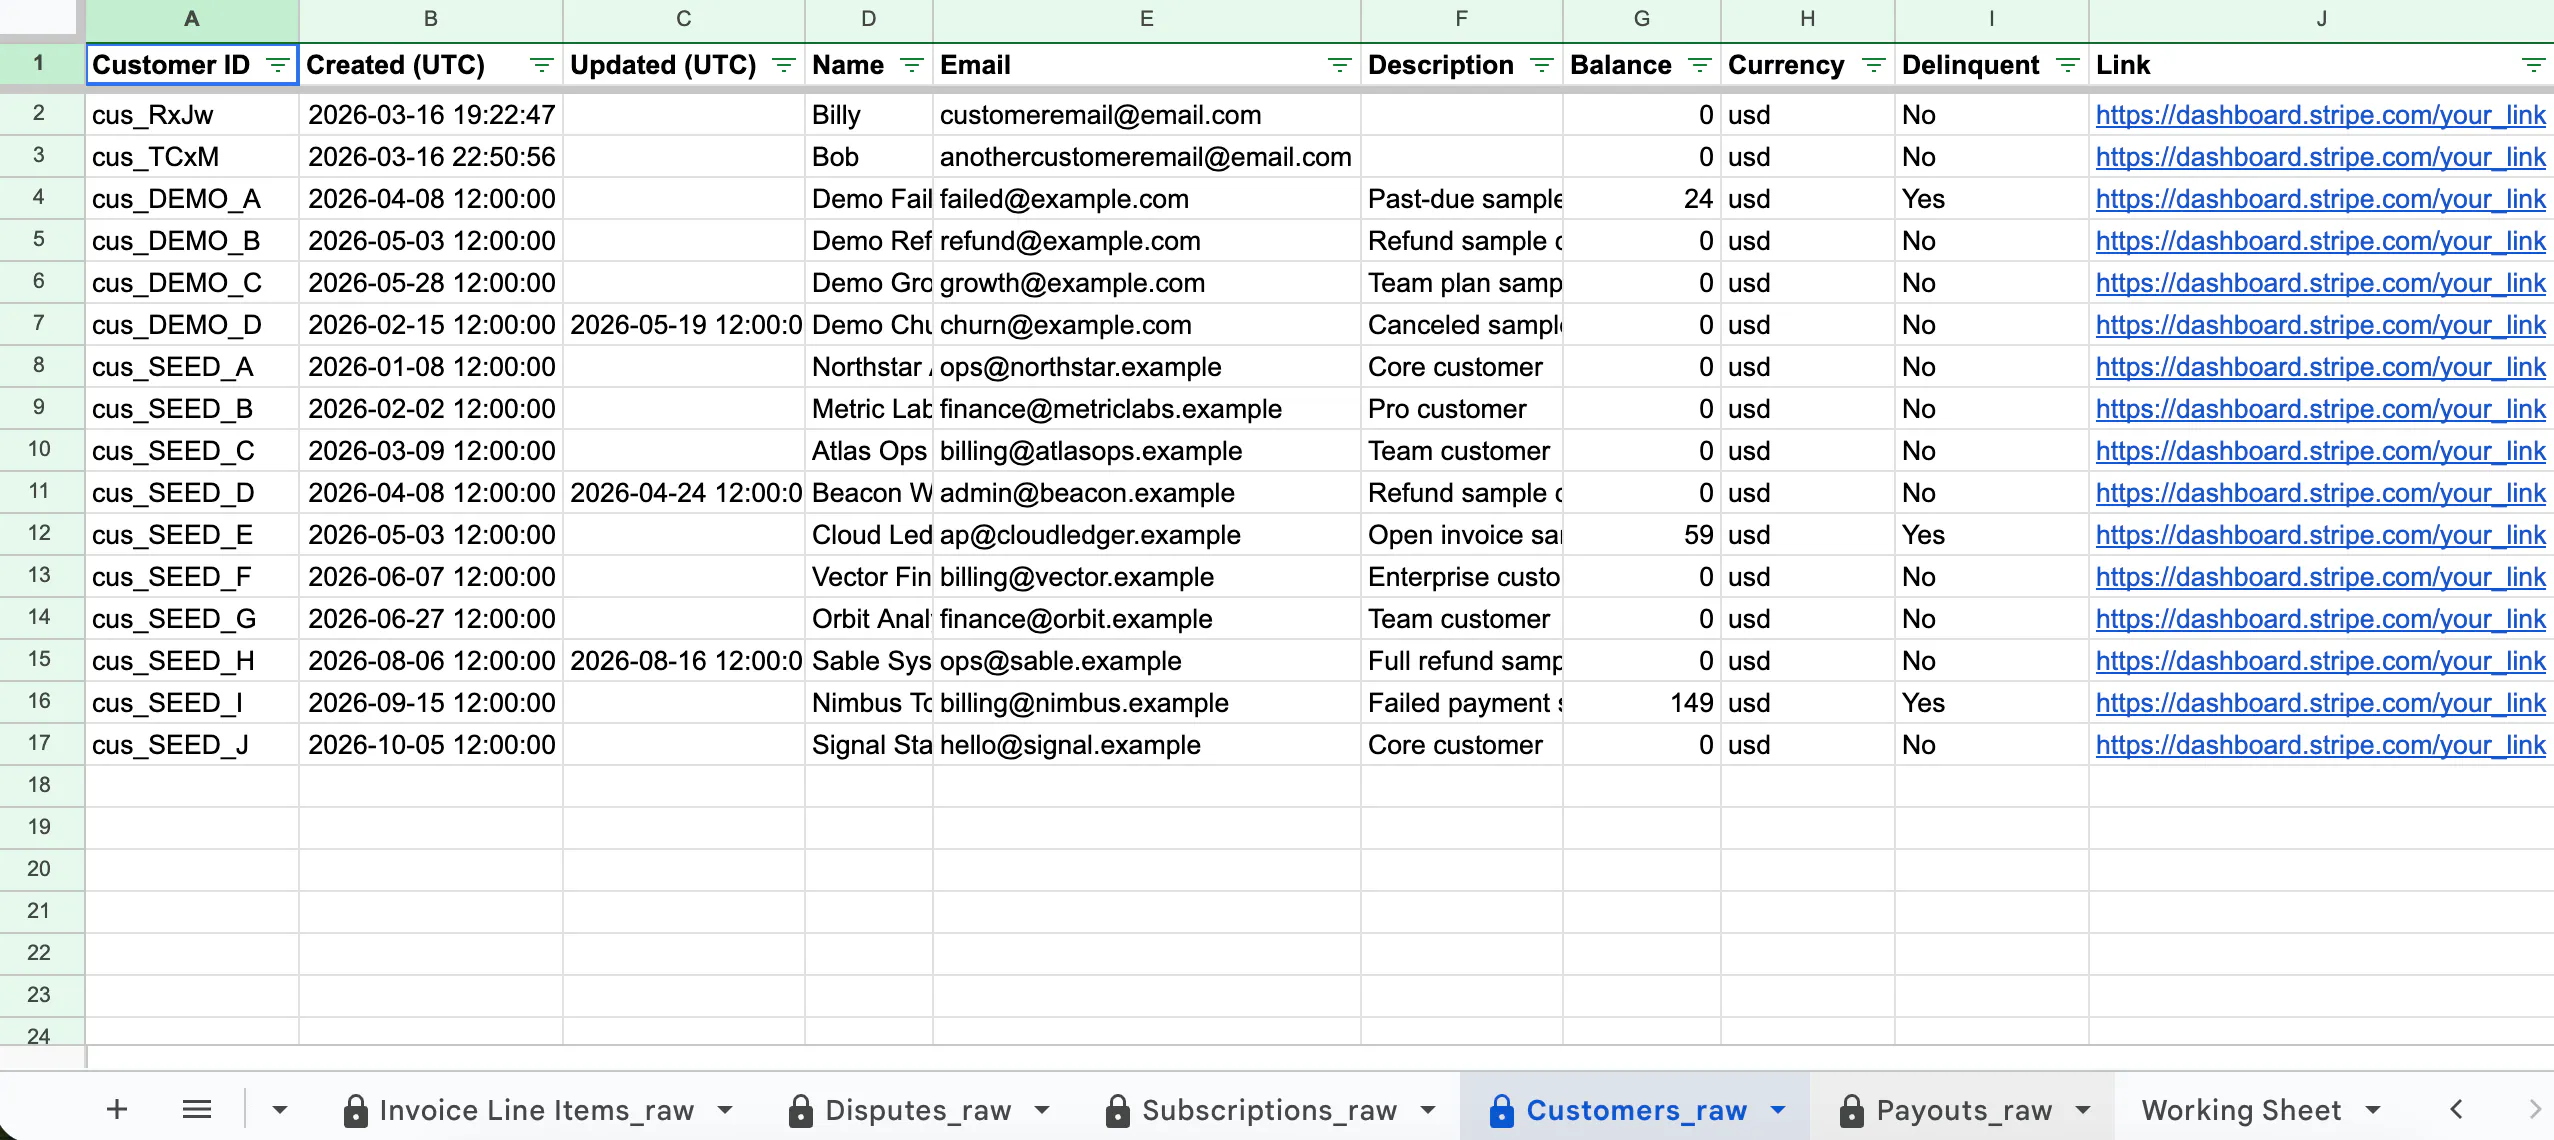
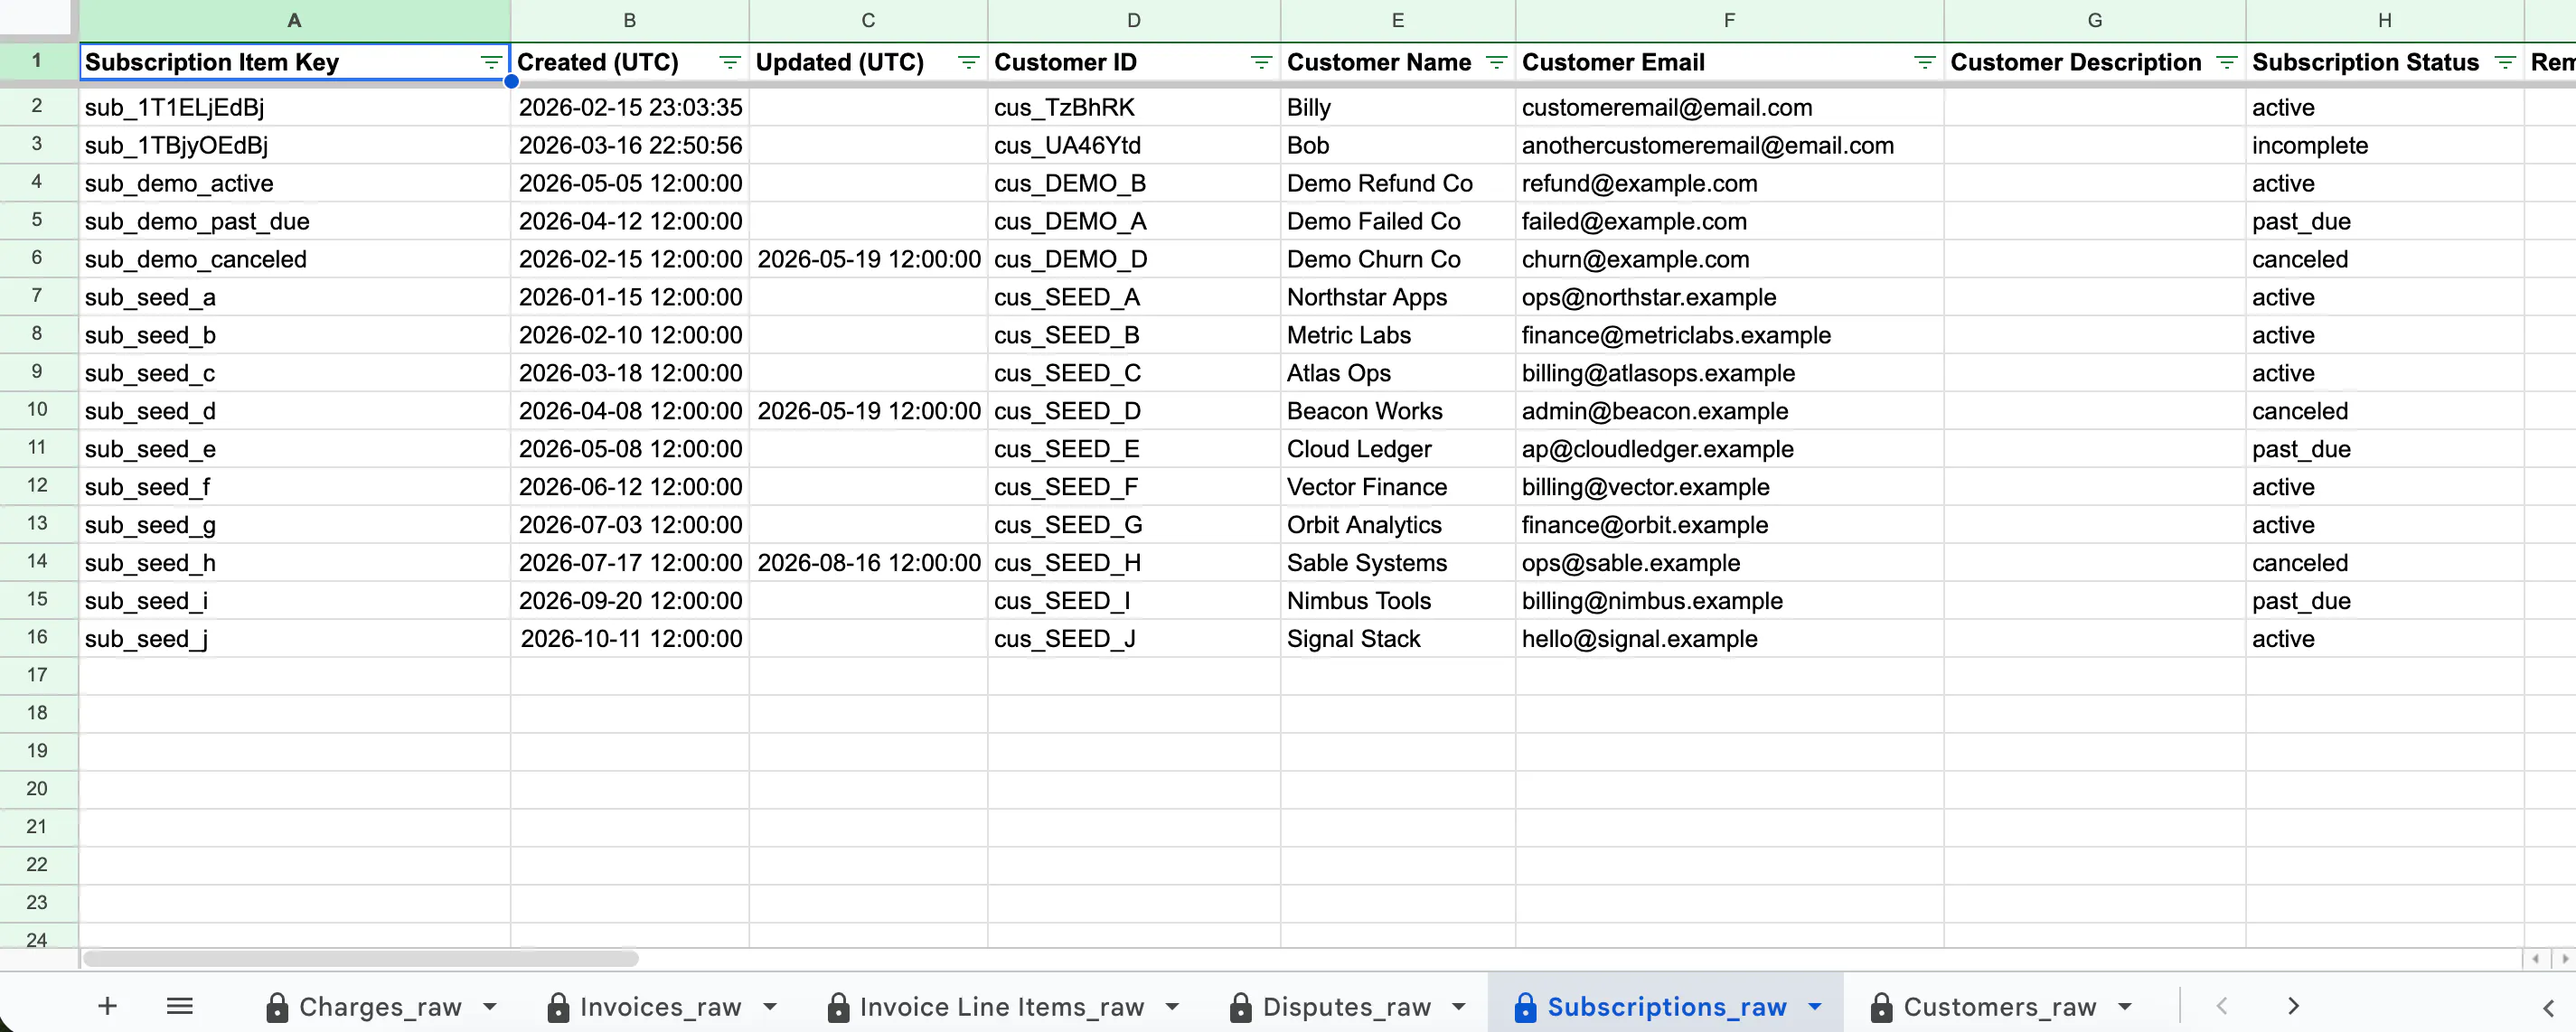
一句话介绍:SyncStaq是一款将Stripe账单数据(收款、发票、订阅、退款、争议等)按事件流实时同步至Google Sheets的自动化工具,解决财务团队手动导出、报表数据因退款/订阅变更而静默过期的问题。
Productivity
Fintech
Spreadsheets
Stripe数据同步
Google Sheets集成
财务自动化
账单数据管理
事件驱动同步
SaaS工具
佣金核算
报表实时更新
无代码集成
数据管道
用户评论摘要:用户普遍认可解决“历史数据变更导致报表失真”的痛点,主要疑问集中在:同步方式(事件流vs定时轮询)、历史行是就地更新还是追加修正(影响SUMIF公式)、Stripe只读密钥最小权限范围,以及是否支持Apple/Google IAP多平台收入合并。创始人回应坦诚,但未明确历史数据变更策略。
AI 锐评
SyncStaq的定位精准地切入了财务运营中一个“小而深”的裂缝:Stripe数据导出后,退款、争议、订阅状态变更会让所有基于历史快照的报表在不知不觉中腐烂。多数团队对这类问题的解决方案是每周手动重导,或依赖脚本按创建日期轮询——都治标不治本。SyncStaq从事件流同步,技术上直击要害,让“行数据随业务真相变化”成为默认行为,而非额外功能。
但产品价值边界同样清晰:它不做BI,不做多平台聚合,甚至刻意不做成“收入全景图”。评论中关于Apple/Google IAP的追问恰恰点出了它的阿喀琉斯之踵——对依赖多收入轨道的现代SaaS来说,Stripe-only的同步工具只是拼图一角,而非完整答案。创始人也坦承团队访谈中发现用户真正要的是佣金计算,这暗示了一个更大但更拥挤的市场,而SyncStaq目前选择不越界。
另一个不可忽视的隐患是“历史行变更”带来的财务审计问题:就地更新会静默改写已汇报给董事会的数字,追加修正则会破坏用户的SUMIF公式。产品目前对此保持沉默,这可能是商业客户在付费前最终会追问的合规性细节。
整体而言,SyncStaq是一个工程上扎实、商业上克制的效率工具。它不性感,但有真实付费意愿的场景,且显著降低了财务团队的隐性加班成本。挑战在于:它能靠99票的发布热度维持增长,还是最终沦为Stripe生态里又一个被Inch或Ragic等通用工具吞并的垂直插件?答案取决于它能否在佣金/分账场景中持续加码,从“同步工具”进化为“结算工作台”。
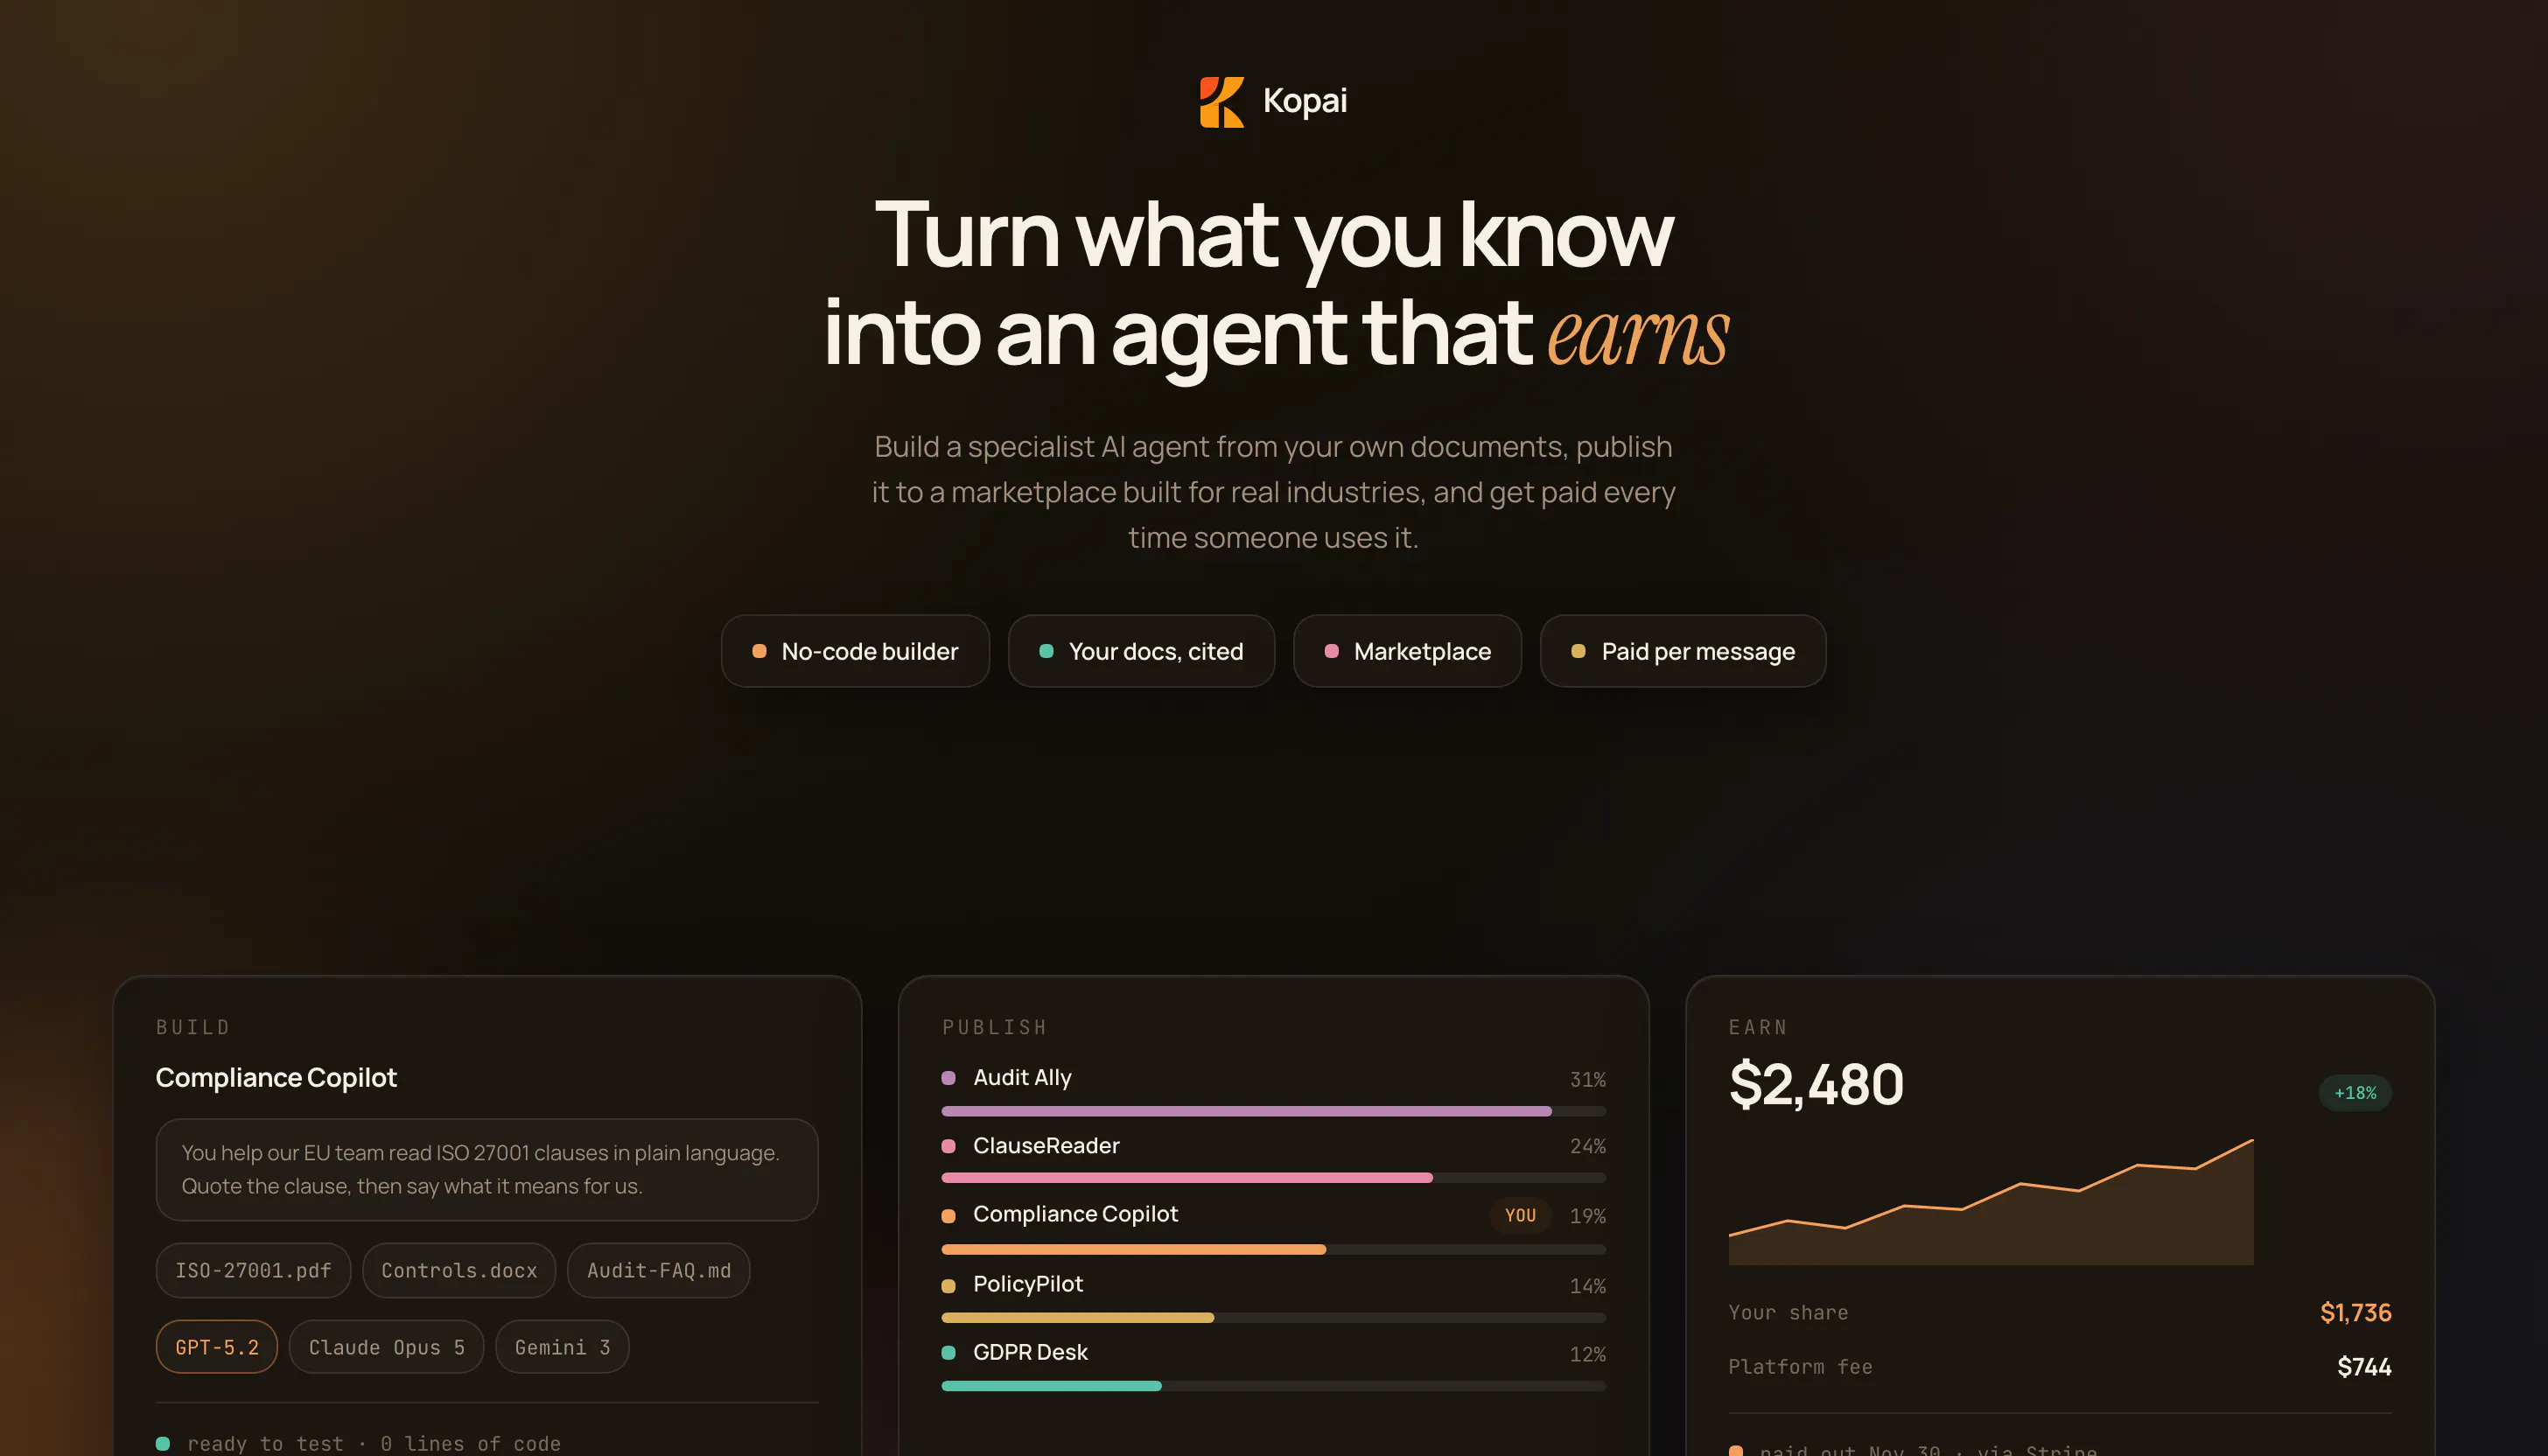
一句话介绍:Kopai是一个无代码AI智能体创作与交易平台,让专家将自身知识封装为按条收费的AI分身,在解决“专家时间有限、知识无法规模化变现”痛点的同时,通过托管发现、计费和评估等基础设施,让知识像商品一样在市场中流通。
SaaS
AI智能体
知识变现
无代码平台
按条计费
专家系统
创作者经济
智能体评估
知识库
市场平台
支付基础设施
用户评论摘要:有效评论聚焦于两个核心问题:一是知识过期与责任归属——当专家脱离循环后,如何防止过时答案持续售卖并明确出错责任(目前专家担责,仅靠事后反馈);二是智能体在长对话中的漂移控制与上下文记忆(30条消息窗口及长期记忆层已解决)。此外,有评论认可按条计费模式,并询问市场推广机制。创始人对评估门槛(发布前评测)及自动下架路线图做了补充说明。
AI 锐评
Kopai切入的“知识变现”赛道并不新鲜,但其“按条计费”的定价模式和对“交付质量”的基础设施化尝试,是区别于普通Prompt包装器的关键。从产品形态看,它本质上是一个“AI知识经纪人”市场,用技术手段把咨询师的边际成本压至接近零,这一逻辑是通的。
但必须泼一盆冷水:评论中暴露出的“知识衰减”与“责任归属”问题,是悬在其商业模式头上的达摩克利斯之剑。创始人对“专家全权负责”的回应,虽然坦诚,却在商业上是脆弱的——买家为“权威答案”付费,一旦出现重大错误,品牌信誉的崩塌会直接反噬平台。其承诺的“置信度评分+自动下架”机制虽在路线图上,但仅靠内部评估无法完全解决外部世界变化的滞后性。
更深层的挑战在于网络效应:Kopai声称处理发现、计费和信任,但这三者都是重运营的苦活。对于87票的冷启动产品而言,市场两端的冷启动(吸引高质量专家入驻 + 吸引足够买家付费提问)将极其艰难。若没有比“被动SEO优化”更主动的需求匹配机制,平台很容易沦为“知识摆摊”的集散地——货品杂乱,流量稀缺。不过,团队对Eval Gate的坚持和明确的基础设施定位,是值得肯定的务实起点。真正的考验在于:当一笔付费问答给出错误答案时,平台是否敢于在“专家免责”条款之外,承担起作为信息守门人的最终责任。这决定了Kopai是做成一门生意,还是一个生态。
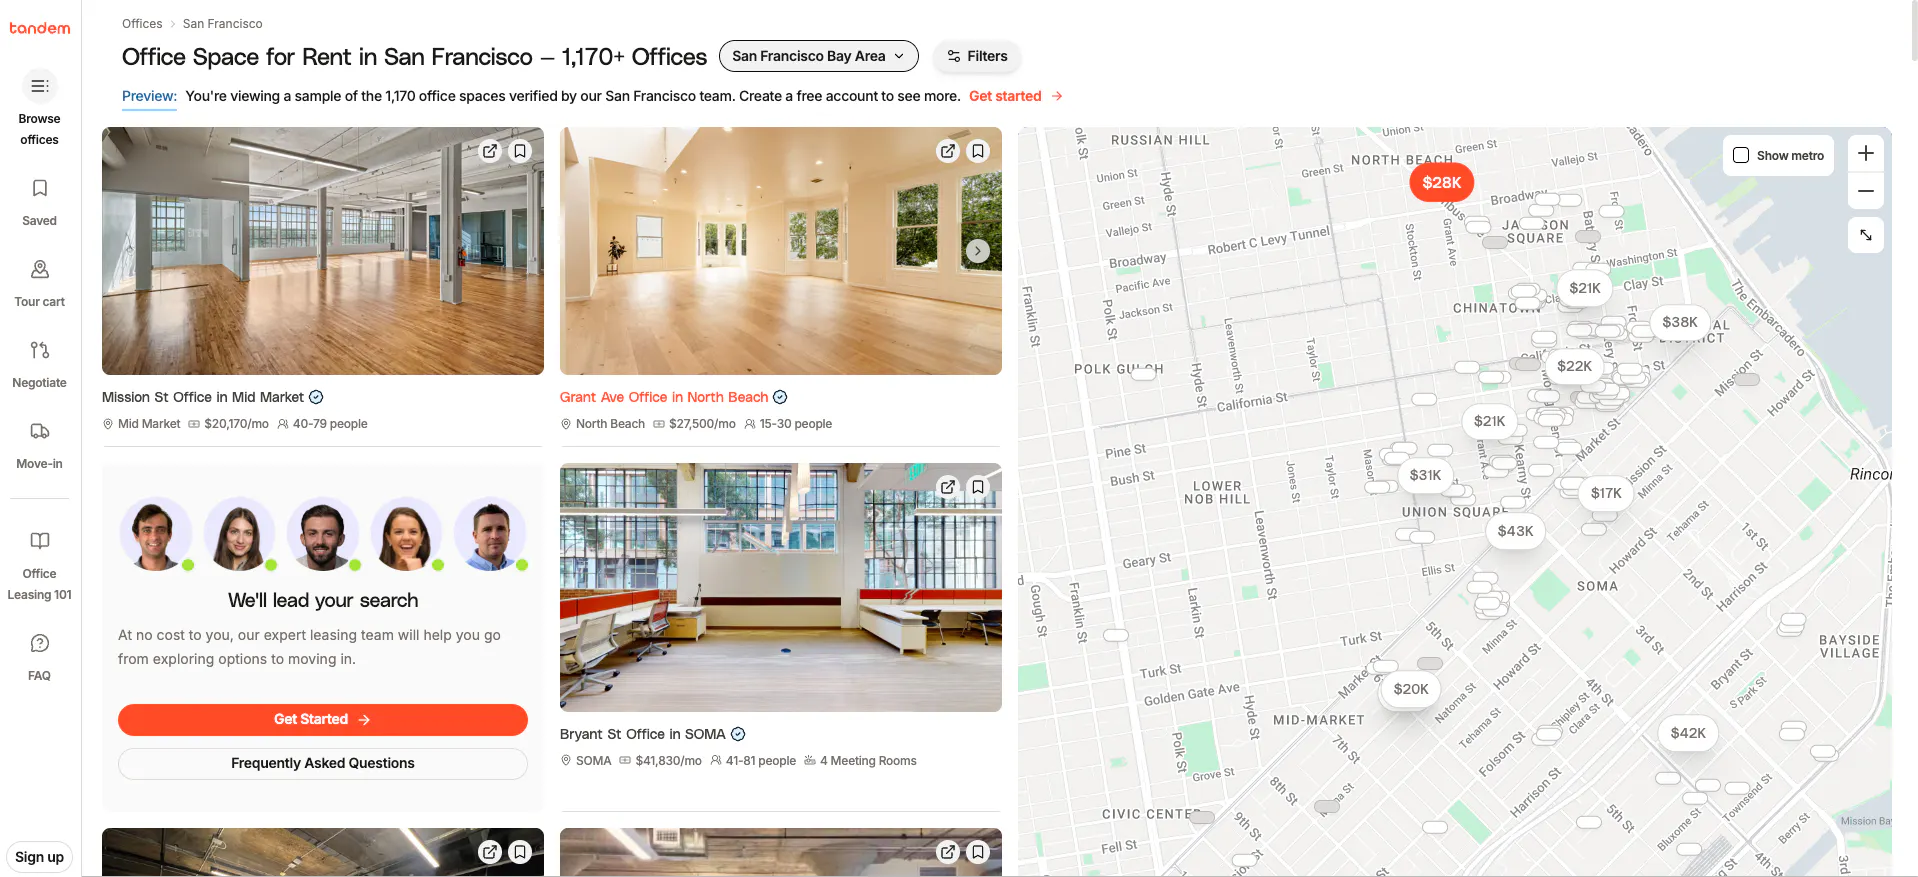
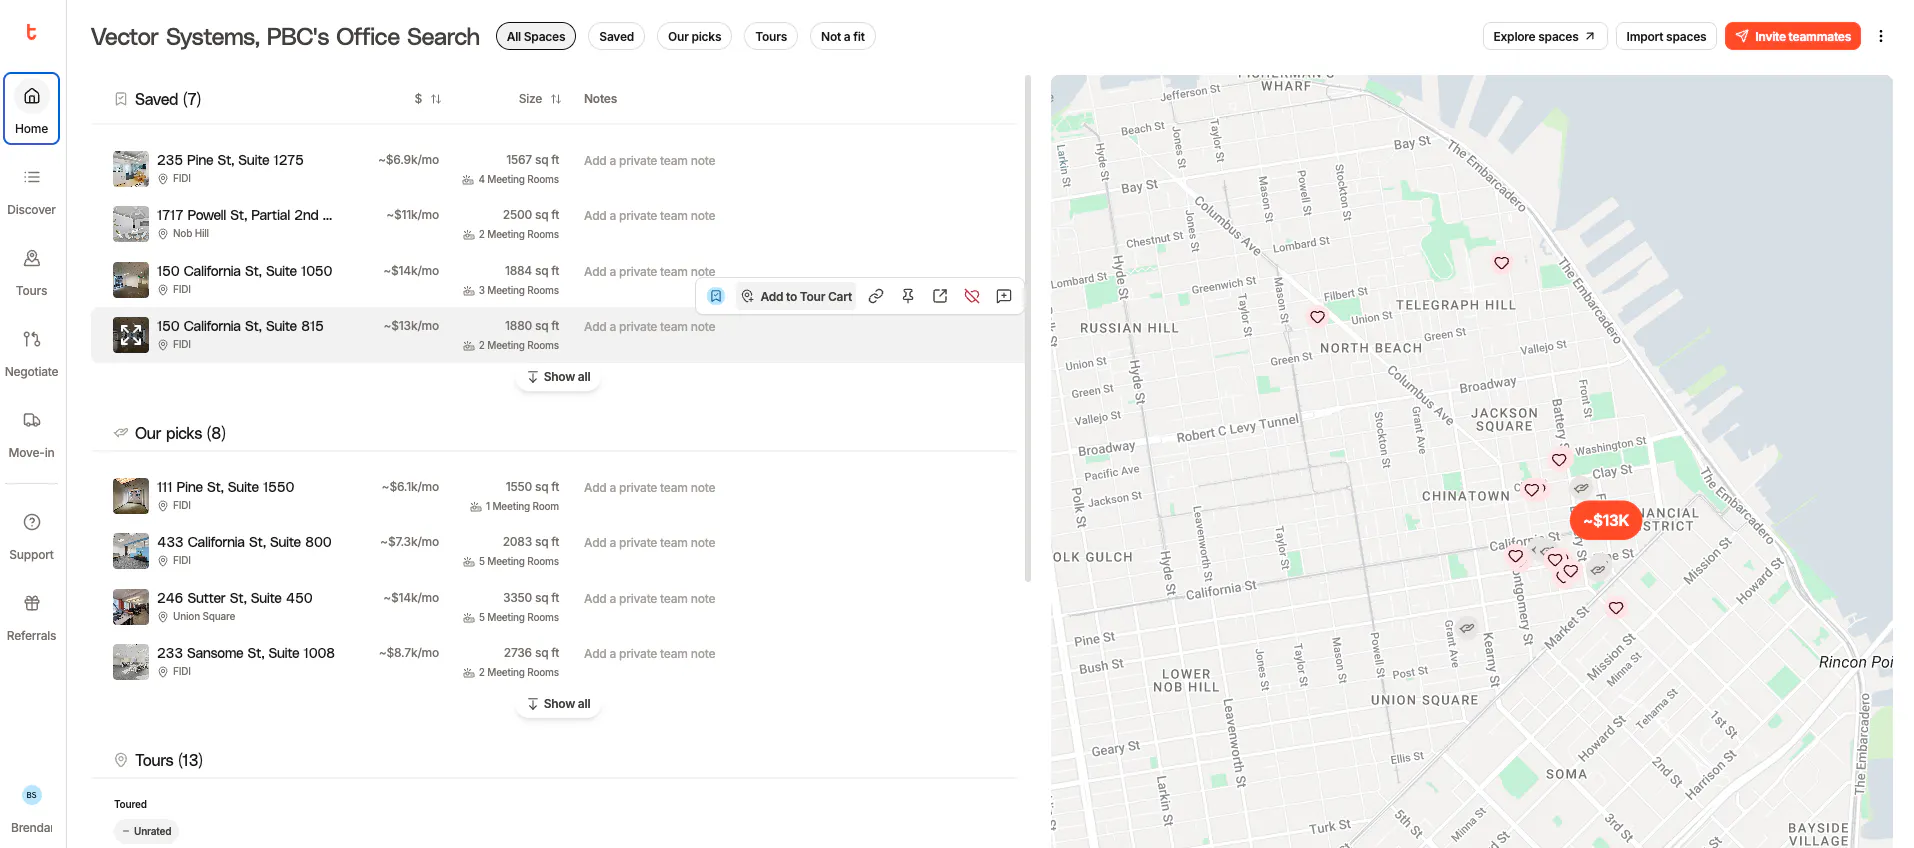
一句话介绍:Tandem 是一款AI原生的办公楼租赁经纪服务,通过AI代理实时监控全市场房源与成交数据,帮助租户(尤其是中小企业)大幅提升找房效率和谈判透明度,且对租户完全免费。
Tech
AI房产经纪
办公楼租赁
商业地产
智能找房
租户代理
市场数据洞察
谈判支持
中小企业服务
佣金模式革新
SaaS+服务
用户评论摘要:用户核心质疑在于佣金模式:传统经纪按租金比例收费,与租户利益冲突,AI是否只是用“客观感”掩盖了同样的利益诱导?用户希望明确Tandem是否只做租户代理,以及如何确保推荐不偏向让租户“略微多付”的方案。
AI 锐评
Tandem的叙事很性感——“AI大脑+人工经纪”看似解决了商业地产最核心的信息不对称问题。它确实命中了行业痛点:中小租户被忽视,市场碎片化,流程冗长低效。用数据覆盖代替人情网络,用快响应对抗慢周转,这是技术上成立的降维打击。
但评论区的质疑恰恰戳中了它的命门:**激励结构没有变,AI只是把利益冲突装进了黑箱。** 传统经纪人拿房东佣金,他的建议你可以打折听,因为你知道他有立场。而Tandem的AI“客观地”推荐房源时,如果背后依然是同一套房东佣金逻辑,那么它所谓的“你该花多少钱”的判断,本质上是一个被训练得更加圆滑、更不容易被识破的销售话术。一个“看过全城”的AI和一个人脉广的老经纪人,在利益驱动下,行为不会有本质区别——区别只是前者更高效地让你信服。
更深层的问题在于:AI能告诉你“市场价是多少”,但无法告诉你“这个房东是否会在两年后耍赖不续租”,也无法替你感知谈判桌上对方的微表情与情绪张力。它的“27天签约”优势,建立在标准化、数据透明的房源匹配上,但商业地产的最后一公里(法务、人情、复杂条款)依然高度依赖人类经验。Tandem的真正价值不在于“取代”经纪,而在于把这种经验的可复制性做了一次边际成本极低的放大——这在商业上可行,但若想建立长期信任,必须回答那个尖锐的问题:**当你的AI和我的利益冲突时,它听谁的?** 目前,它给出的答案依然是模糊的。如果只做租户纯代理(收固定服务费或由租户付费),这个模型会更干净,但也会立刻丧失扩张速度。这本质上是一场关于“信任透明度”和“商业效率”的博弈,而Tandem目前,似乎在优先选择后者。
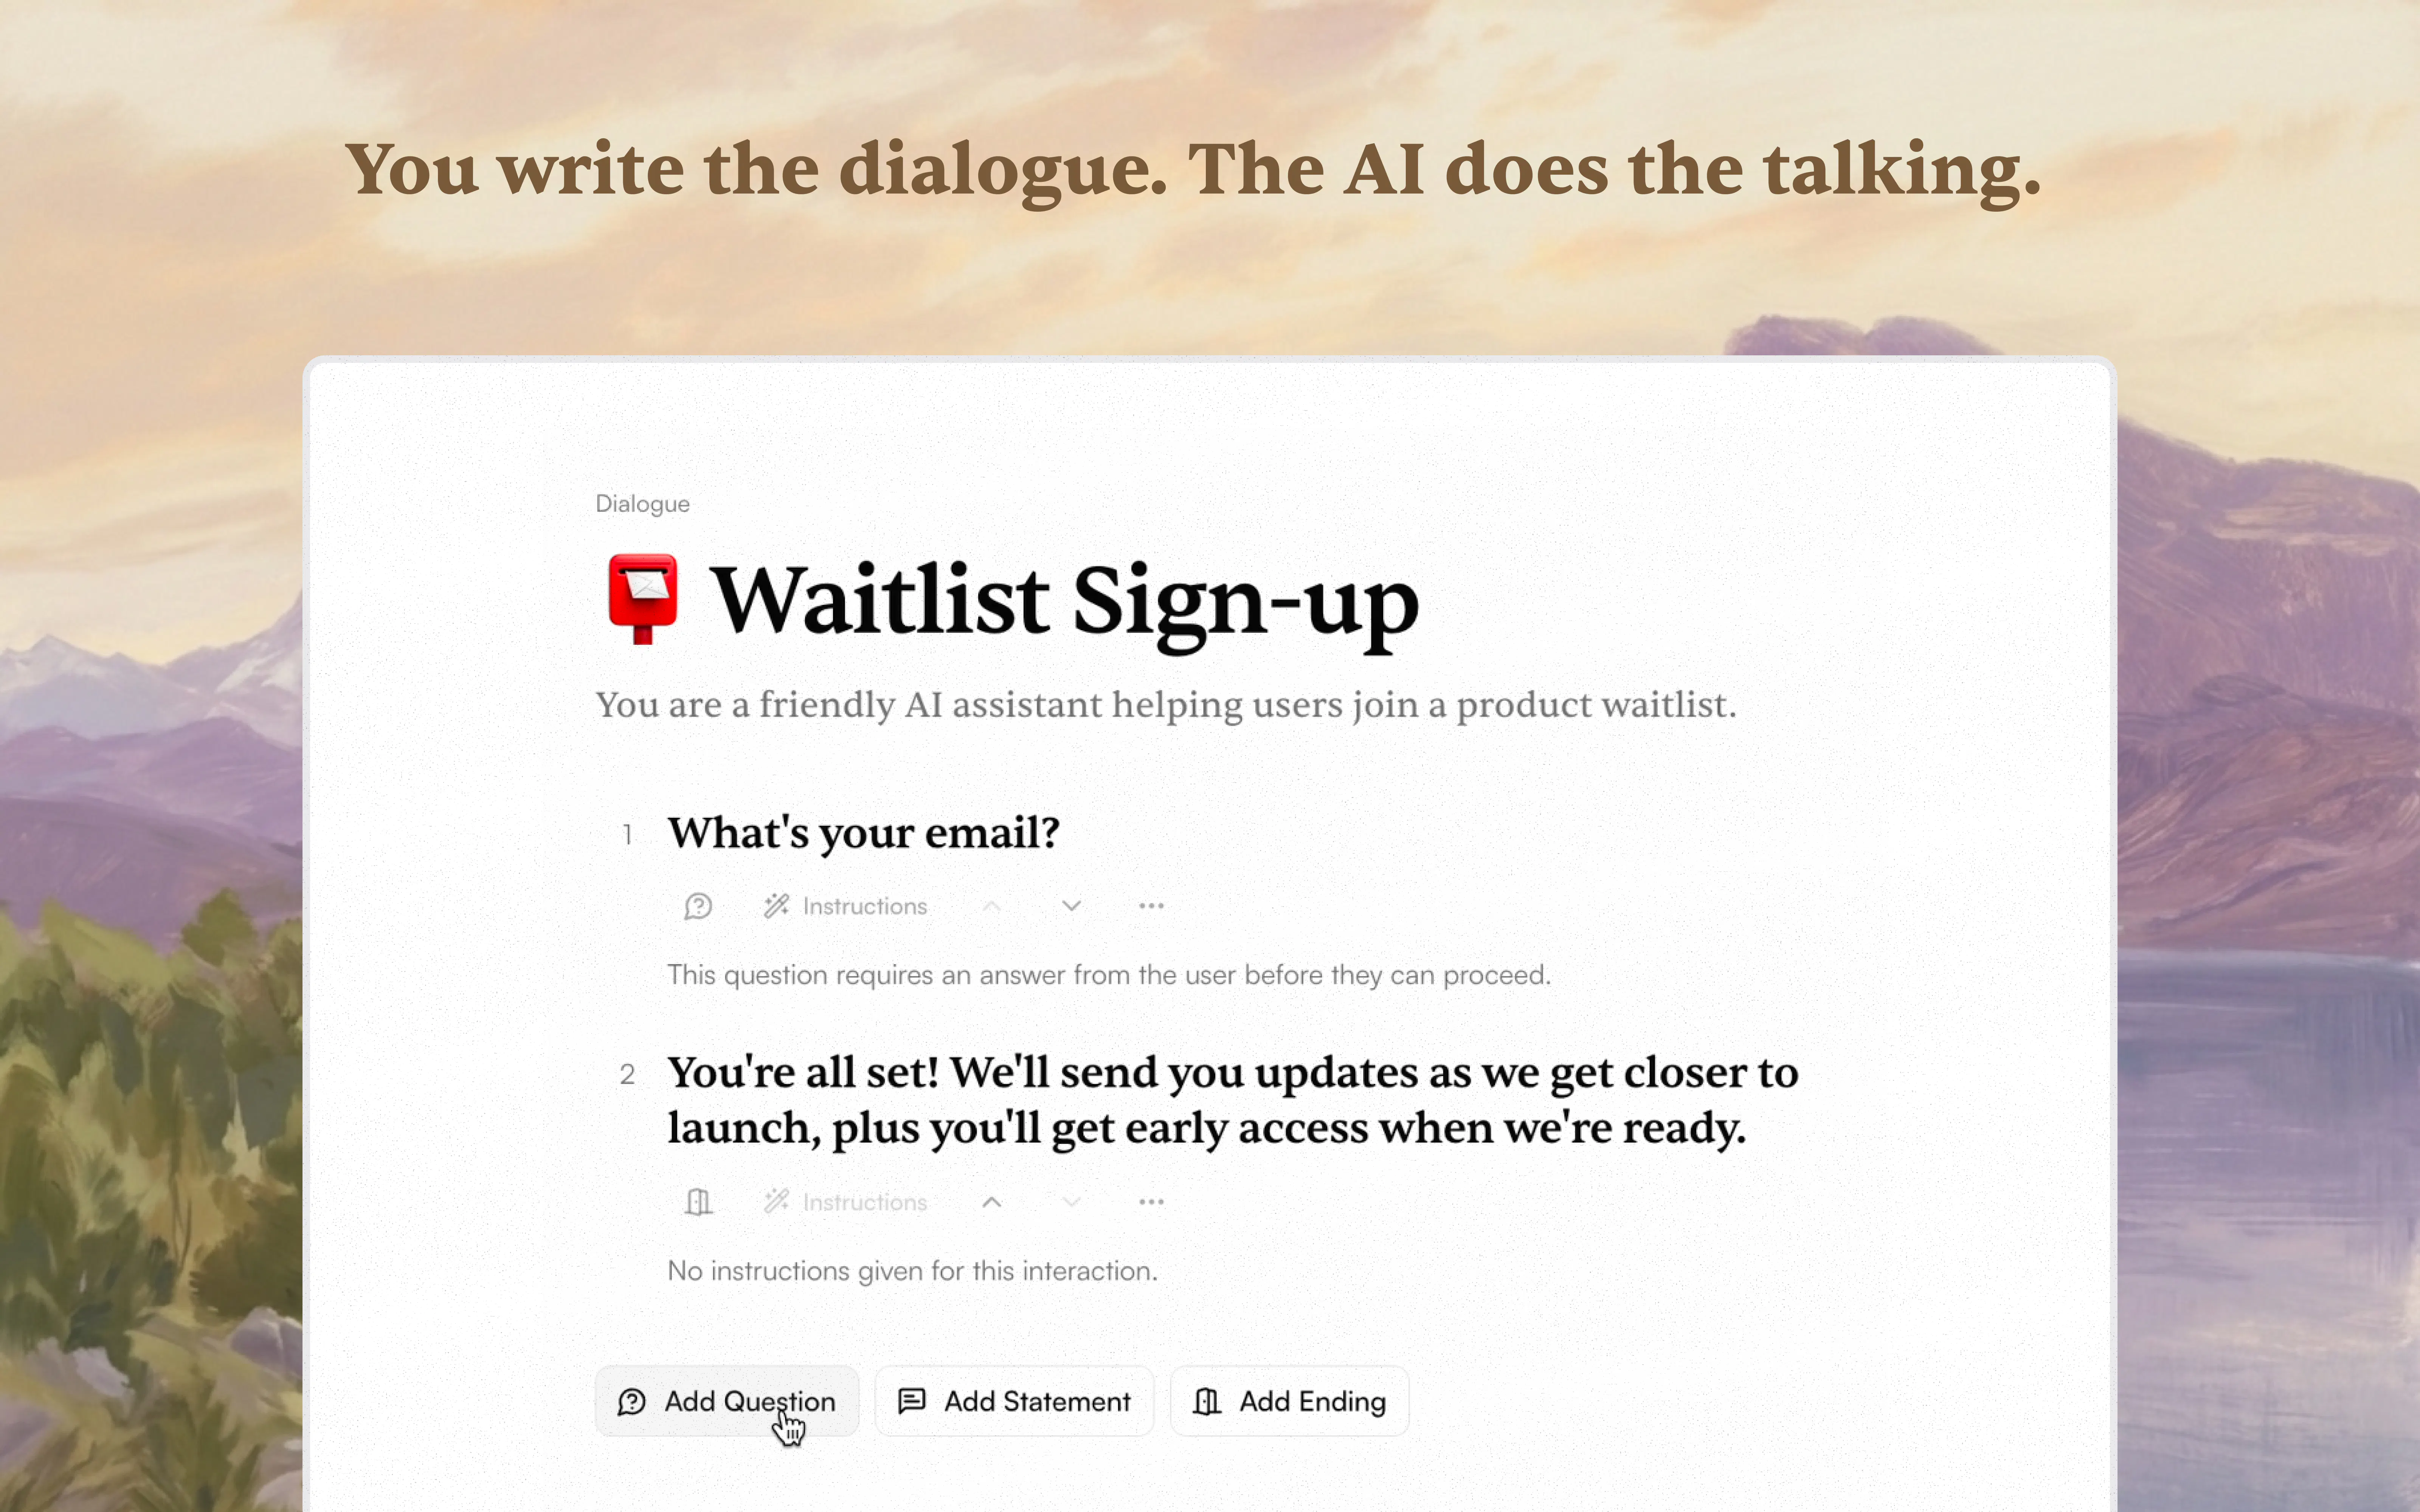
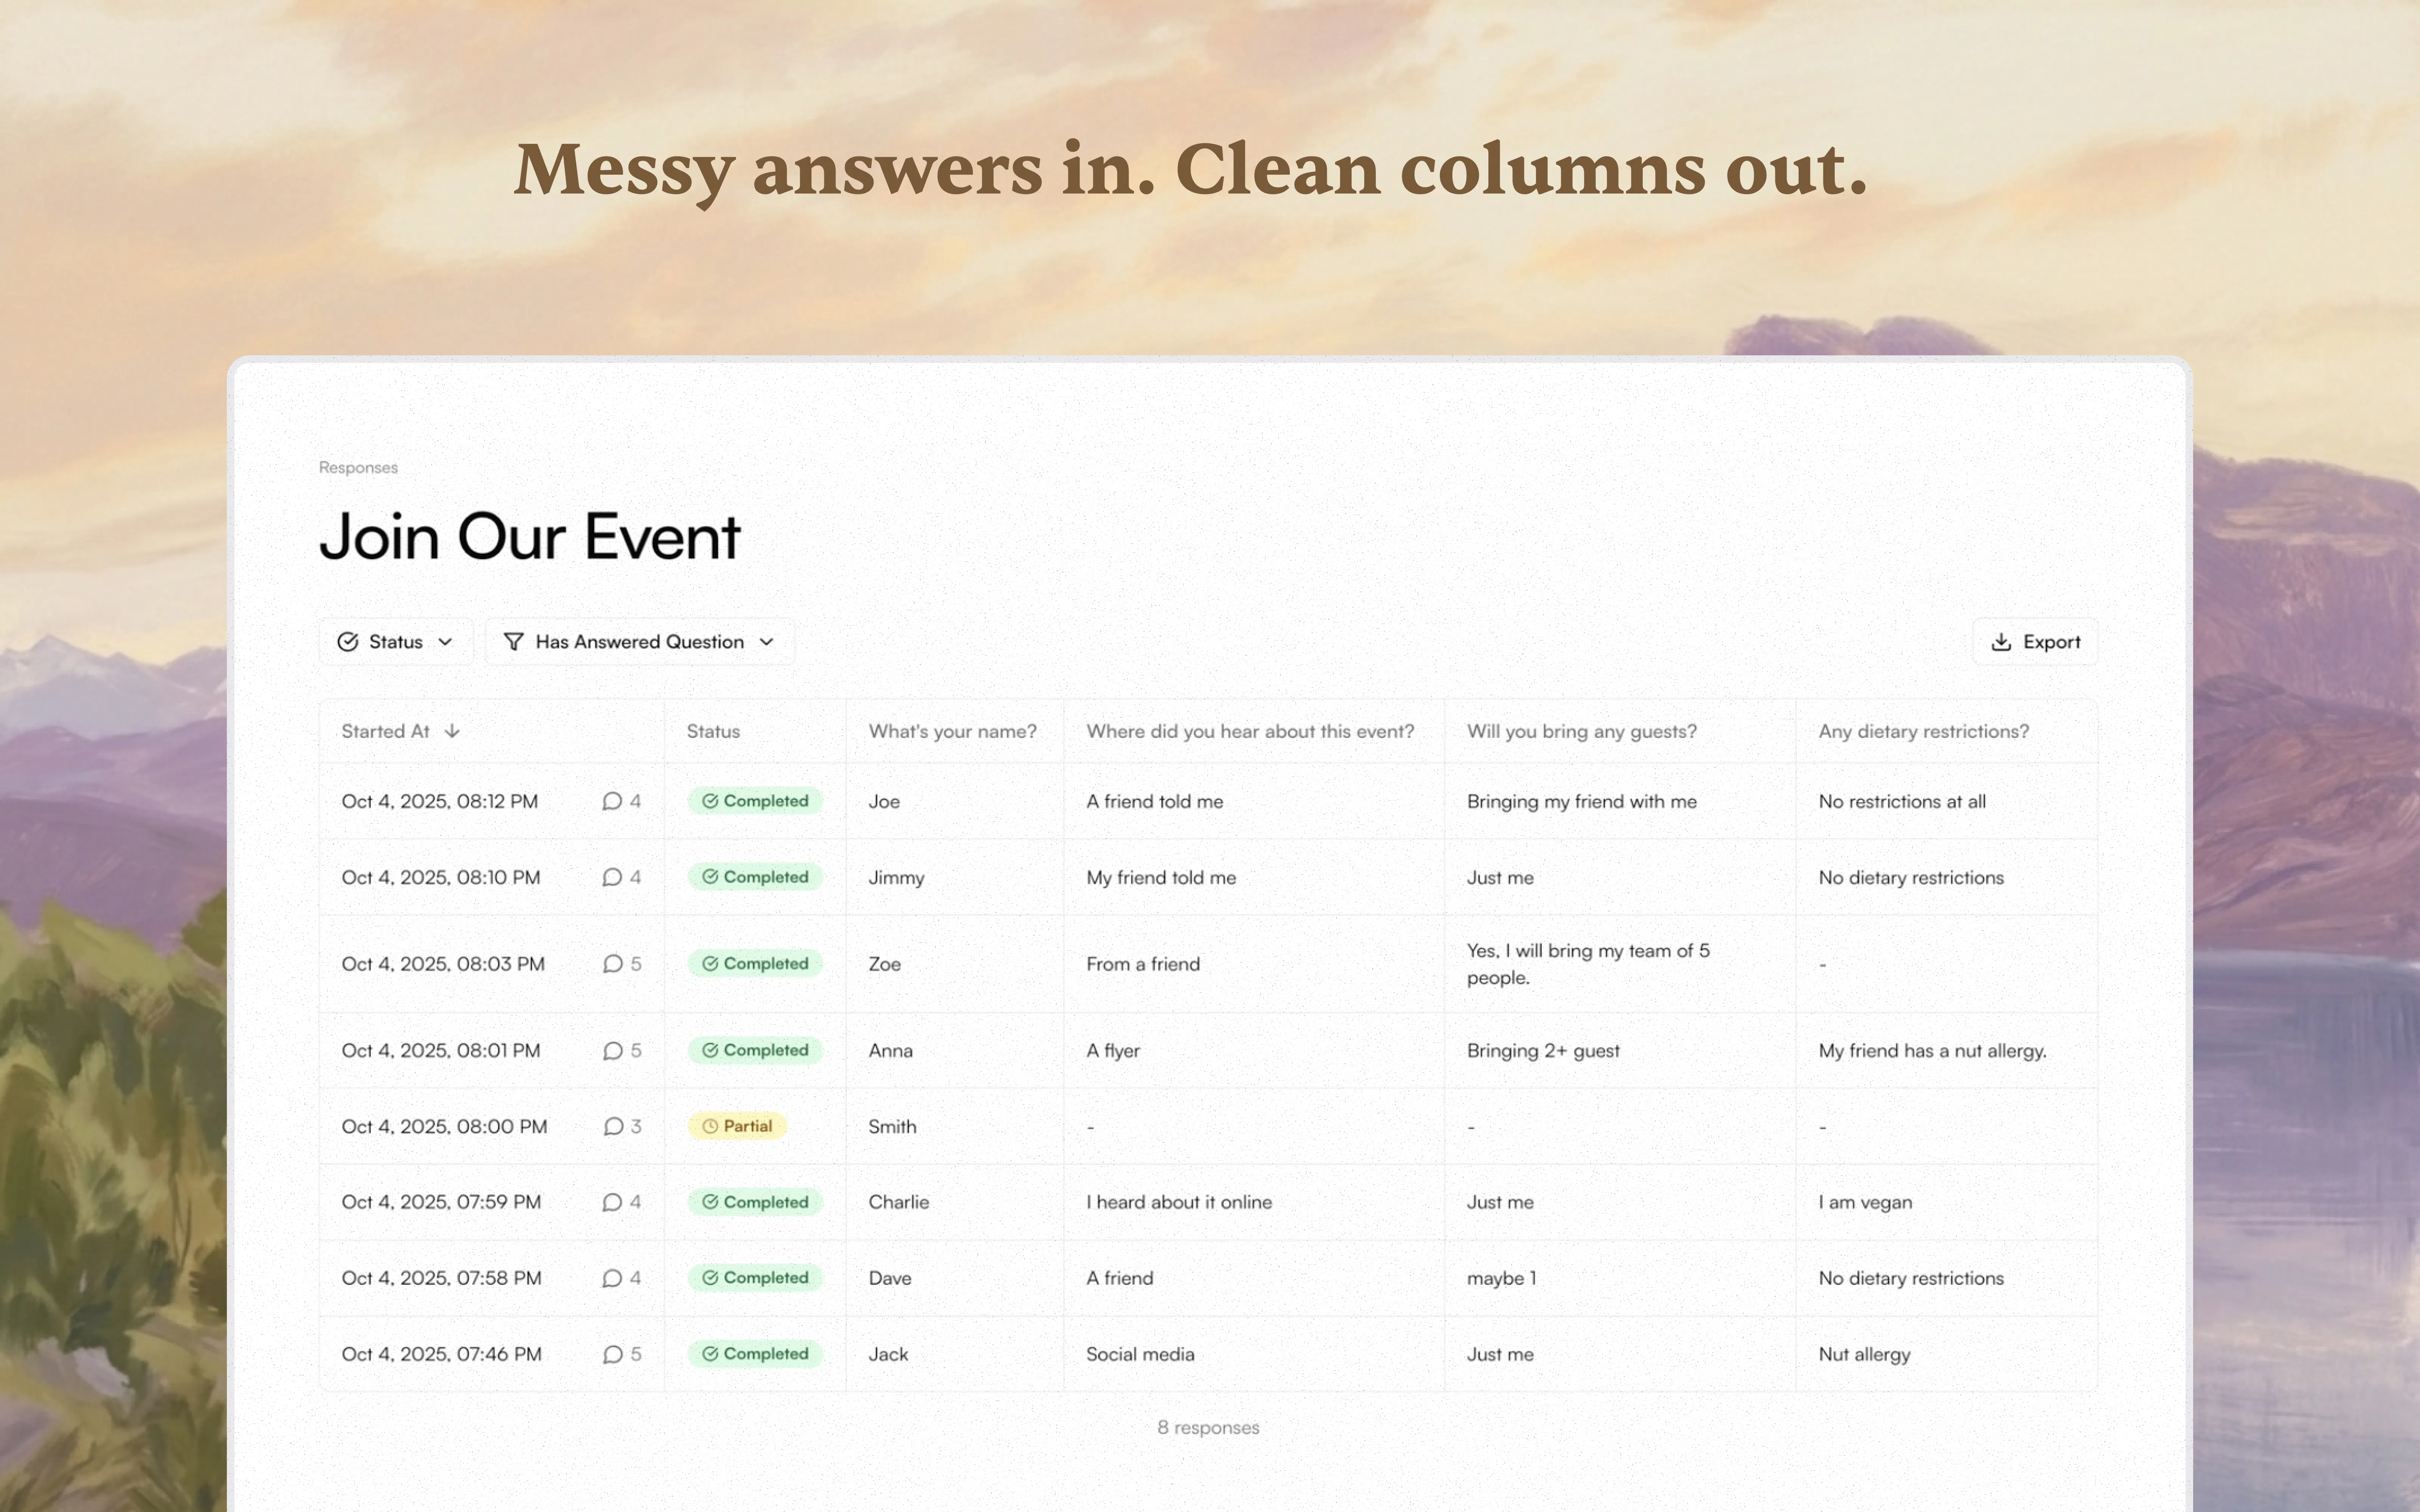
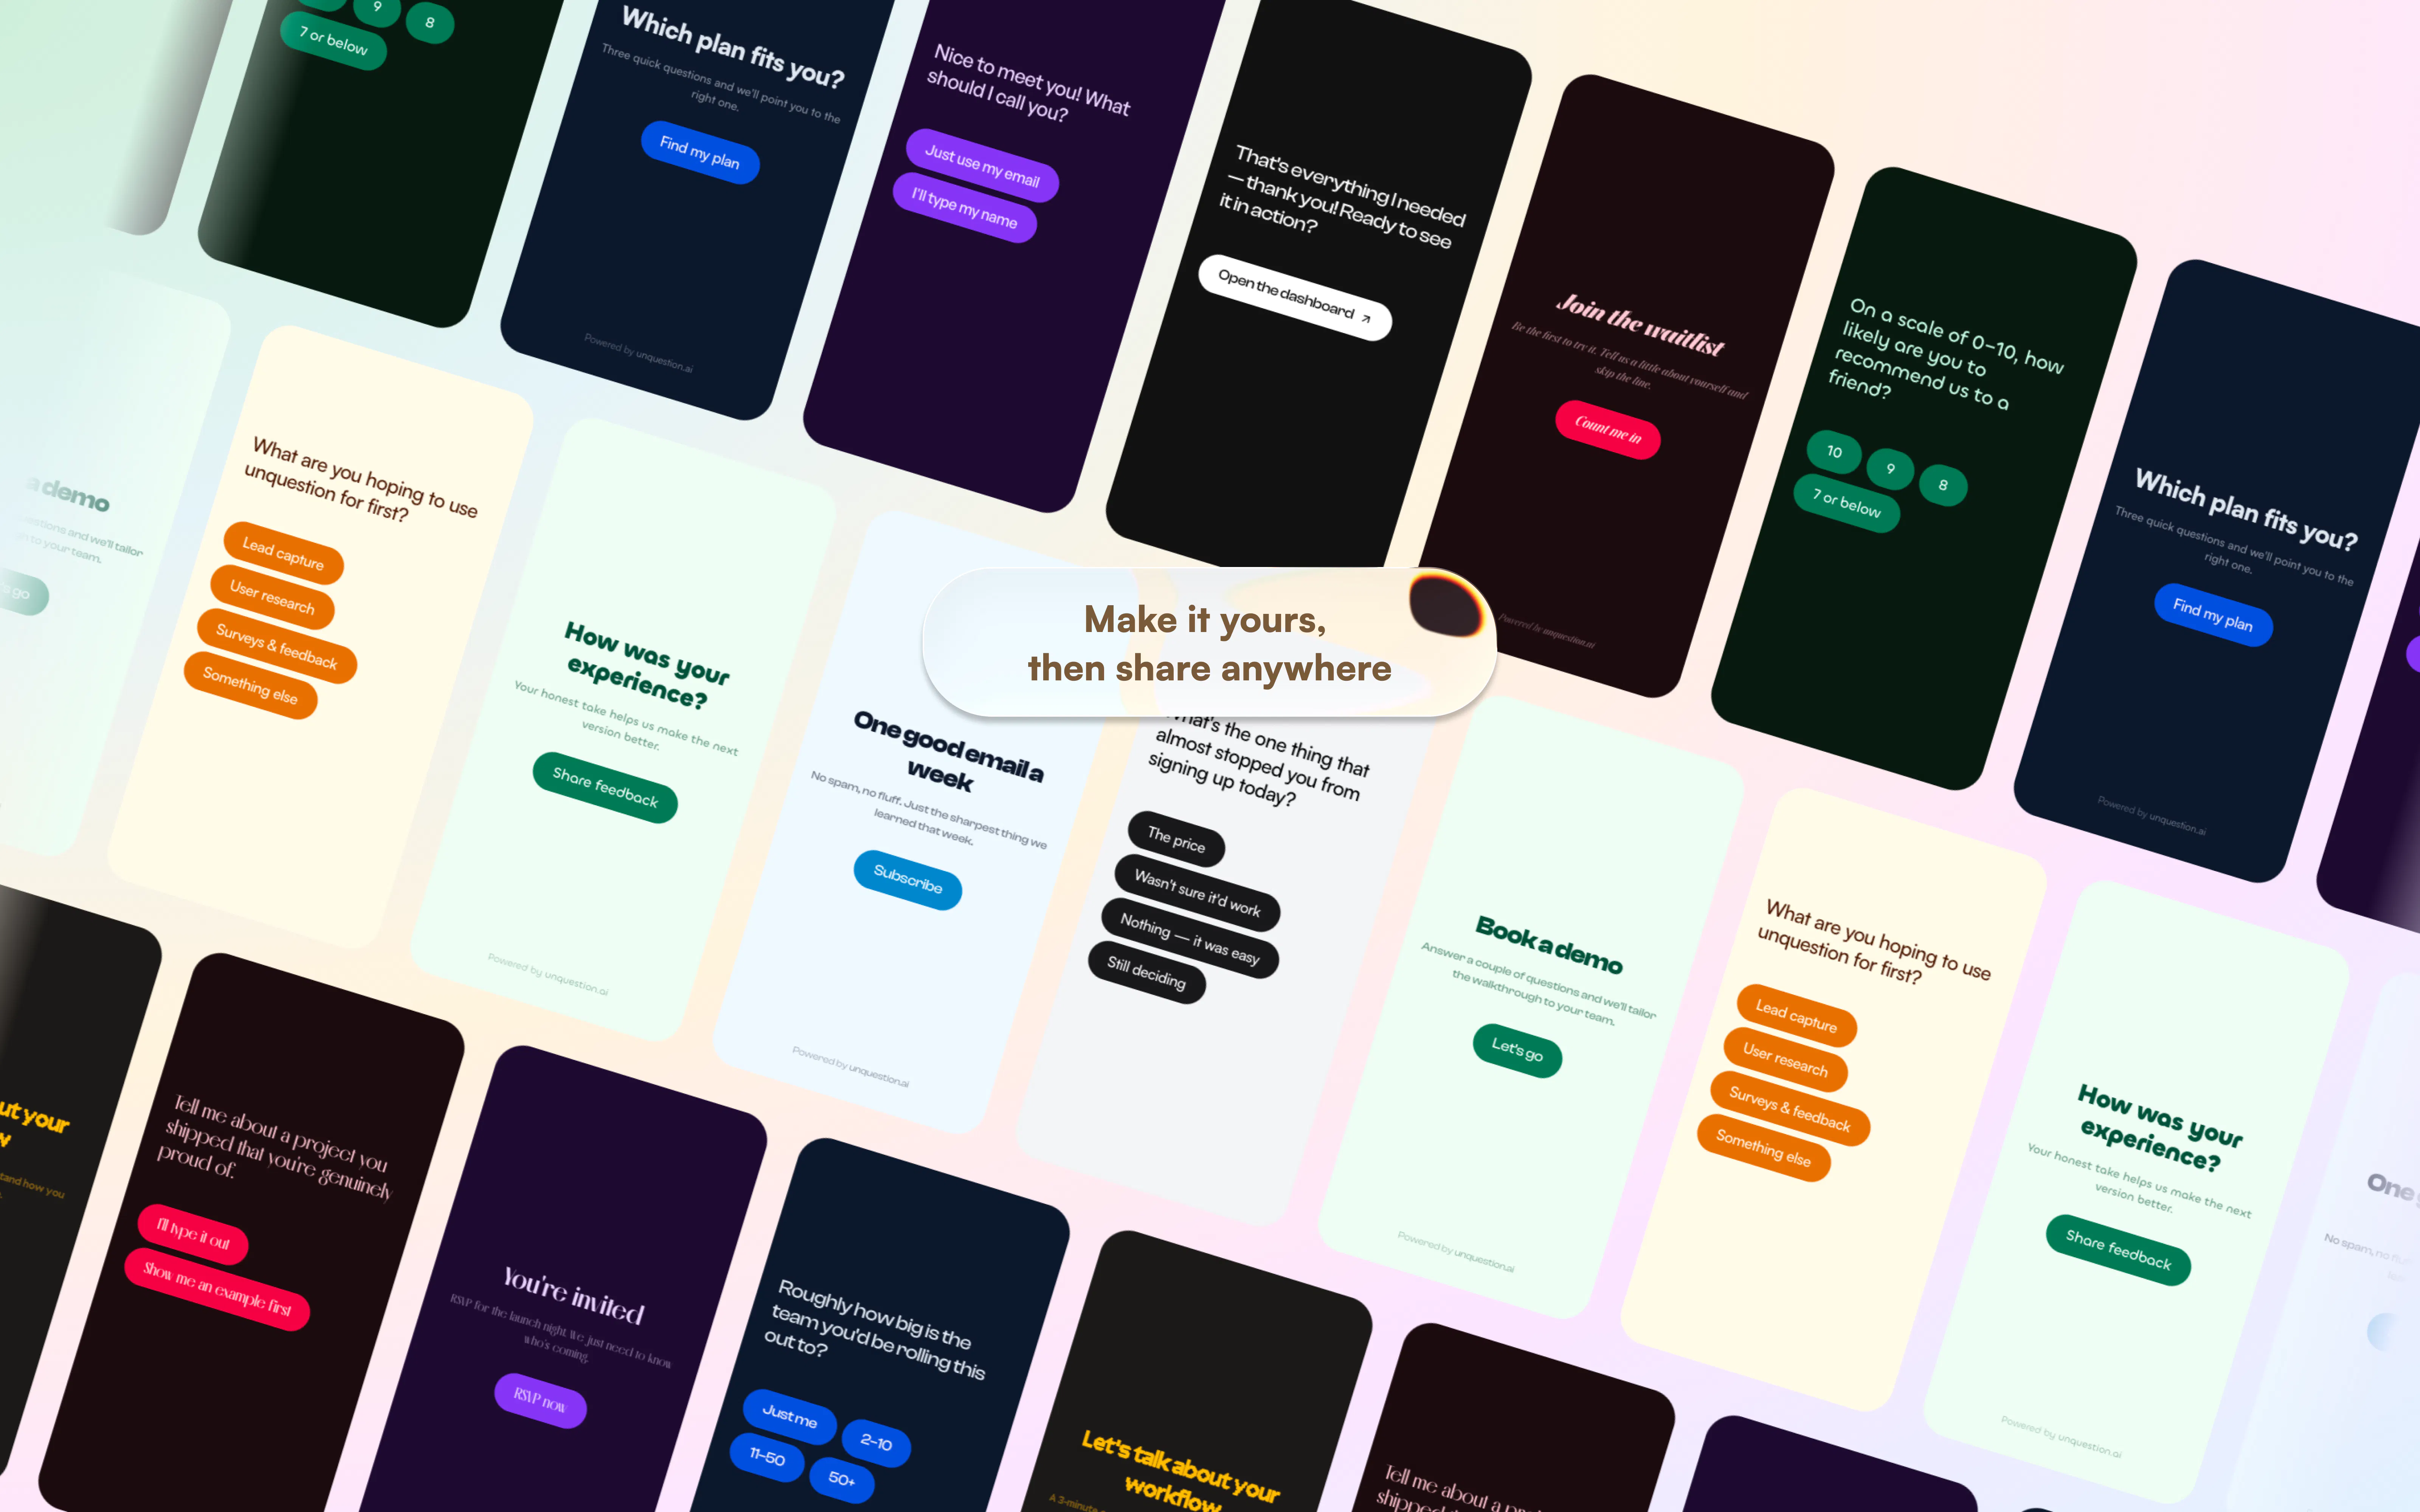
一句话介绍:Unquestion用AI对话替代静态表单,在收集信息场景下,通过自适应追问和结构化数据输出,解决用户填表中途放弃、数据杂乱难整理的痛点。
Marketing
SaaS
Artificial Intelligence
AI表单
对话式收集
结构化数据
无代码搭建
智能追问
用户留存
流程自动化
多语言支持
数据整理
SaaS工具
用户评论摘要:用户肯定AI灵活性与结构化流程的平衡设计。主要疑问集中在与Google Forms的竞争定位,以及如何避免AI追问过多导致对话冗长。官方回应称可通过编辑器设置“确保细节”来控制追问深度,实现平衡。
AI 锐评
Unquestion的切入点很聪明,它没有试图用AI取代表单,而是用对话的外壳包裹表单的内核——这精准命中了“静态表单流失率高”与“纯AI聊天数据不可用”之间的真空地带。从产品逻辑看,其核心价值不在“AI聊天”,而在“结构化提取”:通过无代码流程编排和自然语言规则(如“必须给出全名”),将不可控的自由文本强制收敛为可用的表格数据,这本质上是用AI提升表单的完成率和数据质量,而非制造一个华而不实的聊天机器人。
但必须泼一盆冷水。首先,28个投票和仅有的两条评论(其中一条是创始人自问自答式引导)表明产品尚处于极早期,市场验证远未完成。其次,“AI会像人一样追问”是一把双刃剑:对话式交互天然比静态表单耗时,用户初期可能因新鲜感而容忍,但一旦新鲜感消退,追问带来的认知负担会直接转化为流失。官方回复中“编辑器可配置追问深度”看似灵活,实则把矛盾推给了表单创建者——他们需要同时精通业务逻辑和对话设计,这门槛并不低。
真正的隐忧在于护城河。底层能力依赖LLM,界面交互可轻易模仿,一旦Google Forms或Typeform集成类似AI追问功能,Unquestion的生存空间会被瞬间挤压。其更务实的出路是深耕垂直场景(如售前线索筛选、客户调研、售后反馈),将“AI追问+结构化输出”的模板和规则库做深做透,让竞品难以复制流程经验,而非停留在通用工具层面。否则,它很可能沦为大厂功能迭代的垫脚石。
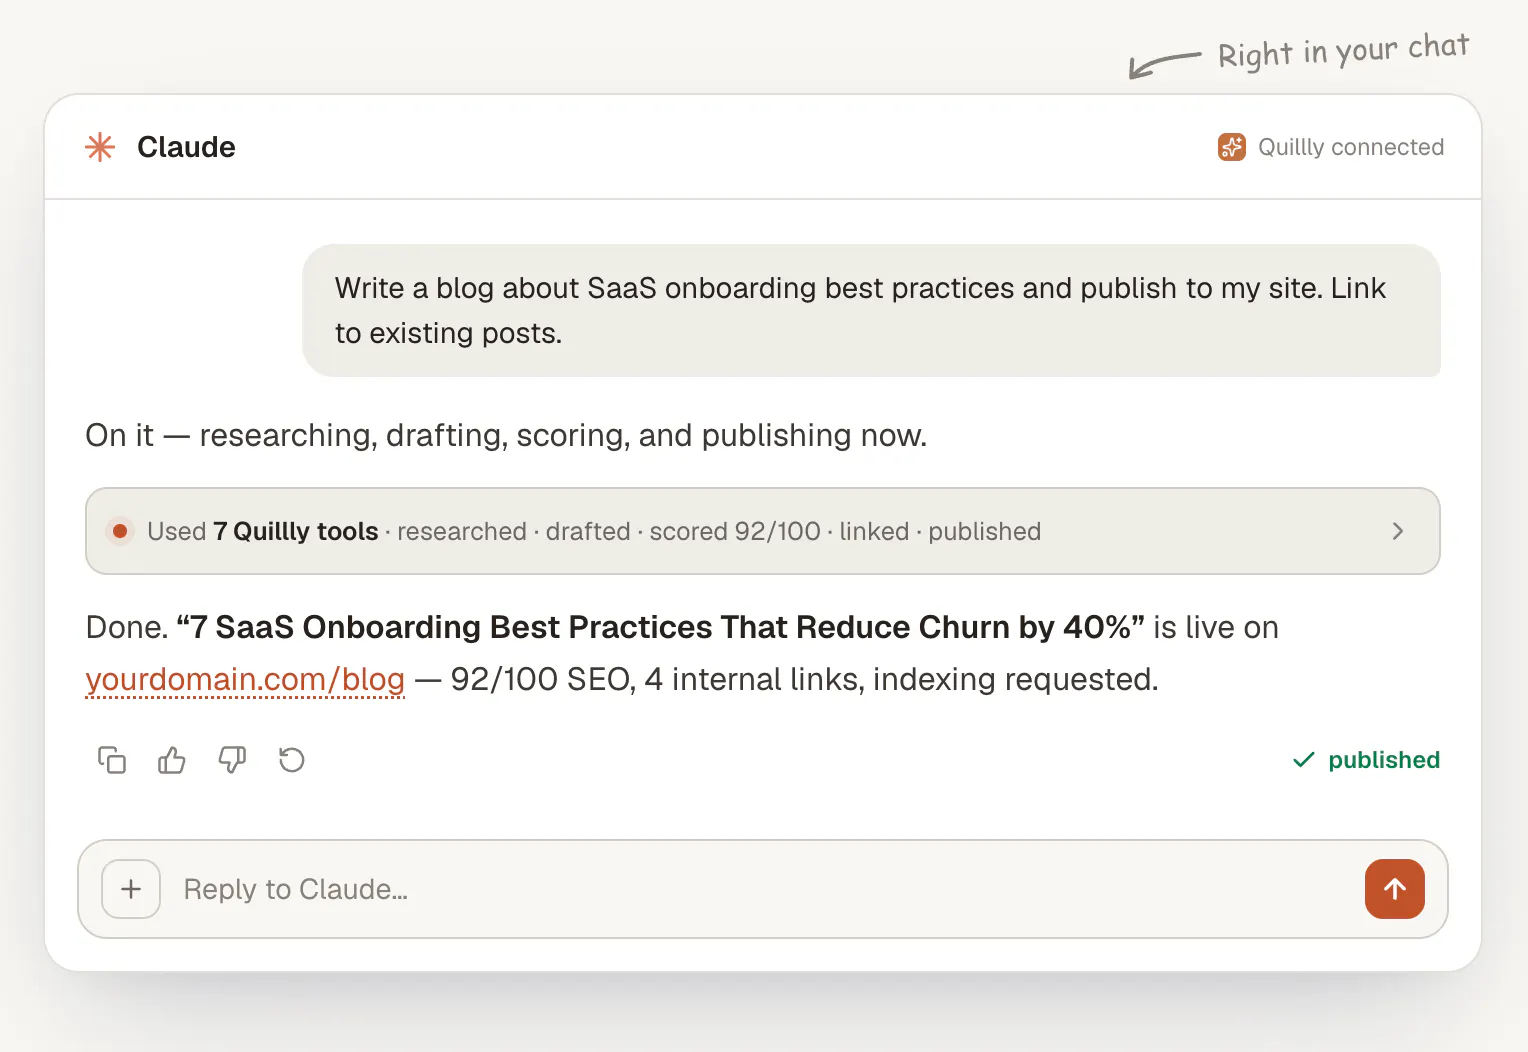
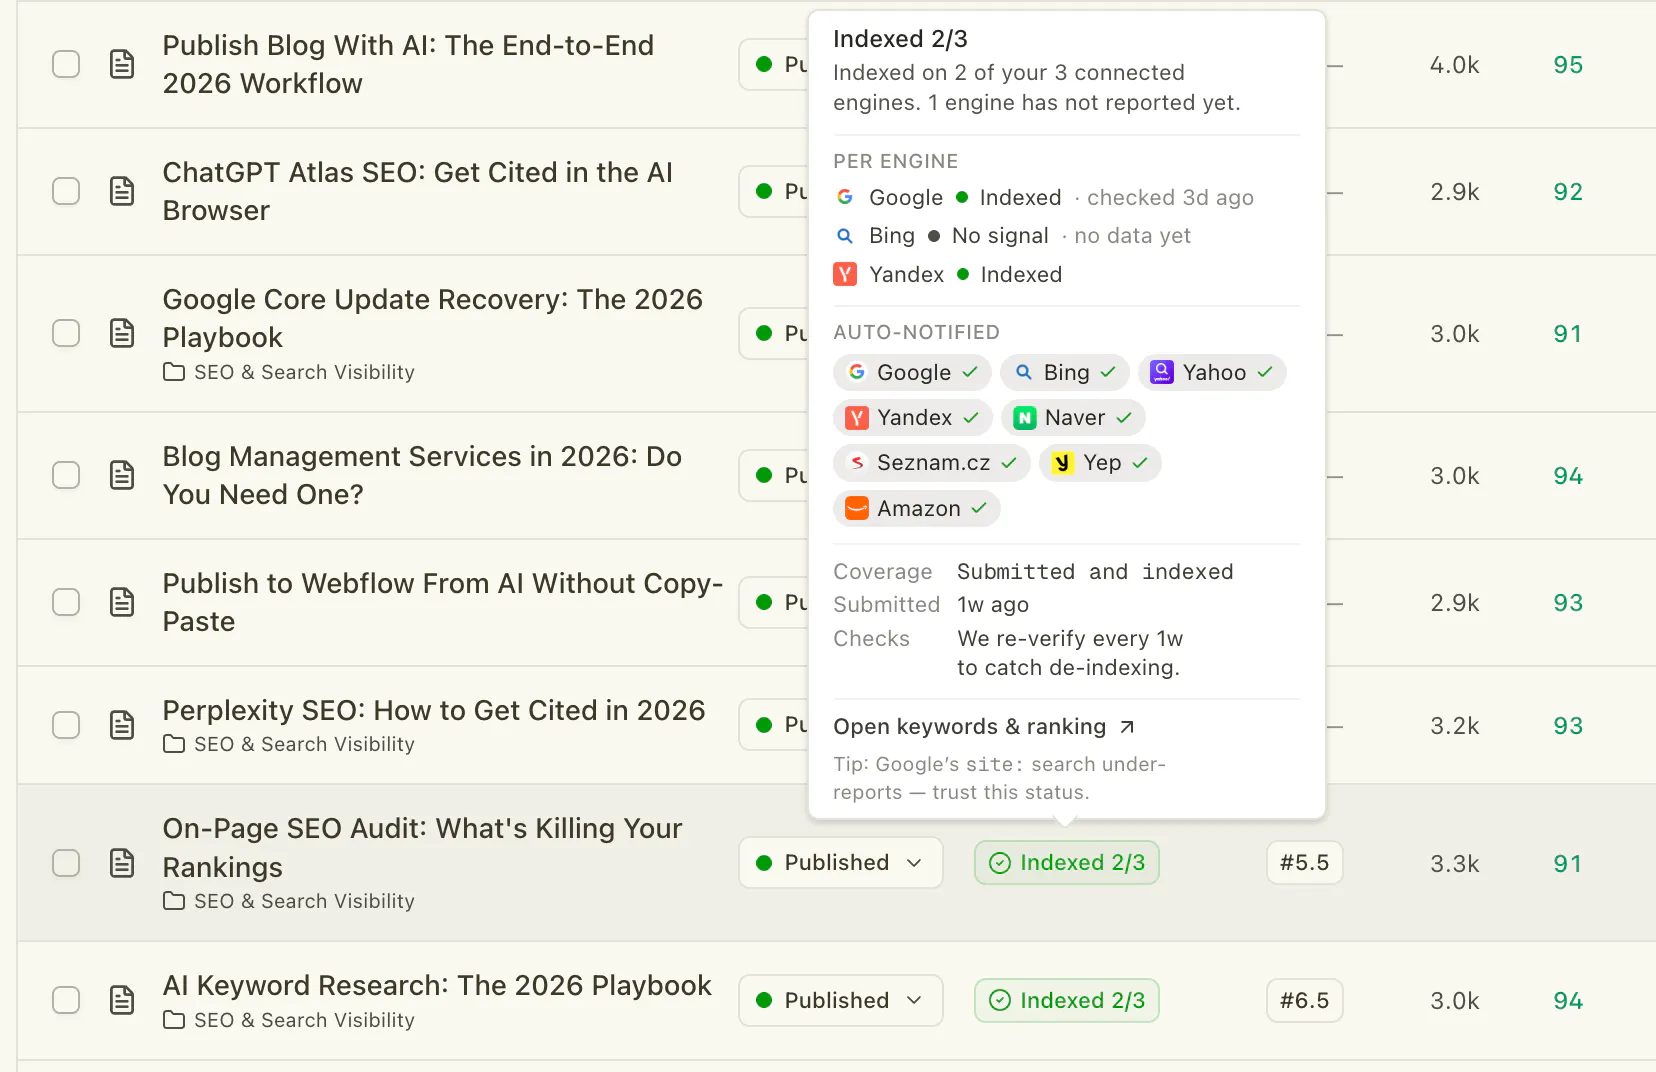
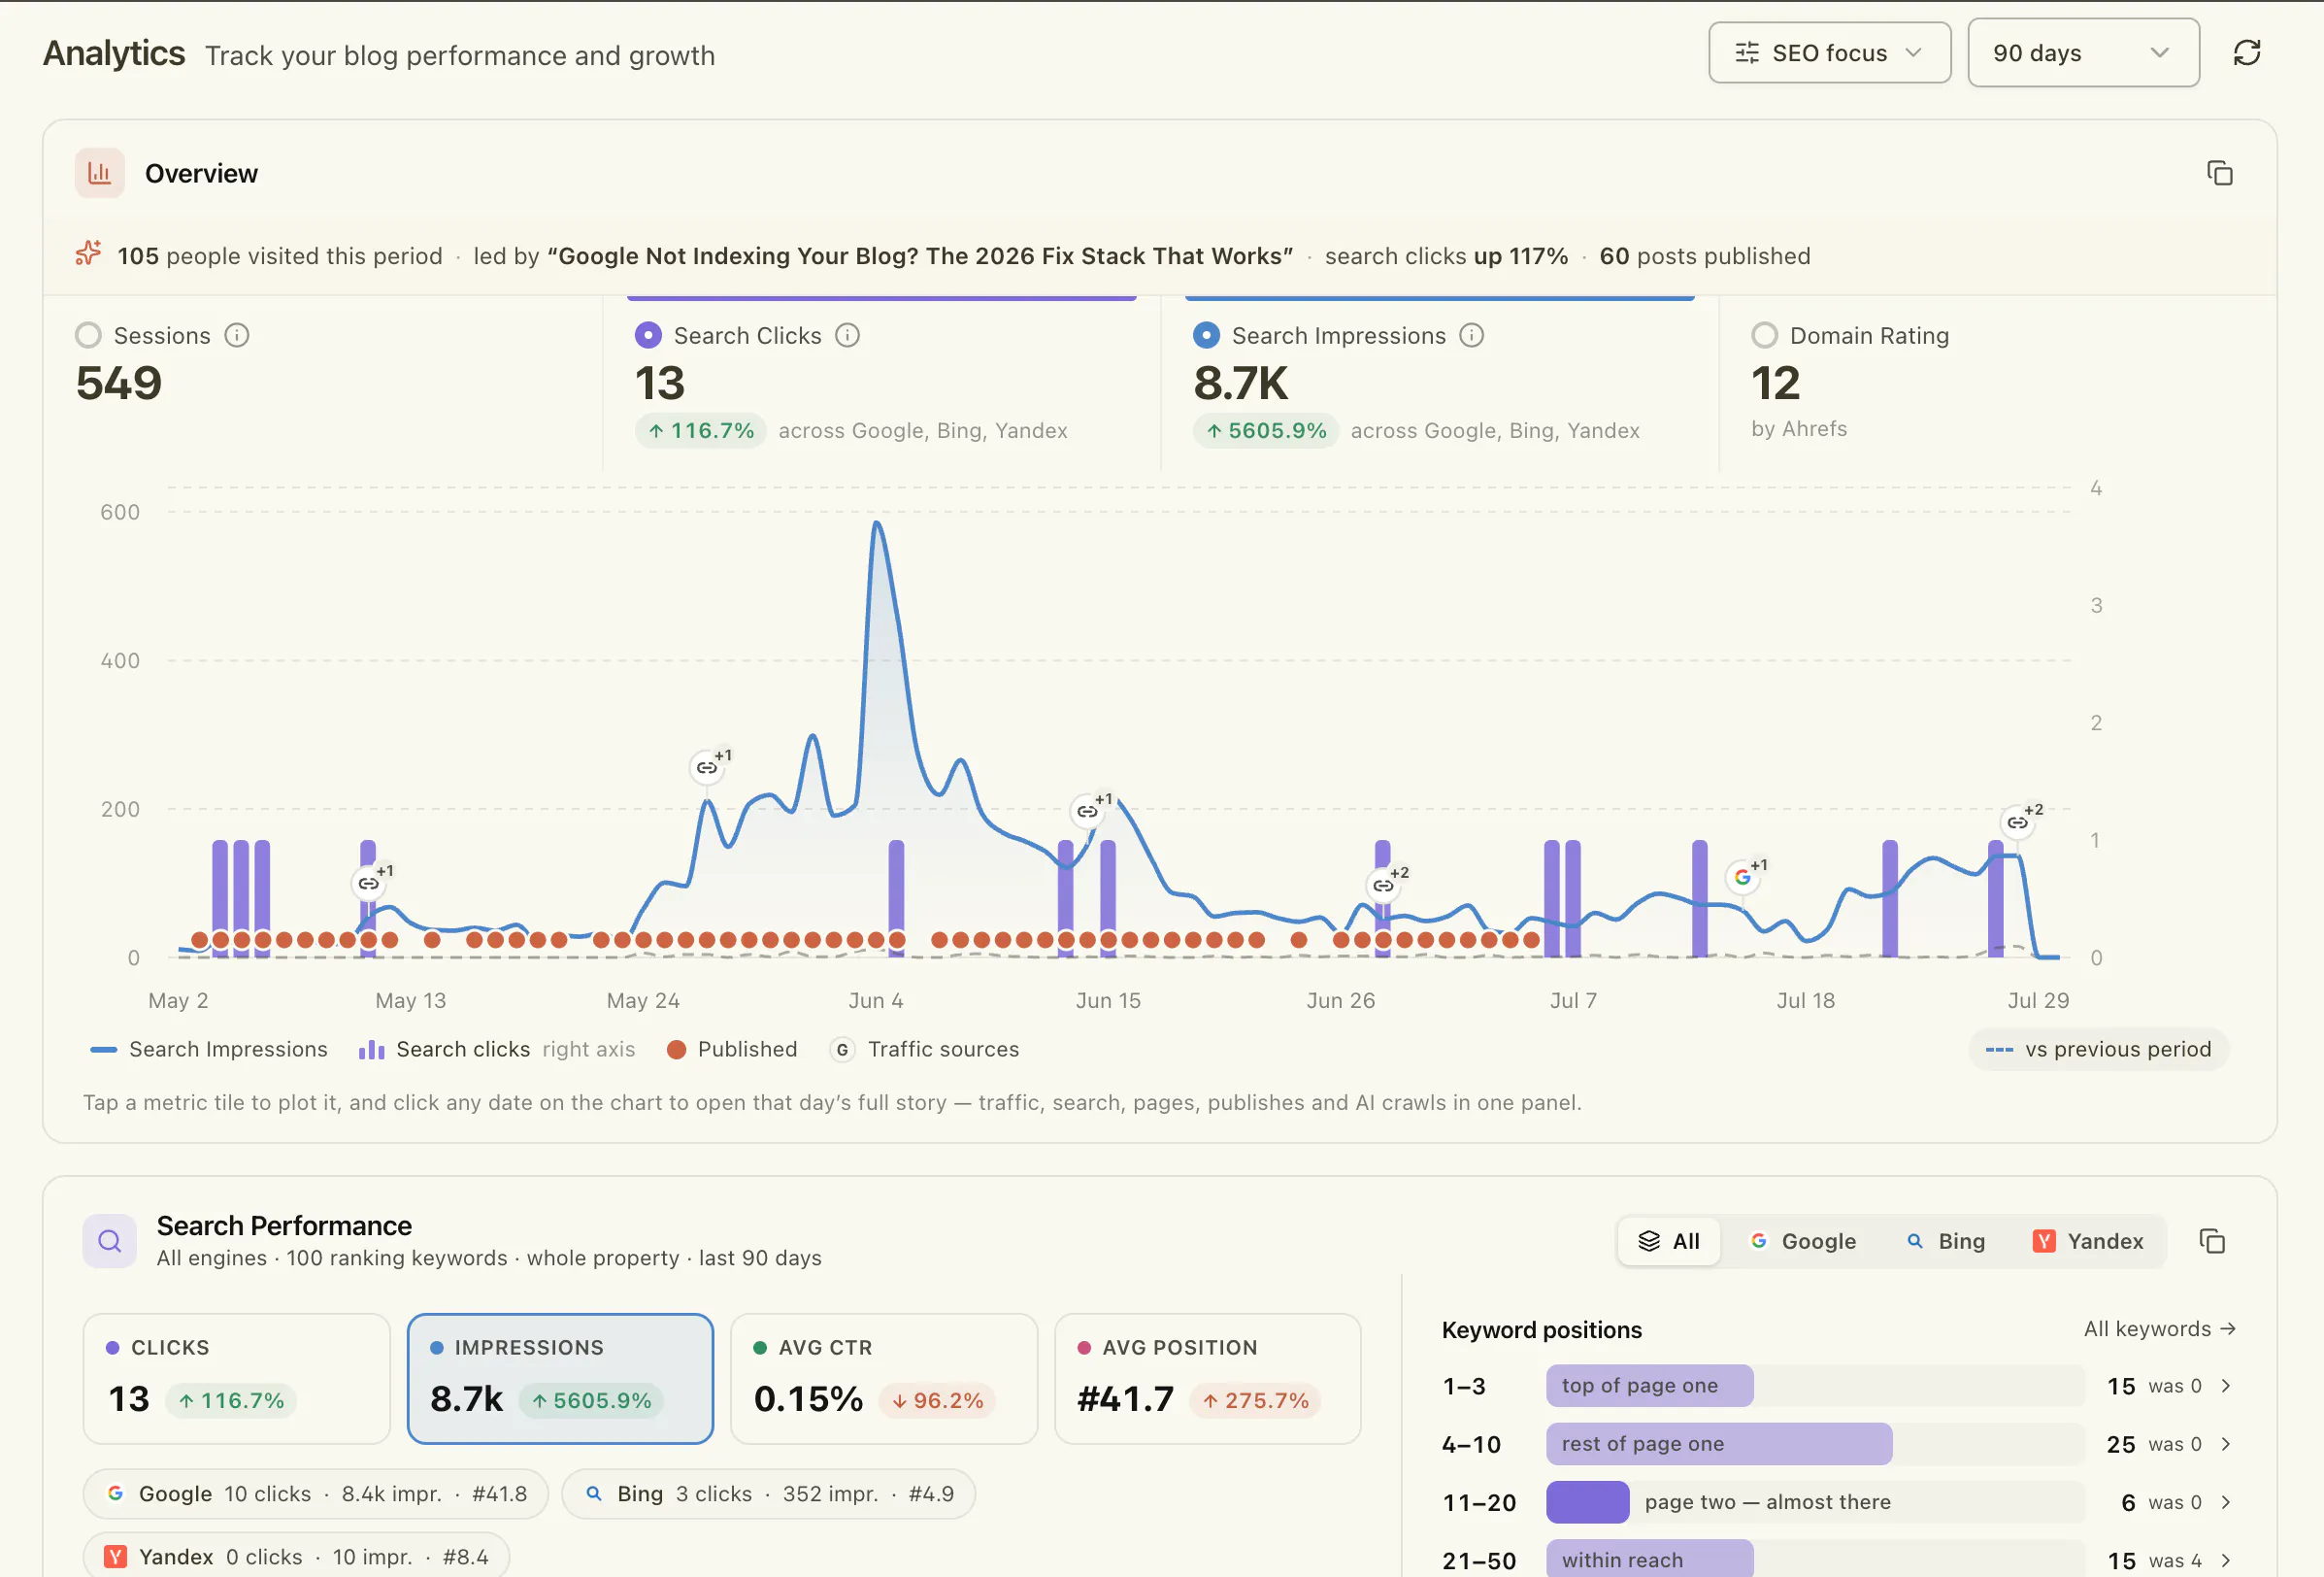
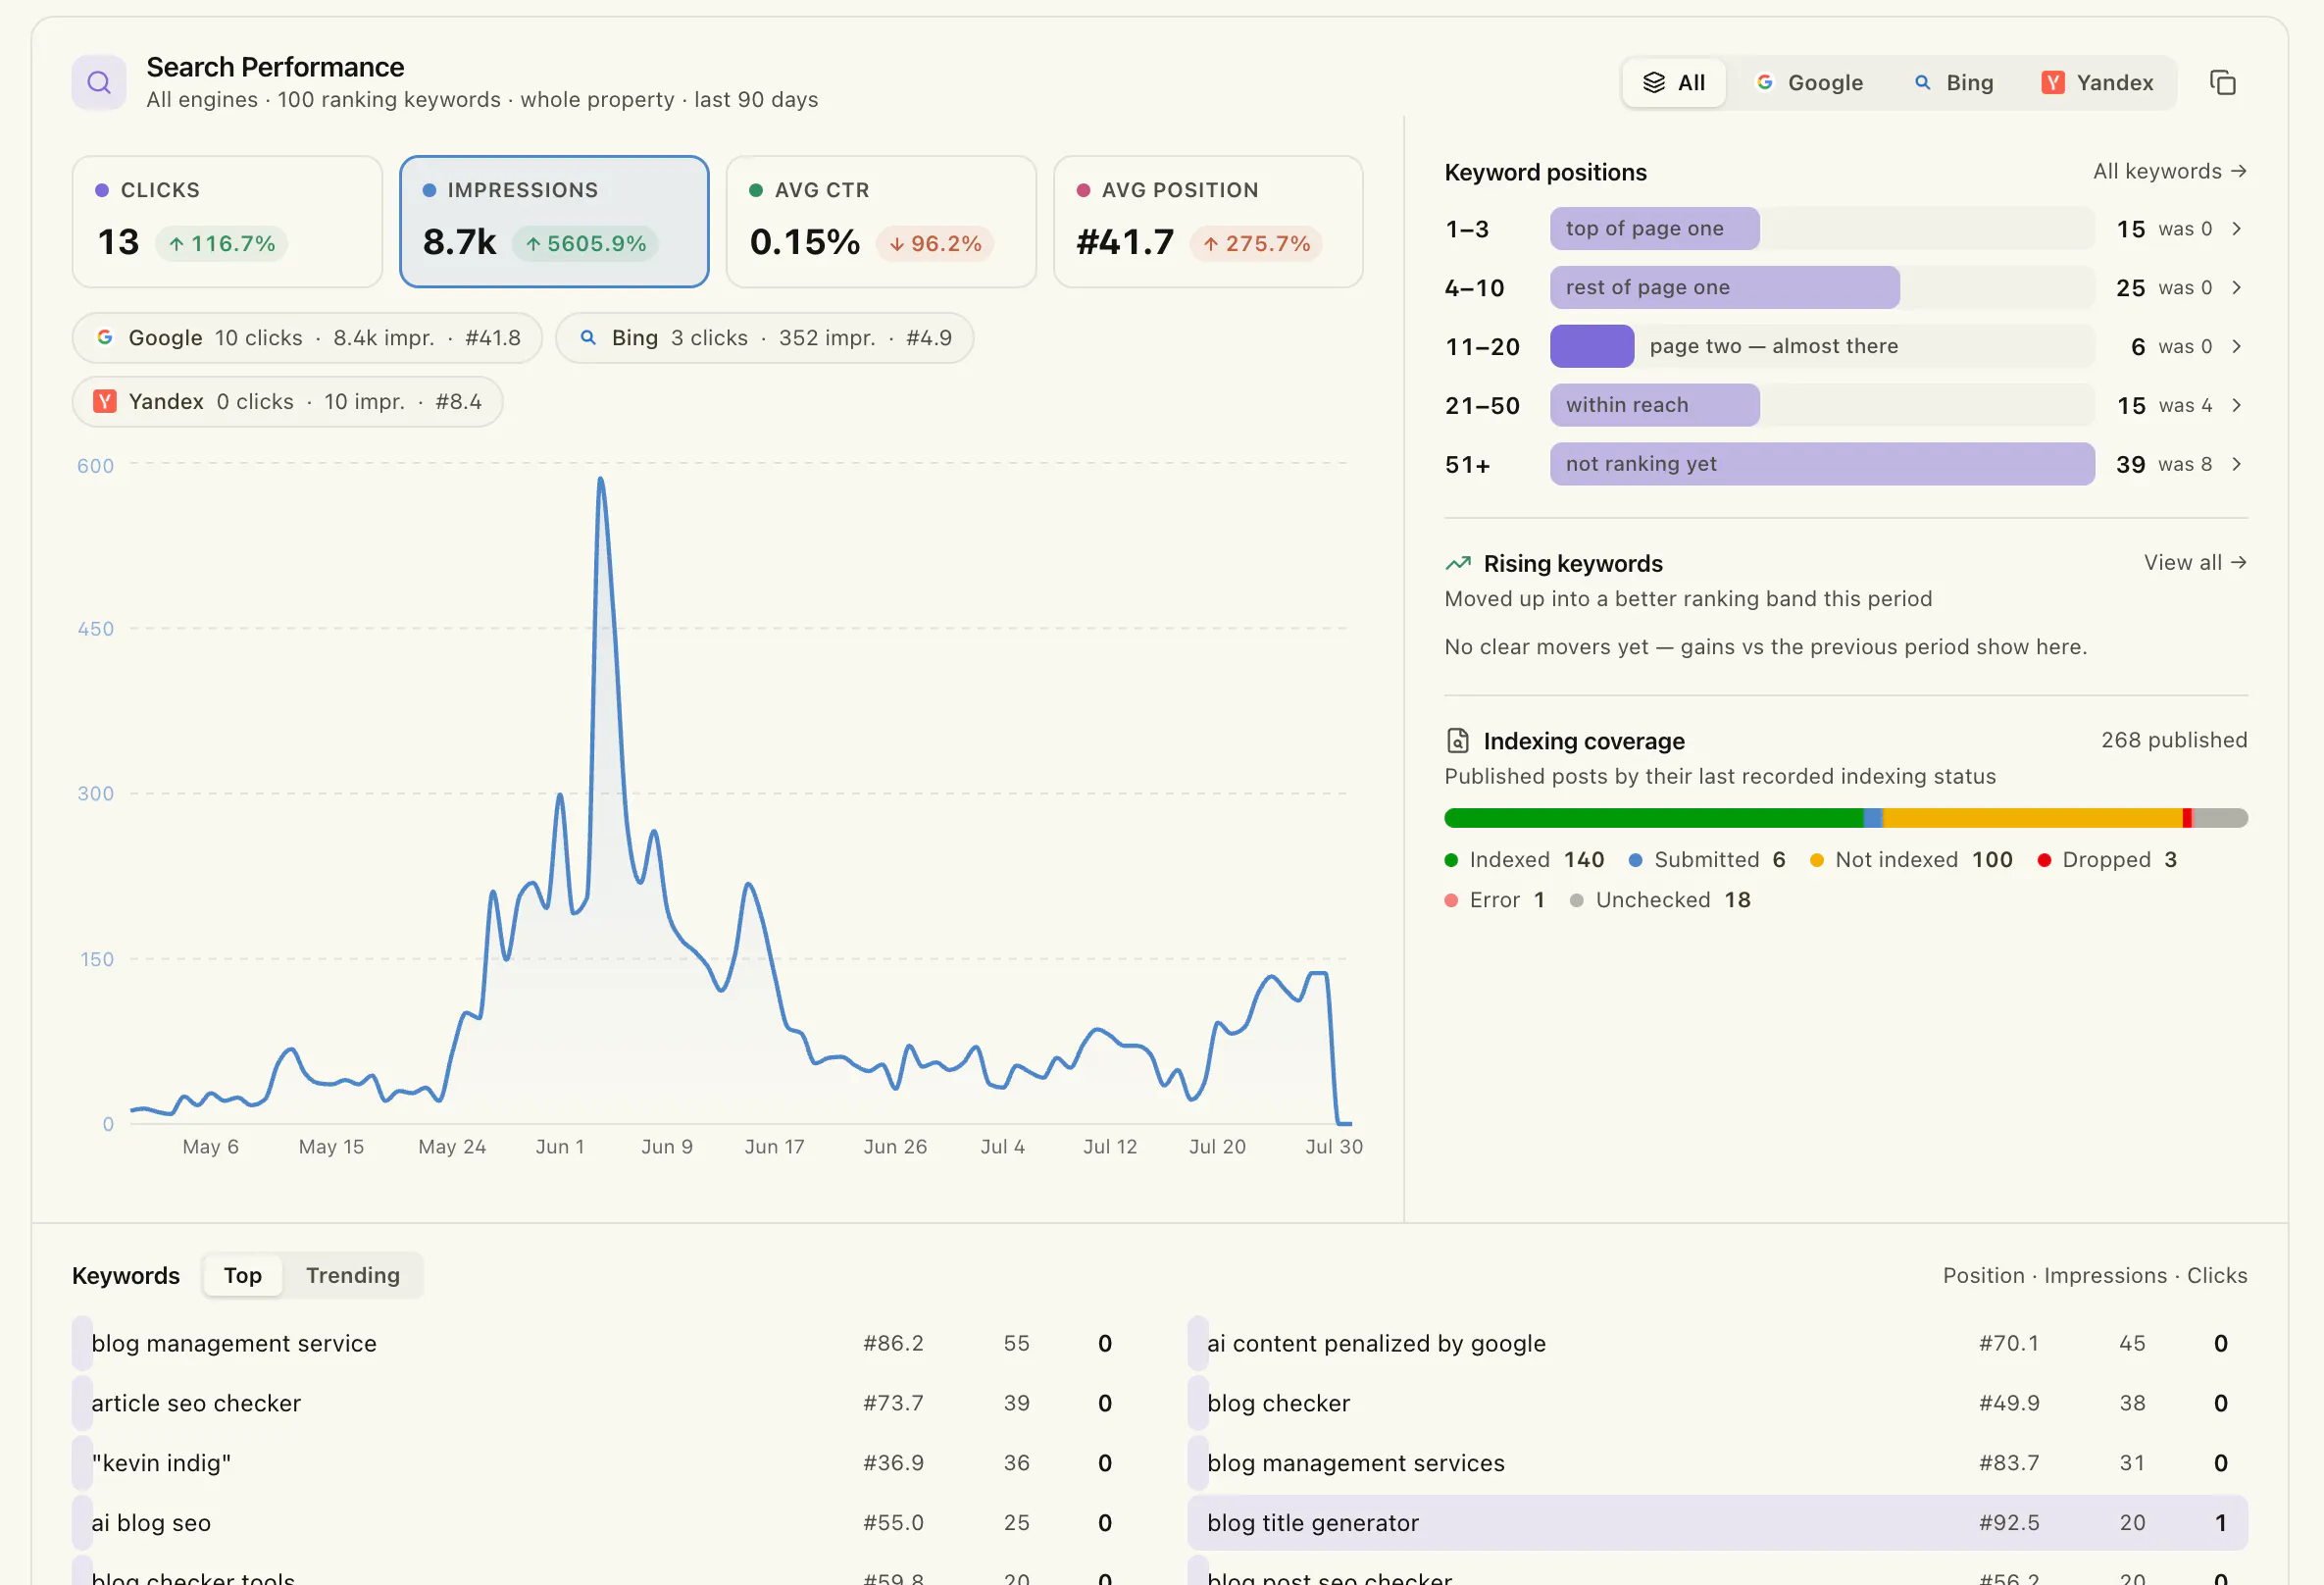
一句话介绍:Quillly通过MCP协议将Claude、ChatGPT等AI助手直接接入你的网站,让AI写完内容后自动完成SEO优化、发布、多搜索引擎提交和排名追踪,省去手动部署和运营的中间环节。
Marketing
SEO
SaaS
AI发布工具
MCP服务器
SEO自动化
内容自动发布
博客管理
搜索排名追踪
无头CMS
AI工作流
独立开发者工具
内容运营
用户评论摘要:用户关心无人干预的自动发布质量是否有失控风险,作者回应称严格SEO规则和工具让AI输出内容深度和可读性俱佳;有自建站用户询问是否支持自托管,作者确认支持sitemap提交和反向代理方案,并补充可管理docs和changelog。
AI 锐评
Quillly踩中了两个真痛点:一是独立开发者“写内容容易,发布运营难”的重复劳动陷阱,二是AI生成内容与搜索引擎收录之间的断层。它本质是个“发布管道+SEO监控”的缝合器,用MCP把AI的输出直接变成线上资产,省掉PR、CI/CD、手动提交索引的琐碎流程,这对小团队和单兵作战者确实有吸引力。
但值得警惕的是,它把“内容质量”的重担几乎完全甩给了AI和SEO规则。作者的自信回应建立在“Claude写得比我好”的个人体验上,这恰恰暴露了产品最大的不确定性——AI输出的同质化风险。当所有人都用Claude+Quillly批量生产“深度好文”,Google的算法未必会继续买账。况且,自动提交7个搜索引擎听起来很美,但Google对AI生成内容的打压从未停止,排名权重本质上掌握在平台手里,而非工具手里。
另一个问题是产品形态的割裂:反向代理方案能解决自托管用户的需求,但引入中间层会增加加载延迟和故障点,对强调SEO的站主可能得不偿失。目前26票的Launch成绩平平,评论热度也不高,说明产品还停留在早期采用者阶段。它能不能从“好用的个人工具”进化为“可信赖的内容基础设施”,取决于后续能否提供更多内容质量的可控性(比如人工审核流、风格约束),而不是单纯鼓吹全自动。否则,它节省的时间,迟早会以另一种方式(比如流量骤降、被Google降权)还回去。
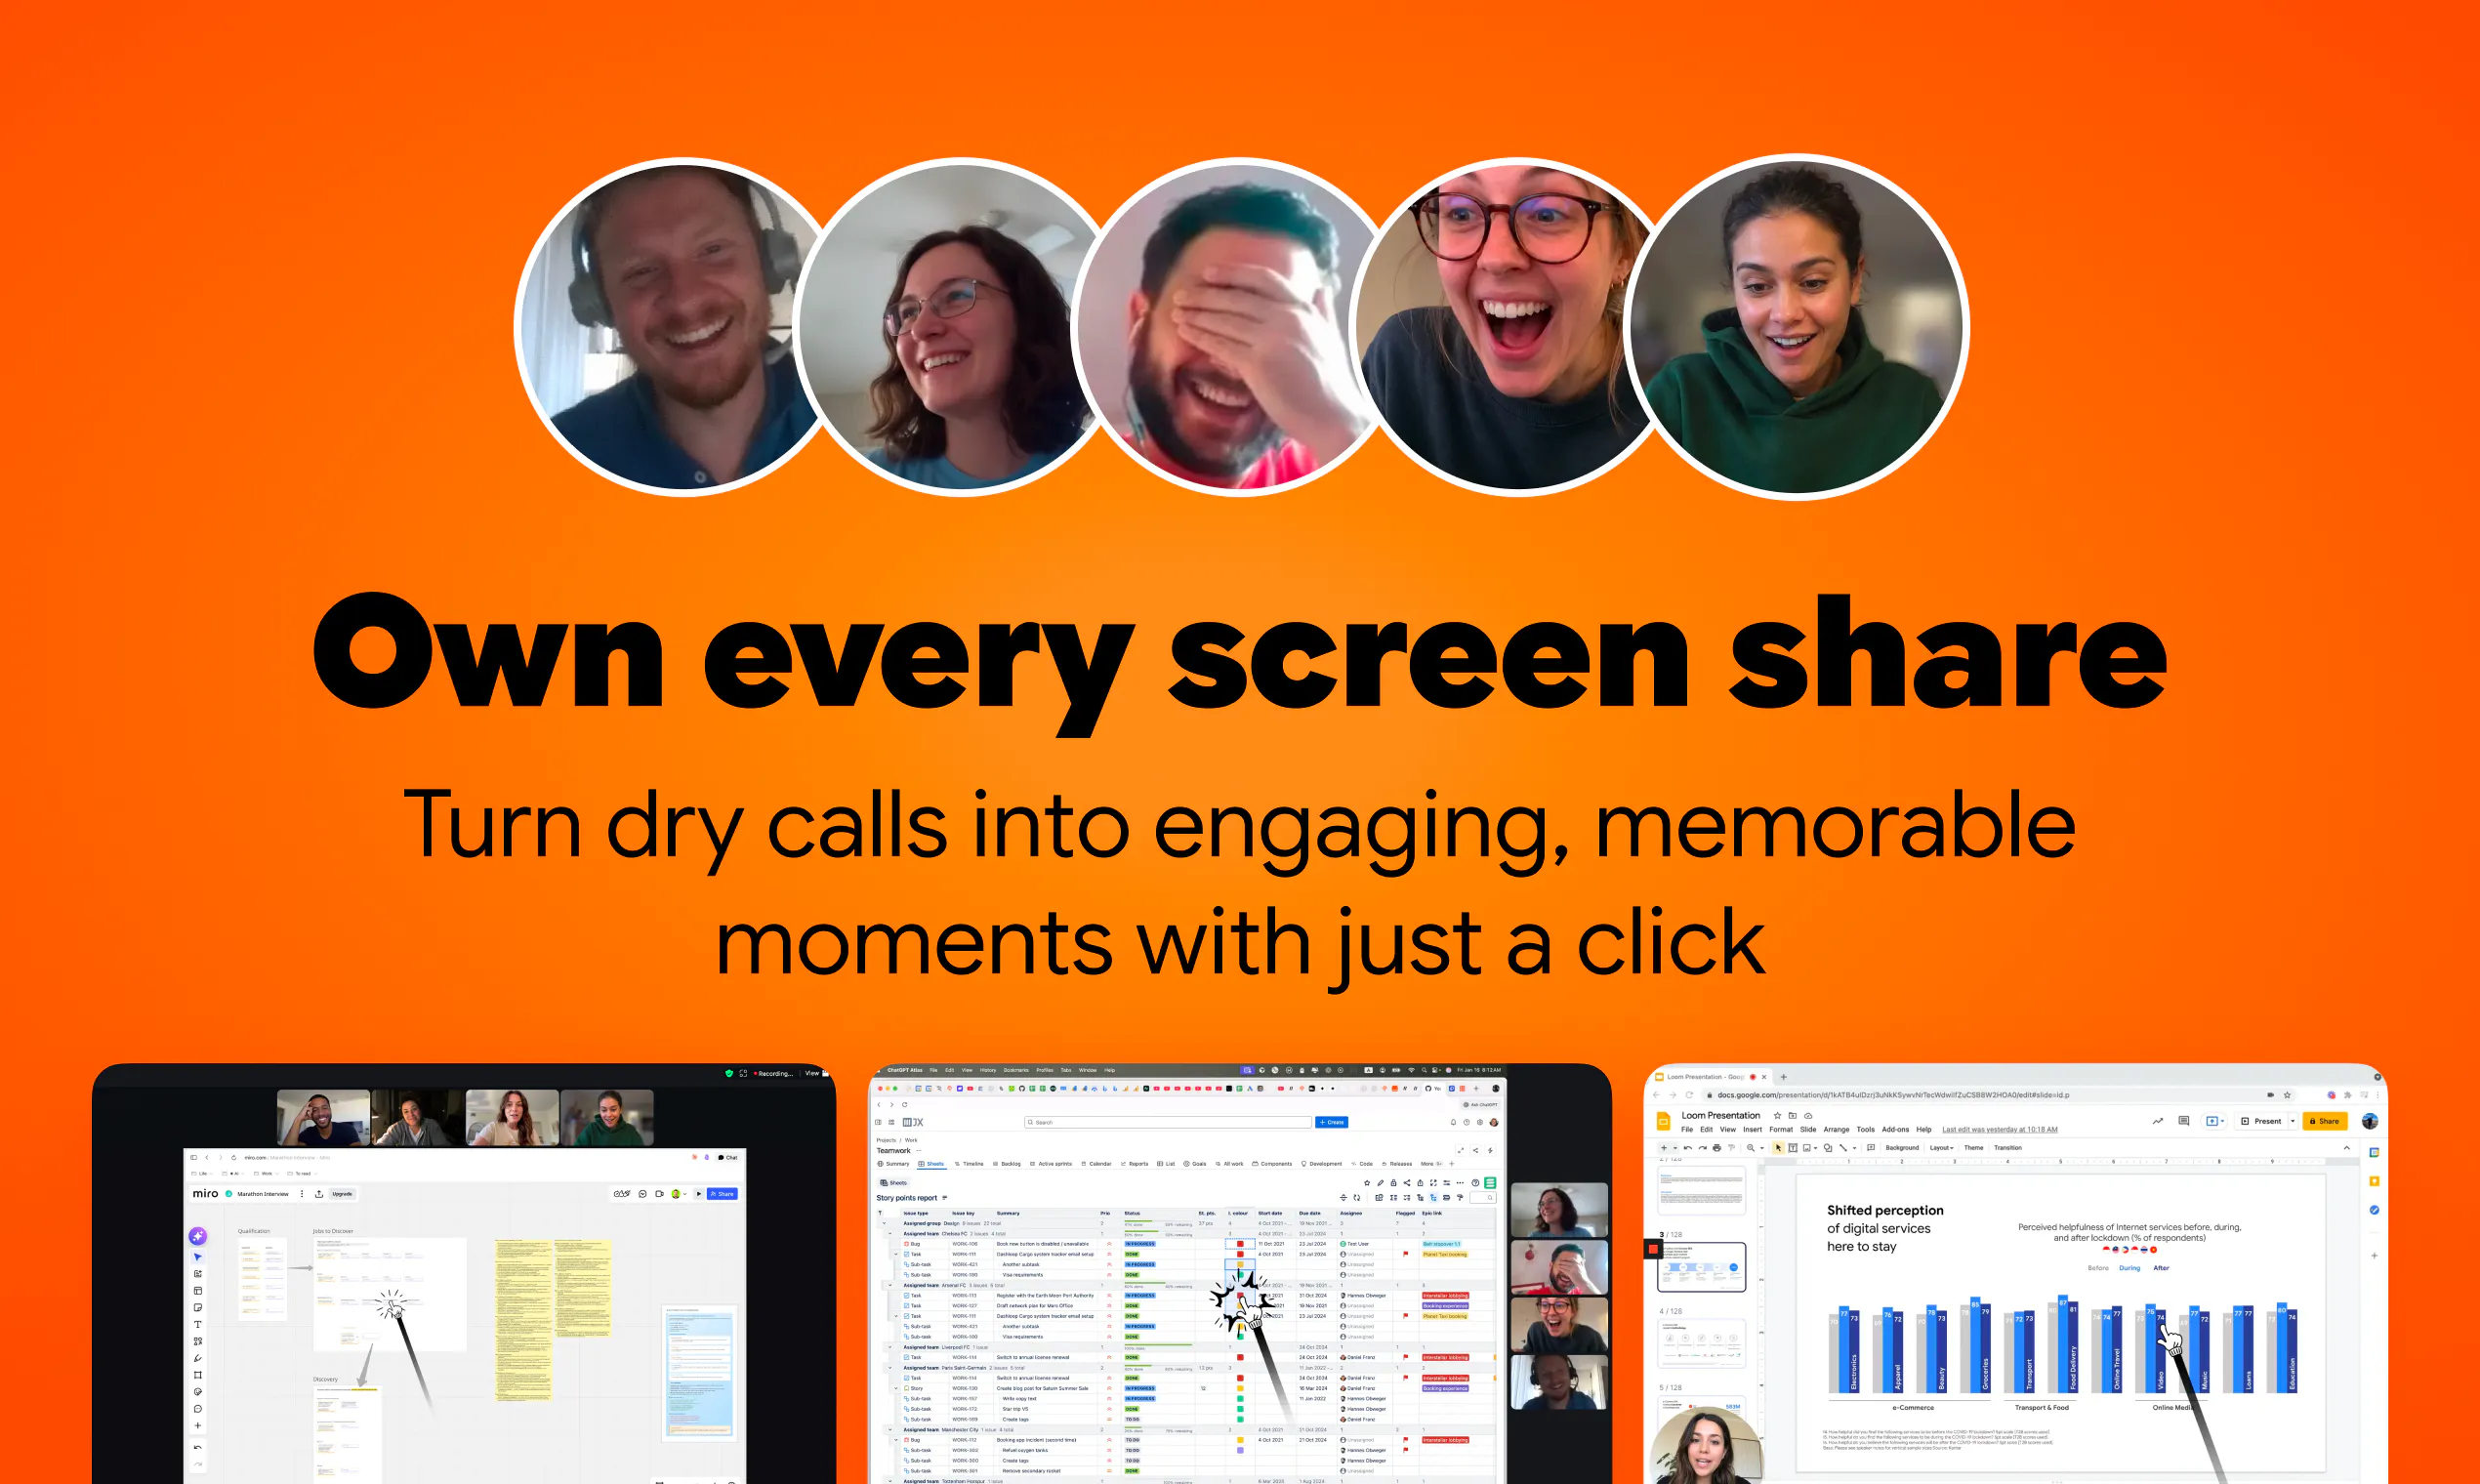
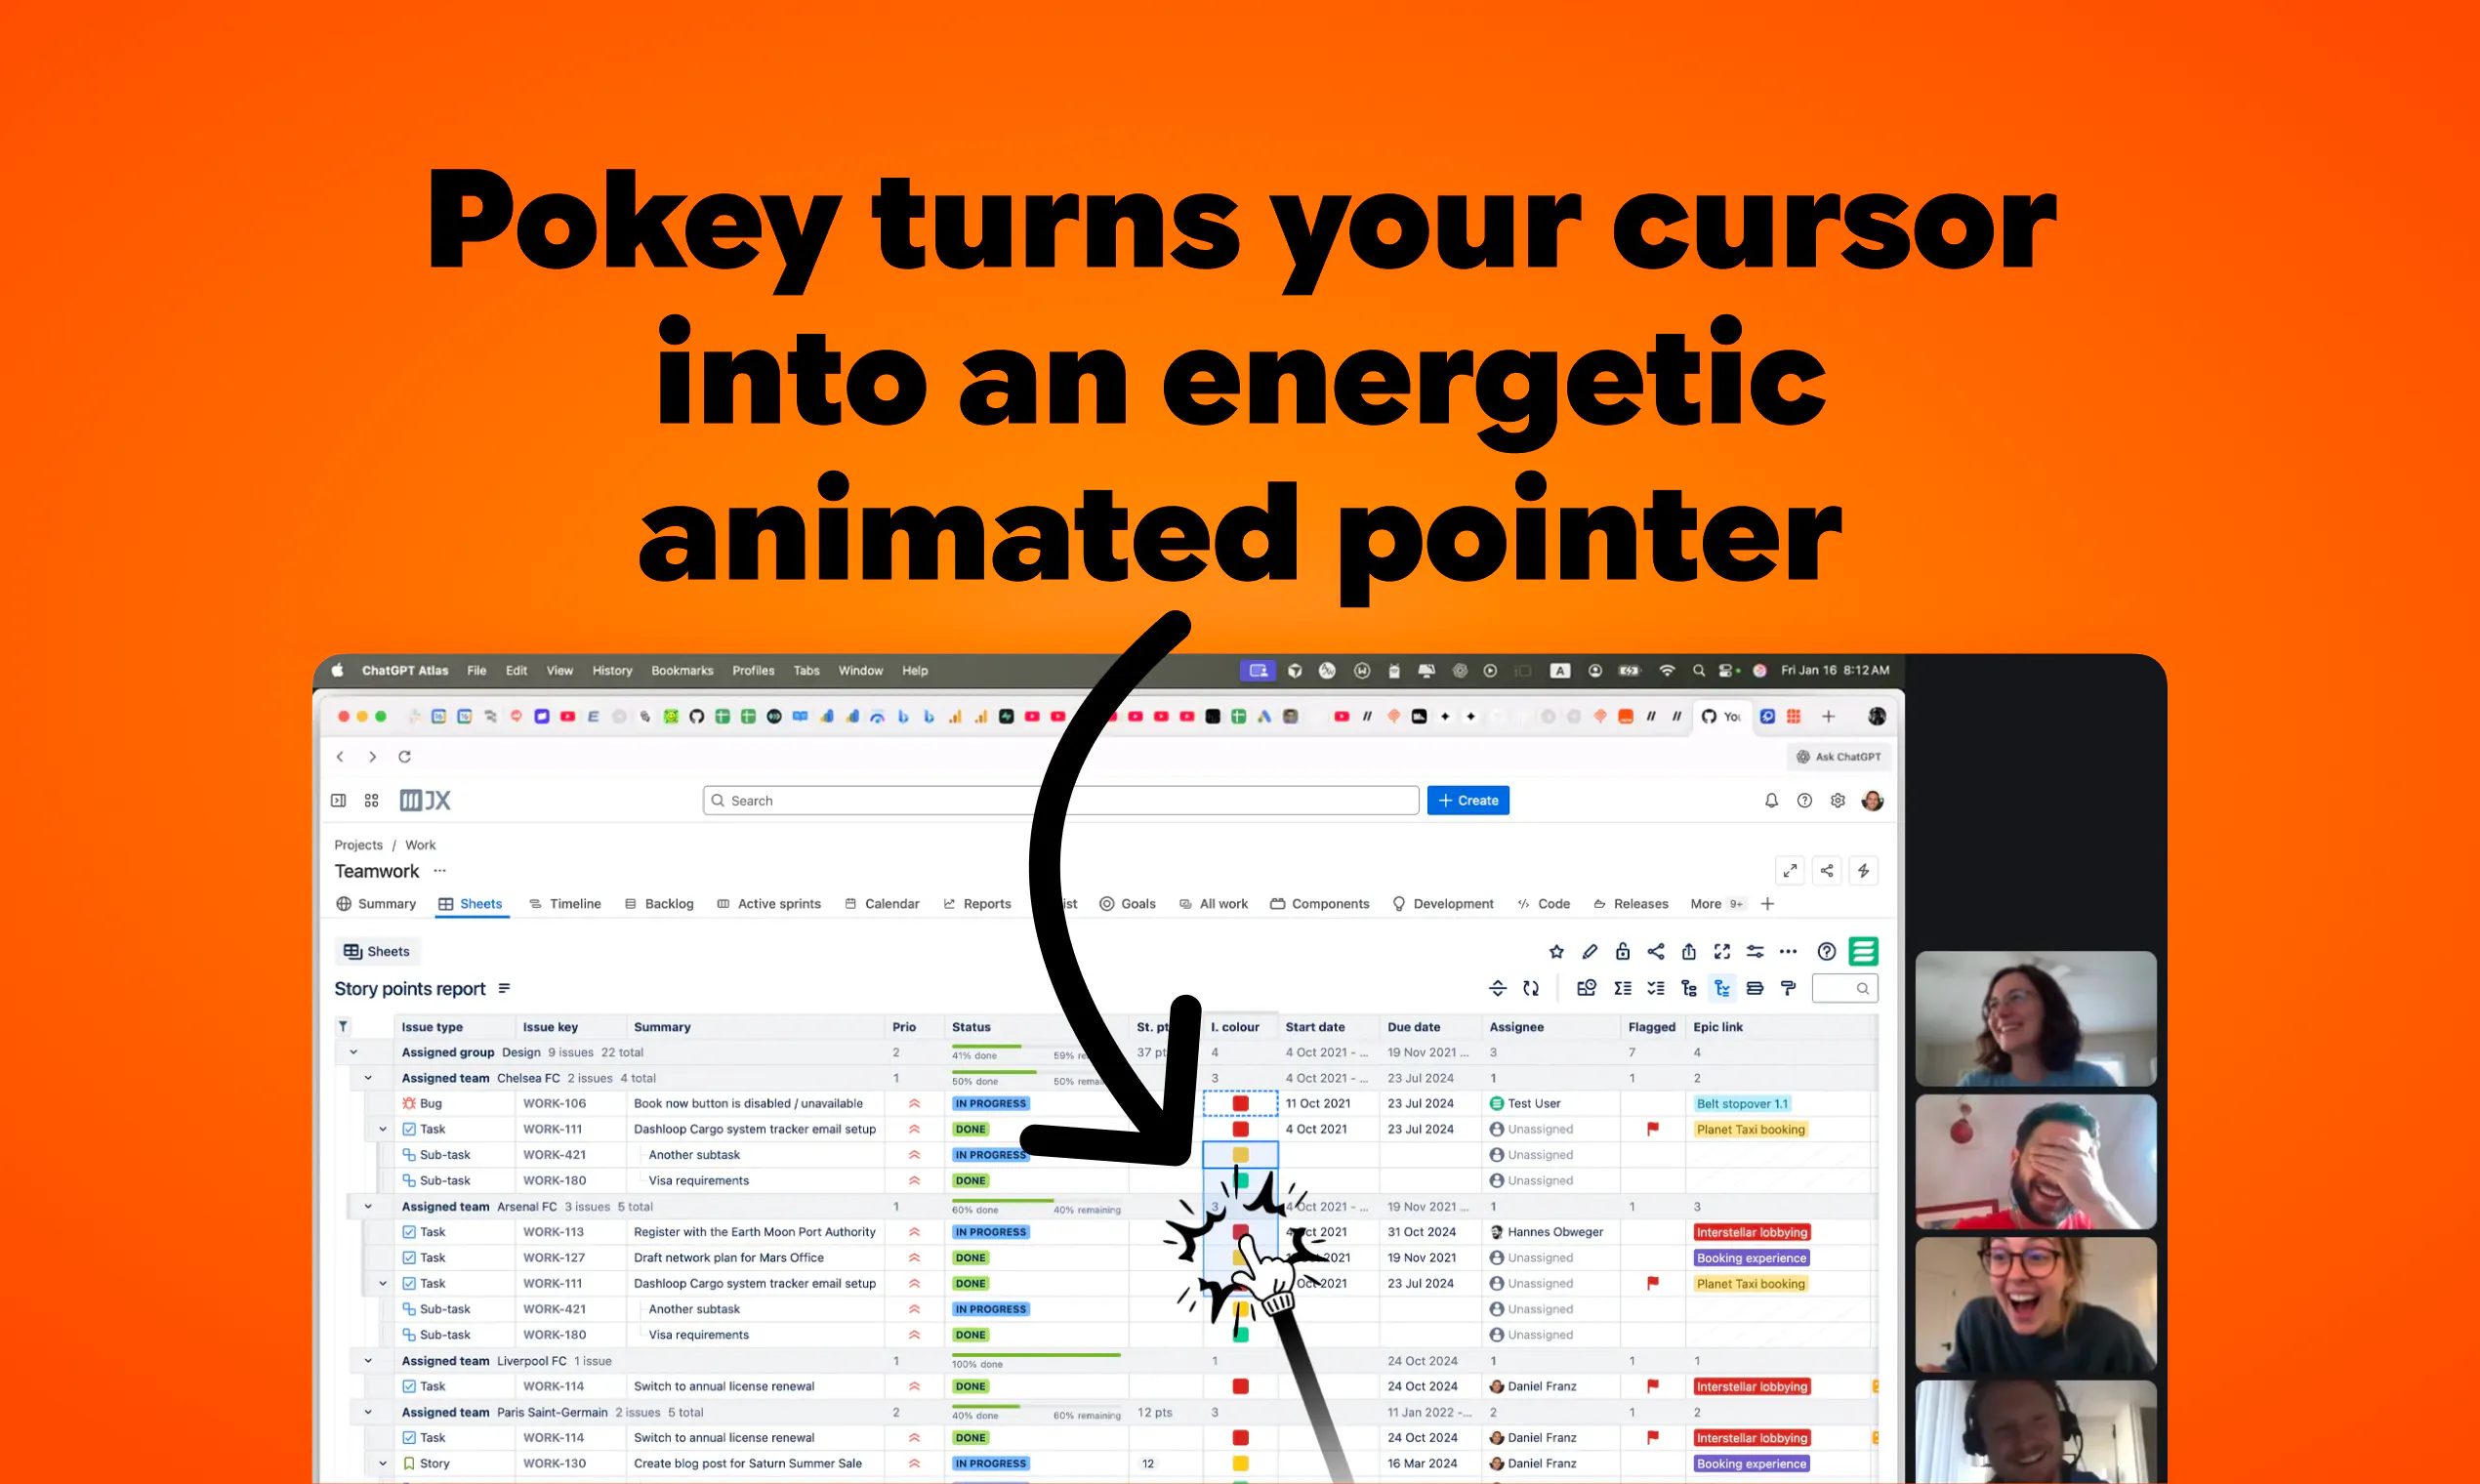
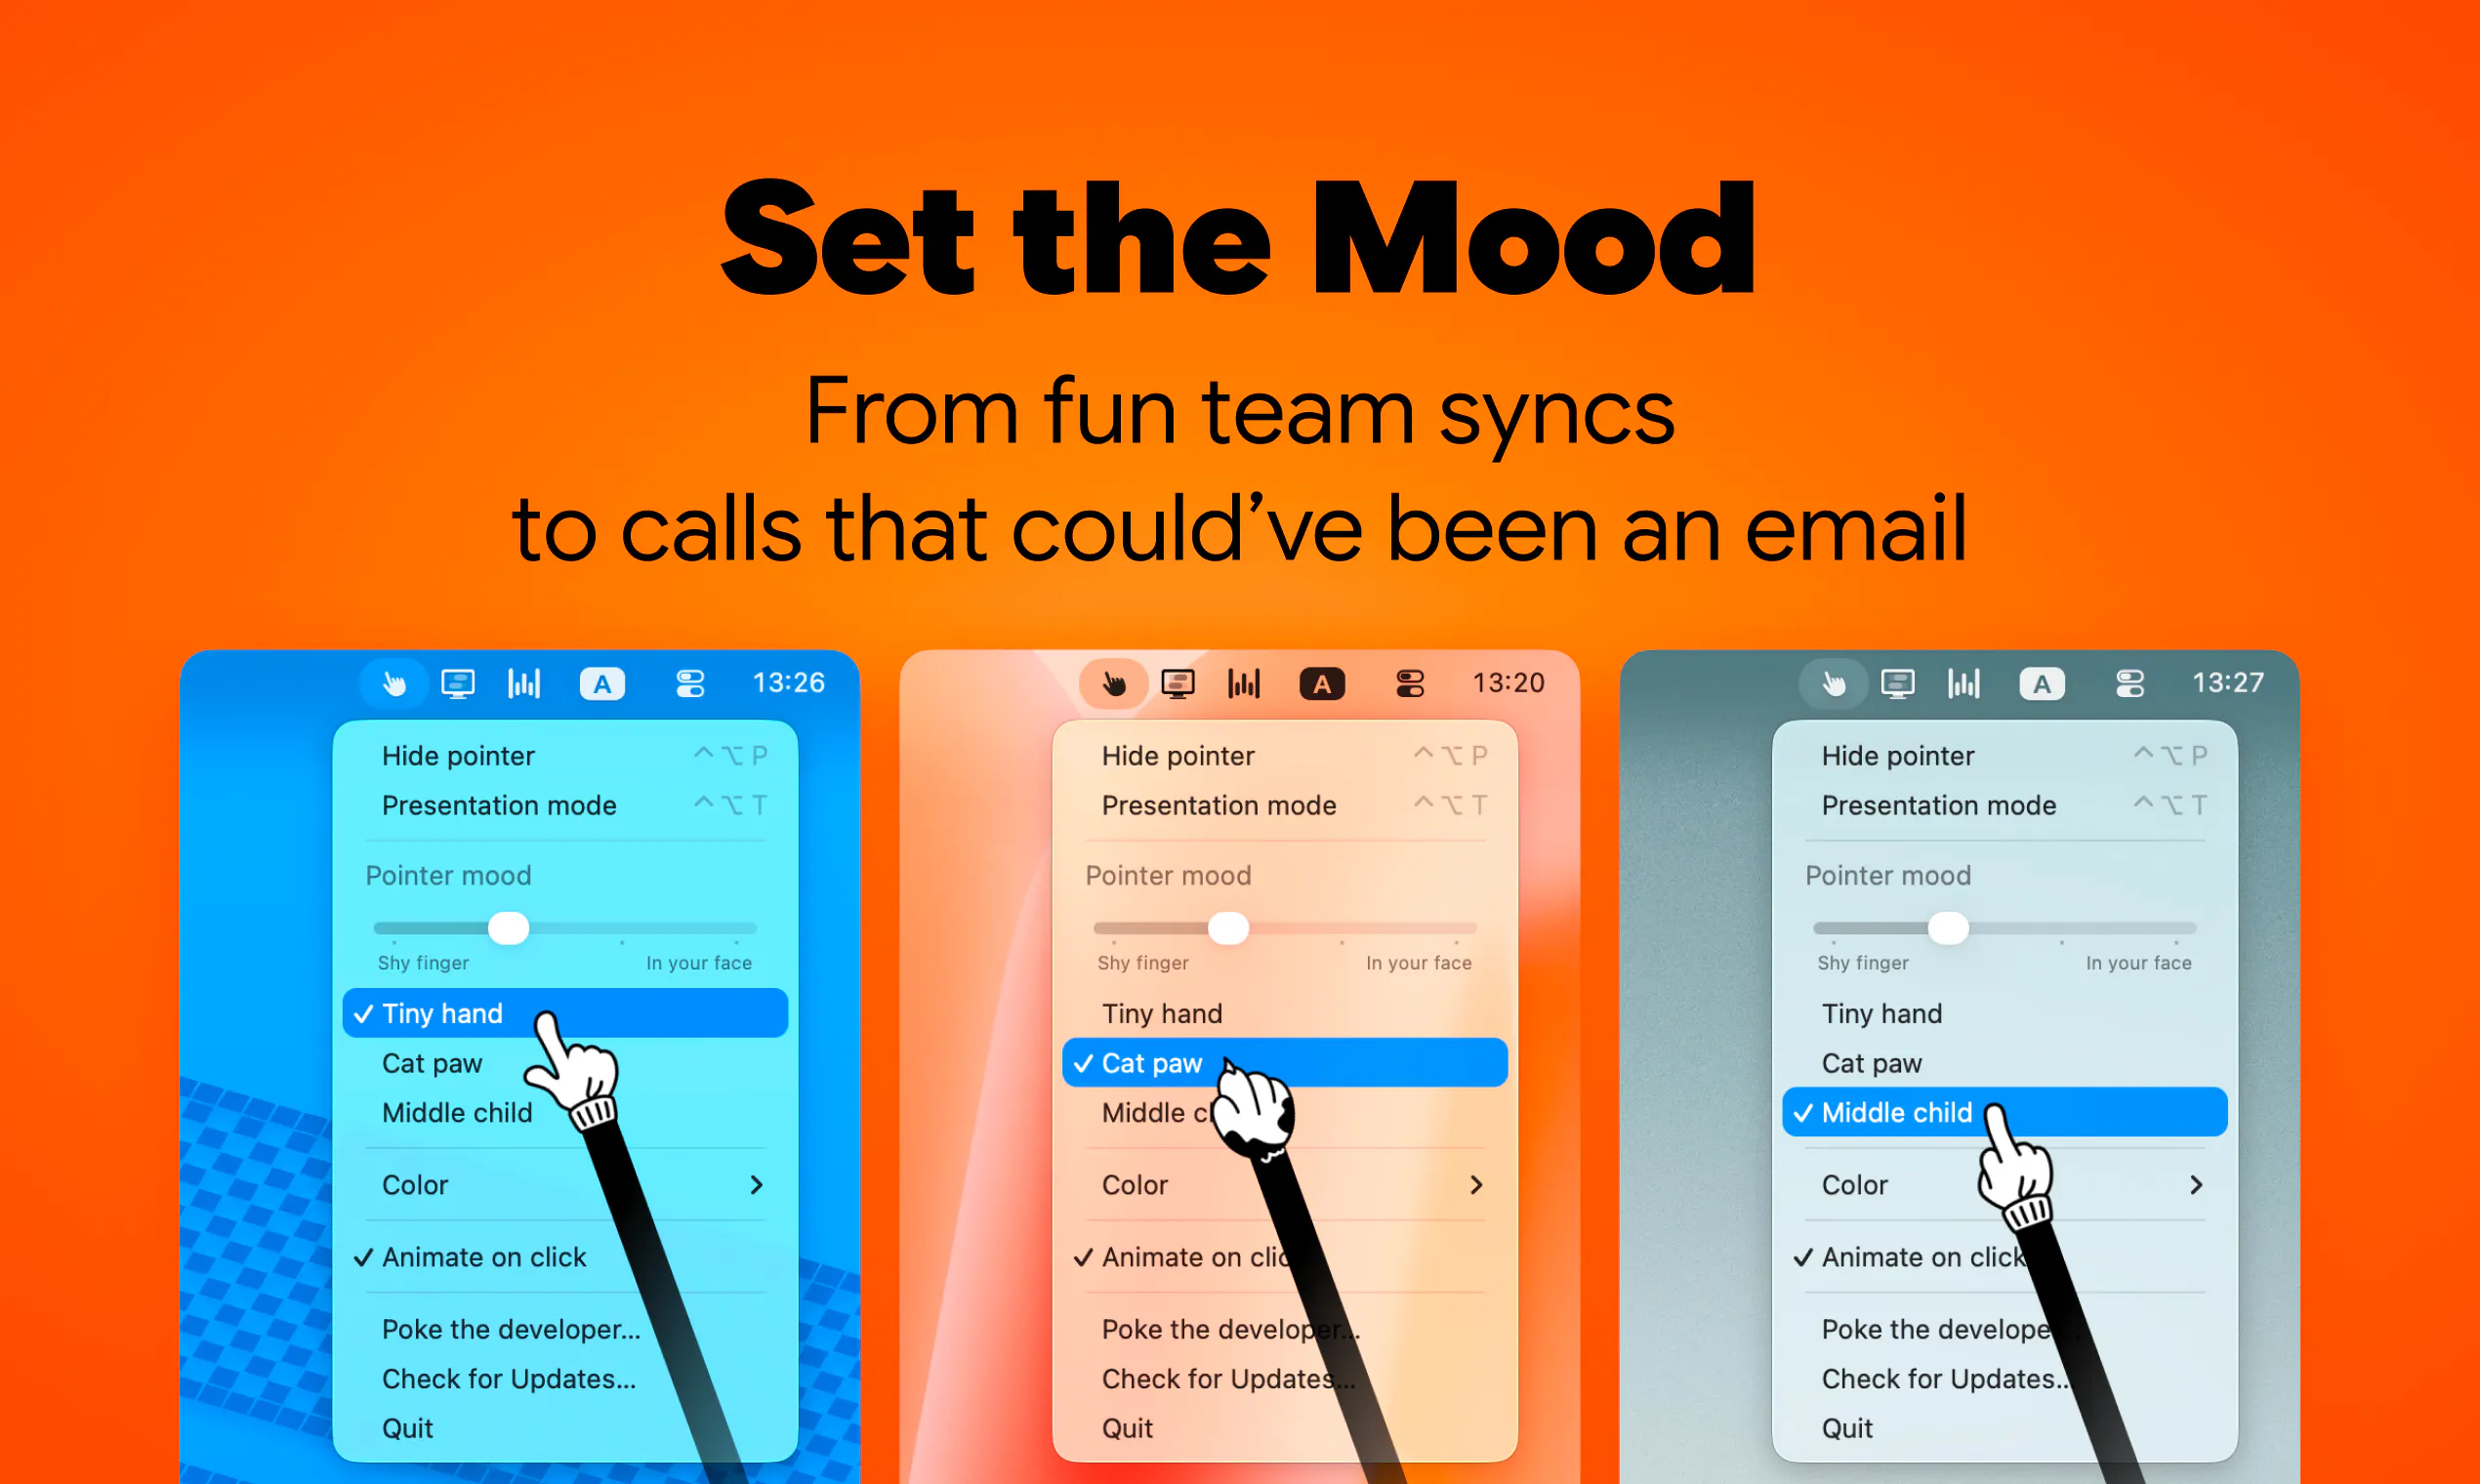
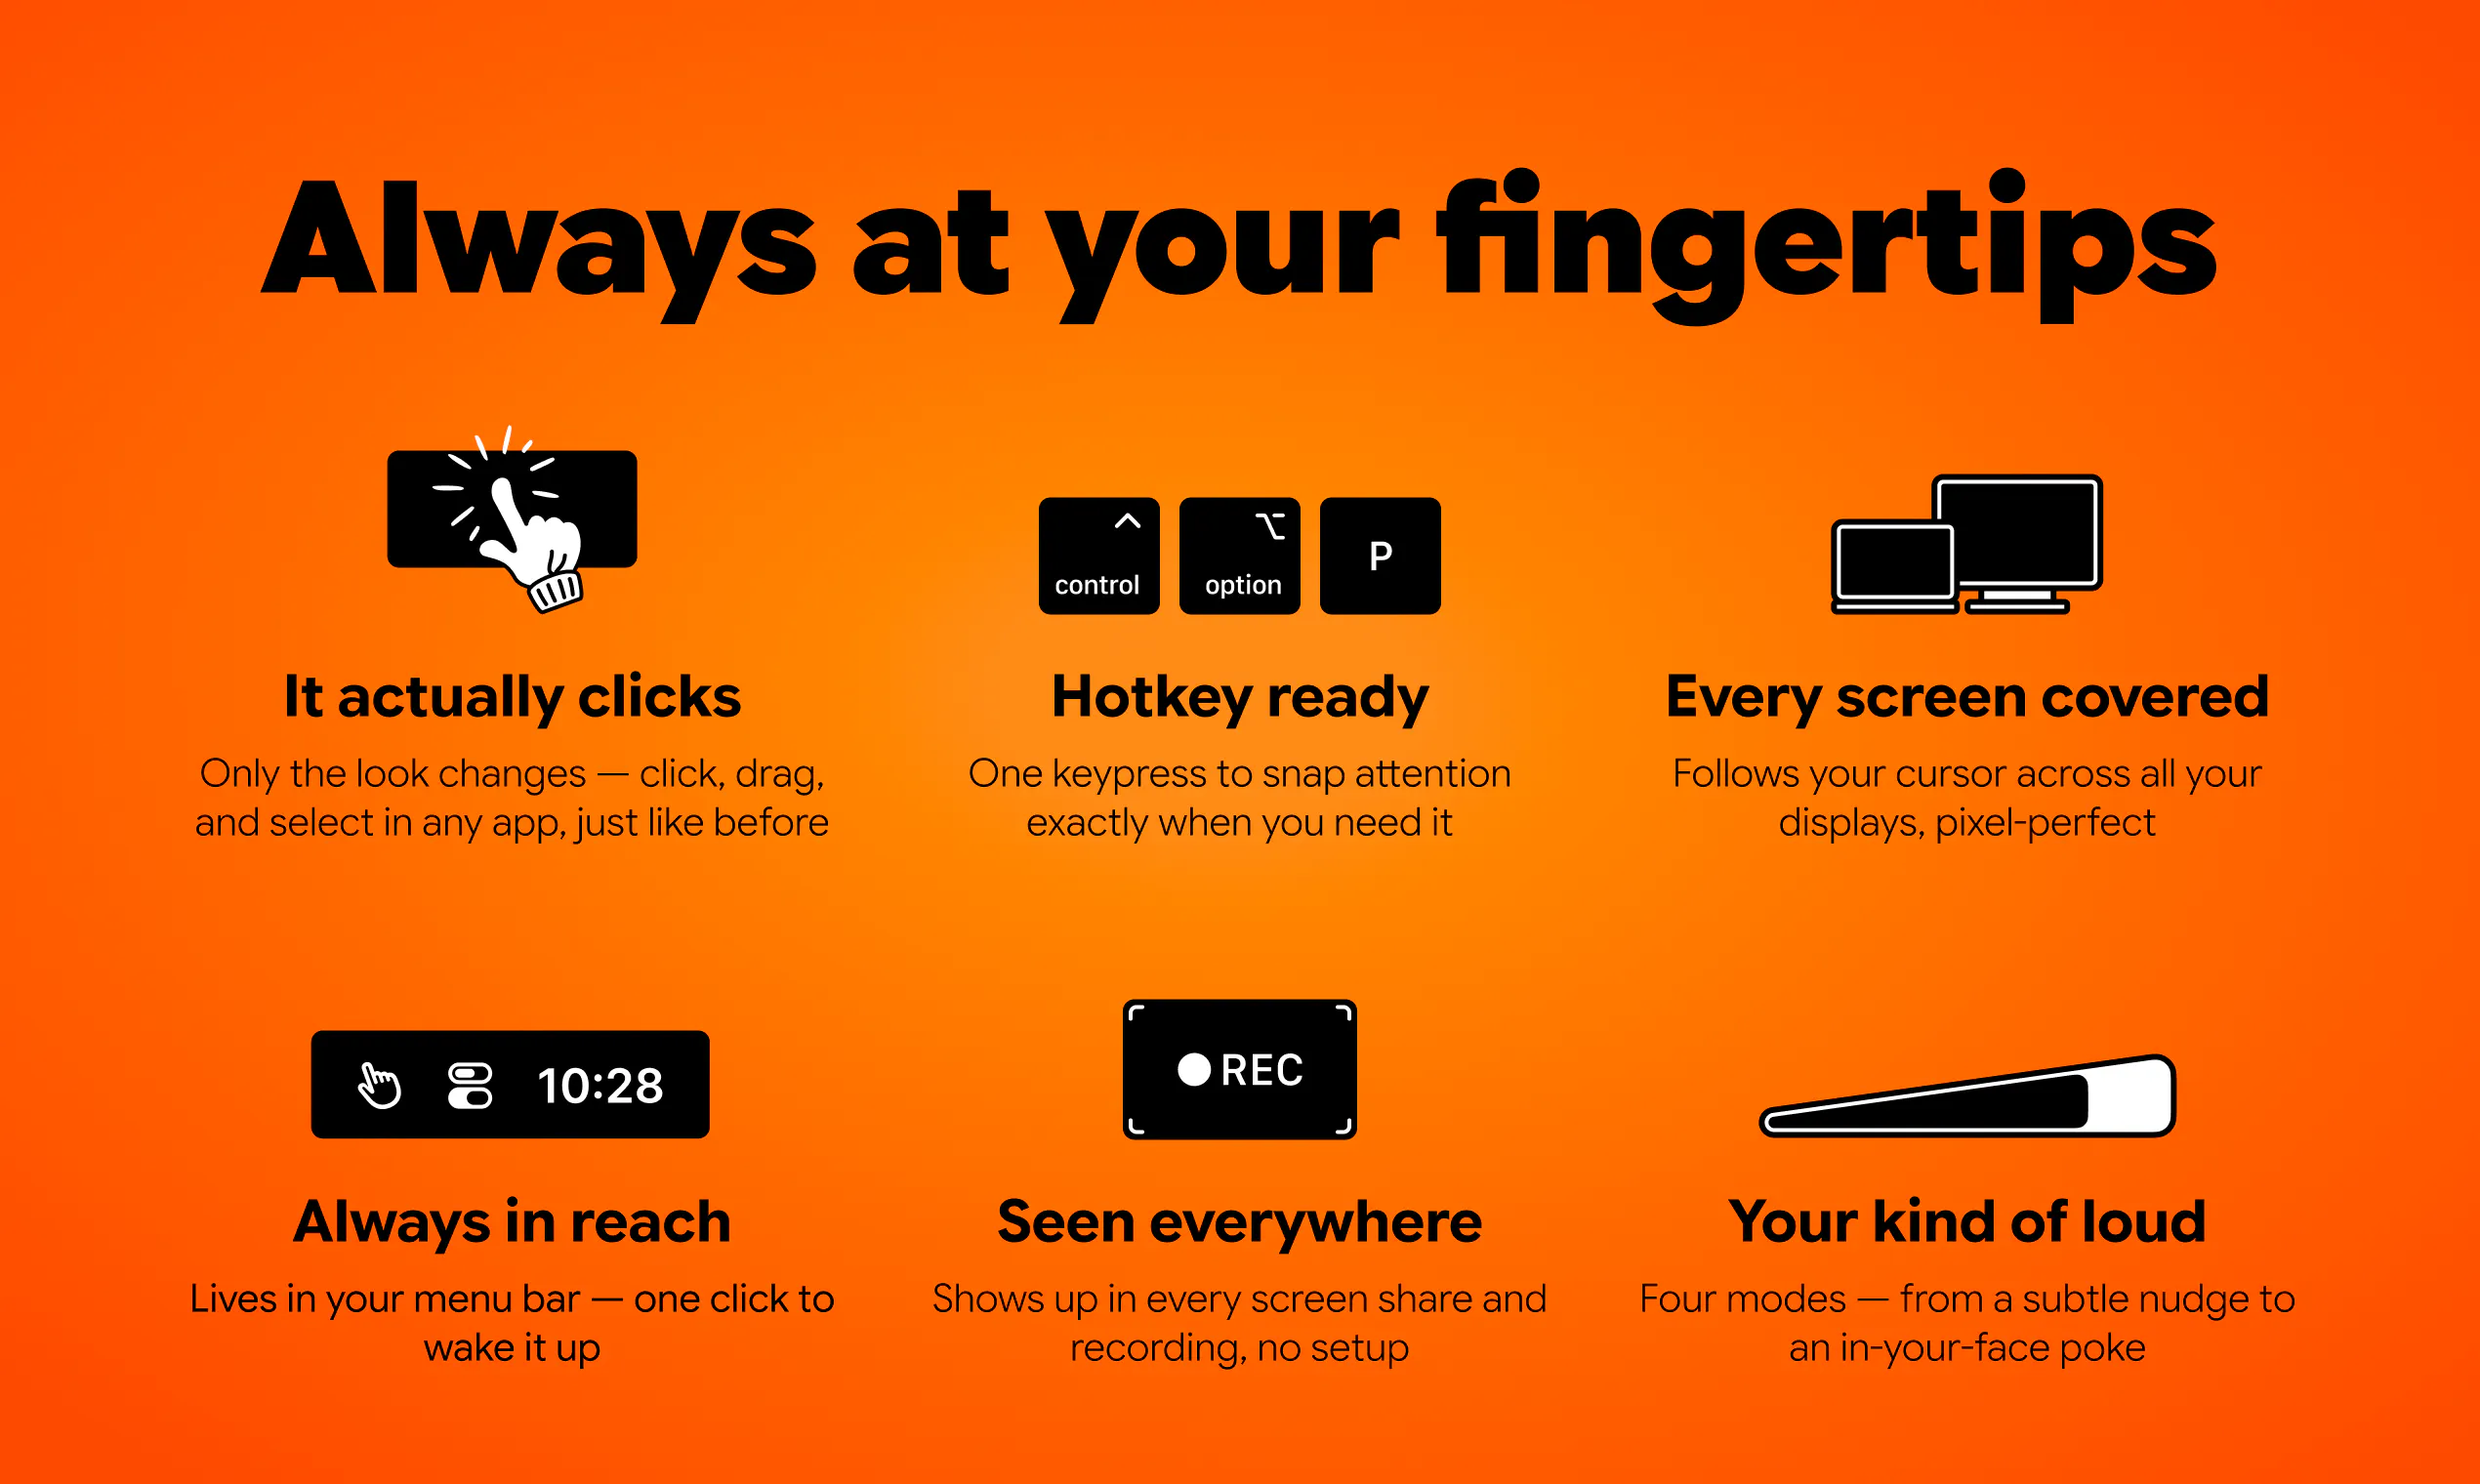
一句话介绍:Pokey是一款菜单栏小工具,通过将系统光标替换成会“敲击”的卡通小手或猫爪等形象,让屏幕共享、团队同步会和销售演示中的操作指示更生动有趣,化解枯燥与尴尬。
Funny
Menu Bar Apps
Memes
macOS工具
菜单栏应用
屏幕共享
光标美化
演示辅助
趣味工具
远程办公
团队协作
会议效率
表情化交互
用户评论摘要:用户普遍认可其趣味性,认为能缓解企业会议严肃气氛、增加说服力。有评论戏称“终于不是AI效率产品”。开发者回应了下载支持。未出现针对功能的负面建议或问题,有效反馈集中在“娱乐价值”认可,但缺乏对价格或稳定性的讨论。
AI 锐评
Pokey的走红逻辑与SlapMac如出一辙——在效率工具泛滥的当下,用“无意义”的趣味性制造社交货币。它精准切中了远程工作中“操作可见性”与“情绪传达”的双重痛点:当你的鼠标指针变成一只会敲击的小手,屏幕共享就从枯燥的“看PPT”变成了带有肢体语言的“表演”,这本质上是一种非语言沟通的补偿机制。
但必须清醒看到,这款产品的价值天花板极其明显。它解决的是“锦上添花”而非“雪中送炭”的问题,核心场景高度依赖“视频会议”这一特定时空。一旦脱离会议场景(如本地演示、编程),其功能即归零。17票的发布数据也印证了其小众属性,这更像是一次个人趣味驱动的微创新实验,而非商业模式的验证。
更深层的风险在于:其核心卖点“情绪适配”(点击力度决定动画幅度)是伪需求——在共享屏幕时,用户注意力集中在内容而非光标的反馈精度上,该功能反而可能因“过度表演”分散听众注意力。至于中指造型,在跨文化、跨层级的商务沟通中更是雷区,很可能从“化解紧张”变成“制造冒犯”。
结论:Pokey是一款优秀的“关系破冰玩具”,但不是一个可持续的产品生意。其真正的价值不在软件本身,而在于验证了“桌面端情绪化交互”的市场空位。若团队能将其能力开放为API,衍生出针对培训、远程医疗等垂直场景的“指示层”工具,或许能突破现有天花板。否则,当新鲜感消退,这枚菜单栏小图标只会沦为Dock栏里又一个吃灰的像素幽灵。
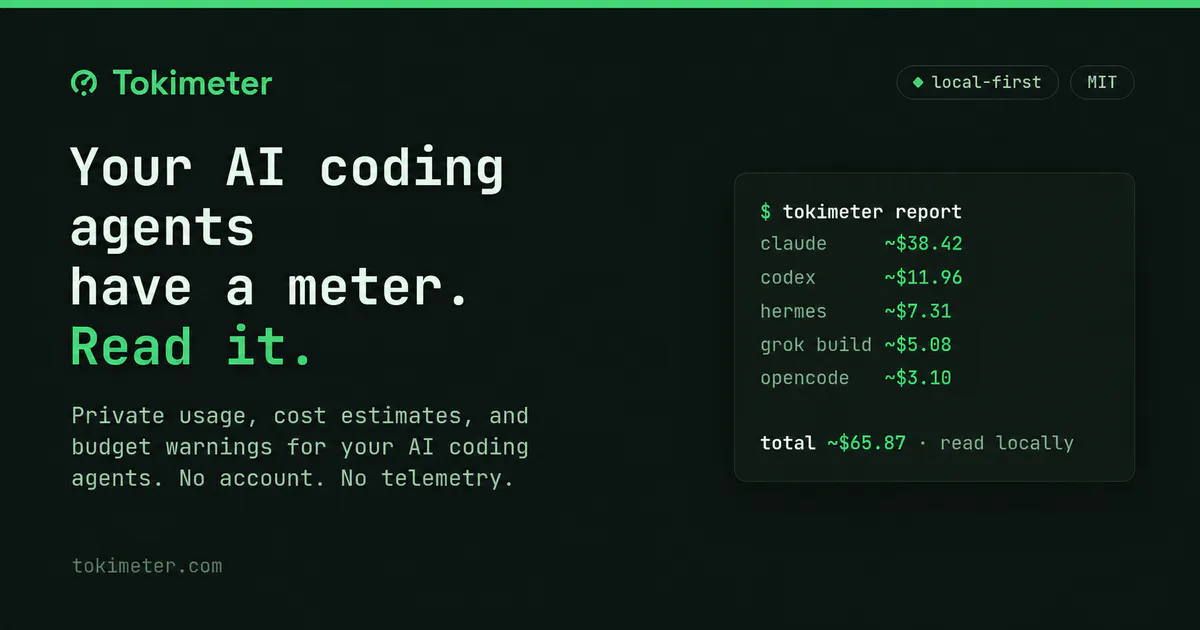
一句话介绍:Tokimeter 是一款本地化的 AI 编程工具用量分析仪表盘,通过读取 Claude、Codex、Cursor 等工具在本机留下的日志,帮你精确统计 token 消耗与费用,并按项目、会话、天、工具和模型多维度切片,解决多工具混用下成本失控、限额无感的痛点。
Open Source
Developer Tools
GitHub
AI编程工具
Token统计
本地优先
用量分析
成本管理
开源工具
CLI
多模型聚合
开发者效率
隐私安全
用户评论摘要:用户@toshipepe 称赞“将全部 AI 用量集中到一处”是天才设计;作者回帖致谢并欢迎大家提问。另一则长评(来自作者自述)详细阐述了使用多工具时“各管各账”的混乱,强调桌面端覆盖和按项目切片的刚需,并提及 Pro 版 $4/月用于跨机同步与历史保留,同时建议后续增加更多工具支持。
AI 锐评
Tokimeter 踩中的是一个真实且迅速膨胀的痛点:AI 编程工具爆发,但每一家都在自己的日志孤岛里记消耗,开发者对整体开支毫无掌控力。它聪明地避开了“自建埋点”的重模式,转而“读取本机已有记录”,这决定了它零成本兼容、隐私安全且有天然的用户信任背书。其开源 CLI 免费,Pro 仅收 $4/月——这定价策略几乎是“以免费换取数据入口,以订阅赚取长期价值”的教科书操作,潜台词是:等用户依赖每月的费用报告后,跨机同步和防日志清理的历史记录会变成刚需。
但必须泼冷水:第一,它不解决问题,只是放大问题——当你有 8 个工具时聚合有用,但若只用 Claude Code 一个工具,价值近乎为零。第二,核心逻辑是“信任本地日志”,而各工具日志格式不稳定,README 也承认有未验证项,维护成本高,一旦某工具更新日志结构,集成易碎。第三,真正的护城河不在聚合,而在“切换成本”——如果未来 Cursor 自带全局用量面板,这类中间层工具会瞬间被边缘化。
价值判断:作为个人开发者或小团队的“记账本”,它足够好用且免费;但作为商业故事,它天花板有限。除非未来它能从“用量报告”进化为“用量优化”,比如自动推荐更低成本的模型替代方案,否则只是时间流水账的高级形态。建议关注其后续对历史趋势分析和多机协同的落地质量,那才是留住 Pro 用户的关键。
一句话介绍:Monolite 是一款让演讲者或活动主办方通过手机扫码即可创建互动问答、投票和词云游戏的活动工具,解决现场观众“只看不参与”的冷场痛点。
Meetings
Maker Tools
Community
互动演示
现场投票
活动工具
观众参与
二维码签到
团队培训
会议互动
游戏化营销
无App参与
SaaS工具
用户评论摘要:用户普遍认可“扫码即玩、无需下载”的体验,认为适合全员大会;创始人回应了感谢,但暂无针对功能缺陷或新增玩法的实质建议,评论深度有限。
AI 锐评
Monolite切中的是“会议冷场”这一高频但低预算的痛点,产品逻辑清晰:用极低门槛(扫码)换取即时参与感,并以数据报告作为B端付费理由。其核心价值不是游戏本身,而是“把被动听众转化为可量化的互动数据”——这在企业培训、内部沟通场景中具有实际抓手。但产品护城河薄弱:同类工具如Slido、Mentimeter早已覆盖问答、投票、词云,Monolite仅靠“Trivia、Versus”等轻游戏差异化,容易被复制。且当前用户评论多为礼貌性祝贺,缺乏真实使用场景的深度反馈,说明早期用户以社交支持为主,产品验证尚浅。真正需要警惕的是:游戏化互动是手段而非目的,若不能嵌入演讲内容流(如自动同步PPT进度、跟进答题结果触发分支讲解),则很容易沦为“热闹但无后续”的暖场玩具。此外,免费模式下的规模瓶颈明显——企业客户一旦需要复杂度较高的定制或私有化部署,Monolite现有能力可能不足。建议聚焦细分垂直场景(如大型培训机构的课堂互动),而非与通用工具全线竞争。
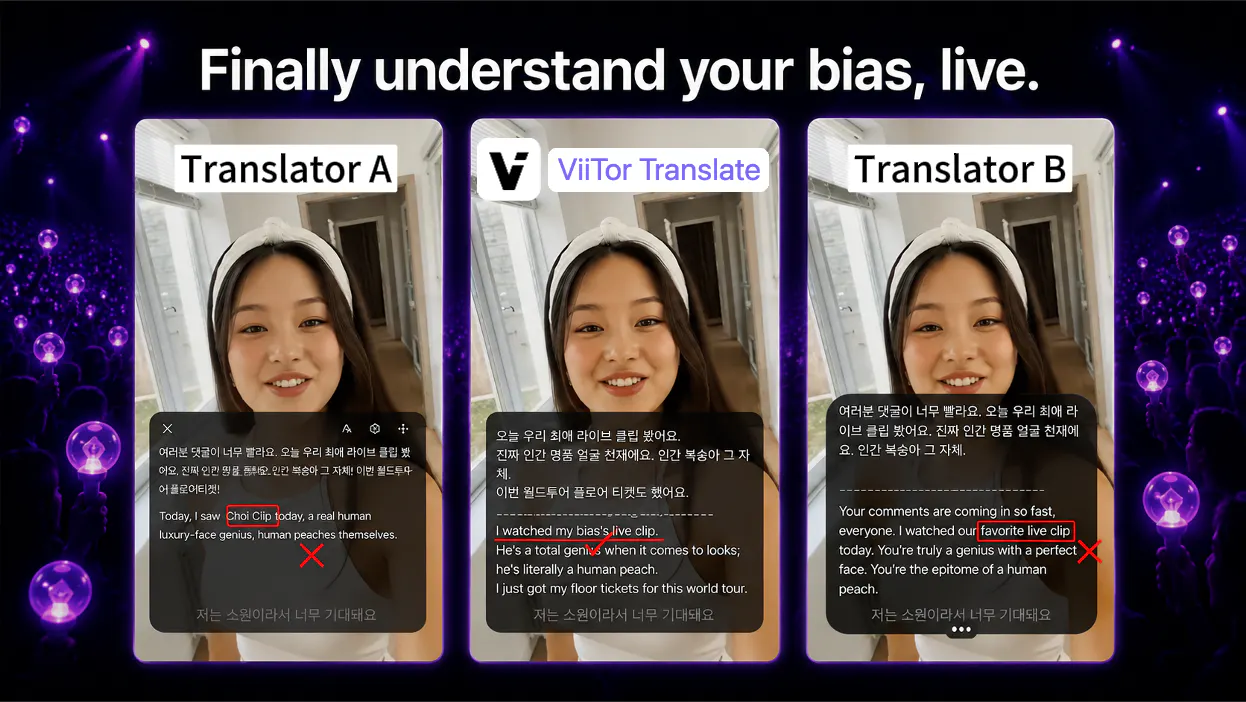
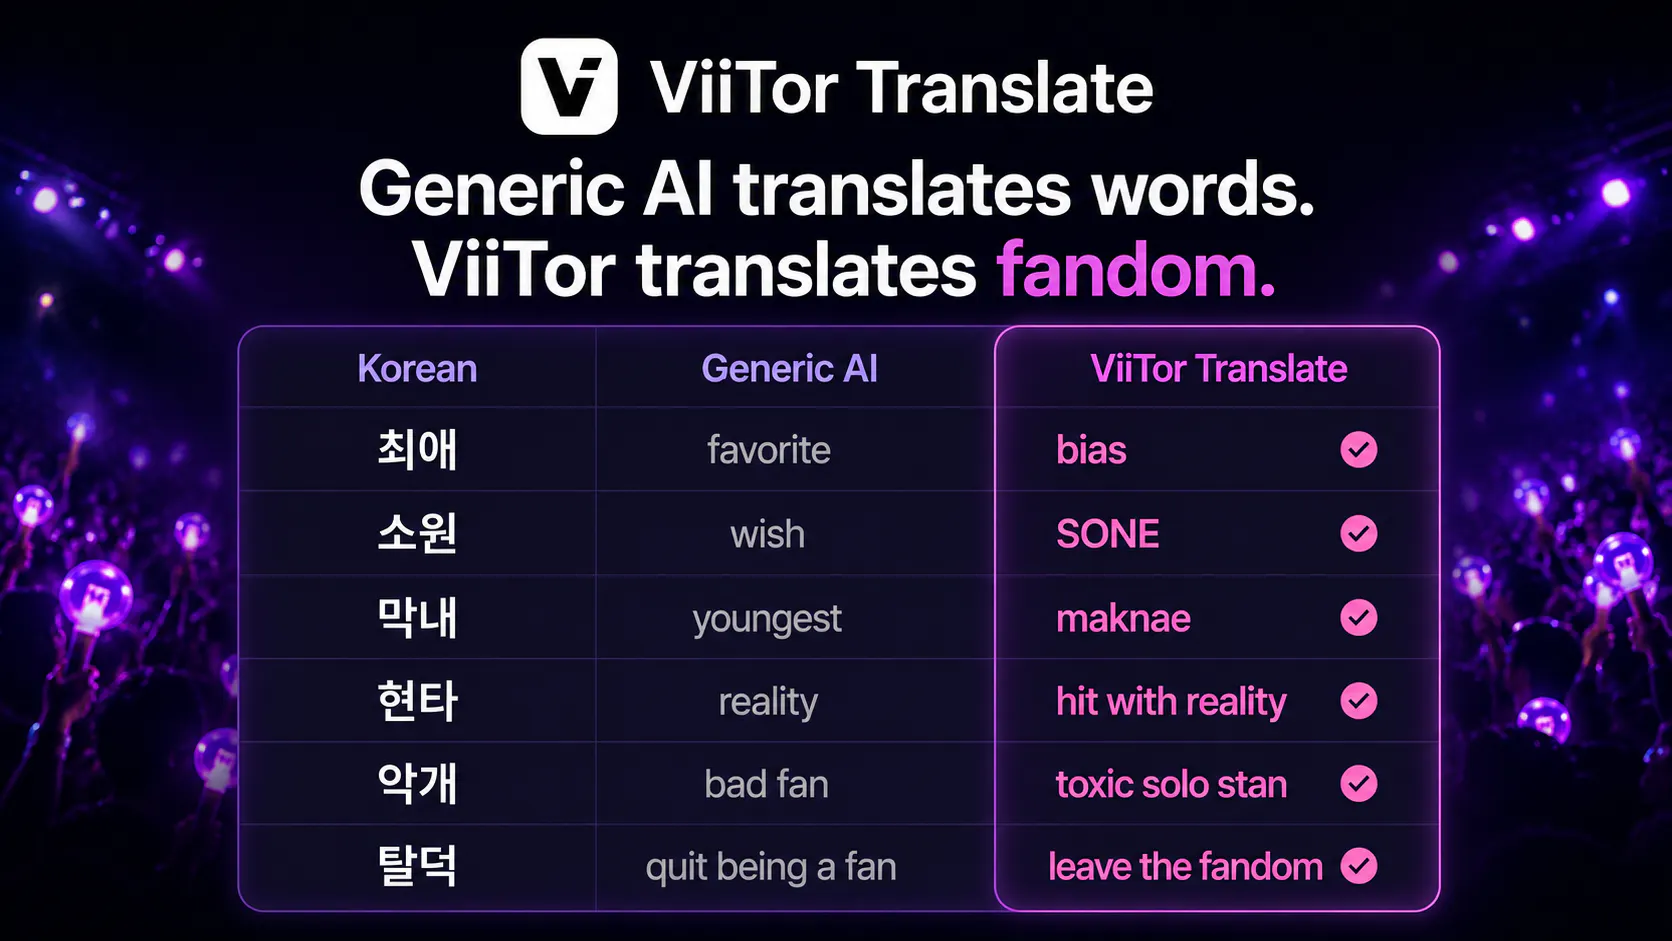
一句话介绍:ViiTor Translate 是一款为直播、视频、会议和课堂提供实时翻译字幕的跨平台工具,核心解决用户在观看快语速、高语境内容(如K-pop、VTuber、动漫)时,因翻译滞后或失去文化语境而错过精彩瞬间的痛点。
Productivity
Languages
Artificial Intelligence
实时翻译字幕
直播字幕
视频翻译
跨平台应用
语境理解
俚语翻译
粉丝词典
多语言支持
K-pop工具
VTuber字幕
用户评论摘要:用户Zoe(产品经理)自述是K-pop与VTuber粉丝,强调Fan Dictionary和双语言模式是亮点。另一条有效评论指出:实时性与语境存在天然矛盾——日语等动词居尾语言中,过早“承诺”翻译可能翻转语义。质疑系统是否会修正已显示的字幕,还是选择延迟输出,并指出修正虽准确但阅读体验更差。
AI 锐评
ViiTor的定位很聪明:它没有试图做“更好的Google翻译”,而是切入了“实时+语境”这一窄缝。但恰恰是这个缝里,藏着它最危险的暗礁。那条关于日语的评论一针见血——这不是技术细节问题,而是产品承诺的根本悖论。如果你保持低延迟,就必须在句子未完整时做出语义猜测,这在动词后置语言中几乎必然产生“反向翻译”时刻;如果你为了语境而等待从句闭合,那“实时”就成了伪命题。评论者指出“修正是更准确但更难读”,这恰恰点中了ViiTor的软肋:它可能优化了算法的延迟,却把认知负担甩给了用户。
从产品层面看,Fan Dictionary是更务实、也更可防御的壁垒。它利用圈层用户的自组织能力去补足通用模型的文化盲区,这是一个比“翻译快”更难被大厂复制的资产。但问题在于,当前12票的冷启动氛围表明,它尚未在核心用户群中形成口碑裂变。Zoe的K-pop/VTuber叙事很动人,但如果产品真想服务会议和课堂,就不得不直面更严苛的实时改写需求——那时日语只是第一道考题,德语的长从句、阿拉伯语的省略结构都在排队等着。
真正的价值点或许不在于“翻译得多准”,而在于“如何管理用户期待”。ViiTor需要明确的交互模式:让用户主动选择“极速模式”(尽早输出,允许翻转)或“完整模式”(稍慢但整句正确)。敢把这个取舍摆上台面,比继续用“context”这个词掩盖矛盾,更能建立信任。目前来看,它是一把磨得很亮但只切开了粉丝圈层的刀——想成为通用工具,得先把那把关于“等待与背叛”的刀刃处理好。
一句话介绍:Curate是一款无广告、无算法的影书剧统一追踪工具,让重视品味的用户摆脱碎片化笔记,在一个安静空间里记录并发现真正值得看的内容。
Productivity
Social Media
Entertainment
影音书籍管理
兴趣追踪
无算法推荐
人文发现
品味社交
书影合集
跨媒体收藏
独立开发
反沉迷设计
Product Hunt新品
用户评论摘要:用户高度认可其替代手机备忘录的实用性,并称赞精选合集功能有效减少了“选择瘫痪”。核心问题集中在导入兼容性(已支持Letterboxd/Goodreads,但缺CSV和IMDb)及对“好友品味匹配”社交功能的急切期待,创始人回应称将基于真实数据谨慎开发,并预告内容页社交层即将上线。
AI 锐评
Curate踩中了当下内容消费领域一个精准的痛点:工具碎片化与算法暴政。将电影、书籍、剧集统一收纳,并刻意剔除点赞、评论和算法推荐,这不仅是功能减法,更是一种清晰的产品哲学——对抗注意力经济,回归“人的品味”。其“先记录,后匹配”的克制策略尤为明智,避免了多数社交产品上线即死于垃圾数据或虚假关系的窘境。从用户反馈来看,其核心吸引力并非“管理”,而是“精选合集”带来的策展价值,这远比追踪功能更具粘性。然而,隐忧同样明显:无算法意味着冷启动依赖人工策展,其可扩展性存疑;且轻社交若缺乏足够用户密度,极易沦为私密笔记工具,难以形成网络效应。11票的启动量虽小,但社区氛围纯粹。Curate真正的赌注在于,它能否在“小众精致”和“规模破圈”之间找到平衡——如果好友匹配机制生效,它有机会成为品味共同体的基础设施;如果流于形式,则不过又是一个漂亮的自我感动型产品。目前来看,它值得被严肃对待,但需要更锋利的增长引擎。
一句话介绍:为独立创作者和一人公司提供50个交互式计算引擎,在浏览器中实时模拟定价、流失、广告支出与MRR等核心财务指标,终结创作者经济中的“拍脑袋”决策,用数据模型替代盲目试错。
Productivity
Marketing
Notion
创作者经济
财务计算器
定价优化
MRR预测
用户流失分析
广告ROI
独立开发者工具
SaaS套件
交互式决策引擎
商业建模
用户评论摘要:用户认可其直击创作者财务盲区(如流失率计算器促使重审定价),认为解决了“只看虚荣指标”的问题。有反馈指出UI交互需优化,整体期待工具实用性而非展示。
AI 锐评
这款产品的切入角度很准——创作者经济里最泛滥的是“教人赚钱”的课程,最稀缺的是“算清自己赚多少”的工具。用50个轻量级HTML/JS引擎替代臃肿的Excel,本质是把“财务建模”这种专业能力降维成拖拽滑块的游戏化操作,这确实是刚需。
但必须泼冷水:第一,9个投票暴露了首发热度极低,而产品上架即面临最大质疑——这50个计算器究竟是“决策引擎”还是“高级换算公式”?很多所谓的“定价、流失、广告优化”模型,如果底层逻辑只是标准公式套壳,那对一个有经验的运营者而言,其价值远不如一张精心设计的Google Sheets,因为后者可定制、可追溯、可迭代。
第二,商业模式看似聪明(29美元买断+商用授权),实则尴尬。面对C端创作者,这个价格高于多数SaaS订阅;面对B端咨询师(商用授权),其计算精度和模型深度又不足以支撑专业服务的可信度。它处于“散户嫌贵、专业嫌浅”的夹缝中。
真正的价值锚点在于“实时反馈”带来的认知冲击——让创作者亲眼看到“加价10%对LTV的影响”或“广告投入20美元后的盈亏平衡点”,这种可视化比任何理论都更能促进行为改变。但若想突围,必须从“通用计算器合集”进化成“垂直场景的决策中枢”(比如专门为Substack作者或Patreon创作者定制),并公开至少1-2个核心模型的推导逻辑来说服专业用户。否则,这更像一次精准的“财务启蒙工具”尝试,而非可持续的产品。
Pretty good idea .. Up until now I only see this in gmail, but with this product it is possible to expand.
Draft mode is the right default, and it also makes precision the entire product. If I open the folder and 4 of 15 drafts are worth sending, I stop opening the folder by week two and the 4 good ones die with the rest. I'd trade recall away hard for that, something like only flag threads where I asked a direct question and got silence for five days, because two right nudges a week beats fifteen maybes.
Love the idea. One question though—how does NudgeForMe decide which conversations actually need a follow-up versus threads that are intentionally left unanswered? Curious about the intelligence behind that
Congrats on the launch @chitreshsingh
Draft mode before any send is the right call. What I want to know: does it look for actual signals in the sent message, like a question or an explicit request, or is the detection purely time-based? A thread that ended with 'thanks, talk soon' should not queue a nudge. Those are easy to misread as cold.
So, basically this app will also ready my OTPs and Sensitive Codes in my mail box I guess?
the detection quality questions in here are all good ones, but the thing I haven't seen asked yet is what happens to the actual email content once it's scanned. reading sent conversations well enough to tell "thanks, talk soon" apart from a real dropped thread means an LLM is seeing the full text of my client emails and partnership deals, not just headers or timestamps. is that content processed and then discarded, or retained/logged anywhere on your end? for a tool sitting on my entire sent folder that's the question I'd want answered in writing before connecting a real inbox, not just "draft mode by default."
Ooh this is nice. Follow ups are a huge case for AI!
Anything the Snoooz team creates you can count on being top quality and probably the best support you've ever received for a product. I've been with them for over a year and @victoria_dash is an absolute super star. These guys are experts with anything email and at the end of the day, email is our biggest relationship management and sales system because it's personal. Wishing you guys so much success with this launch. From a very happy Snoooz user ❤️🚀
Great product. I have already implemented this into my daily use. It found 2 two deals I neglected to follow up on. Just paid for itself in the first week.
Bruh gets access to my mailbox? So I am not only giving away data to them but also their AI providers? Interesting.
Congratulations on the launch. This looks very interesting. I'm going to sign up for it soon.
The tone matching is the part everyone's asking about, but I'd worry more about false positives, threads that look unanswered but weren't actually waiting on anything, like a "sounds good, thanks" that just didn't need a reply back. How does it tell that kind of silence apart from someone actually going quiet on you?
This looks built for warm threads, and what I'd worry about is someone pointing it at a cold list. No reply is the normal case there, so it drafts a nudge for nearly everyone, out of the one mailbox they cannot afford to burn. I keep cold sending on a separate warmed domain for that reason, so does it tell a quiet thread apart from one that was never warm?
Draft mode protects you at draft time. The risk lives at send time.
The draft exists because nobody replied. Then you open the folder tomorrow and some of those people have answered, just not in that thread. On the phone, on LinkedIn, in a new thread with a different subject. Sending just checking in to someone who already replied is the one follow-up that actually costs you the relationship, and it is worse than never following up at all.
So the check I would want sits at send rather than at generation. Re-verify the condition that created the draft, right before it goes out: nothing new in this thread, no newer message from that address anywhere in the mailbox, no meeting with them since. Cheap to run, and it is the whole difference between a stale draft and an embarrassing send.
Does it re-check anything at the moment you press send, or is the decision made when the draft is written?
I have a question, right now draft mode is auto enabled with Gemini specially if you are using google workspace, so what is differentiator?
Starting in draft mode instead of auto-send is the detail that'd make me actually trust this with real leads.