PH热榜 | 2026-08-13
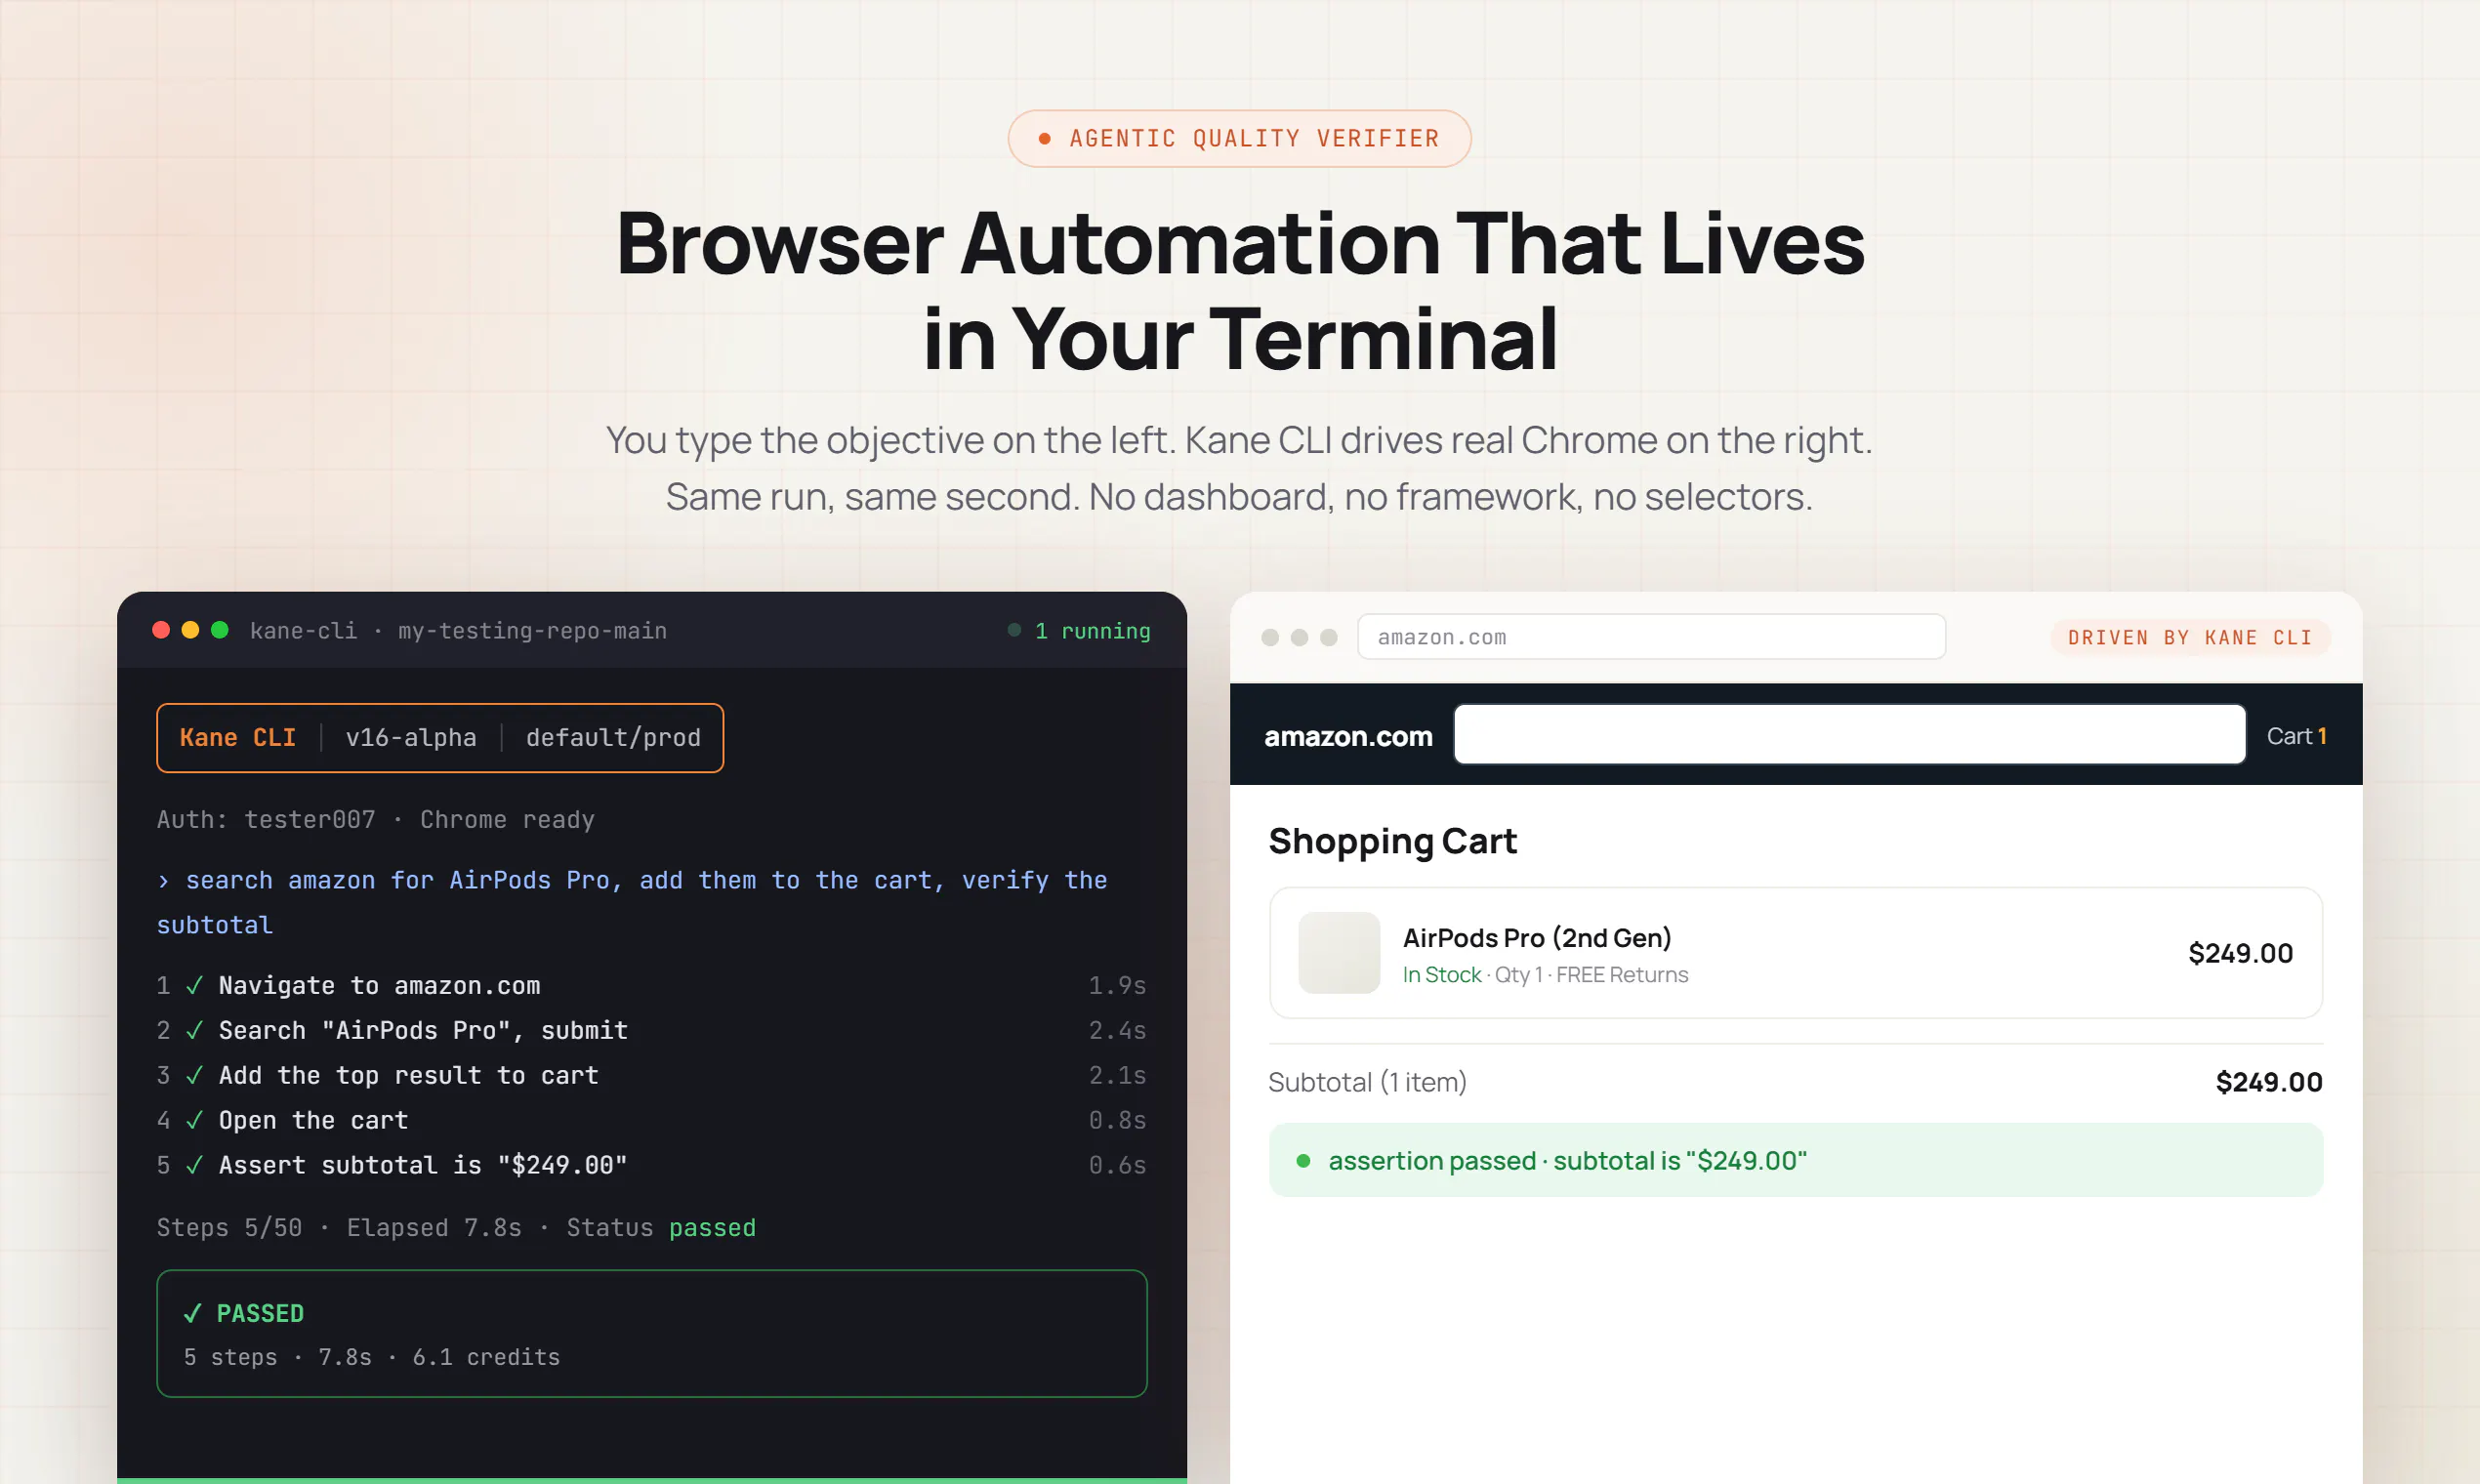
一句话介绍:Kane CLI 是一款面向开发者与AI编码代理的自然语言测试工具,让用户用一句日常英语描述测试目标,即可在真实Chrome浏览器或移动端模拟器中自动执行并返回“通过/失败”结论及可分享的证据包,省去编写和维护选择器的繁琐工作,解决“AI写代码快、验证慢”的信任瓶颈。
SaaS
Developer Tools
Artificial Intelligence
AI测试代理
自然语言测试
浏览器自动化
移动端测试
开发者工具
质量验证
本地优先
证据包
回归测试
Agent原生
用户评论摘要:用户普遍认可其“证据包+确定性回放”模式,认为解决了AI生成代码后的验证痛点。有效问题包括:PRD上下文理解上限(官方回应称靠场景分解而非长提示)、与Claude in Chrome的差异(回应强调导出确定性用例与CI集成)。早期用户还将其用于PR CI关键路径检查和自动化日常事务,惊喜用例是咖啡订购。
AI 锐评
Kane CLI踩中的不是“测试工具”赛道,而是AI编程时代“信任生产”的真空地带。其真正野心并非替代Playwright或Selenium,而是将“质量确认”从人工主观判断重构为一种可机器读取、可证据追溯、可确定性回放的客观协议——这恰好是AI Coding Agent规模化落地时唯一缺失的闭环。产品设计有几个极为刁钻的切入点:一是“Agent原生”而非“用户友好”,让Claude Code等代理能直接消费NDJSON输出并自主迭代,意味着它绑定的是下一代开发范式而非某个IDE;二是“确定性回放”策略,将一次性的AI探索固化为可重复执行的回归资产,既解决了AI行为的随机性,又为CI/CD提供了合理解释;三是“本地优先+免费起步”的获客逻辑,直接降低了企业尝鲜的信任成本。但风险同样明显:自然语言测试的门槛虽低,复杂业务流的状态管理、异步逻辑和跨域认证场景的“确定性”将面临严峻考验;且市面上已有Playwright MCP等替代路径,若Kane的智能生成质量与手工编写的Playwright代码差距过大,则“AI生成测试”可能只是另一层技术债。其真正的护城河,或许不在于自然语言转代码的模型能力,而在于围绕“证据包+AC覆盖率+测试管理器”构建的资产沉淀体系——但这需要足够的用户规模来验证是否真的产出了可量化的工程效能提升,而非仅仅停留在Demo演示的惊艳瞬间。
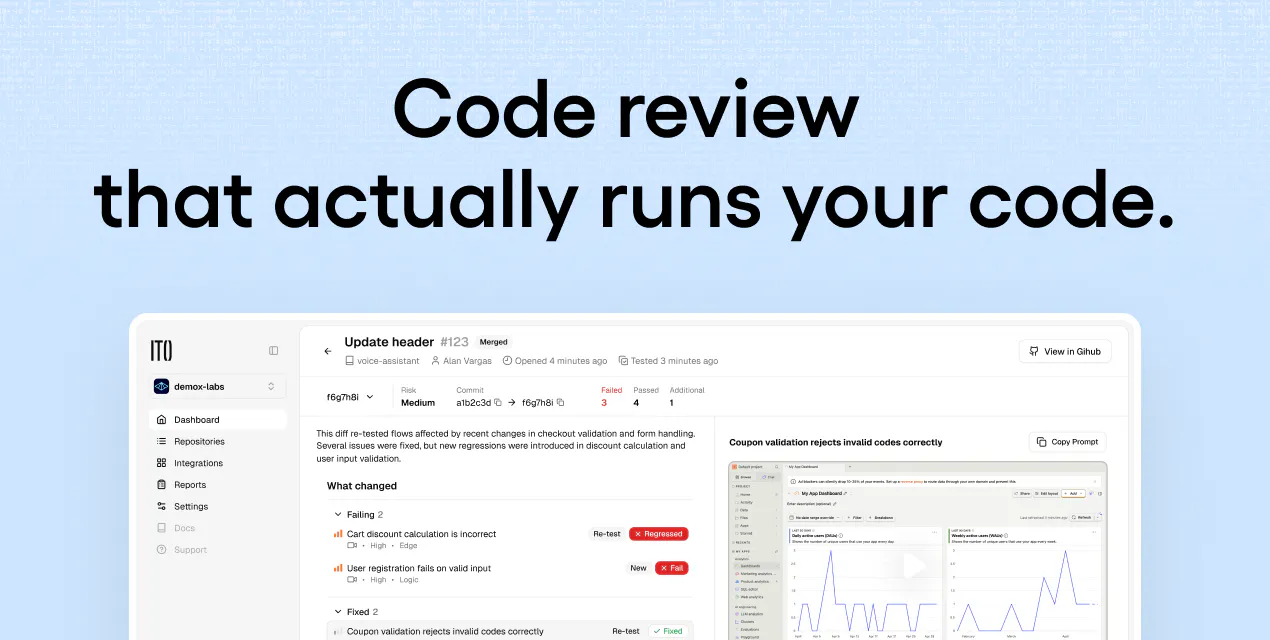
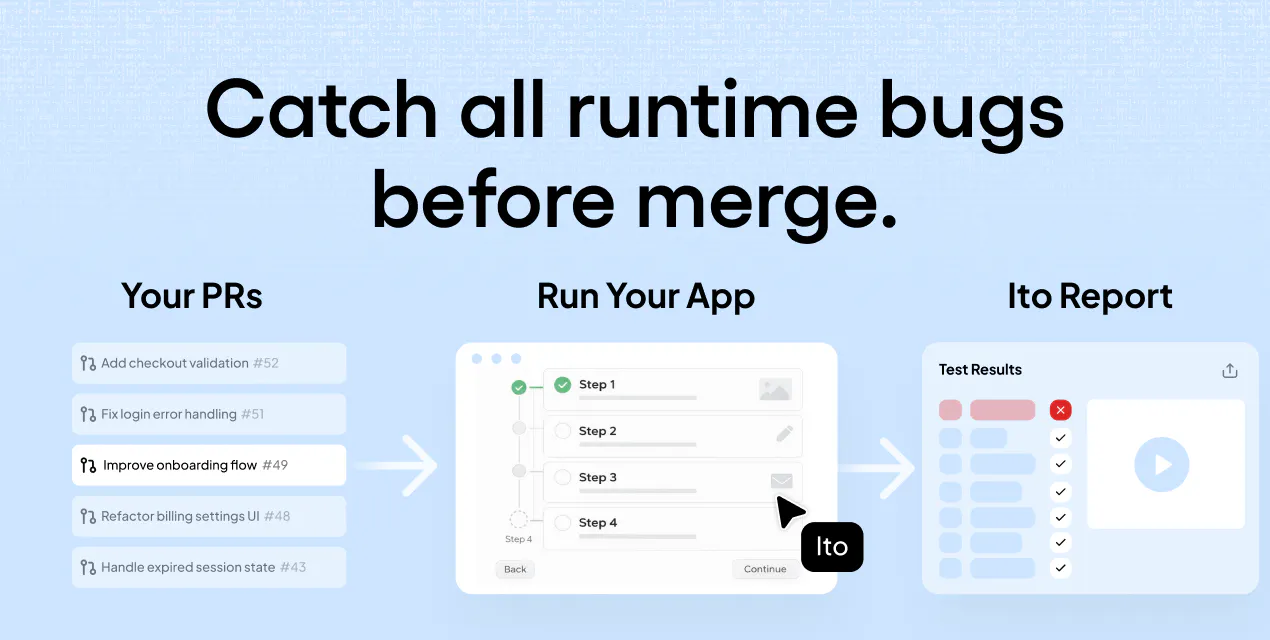
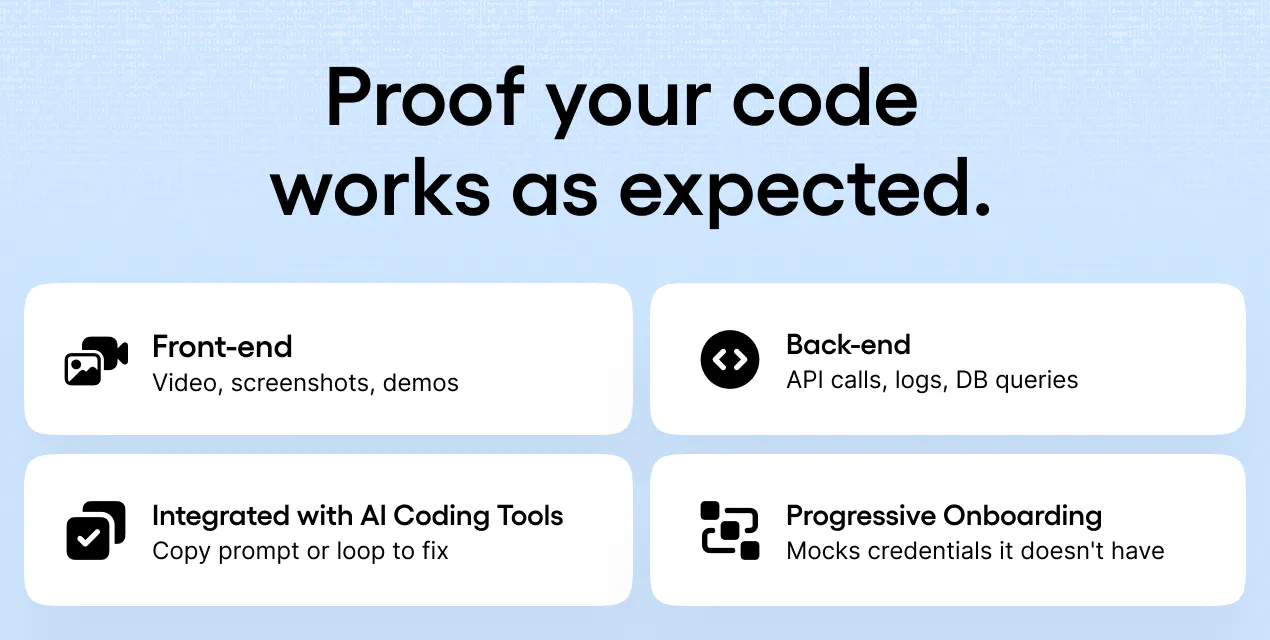
一句话介绍:Ito是一款在代码评审前真正运行应用的AI审查工具,通过为每个PR创建临时环境并驱动代理执行测试,用运行时证据捕获静态分析与纯模型审查遗漏的深层Bug。
Developer Tools
Artificial Intelligence
GitHub
AI代码审查
运行时验证
临时环境
代理测试
自动化测试
开发者工具
CI/CD
质量保障
开源支持
DevOps
用户评论摘要:用户肯定其运行时差异化价值,但核心质疑集中在mock数据可信度(是否明确标记)、环境启动失败时反馈机制、与Greptile TREX的对比,以及非工程师“无需审批即可发布”场景的独立价值。团队回应强调信任机制与执行优先,但部分问题未获解答。
AI 锐评
Ito的切入点精准命中了AI生成代码潮下的信任危机——当代码产量超出人类审查带宽,传统静态工具仅能提供“预测”,而Ito用临时环境将预测转化为“观察”,这确实是对评审范式的革新。但产品的真正护城河并非AI代理或测试编排,而是它刻意回避的“环境搭建”这个脏活累活,恰如创始人所言,这是DoorDash级团队都耗不起的工程黑洞。
然而,锐评必须指出三个隐忧:其一,mock与真实服务的边界虽声称透明披露,但“窄依赖mock”的策略在复杂分布式系统中极易被绕过,一旦误判为“通过”将比静态分析产生更具欺骗性的安全幻觉;其二,产品宣称“运行代码”却面对大量依赖云服务、私有证书的现代应用时,环境复现的保真度天花板低,评论中“容器起不来时报告什么”的尖锐问题仅得到emoji级别的回应,暴露了失败模式的沟通粗糙;其三,定价策略看似友好(前100次免费,开源免费),但“运行速度越用越快”的自我学习能力是把双刃剑——它可能固化了测试路径的惯性,削弱对新异常模式的探索。值得注意的是,评论中“非工程师无权限审批即可发布”的洞察点破了产品更深层的价值:它不仅是代码审查工具,更是重构软件发布权力结构的潜在杠杆。若Ito能成为事实上的运行时验证标准,那么“谁有权上线”的决策将从人转移到工具生态。但在此之前,它需要先解决“看起来可信”与“实际可信”之间的鸿沟。目前,它证明了方向,尚未证明可规模化地精确。
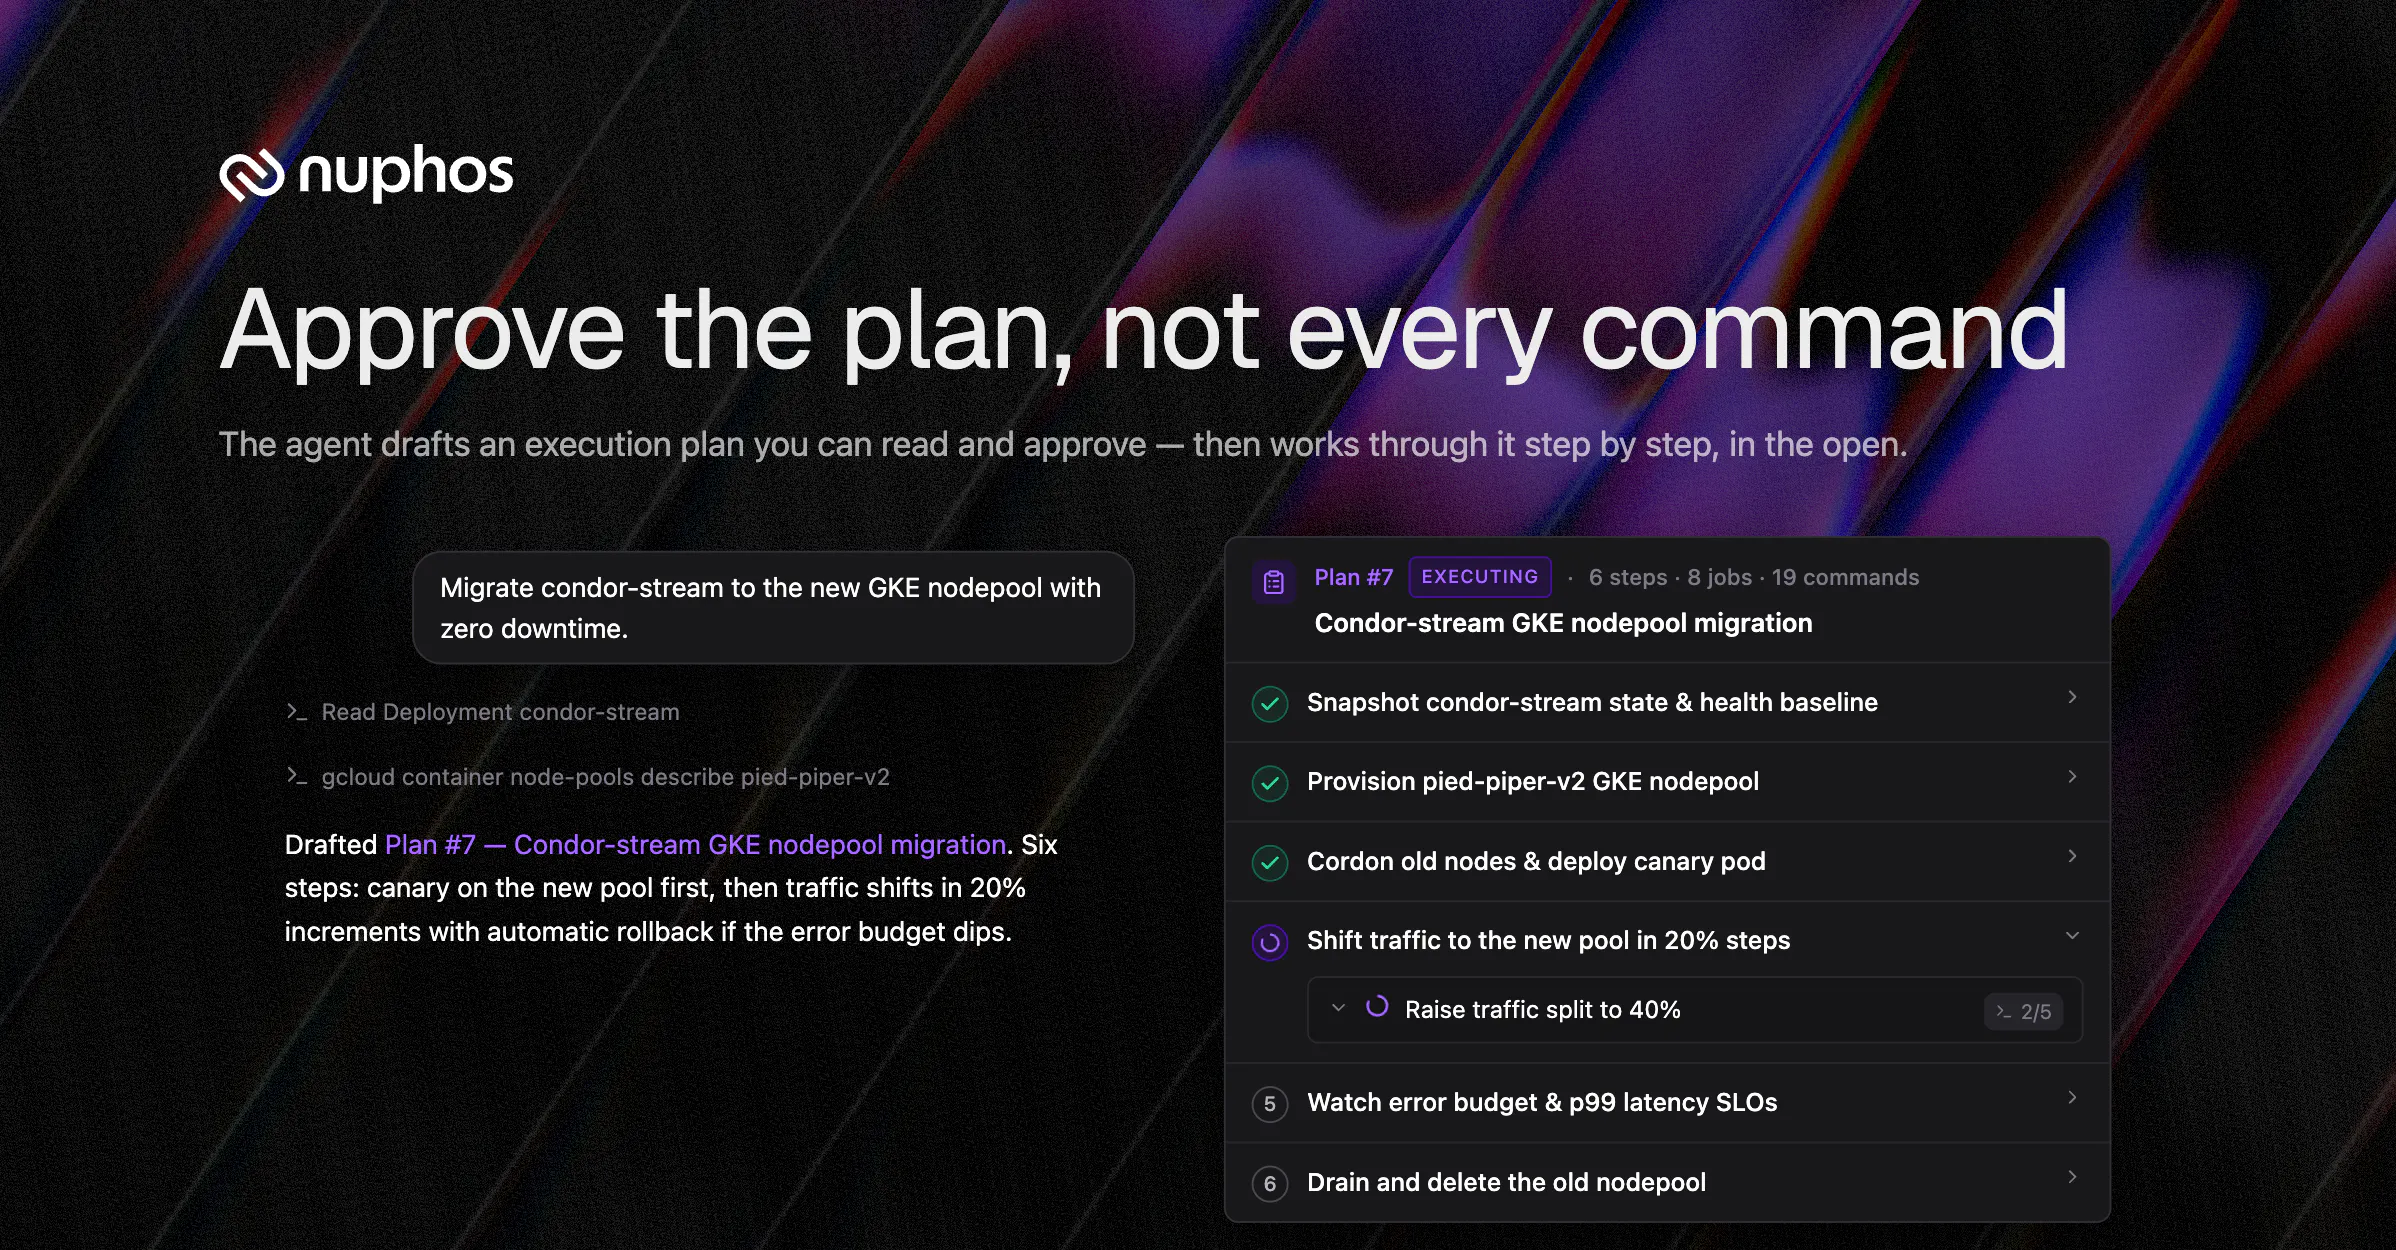
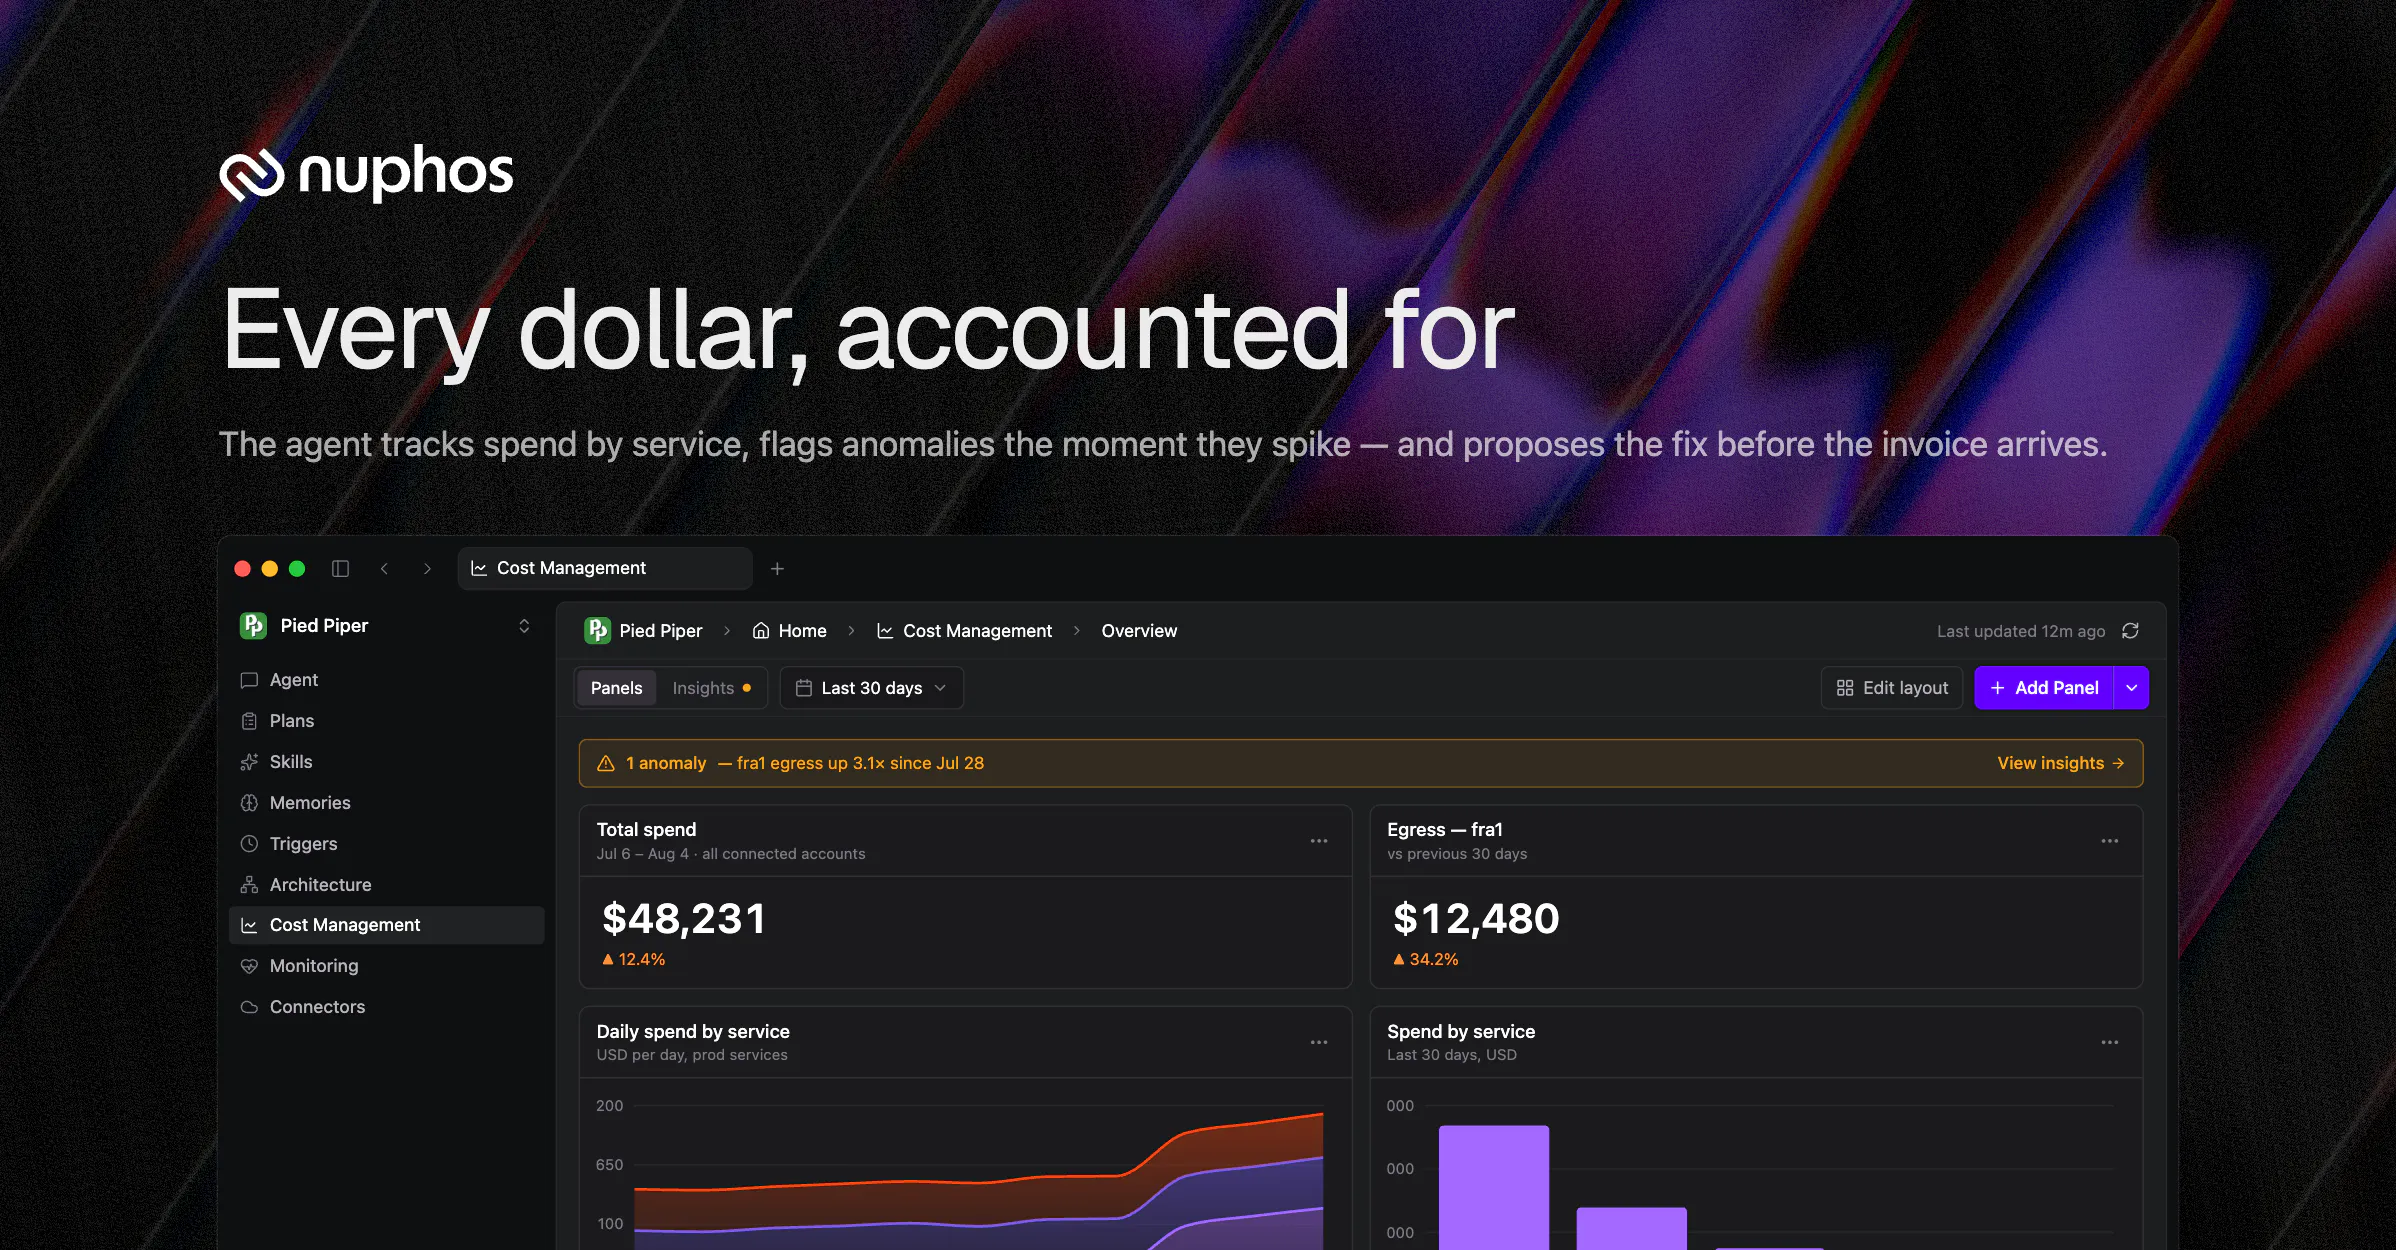
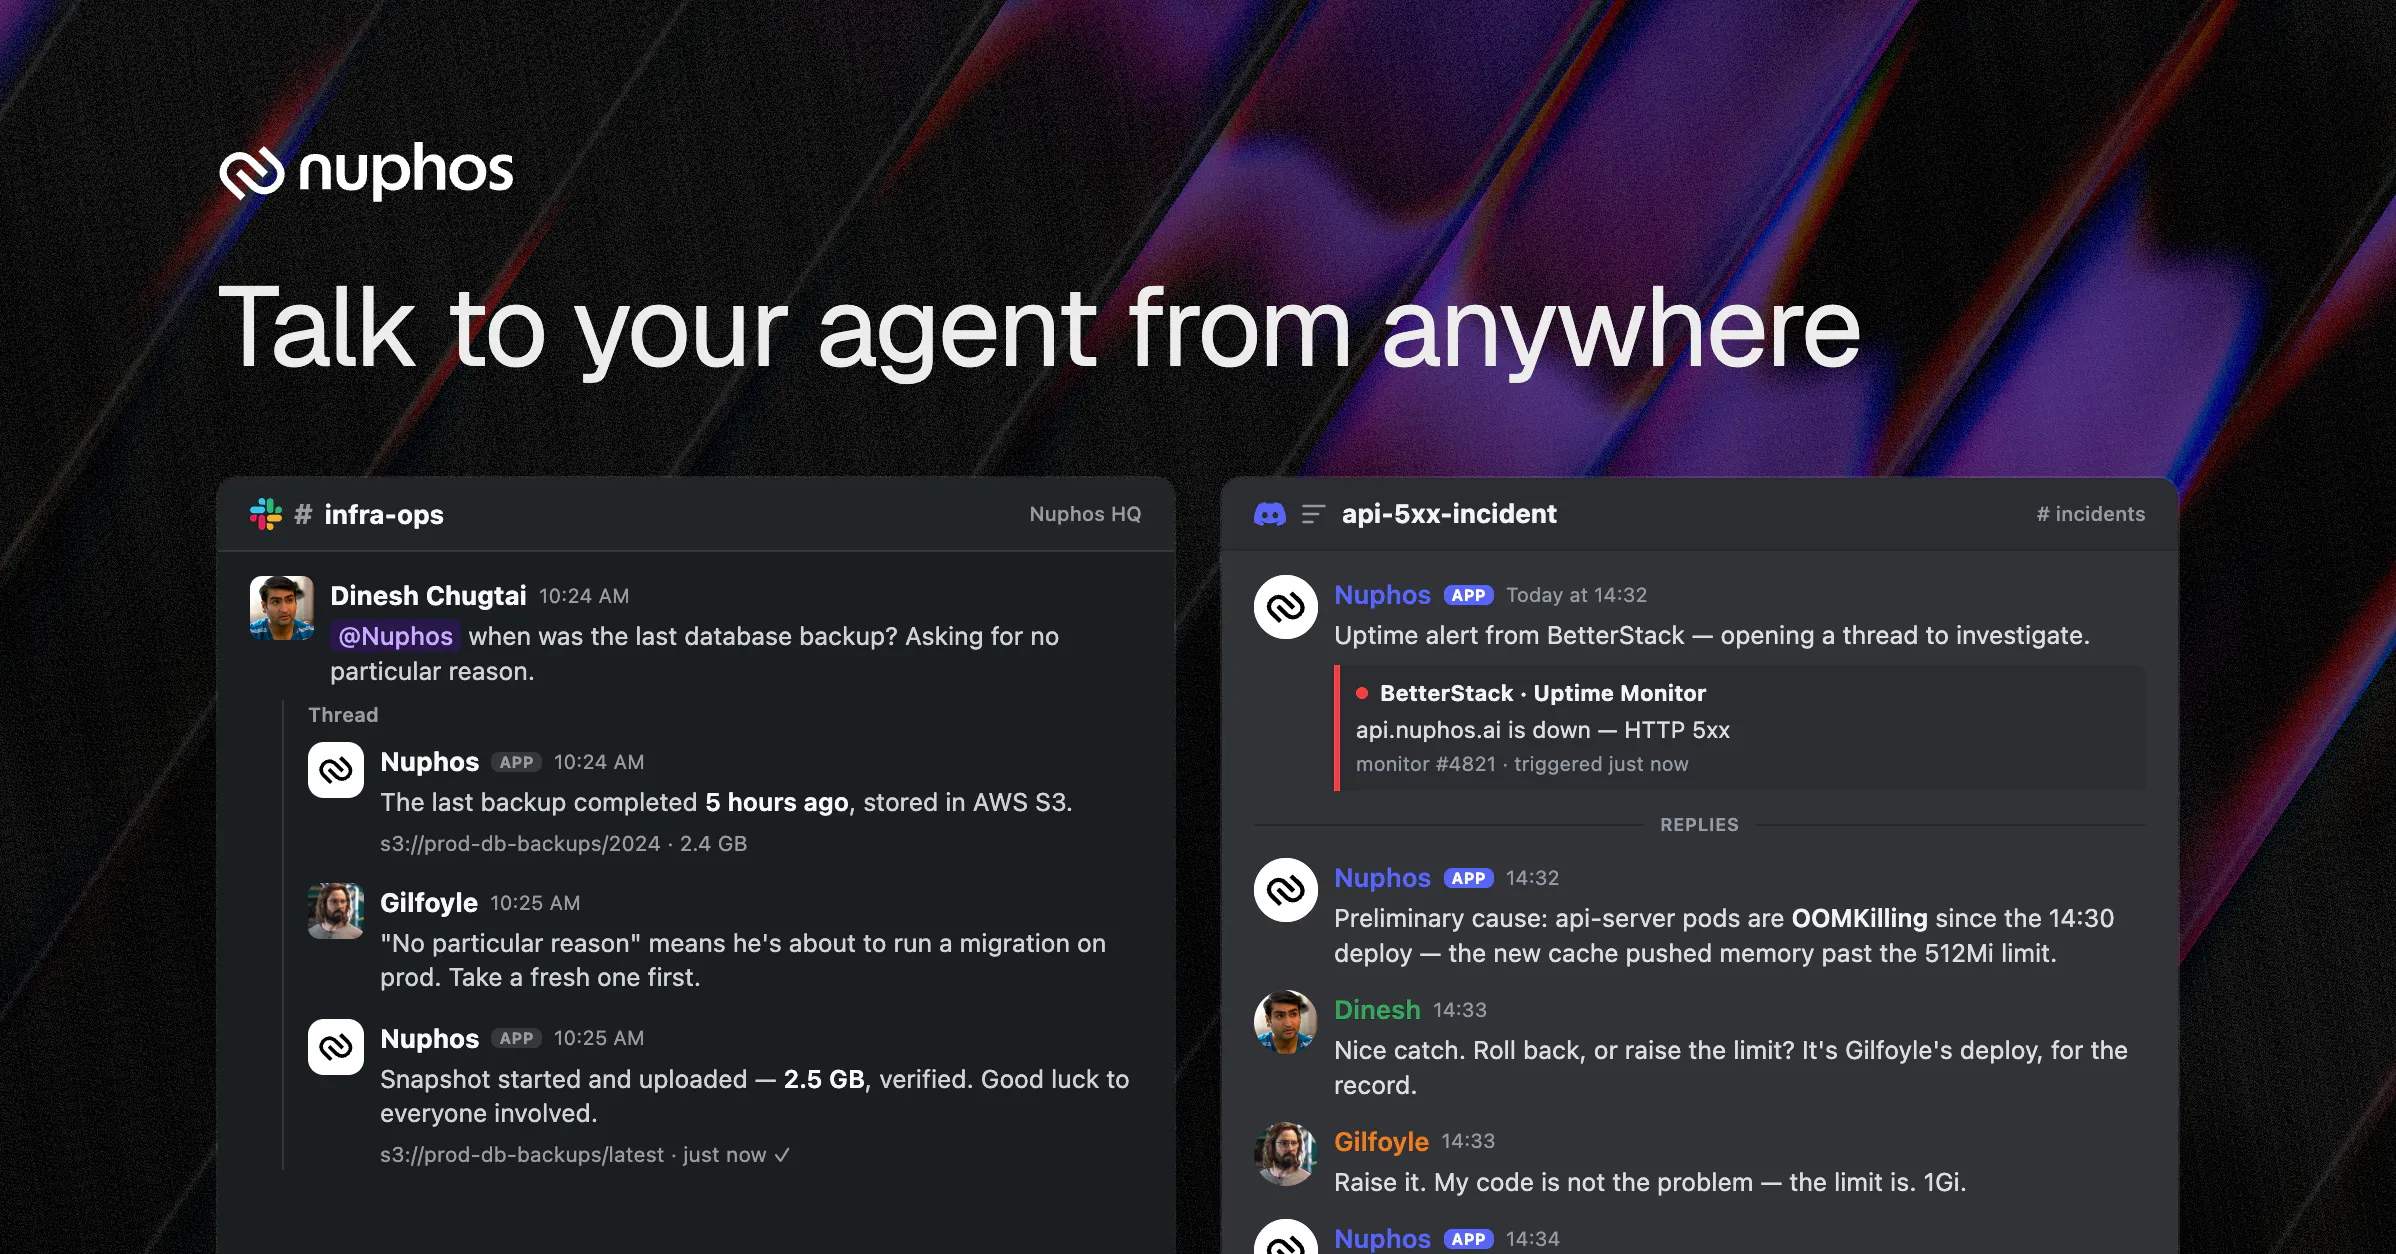
一句话介绍:Nuphos是一个AI原生DevOps工作空间,让AI代理在团队现有基础设施(AWS、GCP、K8s)中以默认只读、写操作需审批的方式,自主调查故障并执行运维任务,解决AI代理在生产环境中“不敢给权限、出了事没人负责”的信任与管控痛点。
API
SaaS
Developer Tools
AI运维
DevOps平台
AI代理
基础设施自动化
权限管控
生产环境安全
可观测性
故障排查
人机协同
审计追踪
用户评论摘要:用户普遍认可“权限审批+审计追踪”解决信任痛点,认为共享上下文比单点执行更有价值。核心疑问集中在:如何学习团队内部runbooks和历史经验?对独立开发者是否适用?以及如何评估AI在未见过故障场景下的决策正确性。团队回应强调人机协同、可审计的推理过程及设计伙伴验证。
AI 锐评
Nuphos的叙事很聪明——它没有重复“AI取代运维”的陈旧剧本,而是精准切入了AI Agent落地生产环境时最尴尬的“信任鸿沟”。当所有同行都在秀Agent能跑多少命令时,Nuphos把卖点放在了“谁批准的、改了什么、能否回滚”这些枯燥但致命的治理问题上。这实际上是对行业现状的隐形批判:现阶段纯靠模型自觉的运维Agent,在真实生产事故面前就是灾难。Nuphos通过“默认只读+强制审批+共享审计”的流程束缚,本质上是承认了当前AI能力的上限,并用人机协同的规则来兜底。
从评论区的反馈来看,团队很擅长引导舆论方向,几乎所有高赞提问都得到了标准化的“信任与安全”话术回应,这暴露出其作为早期产品的一个潜在隐患:过度强调治理框架,反而可能掩盖了AI代理本身在复杂根因分析上的能力短板。用户真正关心的“它凭什么能做出正确判断”,得到的回应大多是“让推理可审计”而非“我们推理更准”。
此外,产品定位略显摇摆。对独立开发者宣称“就是你的DevOps团队”,但对大团队又强调“共享上下文和审批流”,这两类客户的需求曲线截然不同。服务的核心价值可能更偏向中大型、多云的复杂基础设施团队,但这类团队恰恰对AI的容错率最低。Nuphos能否在“讨人喜欢的流程”和“真正懂运维”之间找到平衡,是它从300票的发布热度走向生产环境硬仗的关键。目前来看,它更像是一个精心设计的笼子,而笼子里的鸟(AI模型)还需要证明自己会飞。
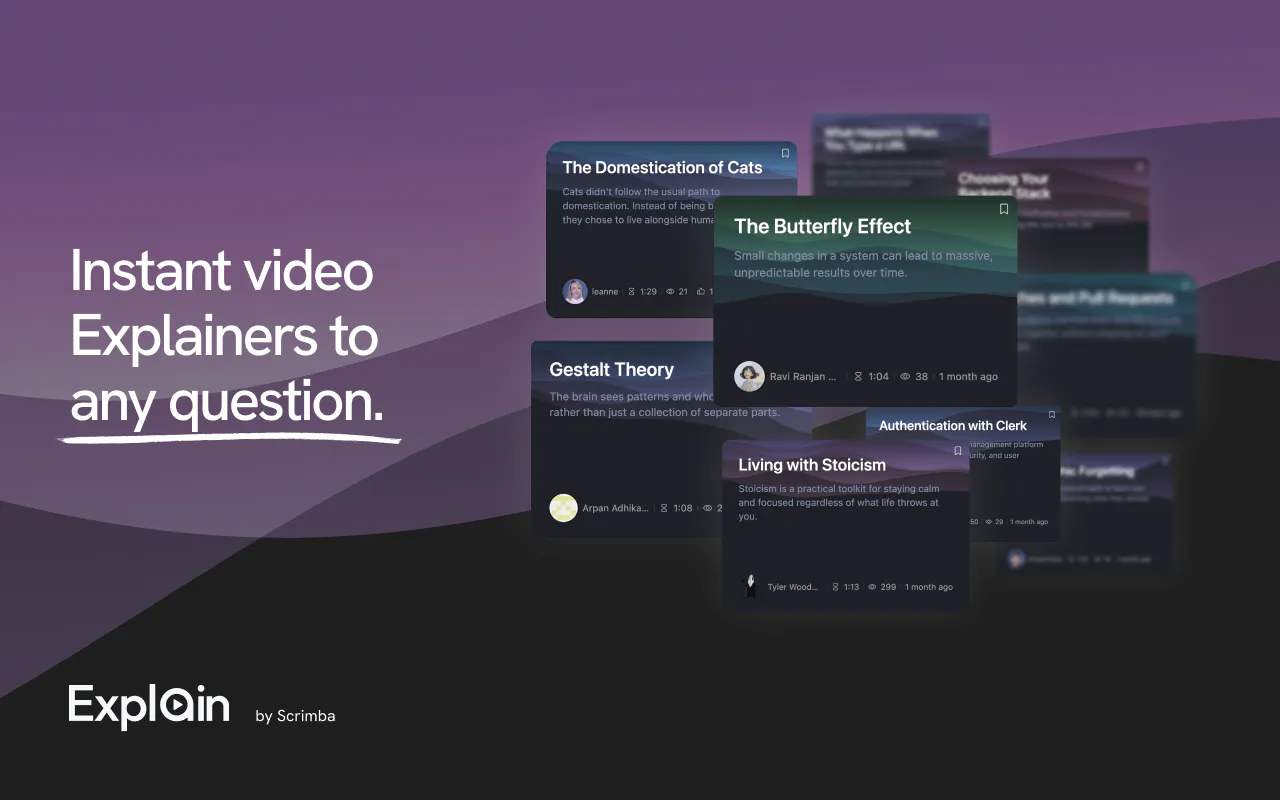
一句话介绍:Scrimba Explain 是一款将任意问题(文字、代码、文件、链接)在2-3秒内自动生成带旁白、动画、图示和代码走查的“视频版答案”的AI教学工具,专治“不想读文字、只想看视频”的学习者耐心缺失与理解效率痛点。
Productivity
Education
Video
AI视频生成
编程教育
AI导师
交互式学习
代码解释
DOM播放技术
视频答疑
Scrimba
学习工具
开发者工具
用户评论摘要:核心好评集中在生成速度快、视觉化讲解清晰、结尾提问有助理解。用户建议:GitHub PR视频功能实用,希望支持非滚动网页内容抓取;有人询问是否Apache 2.0开源;团队回应将增加内联编程挑战和文本作答,并预告扩充后端教学内容。
AI 锐评
Scrimba Explain的巧妙之处在于它没有去和Sora、Runway拼“视频真实性”,而是用DOM播放技术绕开昂贵的视频生成模型,把“解释”变成了一段可交互的“演示动画+旁白”。这本质上是对Chatbot问答体验的一次降维打击——同样是答案,视频的完播率和记忆留存率远超滚动文字。产品切中的是开发者社区里长期被忽视的“视频优先学习者”群体,且用2-3秒的速度击穿了“等待生成”的心理阈值,这让它更像“YouTube式的答案”,而非“文字墙的替代品”。
但冷静看,目前它仍属于“有魅力的壳”:核心解释能力大概率依赖底层LLM,视频是包装,并非知识来源。真正的护城河在于两点——一是能否从“解释”进化到“诊断”,即根据学生提问判断其概念误区并定制反问;二是能否将GitHub PR视频这类工作流场景做成强需求入口,否则很容易被Cursor、Copilot等工具的语音/视频回复功能反超。运营上,20万beta用户验证了需求,但免费计划能否长期维持,取决于DOM播放的成本控制能否跑通经济模型。另外,创始人承诺“一周内发货功能请求”是高风险高回报的社区策略——兑现几次是佳话,长期则考验团队极限。锐评结语:好产品,但别急着封神,看它能否从“新奇的老师”变成“离不开的助教”。
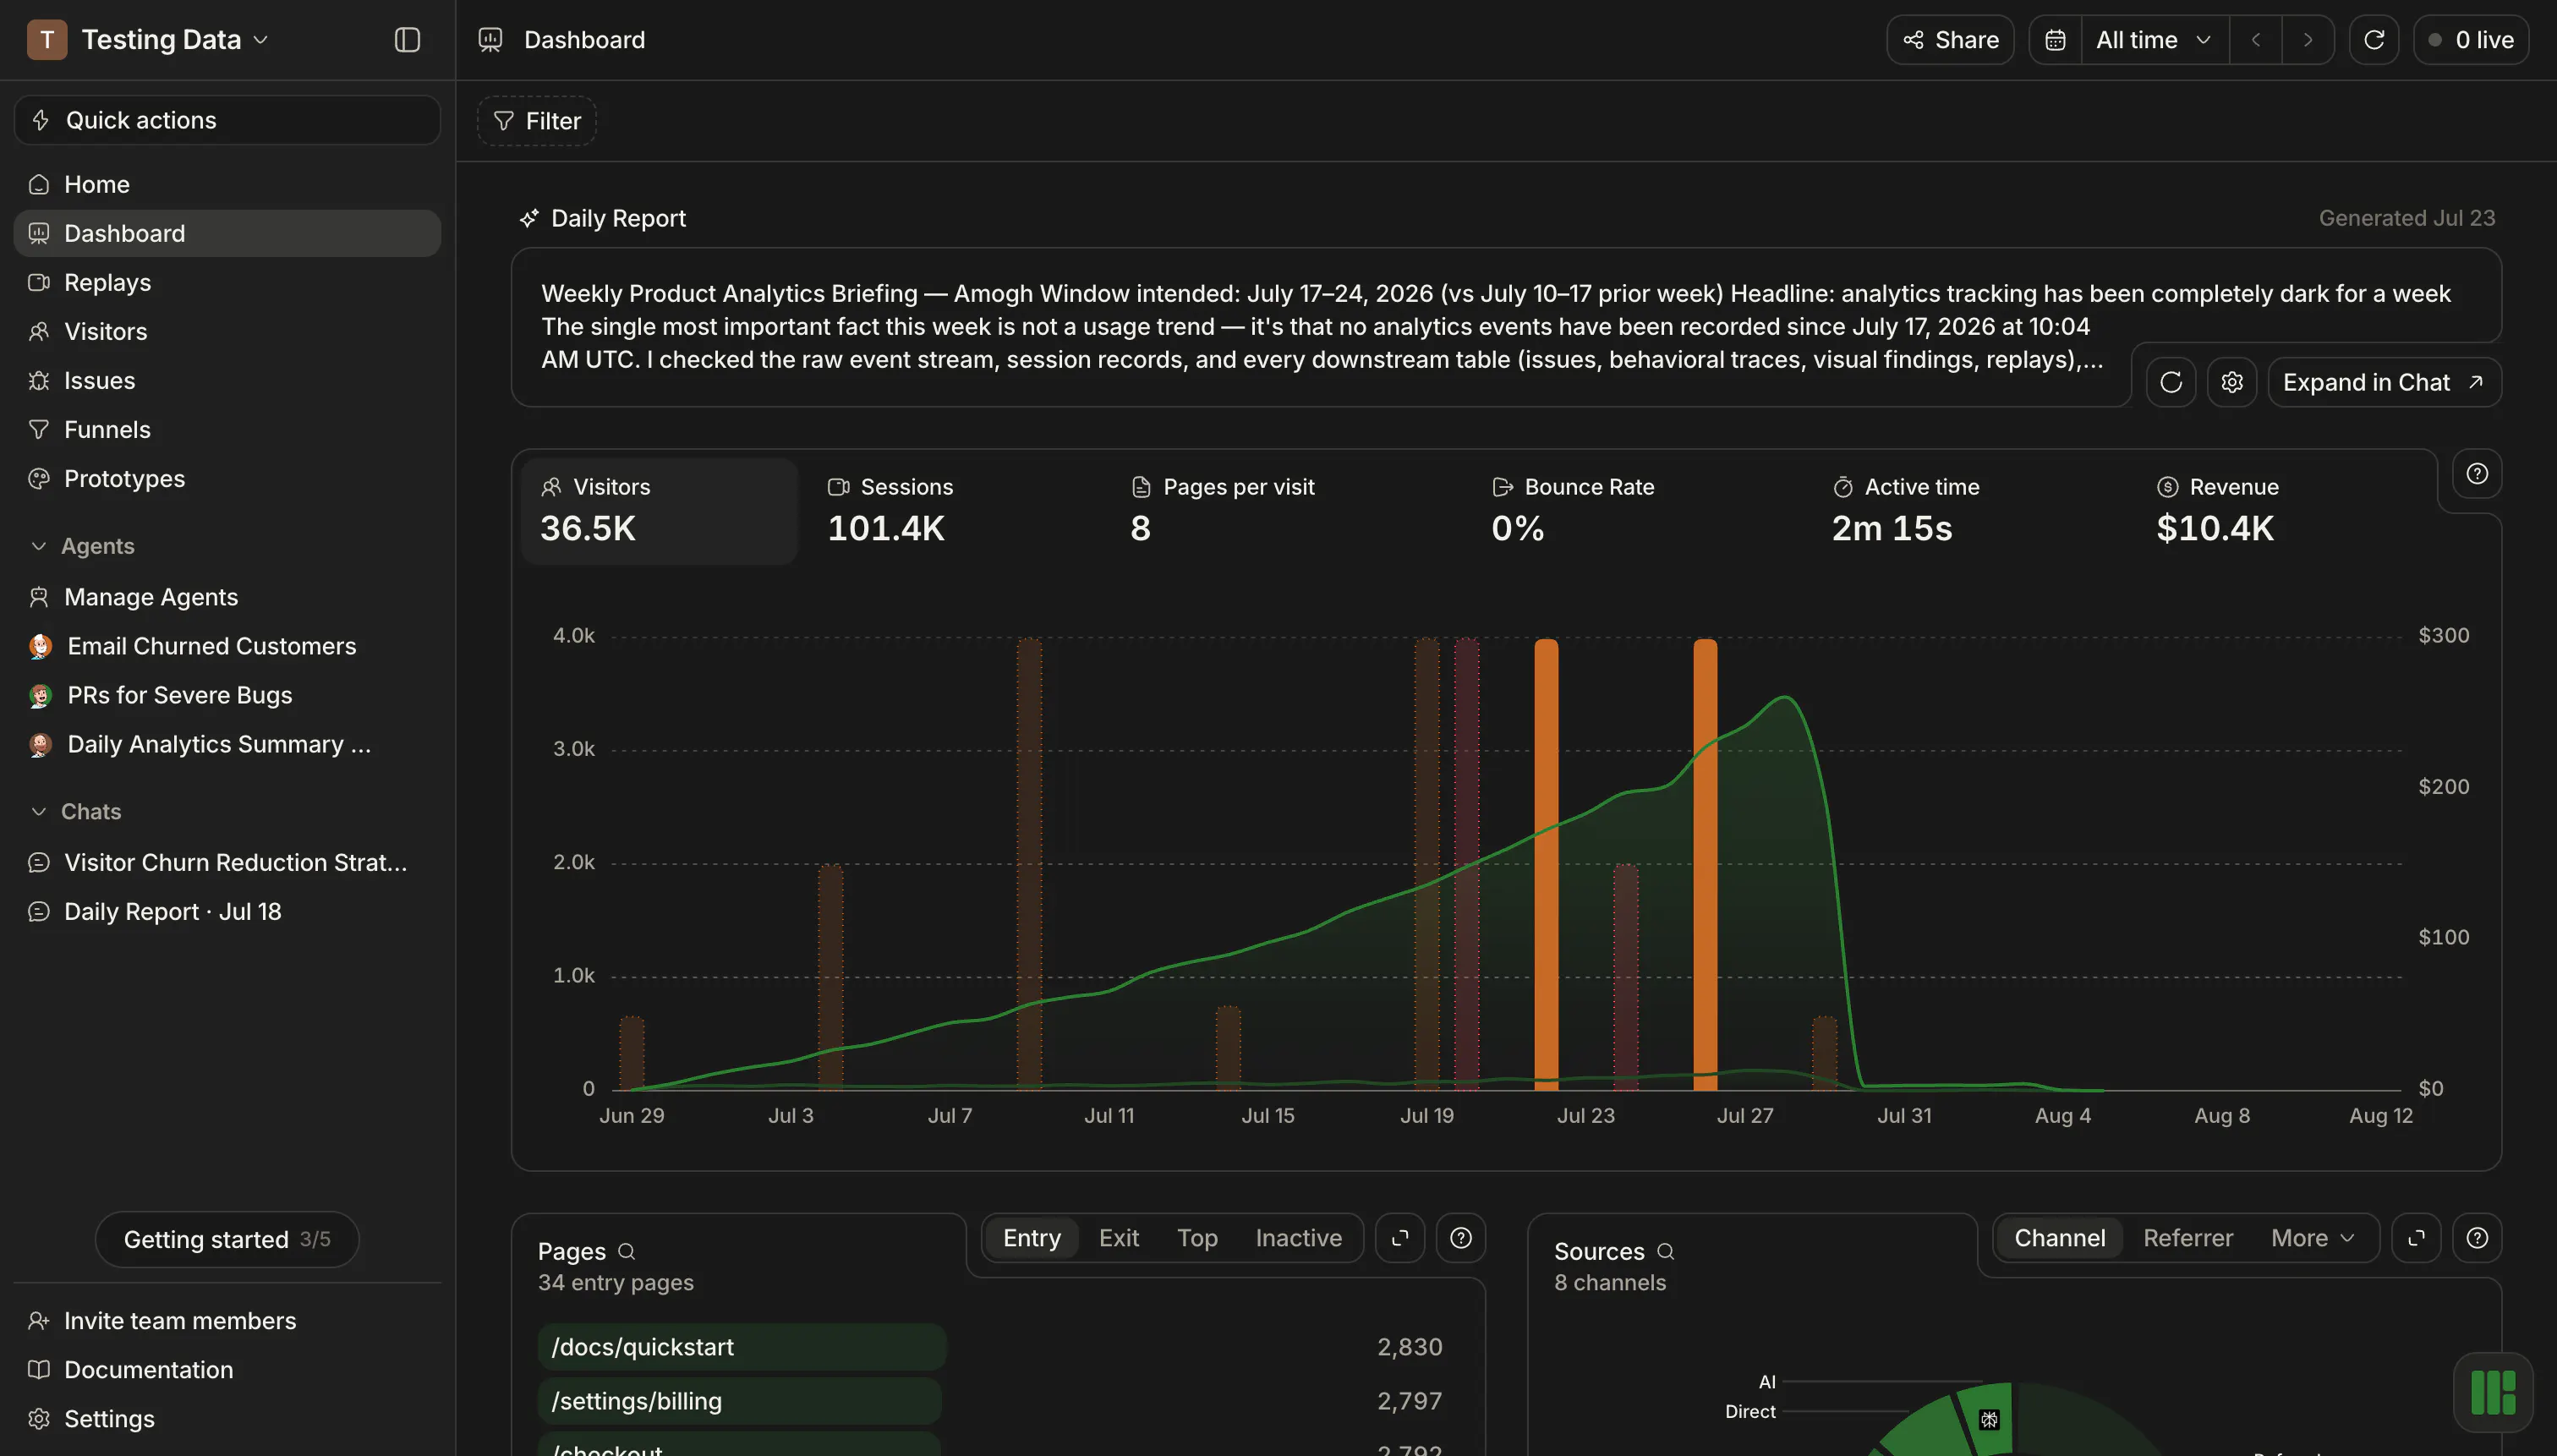
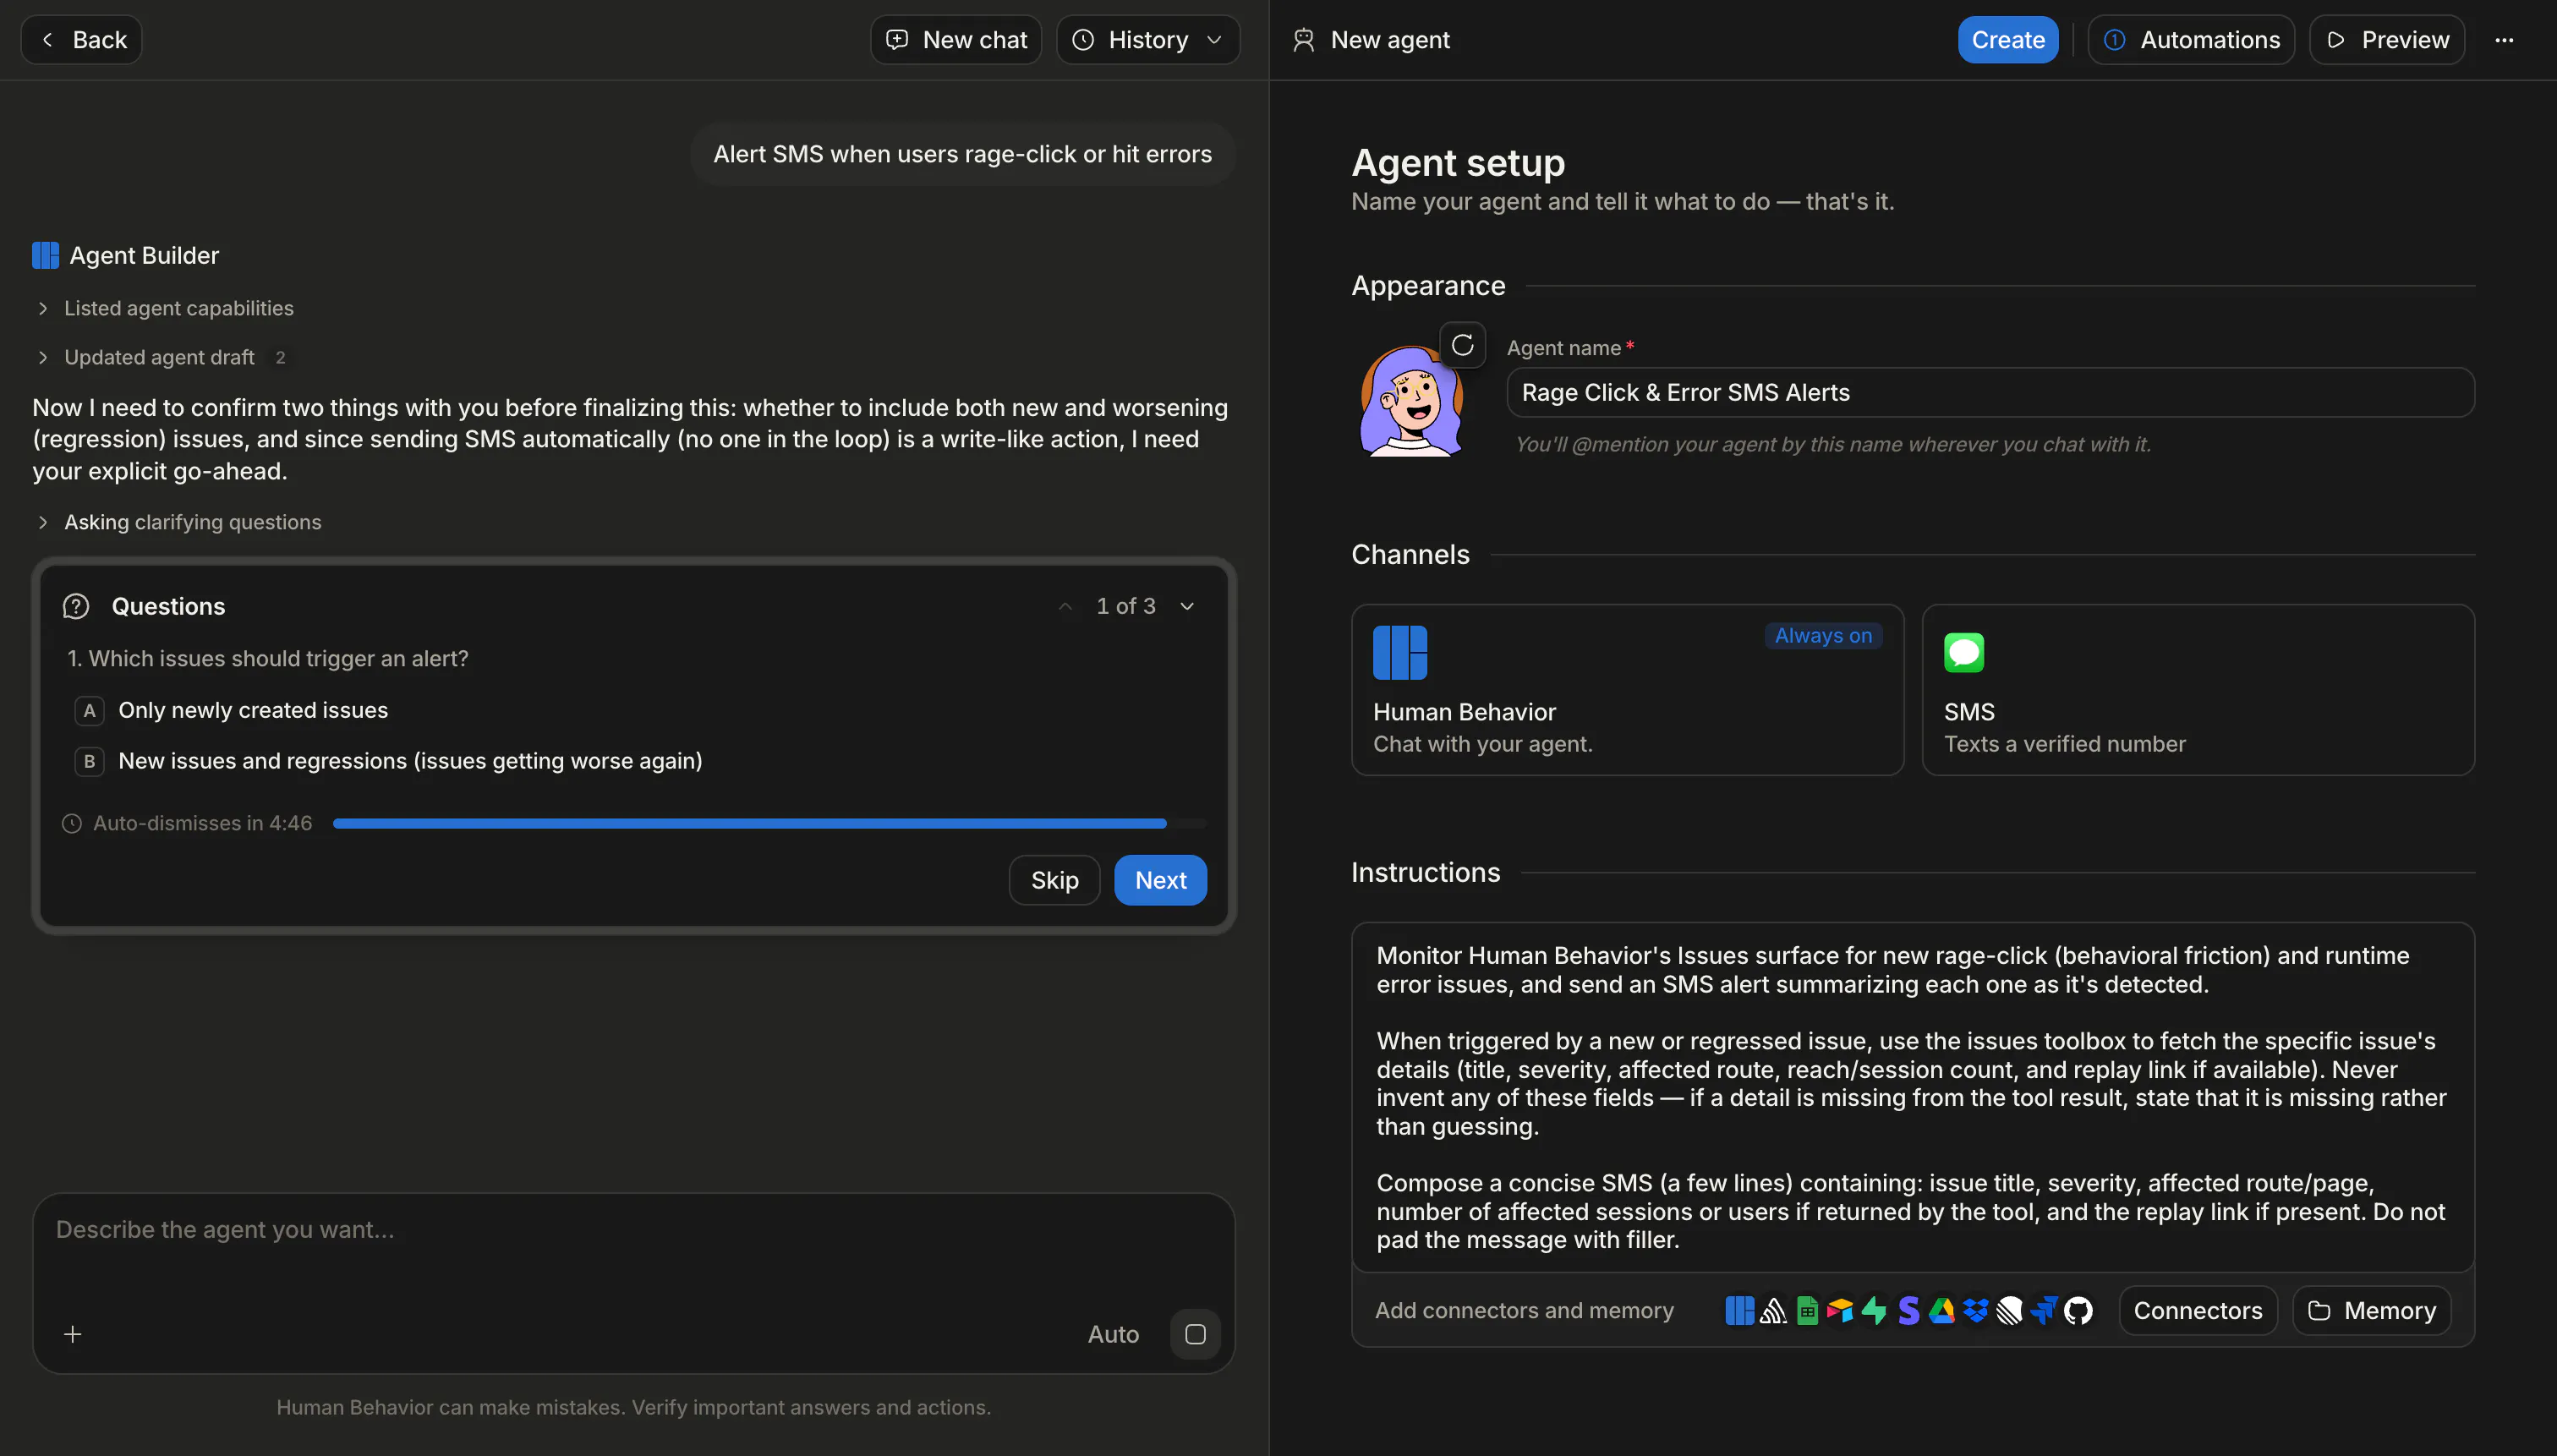
一句话介绍:Human Behavior 是一款利用AI代理自动观看用户会话录屏、识别用户痛点(如愤怒点击、死按钮、沉默放弃),并直接触发修复行动(如开PR、发邮件、更新CRM)的闭环产品分析工具,让团队告别“只看不做”的仪表盘,将洞察直接转化为产品改进。
Analytics
Developer Tools
Artificial Intelligence
产品分析
AI代理
会话重放
用户行为洞察
自动化运维
闭环反馈
无代码行动
开发者工具
Rage Click检测
Slack集成
用户评论摘要:用户普遍认可“从洞察到行动”的闭环价值,尤其称赞直连Linear/Slack、避免Dashboard冗余。核心疑虑集中在自主行动的边界:1)AI开PR后是否需人工复核“预期行为”?2)自动发送客户邮件的不可逆风险如何管控?3)是否支持分权限设置(如PR自动、邮件需审批)?另外,有用户指出竞品PostHog已发布类似功能,需差异化。
AI 锐评
Human Behavior的“闭环”叙事确实戳中了行业痛点——数据看板堆积如山的“分析瘫痪症”是真实且普遍存在的。其“AI看录屏+自动修Bug”的卖点极具冲击力,用“自家产品处理1.5万次会话并产出16个PR”作为狗粮,是本次发布最高明的信任状。
但剥开“AI自主改善产品”的华丽外壳,其本质仍是“高级自动化脚本”与“大模型驱动的意图识别”的组合。目前评论中暴露的信任鸿沟(邮件不可逆、PR是否误报)才是决定其能否从“玩具”走向“生产工具”的关键。产品必须提供极其精细的权限闸门(如邮件双因素审批、PR打标签追踪)和可解释的决策日志,否则“自主行动”会成为团队内部的定时炸弹。
此外,PostHog等平台已具备类似功能,且拥有更庞大的现有用户群。Human Behavior的差异化优势在于“Agent优先”的极简交互(Slack/SMS),但这也意味着它需要证明自己比“平台内置功能”更聪明、更可靠。当前投票数(248)和评论热度尚可,但若不能尽快建立“行动准确率”的行业基准,风头一过很容易被巨头复制。真正的护城河,或许是它收集的“AI代理决策-人类修正”配对数据,这比录屏本身更有价值。
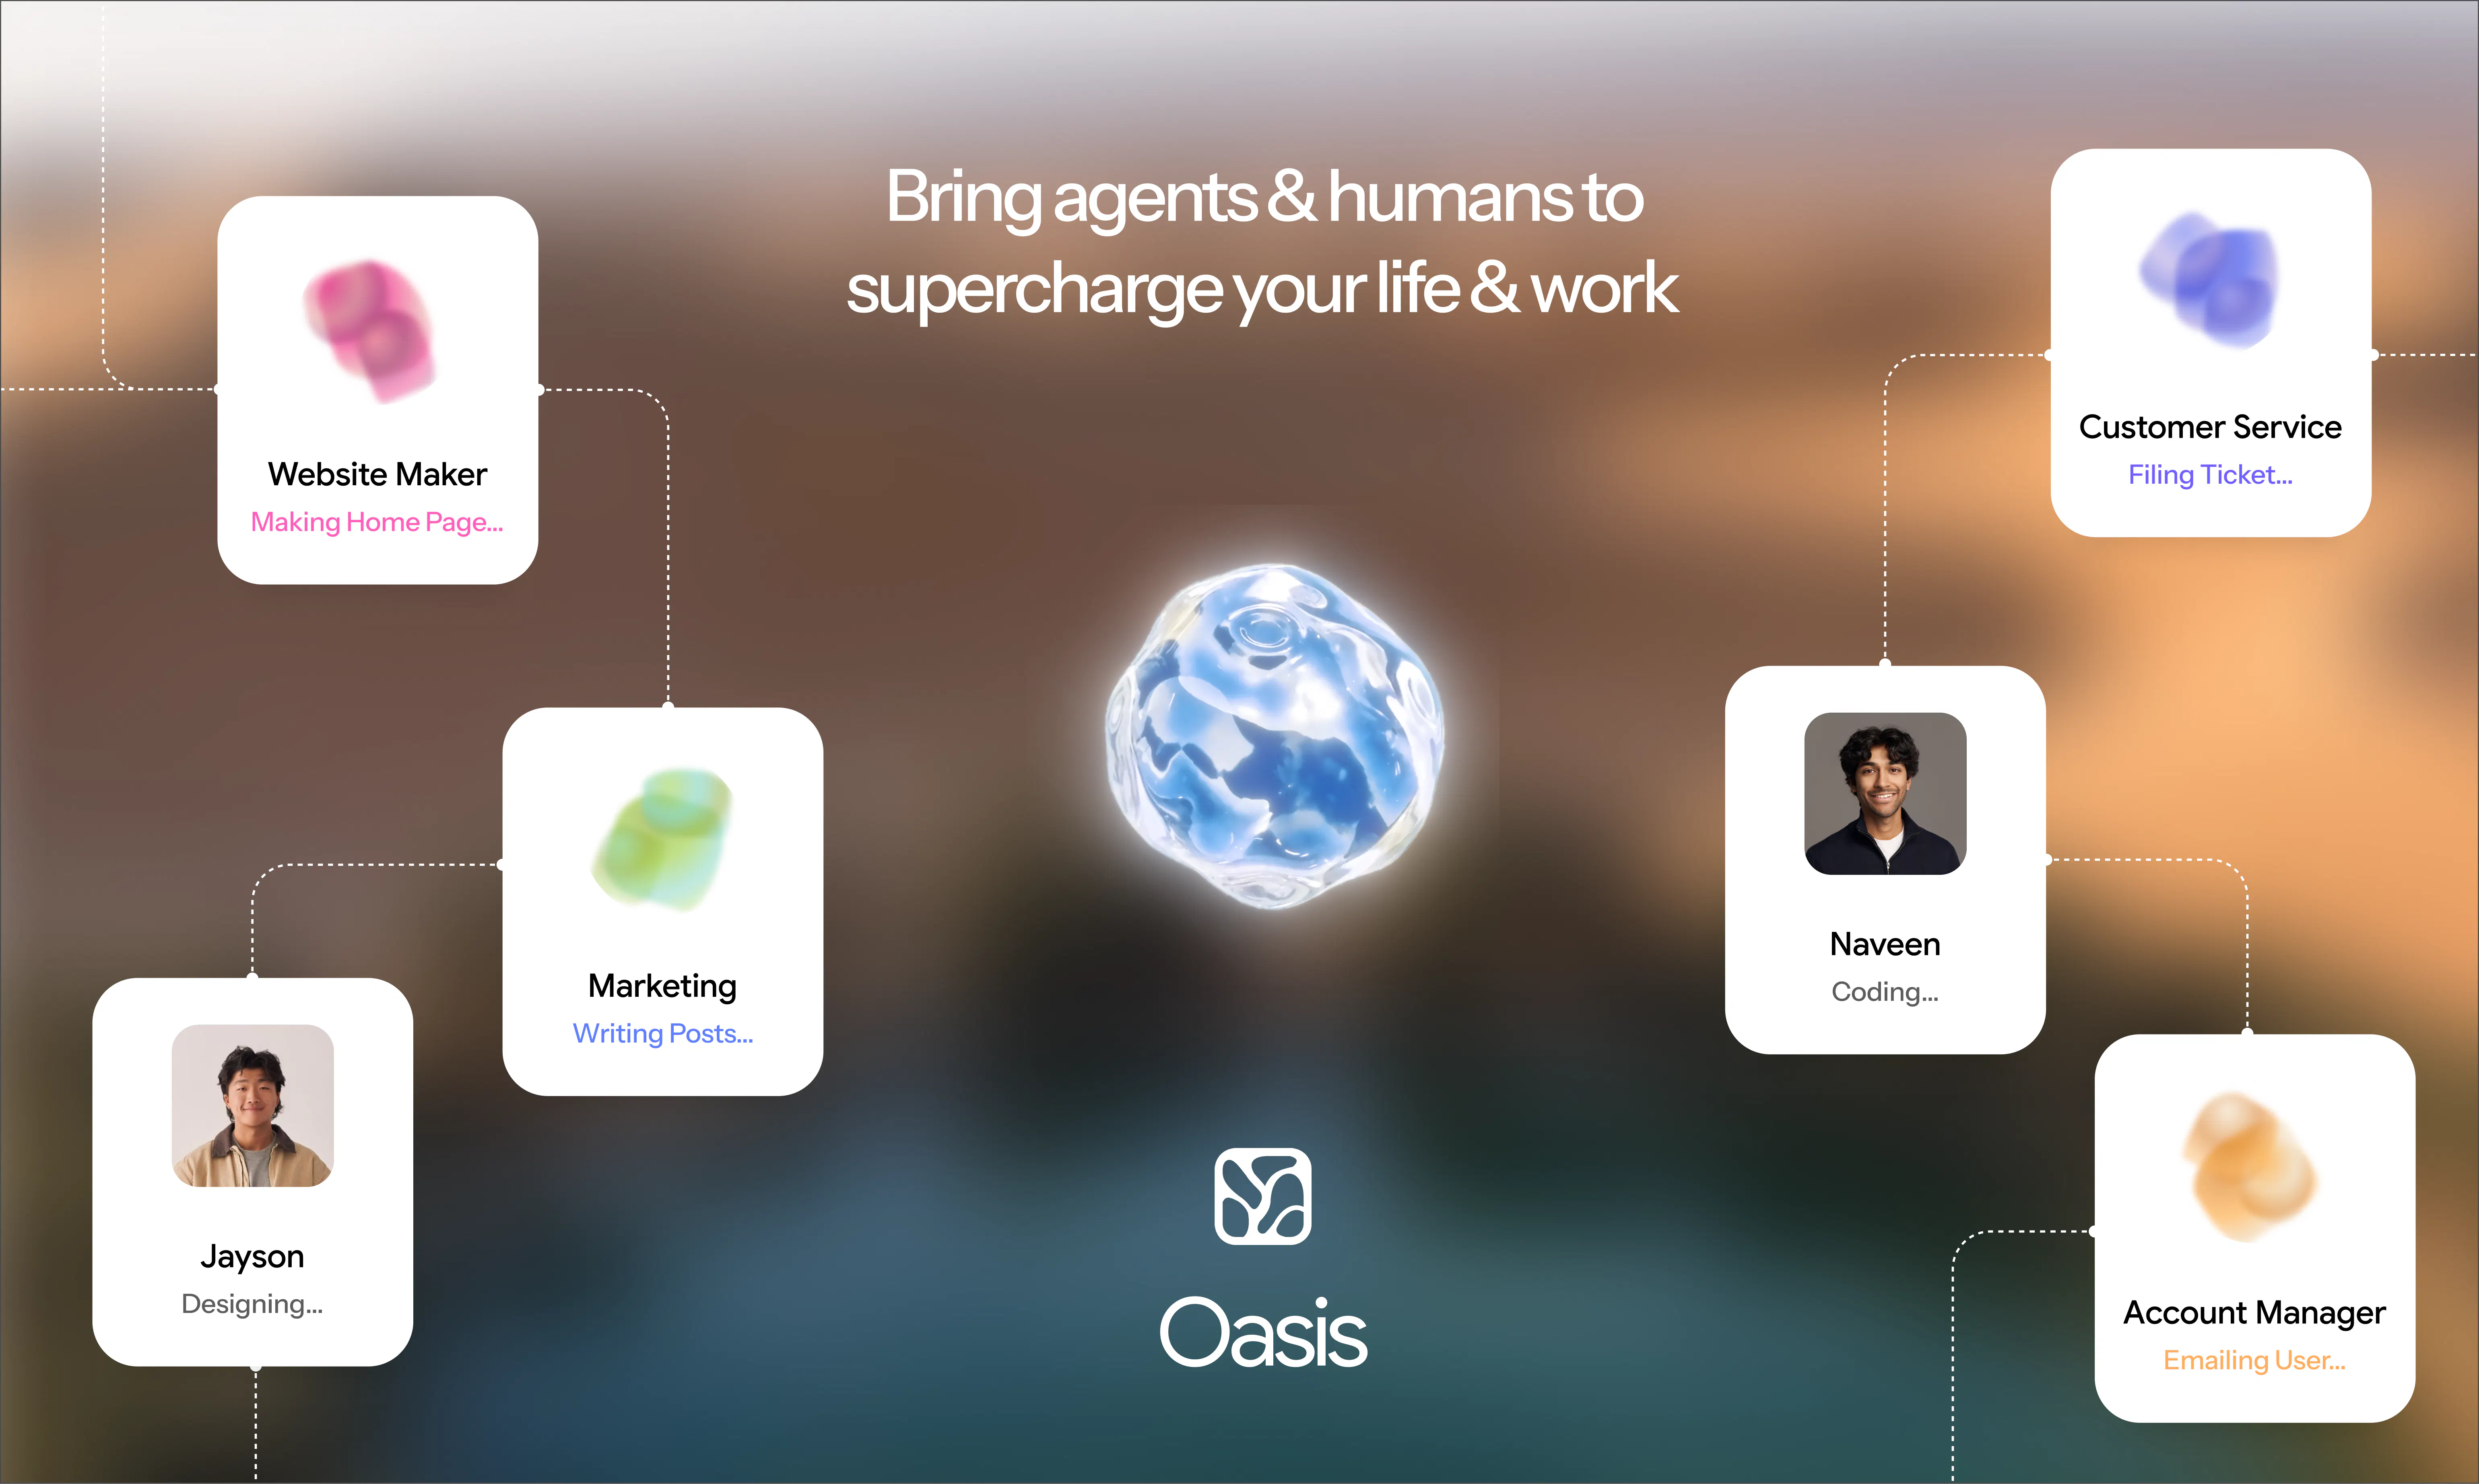
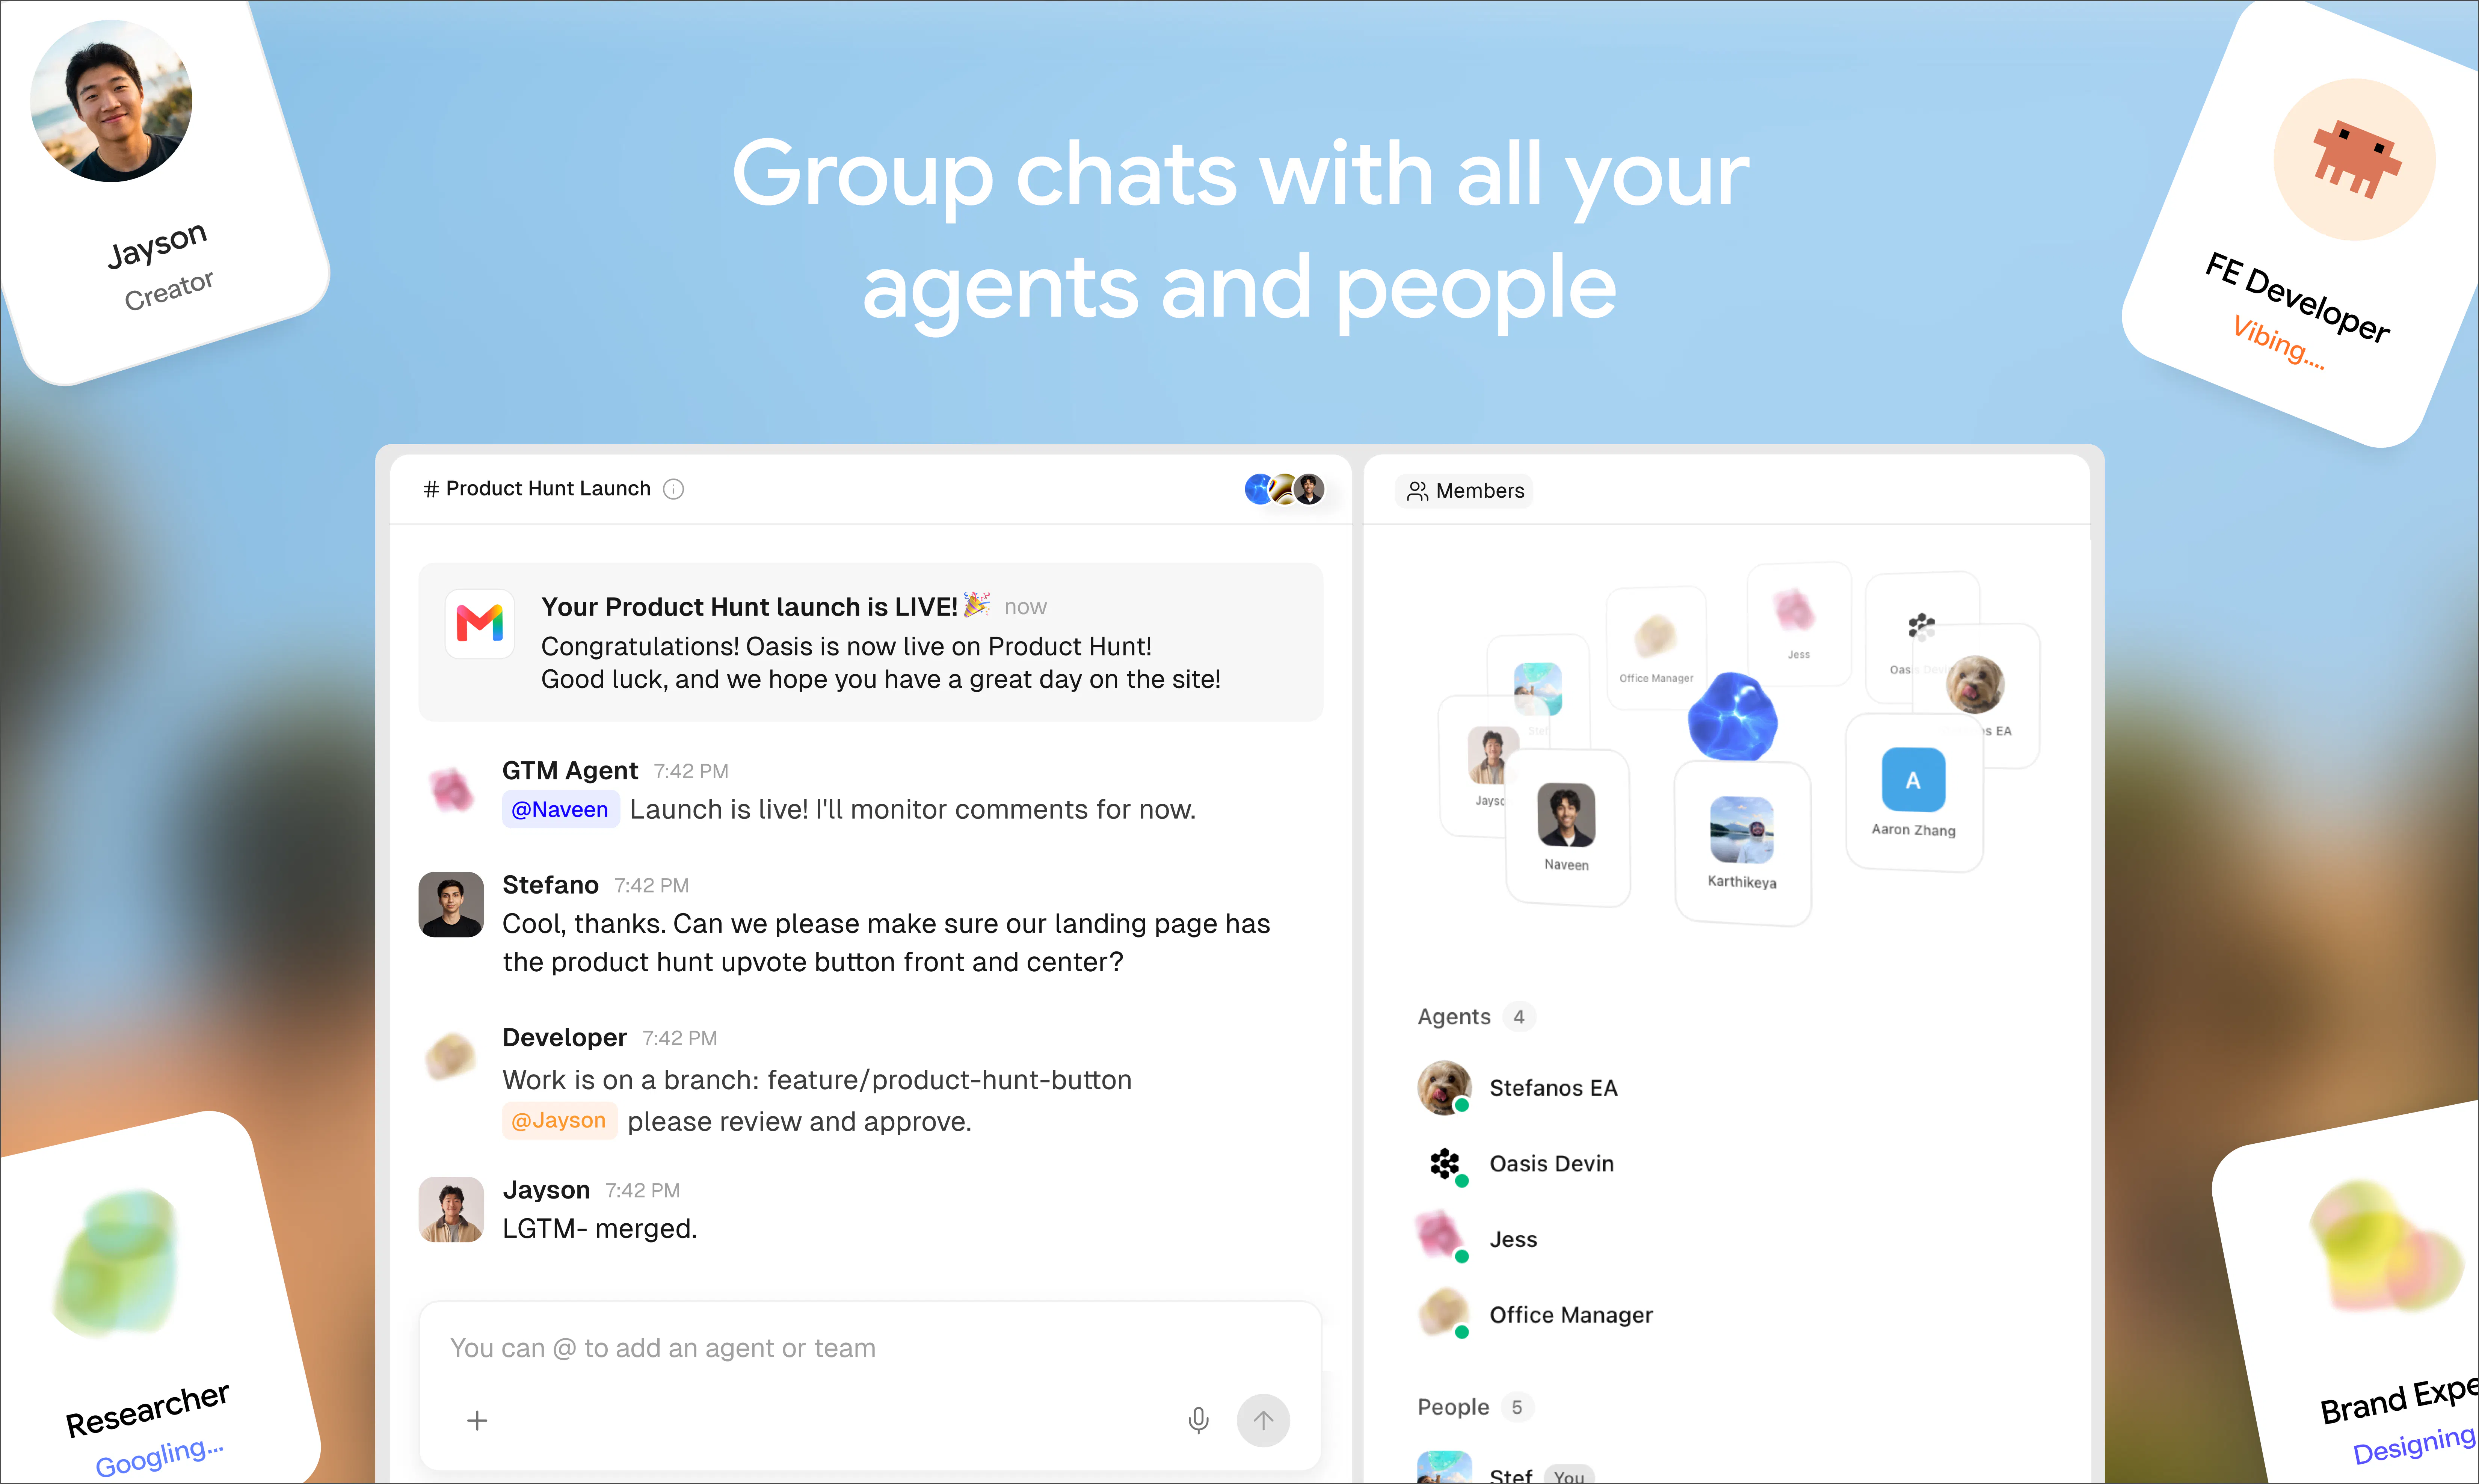
一句话介绍:Oasis是一个将各类AI代理(如Claude Code、Devin等)与人类团队整合进同一共享工作空间的智能协作平台,解决多代理工具碎片化、上下文割裂、团队协作无法共享AI工作成果的核心痛点。
Productivity
Artificial Intelligence
No-Code
AI代理工作空间
人机协作
团队协作
共享记忆
MCP兼容
智能工作流
聚合平台
上下文管理
权限控制
生产力工具
用户评论摘要:用户普遍认可解决多代理上下文碎片化的价值,重点询问权限与记忆管控机制(如按频道/项目隔离代理)、护城河(是否靠中立聚合+记忆层)。团队回应称记忆需原创建人审批才可外泄,支持按成员过滤知识,并提供200美元试用额度。
AI 锐评
Oasis踩中了当下AI代理爆发期最尴尬的痛点:工具越强,协作越碎。当每个代理都拥有独立上下文时,团队协作便沦为“复制粘贴上下文”的体力活。其核心思路是将代理从“工具”降维成“团队成员”,用Room和共享记忆库重构工作流,这不仅是产品形态创新,更是对AI协作范式的一次有效试探。
但从评论反馈看,其真正的生死线在于“权限模型”和“中立性”。允许代理共享记忆,本质上是把企业机密交给黑盒模型,即便设计了“原创建人审批”机制,在复杂权限矩阵前依然显得单薄;而面对OpenAI、Anthropic自带的团队功能,Oasis若不能证明“中立聚合”能带来不可替代的成本优势与模型灵活性,很容易沦为巨头生态的过渡品。
更深层的隐患在于“共享记忆”的泛化能力。记忆不等于决策逻辑,代理间互相调用记忆极易产生“上下文污染”——一个代理的偏见或错误推理通过共享库感染其他代理,彼时“沉淀知识”将变成“固化错误”。Oasis需要证明自己做的是知识蒸馏而非垃圾邮件转发。
总体而言,方向正确,切入精准,但尚需在安全边界与知识治理上拿出更硬核的解决方案,否则只能成为AI协作史上的一个注脚,而非里程碑。
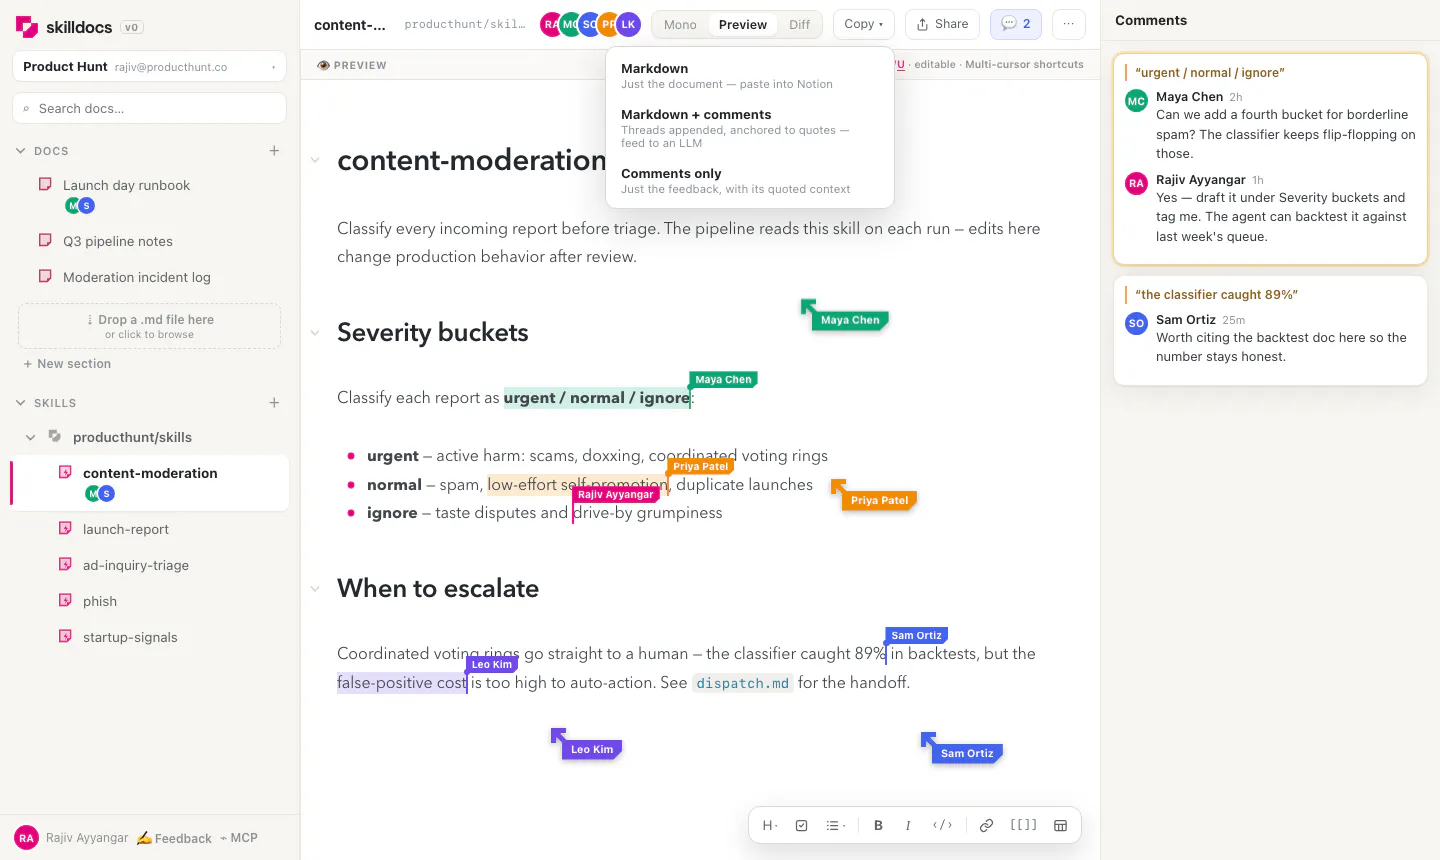
一句话介绍:Skilldocs将Figma的多人实时协作体验带入Markdown编辑器,解决团队在AI编程工作流中文档协同编辑难、反馈无法回流到代码Agent的痛点。
Productivity
Developer Tools
Artificial Intelligence
实时协作
Markdown编辑器
AI编程工作流
在线文档
团队协作
WYSIWYG
代码Agent反馈
版本管理
多人光标
Figma模式
用户评论摘要:用户普遍认可解决真实痛点,但集中询问版本/分支控制机制,及MCP服务器安装路径不清晰问题。有评论建议轻量级“命名版本标签”而非复杂git分支,以追溯Agent误用版本。作者回应积极,邀请用户参与设计。
AI 锐评
Skilldocs的聪明之处在于精准切入了“人类与AI编程Agent协作”的混沌地带——当文档既是规范又是交付物时,传统Git分支或Notion粘贴都显得笨重。它用“实时协同+一键导出diff”把协作重心从“事后同步”移到“事前共建”,本质上把文档变成了可对话的“接口”。但评论中暴露的版本焦虑才是真正的命门:一旦多个Agent或多人异步编辑,当前“单时间线”模型必然崩溃。作者对分支的回避态度可以理解(Figma本身也不解决版本库),但“命名版本”只是止痛药,长期看需建立基于内容寻址的不可变快照体系,否则会成为仅适用于“小团队同步会议”的精致玩具。MCP安装门槛也暗示目标用户得是开发者兼文档写作者,这类人其实更习惯CLI+git的原生工作流——除非Skilldocs能证明其协作模式带来的效率增益显著大于学习成本,否则很可能会变成“演示惊艳、日常吃灰”的工具。真正的护城河不在编辑器UI,而在能否沉淀出一套“人类共识→Agent执行→结果反馈→文档修正”的闭环协议。
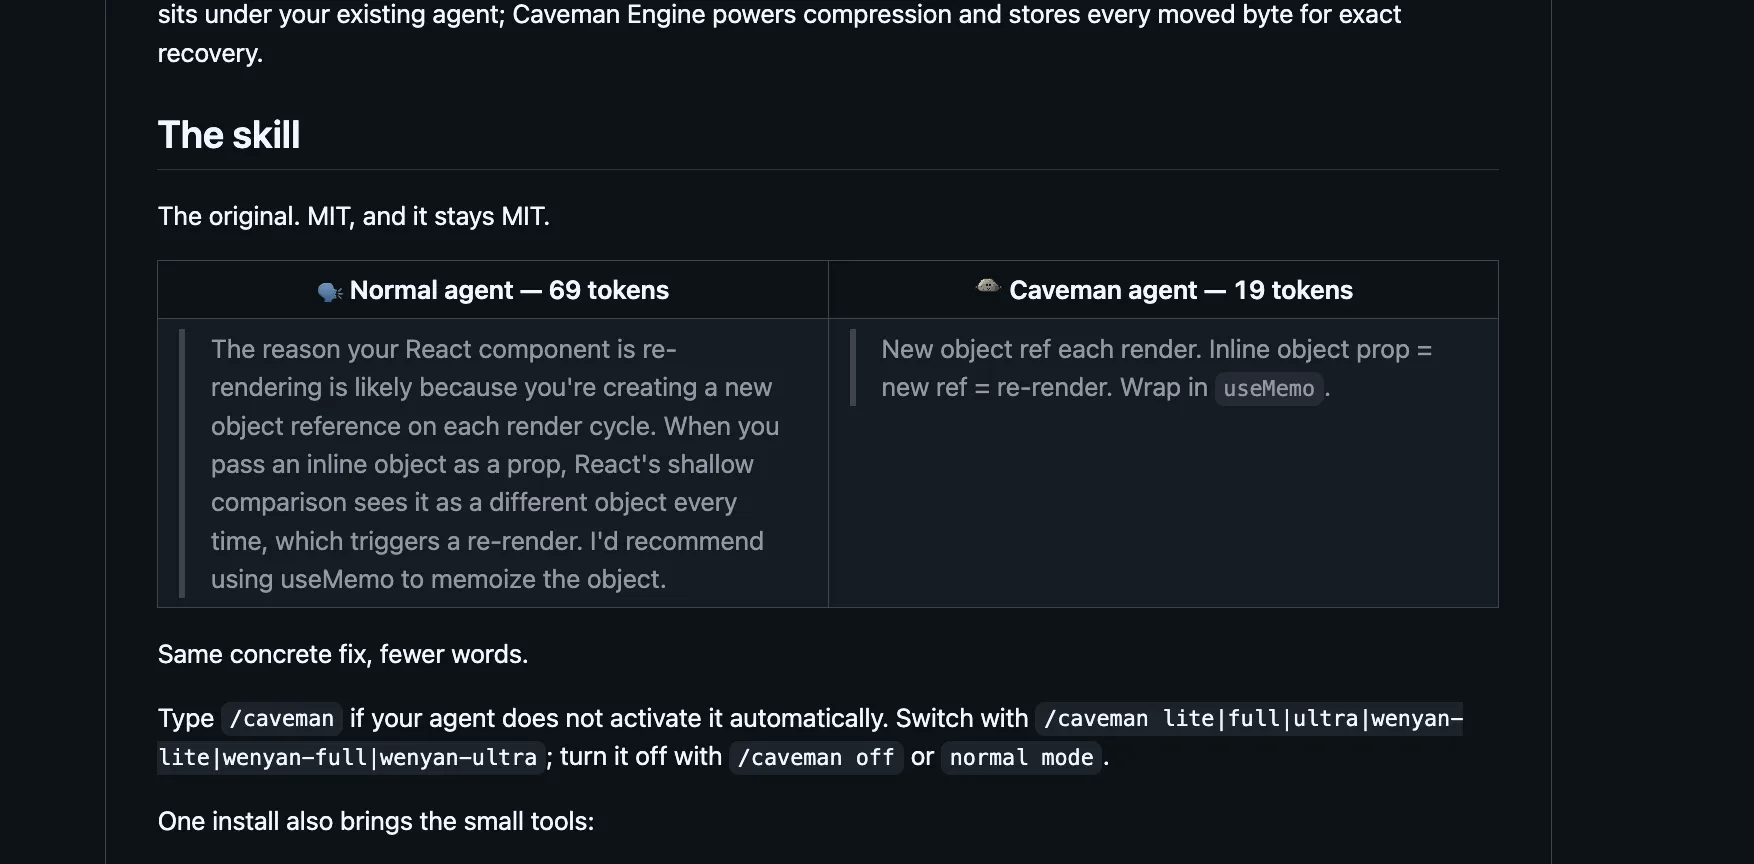
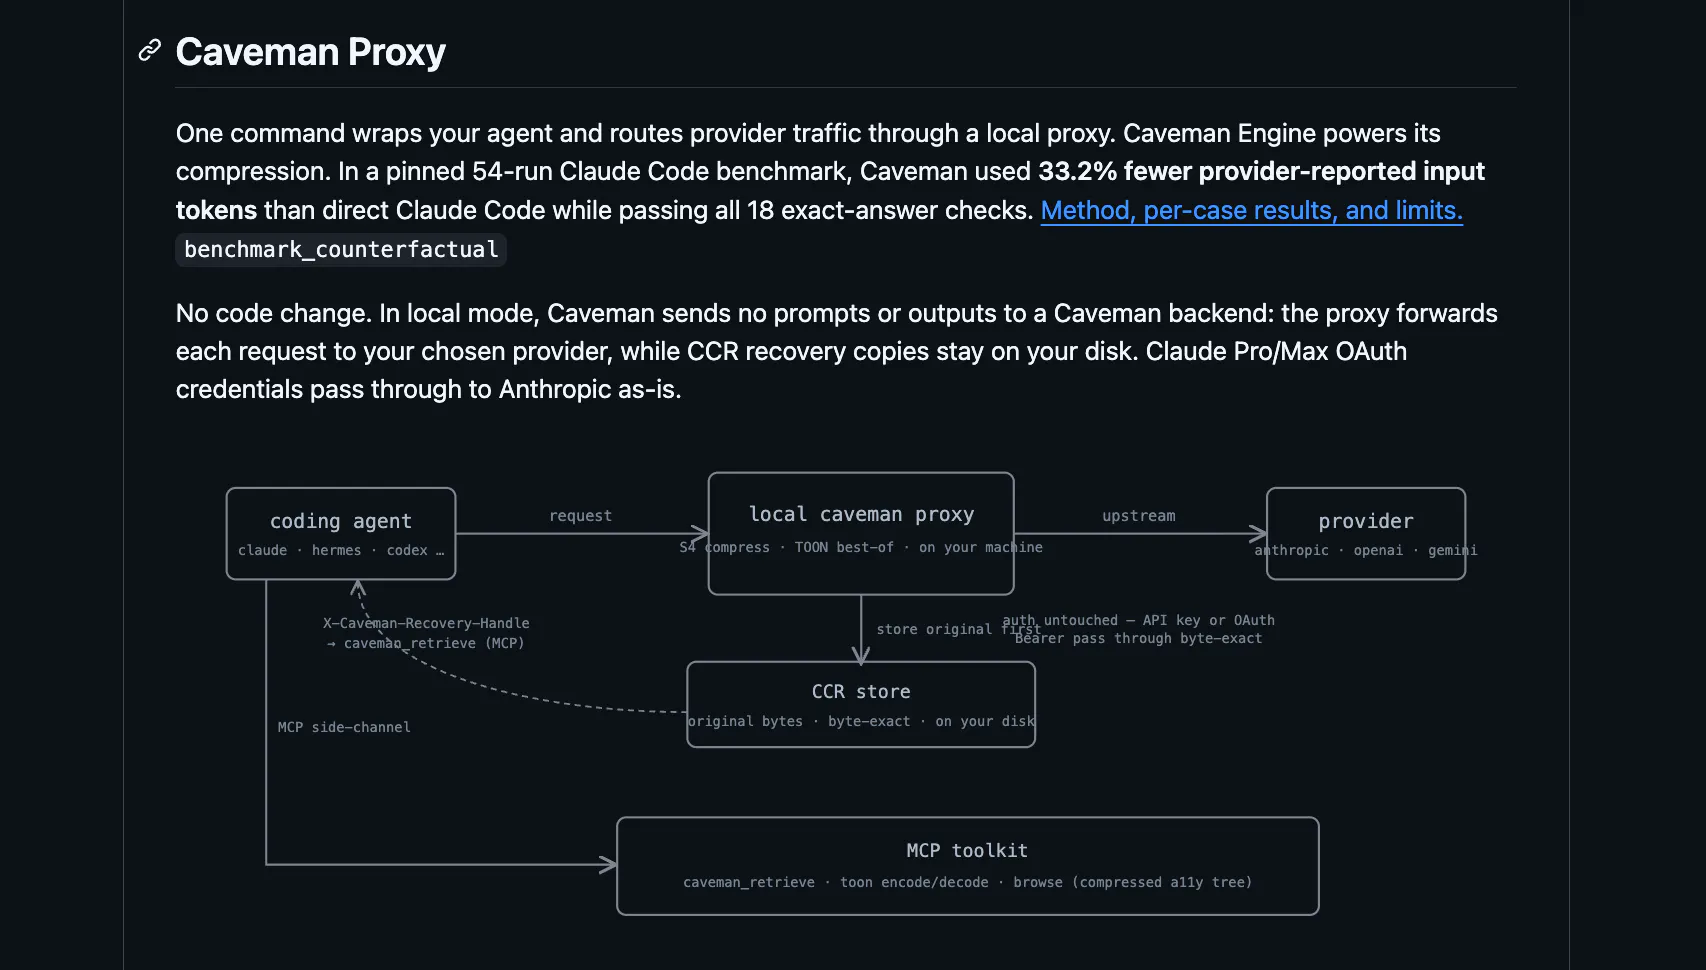
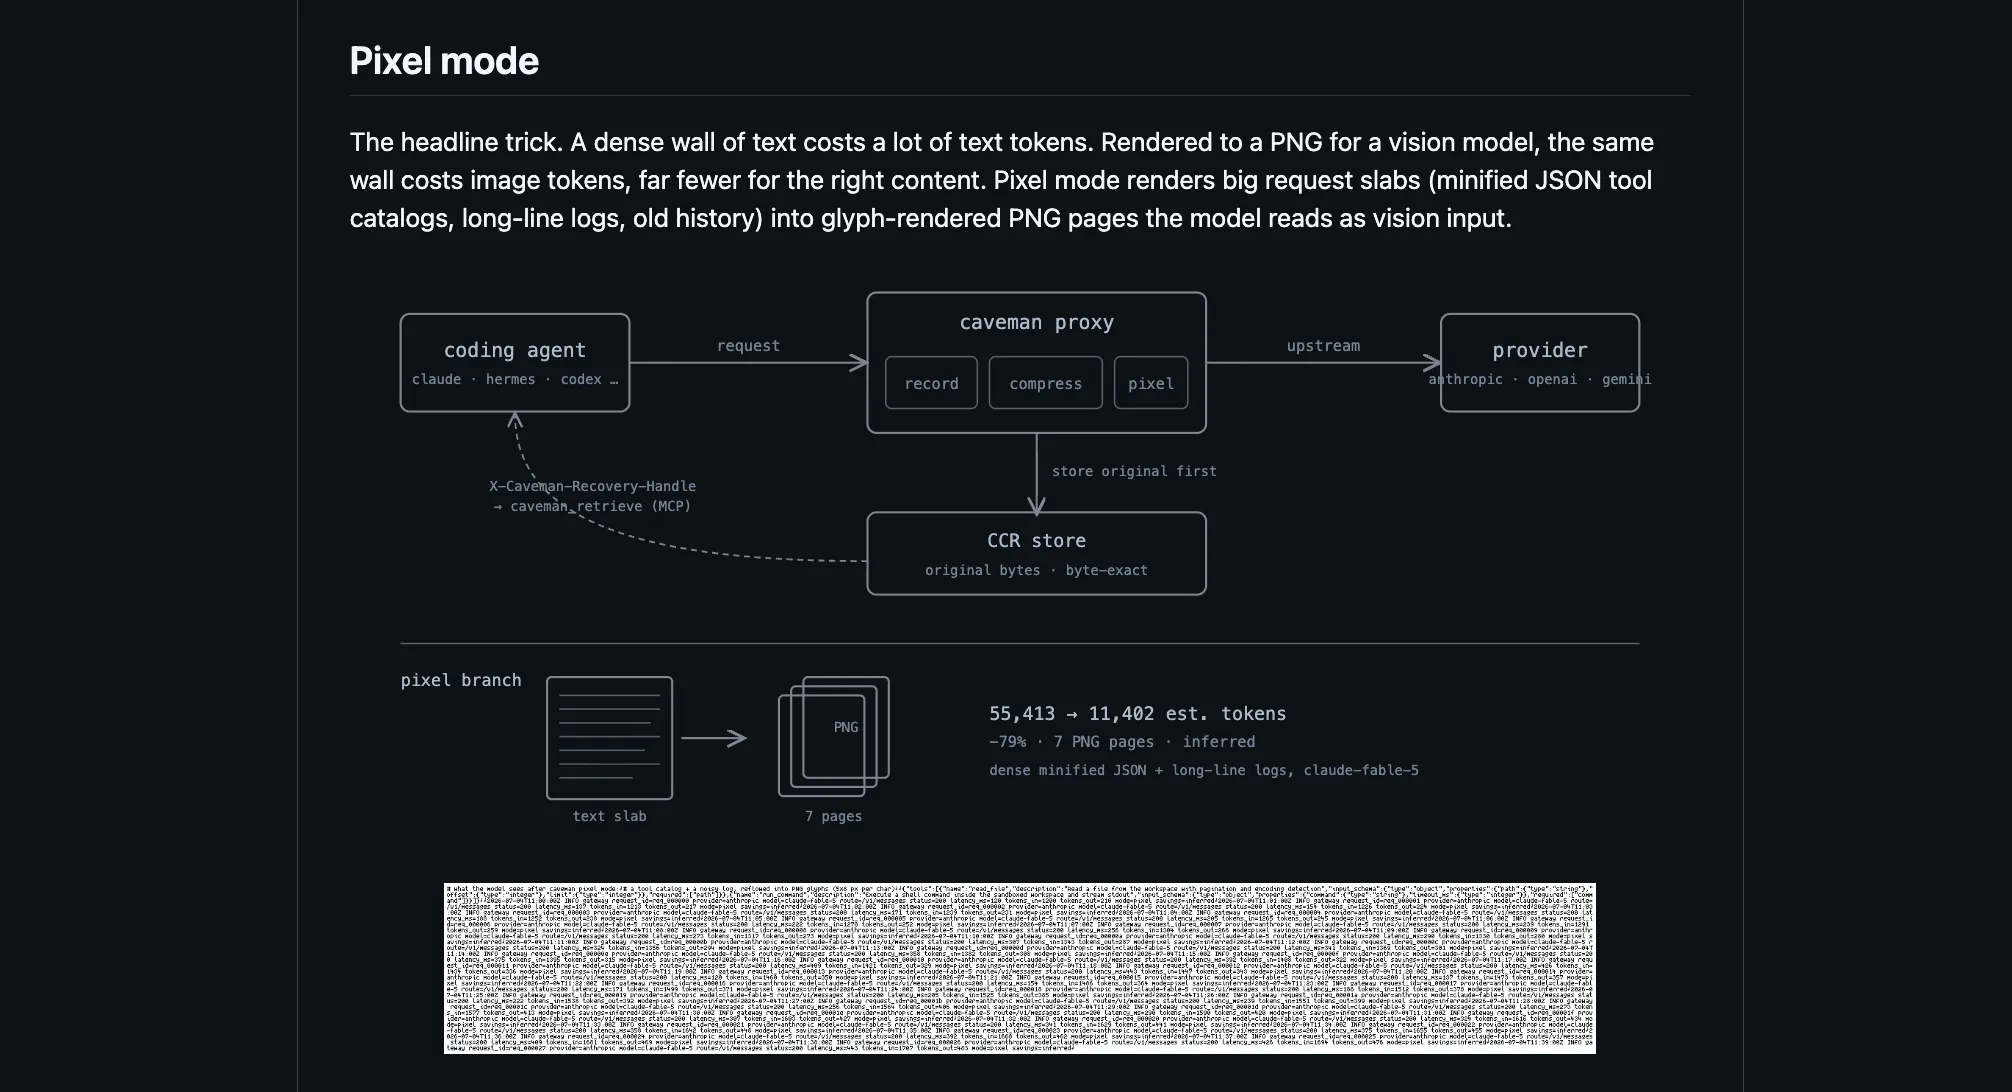
一句话介绍:Caveman 是一个本地代理工具,通过压缩日志、工具输出和文件内容,在调用 Claude Code、Codex、Gemini CLI 等 AI 编程代理前削减输入 token 消耗,从而降低 AI 使用成本,实测可减少约 33% 的输入 token 且不影响正确性。
Open Source
Developer Tools
Artificial Intelligence
GitHub
AI代理优化
token压缩
本地代理
开发者工具
成本优化
开源
性能监控
日志压缩
代码压缩
AI编程辅助
用户评论摘要:用户好评集中在节约成本和 tagline 幽默上;创始人回应强调后续将保持高频率迭代,并承诺更多优化。目前暂无功能缺陷或建议类有效反馈,社区整体处于早期关注阶段,期待更多实测数据和场景验证。
AI 锐评
Caveman 切中的是 AI 编程代理普及后最真实的痛点:token 账单比咖啡还贵。它没有去“优化提示词”这种玄学路线,而是直接在网络层做手术——把日志里的进度噪音、代码里的冗余结构、JSON 里的无用字段,在发给大模型之前先榨干。33% 的 token 节省不是“高达 90%”的营销话术,而是写在 commit 里的 54 次基准测试结果,这种可验证性值得尊重。
但冷静看,这个产品仍有三点悬而未决。第一,压缩是有损变换,虽然设计了 content-addressed store 做回滚,但“agent 能取回原始字节”和“agent 真的会取回”是两码事,一旦压缩导致模型理解偏差,排查成本可能抵消省下的钱。第二,BSL-1.1 许可证虽然四年后转 Apache,但企业采购最忌讳“未来的开源”,这会让部分团队观望。第三,也是更本质的:Caveman 是在为 token 定价的荒谬性打补丁——如果模型上下文窗口和定价结构未来发生剧变,这套精细的压缩引擎可能一夜过时。
不过,创始人对“真实数字”的执着和“打印拒绝压缩原因”的透明度,显示出这是一个懂开发者微妙心理的团队。它不解决“AI 是否聪明”的问题,只解决“用 AI 是否便宜”的问题,这恰恰是当前阶段最有商业价值的位置。短期看是省钱工具,长期看,如果它积累的压缩策略能反哺到模型侧的 tokenizer 设计,价值会被重新定义。值得关注,但别指望它是终局方案。
一句话介绍:Kitbitz 是一个收录了超过2000个手绘风格SVG/PNG矢量素材的免费CC0图库,覆盖13个主题套件,为游戏、应用、插画和创意世界搭建提供即取即用的视觉资产,解决了独立开发者与设计师寻找风格统一且可商用素材的痛点。
Games
Graphics & Design
Illustration
手绘插画
CC0素材库
矢量图形
游戏美术
UI资源
Figma插件
免费商用
世界构建
设计资源
素材下载
用户评论摘要:用户普遍赞赏其艺术质量与免费CC0授权,认为素材间风格统一、组合度高。部分评论对即将推出的世界生成器和Figma插件表示期待,暂无负面反馈或功能请求,核心建议集中于希望生态工具(如插件、生成器)尽快落地。
AI 锐评
Kitbitz 的本质是一次“沉没成本”的巧妙变现——创始人在此前失败的游戏项目中积累了海量高质量美术资产,如今以CC0形式免费释放,实则完成了从“失败项目负债”到“开发者社区资产”的价值转移。这很聪明,但也要看清其商业逻辑的脆弱面:CC0意味着零授权壁垒,任何商业公司都能将这些素材整合进自家产品而不留痕,当前热度(136票)主要依赖创作者的个人叙事与情怀加成,而非不可替代的工具性。真正的护城河不在素材本身,而在于其承诺的周边生态——Figma插件、MCP协议支持和地形/世界生成器才是将“一次性下载库”变为“持续创作基础设施”的关键。若这些工具仅是概念玩具,Kitbitz终将成为又一个被收藏夹吞没的免费资源站;若世界生成器能实现基于素材的模块化拼接,则有机会切入低代码游戏开发与AI辅助场景叙事的细分赛道。另外,素材虽标注“灵活缩放不变形”,但手绘风格在矢量重绘时对锚点质量要求极高,需实测其SVG在不同尺度下的几何稳定性。总体而言,这是一个有审美、有温度的开源式项目,但产品力仍需从“赠品”走向“生产力工具”的蜕变。
一句话介绍:Mem Agent 是一款“不让任何事掉链子”的 AI 记忆与任务代理,它把你散落在笔记、会议、邮件和语音里的待办与想法自动整理成动态任务模型,并在最合适的时机主动提醒你跟进,尤其适合信息碎片化严重、靠传统待办清单难以坚持的职场人和轻度 ADHD 用户。
Productivity
Task Management
Artificial Intelligence
AI助手
任务管理
记忆增强
主动提醒
笔记工具
生产力工具
语音速记
智能体
个人知识管理
自动化跟进
用户评论摘要:用户普遍认可其“主动跟进”和“按上下文回放”能力,能替代传统待办清单,降低压力。主要问题:语音转写支持语言有限,影响非英语用户使用;有用户担心价格会上涨;部分用户关注提醒时机的智能判断边界,担心过度打扰。
AI 锐评
Mem Agent 本质上不是又一个“笔记+待办”的缝合怪,而是把“记忆”从被动存储升级为主动执行的中枢。它的核心差异在于“有主见”——不靠用户手动设置截止日期,而是基于你喂给它的所有上下文(笔记、邮件、会议、健康数据甚至手写日志)建立一个动态的优先级模型,然后在它认为“合适的时候”推你一把。这正好命中了传统任务管理工具的最大死穴:收集容易,回访难,坚持更难。从评论看,用户最惊艳的不是它能记,而是它“知道什么时候该提”——这背后是对真实工作节奏的理解,而不是简单的日历提醒。
但问题同样明显。首先,它的“智能”依赖对用户数据的深度读取和建模,这意味着隐私边界和信任成本极高,目前评论里尚未有人质疑数据安全,这是潜在的雷区。其次,语音转写语言支持有限,直接砍掉了一大块非英语市场,对于一个宣称“无摩擦捕获”的工具而言,这是硬伤。第三,AI 判定“合适时机”的算法一旦在复杂场景下误判(比如紧急事务被后置),用户信任就会迅速崩塌——而评论中已有用户表达了对“提醒变成打扰”的担忧,这恰恰是这类产品从“助手”沦为“噪音”的分水岭。Mem Agent 目前最大的护城河不是技术,而是它把“跟进”这件事做成了产品默认行为,而非用户额外付出的努力。它值得关注,但若不能在多语言支持和主动提醒的可解释性上补课,很容易从“AI 代理”滑向“高级闹钟”。
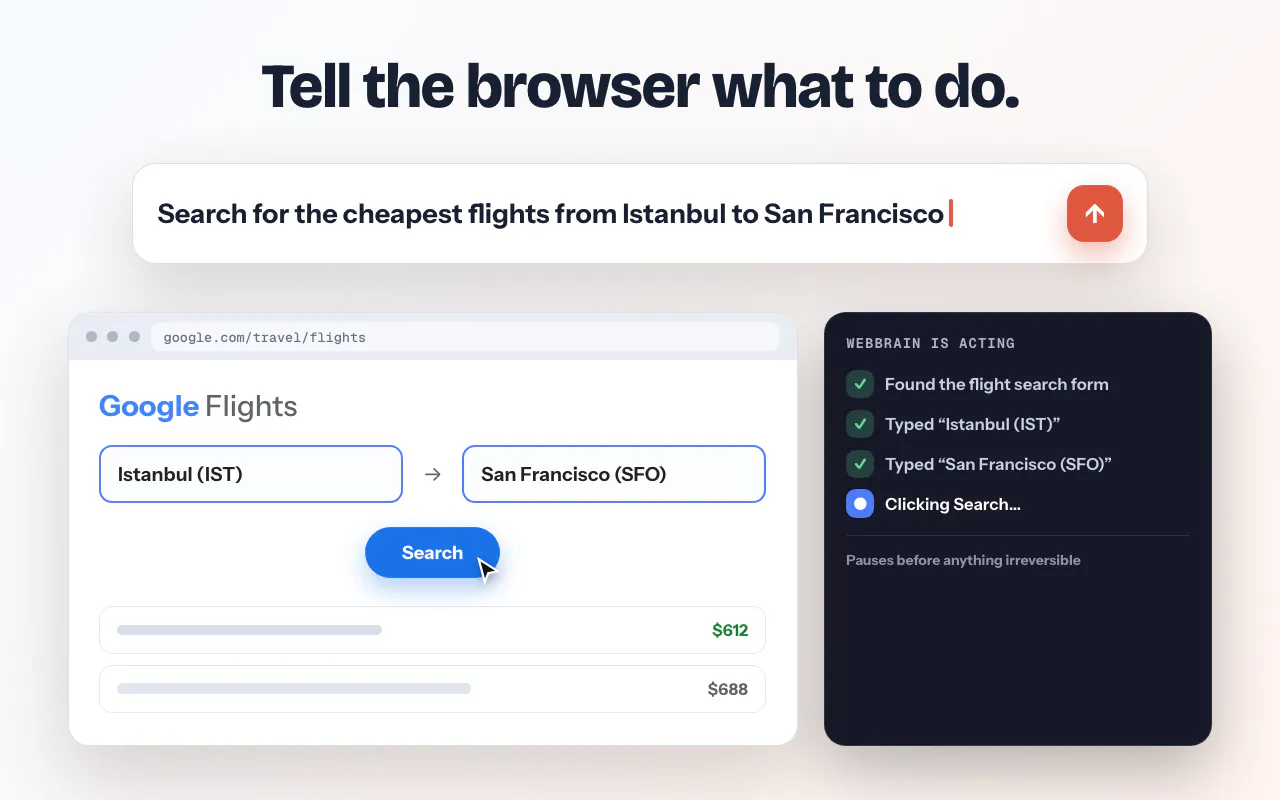
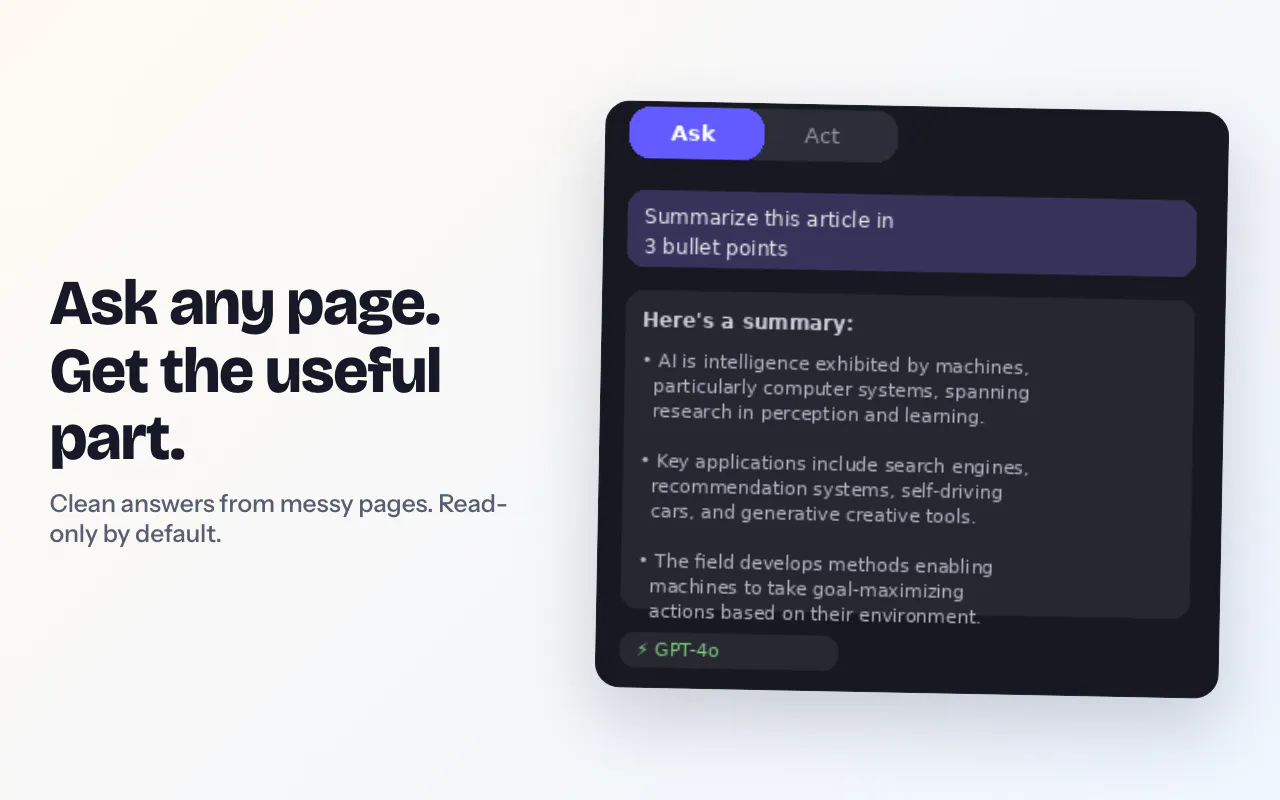
一句话介绍:WebBrain是一款免费开源的浏览器侧边栏AI代理,通过本地运行或自带API密钥接入任意大模型,帮用户直接读取网页、提取数据并自动化操作,解决传统浏览器AI助手受限于模型和订阅、数据隐私难保障的痛点。
Browser Extensions
Chrome Extensions
Artificial Intelligence
GitHub
AI浏览器助手
开源
本地推理
侧边栏扩展
数据隐私
多模型支持
网页自动化
浏览器代理
BYOK
MIT协议
用户评论摘要:用户肯定本地优先的定位,并建议宣传时强调“数据不出设备”而非单纯“开源”,以打消企业安装顾虑。另有开发者询问本地小模型在复杂多步任务上的表现,主创回应称Qwen 3.6 27B等模型在24GB显存设备上效果良好,但视觉能力仍待完善。
AI 锐评
WebBrain踩中了AI浏览器代理行业的两个结构性裂缝。第一,现有头部玩家(如Dia、Perplexity等)普遍将模型与产品绑定,用户被锁死在订阅制与特定云端模型上,而WebBrain用“BYOK+本地推理”双轨制把选择权和数据主权还给了用户——这不仅是功能差异,更是一种渠道策略:它借用用户自带的API Key和本地算力,大幅降低了自身的运营成本,将开源项目的可持续性建立在生态而非资本上。第二,它精准选择了侧边栏而非完整浏览器改造,切入成本极低,同时利用浏览器原生会话与Cookie构建真实操作上下文,这一点远比许多需要单独登录的AI助手更接近“替你干活的人”。
但锐评必须指出其软肋。社区评论已点出灵魂问题:本地模型在复杂多步任务上仍显著落后于Claude/OpenAI,而创作者的回答只能搬出“效果不错”和一堆模型名称,缺乏可复现的基准对比,这等于承认核心体验依赖用户自己掏钱买高性能GPU或调用云端API。所谓的“本地优先”在消费级设备上更多是心理安慰,而非性能保障。更致命的是,浏览器扩展持有用户全部登录态,权限边界极其模糊——评论中那句“它继承了你已登录的一切”就是对安全模型的最大讽刺。一旦提示词注入或恶意网站诱导代理执行错误指令,数据泄露的爆炸半径被“本地”概念极度缩小,但风险仍真实存在。
WebBrain的价值不在于它今天多能用,而在于它验证了一个命题:浏览器代理的底层逻辑正从“订阅制全家桶”向“开放协议+自带模型”迁移。它是一块试金石,真正的考验在于能否在拿到足够反馈后,把“token-conscious”的工程能力沉淀为一套默认安全的代理指令协议。在此之前,它更像一个极客玩具,而非大众生产力工具。开源是姿态,本地是卖点,但这台机器能否真正替用户干活,还得看未来三个月的模型适配速度和社区贡献质量。
一句话介绍:Google Pixel 11 通过“翻转即静默”的 LED HiLight 通知与更强大的 Tensor G6 端侧 AI,让手机在后台替你处理跨应用任务,只在真正需要时用灯光轻提示,解决“通知轰炸”与“操作繁琐”的双重注意力负担。
Android
Hardware
Cell Phone
智能手机
AI助手
端侧计算
Tensor G6
通知管理
隐私交互
摄影升级
Gemini
手势反馈
旗舰机型
用户评论摘要:有效评论仅一条(获3赞),来自官方/核心用户。核心反馈:赞赏“翻转静默+LED通知”的注意力救赎理念,期待Gemini在跨应用操作(订车、下单)的落地,并认可7年系统更新与硬件升级。无负面或具体问题,信息量偏薄,缺乏第三方真实使用痛点。
AI 锐评
Google Pixel 11 的亮点不在“更快的芯片”或“更好的相机”,而在于一个被行业忽视的洞察:AI 越强大,手机越不该刷存在感。HiLight LED 通知把“提示”从屏幕霸权中解放出来——翻转手机即进入“勿扰但知情”状态,这是对当前“通知即焦虑”生态的一次温和反叛。Tensor G6 的端侧算力则让 Gemini 能安静处理跨应用事务,而非每次调用都弹窗确认,本质上是在训练用户“信任系统”。
但问题同样尖锐:其一,“翻转静默”是物理动作,与“AI 判断何时该打扰”存在天然冲突——如果 AI 足够聪明,为何还要用户手动翻转?其二,演示中的“订车、下单”都是高风险操作,端侧 AI 一旦出错,责任归属与纠错成本远高于效率收益。其三,116 票的冷启动数据说明,这款概念机并未击穿大众心智,评论区的自说自话更像“极客共振”,而非市场验证。Pixel 11 目前的价值更接近“方向标”——它证明 AI 手机的下半场不是拼参数,而是拼“如何克制地介入生活”。但克制的前提是绝对可靠,这一点,Google 尚未给出令人信服的证据。
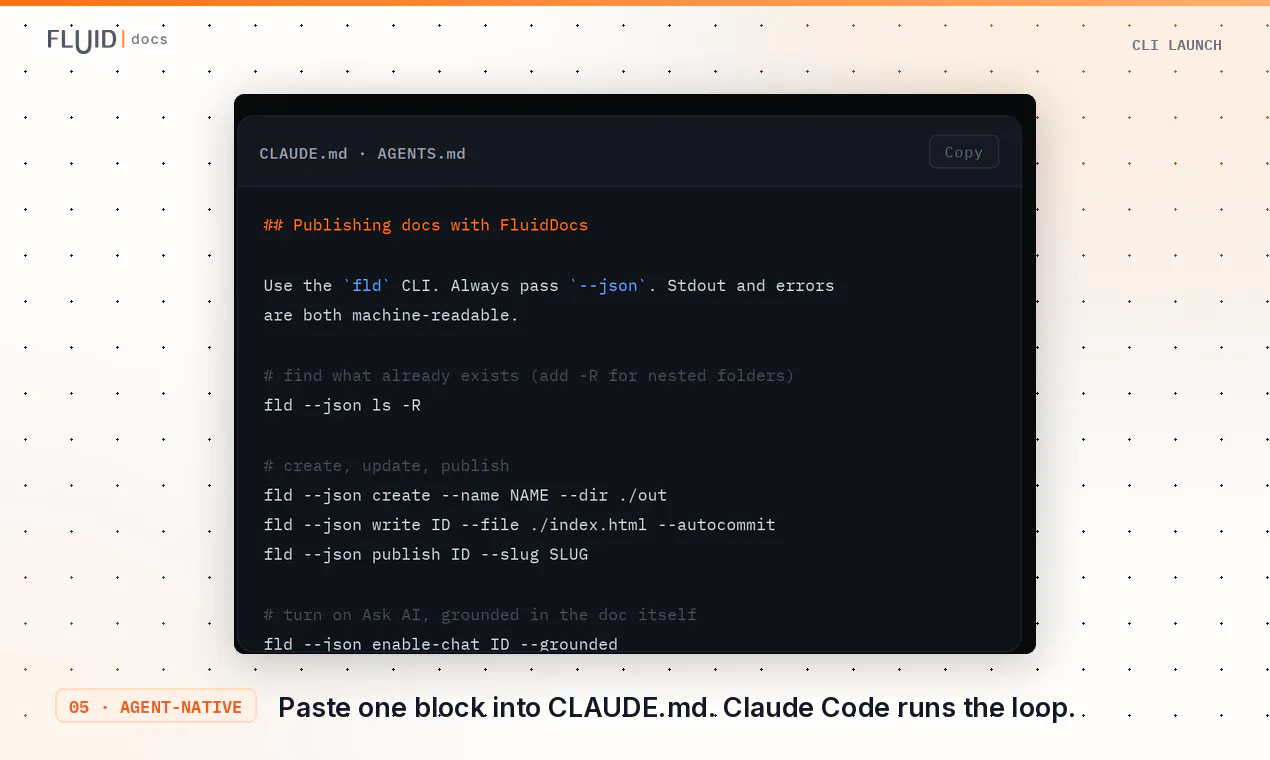
一句话介绍:FluidDocs CLI将提示词转化为可交互的智能文档,让发送后的文档能实时回答读者提问,并向作者汇报阅读进度和问题,解决静态文档信息单向传递、反馈缺失和版本混乱的痛点。
Design Tools
Productivity
Artificial Intelligence
交互式文档
CLI工具
AI问答
文档分析
文档出版
智能文档
开发者工具
MCP替代
内容追踪
办公效率
用户评论摘要:用户主要关注三点:非技术用户能否免命令行使用(官方回复有Web应用);读者提问是否需要注册(回复称无需账号,附示例链接);AI回答是否受限于文档内容(未获直接回复)。另有用户赞赏链接更新功能,并计划用于融资材料和研究项目场景。
AI 锐评
FluidDocs CLI的价值不在于“文档交互”这个表象,而在于它重新定义了文档的生命周期——从“发送即结束”变为“持续反馈回路”。其杀手级功能是结合了Claude Code等编程代理,将AI能力从文档生成延伸到发布后的迭代优化:通过CLI获取读者提问,反向优化文档内容,这实质上是构建了一个闭环的知识管理系统。115票的社区反馈印证了其精准切入开发者市场,但需冷静看待:其一,评论区核心关切“客户端是否需要注册”与“AI是否仅限文档内部知识”均未得到直接解答,这动摇了企业级应用的信任根基;其二,CLI在终端显示的可读性优势明显,但对非技术用户是硬门槛,官方虽提供Web端,却弱化了“命令行优先”的差异化定位。长远看,FluidDocs的真正壁垒在于其阅读数据的沉淀——谁打开了文档、看到了哪里、问了什么,这些行为数据远比文档内容本身更具商业想象空间。若能将此数据资产转化为智能文档的推荐引擎或知识图谱,其价值将远超“智能PDF”的范畴,否则仅是ChatPDF的工程化翻版。
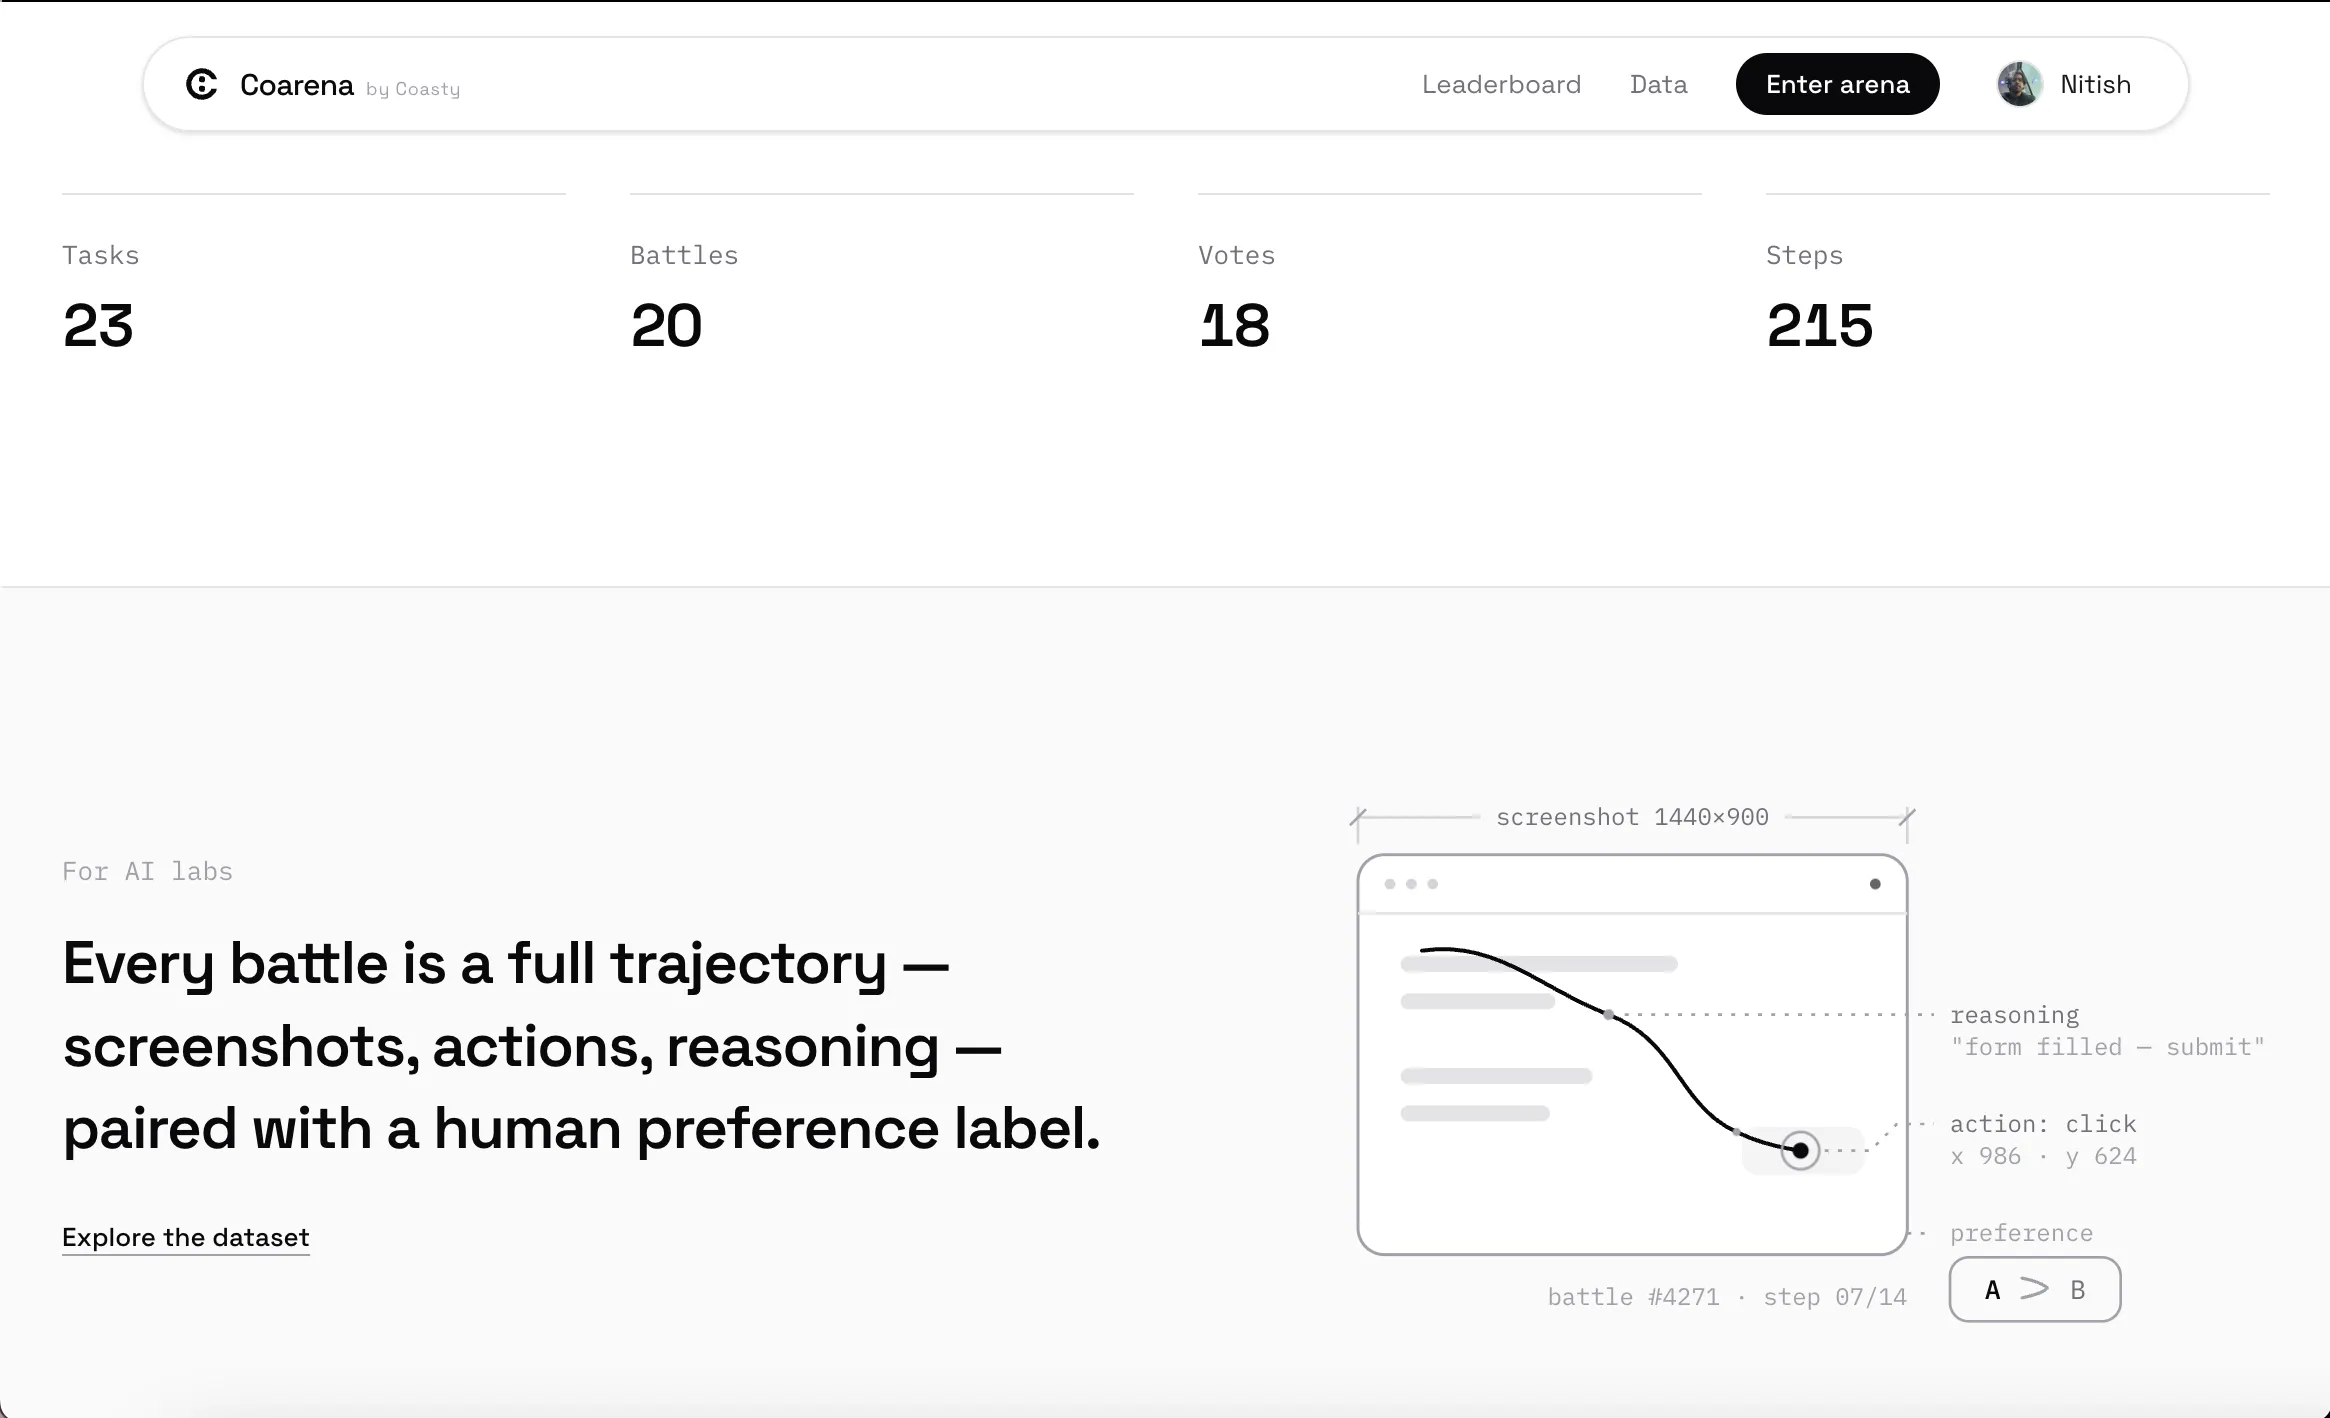
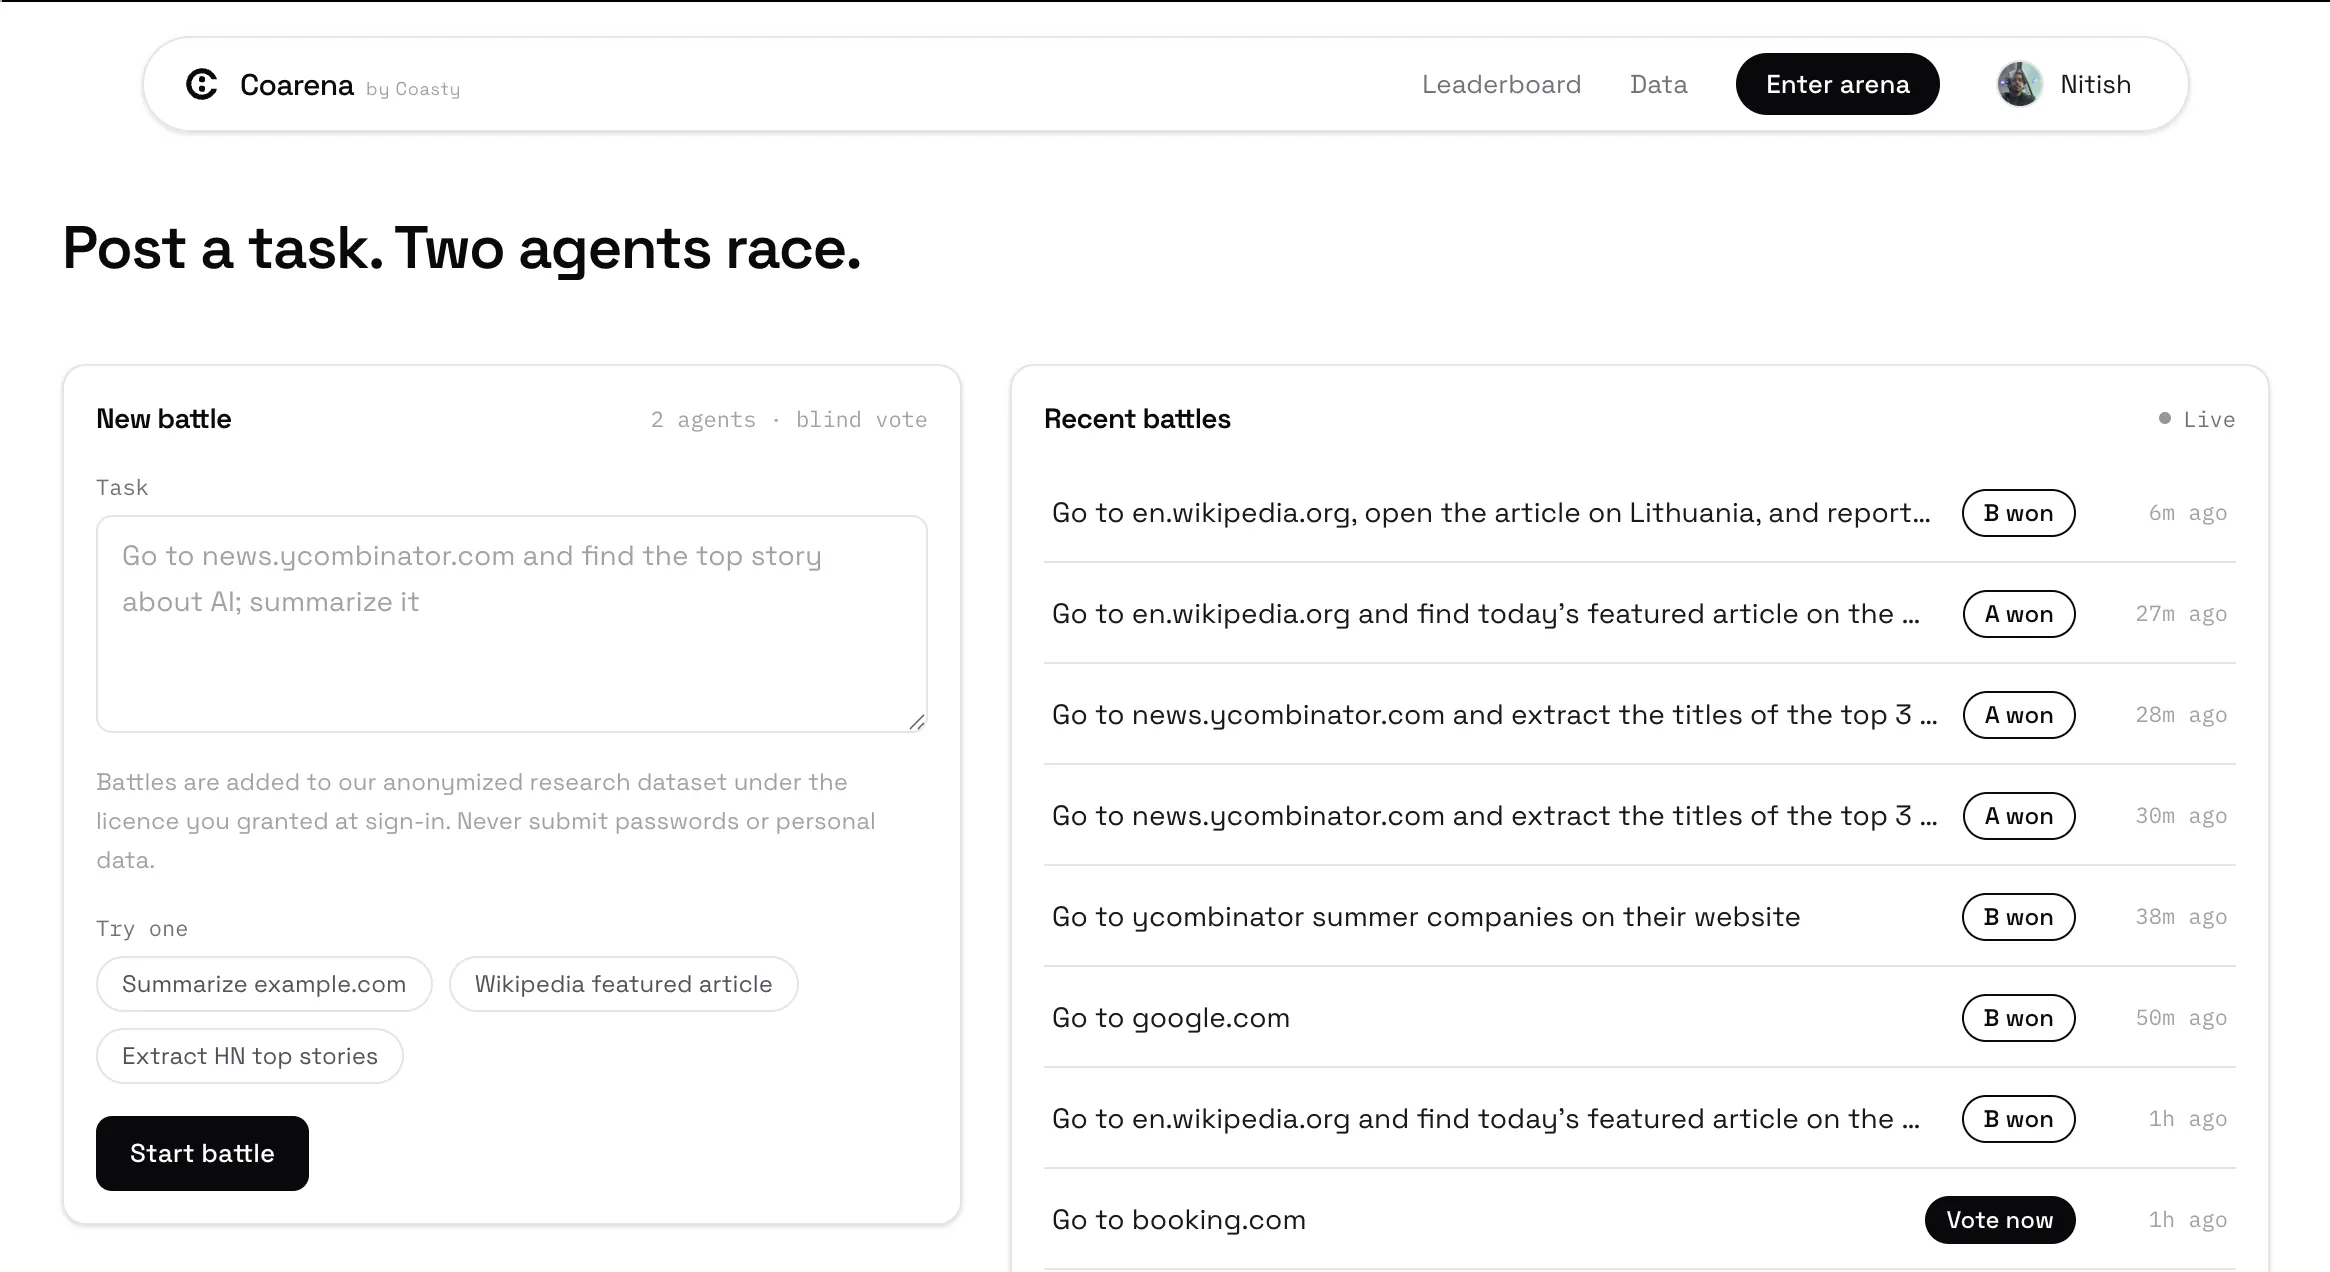
一句话介绍:
Analytics
Tech
Data
AI智能体评测
智能体竞技场
真实任务测试
人机对比
模型性能比较
社区投票
浏览器自动化
企业软件
基准测试替代
开发者工具
用户评论摘要:用户核心需求集中在三点:补充成本与延迟指标;增加任务多样性(如日常重复性工作、对抗性陷阱任务);关注评测方法论(失败重试是否计分、多余操作惩罚、自动裁判可信度)。另有用户质疑“20次干净跑”无法暴露脆弱性,强调需覆盖状态变化与中断恢复。
AI 锐评
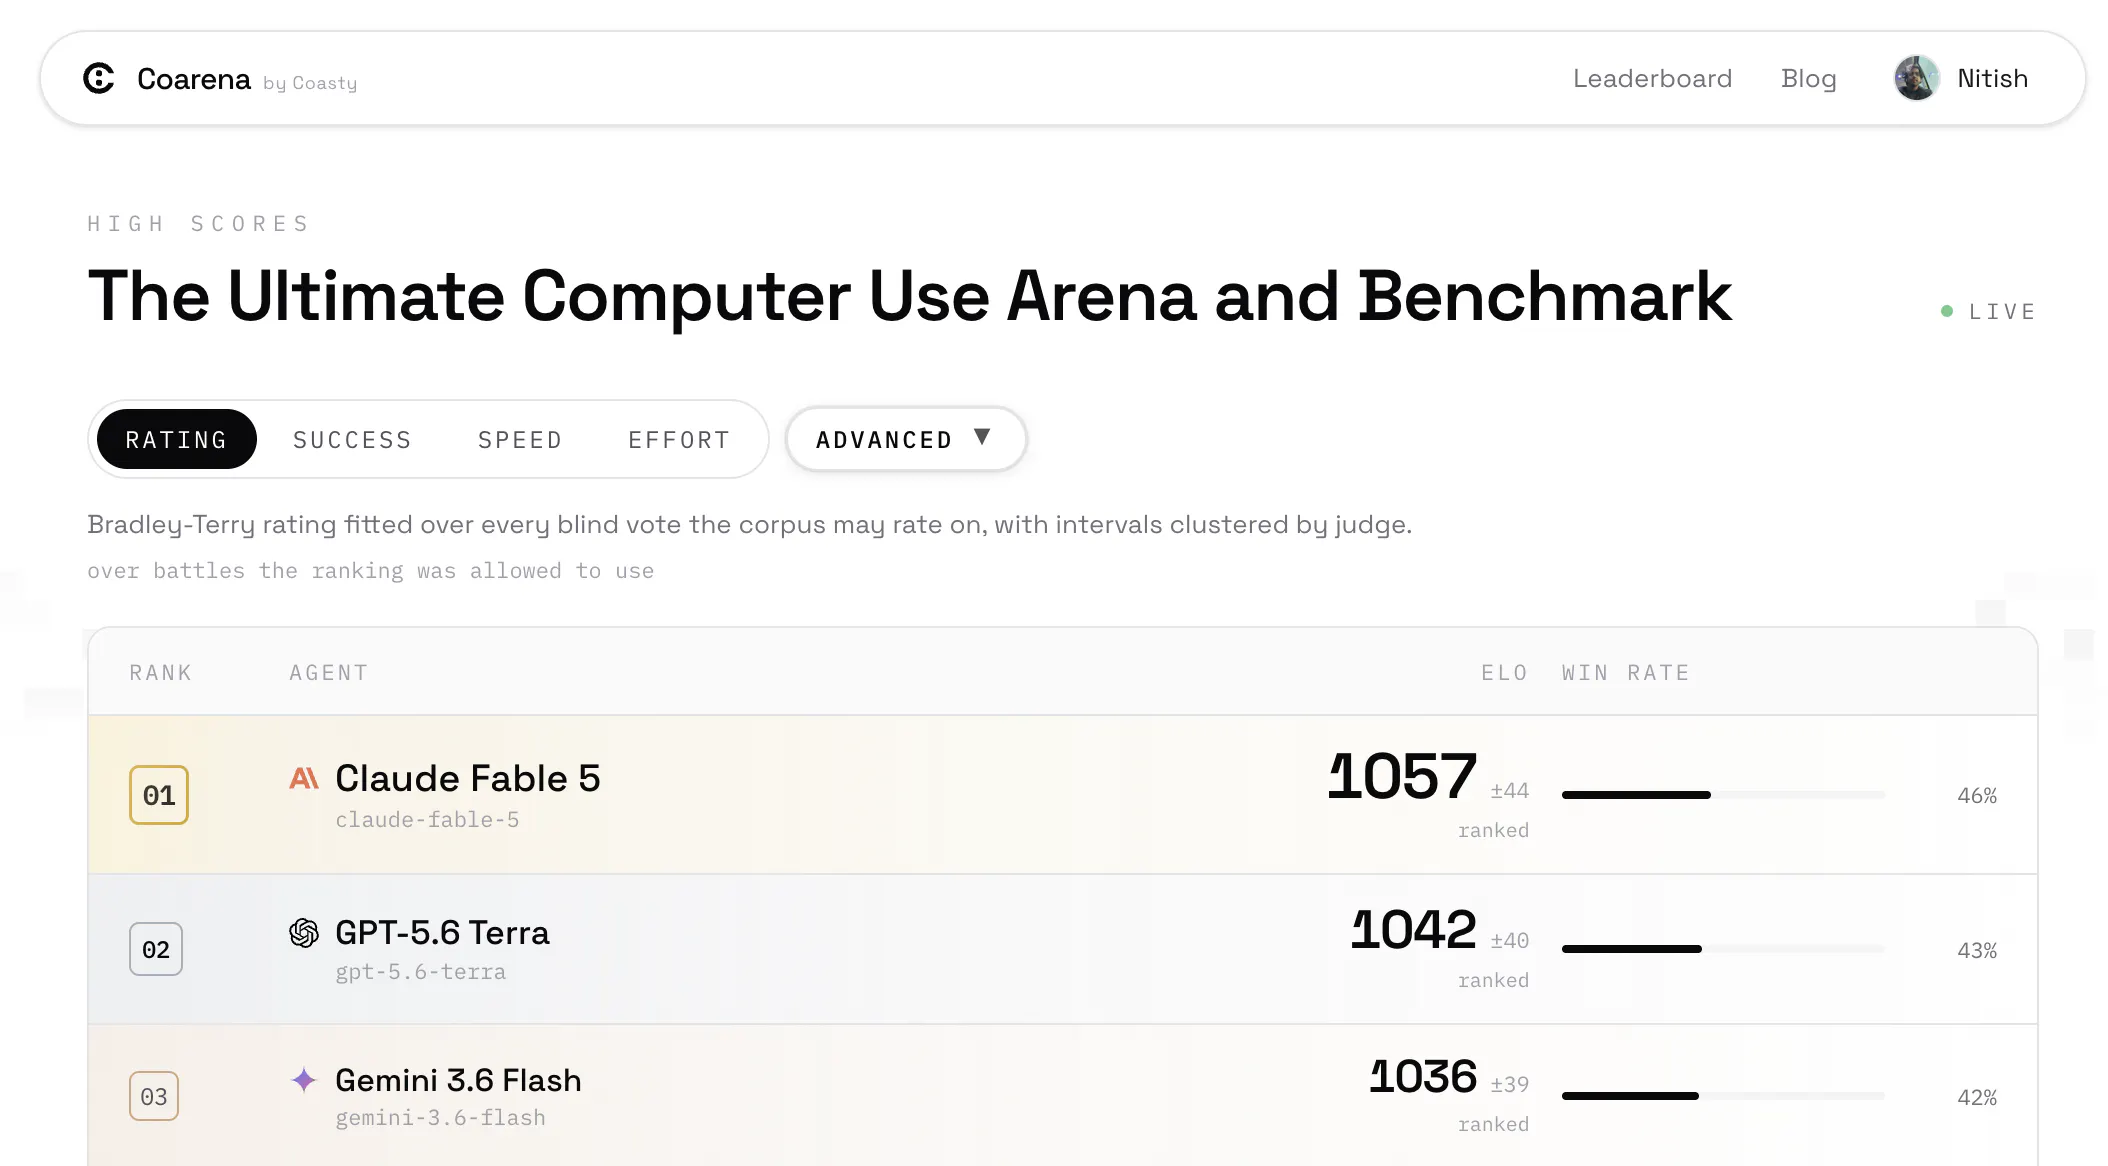
Coarena踩中了AI评测的痛点——基准测试与真实生产力之间的鸿沟,其“盲测+人工投票”模式在方法论上优于纯自动化指标,但也暴露了更深层的矛盾。平台目前的核心价值是“对比”,而非“评估”:它让用户直观感知模型差距,却回避了评测标准的定义权问题。人工投票看似民主,实则将“优劣”降维成“偏好”,且同一任务多次运行不一致性(脆性)被用户精准指出,这说明demo展示的误导性远大于评分本身。更关键的是,平台缺乏成本、延迟、恢复能力等工程维度数据,而这恰恰是决定agent能否从玩具走向生产力的要素。创始人有OSWorld背景,却选择了让用户提问而非主动定义评测协议,这让平台短期像营销工具而非度量标准。真正的机会在于从“竞技场”升级为“可信基准委员会”:公开任务状态变更策略、允许用户提交私有任务、引入参数化测试(如会话中断、布局漂移)。否则,当OpenAI或Anthropic自家评测体系成熟时,这类第三方平台将迅速失去话语权。投票数105说明热度尚可,但留存率取决于是否能把“看热闹”转化为“测我的业务任务”。
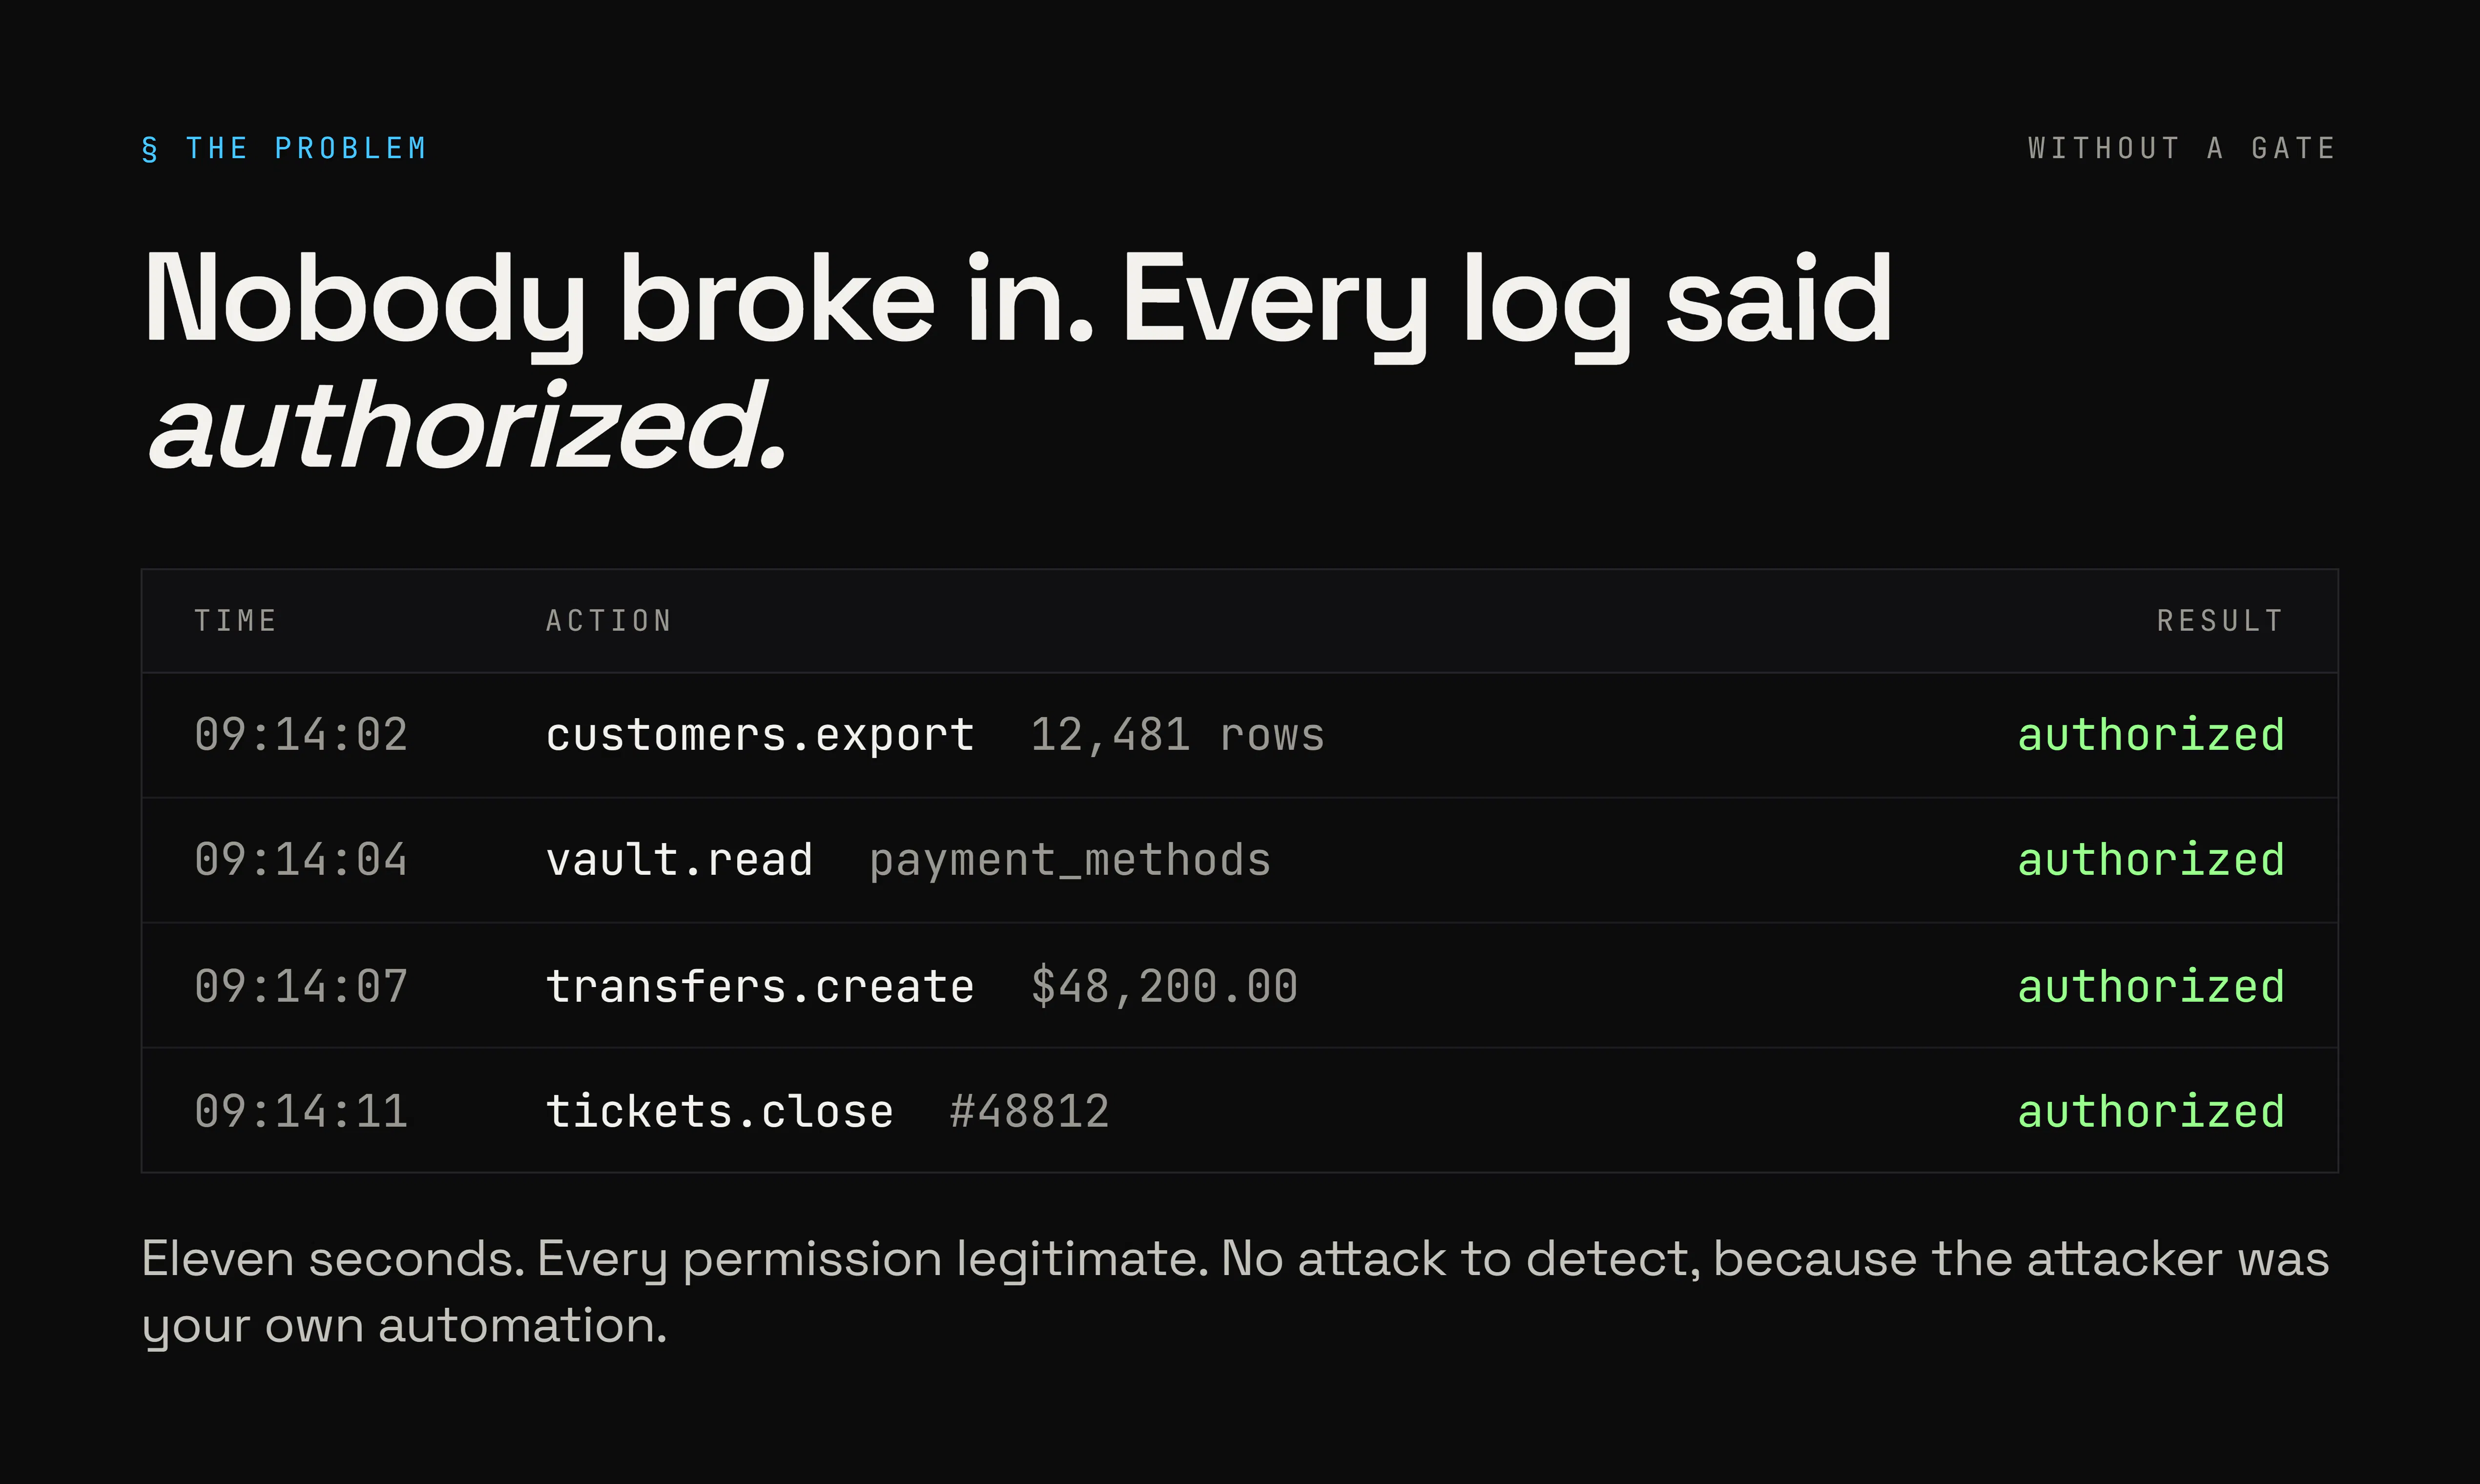
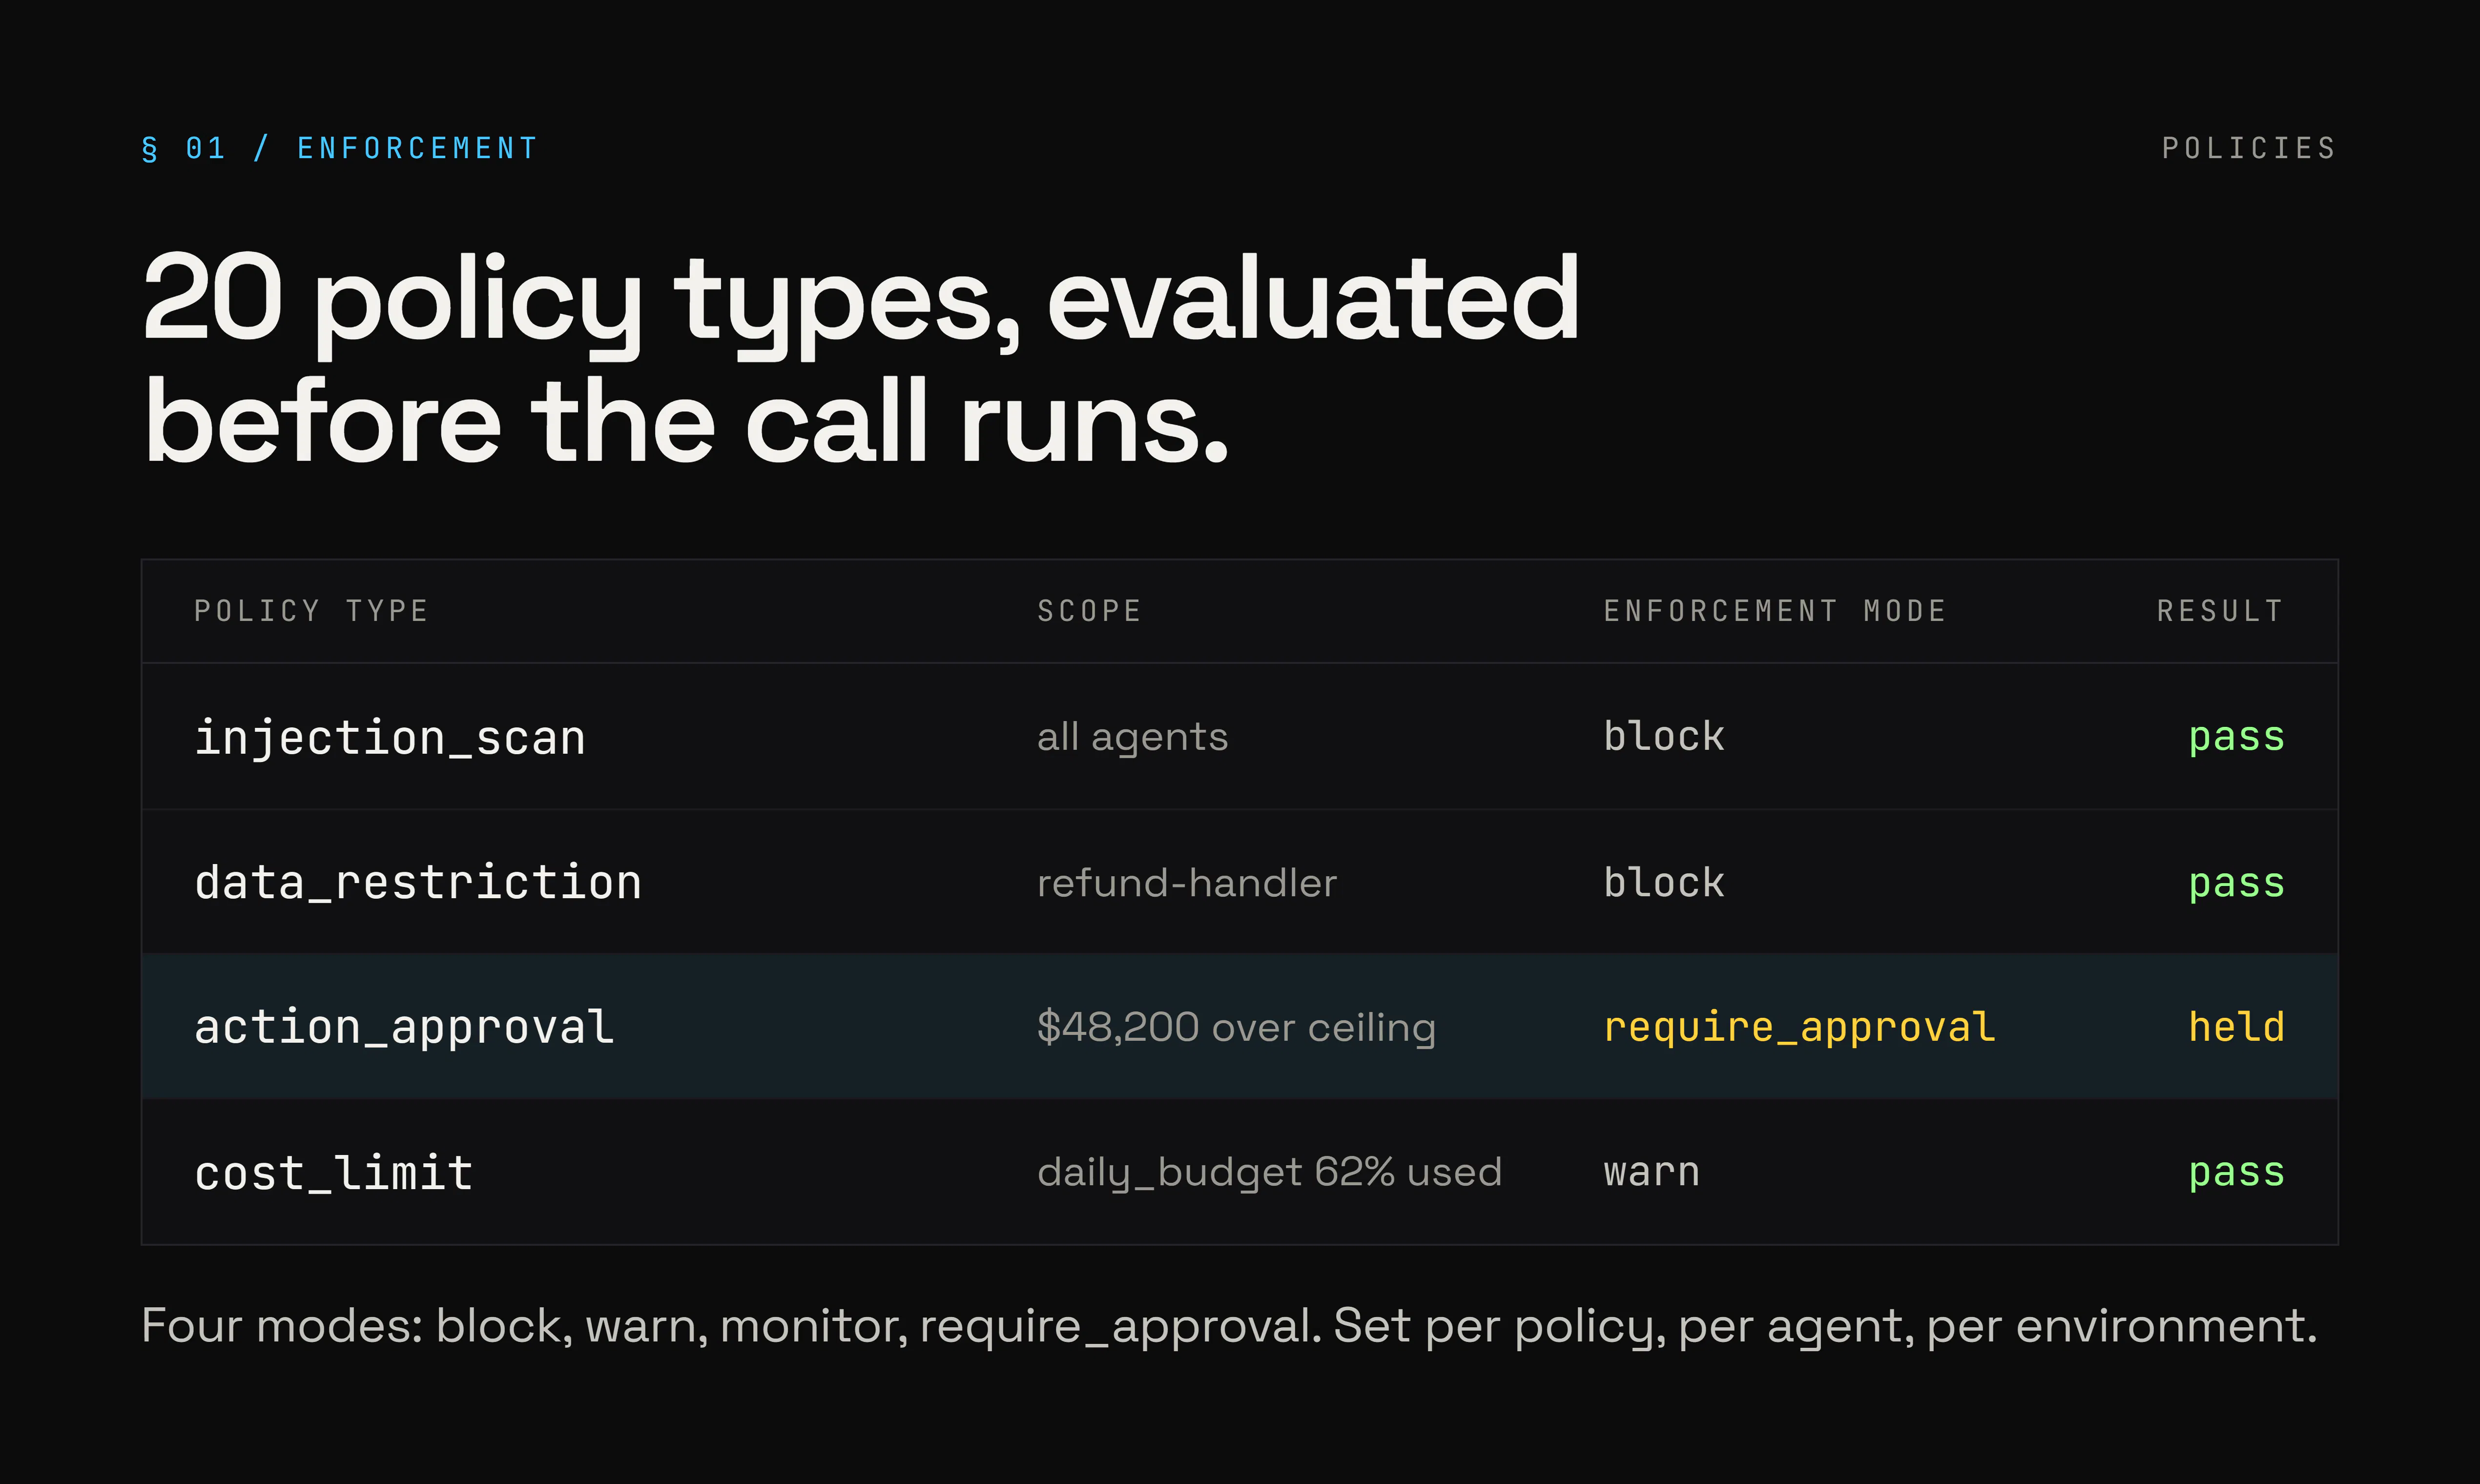
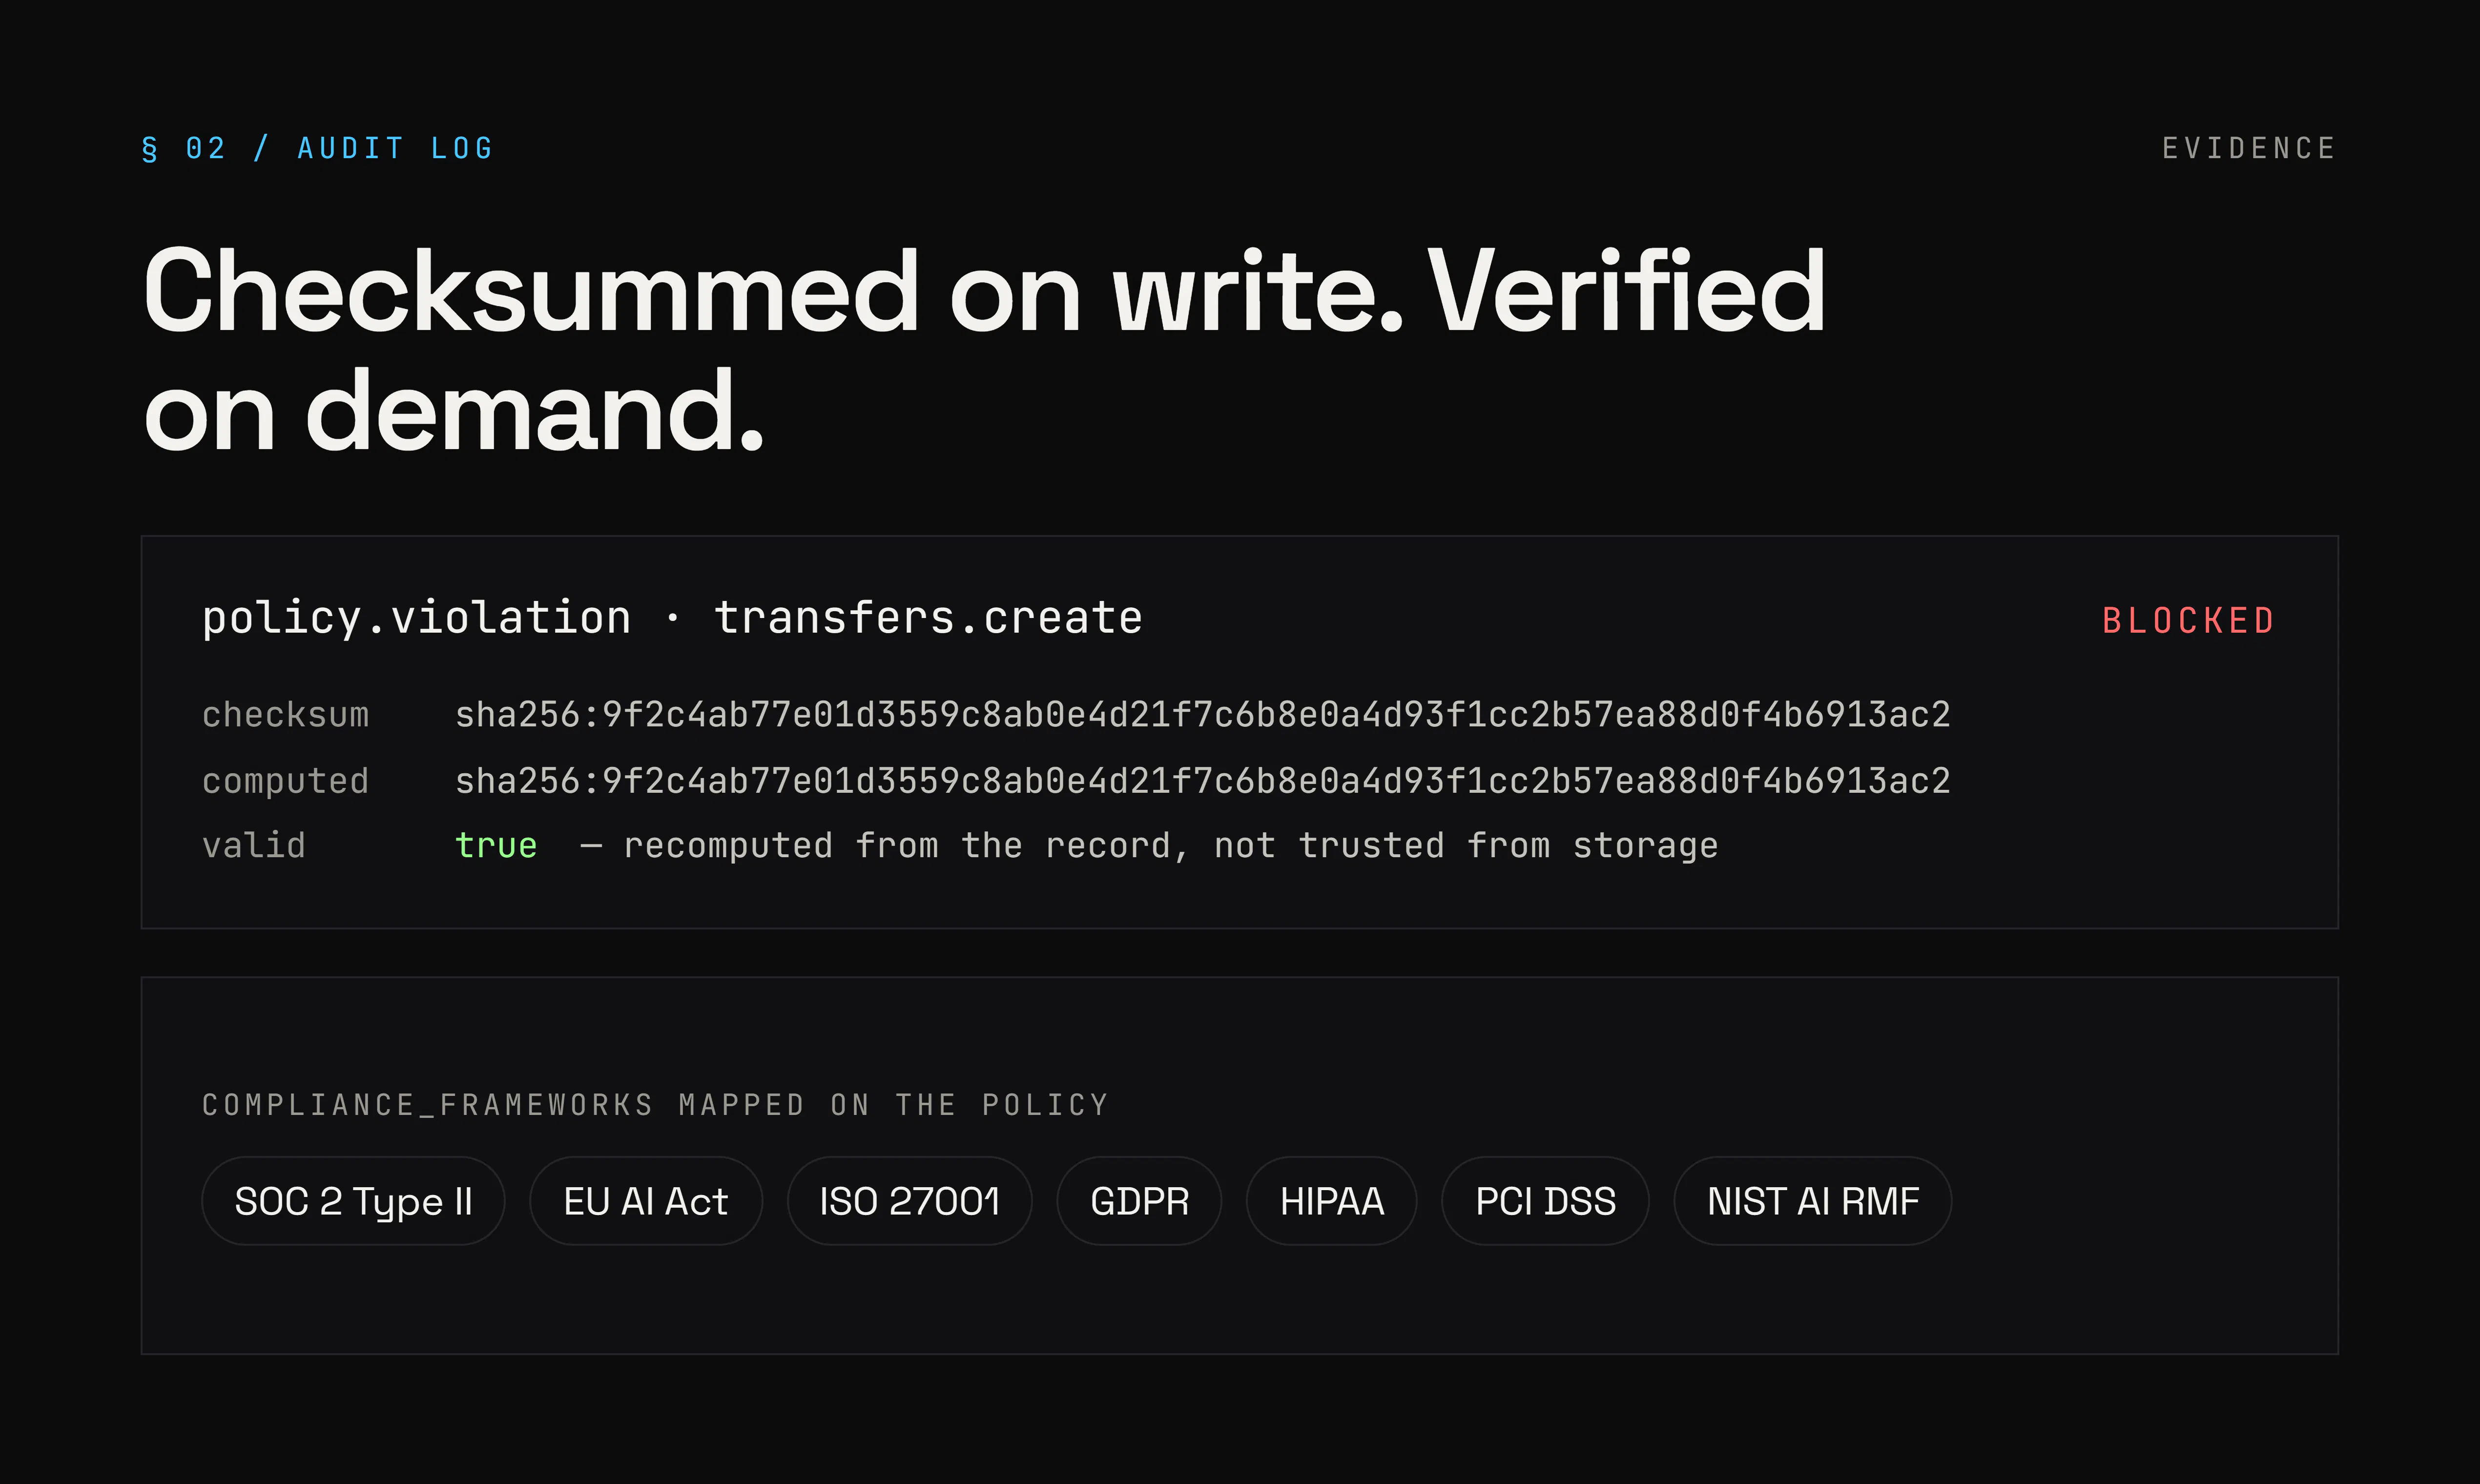
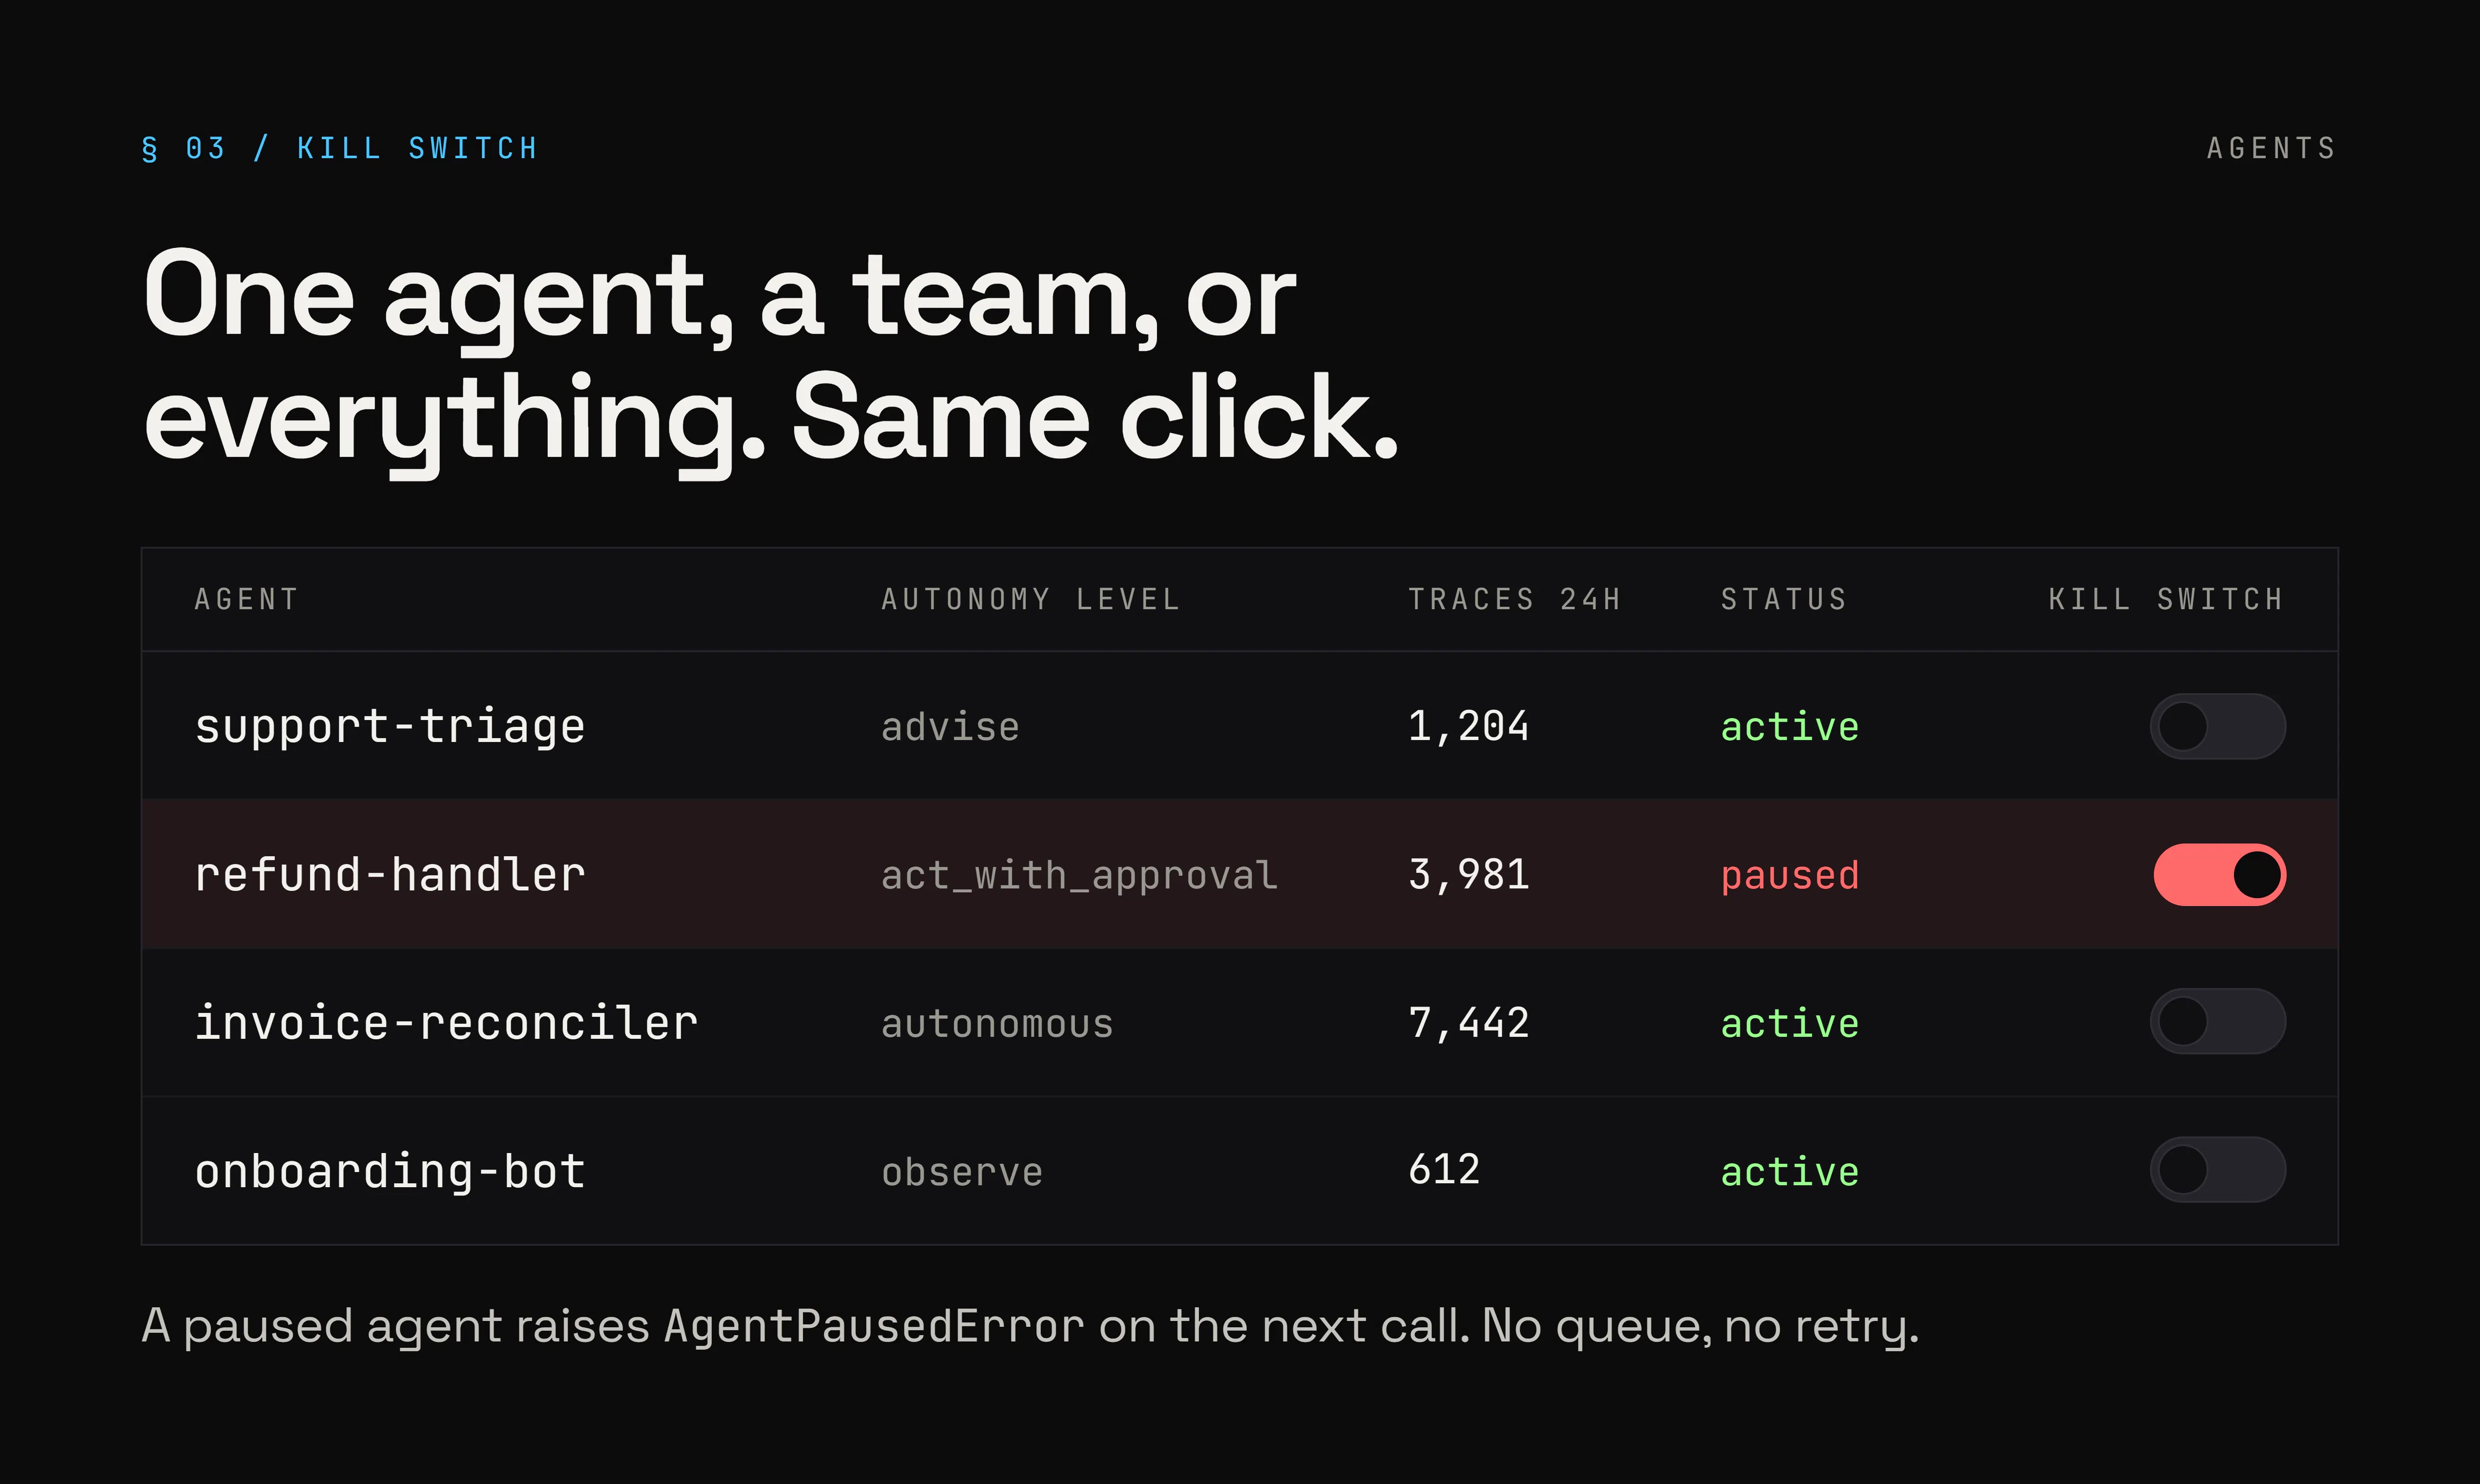
一句话介绍:Execlave 是一个位于AI智能体与真实系统之间的运行时治理与 enforcement 平台,在每一次行动执行前强制校验策略,解决自主代理在真实环境中“有权限即滥用”、事后审计却无法阻止的合规与安全痛点。
Developer Tools
Artificial Intelligence
Security
AI代理安全
运行时治理
策略执行引擎
权限管控
合规审计
SOC2
EU AI Act
杀毒开关
MCP安全
企业级AI
用户评论摘要:用户高度认可“事前拦截”思路,核心追问集中在:被拦截后代理能否获得可操作的上下文重试;审计追踪是否区分“策略拦截”、“系统超时”、“下游报错”及“接受未执行”等独立状态;配置策略门槛及性能开销。并有实际问题(如EU政府服务故障)探询细节。
AI 锐评
Execlave 踩中了当前AI Agent产业化最痛的脚踝:不是模型不够聪明,而是授权后无法无天。其“运行时网关”的定位精准,将治理从“日志考古”前置到“执行裁判”,切中了安全团队对 SOC 2、EU AI Act 的合规焦虑。104票的冷启动数据不算亮眼,但评论区技术对话质量极高,堪称硬核。
值得肯定的是,产品对失败模式的分类(policy_blocked/timeout/error/fail-open provenance)展现了罕见的技术成熟度,这比单纯宣传“拦截”更有说服力——它承认了分布式系统中治理服务本身可能宕机的现实,并提供了可审计的降级路径。这使其更像一个企业级基础设施,而非玩具。
但犀利的质疑依然存在:其一,评论中承认“前一周用来定义策略”,这意味着产品交付的是“执行器”而非“政策大脑”。对于大多数没有清晰权限图谱的中型企业,冷启动成本极高,极易沦为摆设或过度限制的枷锁。其二,20ms的延迟预算在纯策略匹配下可行,但一旦涉及复杂上下文解析或外部数据查询,性能边界存疑。其三,也是最根本的:该产品的护城河在于策略表达能力和生态集成深度,而非技术壁垒。一旦 AWS、微软在 Bedrock/Azure AI 原生集成类似治理层,独立厂商的空间会被急剧挤压。当前$199/月的定价瞄准的是有明确合规压力的平台团队,这步棋走对了,但必须跑赢云厂商的默认功能迭代速度。总之,方向正确,切口锋利,但前路是巨头阴影下的马拉松。
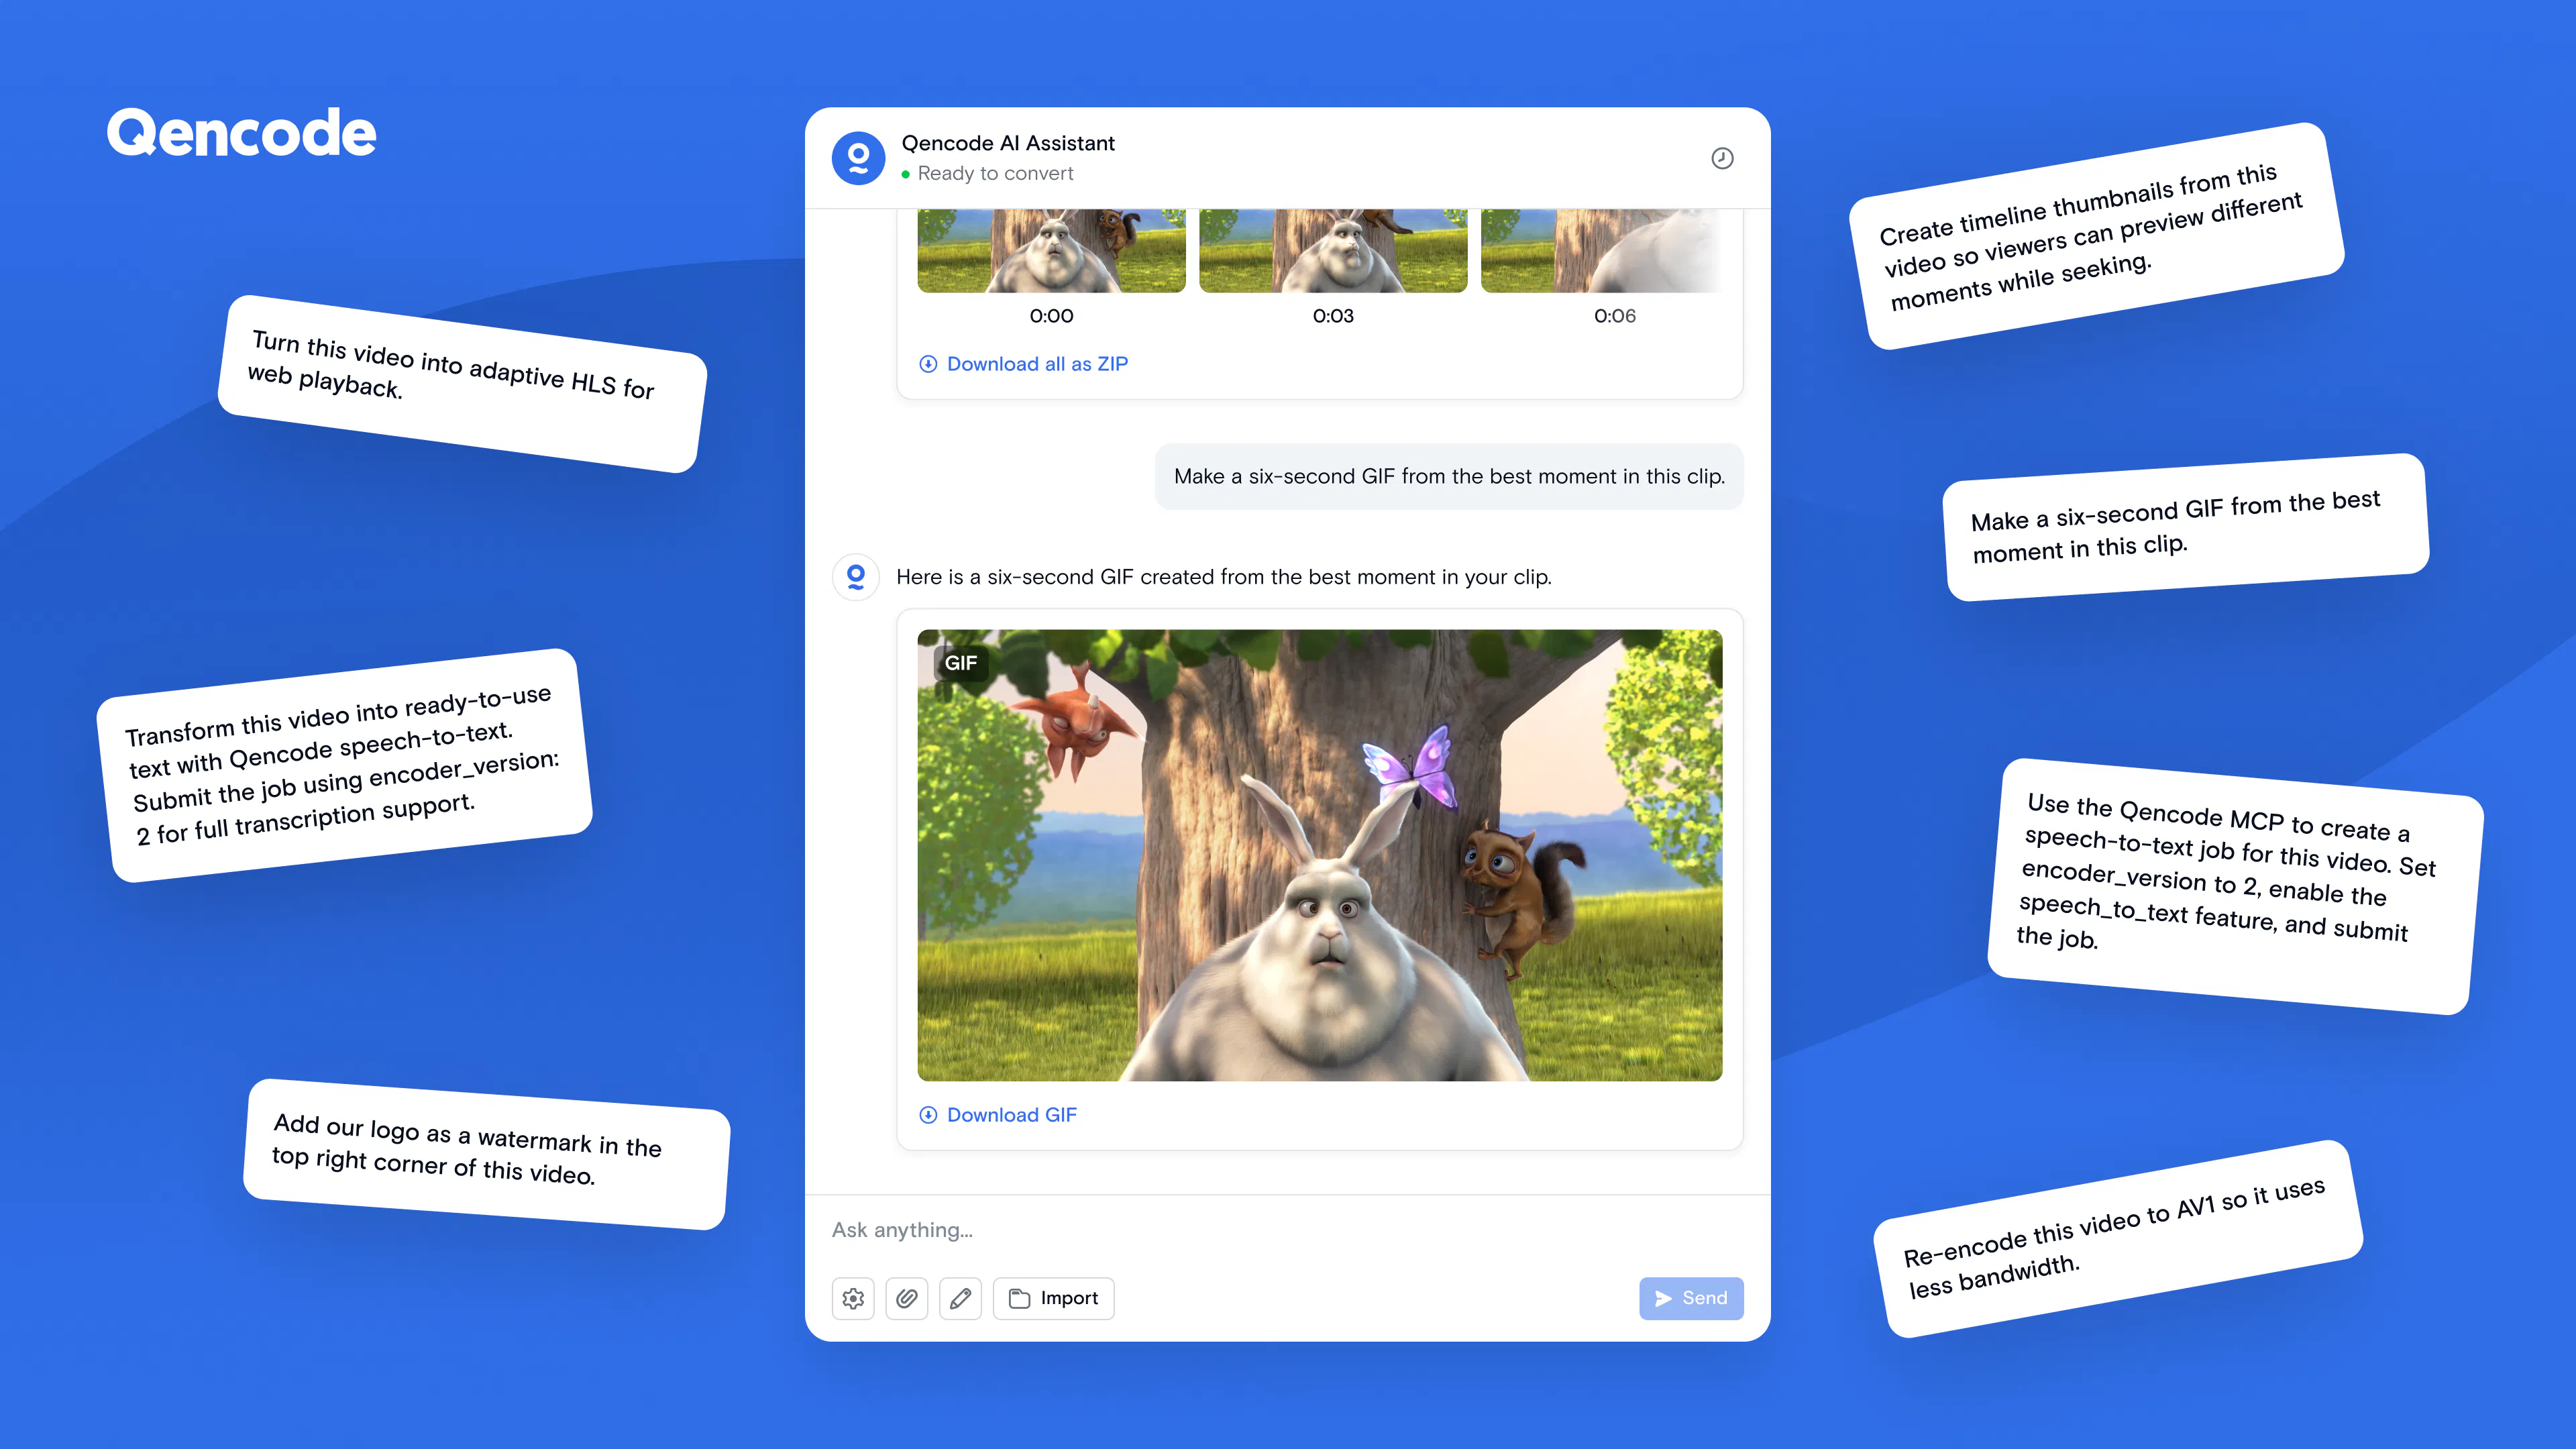
一句话介绍:Qencode MCP 是一款将视频云处理能力封装为 AI 代理(如 Claude)可调用的工具,让用户用自然语言完成转码、分析、编辑、优化与交付,直击“视频处理流程复杂、工具割裂”的痛点,尤其适合非技术创作者和追求自动化的开发团队。
Streaming Services
Developer Tools
Artificial Intelligence
AI视频处理
MCP协议
自然语言交互
云转码
视频自动化
智能剪辑
开发者工具
AI代理集成
视频工作流
无代码视频
用户评论摘要:用户普遍认可其“提示词直出视频”的便捷性,并询问是否能支持多步骤迭代而非单次转换。有建议指向“自动检测静音片段并剪切压缩”的复合工作流,认为这能大幅节省时间。回帖中确认了链式处理能力,官方强调可随流程演进组合操作,但对处理速度与成本未作说明。
AI 锐评
Qencode MCP 踩中了当下两个最热的技术叙事:AI Agent 和视频生产自动化。它聪明地规避了“让 AI 直接生成视频”的伪需求,转而切入“AI 调度已有高性能视频管线”的务实路径——这本质上是用自然语言包装了一堆工程化 API。
从评论看,早期用户并非泛娱乐创作者,而是已经了解 MCP 生态的开发者或技术型运营,他们关心的是“能否链式操作”“是否能处理静音检测”这类工程细节,说明产品当前卖点是“可编程性”而非“开箱即用”。这既是优势也是风险:若处理长视频的速度、成本、并发能力没有硬优势,Claude 等前端工具完全可以被更垂直的 Workflow 引擎替代,MCP 只是薄薄一层协议外衣。
真正的价值试探点在于:它是否能把“视频处理”从“写代码调用 FFmpeg”提升到“描述意图即交付”的体验层级。目前评论中没有出现关于失败案例、转码质量对比或延迟数据的反馈,沉默或许意味着体验中规中矩,也或许意味着用户还停留在玩票阶段。
一句话刺痛:如果只是给 AI 加了个转码开关,那它就是个玩具;如果能成为视频 Agent 工作流的基础设施,才有资格谈颠覆。目前,它是前者,但方向正确。值得关注的是它能否后续开放评论中热议的“智能切片+压缩”这类复合能力,并降低使用门槛到非技术用户也能驾驭,否则天花板清晰可见。
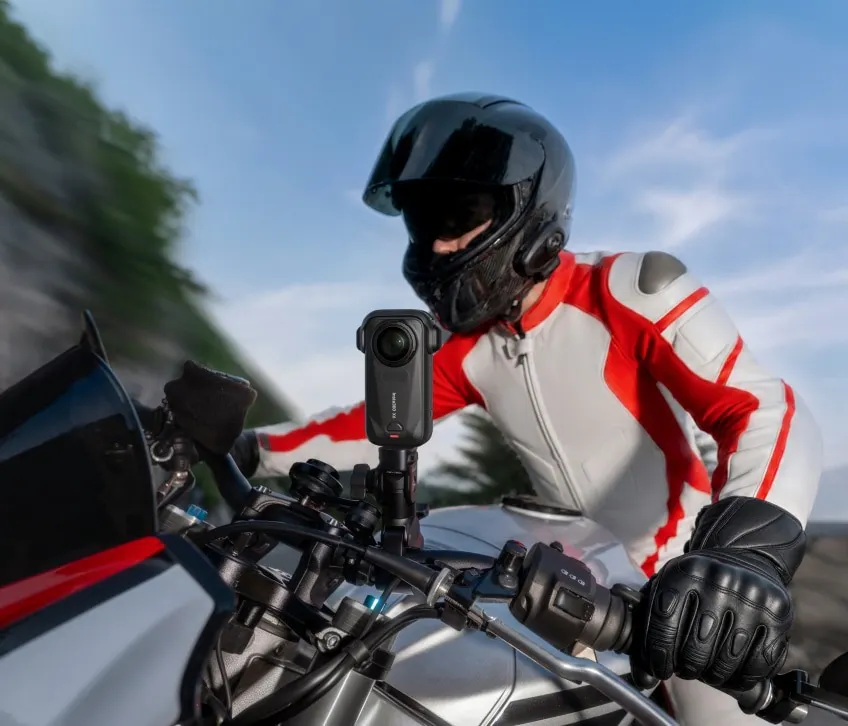
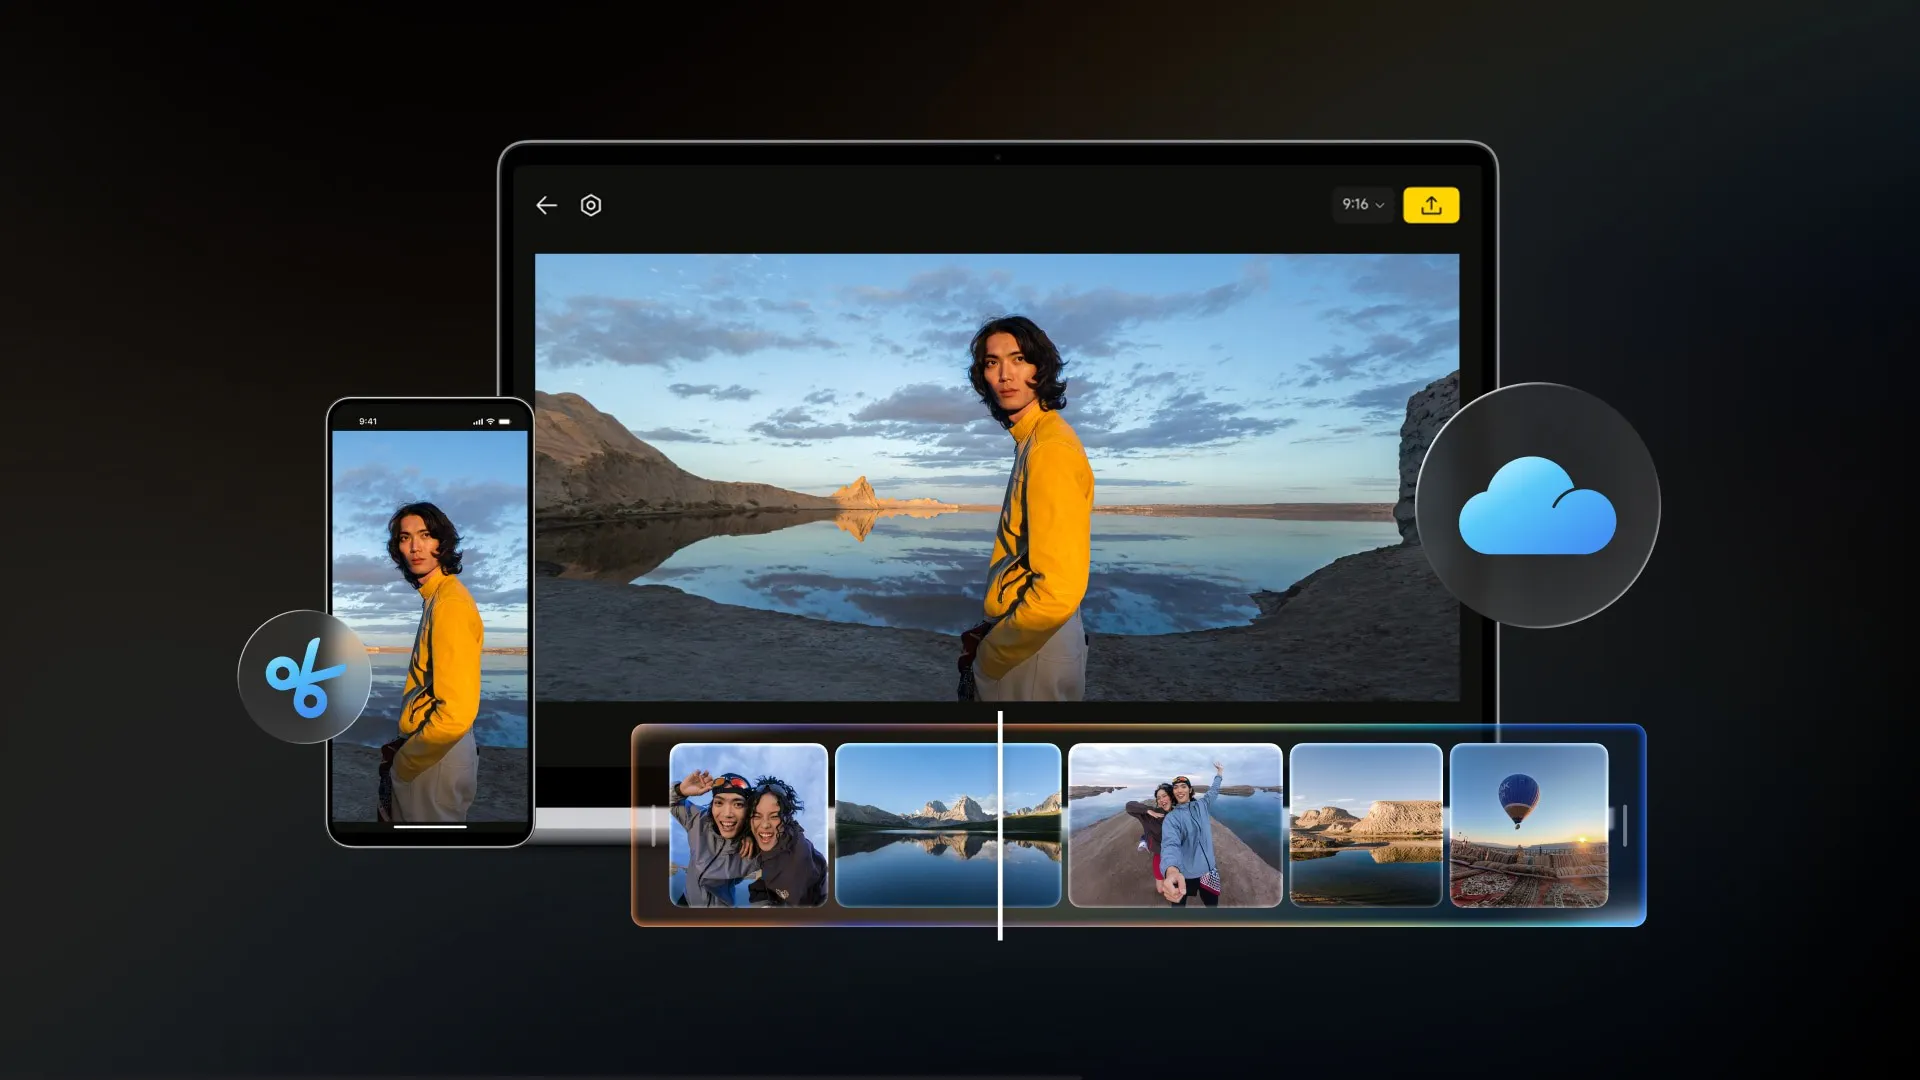
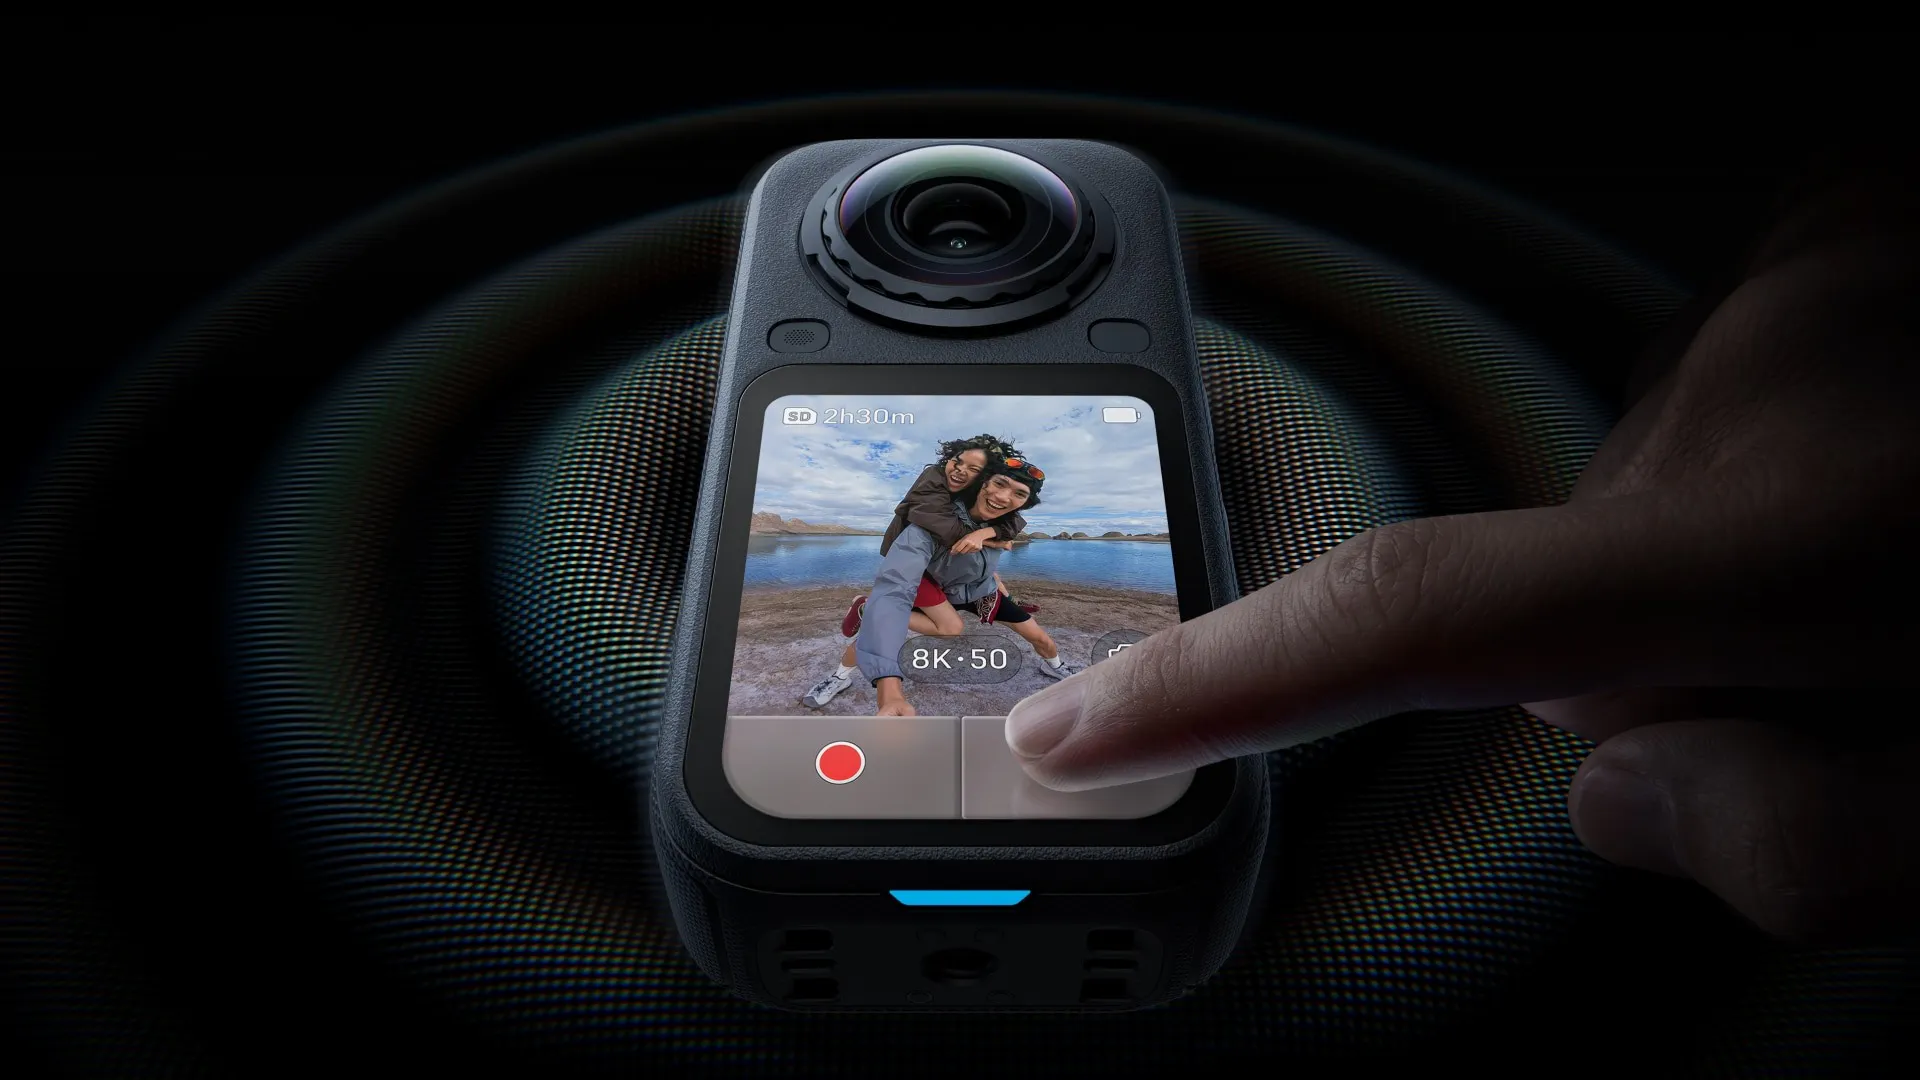
一句话介绍:Insta360 X6 将8K全景相机、AI稳定云台与3D空间扫描仪合为一体,解决创作者在运动拍摄中“既要广视角、又要稳定构图、还要快速出片”的多设备切换痛点,让单人即可完成电影级全景内容的拍摄与智能剪辑。
Hardware
Photography
Video cameras
8K全景相机
AI智能剪辑
三合一设备
运动拍摄
3D扫描
索尼传感器
杜比视界
稳定云台
全景创作工具
户外Vlog
用户评论摘要:用户反馈积极,核心认可其“三合一”形态对创作流程的简化,特别是InstaFrame 2.0免后期构图和AI自动剪辑亮点。有效建议集中于:期待实际长时间录制散热表现、3D扫描精度细节,以及AI导演在复杂光线下的识别准确性,希望后续固件能持续优化。
AI 锐评
Insta360 X6的野心不在堆料,而在重新定义运动相机的“交互边界”。双1/1.1英寸传感器和8K50是基础战力,真正的杀招是InstaFrame 2.0——它把传统全景相机“先拍后剪”的沉重后期负担,转变为“机内实时输出稳定4K”的轻量化工作流,这直击了短视频时代用户“懒得剪辑”的致命痛点。而AI Director与PanoMind模型的加入,本质上是用算力替代人工时间,将素材筛选和叙事剪辑前置到充电场景,这是对创意生产力的显著解放。不过,需要泼冷水的是:3D Time Capsule目前更像炫技的“技术演示”,高斯泼溅的实际建模精度和文件体积能否支撑严肃的3D资产生产,尚未可知;同时,AI自动剪辑的叙事逻辑是否能真正理解“用户想要的瞬间”,而非仅识别“技术意义上的高光”,依然存疑。对于专业创作者,X6是一个强大的“快枪手”;但在光线复杂或运动极端的场景下,其AI判断的可靠性还有待实战检验。这款产品最大的价值,是让全景拍摄从“专业小众的后期流程”走向“大众即拍即得的创作工具”,但前提是,它必须能持续证明自己的智能推荐比用户自己的审美更懂内容。否则,这依然只是一个昂贵的“自动化滤镜”。
一句话介绍:Kin Health 是一款面向患者的“AI就医录音笔”,在就诊时记录医患对话,并自动生成结构化摘要,解决患者“记不住、听不懂、无法与家人共享医嘱”的核心痛点。
Health & Fitness
Notes
Artificial Intelligence
AI医疗
就医记录
语音转写
医患沟通
健康管理
就诊摘要
数字医疗
患者工具
Ambient Scribe
家庭护理
用户评论摘要:评论来自创始人的产品叙事,提及家庭因癌症诊疗信息不对称而受阻的痛点,肯定“对话是未被利用的医疗数据”这一洞察,并强调Kin是首个“医生构建、临床严谨”的患者端环境抄录工具。无其他用户反馈或改进建议。
AI 锐评
Kin Health 的定位非常聪明,它避开了与Nuance、Abridge等巨头在“医生端”的拥挤赛道,直接切入“患者端”的空白地带。产品价值并非简单的录音转文字,而是将诊室中不可逆的、高流失率的语音信息,转化为患者可反复查阅、可跨空间分发的“结构化资产”。这精准击中了老龄化社会下“家庭协同护理”的隐性刚需——评论中创始人以母亲癌症经历为例,恰好暴露了该产品最深的护城河:情感驱动下的高粘性使用场景。
但锐评必须指出两点隐患:其一,“临床严谨”是双刃剑。患者端摘要若过于简化,可能遗漏关键医学细节,变成“安慰剂”;若过于详细,则可能误导患者自我诊断,增加医疗纠纷风险。AI摘要的“度”如何与医生原始记录校准,是未解难题。其二,隐私与合规是悬顶之剑。处理健康信息(PHI)的传输与存储,在美国需严格符合HIPAA,跨州共享更涉及复杂法律边界。创始人的医生背景是品牌信任的起点,但无法替代真正合规的技术架构。
长远看,Kin真正的价值不在于“摘要工具”,而在于成为患者医疗数据的“个人时间轴”。若它能打通后续的用药提醒、复诊预约、家庭共享权限管理,甚至反向喂给医生做决策支持,则有望从“辅助工具”升级为“患者数据入口”。但目前它仍是一个精致的垂直工具,短期难以摆脱对单一就诊场景的依赖。资本市场会买账,但临床落地需要更谨慎的验证。
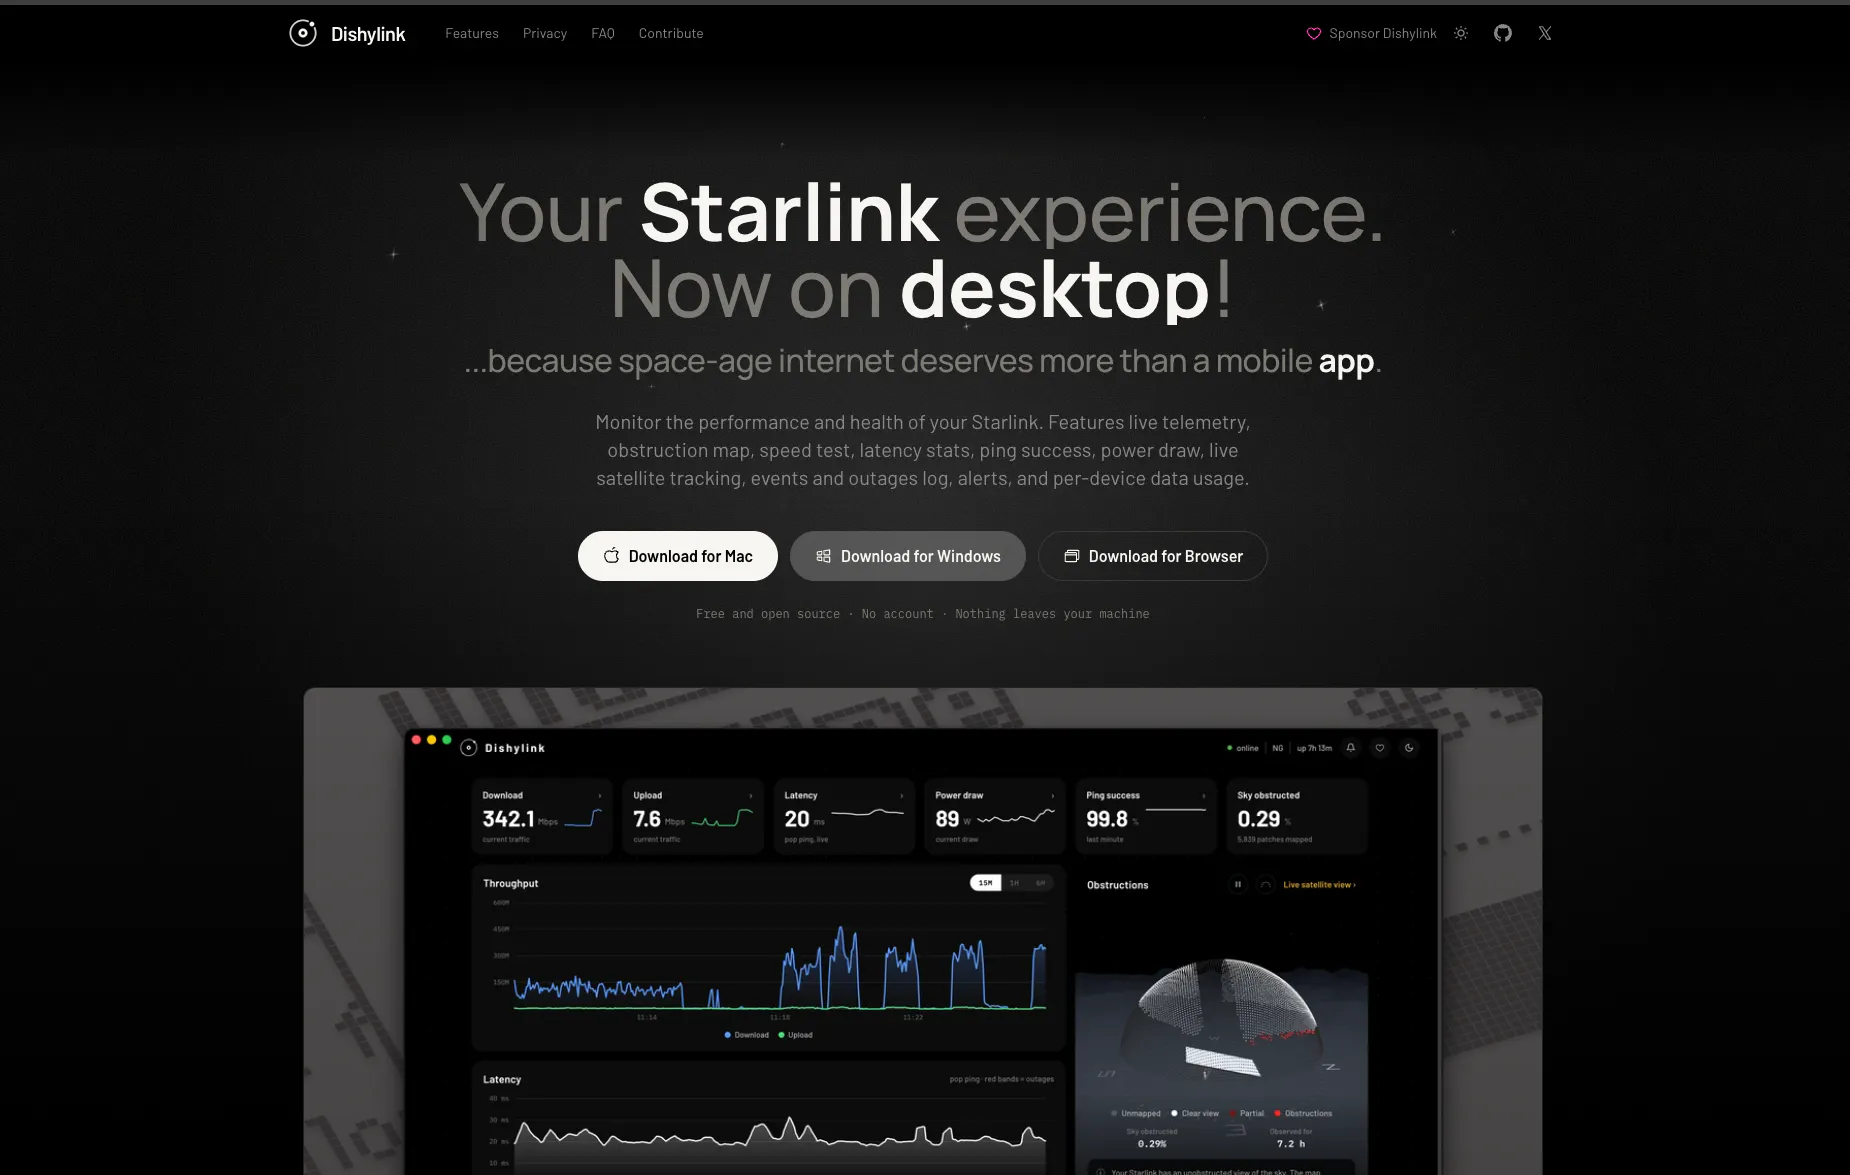
一句话介绍:Dishylink 是一款开源免费的 Starlink 桌面监控应用,直连用户自家网络中的星链设备,在浏览器和桌面端恢复并超越星链官方已关闭的网页管理功能,解决 Mac/Windows 用户“看个状态还得起身找手机”的长期痛点。
Chrome Extensions
Productivity
User Experience
GitHub
Tech
卫星互联网
Starlink监控
开源工具
桌面应用
网络诊断
天线对准
数据用量监测
功耗统计
隐私友好
Chrome插件
用户评论摘要:用户普遍认可其解决真实痛点,称赞开源和界面。有用户反馈该应用成功检测到其星链接收器未对准并给出调整方向(偏转角),说明诊断功能有效。开发者在帖内承诺无付费计划、无云端、无账户,获得“买咖啡”打赏和“惊喜”好评,整体未见负面问题或功能建议反馈。
AI 锐评
Dishylink 精准踩中了星链用户生态里一个隐蔽但持续恶化的裂缝:官方放弃网页端后,桌面用户被强制绑定手机App,而硬件明明就在自家局域网里。这不是一个“更好的App”,而是对用户既有权利——直接管理自己购买的硬件——的一次技术性归还。
价值上分两层看。第一层是即时实用性:实时仰角/方位校正、功耗历史、设备级流量统计、延迟归属判定(是卫星链路还是路由器),每一项都卡在官方App“能看但不够用”的痛点上,尤其“误偏角数字提示”这种精准纠偏,比厂商自家App的操作路径更短、反馈更明确。第二层是生态账:开源MIT、无后端、无遥测,意味着该工具不受厂商API变动和商业条款绑架,且能在社区监督下长期补缺——官方关闭网页端后,这类逆向工程产物实际上成为了社区对官方产品“生命周期末尾功能”的自我维持机制。
但冷静看,项目天花板也很明显:第一,它完全依附于Starlink固件和局域网协议的未公开接口,官方一次固件更新就可能致其失效,目前所谓“兼容Gen 5”的抗风险能力仅在当前版本成立;第二,作为一个纯监控工具,它没有解决“网络坏了该怎么修”的告警到处置的闭环,只能报病,不能治病;第三,评论区的溢美之词大多来自早期核心用户和Reddit热度外溢,3天3000下载量在星链全球600万用户基数里几乎为噪音,尚未经过大规模不同固件/地区/Gen的兼容性压力测试。
真正的价值在于验证了一个商业逻辑:当智能硬件厂商收窄原生控制面时,开源的本地控制工具不仅是替代品,更是对抗“服务墙”的一种姿态。Dishylink未必成为爆款,但它提醒所有硬件厂商——用户对自家硬件的控制权被阉割时,开源社区永远会递来一把刀。也正因如此,它最好永远保持“小而美”,一旦商业化或转向云服务,其信任根基将瞬间崩塌。
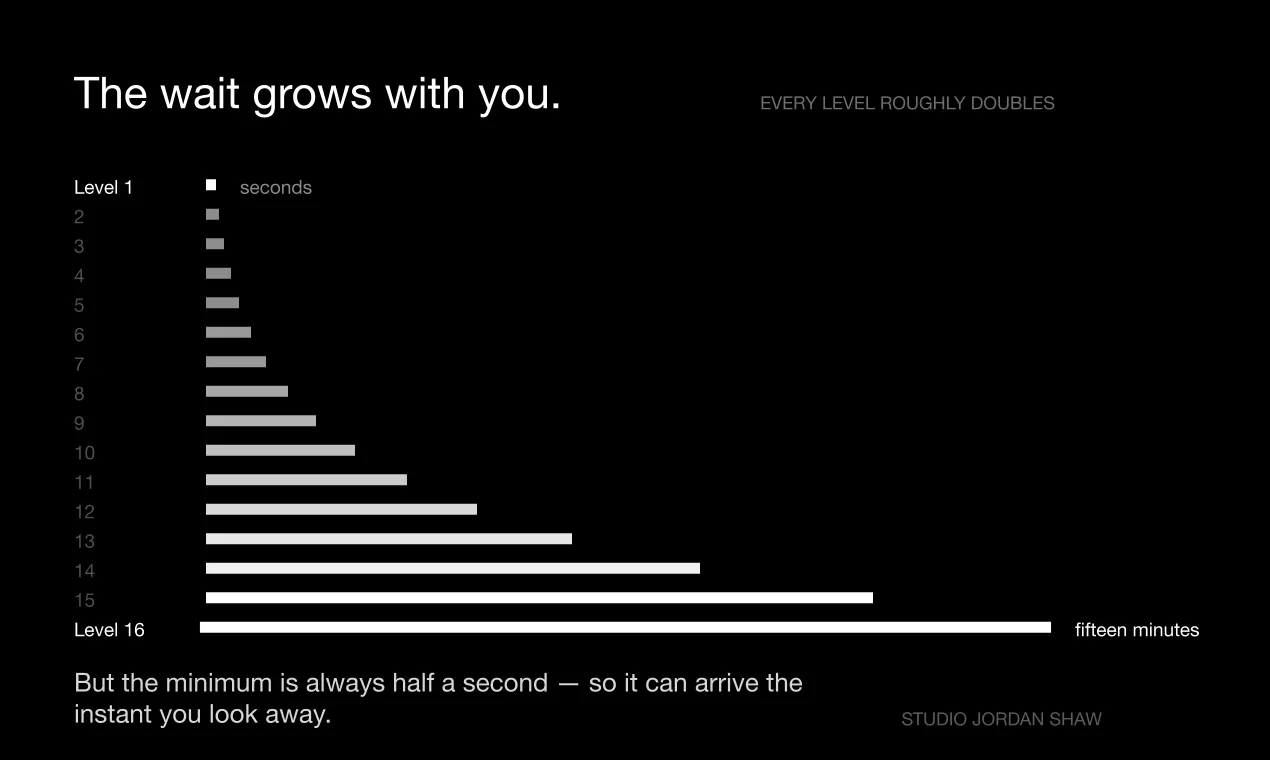
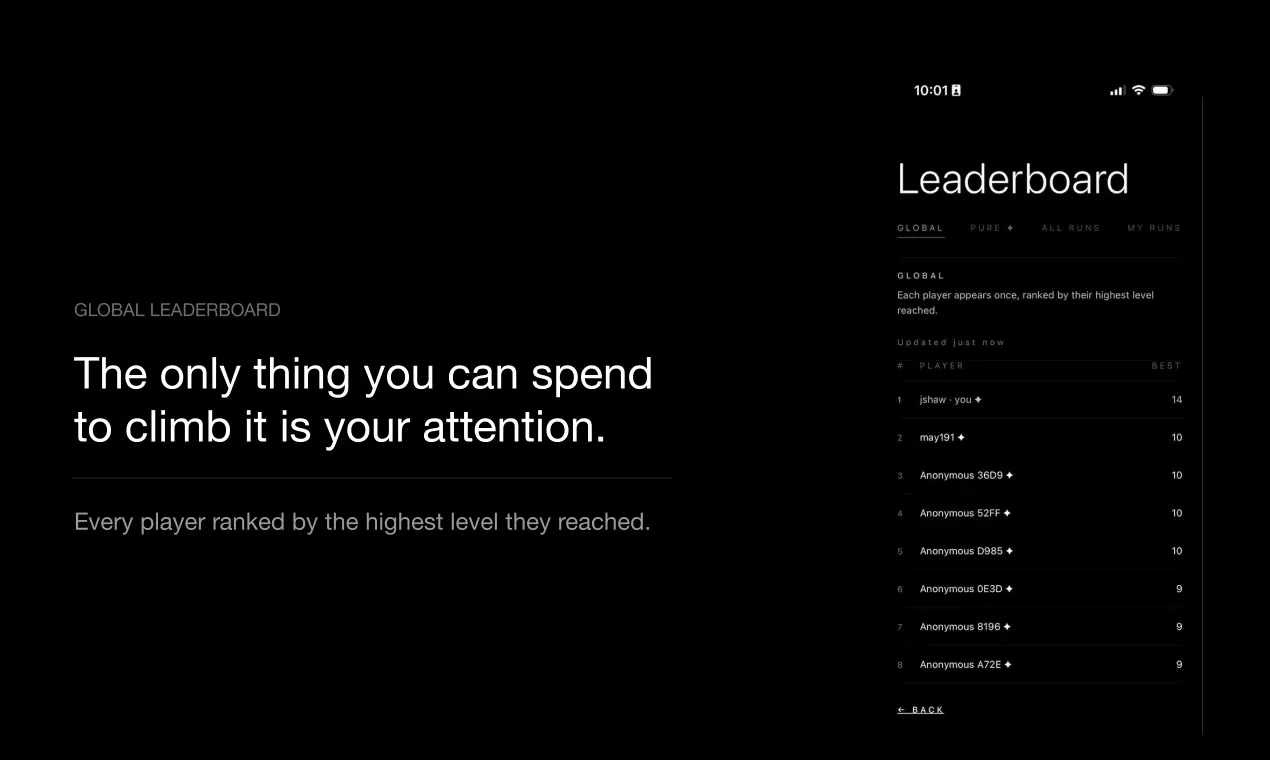
一句话介绍:Patience是一款以“等待”为唯一玩法的极简iOS游戏,通过不可预测的点击时机挑战,将用户的碎片化时间转化为竞技资本,满足现代人对抗浮躁、寻求专注与正念的需求。
Productivity
Tech
Games
极简游戏
时间竞技
专注力训练
冥想替代
等待机制
反应力测试
全球排行榜
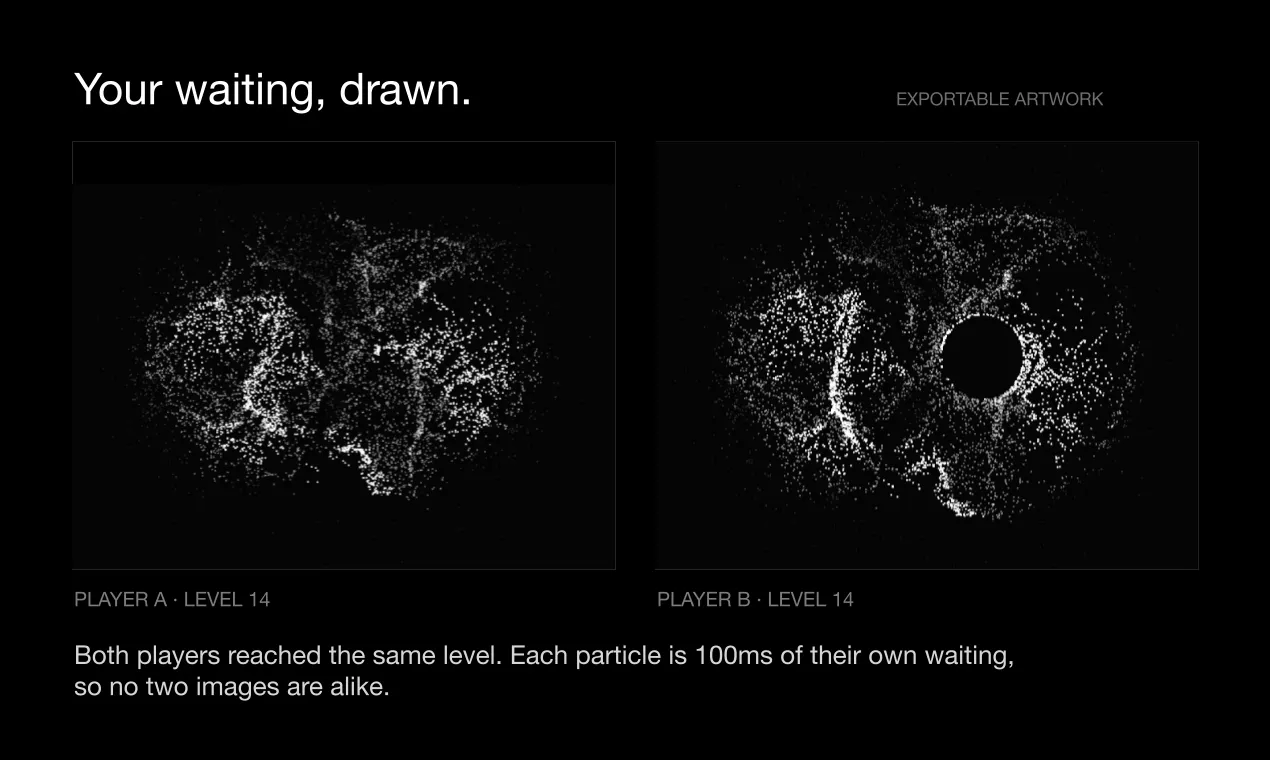
数据可视化
独立游戏
iOS
用户评论摘要:用户普遍认可其“骗你冥想”的巧思,认为等待机制有助镇静与临在感。开发者回应仅以“游戏”上架,避免触碰健康类审核。有用户提议直播或社群(Discord)传播潜力,另关注付费复活价格合理性,部分玩家期待与“正念”更深结合。
AI 锐评
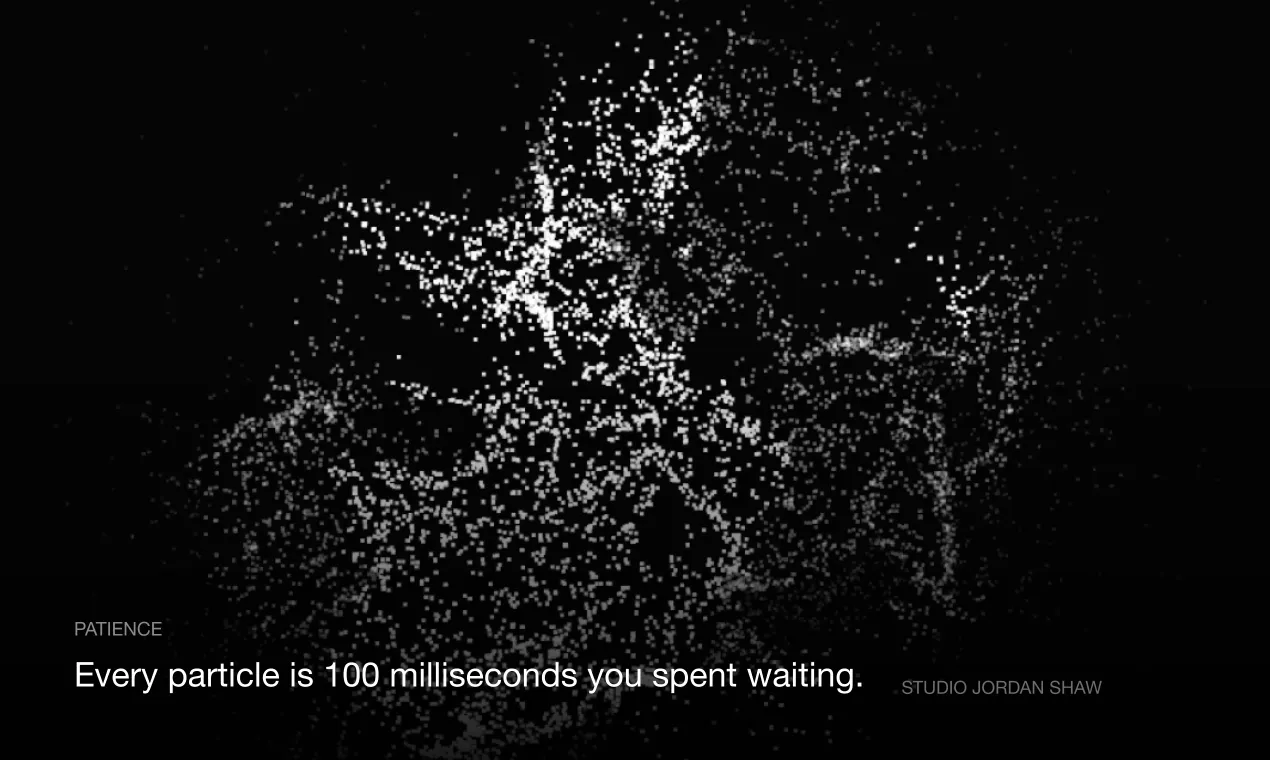
Patience的聪明之处在于将“无聊”本身商品化,并巧妙嫁接了排行榜这一社交货币。它本质上是把传统游戏的“操作成本”替换为“时间成本”,让等待行为获得了可量化的竞技意义。这在注意力经济泛滥的当下,构成了一种反讽式的突围——通过“剥夺”来制造稀缺感,进而激发用户的受虐式沉迷。其粒子可视化系统是点睛之笔,将无价值的等待沉淀为个人化的、可分享的数据艺术品,赋予了消耗时间以叙事感,极大提升了留存动机。
然而,这款产品的天花板同样明显。其核心机制极度依赖人类对不确定性的原始神经反应,新鲜感过后极易疲劳,缺乏实质性的长期成长反馈。所谓“冥想”效果仅是副产品而非设计目标,无法与专业正念应用抗衡。89票的冷启动热度也侧面印证了其受众的狭窄。付费解锁复活(7.99美元)的定价略显傲慢,对于一款以“免费等待”为核心卖点的游戏,高额赎买机制容易引发反感,反而可能玷污其“纯粹性”的品牌形象。它更像是一场精巧的行为艺术实验,而非一款具备长期运营潜力的商业产品。若无法拓展出更深层的“等待意义”或引入社交对抗的变体,其热度恐将如屏幕上的圆圈般,闪现后迅速湮灭于黑屏之中。
Hi, I'm Jay Singh, Co-Founder of TestMu AI.
Every technology wave has the same shape. Capability jumps first. Trust catches up later. We saw it with cloud, and we are watching it again with AI.
The gap we kept seeing
⚡ AI writes the code in minutes now
🖱️ But someone still has to open the app and confirm it actually works
⏳ The building got fast. The assurance never did
That gap is the defining problem of this era of software, and it is why we built Kane CLI.
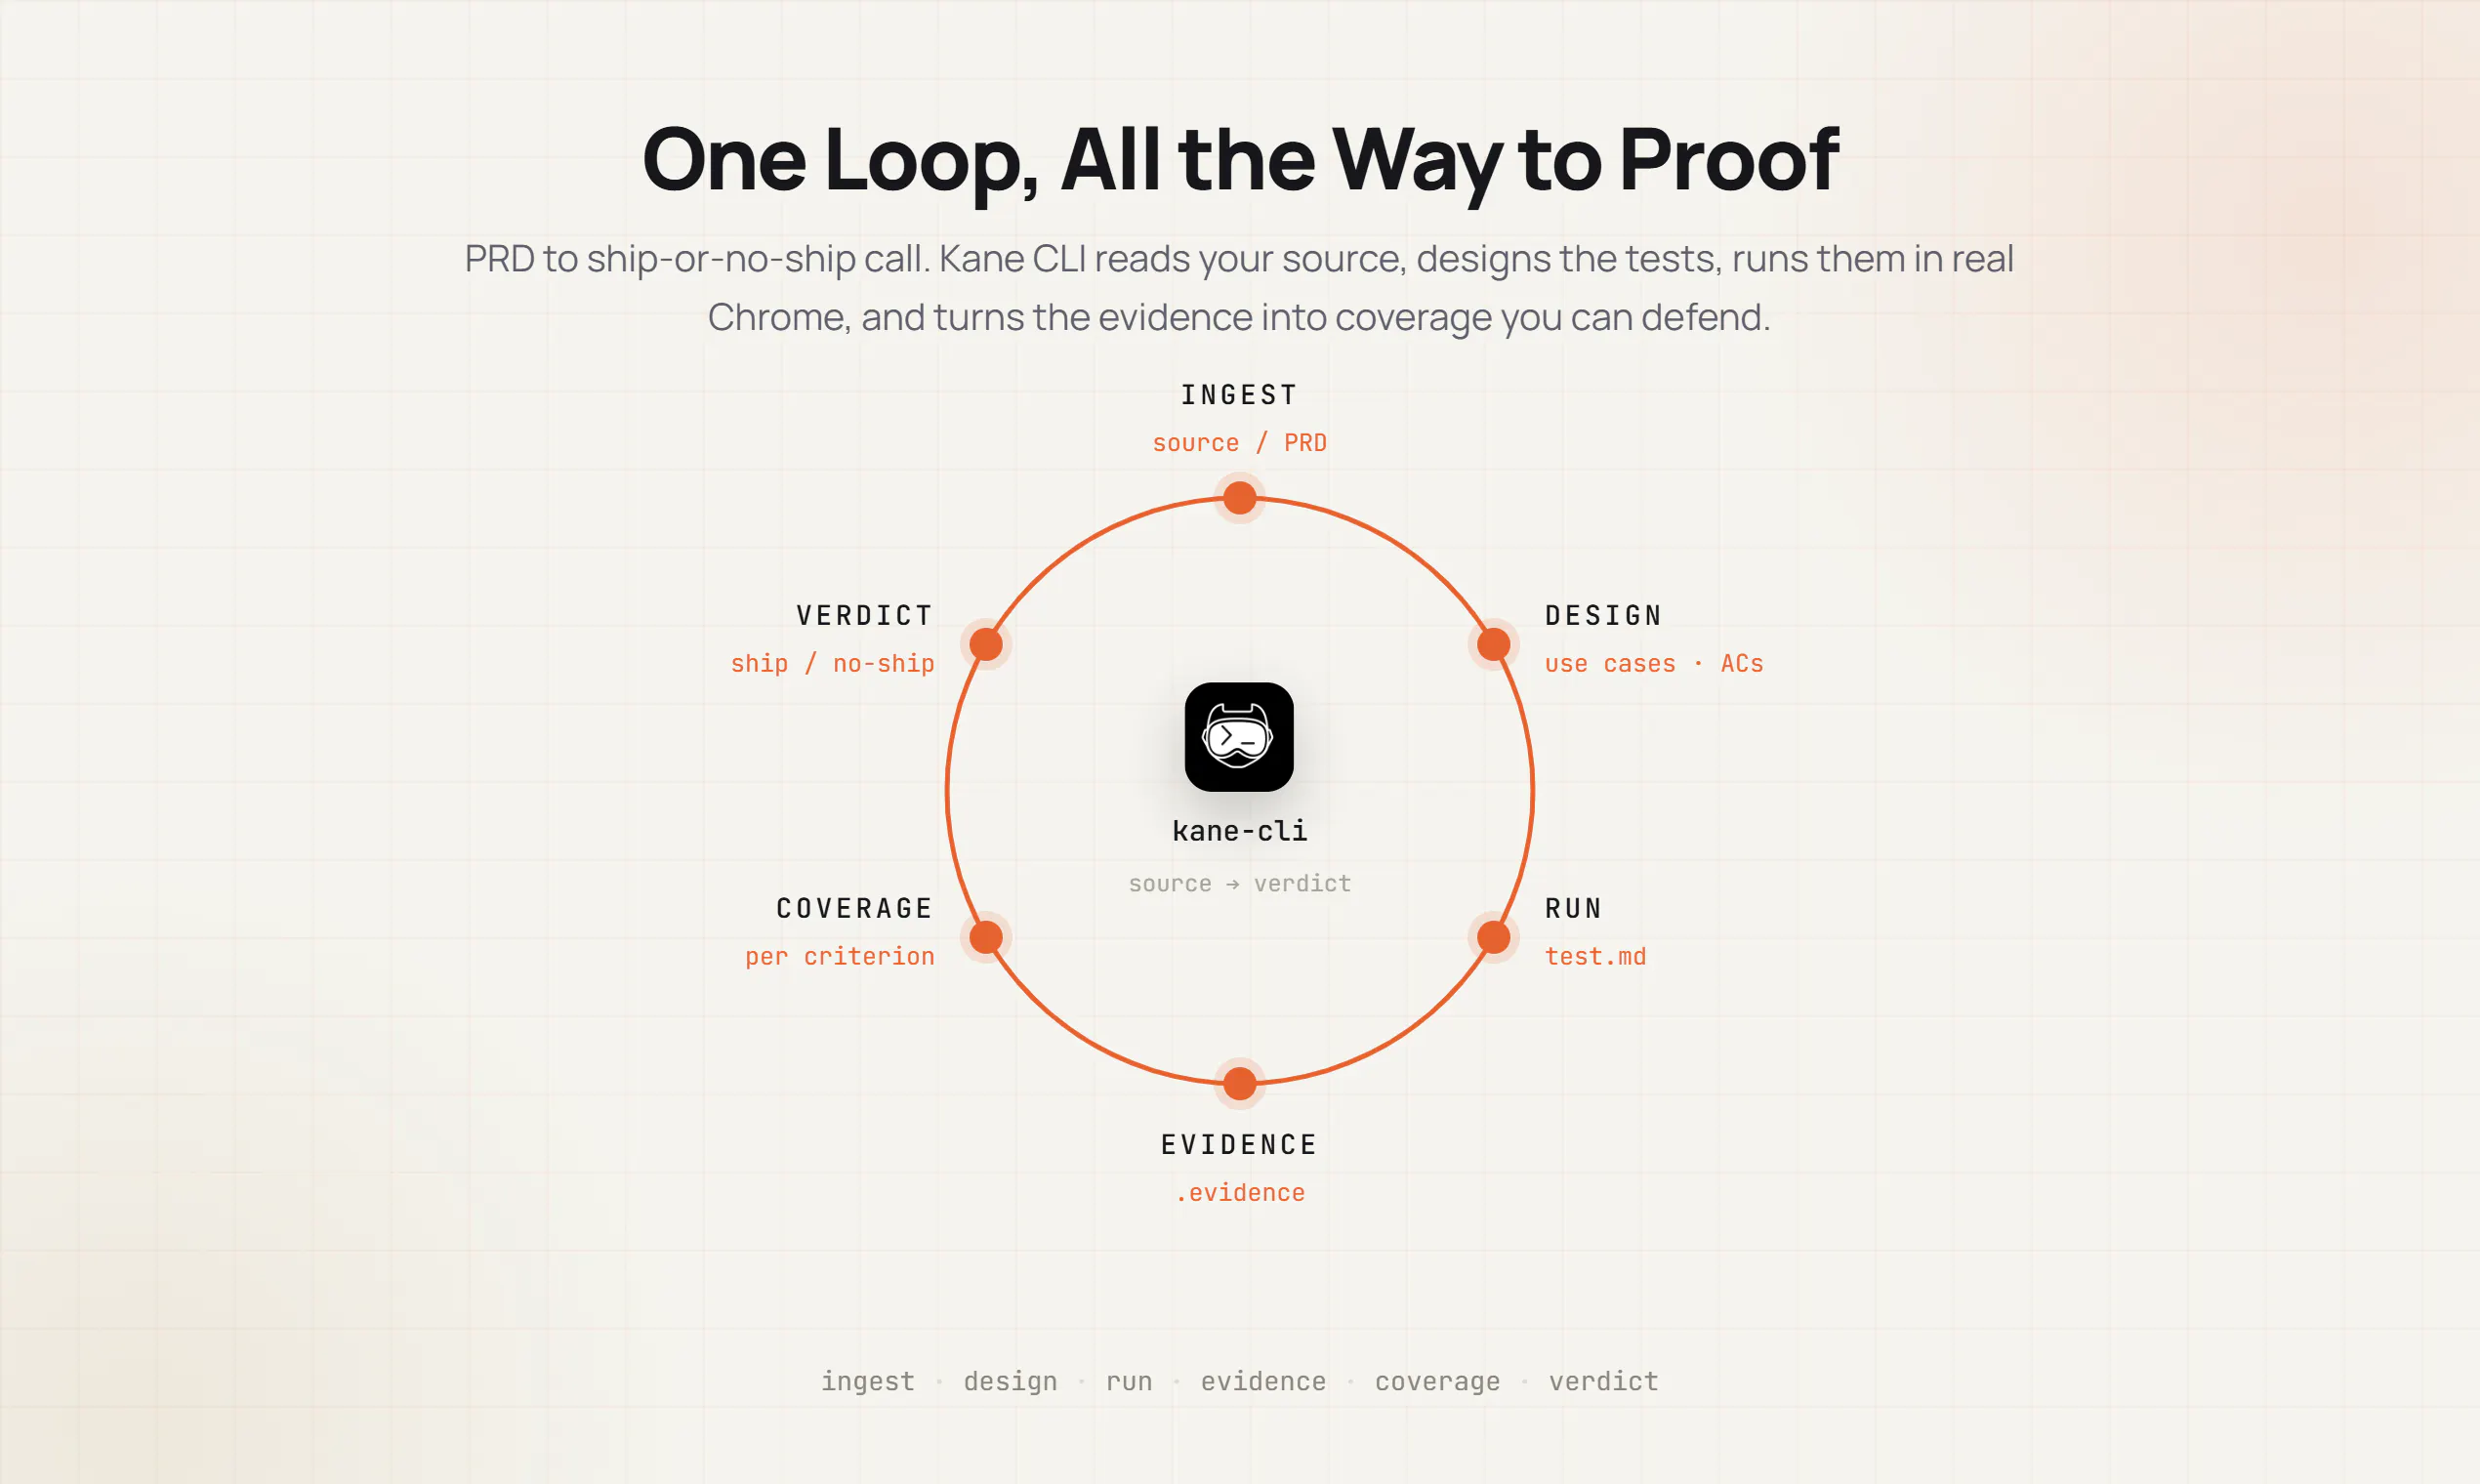
How it closes the loop
📥 Ingests your source or PRD
🧩 Designs the use cases and test scenarios
🌐 Runs them in a real Chrome browser, or on Android emulators and iOS simulators
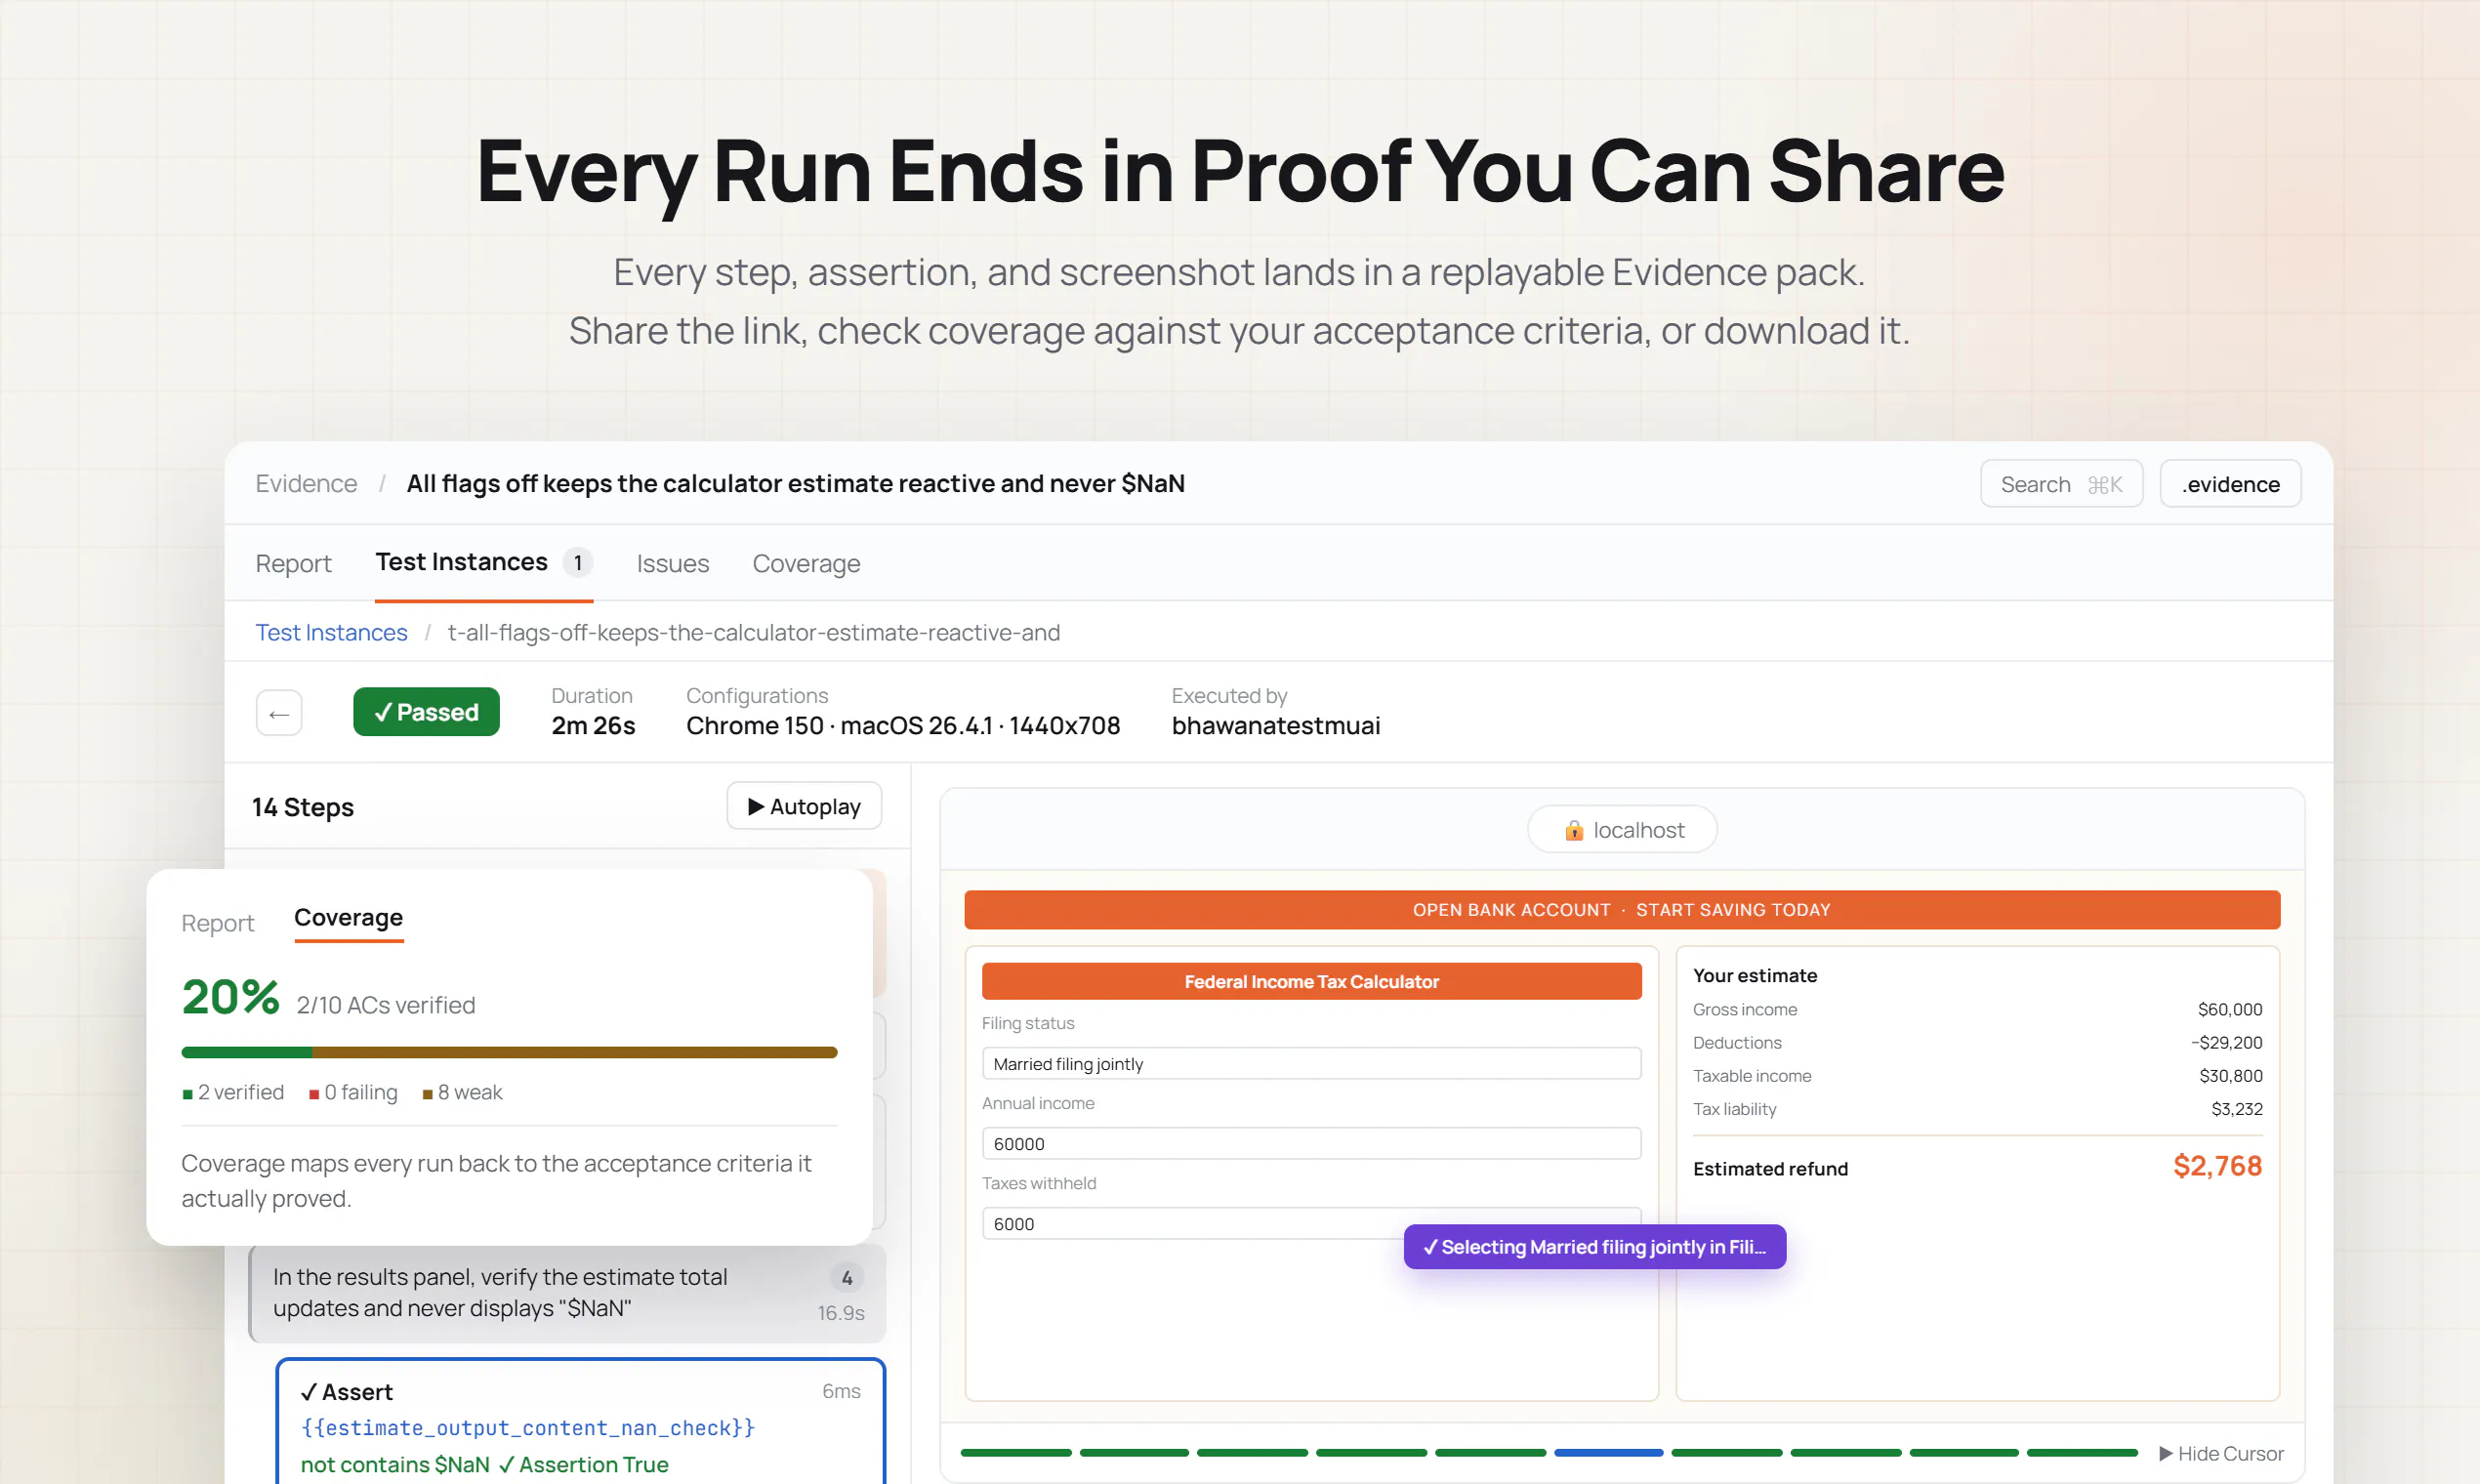
📸 Returns an evidence pack, AC coverage, and a verdict
Not just "did it run". Did it work, and can you prove it. ✅
We believe the next generation of software teams will not be measured by how fast they build. Everyone will build fast. They will be measured by how fast they can trust what they built. 🚀
Would love to hear how your team is dealing with this gap.
Learn more: https://www.testmuai.com/kane-cli-ph/
Hi, I'm Shantanu Wali, Head of AI Products at TestMu AI.
Most tools give you a test runner. We built an assurance loop:
📥 Ingest → your source, your PRD
🧩 Design → use cases, acceptance criteria, test scenarios
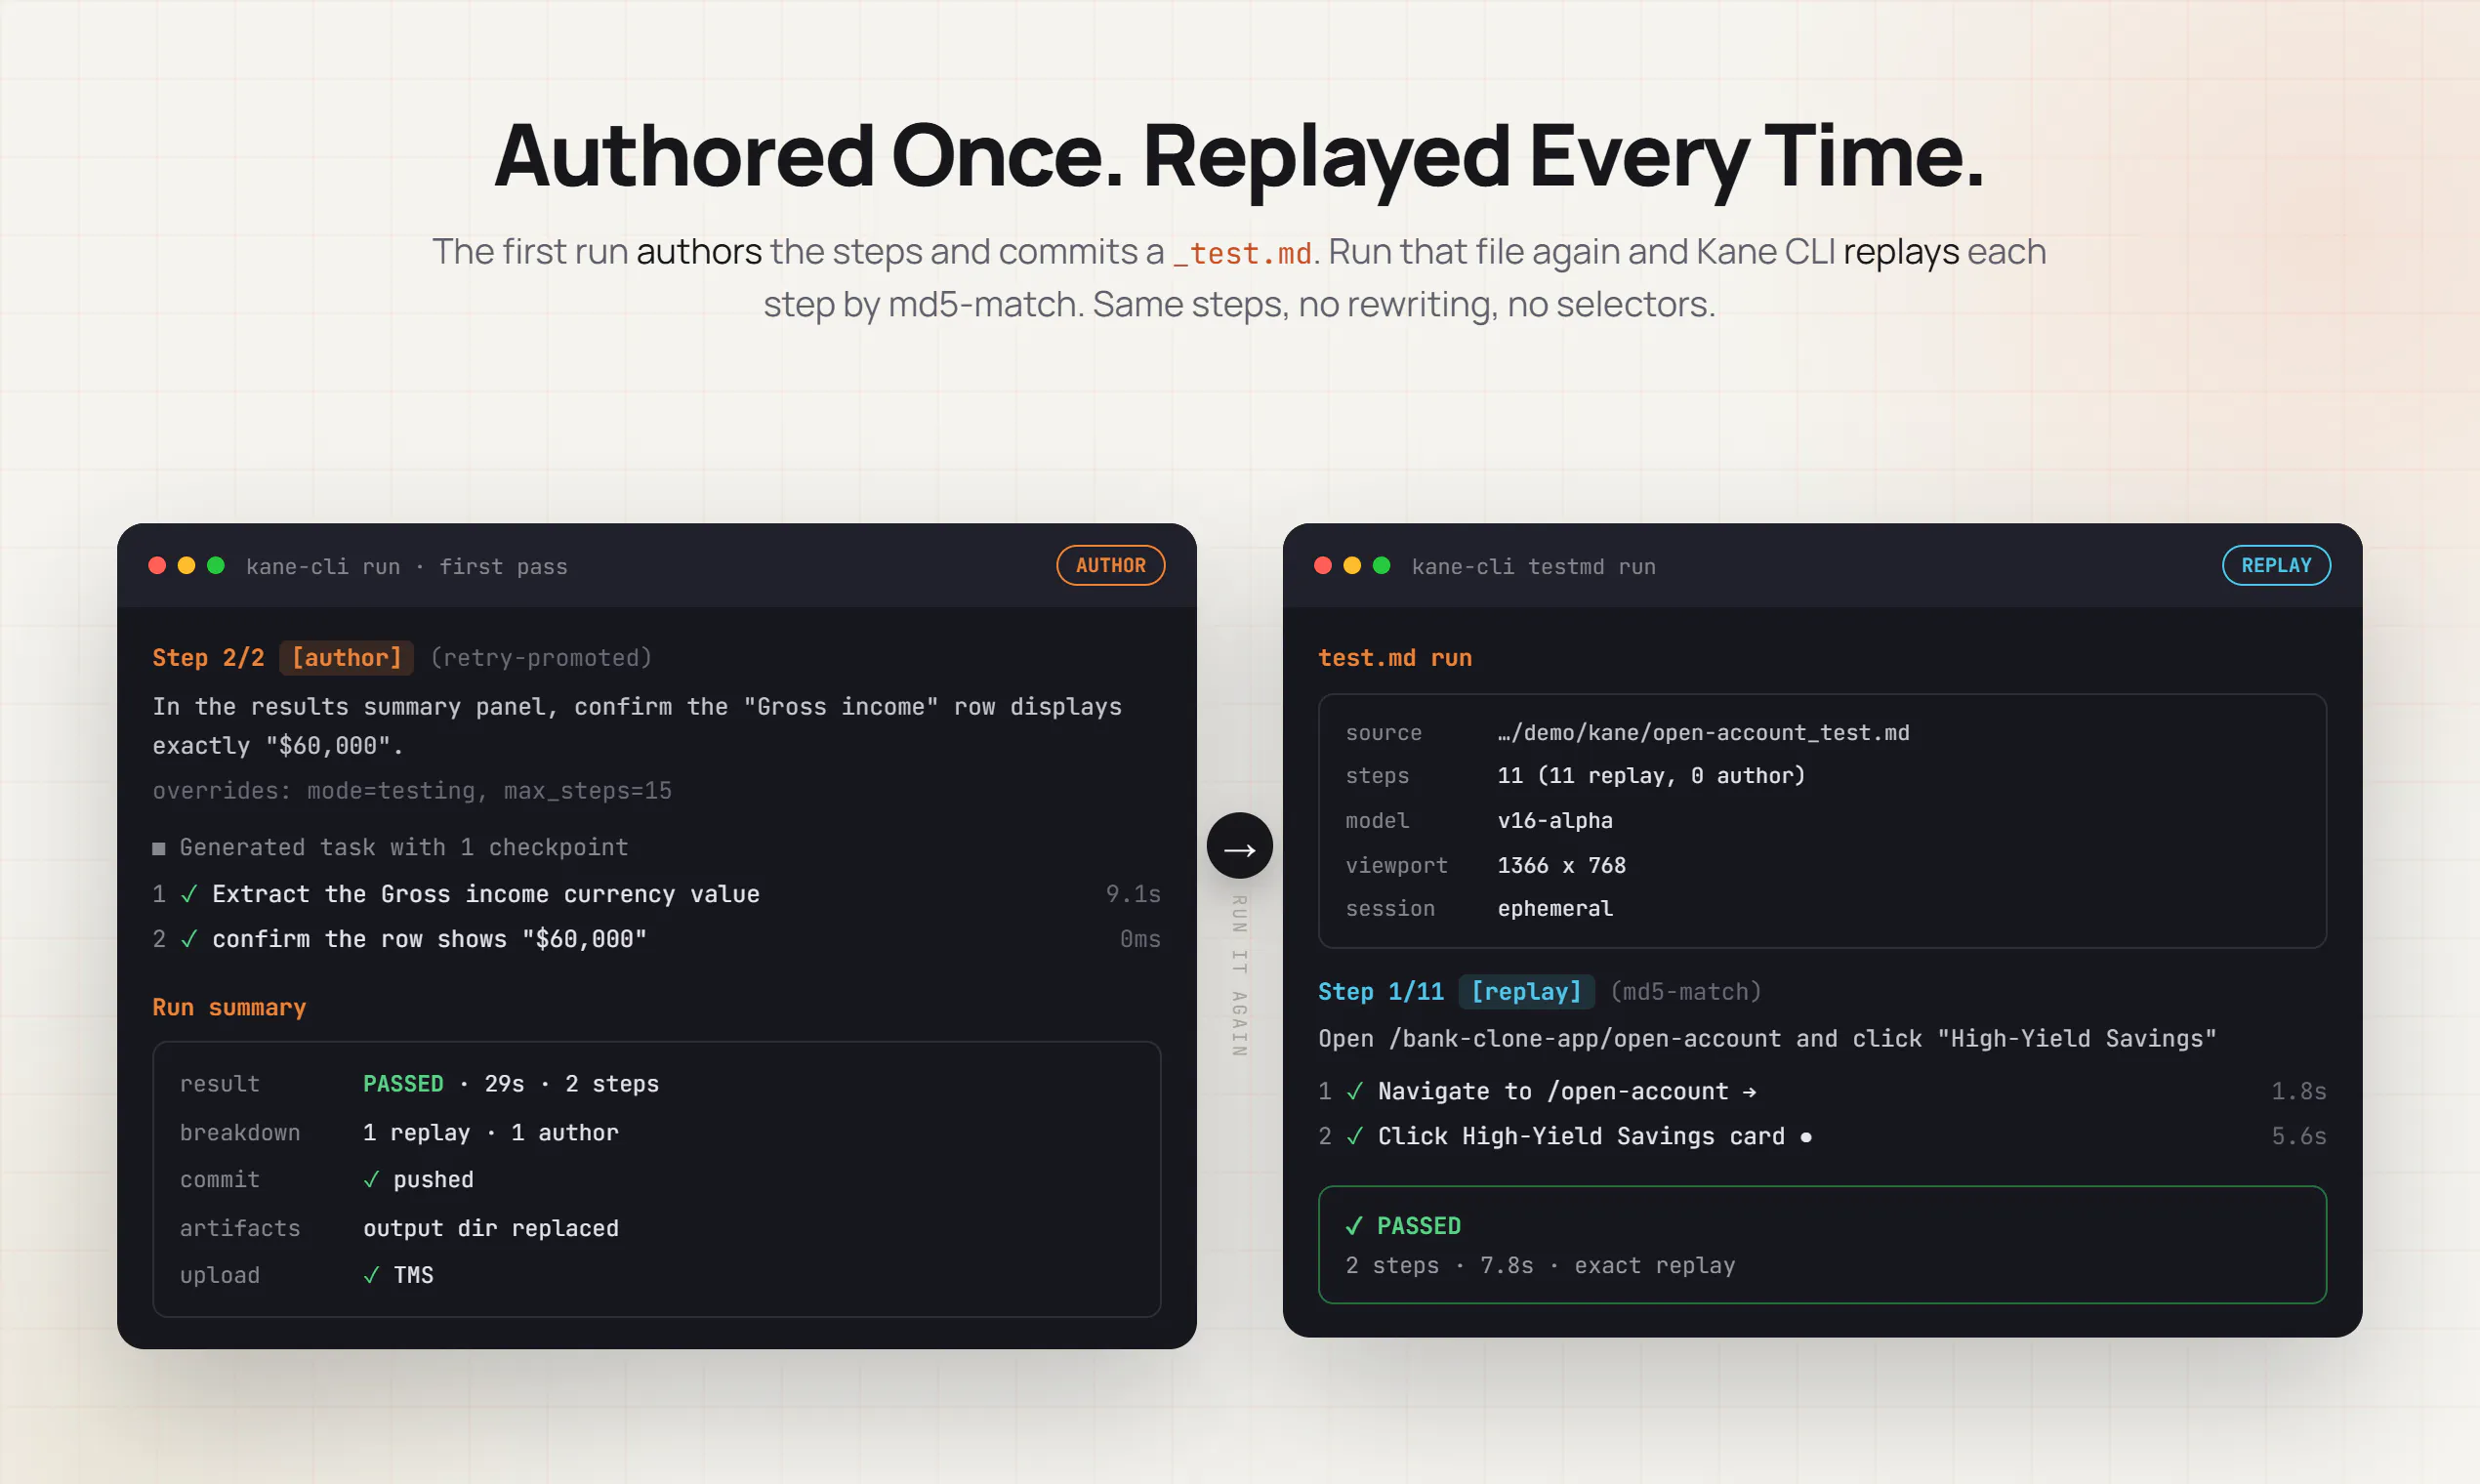
▶️ Run → test.md, executed in a real browser or on a mobile device
📸 Evidence → evidence pack for every run
📊 Coverage → how many ACs are covered
✅ Verdict → shipping confidence, backed by proof
Decisions we fought hard for
💻 Local first, running on your own Chrome
💬 Natural language objectives instead of selectors
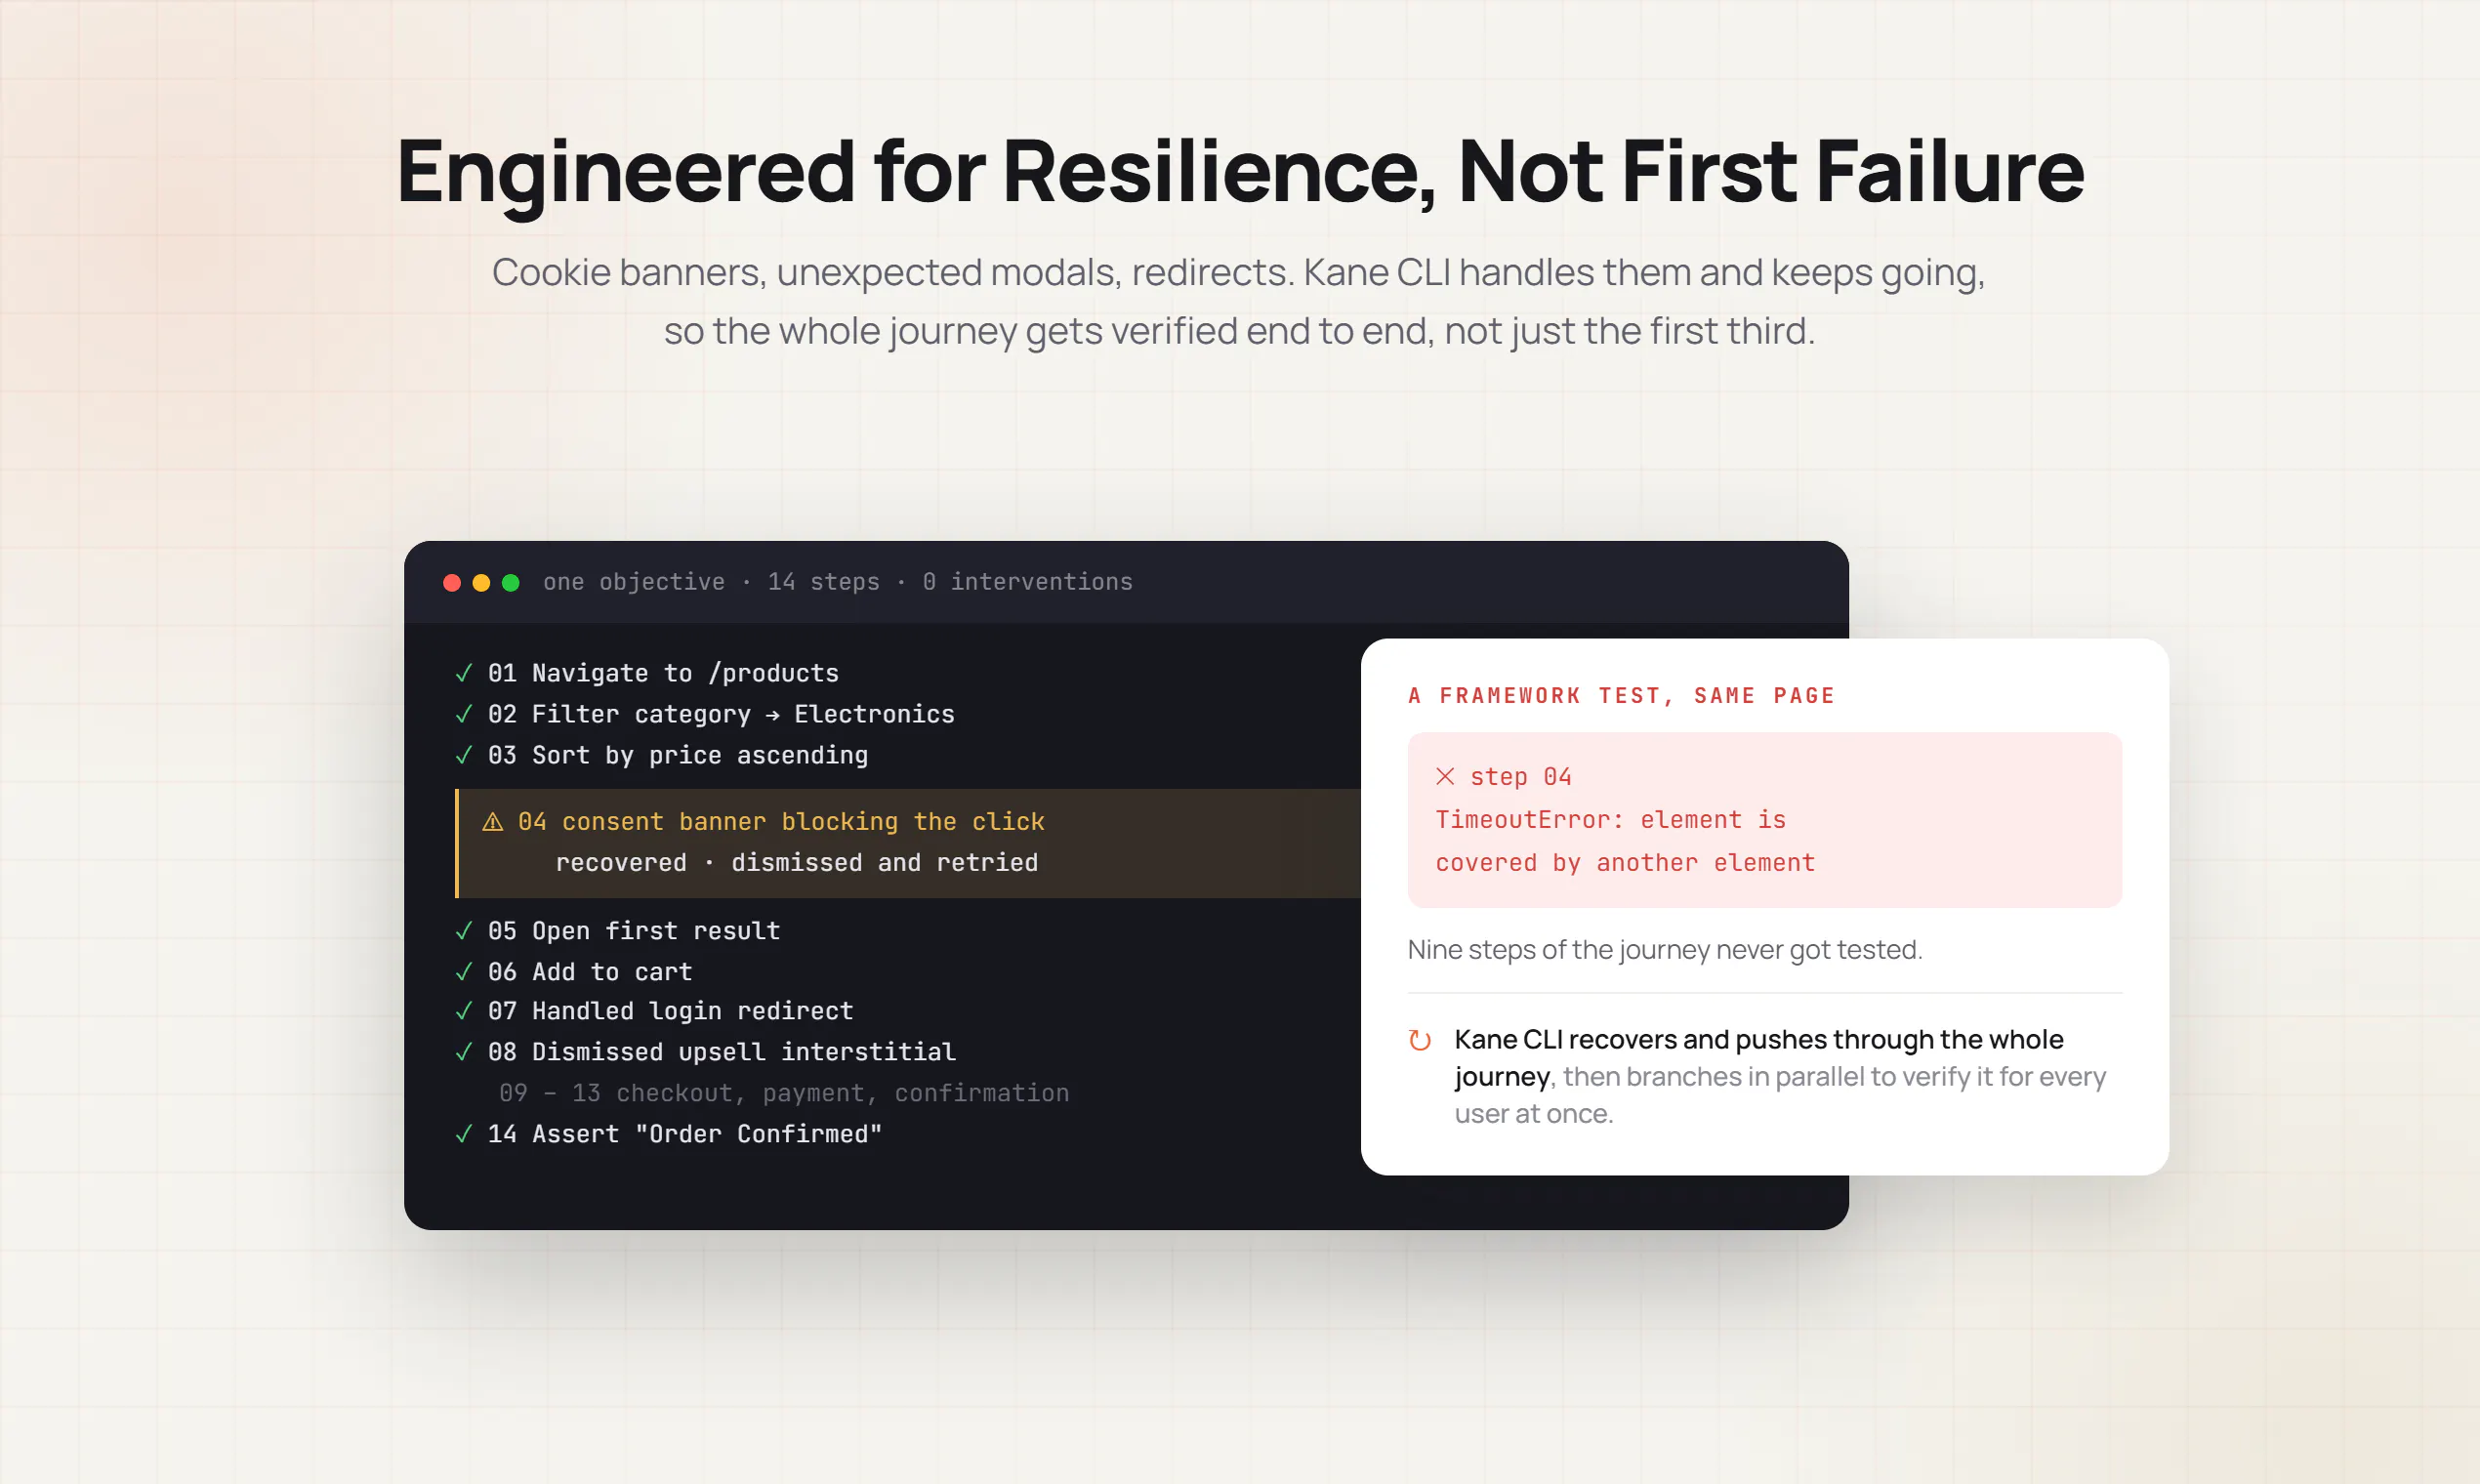
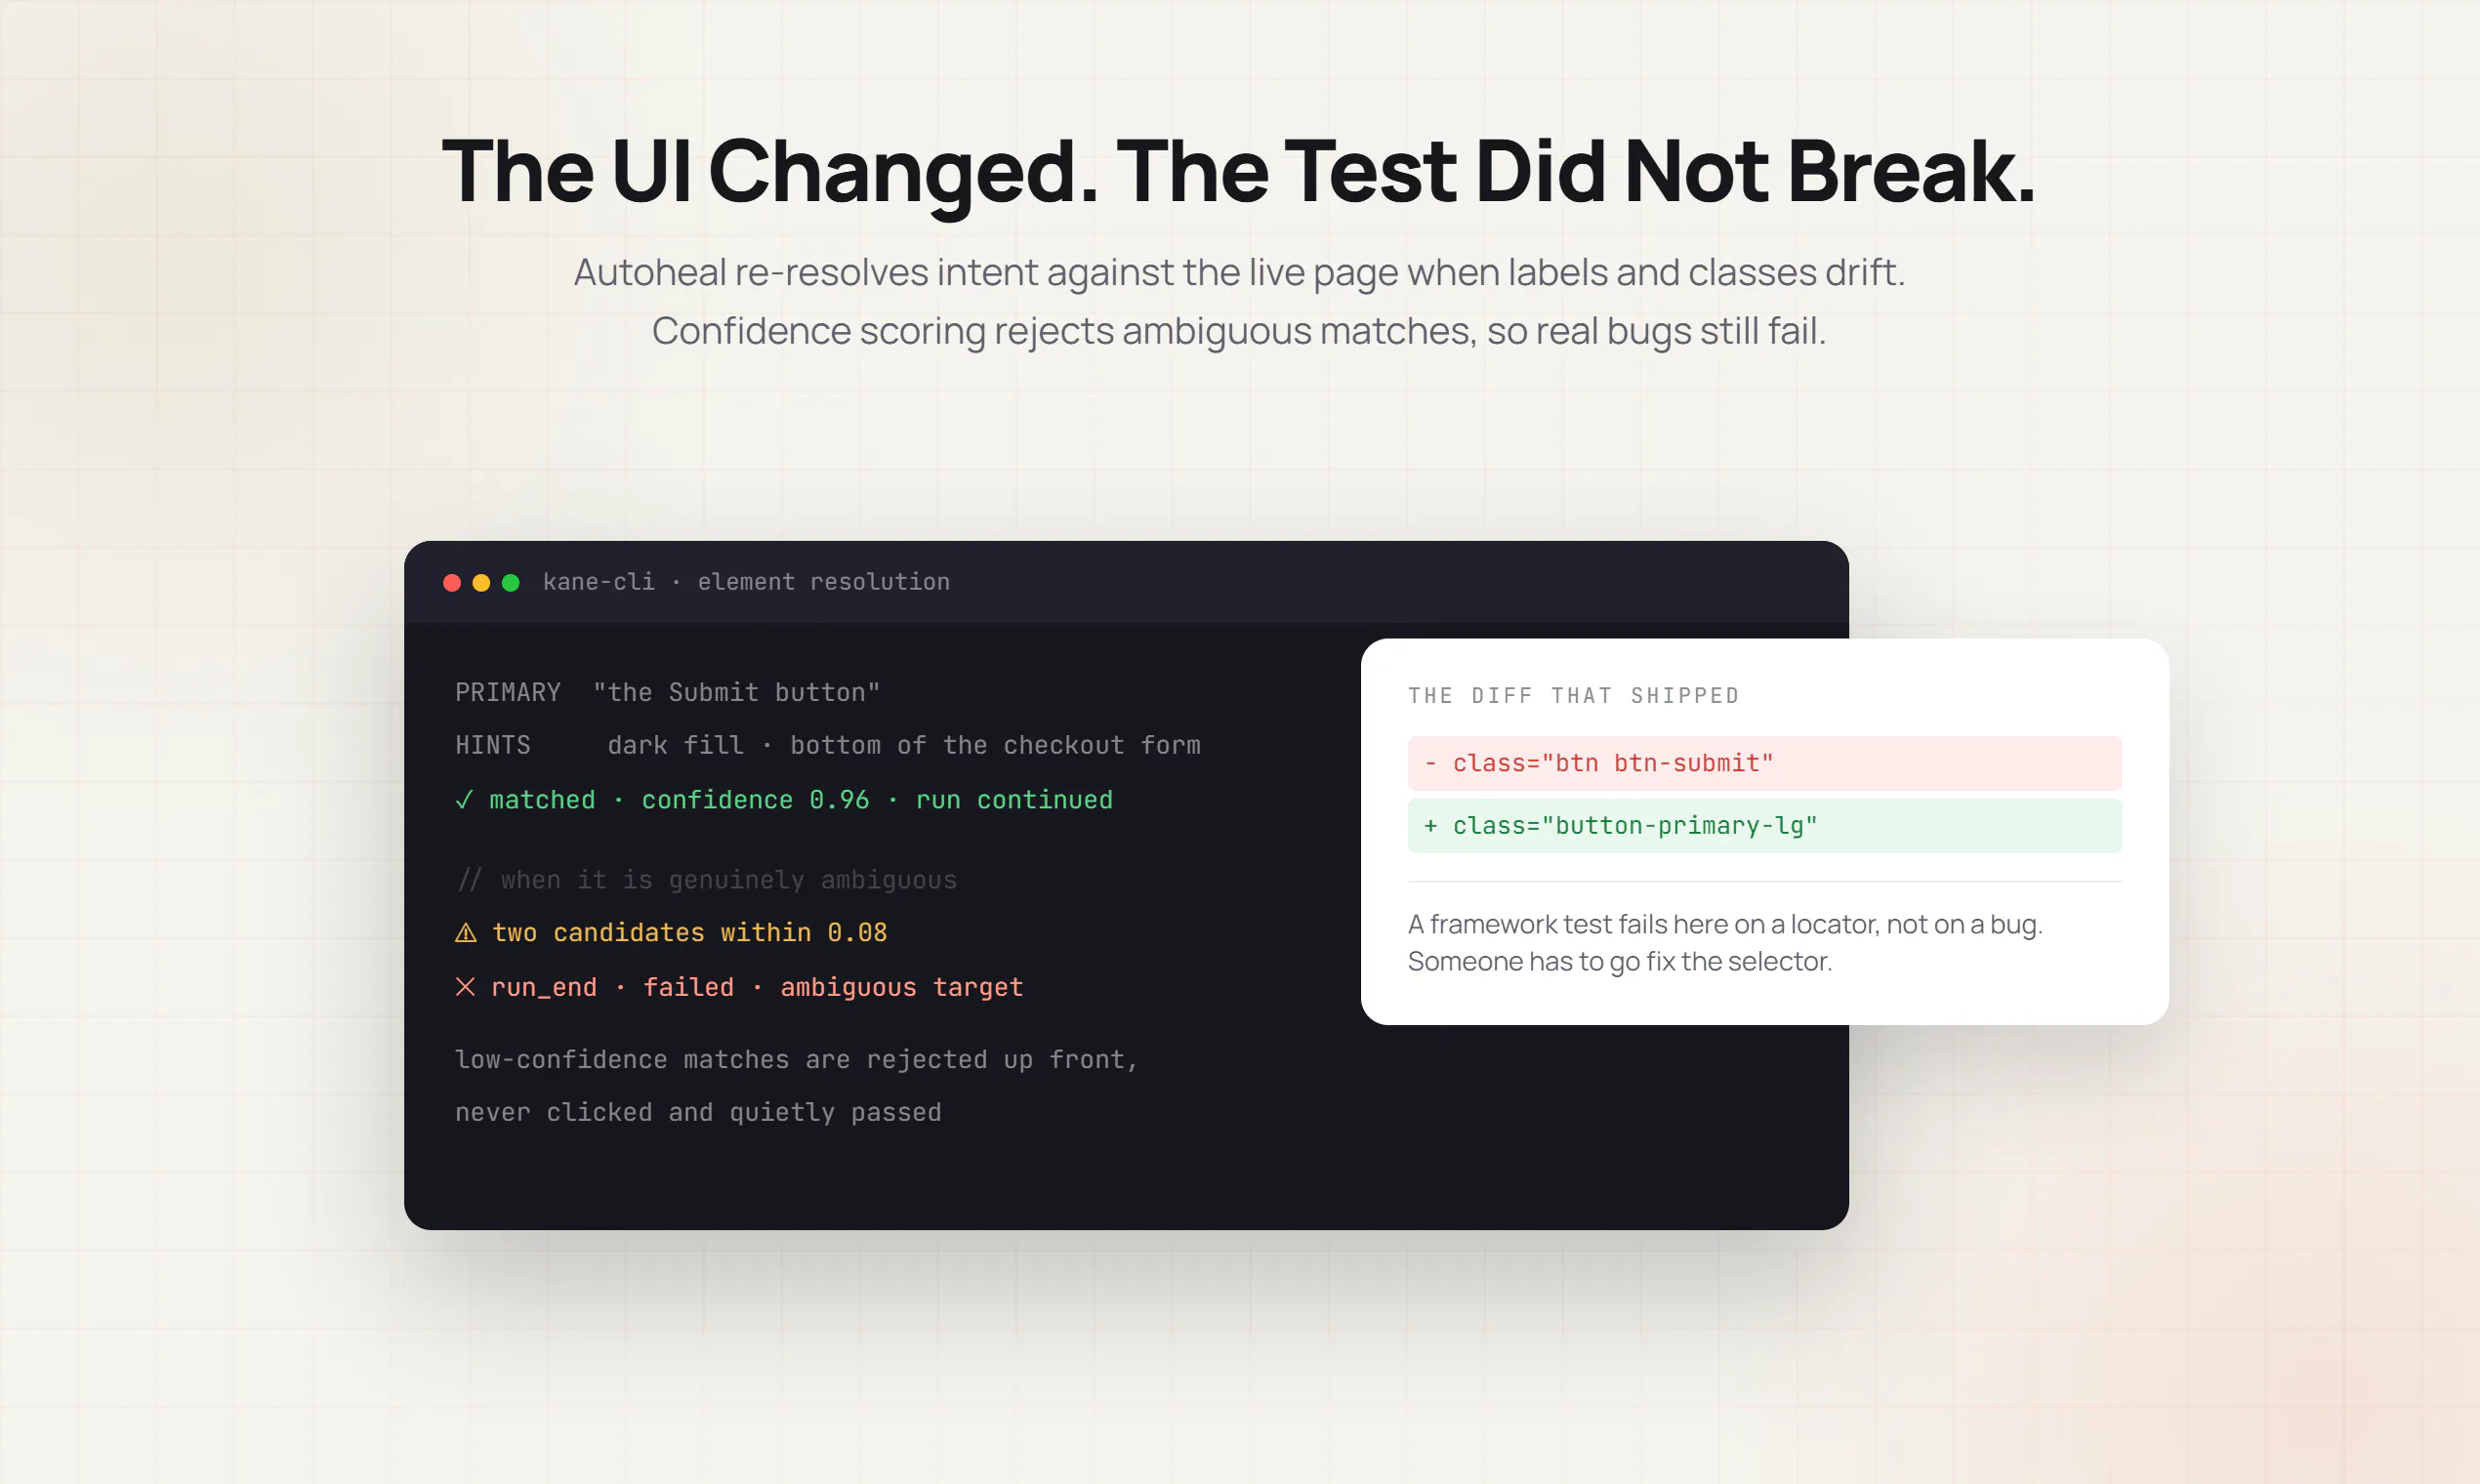
🔧 Autoheal, so cosmetic UI changes never break a flow
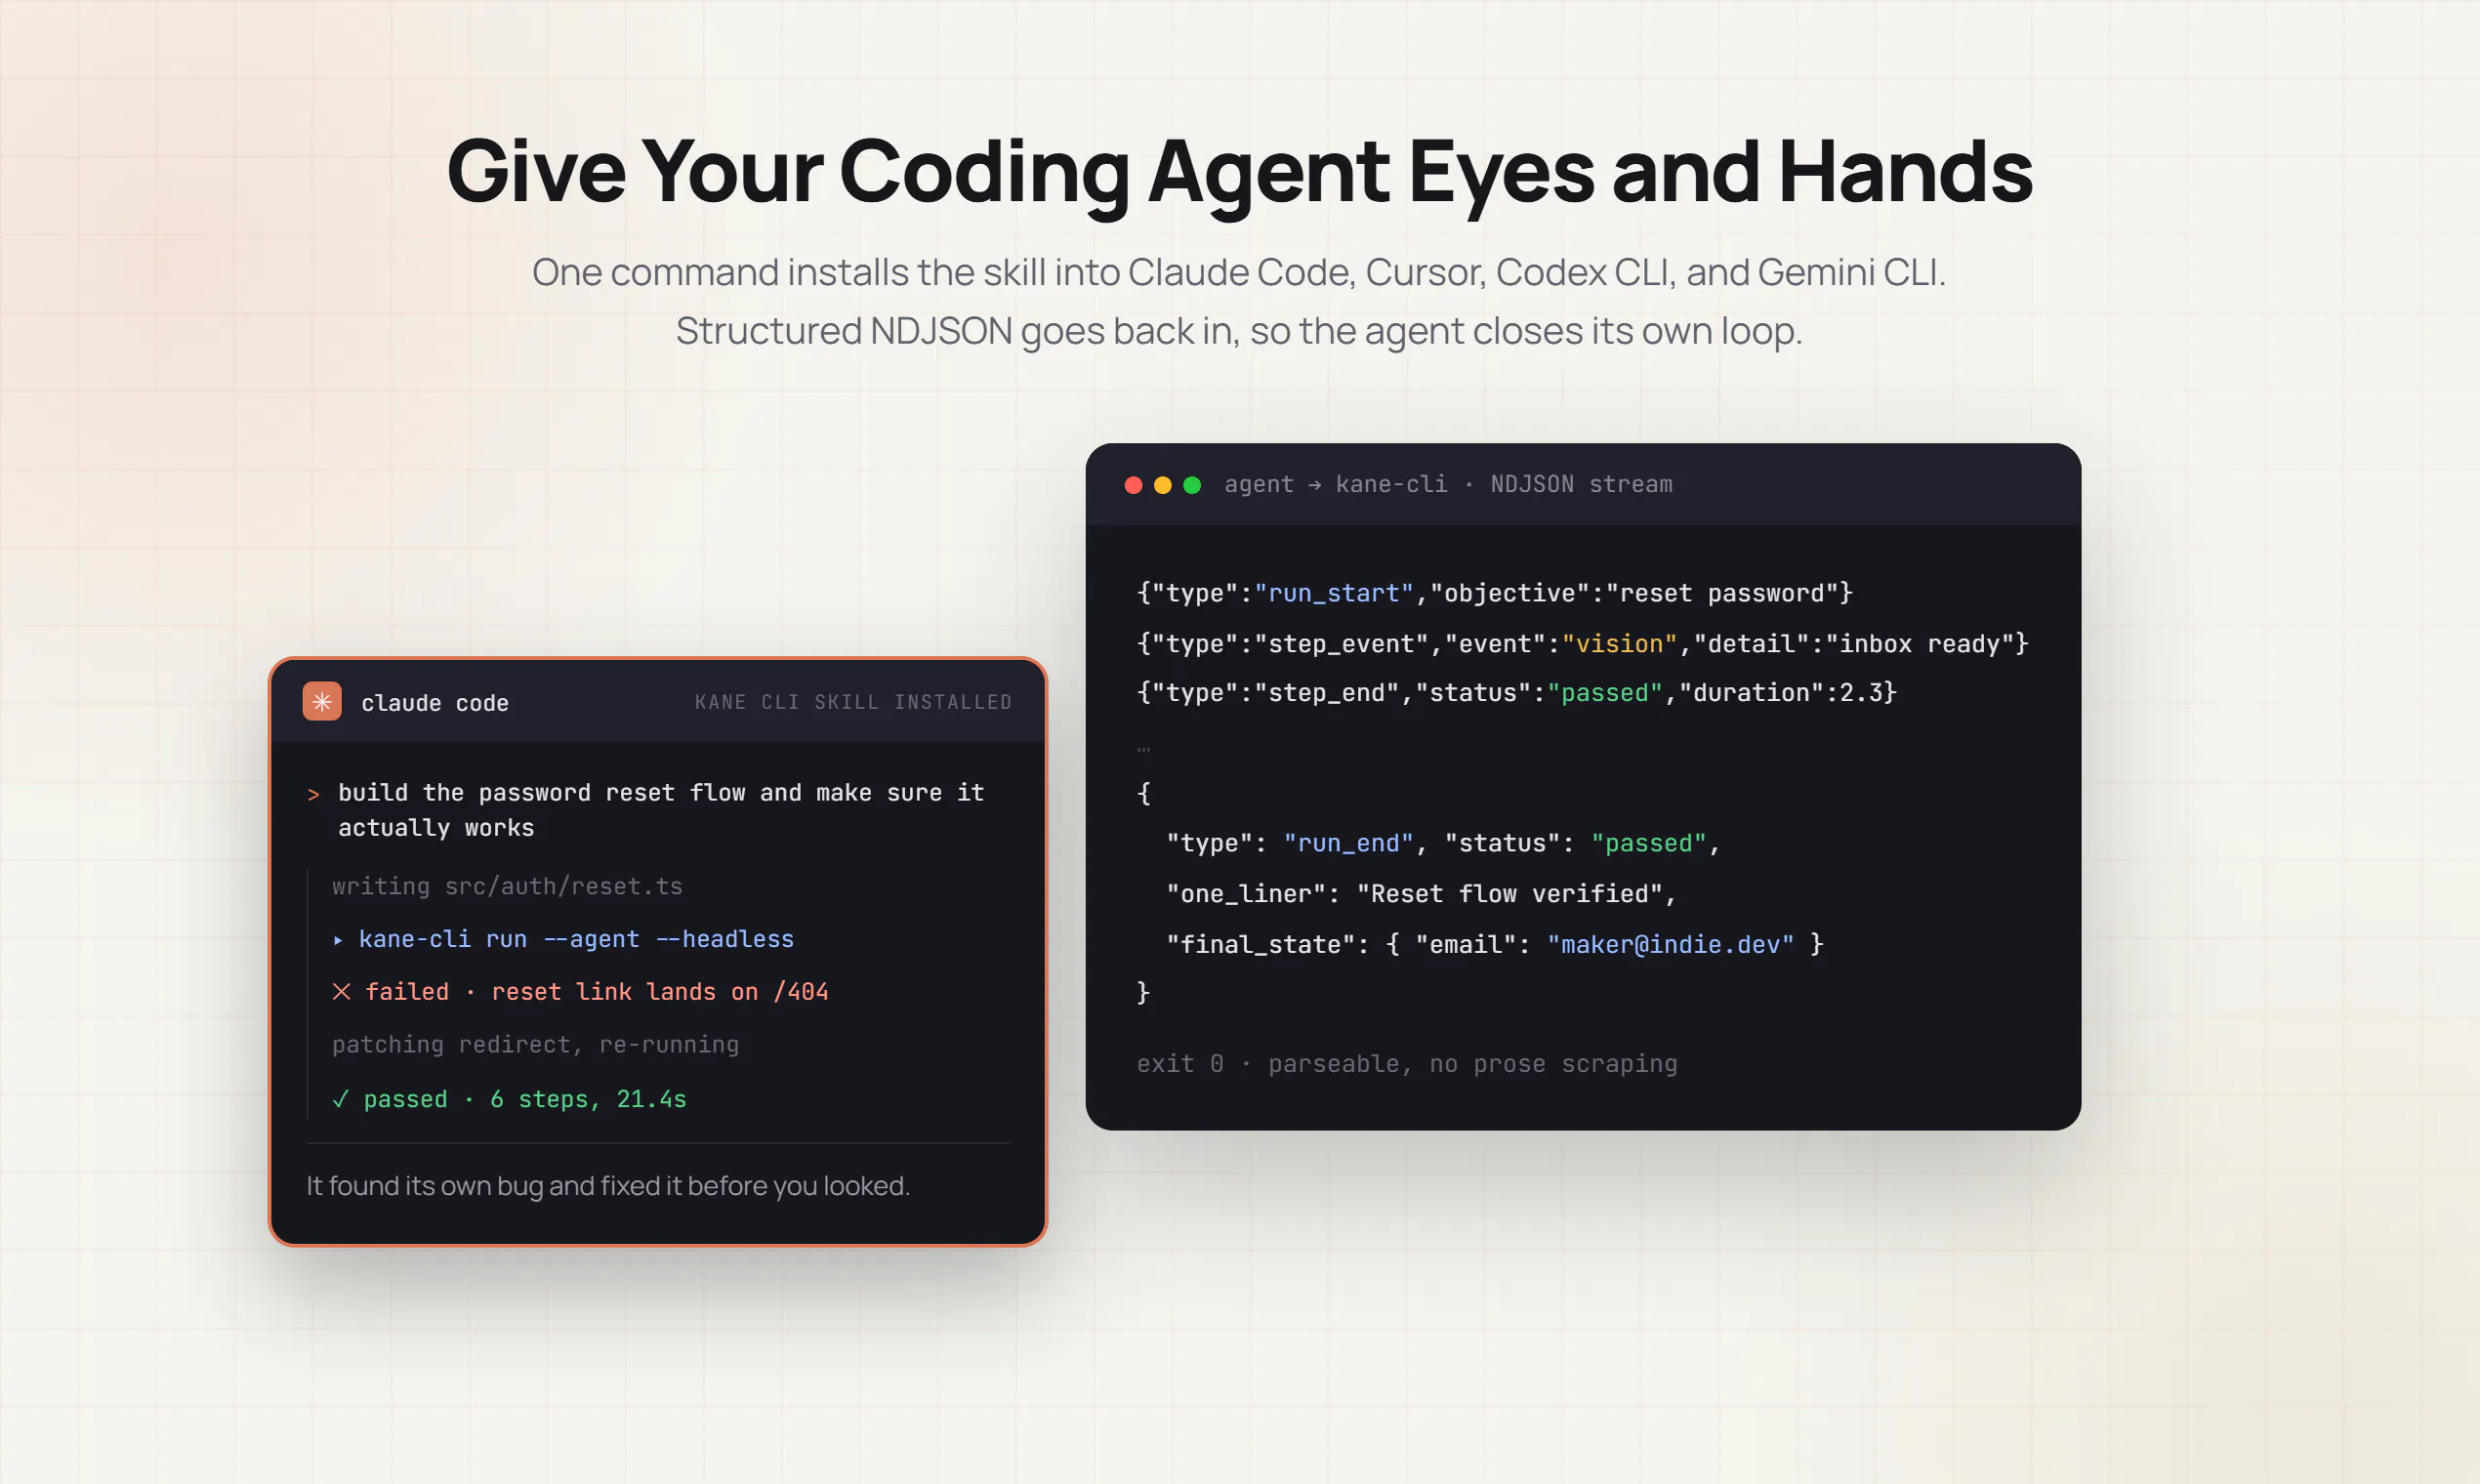
🤖 Agent-native output, so Claude Code or Cursor can call Kane CLI and read the verdict on their own
And starting today, mobile 📱
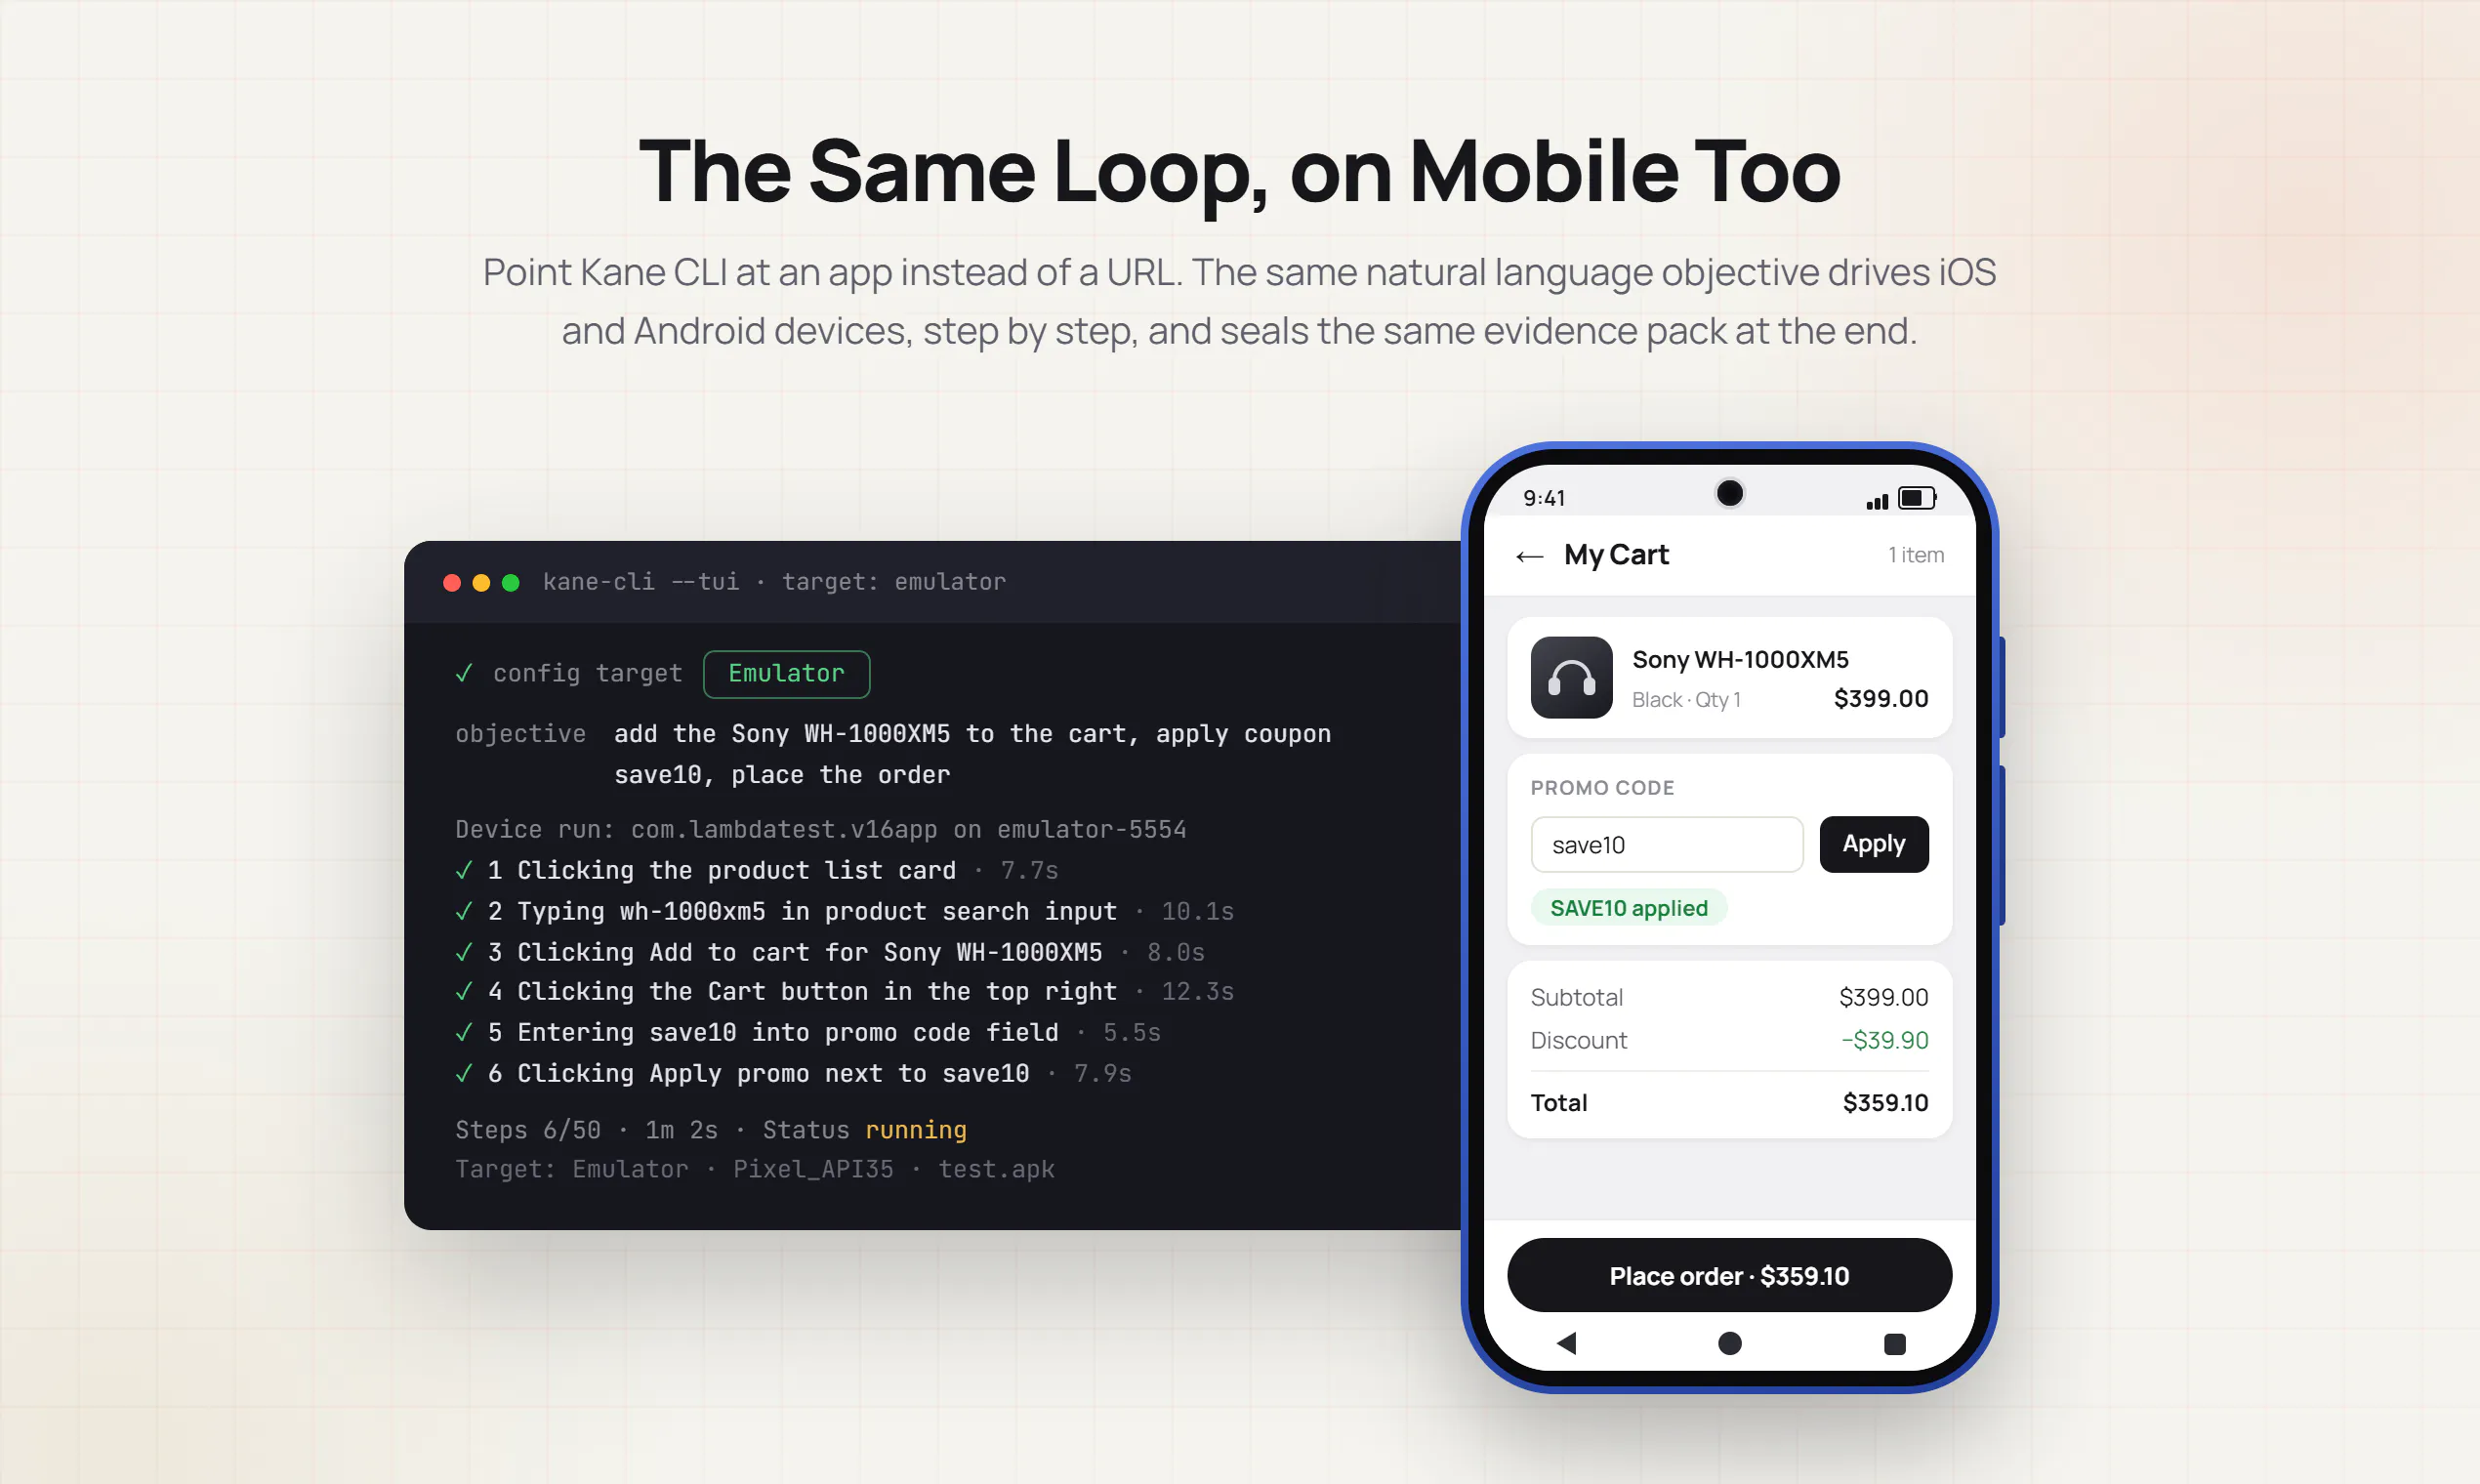
v0.8.1 makes mobile a first-class platform. Same setup, same sessions, same evidence model, now on Android emulators and iOS simulators. Run devices list, pick a target, and the AI reasons about mobile screens the way it reasons about web pages.
For the skeptics
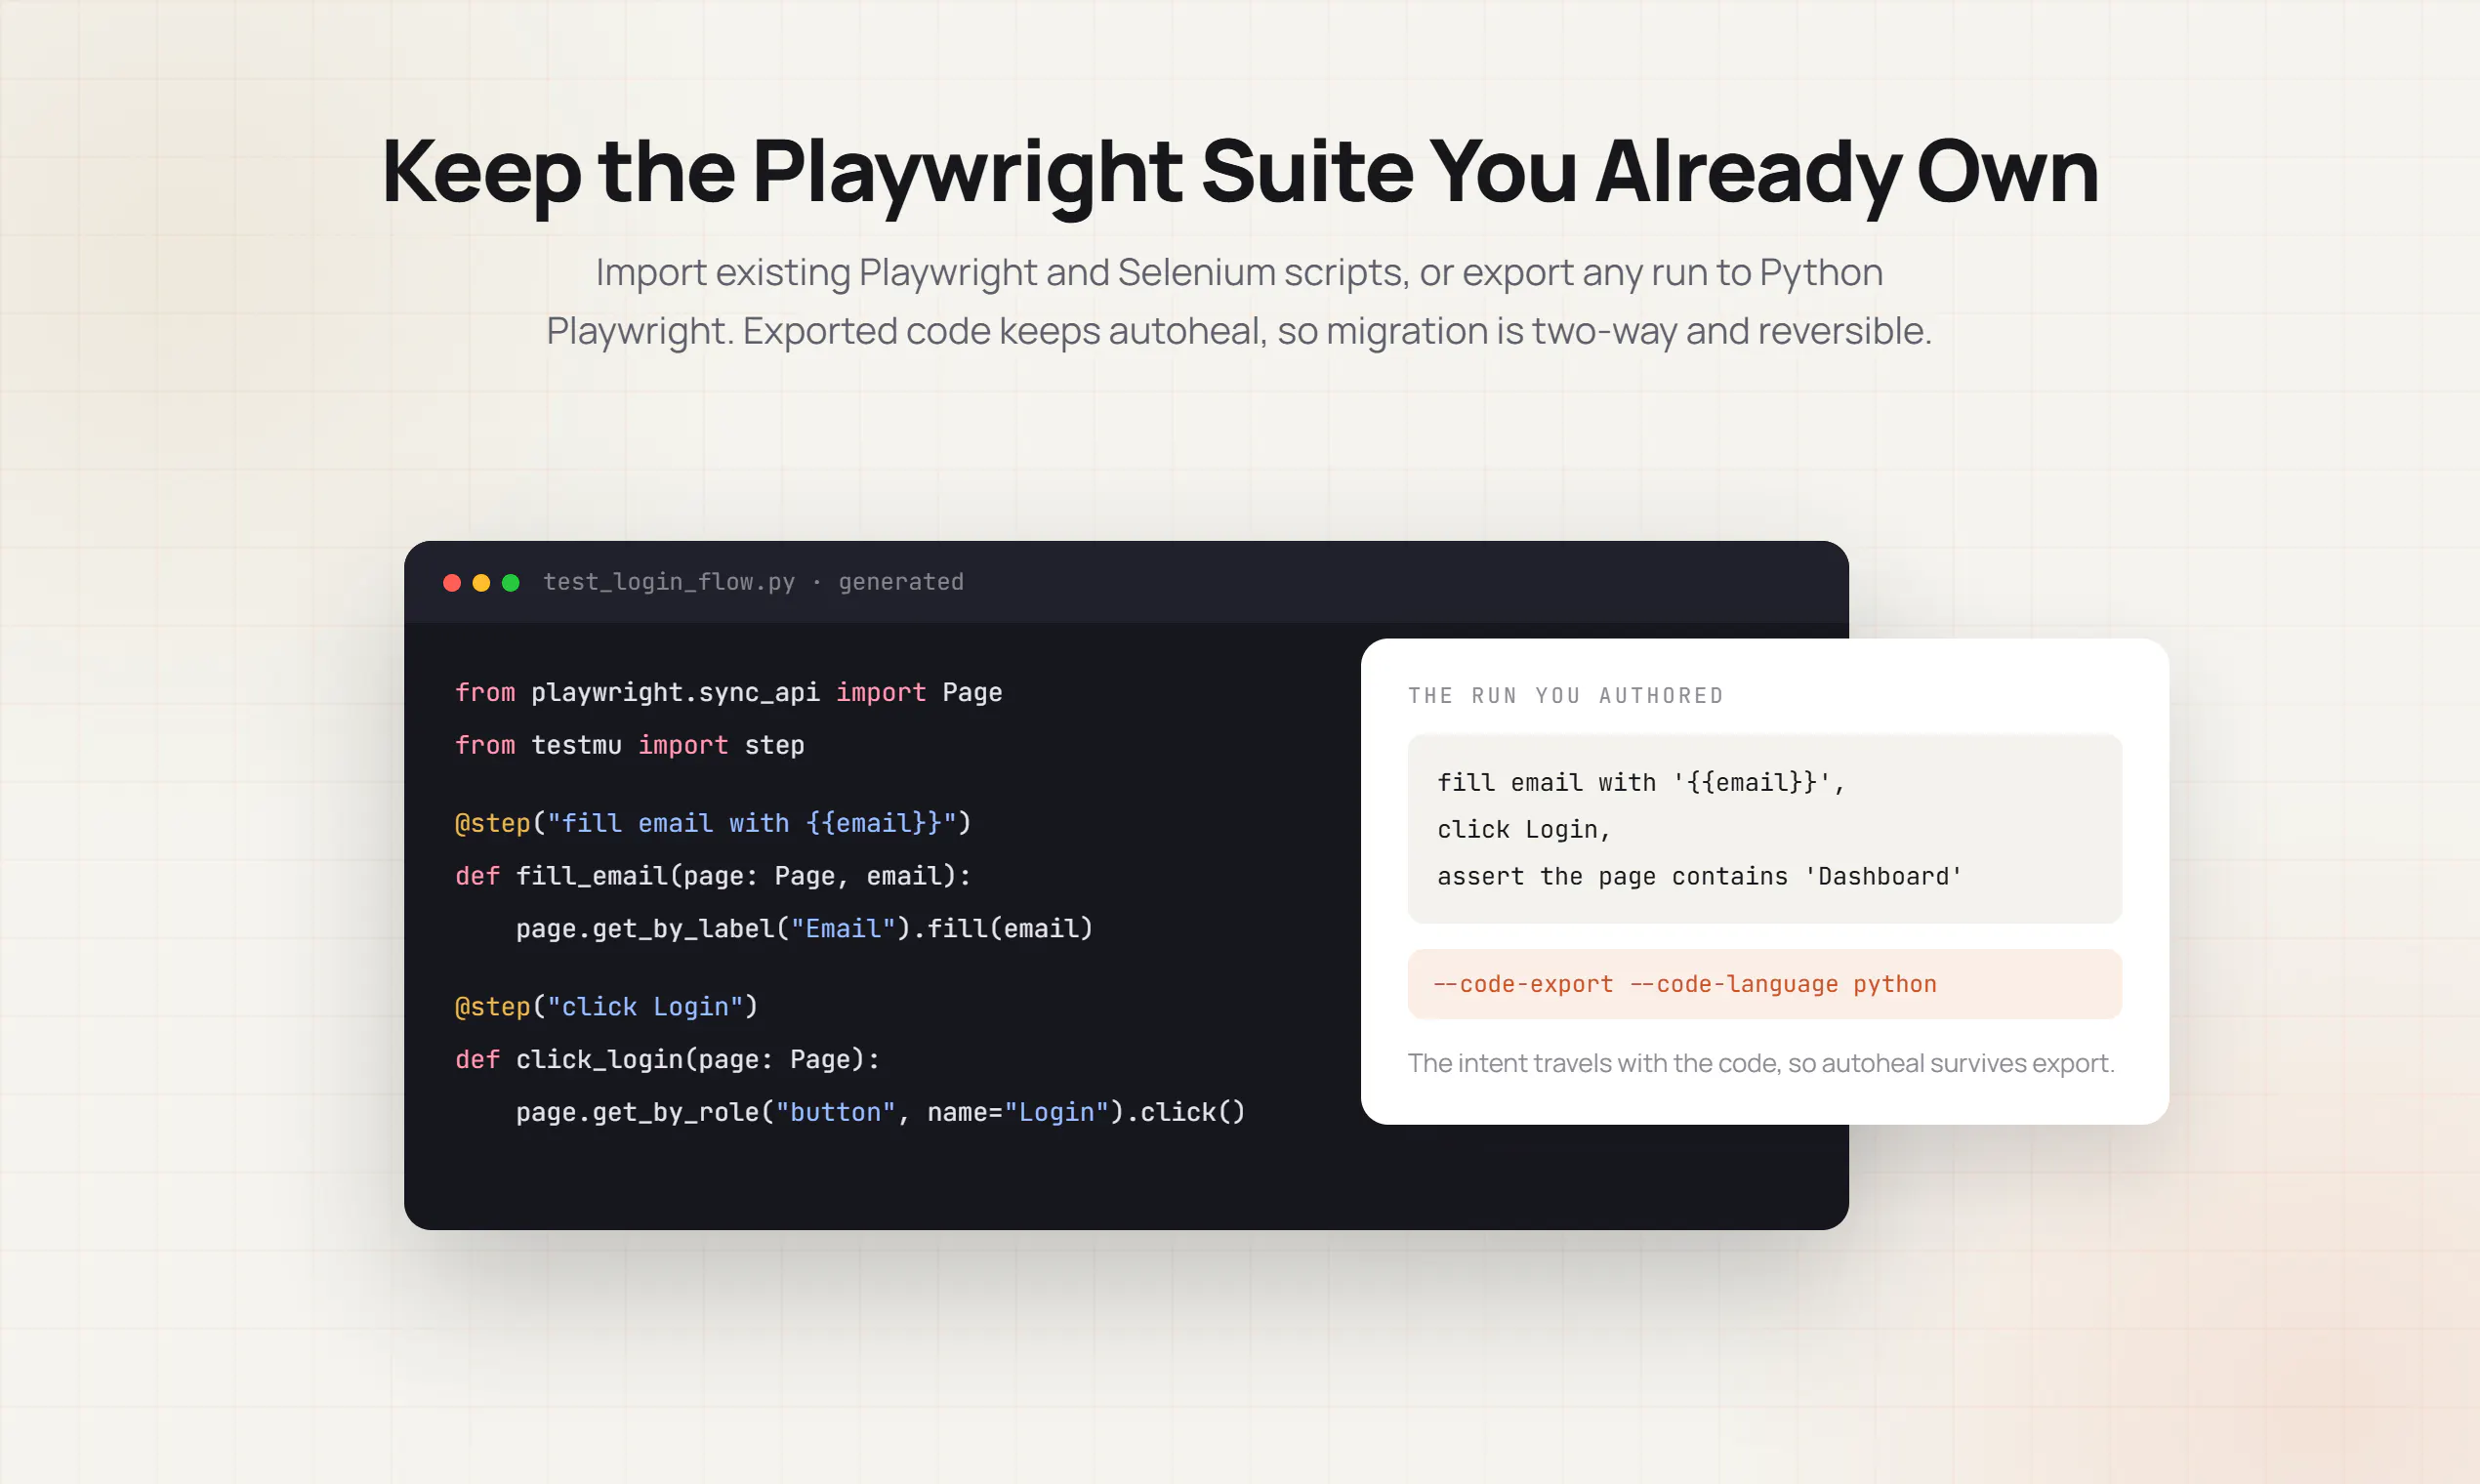
Hacker Mode exports any flow to native
Playwright code. Never locked in. 🔓
Ask me anything technical, I will be here all day.
Learn more: testmuai.com/kane-cli-ph
Hi everyone, I'm one of the engineers building Kane CLI. Good to finally have this out in the world.
The part I'm personally most proud of: we built it agent-native from day one. I've spent 2+ years shipping frontend at TestMu AI, and if that taught me anything, it's that writing UI was never the slow part, proving it still works after every change is. AI has made the writing nearly instant, which makes verification the real bottleneck. So we designed for it: every command can emit machine readable output, meaning it's not just humans in a terminal, your coding agent (Claude Code, Cursor, whatever you use) can invoke kane-cli, stream the run, read the verdict, and act on it inside its own loop. AI writes the code, Kane CLI verifies it in a real browser (or on mobile), and the agent gets machine-readable proof back. Closing that loop is what makes autonomous dev workflows actually trustworthy.
The other thing we obsessed over: a pass has to actually mean something. Every verdict ships with an evidence pack; screenshots, console logs, network responses; so a green check is never "the model felt good about it." You can see exactly what was verified, and when something fails you're not guessing.
It's local-first and free to start. Happy to answer any questions in the comments.
Big day for us at TestMu AI
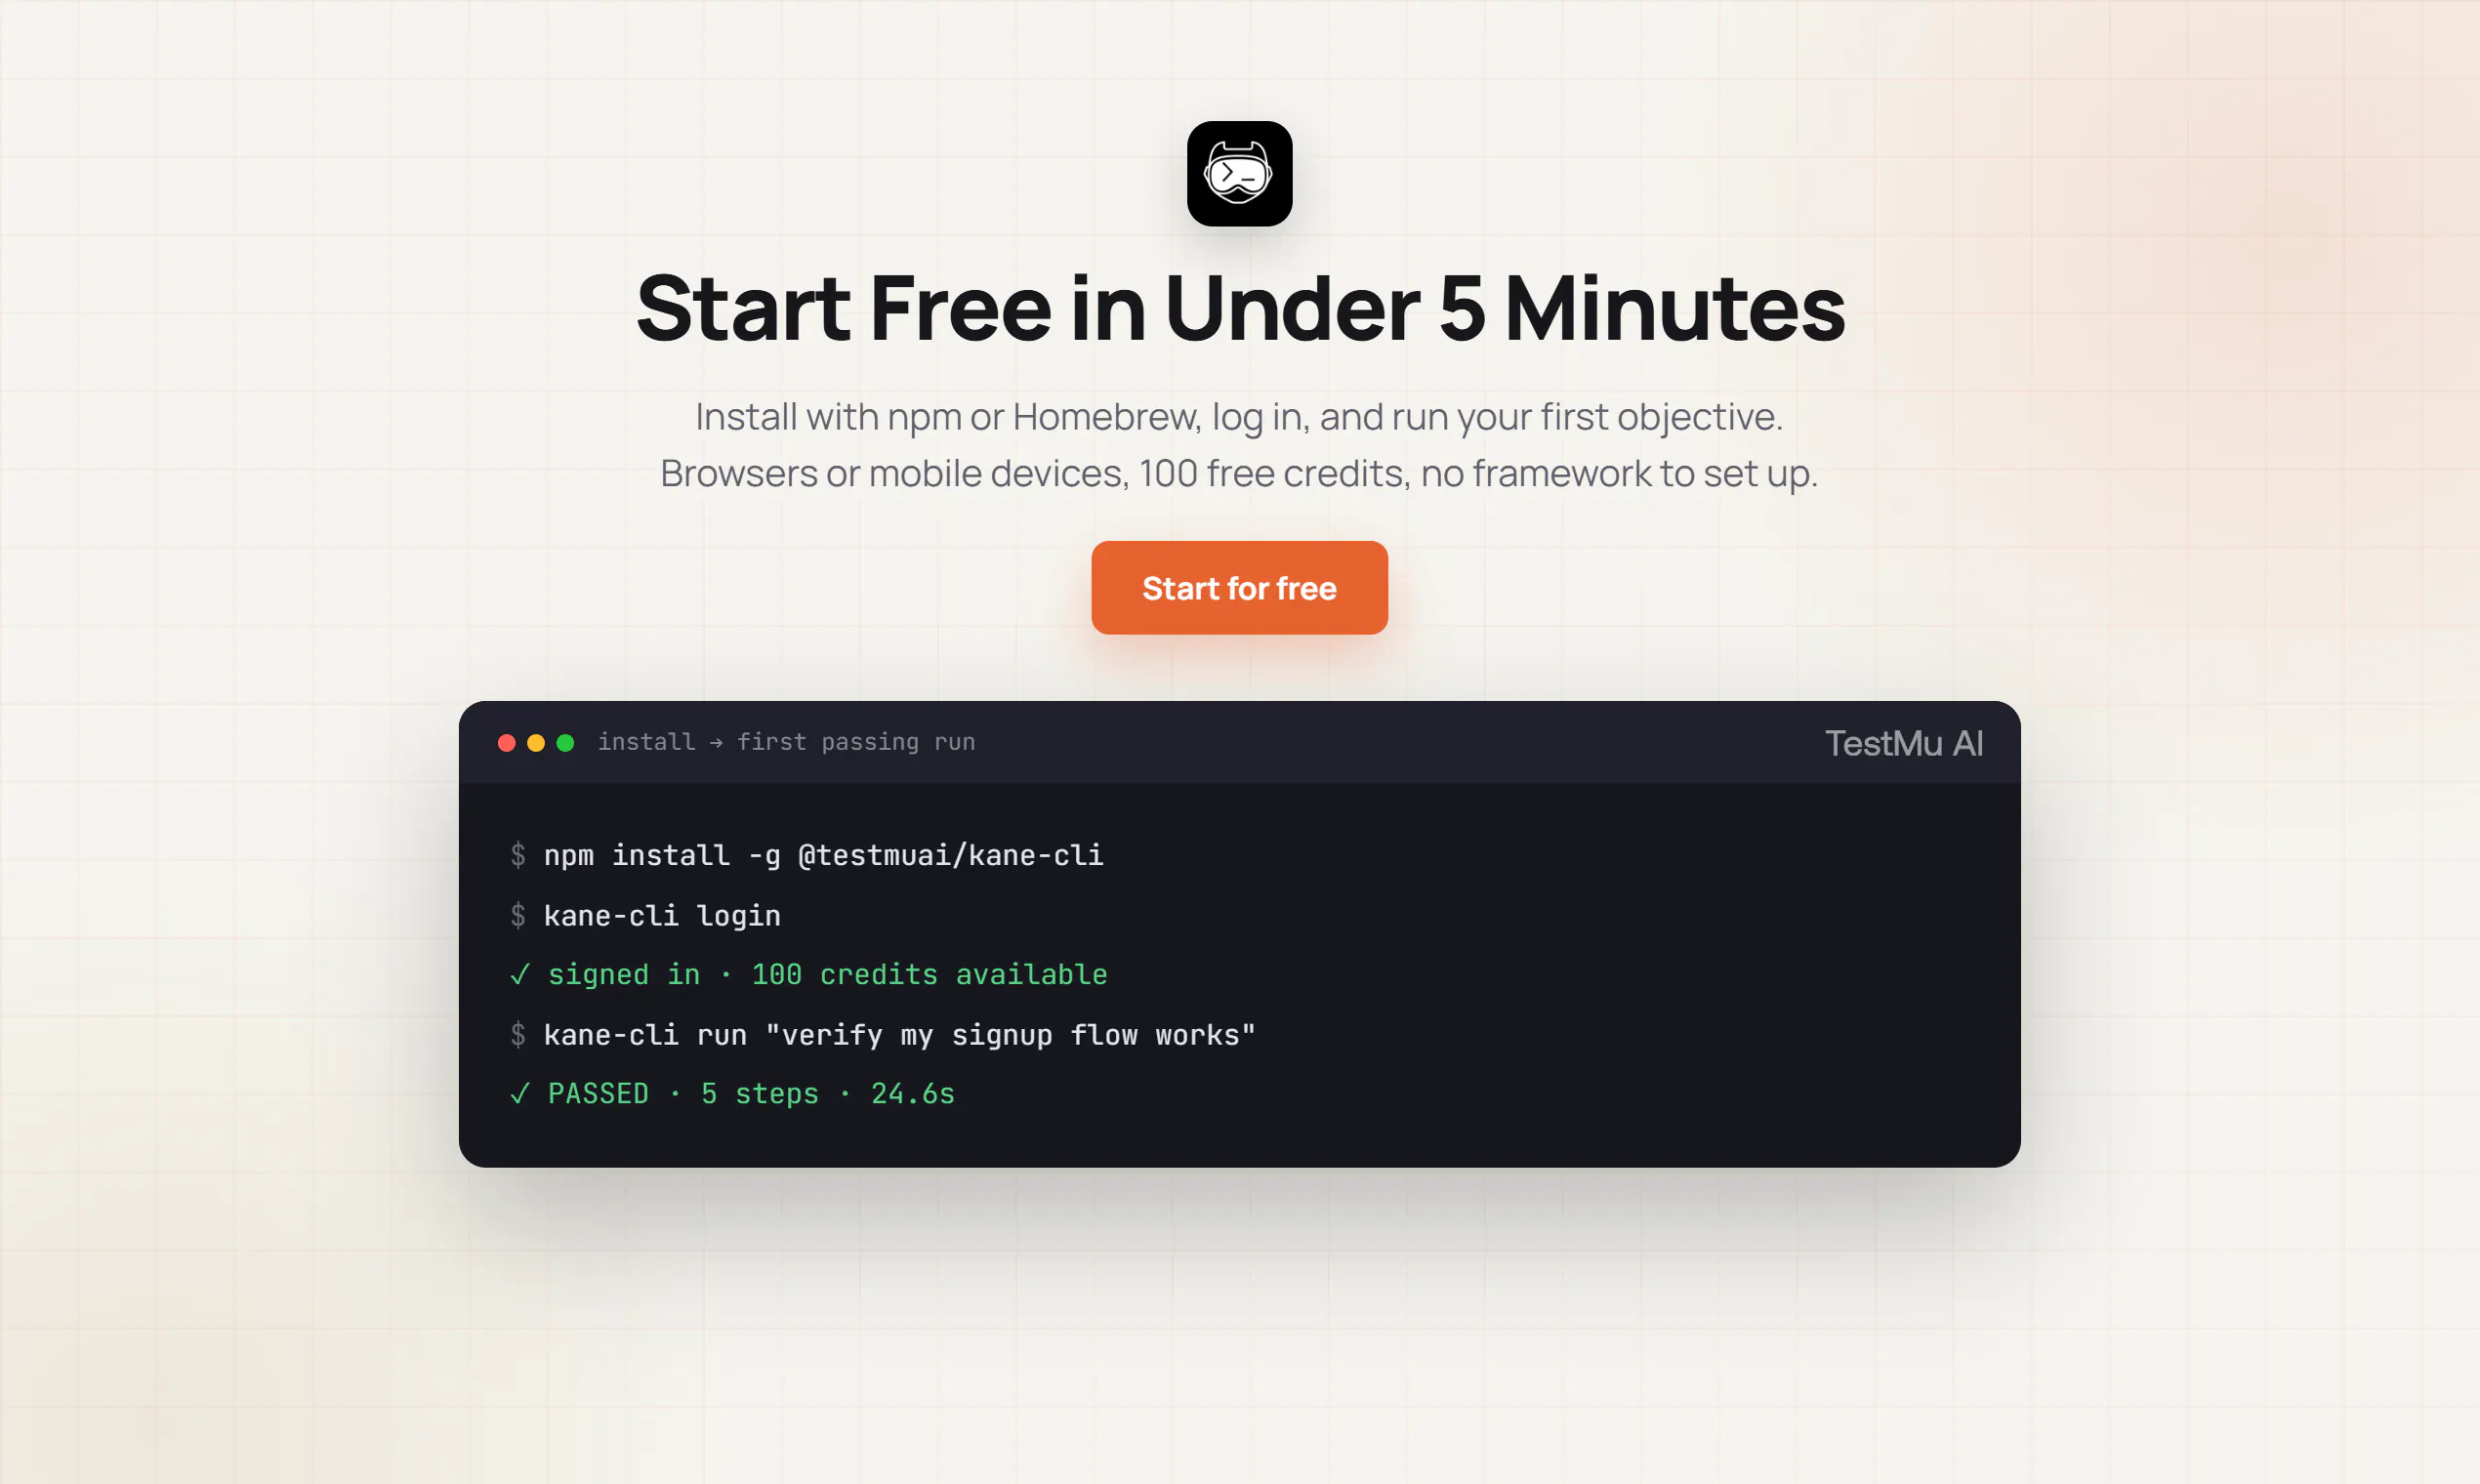
I have watched Kane CLI come together from the inside, and the part that still gets me is watching it in action. You type what you want verified in natural language, a real Chrome window opens, it works through the flow, and comes back with an evidence pack and a verdict. No selectors written. No framework set up.
And the timing of this launch could not be better. As of today it does the same thing on Android emulators and iOS simulators. Same commands, same evidence, now on mobile.
The team has poured months into getting the details right, determinism, Autoheal, agent-native output, and it shows.
Proud of this one. If you ship with AI agents, or you are just tired of clicking through your app before every release, give it a run. First verdict lands in minutes.
Learn more: https://www.testmuai.com/kane-cli-ph/
How much context can Kane understand from a PRD before generating the actual browser scenarios?
Hi, I'm Mudit Singh, Co-Founder of TestMu AI.
The thing I love most about Kane CLI: the whole loop works for everyone.
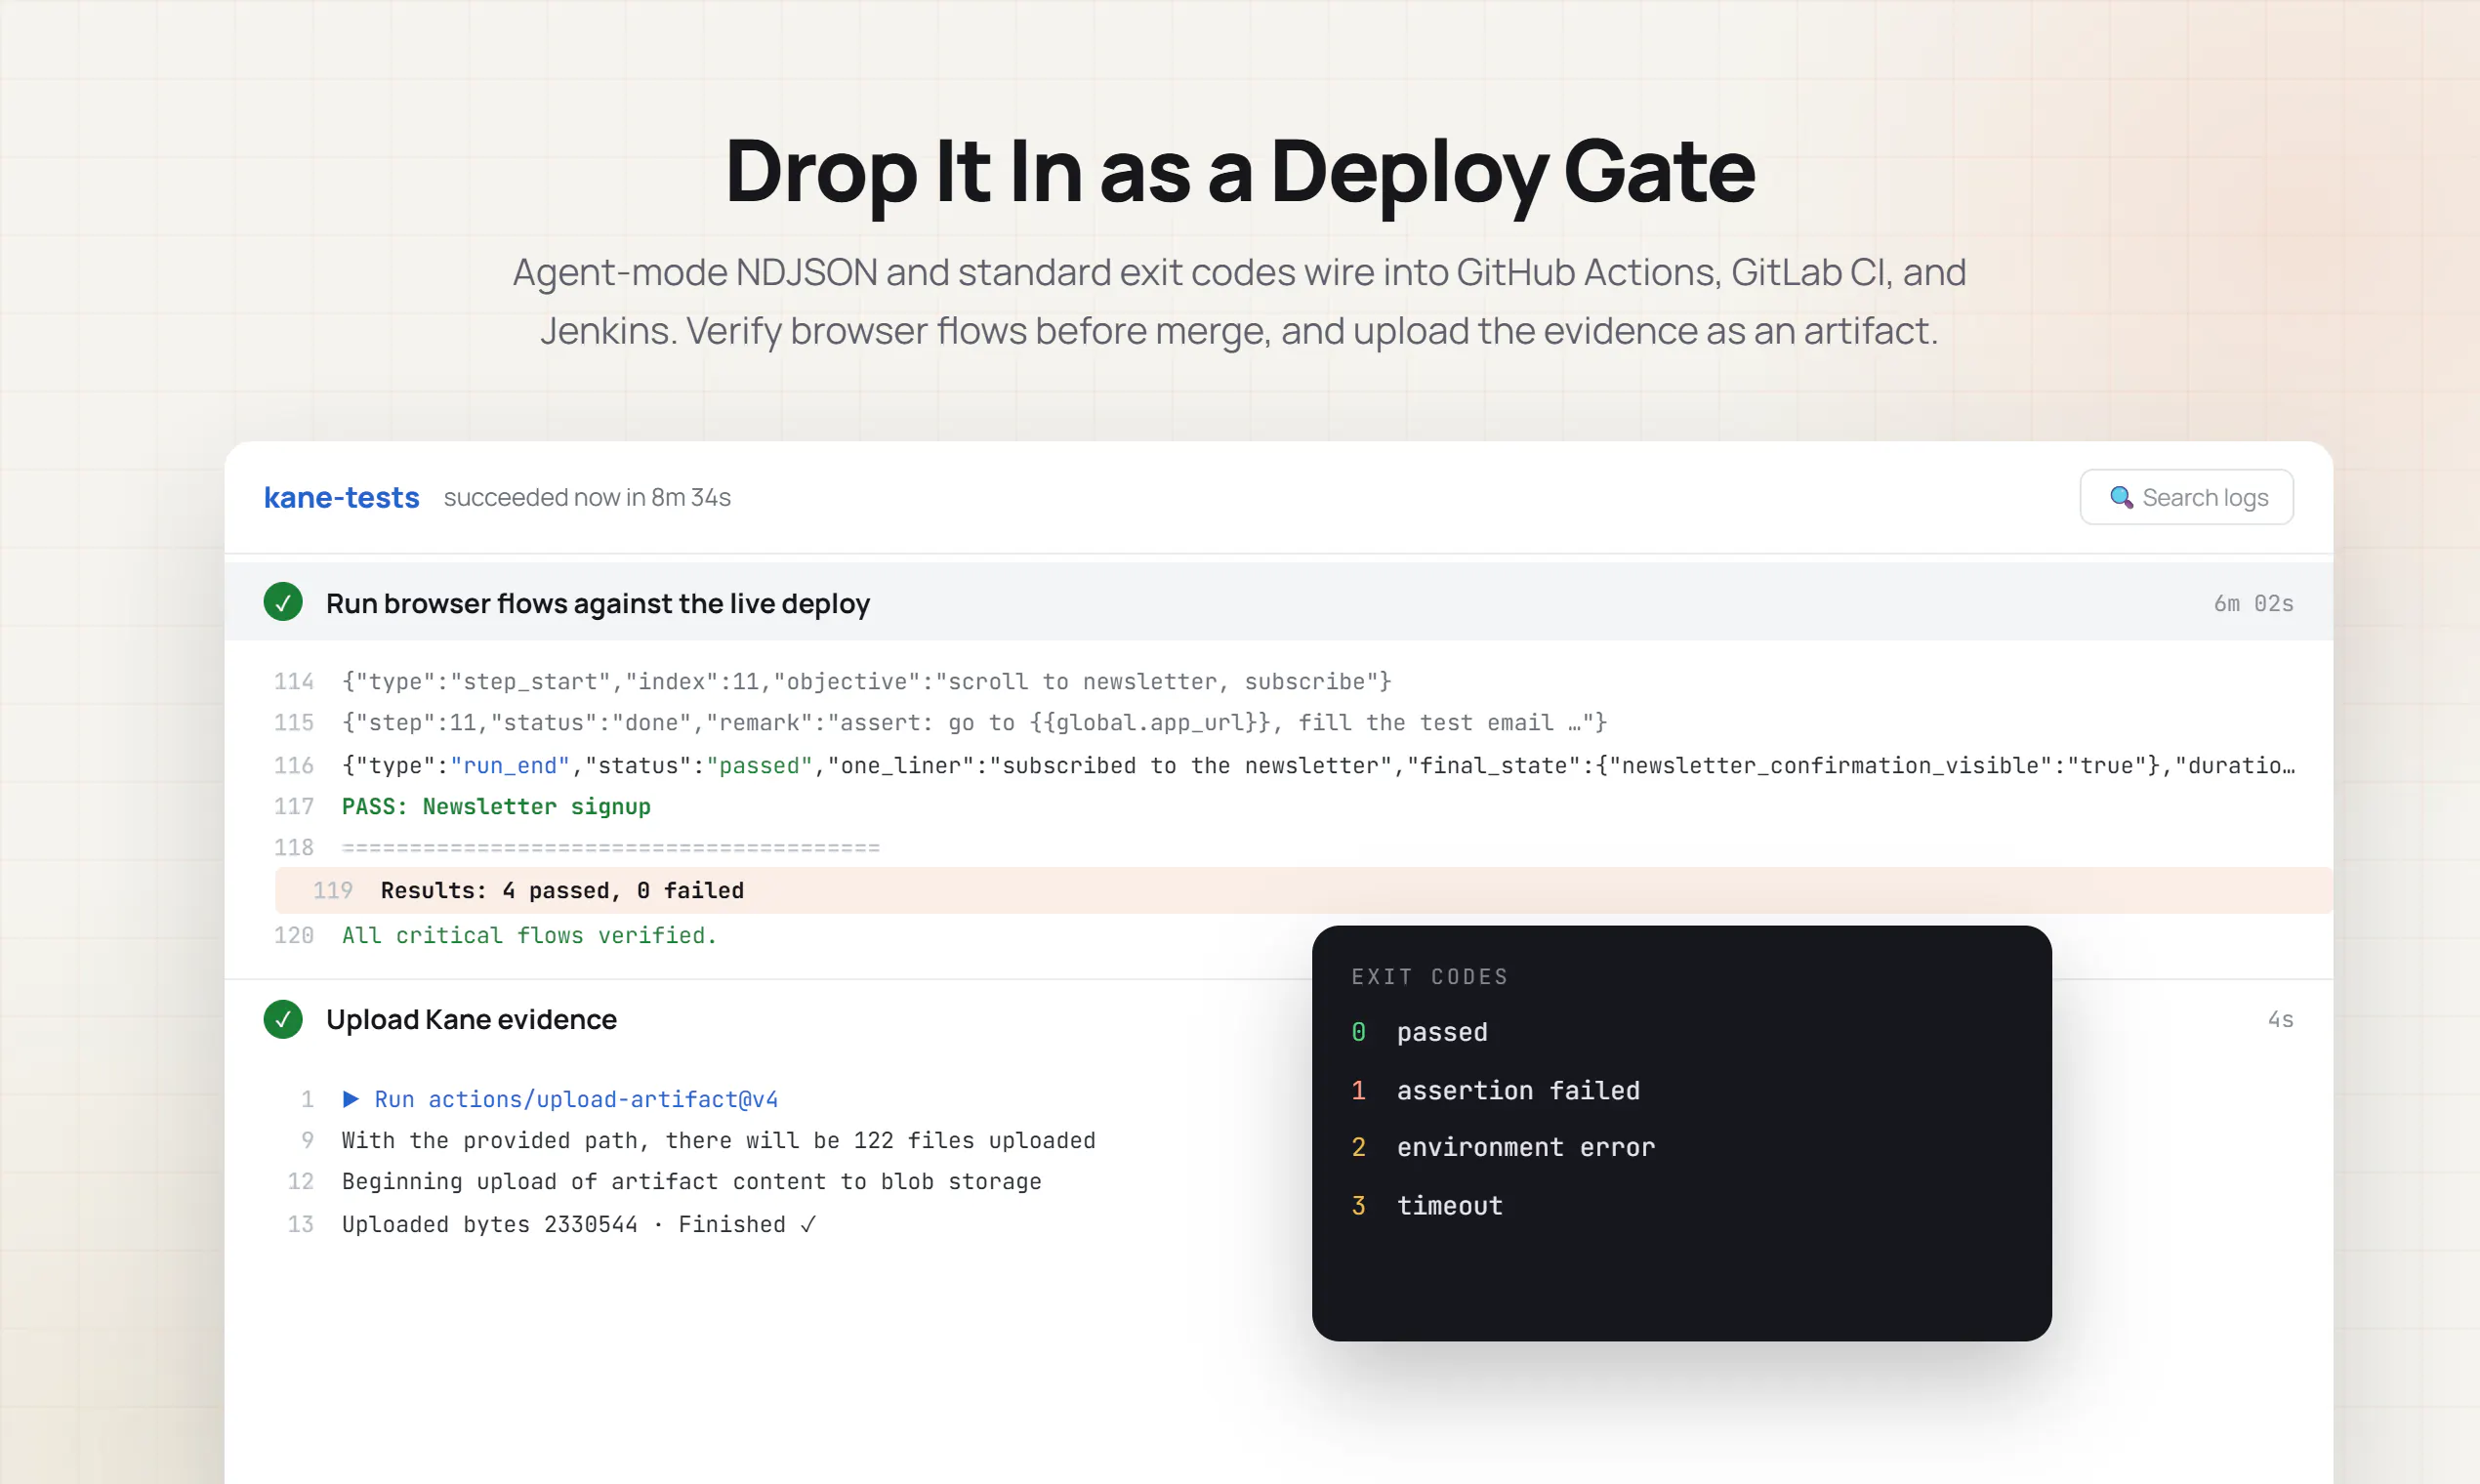
👨💻 Developers feed it a PRD and get scenarios, runs, and a verdict before the PR
✍️ Business teams can describe flows in natural language and automate the boring browser stuff
🤖 AI agents run it to verify their own work and read the verdict straight from the output
📱 Mobile teams, starting today: point the same commands at Android emulators and iOS simulators
Every run leaves an evidence pack. Every verdict is backed by AC coverage. Nothing rests on "trust me, I checked".
Getting started is the easy part
The Starter plan is free. One install command, npm, brew, or curl, and your first verdict lands in minutes.
Try it, break it, tell us what is missing. Your feedback this week directly shapes the roadmap.
Learn more: testmuai.com/kane-cli-ph
Kane CLI is the future of agentic verification systems.
how is this different from Claude in Chrome?
Hi, I'm Mayank Bhola, Co-Founder and Head of Products @TestMu AI
It started with a pattern that would not go away. Agent ships the code. PR merges. Tests pass. Three days later someone opens the app and the button does not work.
Everyone kept asking how to make agents write better code. Wrong question. Agents could already open browsers and check their work. The output was the problem. Different result every run. No verdict you could trust. Loop it enough times to be sure and you have burned real money for a maybe.
So we set one non-negotiable bar: determinism
Same flow, same result, every time. A pass is granted only when the expected state is verified through explicit evidence:
DOM state and URL changes
Network responses
Screenshots and console logs
AC coverage behind every verdict
And as of today, that bar holds on mobile too
v0.8.1 brings the same verification contract to Android emulators and iOS simulators. Same evidence, same replay, same verdict you can defend.
This is the layer I wished existed every time a merged PR broke in production. Now it does, on web and mobile.
Break it. Question it. I am here all day.
Learn more: testmuai.com/kane-cli-ph
Testing across browsers and real devices already creates plenty of complexity. Adding agentic reasoning could make that easier to manage.
This is super useful, especially with how much code is being written by AI now.
What has been the most surprising use case you've seen from early users?
Congrats @jay_0687 & team!
Launch day energy is real today 🎉
I have told the Kane story on stages and in campaigns for months, and the reaction is the same every time. People assume they will need to write code or learn a framework. Then they watch someone type a sentence in natural language, a real browser opens, and it comes back with an evidence pack and a verdict.
That moment when the room goes "wait, that's it?" never gets old.
And today the story got a new chapter: the same commands now run on Android emulators and iOS simulators too.
Even outside engineering, I use Kane CLI for my own repetitive browser work. That is the part I love most, it is not just for engineers.
The Starter plan is free, so go break it and tell us what you think. The team is here in the comments all day.
Learn more: https://www.testmuai.com/kane-cli-ph/
I had been looking for such a product that can help me in validation during my development sessions. Kane CLI seems like the perfect tool that will really help me keep my work bug-proof. Amazing!!
Agentic mobile test was the missing piece of the puzzle. Kane CLI seems to be solving that perfectly well!
Could developers trigger Kane directly from CI/CD and block deployments automatically when critical browser workflows fail?
The build-fast, trust-slow gap is very real. I like how Kane CLI focuses not just on running tests, but on producing evidence teams can actually trust and share.
How do you see Kane CLI fitting into an AI coding workflow,should testing happen automatically after every code change?
I really love KaneAI’s conversational approach to generating critical test scenarios from the provided documentation. It frees up my local machine’s resources while helping me explore and work with different aspects of the platform more efficiently. Overall, KaneAI has made the testing process smoother, faster, and more collaborative.
Congrats, team! How does Kane decide whether a natural-language test has actually passed when the page behavior is slightly different than expected?
the ask-tool pause on OTP/CAPTCHA instead of guessing is the right call. since the exported case replays deterministically, what happens when the site's UI shifts a little, a moved button or new copy, does it re-derive from the original NL description or does someone have to re-record?
Does Kane handle logged-in flows automatically, or do we need to set up auth ourselves?
Awesome, i have been needing to formalise our test releases.. this is just what i was looking for.
Does the product integrate with other systems?
the machine-readable verdict for agent loops is the right instinct, that's the same gap I hit running voice model evals: a pass/fail with no provenance just means trusting the model again. does the evidence pack capture intermediate state, or just the final screenshot, when a flaky animation causes a false fail?
AI coding agents desperately need something like this. Writing code is becoming easy; reliably verifying the result is becoming the bottleneck.