PH热榜 | 2026-07-31
一句话介绍:MiniMax H3 是一个能一次生成带原生立体声的2K视频的开源多模态模型,将文本、图像、视频和音频输入统一处理,解决商业创作者在动态海报、品牌视频和电商营销中反复拼接多个工具、难以保持风格一致和文字渲染失真的痛点。
Design Tools
Art
Artificial Intelligence
视频生成
多模态大模型
2K视频
原生立体声
文字渲染
品牌资产生产
动态设计
商业内容创作
开源模型
AI视频工具
用户评论摘要:用户核心关注点集中在品牌一致性与文字渲染稳定性上,质疑连续重渲时能否锁定精确色号和字体;同时询问是否支持对已有视频的局部迭代编辑而非整段重生成;另有用户关注多模态输入是真正联合驱动还是仅同一接口并行,以及API是否支持alpha通道以支持后期合成。
AI 锐评
MiniMax H3 踩中了视频生成从“demo玩具”向“生产工具”转型的临界点。其真正价值不在于把多模态塞进一个模型,而在于它用“原生立体声”和“2K分辨率”回应了商业视频最硬性的交付指标——这比单纯追求画面“好看”务实得多。但社区评论一针见血地揭开了它的遮羞布:品牌工作流的核心是“精确复现”,而生成模型的本质是“连续概率分布”,这决定了它在锁定Hex色号、特定字体这类离散命题上必然失分。更致命的是,几乎没有人关心首帧有多惊艳,所有人都在追问“重渲一致性”和“局部编辑能力”。这暴露了产品介绍与真实生产需求之间的错位:API已上线,但若没有提供alpha通道或干净背景板以便后期确定性合成品牌元素,它依然只能停留在概念可视化阶段,无法真正进入品牌资产交付管线。另一个被广泛质疑的点是“统一多模态”是否名副其实:如果音频只是叠加在画面下,而非驱动剪辑节奏,那所谓融合不过是拼接。MiniMax要想从“让人惊叹”走向“让人依赖”,下一步必须回答:如何在不可控的生成层与要求绝对精确的品牌层之间,架起一条可预测的工程桥梁。否则,它只能吞噬初级剪辑师的工作,却取代不了品牌设计师。
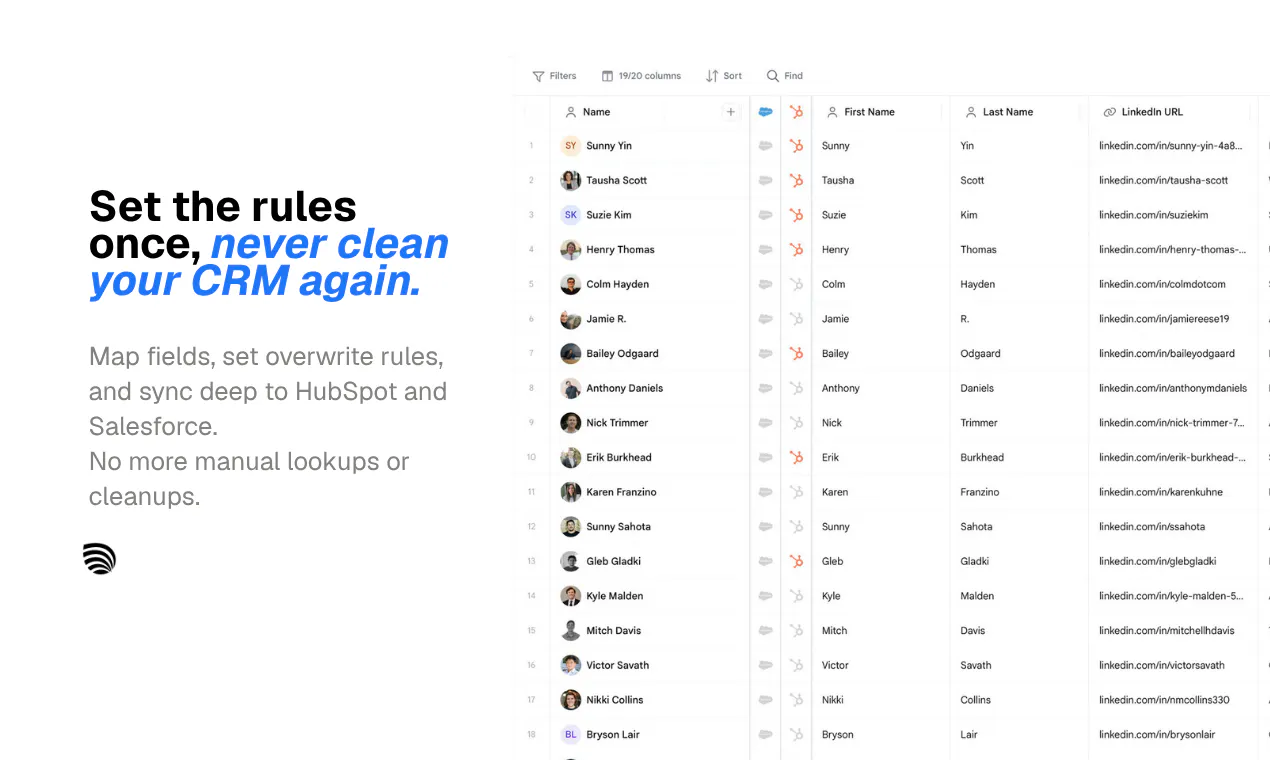
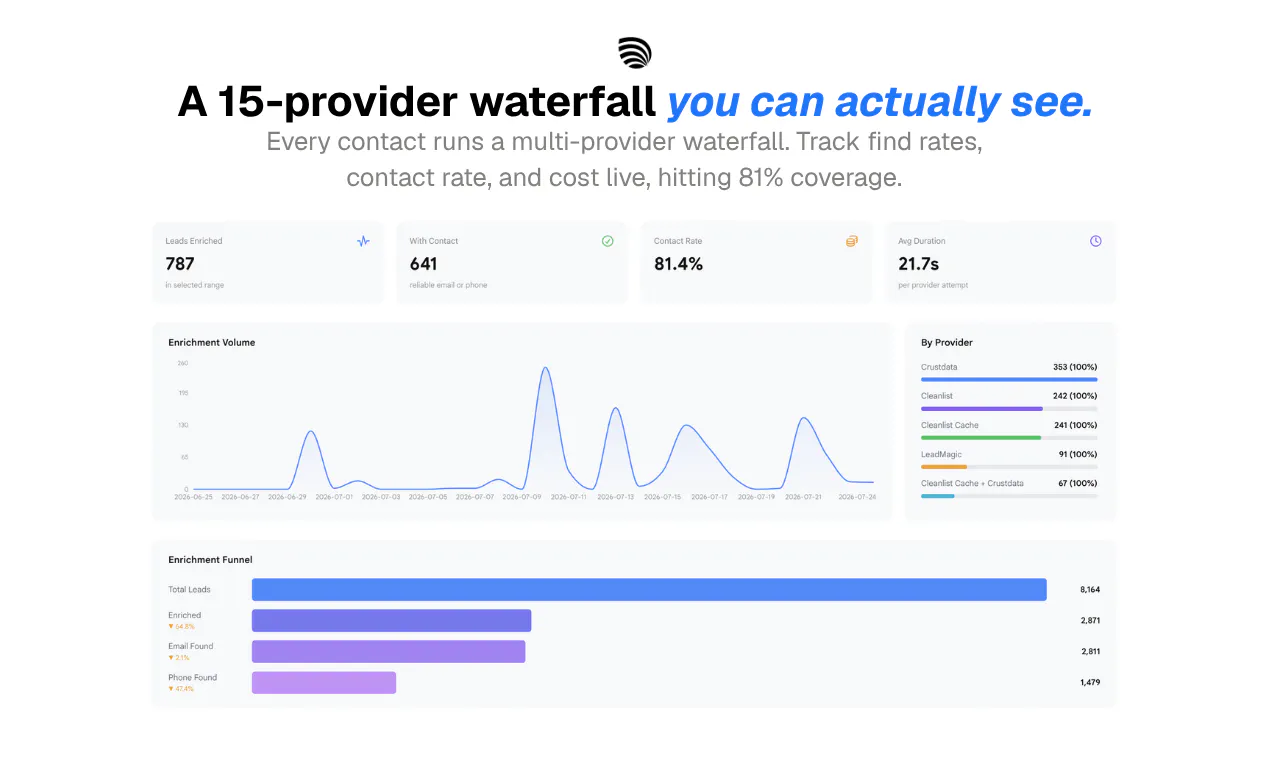
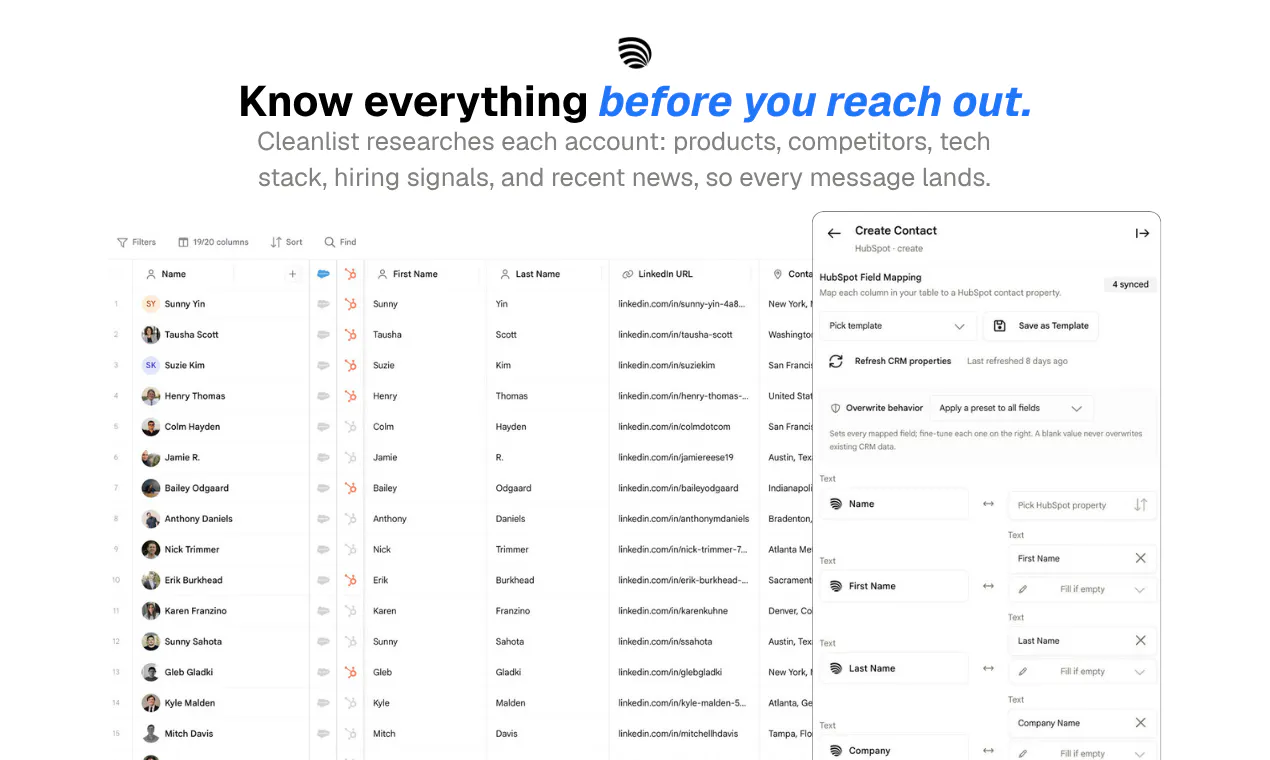
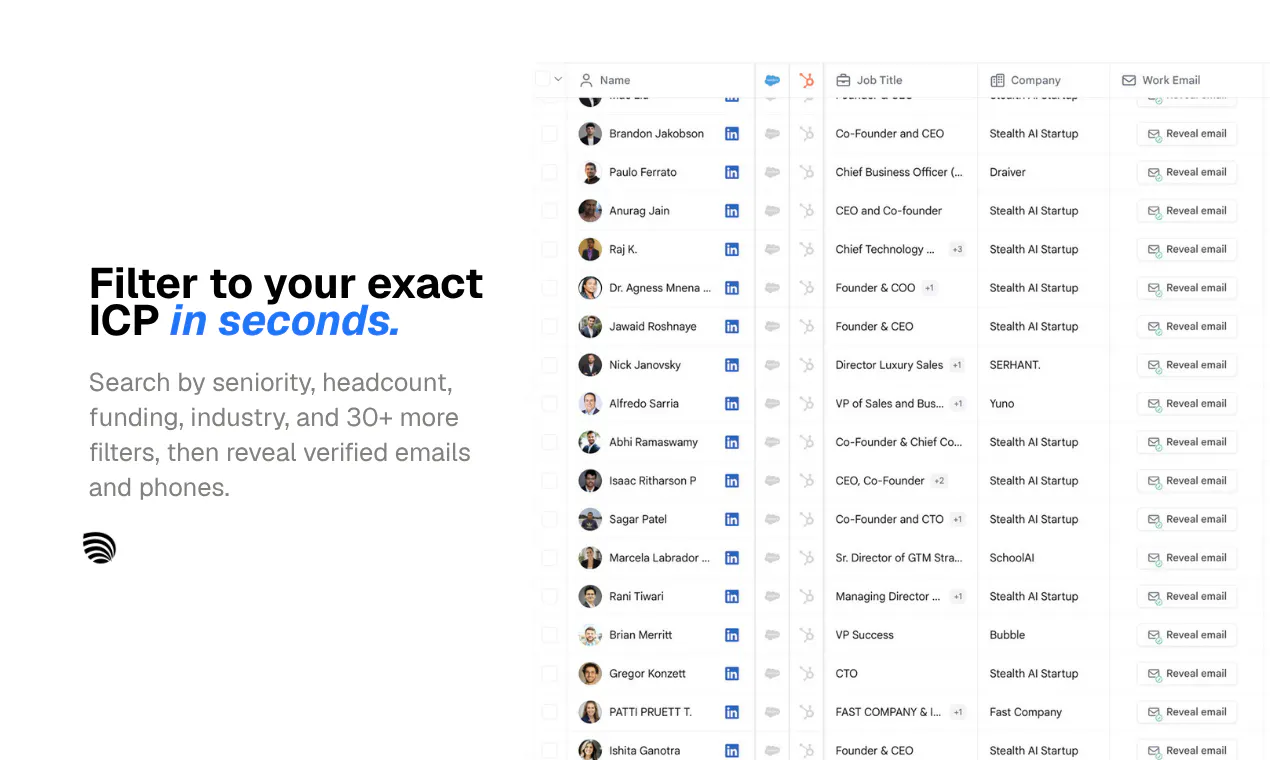
一句话介绍:Cleanlist AI 是一款自然语言驱动的B2B销售线索挖掘与 enrichment 工具,帮助GTM团队将任意来源的原始线索(CSV、LinkedIn URL、搜索条件)自动清洗、验证、丰富并同步至CRM,省去多工具拼接的繁琐流程。
Sales
SaaS
Artificial Intelligence
AI销售线索挖掘
B2B数据清洗
邮件验证
CRM同步
自然语言搜索
销售赋能
GTM工具
数据丰富
线索管理
自动化销售流程
用户评论摘要:用户普遍认可其解决多工具切换痛点的方向,核心质疑集中在三点:数据新鲜度与置信度标识、GDPR下数据来源溯源性(及API/导出是否暴露字段级来源)、与Clay的差异化(尤其对比“工作台”与“电器”的定位)。另有负面反馈称UI过时难用,遭创始人反驳为虚假评论。整体有效建议指向透明性与权限控制。
AI 锐评
Cleanlist AI 的巧妙之处不在于技术壁垒,而在于精准的“产品立场”切割——它把自己定位为“有主见的家电”,而非Clay式的“可组装工作台”。这直击了GTM团队中“没有专人运维复杂工具链”这一隐形但普遍的权力真空。500+付费用户验证了其“开箱即用”的价值主张,15家供应商的水瀑布在成本控制上采用“首中即停”与“无效不收费”策略,商业逻辑比功能本身更值得赞赏。
然而,其护城河相当可疑。核心功能(找邮箱、验证、CSV清洗)极易被集成商(如HubSpot原生功能)或通用AI Agent(Claude Code + API)组合替代。评论中对其“AI”含量的质疑——Copilot生成的代码甚至不如手动筛选——暴露了其自然语言层的浅薄。
更重要且致命的是数据合规与透明性隐患。创始人承认“字段级来源未在UI展示”,这不仅是GDPR Article 14的技术债,更是触发规模化销售的定时炸弹。当客户询问“第14个供应商的模式猜测与第1个的真实匹配为何显示相同置信度”时,现有回答难以服众。若不出台自服务的字段级溯源及置信度分级导出,其高价值企业客户增长将很快触顶。概括而言:这是一款优秀的效率工具,但距离“可信赖的数据平台”,还差一个“审计功能”的距离。
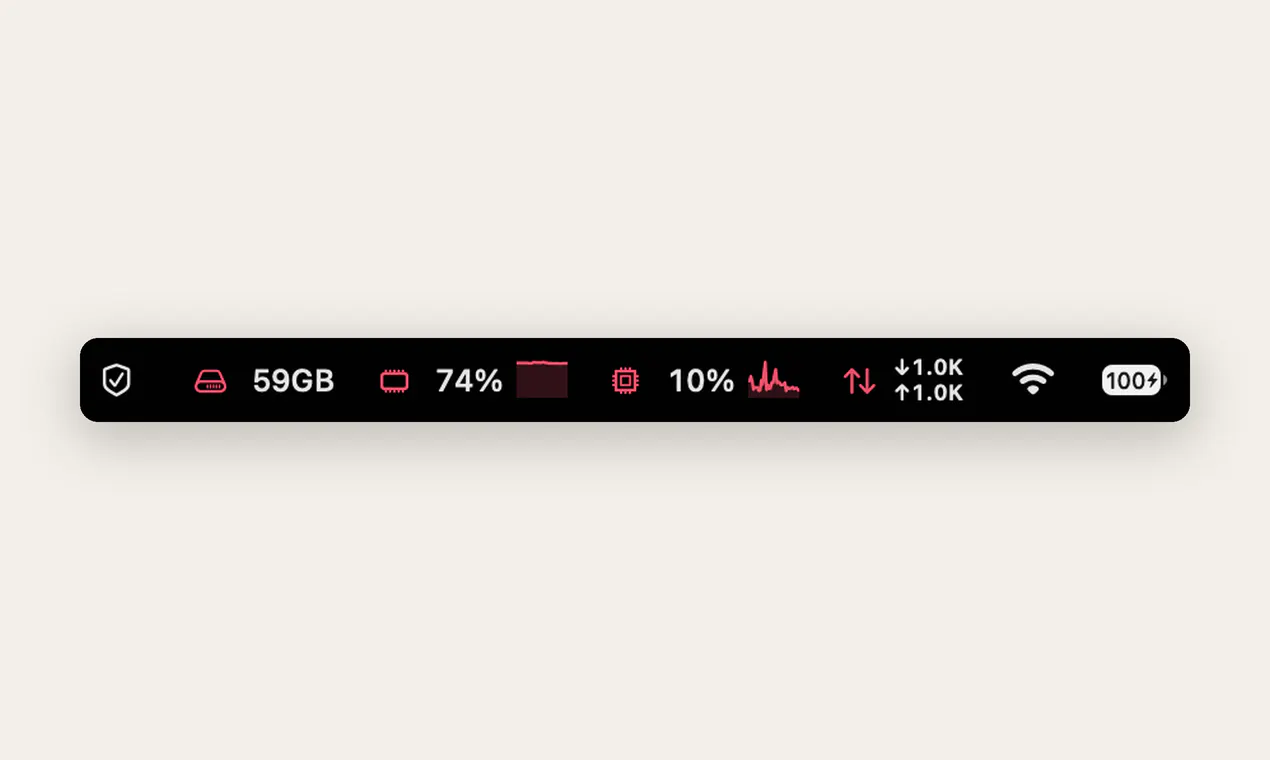
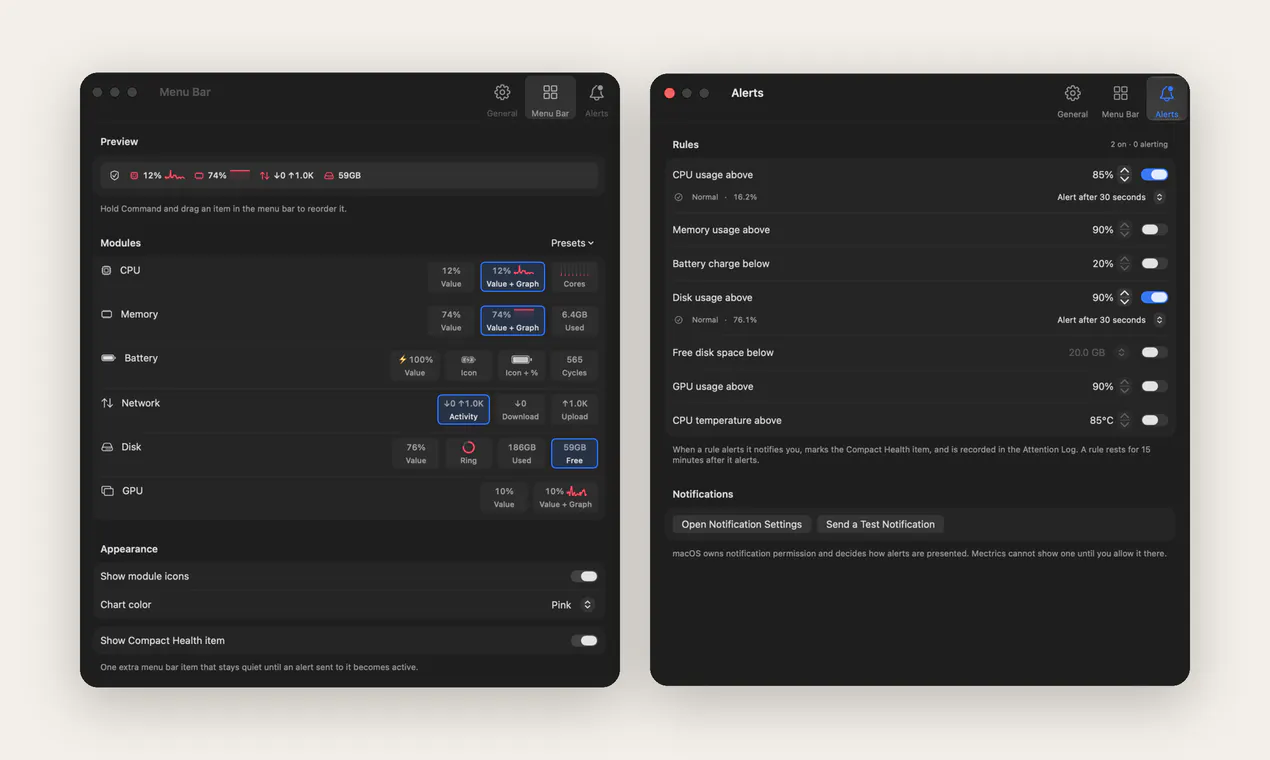
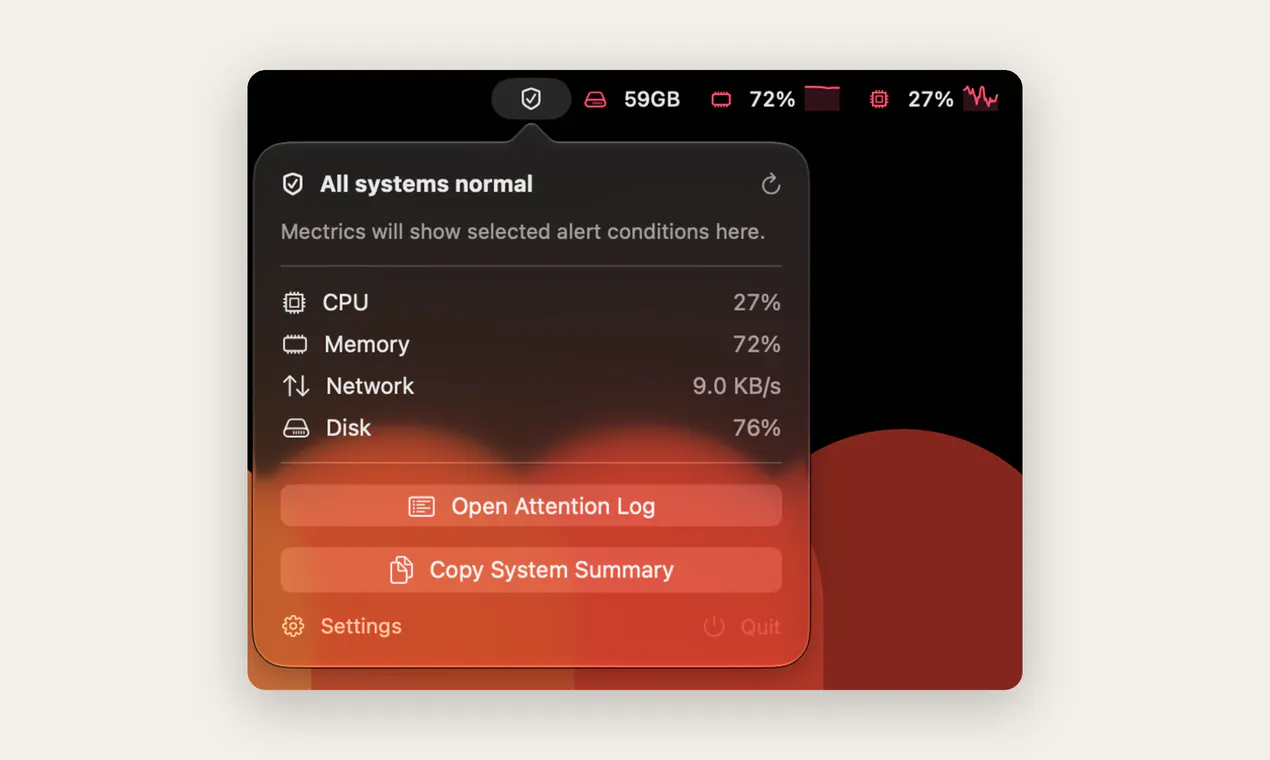
一句话介绍:mectrics 是一款免费开源的 macOS 菜单栏系统监控工具,通过“Compact Health”将 CPU、内存、电池等状态折叠为一个安静图标,只在异常持续时主动提醒,解决用户被海量实时数据淹没、对告警麻木的痛点。
Mac
Open Source
Menu Bar Apps
系统监控
菜单栏工具
开源免费
macOS
硬件状态
告警通知
隐私保护
轻量级
Compact Health
开发者工具
用户评论摘要:用户普遍认可“Compact Health”的克制告警逻辑,认为其优于 iStat Menus 的持续噪音。核心诉求集中在:① 缺少 CLI/JSON 导出,不利于无头 Mac mini 场景;② 温度/风扇模块未在菜单栏展示,且无法识别“热降频”而非单纯高温;③ 询问自身资源占用(约60-65MB);④ 对比 iStat 的优势在于免费、开源、零遥测。
AI 锐评
mectrics 的聪明之处在于它没有试图在数据广度上对抗 iStat Menus,而是用“注意力管理”重构了监控工具的体验。Compact Health 本质上是一个“沉默的大多数”逻辑——默认不打扰,只在持续异常时发声,这精准击中了老用户对传统监控工具“信息过载导致心理脱敏”的痛点。其零遥测、纯本地读取的隐私承诺,在当下一众云端监控工具中形成了清晰的价值观差异,对开发者群体有天然吸引力。
但它的短板同样明显。首先,功能深度不足:温度与风扇模块缺失,且无法区分“传感器读数高”和“系统实际降频”这两种本质不同的异常,这对跑批处理或本地 AI 负载的用户是硬伤——他们需要的不是温度波动,而是“性能被腰斩”的明确信号。其次,所有告警逻辑依赖 GUI,没有 CLI/JSON 输出,直接切断了无头 Mac mini、自动化运维等最需要“静默监控”的核心场景,这与其“轻量、安静”的定位自相矛盾。作者在回复中已承诺下个版本加入只读 CLI,方向正确,但若想真正撼动 iStat 的存量用户,还需在“热降频事件”识别、自定义规则上做更深层的系统级整合。
开源的 MIT 协议是双刃剑:它吸引了隐私敏感型用户,但长期维护的可持续性、以及社区贡献能否跟上 macOS 系统迭代,都是未知数。简而言之,mectrics 目前是一款“理念优秀、细节尚欠火候”的产品,它在正确的方向上迈出了第一步,但距离成为替代 iStat 的成熟工具,还差一个深度场景的打磨。
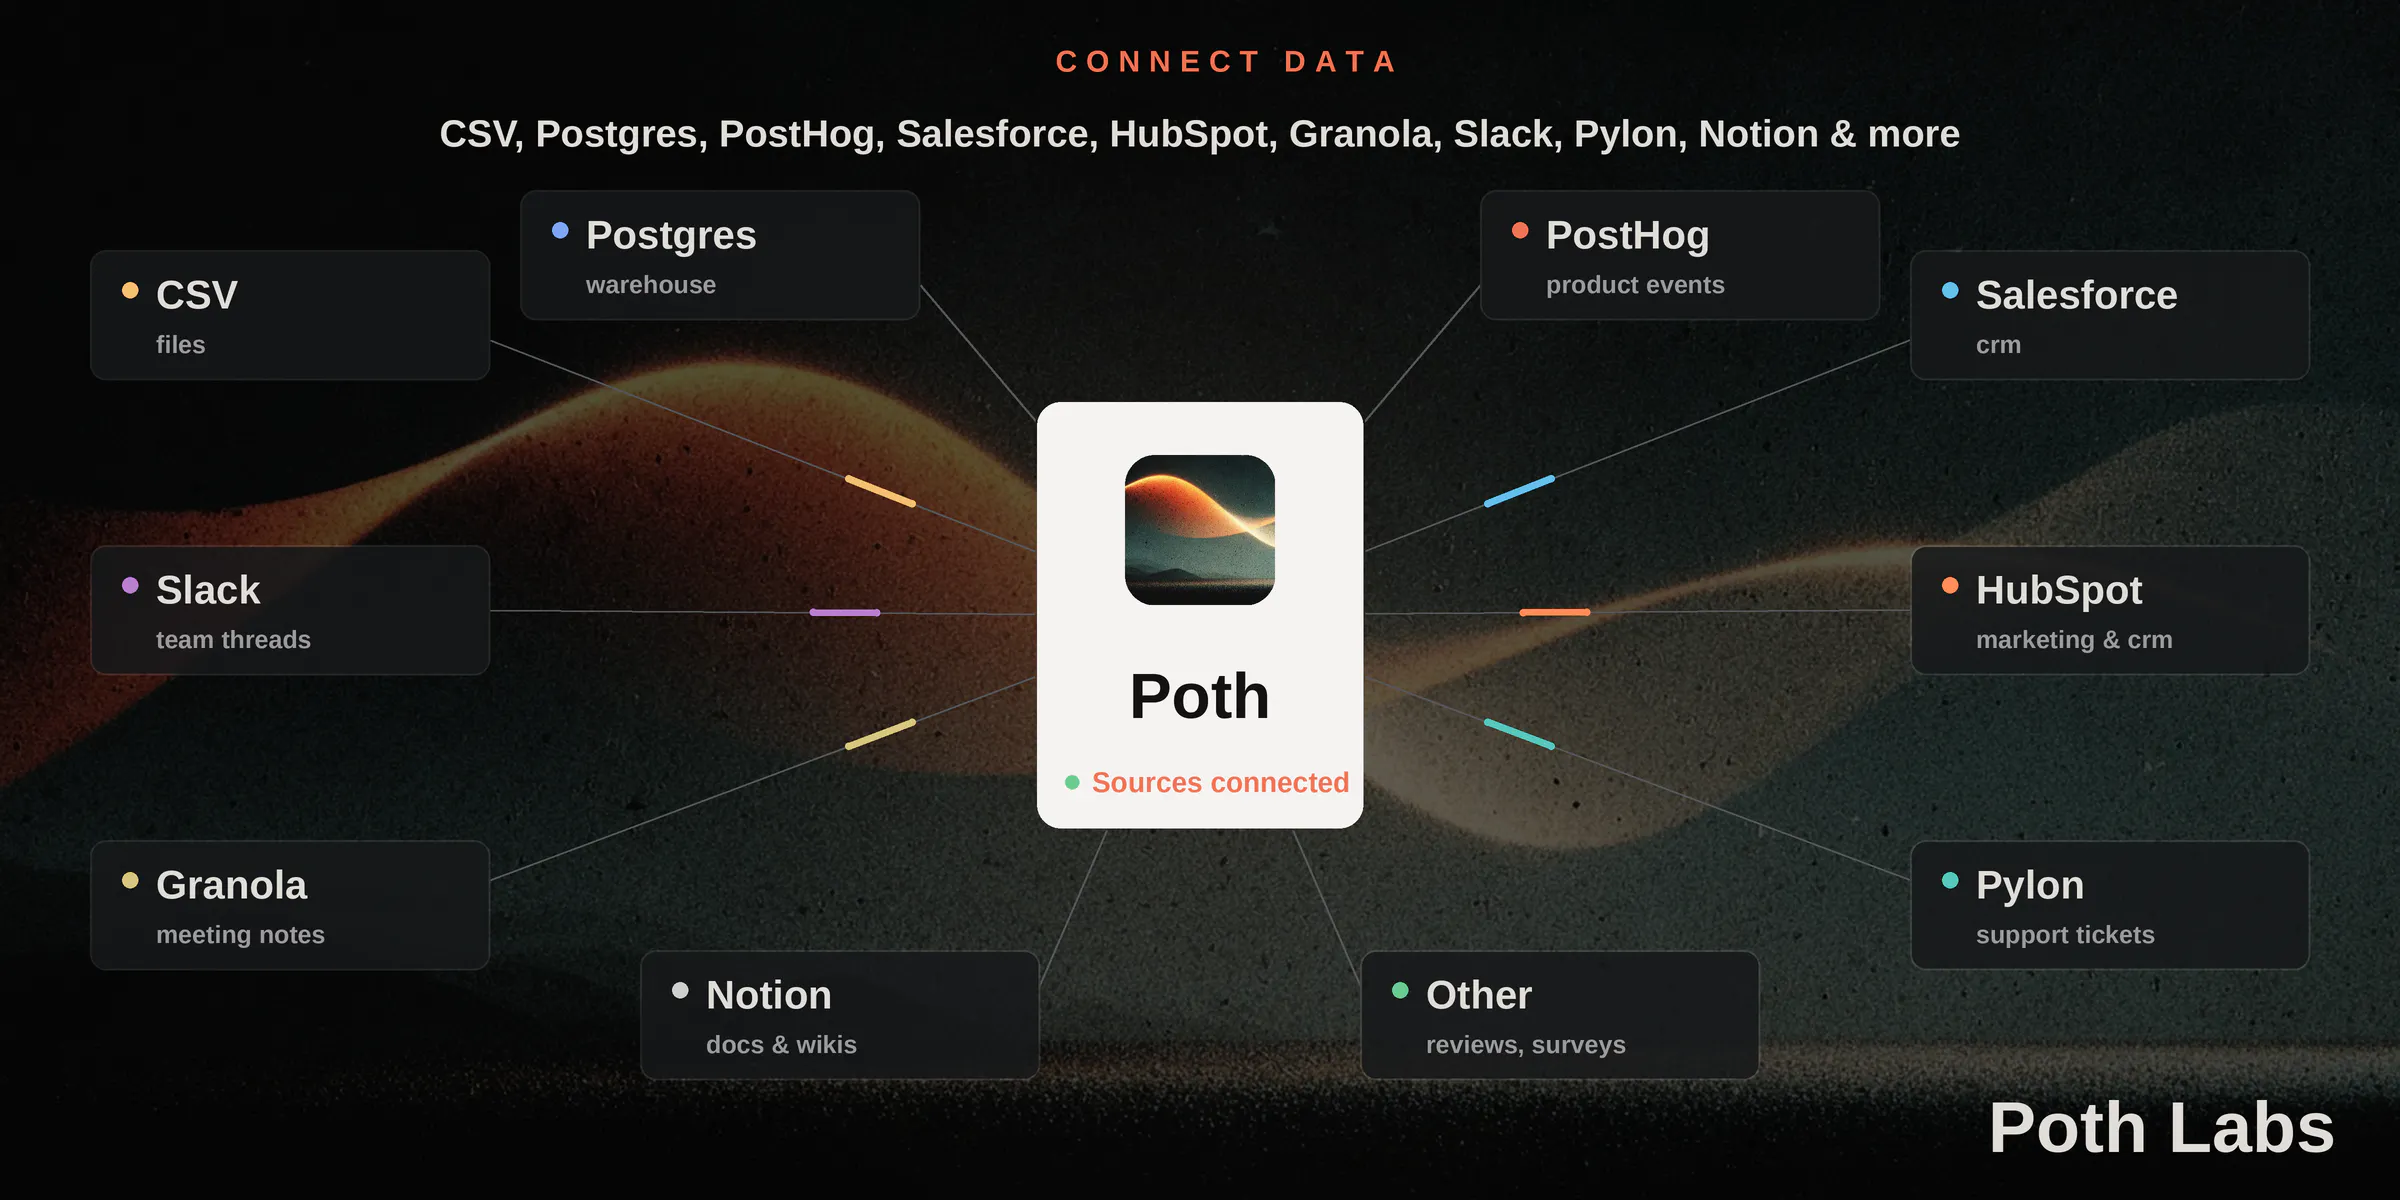
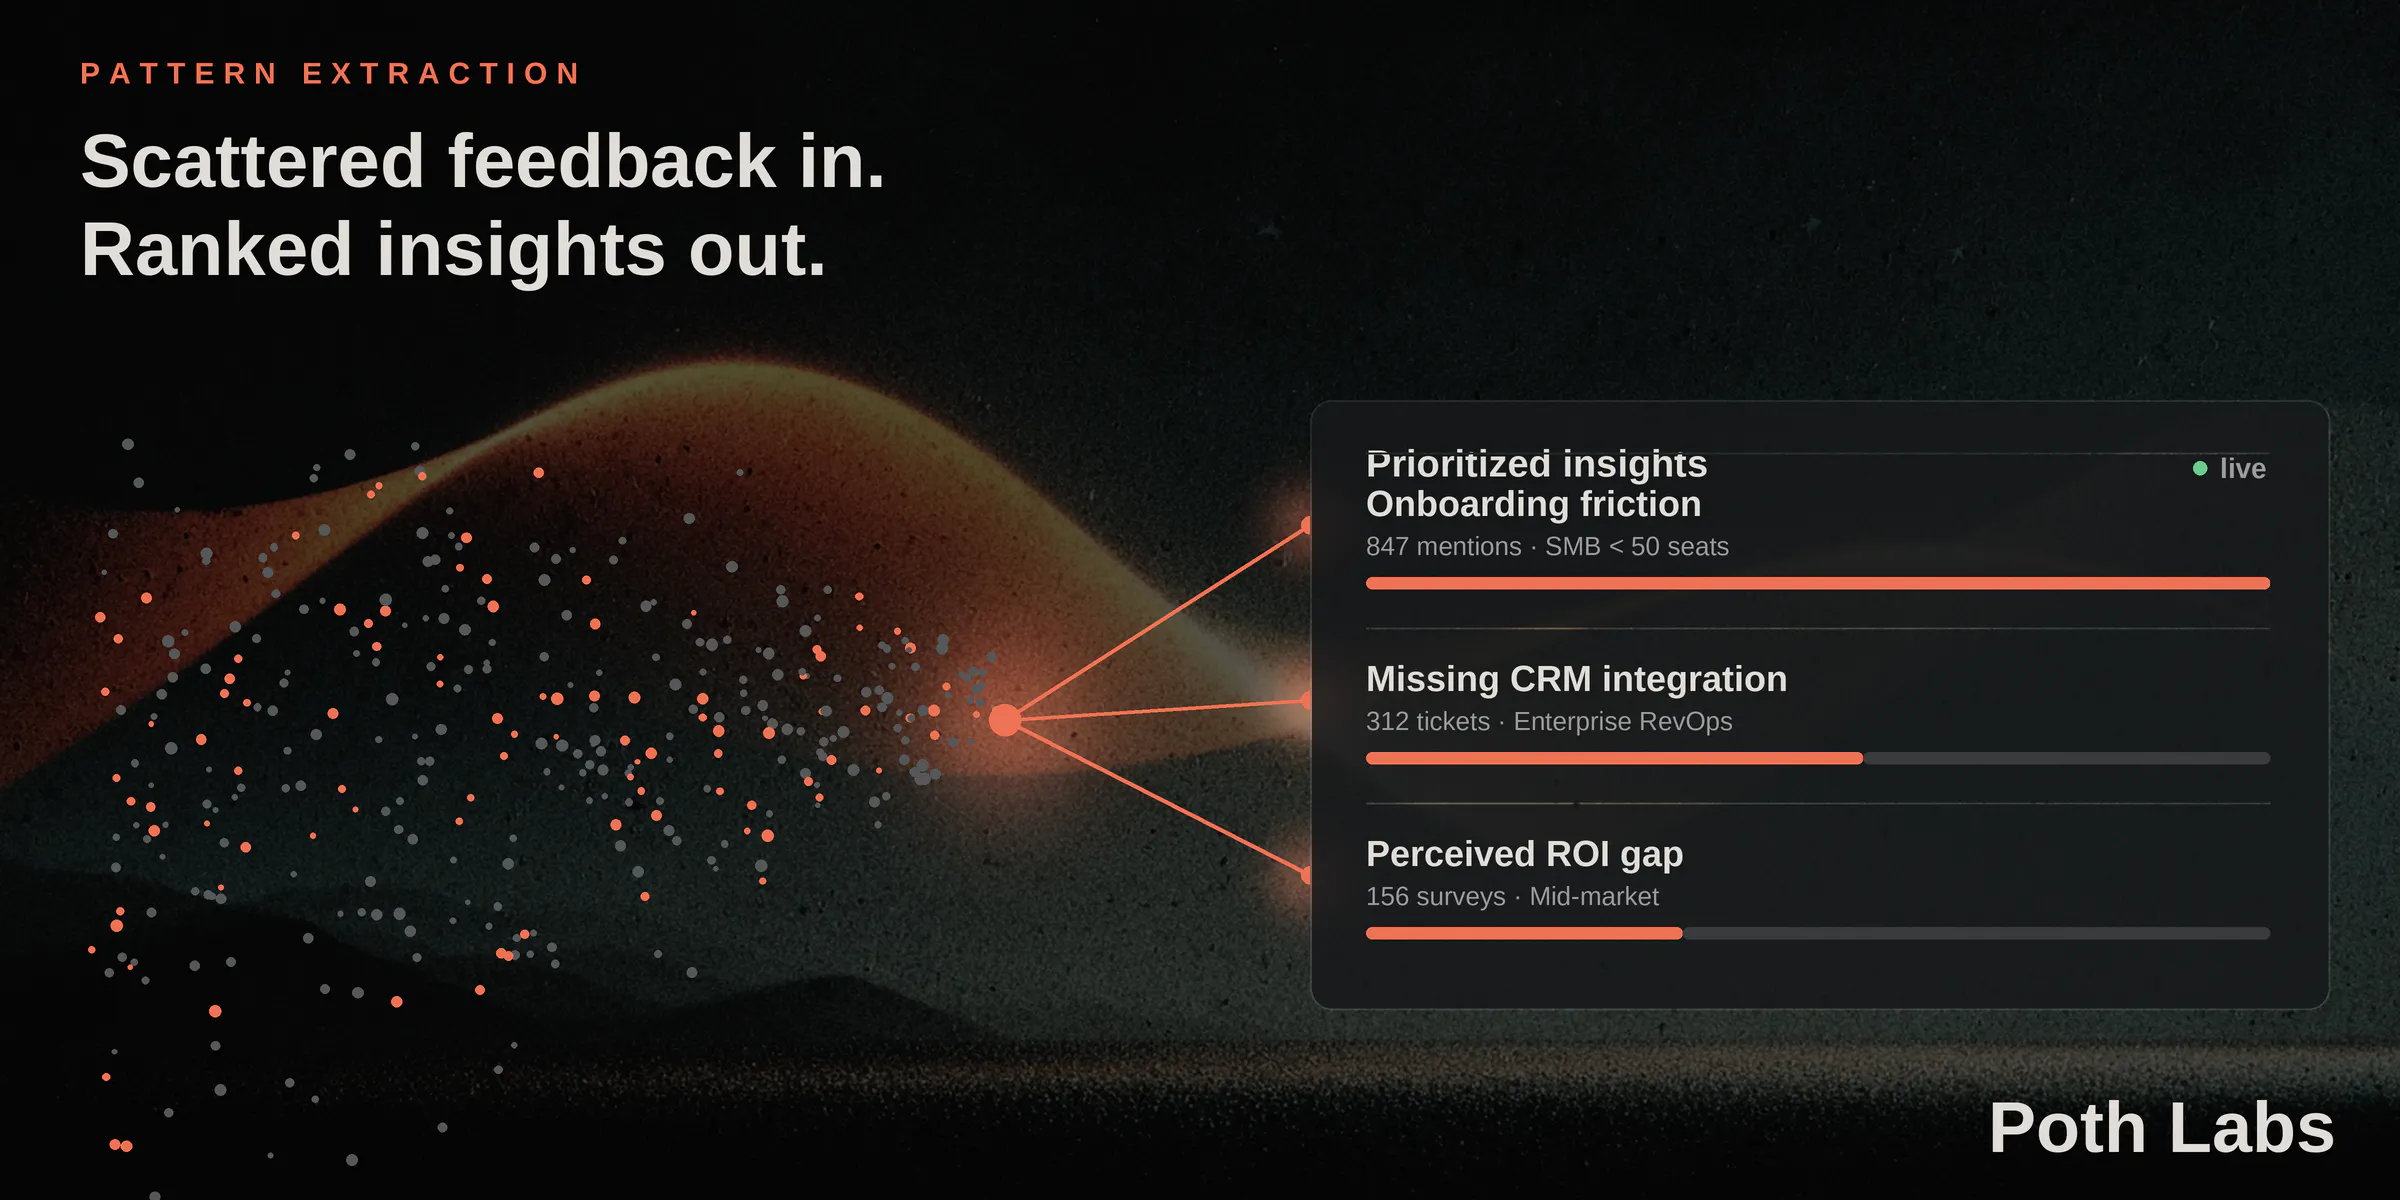
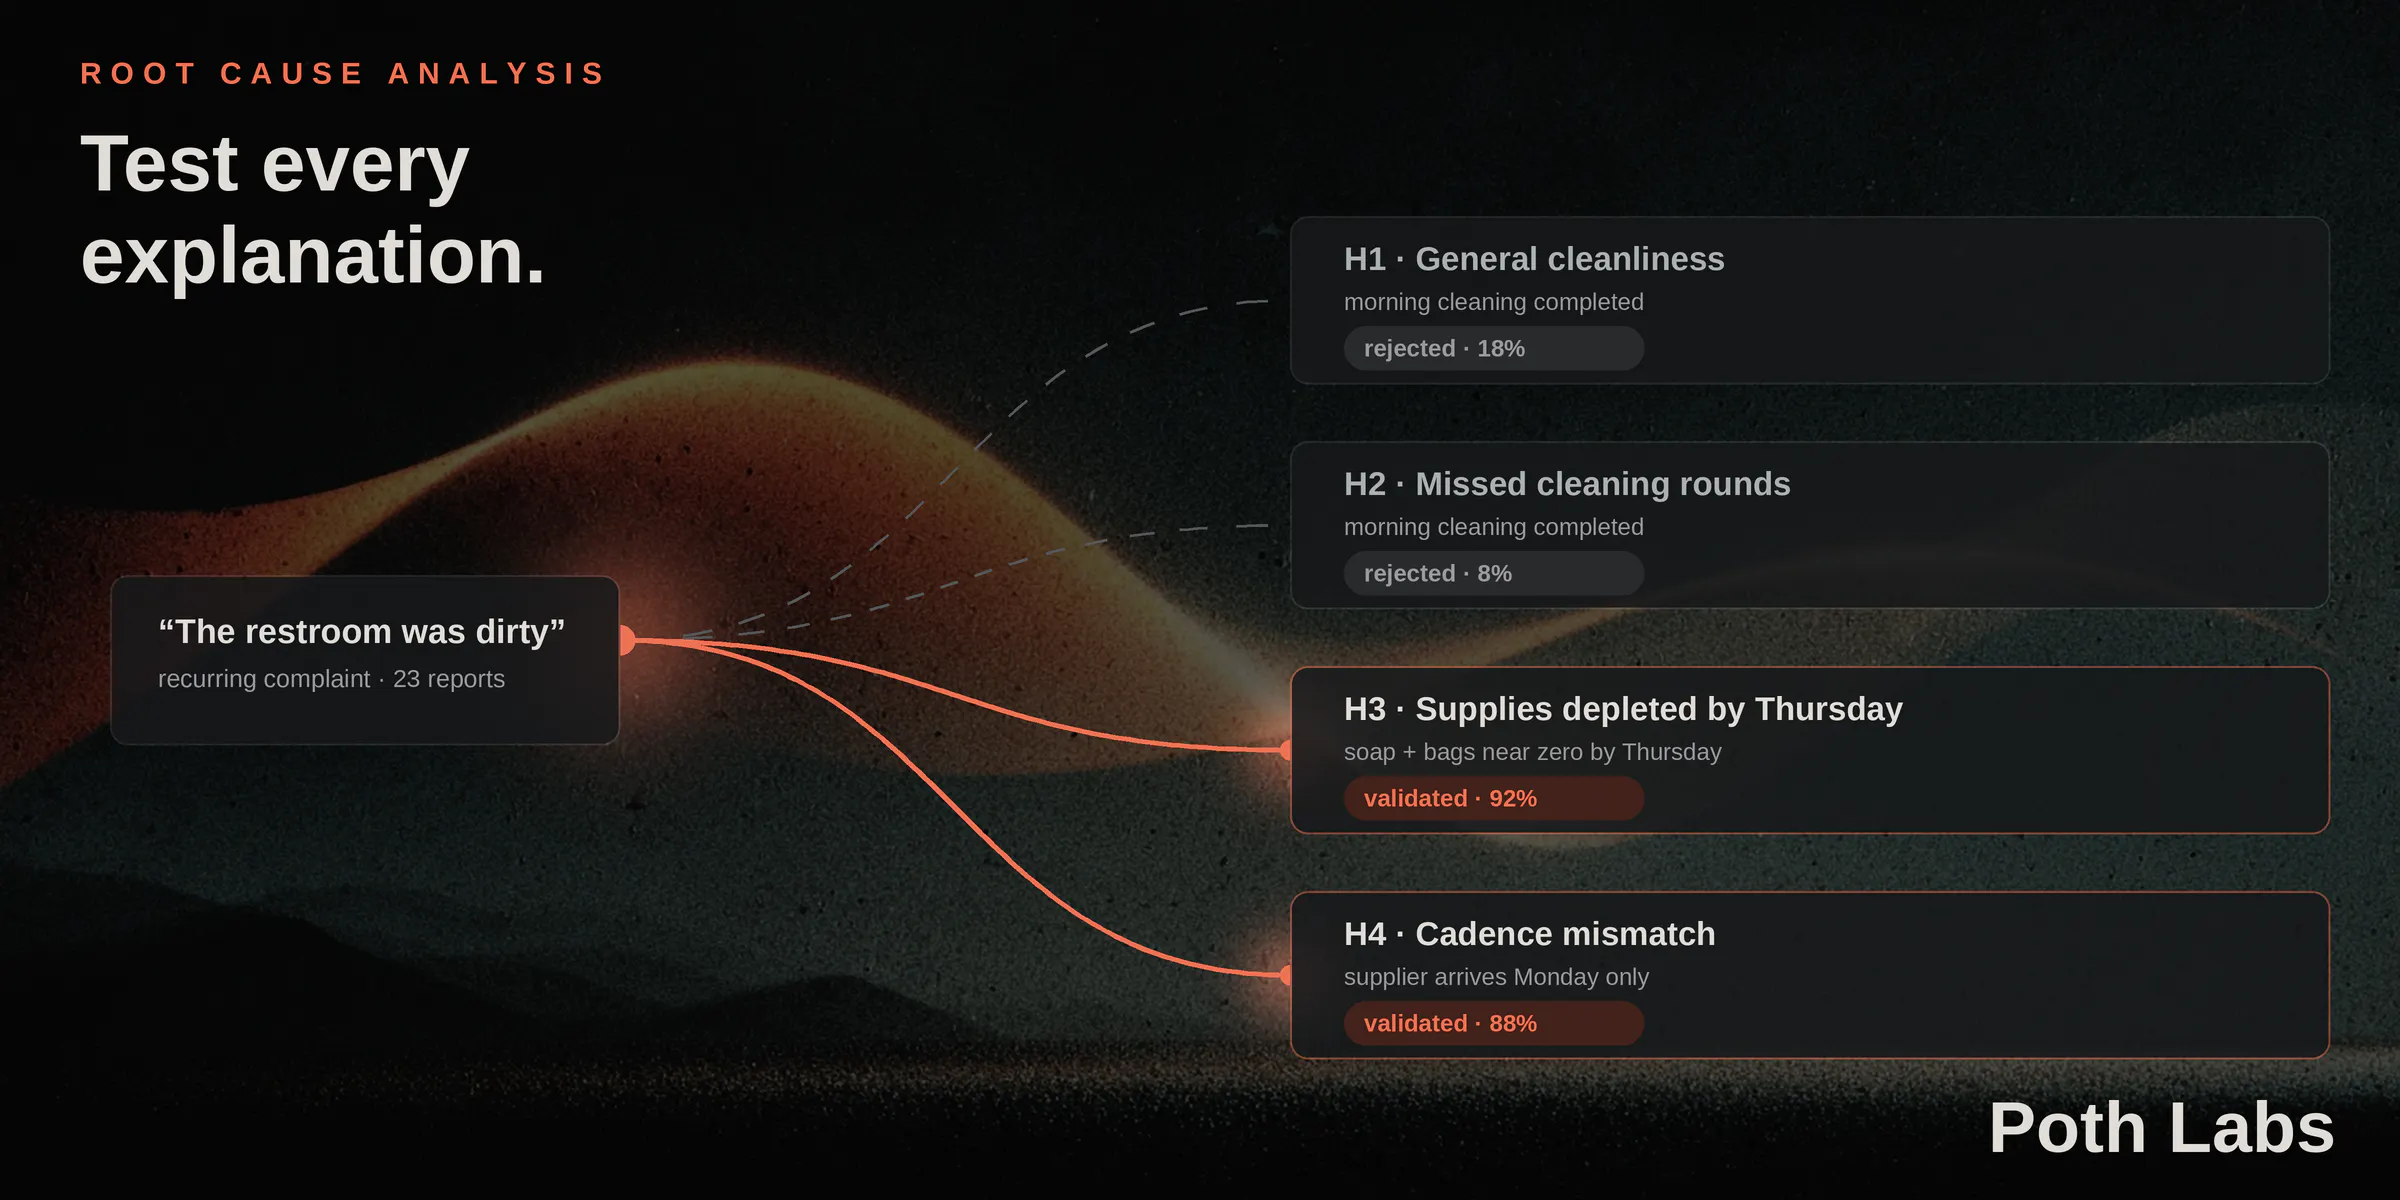
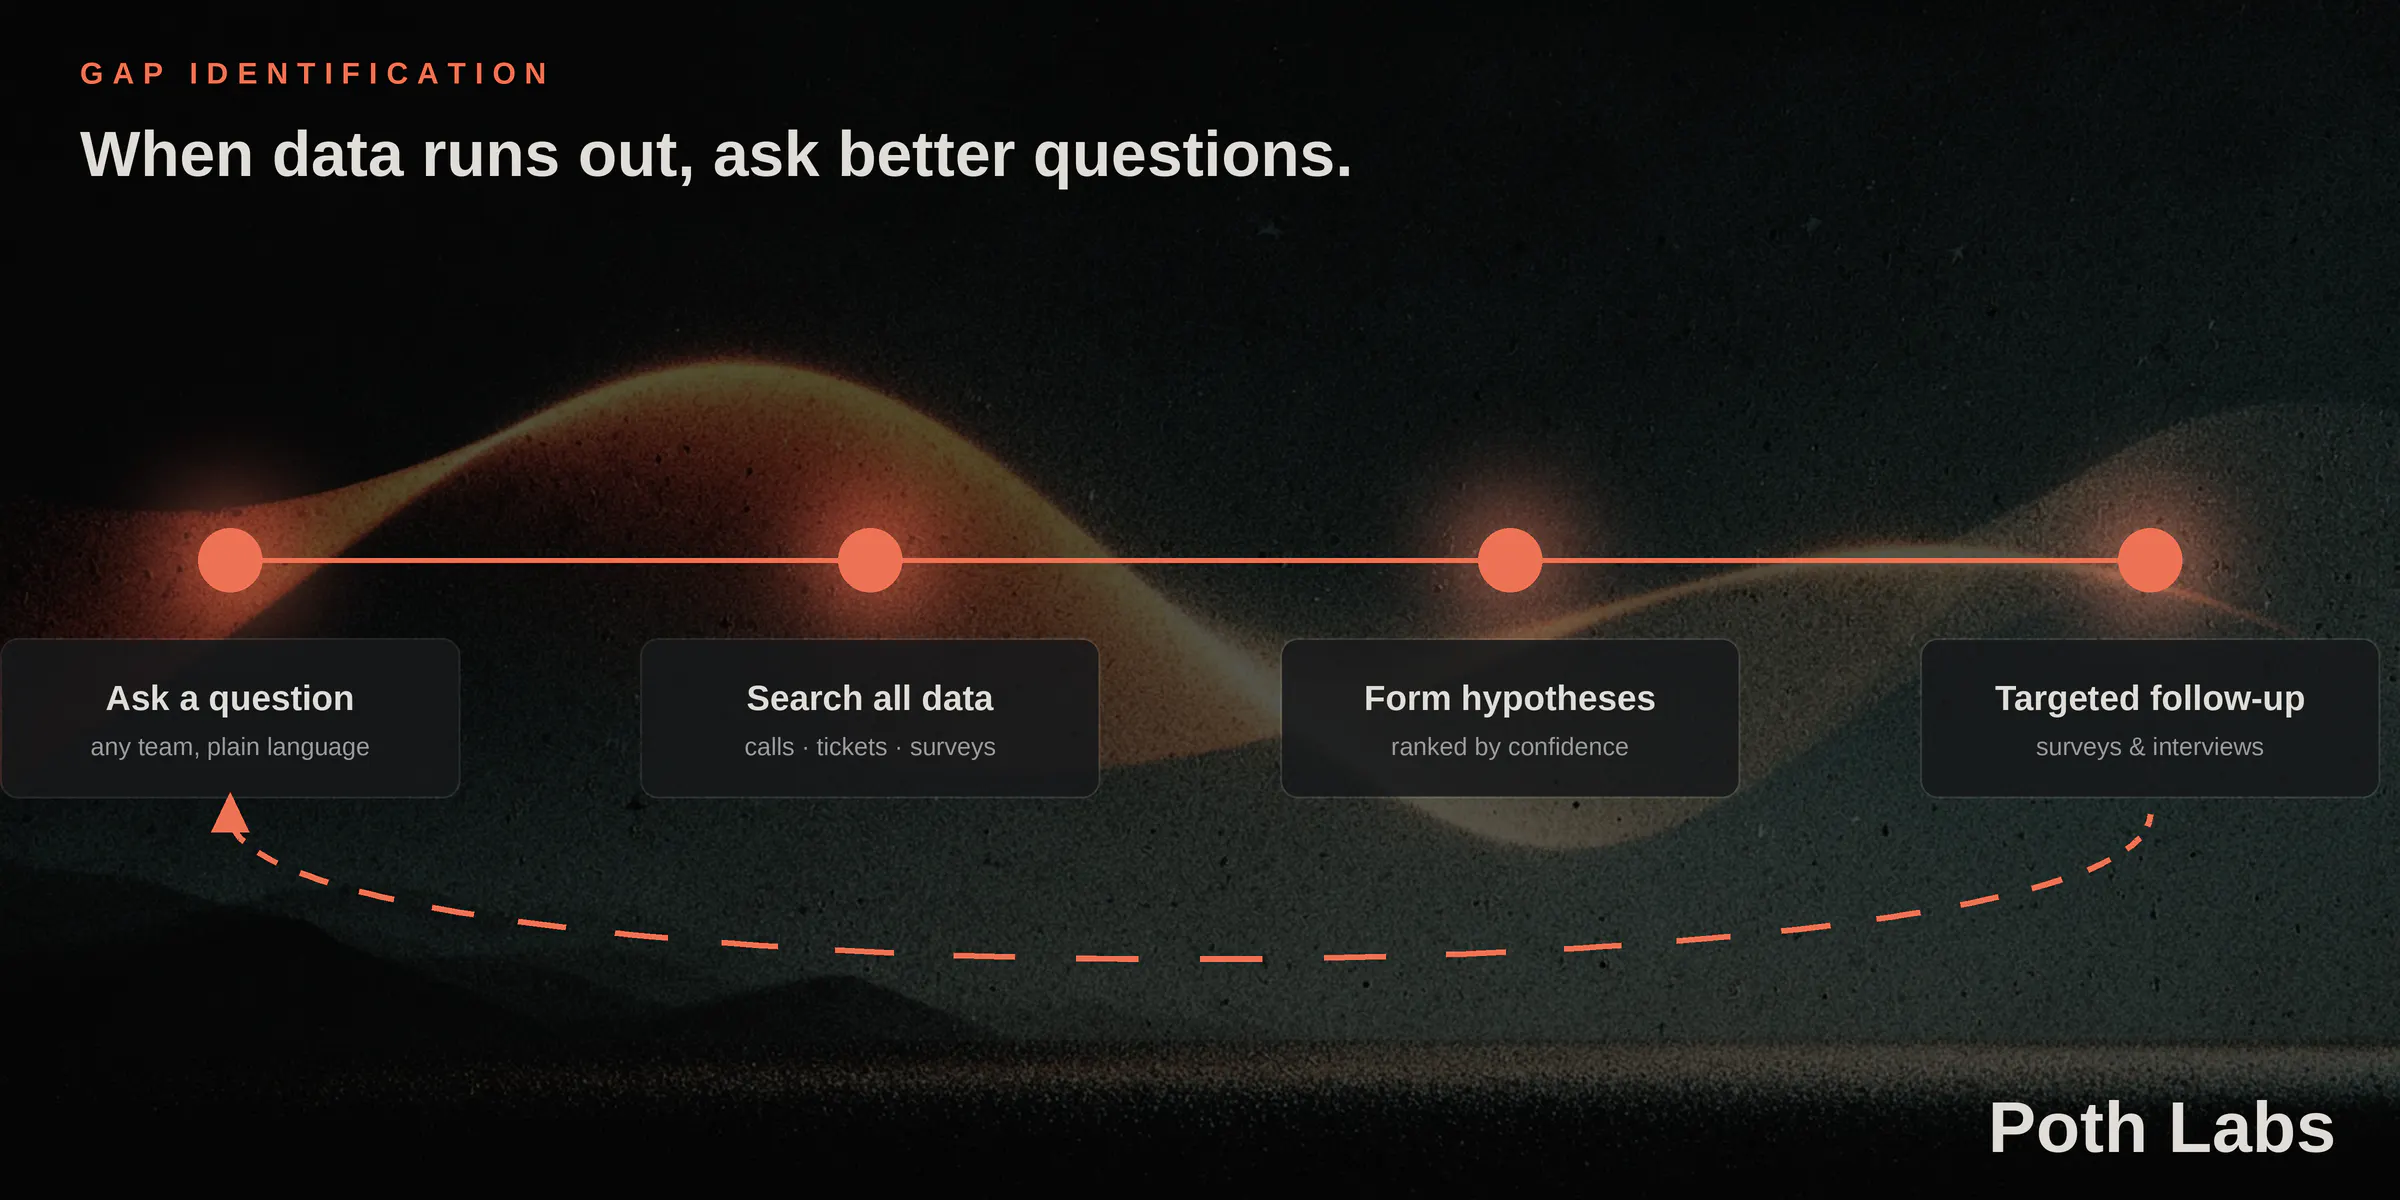
一句话介绍:Poth Labs 通过构建客户知识关系图谱,让“Ask Poth”能跨系统推理分析客户行为与业务结果,解答“高价值客户为何流失”等单一数据源无法回答的问题,并自主补缺调查。
Customer Success
Analytics
SaaS
客户知识图谱
客户智能
流失分析
行为分析
AI问答
自适应调研
B2B SaaS
数据集成
沉默信号识别
用户评论摘要:用户高度认可“关系而非文档”的理念,但集中追问:1)首日接入哪些系统及CRM与工单冲突如何处理;2)小团队最低数据源配置;3)是否支持Discord/GitHub等社区信号及其实时性;4)能否将“沉默”建模为流失前兆而非数据缺失。
AI 锐评
Poth Labs的切入点精准且刁钻——它没有试图再造一个“更聪明的CRM”,而是用知识图谱重新编排企业已有的客户数据孤岛。其核心价值并非“回答问题”,而是把“无数据”与“有数据但沉默”区分开,让“安静”不再被误读为“健康”。这直击了SaaS续约场景中最昂贵的认知盲区。
但产品面临三重考验:其一,认知负担——图谱的价值取决于数据源的丰富度与清洗质量,小团队可能陷入“连完数据却问不出好问题”的尴尬,评论中关于最低配置的追问正是此焦虑的体现;其二,信号时效性——企业知识图谱的构建容易,但维持实时同步极难,尤其是社区信号(Discord/GitHub),一旦延迟,预测性价值将大幅缩水;其三,判断权归属——当CRM与工单数据矛盾时,Poth选择“呈现矛盾而非裁决”,这在AI时代很政治正确,但也意味着它现阶段只是“高级陈列架”,而非决策引擎。
真正的护城河在于“自适应调查”闭环——用图谱暴露信息缺口,再通过AI主动向客户发问补全。这比单纯的分析仪表盘深一个维度。但若调查触发过于频繁或问题笨拙,极易消耗客户耐心,反而加速沉默。Poth需要在“主动提问”与“保持安静”之间找到危险的平衡点——这决定了它是客户的第二大脑,还是又一个制造噪音的骚扰者。短期看,它最性感的场景仍是高客单价、长周期的B2B生意,尤其是开发者工具领域,先发占据“沉默预测”心智,比追逐通用智能更稳妥。
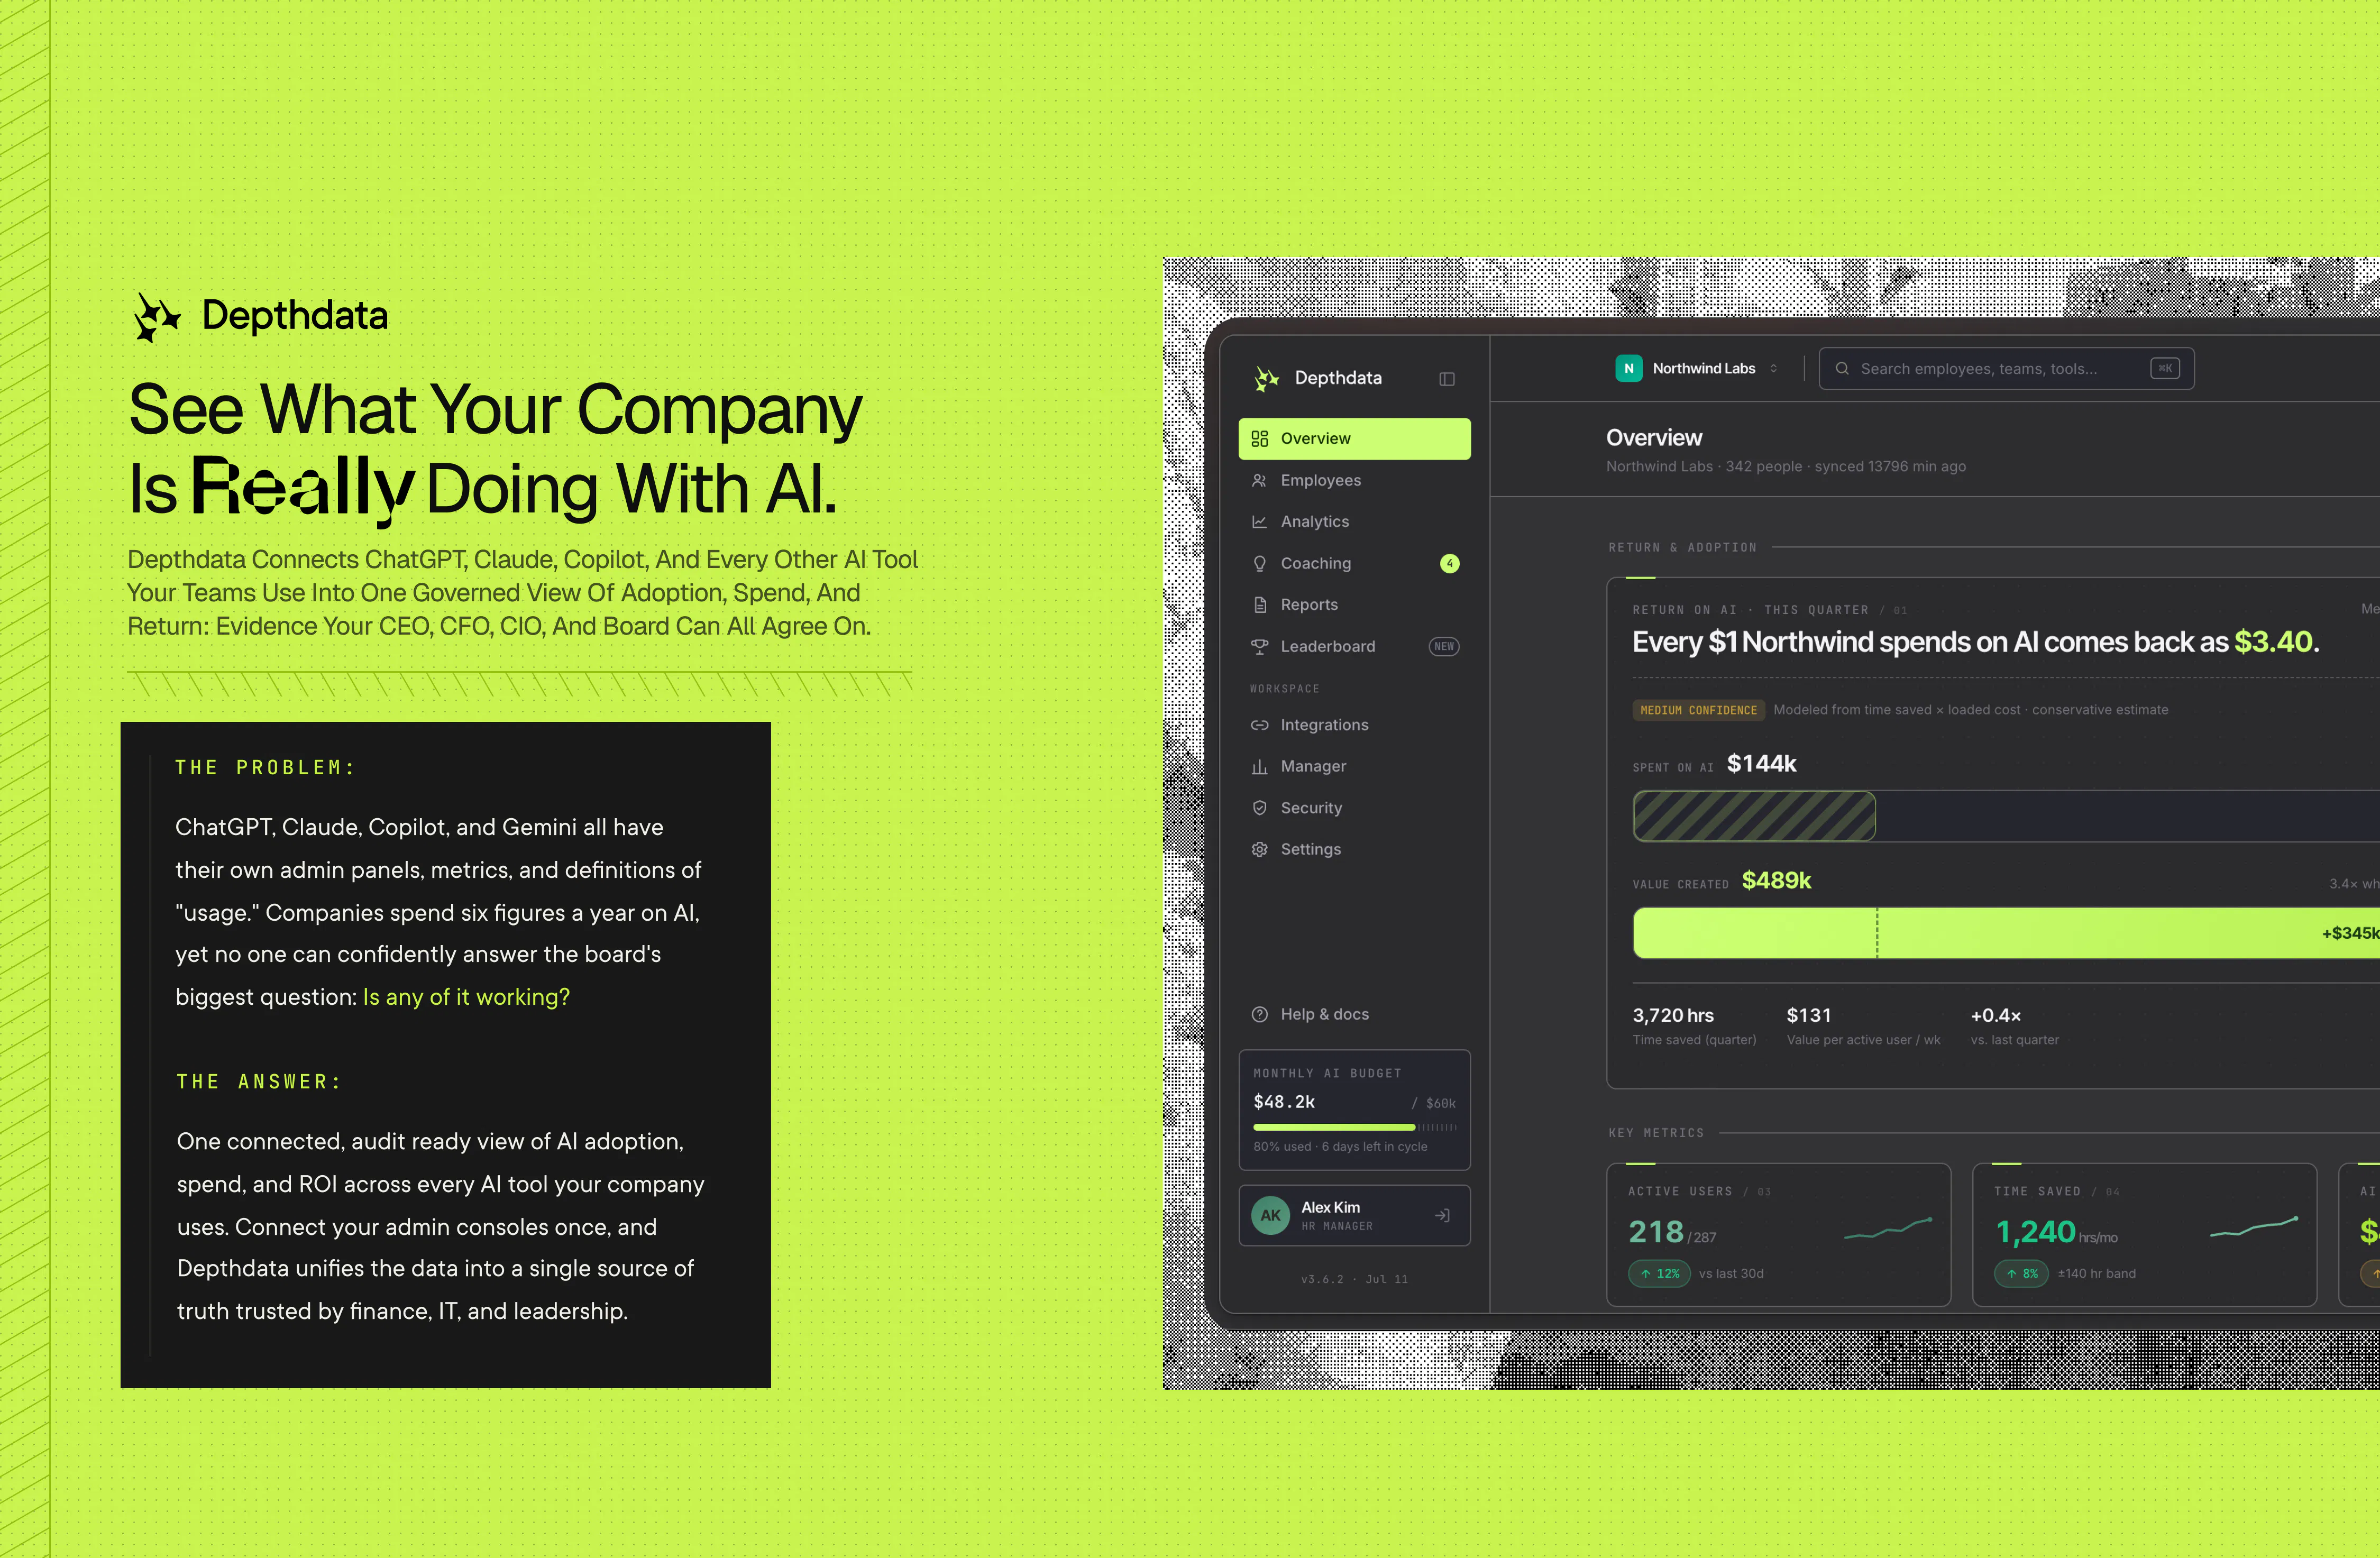
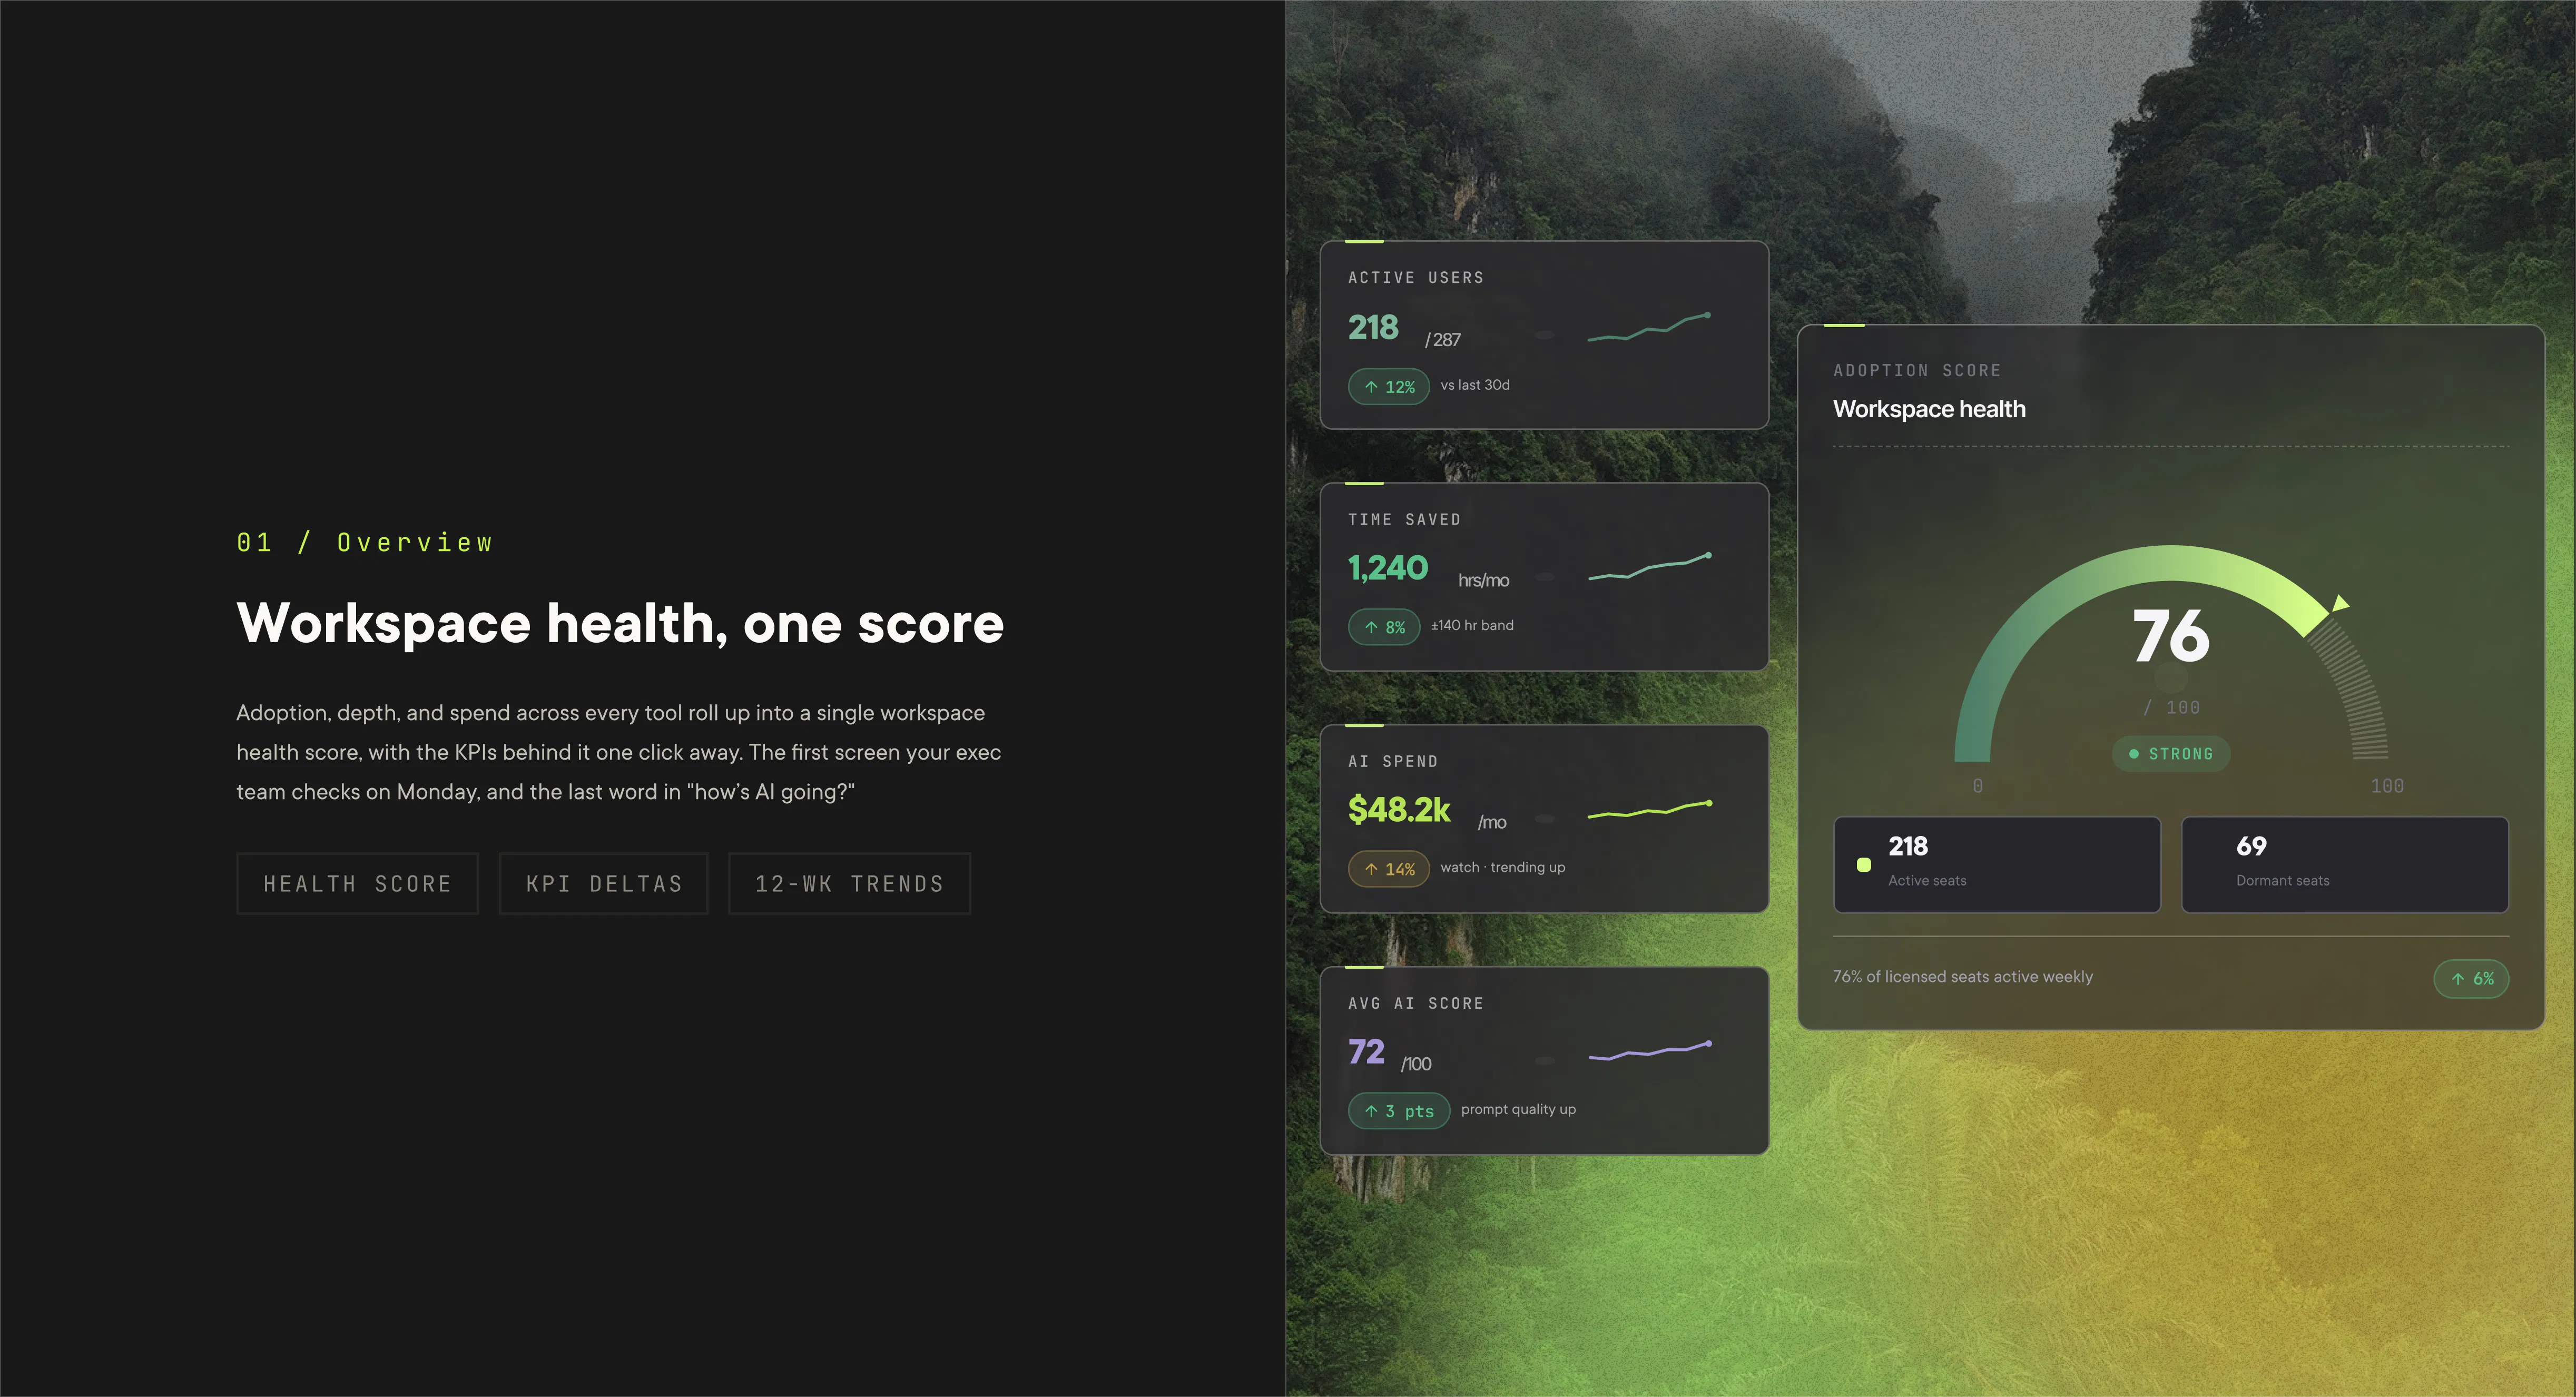
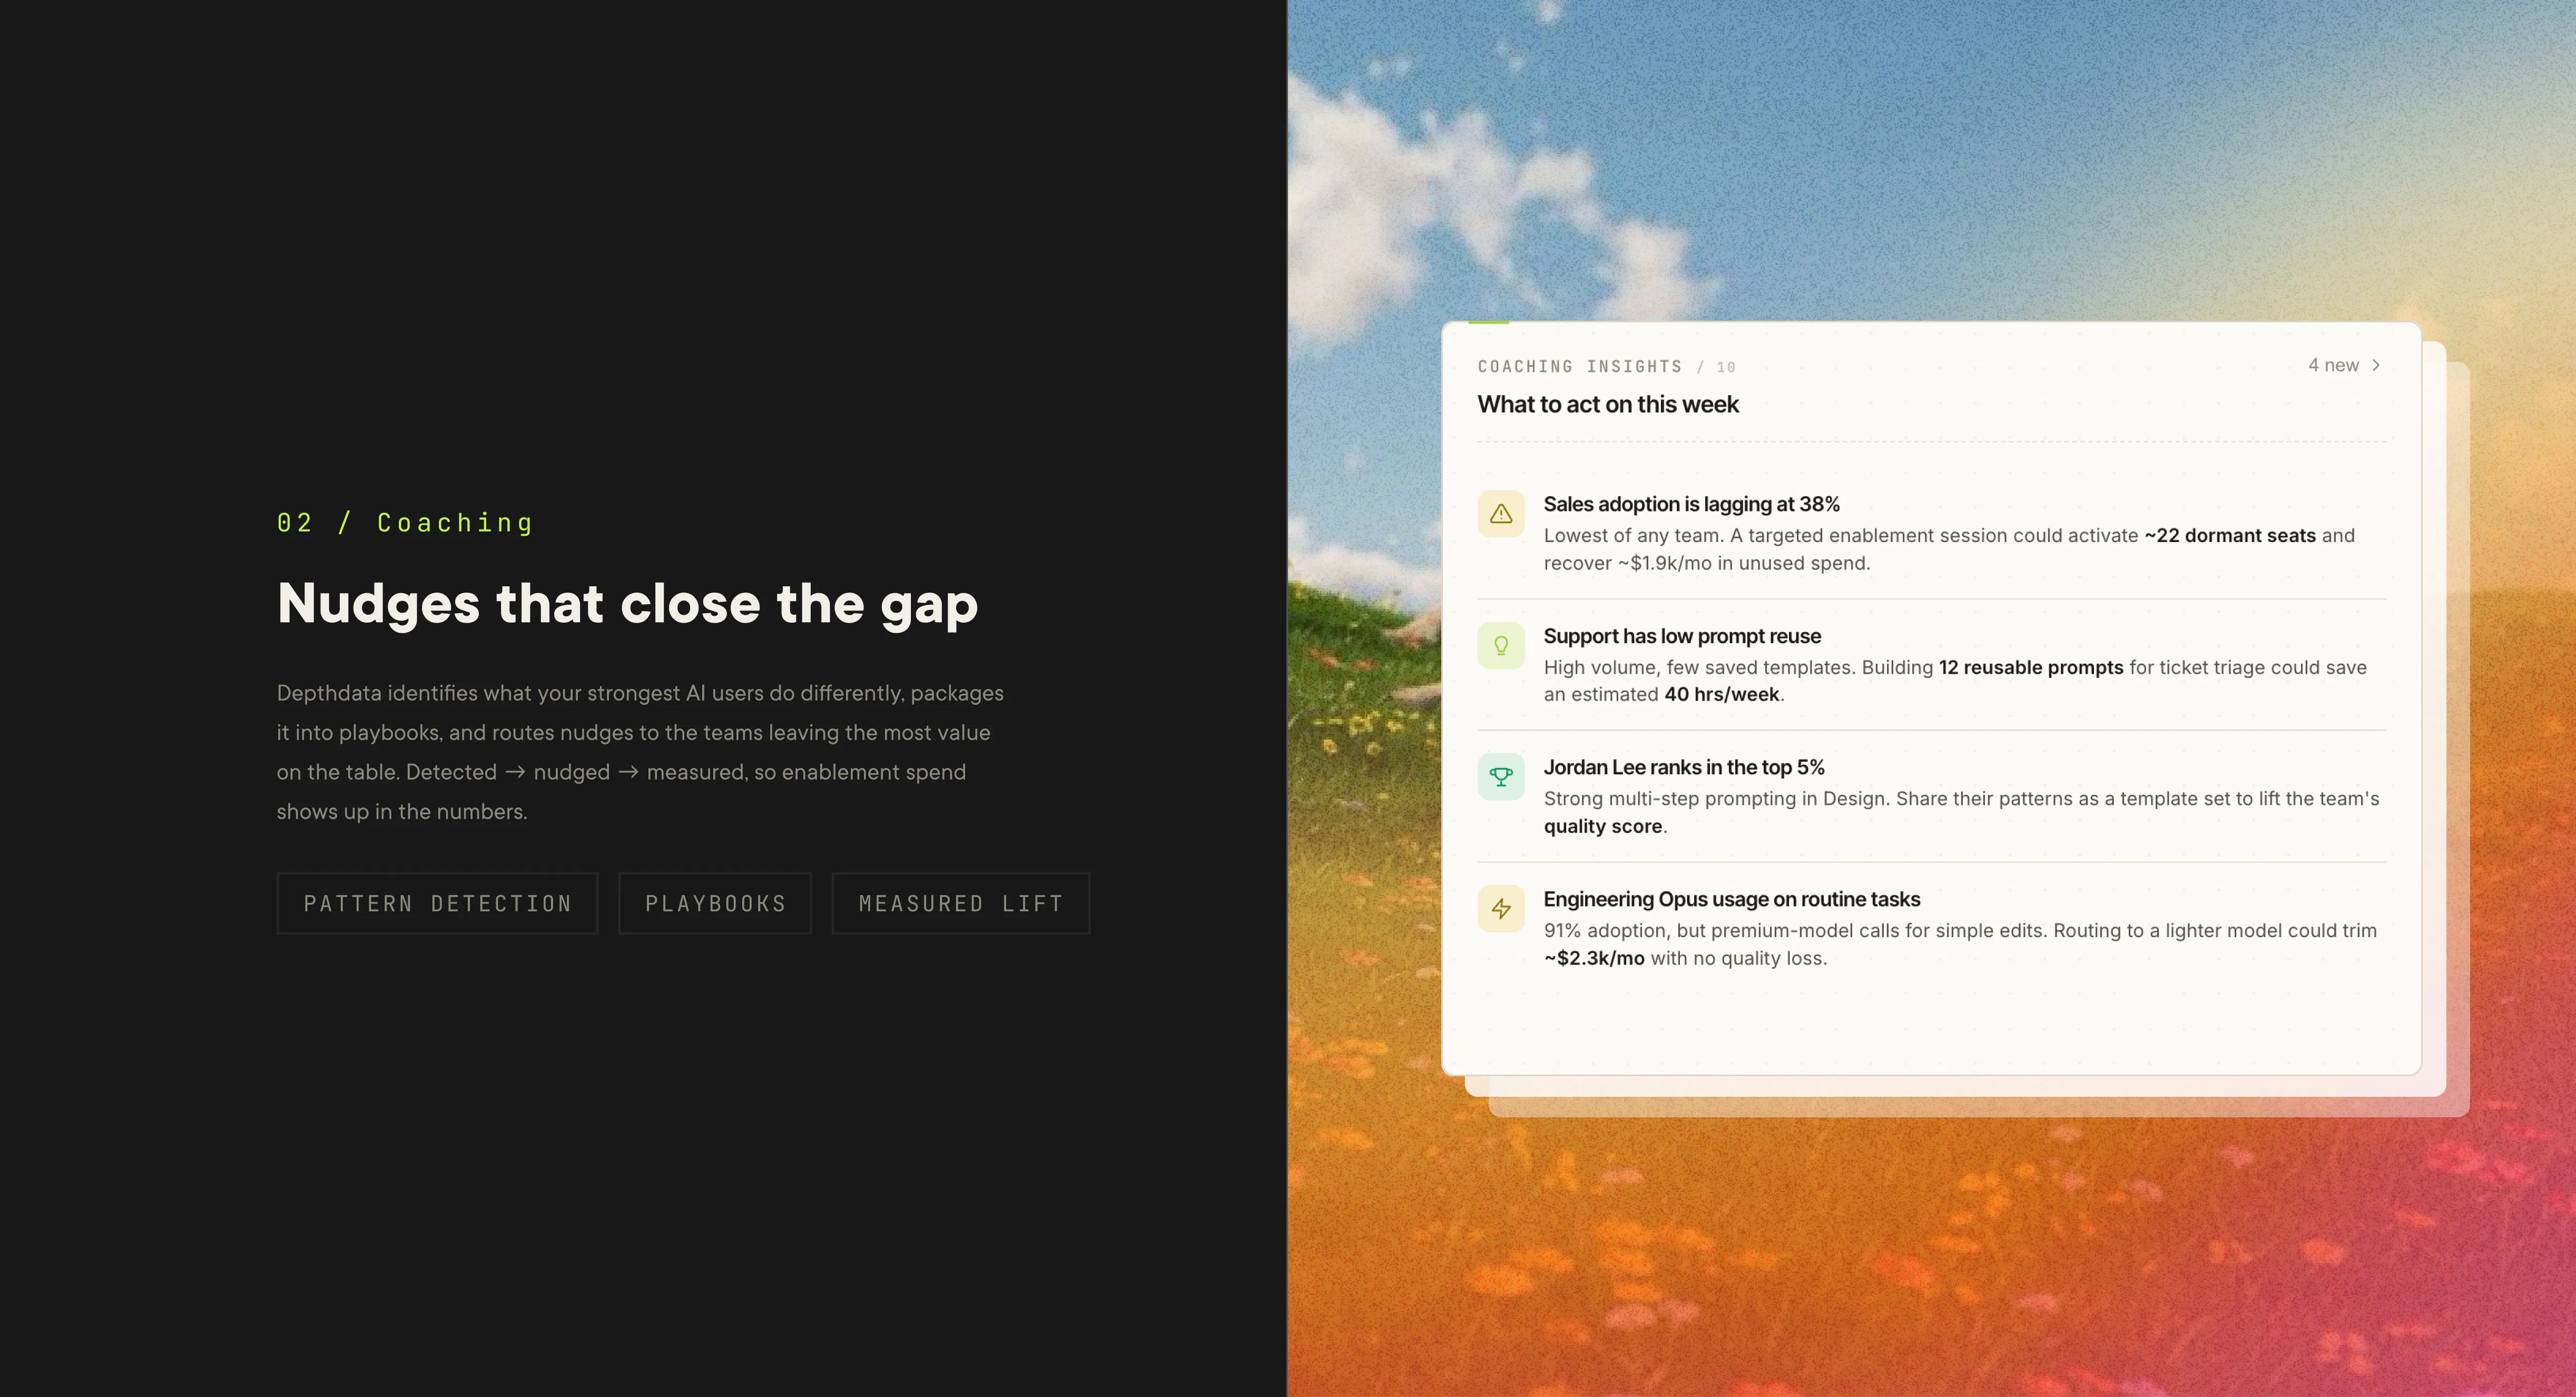
一句话介绍:DepthData 是一个企业AI支出与采用度的审计级记录系统,解决公司同时使用多个AI工具(如ChatGPT、Claude、Copilot)时,无法回答“花了多少钱、谁在用、哪些席位闲置”这一基本管理盲区,无需读取提示词、仅基于API元数据即可生成可验证的支出总览。
Analytics
SaaS
Artificial Intelligence
AI支出管理
SaaS管理
成本优化
IT治理
审计合规
使用分析
席位管理
API集成
财务运营
企业软件
用户评论摘要:用户核心关注点集中在:数据验证层级(测得/分配标签)、API权限边界(是否读取提示词)、影子AI支出(个人订阅报销)、跨工具重叠检测(同一用户双席位)、按用量计价的单人高额消费(席位视图失真)、通过SSO/IdP交叉验证使用真实性。创始人回应称,对API不可见数据明确显示为“缺口”而非估算,并支持按人员成本与重叠成本归因,但判断由用户自行决定。
AI 锐评
DepthData切入的是一个真实且迅速恶化的企业痛点:AI采购从“单一工具试点”变成了“部门各自为战的多工具混战”,而财务与IT部门仍在用Excel和猜测进行管理。其核心价值不在于“又一个可视化仪表盘”,而在于确立了“证据层级”这一信任机制——每一个数字都标注为MEASURED(从API直接测得)或ALLOCATED(分配/推断),并诚实显示API无法覆盖的“数据缺口”而非填充估算值。这一设计直击企业软件采购中“审计恐惧”的命门:当老板追问数字来源时,销售方拿出的往往是“看起来精确”的模型假设,而DepthData选择在架构层面拒绝造假,这恰好是CFO和CISO最看重的稀缺品质。
然而,产品面临两个结构性挑战。第一,AI工具生态本身的API开放度参差不齐,Anthropic、OpenAI、Cursor提供较细粒度用量数据,但Gemini捆绑在Workspace中、Replit聚合credits、Vercel依赖用户打标签,这种碎片化意味着DepthData的“可信数据”视图天然带有大量空洞。虽然以“显示缺口”而非“估算”处理在道德上正确,但商业上可能削弱实用性——采购方最终仍需全口径数字,缺口过多会降低使用意愿。第二,评论中反复出现的“影子AI支出”(员工用个人订阅额度报销)无法从供应商API获取,只能通过对接费用系统解决,而那是另一个产品类别的战场。创始人对此的回应——“显示缺口而非猜测”——虽然诚实,但可能让产品在“完整记录”这一核心主张上打折扣。
从产品策略看,DepthData的“验证标签”是绝佳的设计锚点,既建立了专业信任,又制造了与竞品(如Zylo、Productiv)的差异化。但真正的护城河可能不在“展示开销”,而在“归因到人”——评论中一位用户指出“名字旁边有数字比总金额更能改变行为”,这暗示其最终形态应成为企业内AI资源治理的“问责工具”,而非单纯的费用报表。若下一步能打通SSO/IdP登录数据(Okta、Entra)进行交叉验证,并支持从费用系统导入个人报销数据将影子支出显性化,产品将补齐“审计闭环”。否则,它可能止步于“大型企业的IT治理专员”这一相对狭窄的市场,而无法触及更普遍的“AI支出失控”焦虑。产品验证了需求,但仍需证明自己能否覆盖数据的暗面。
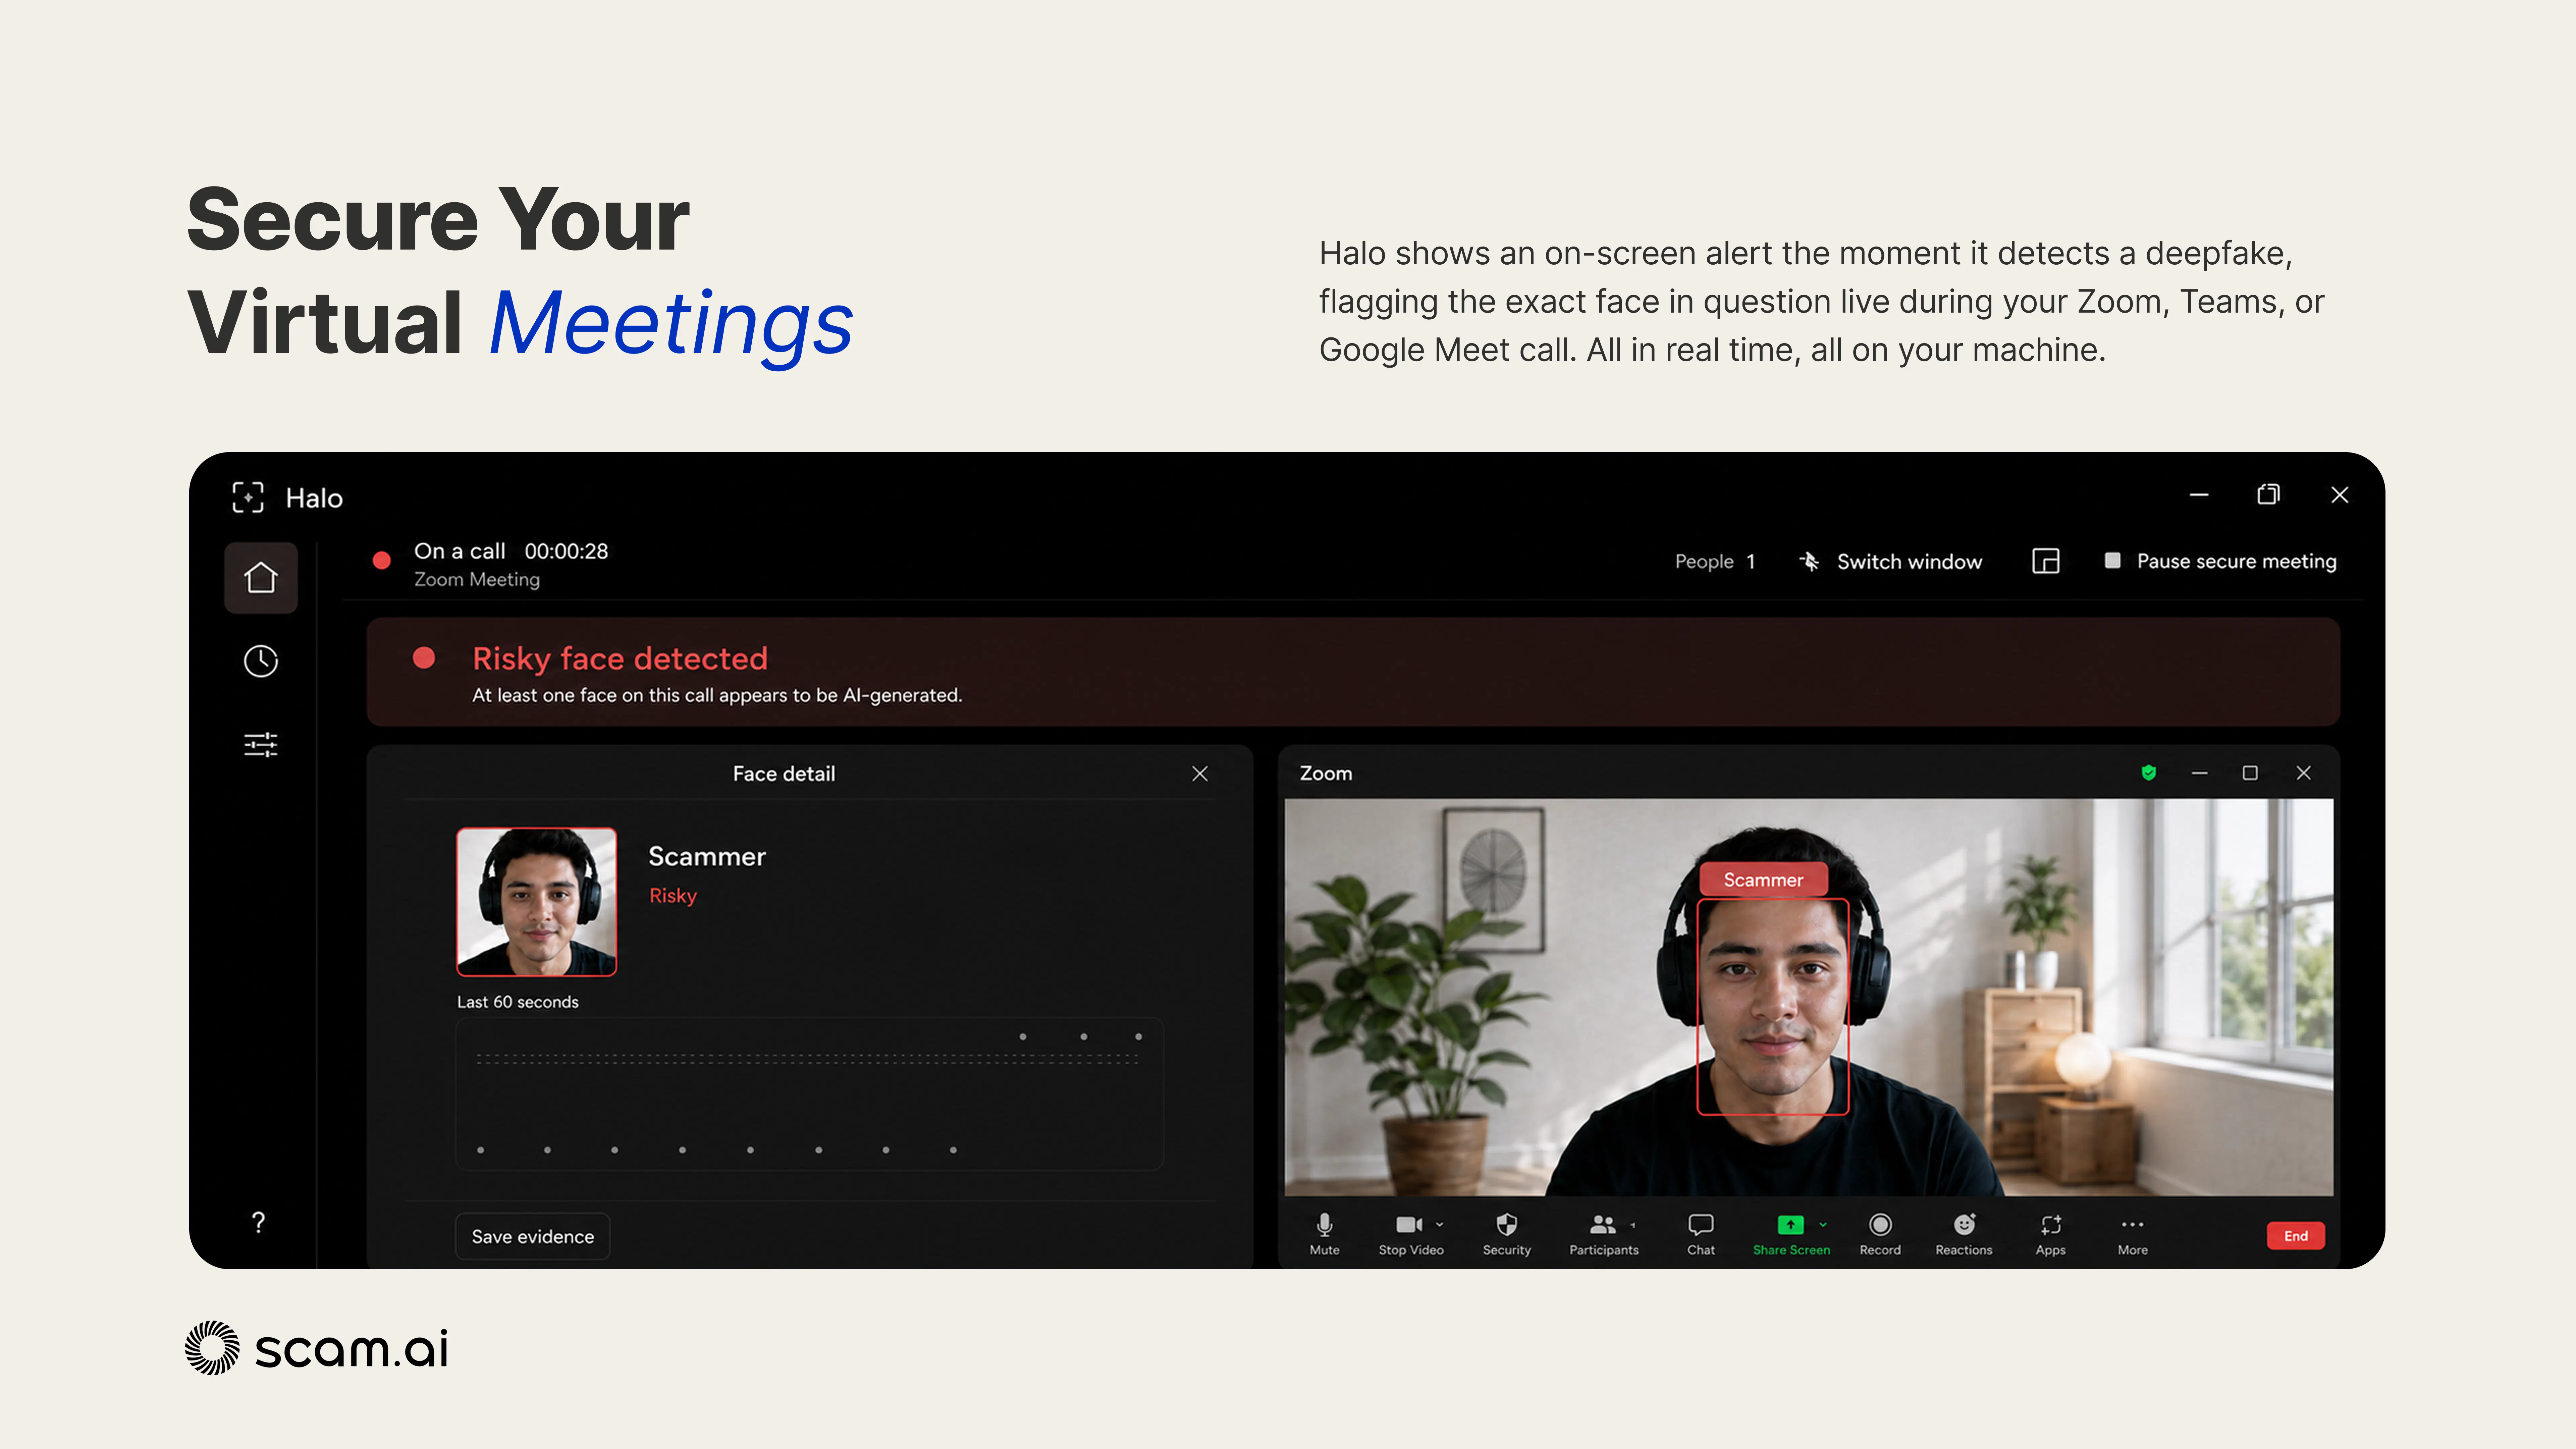
一句话介绍:Halo是一款实时运行于设备本地、为Zoom/Teams/Google Meet等视频会议提供深度伪造人脸检测的AI安全工具,在通话进行中即时标记合成面孔,解决“屏幕对面的人是否真实”这一关键信任痛点。
Meetings
Artificial Intelligence
Security
深度伪造检测
视频会议安全
实时AI防护
端侧推理
反欺诈
身份验证
金融安全
隐私保护
企业风控
防骗工具
用户评论摘要:用户高度认可“实时检测”而非事后分析的价值,称赞端侧部署带来的隐私优势。核心追问集中在:技术实现路径(WGC抓取窗口)、对新生成模型的更新策略(agentic系统+重训练)、误报控制机制(画质过滤+置信度阈值)。有深度评论指出检测生成物是“注定失败的竞赛”,建议转向“认证身份比对”而非“识别合成”;另有用户担忧产品会改变用户警惕行为,导致假阴性代价更高,并质疑其能否作为财务流程的可依赖控制项。
AI 锐评
Halo的产品叙事很聪明——用一个“电汇2500万美元”的极端案例激活恐惧,再用“纯端侧、实时、不录音”三重卖点包装技术方案。但这恰恰是最值得警惕的地方:它把“检测合成”包装成了“验证真实”,两者之间存在本质断层。
评论中那位匿名用户的质疑击中要害:基于生成物特征的检测器是天然衰减的资产。生成端(如扩散模型、GAN变体)迭代速度以周计,且无需任何许可即可发布;而端侧模型受制于应用商店审核和用户更新习惯,仅靠“web爬虫+定期微调”的agentic系统根本无法弥合这个时间差。你永远在追着对手的上一代产品跑。
更深层的问题在于产品对用户行为的反噬。当用户信赖“没有警告=安全”时,Halo实际上把原有的怀疑机制给替代掉了。一次假阴性(漏检)在部署后的破坏力远大于部署前——因为屏幕上的绿色状态本身就是一种社会工程。评论者精准地指出:产品应该永远不显示“此人真实”,只输出“有风险”或“信息不足”,但这会严重削弱商业价值,所以厂商大概率不会这么做。
因此Halo的真实定位与其说是“安全产品”,不如说是一种“心理安慰剂”。它在金融风控流程中能提供的增量价值极为有限——正如用户所问:当一笔转账仅凭视频通话就能被批准,漏洞根本不在视频,而在流程。Halo让调用者感觉安全,却没有解决流程中“为何视频是唯一信任锚点”的问题。这是产品经理用技术焦虑包装流程缺陷的典型案例。
最终结论:Halo是一个漂亮的技术demo,一个优秀的公关叙事,但它离“安全基础设施”还差一个承认——承认自己无法证明“真”,只能试探性地提示“假”,且这个“假”的识别能力会持续衰减。它真正适合的场景,是低风险的社交或招聘场景的辅助提示,而非任何涉及资金转移的高风险决策点。
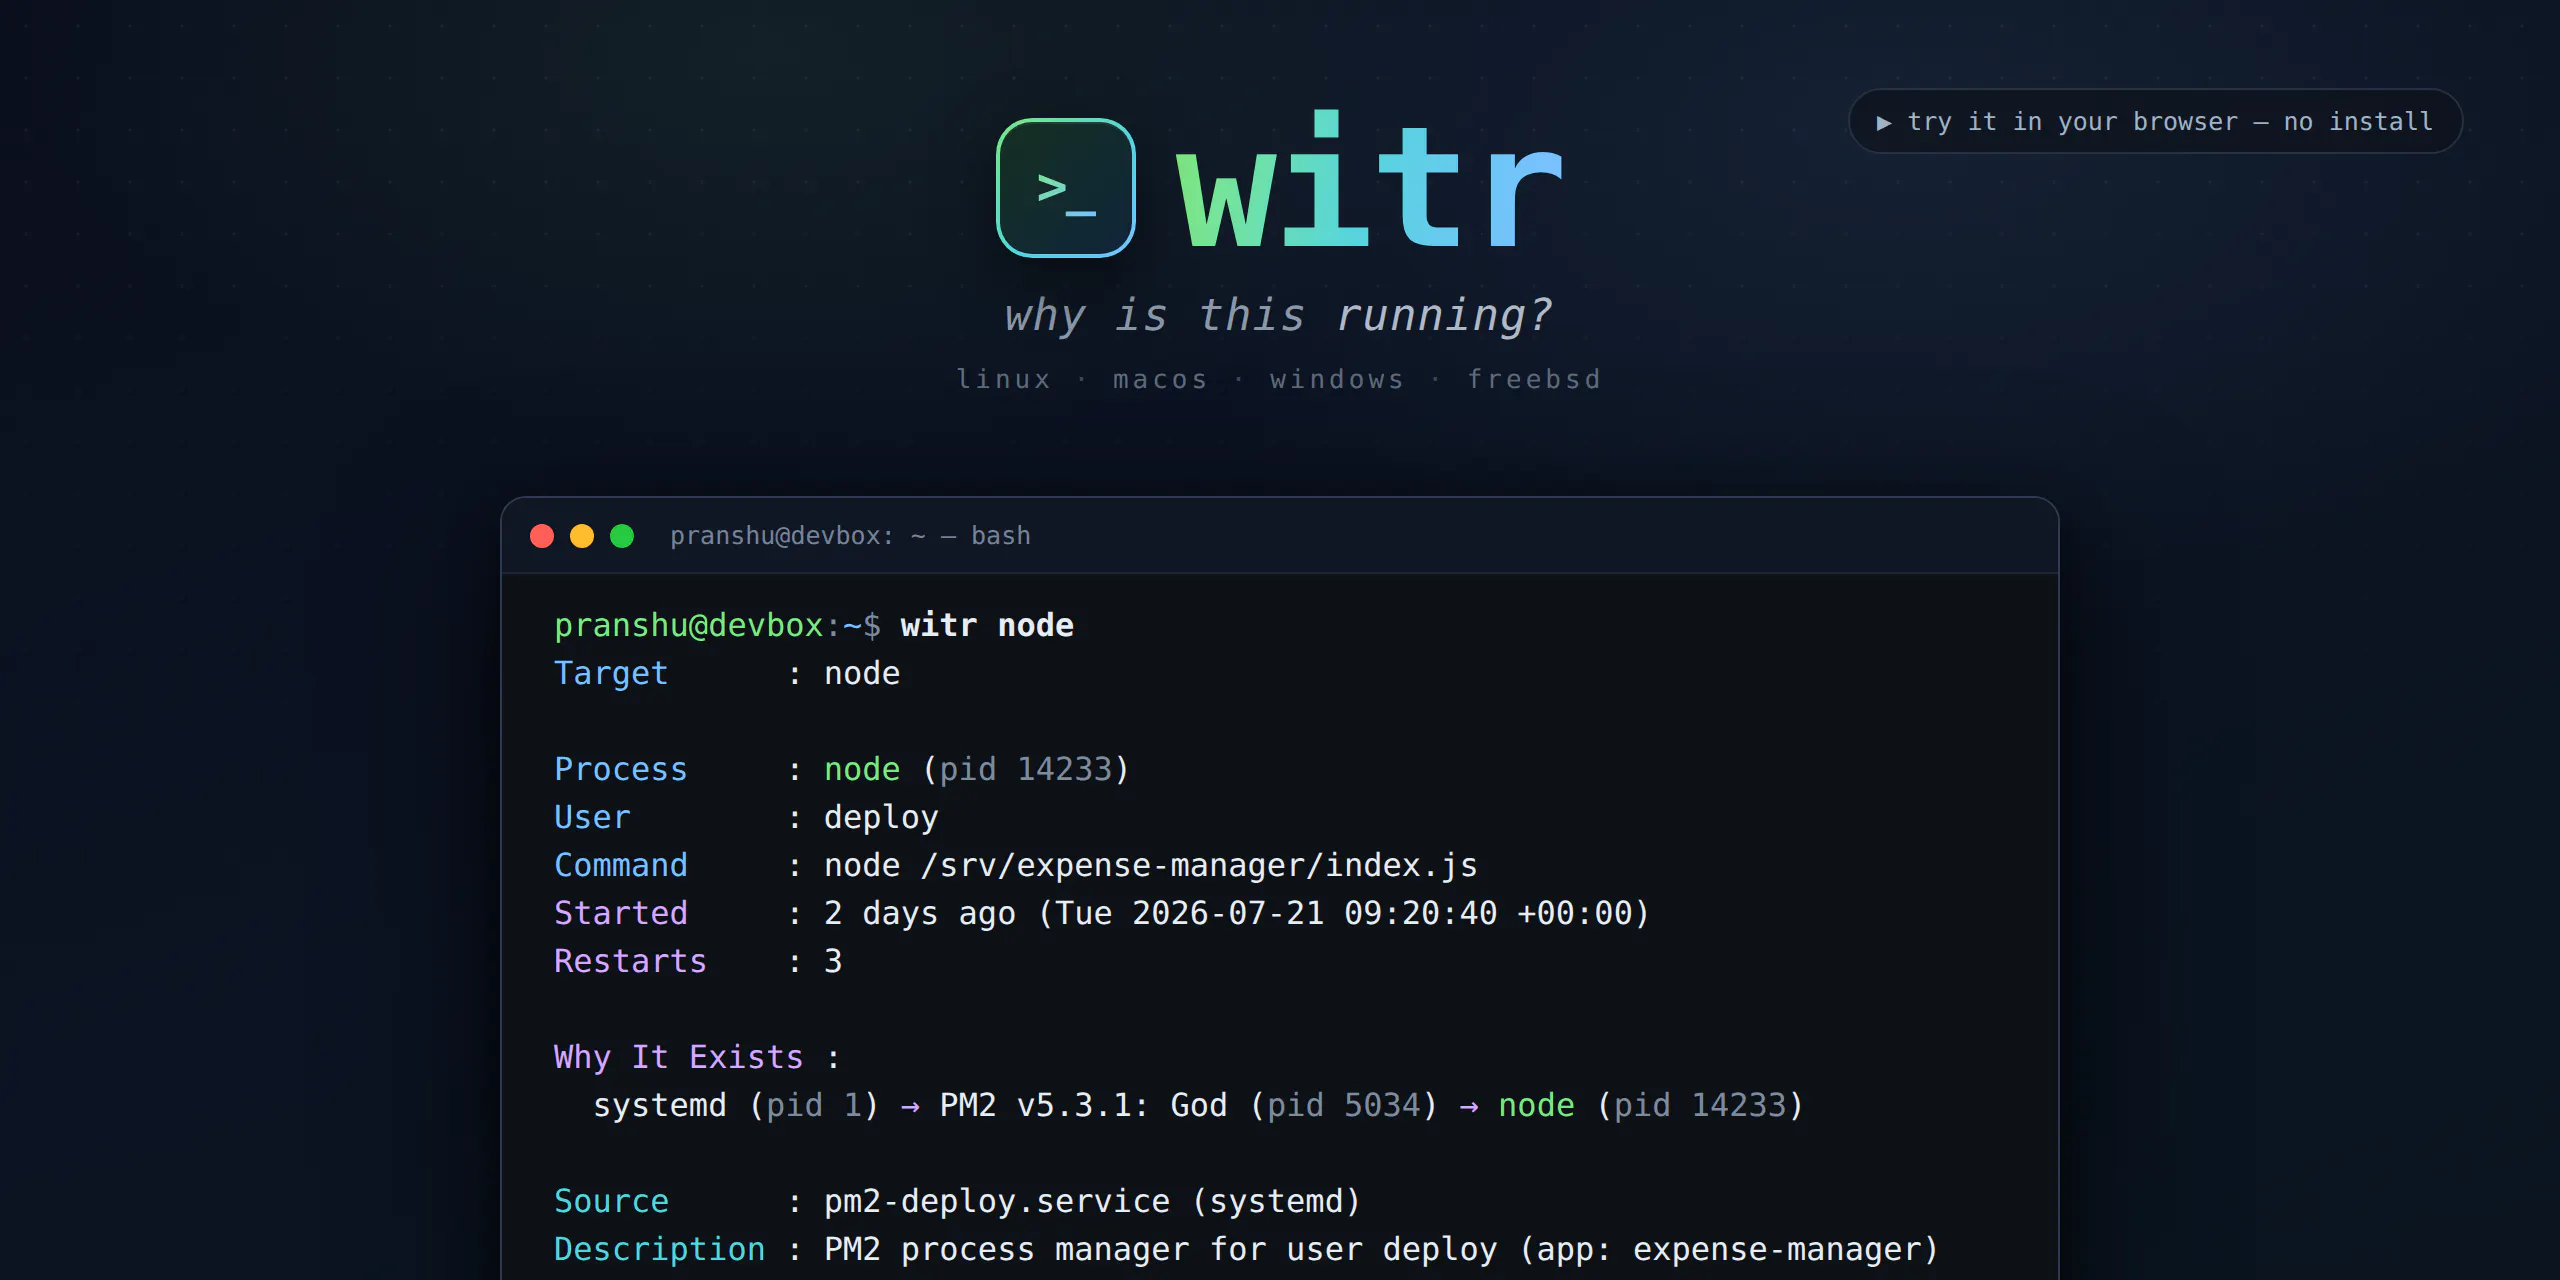
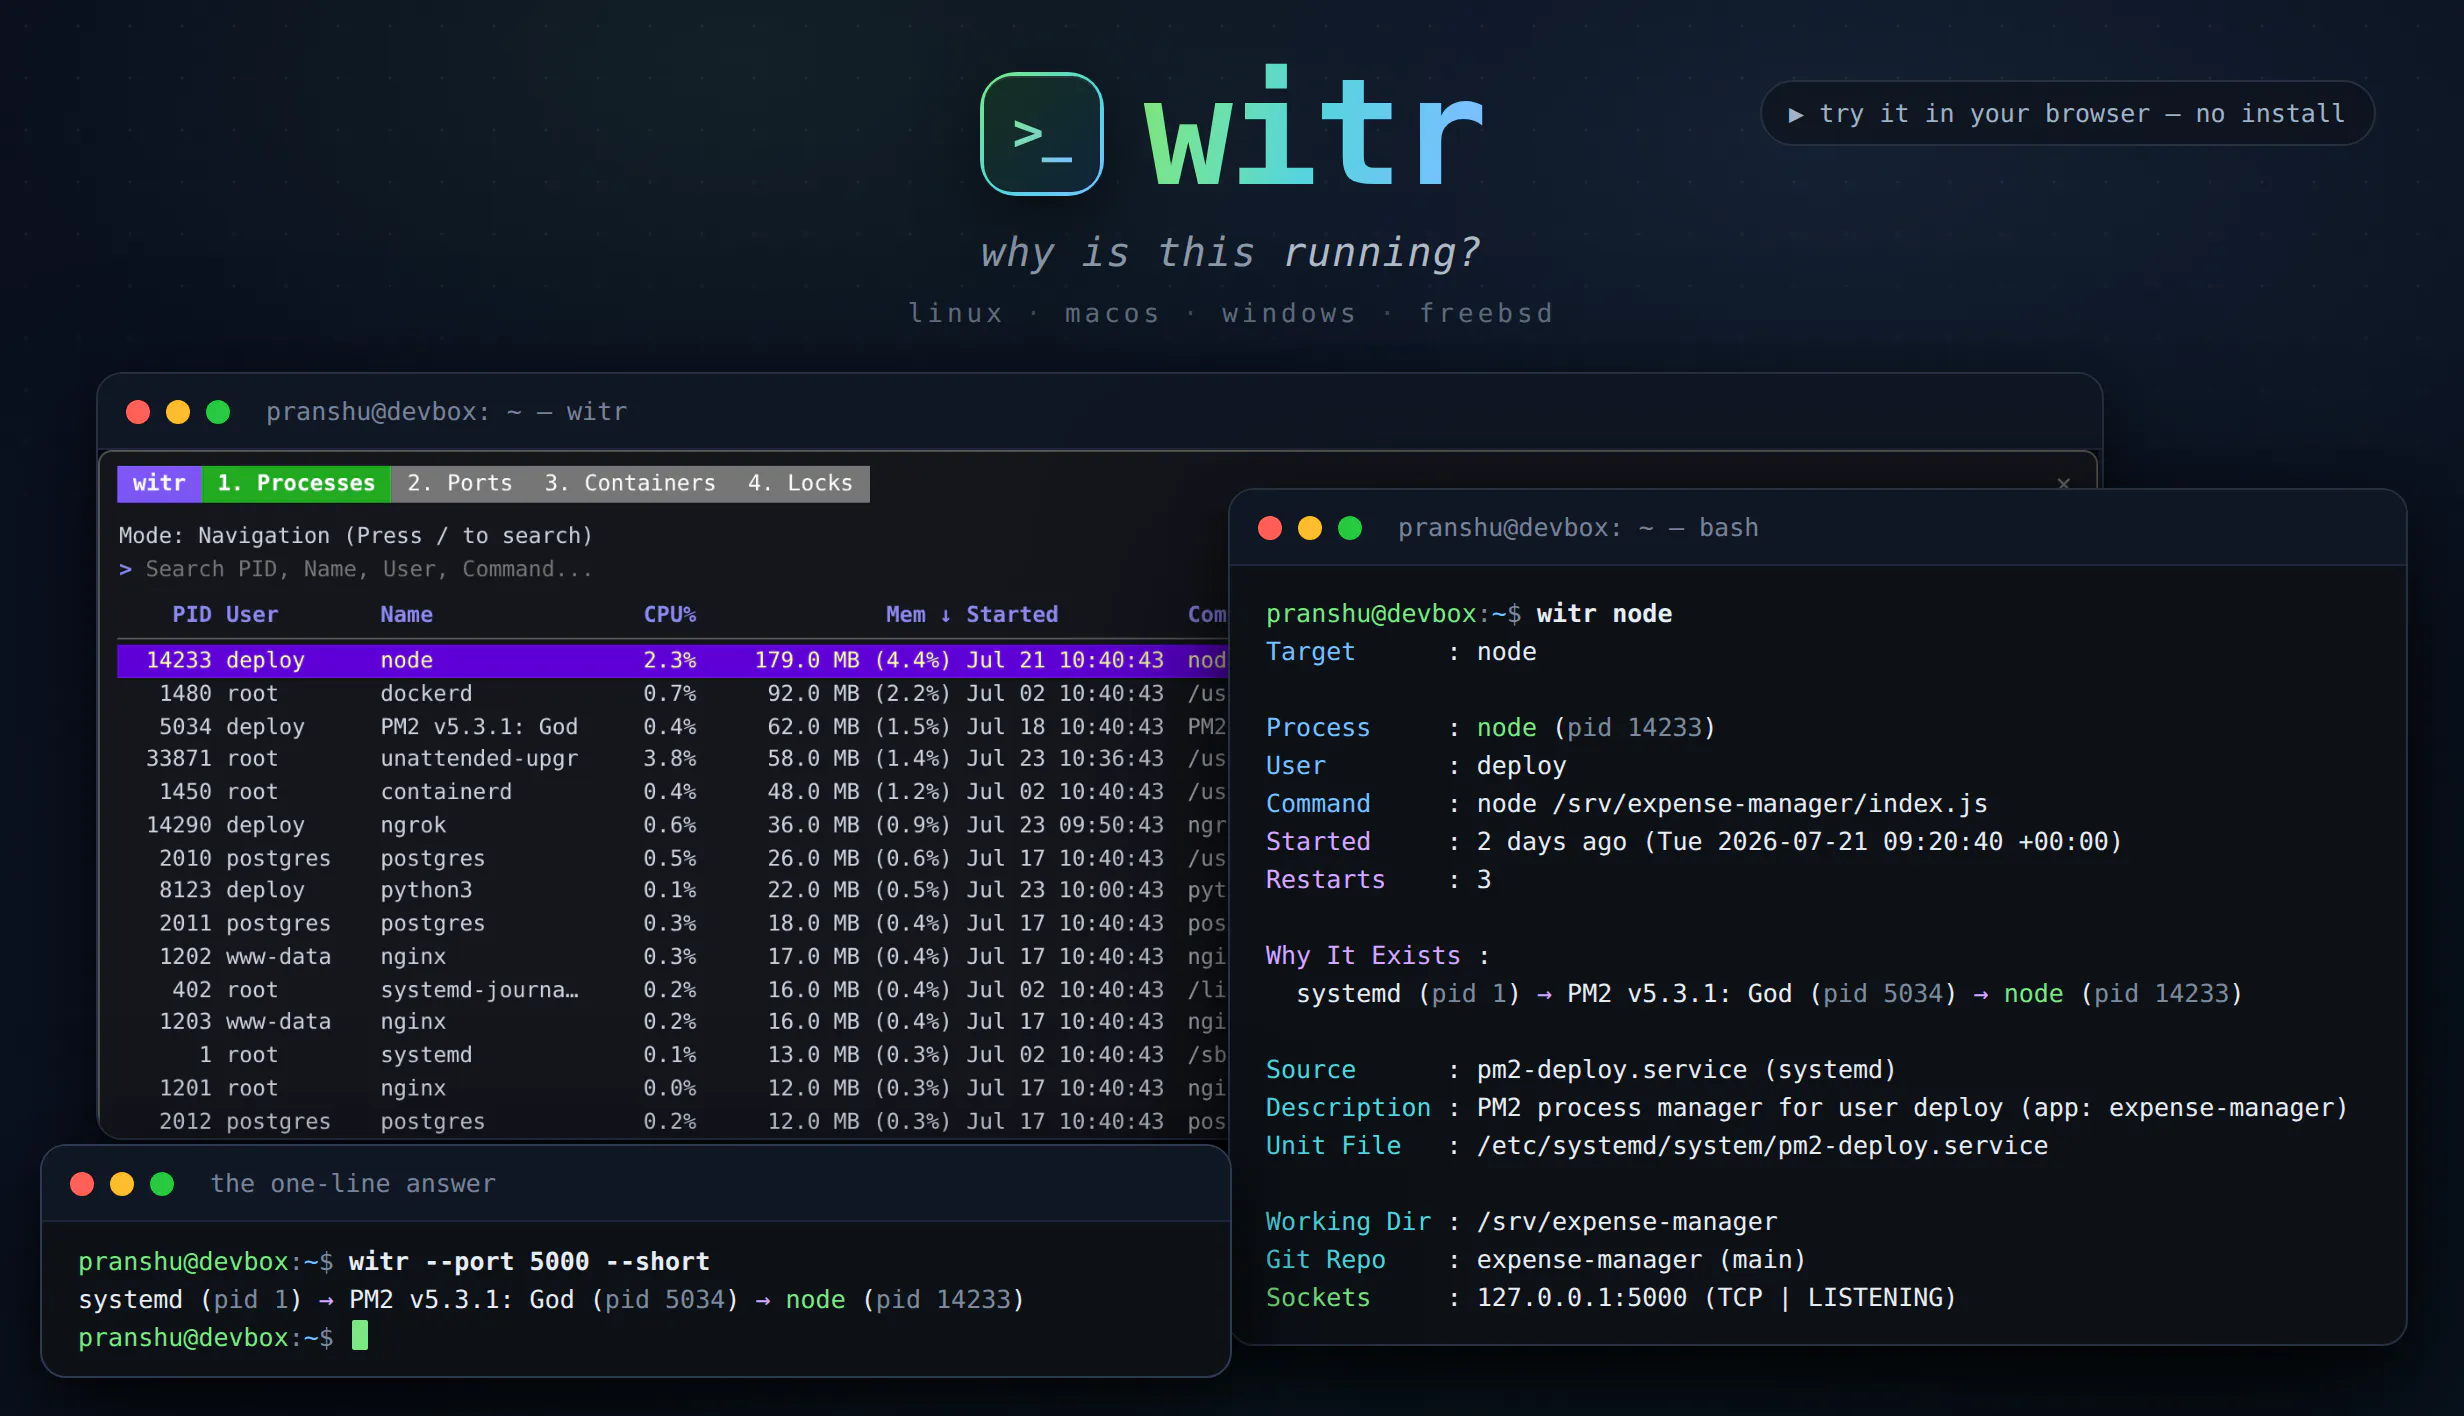
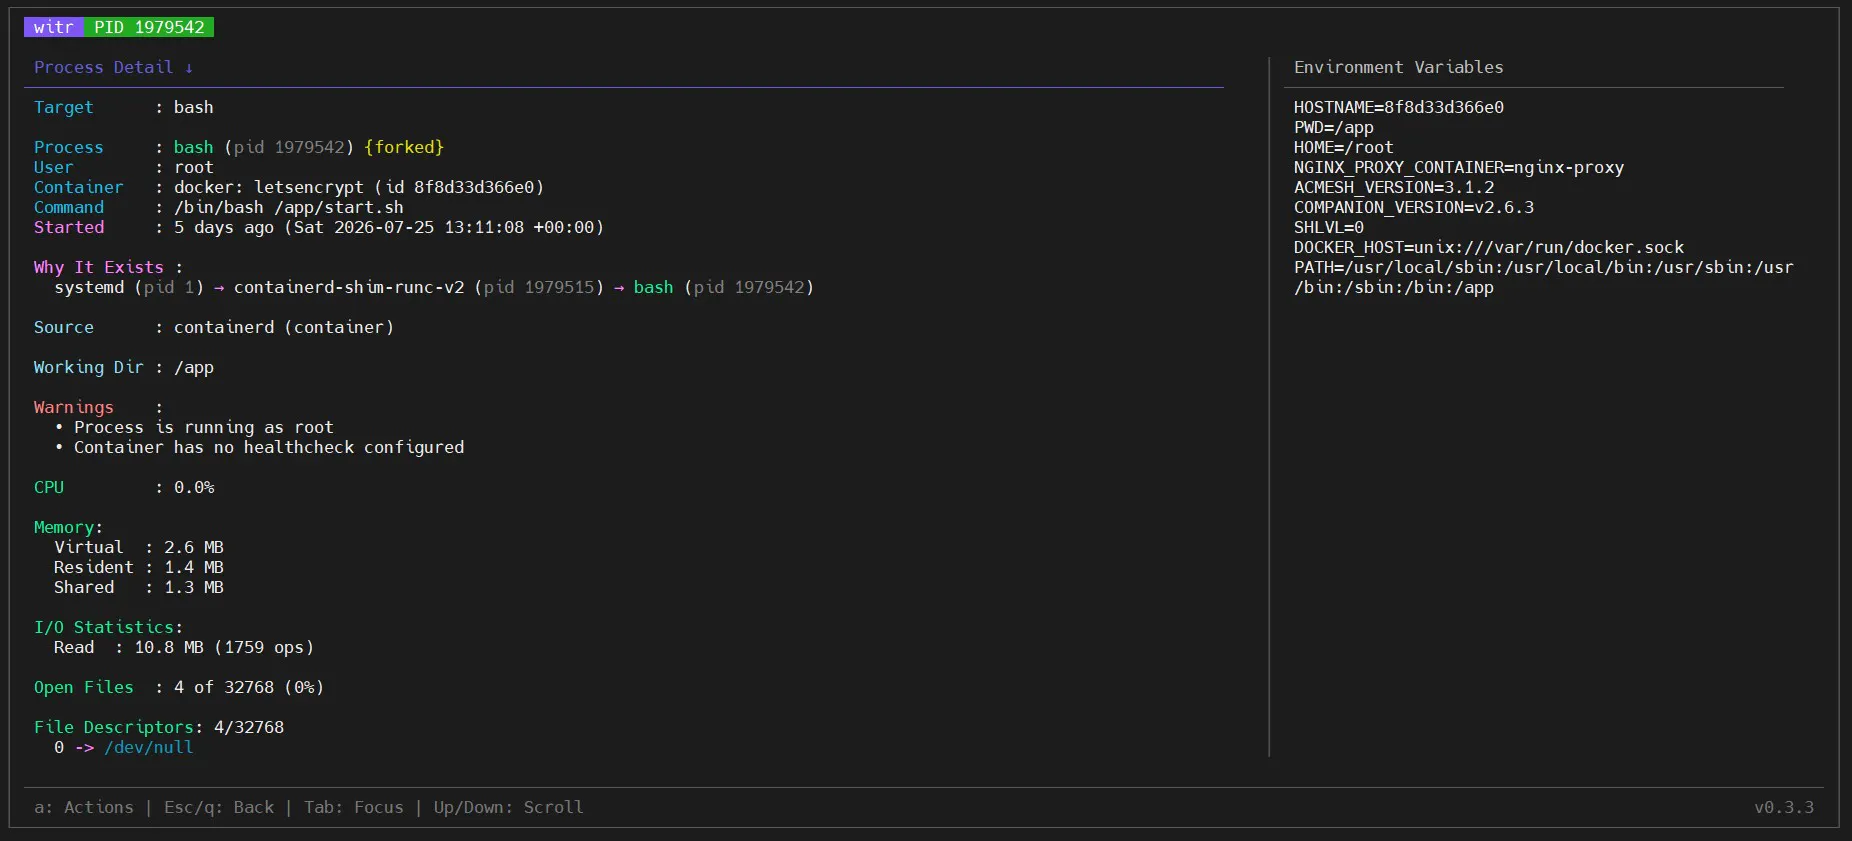
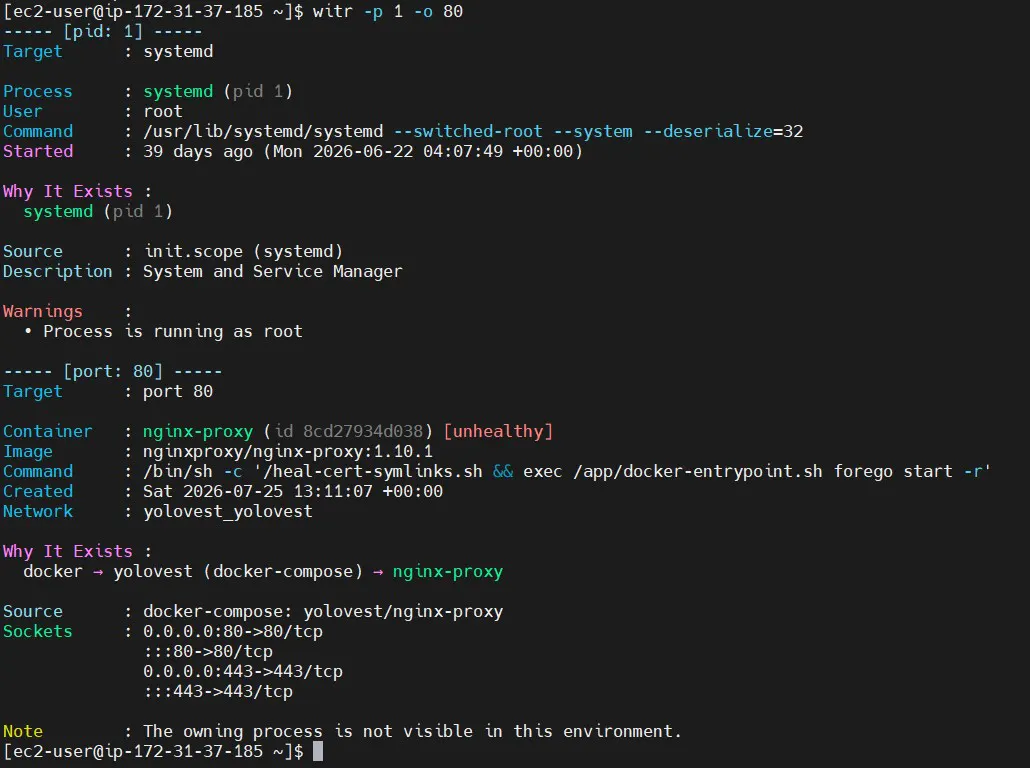
一句话介绍:witr 是一款用于回答“进程为什么在运行”的根因追溯工具,通过沿着进程、端口、容器或文件的父子关系链,定位到 systemd、cron、shell 等真正的启动源头,解决运维和开发中“知其然不知其所以然”的排查痛点。
Linux
Open Source
Developer Tools
GitHub
进程溯源
根因分析
系统监控
命令行工具
TUI
容器调试
端口排查
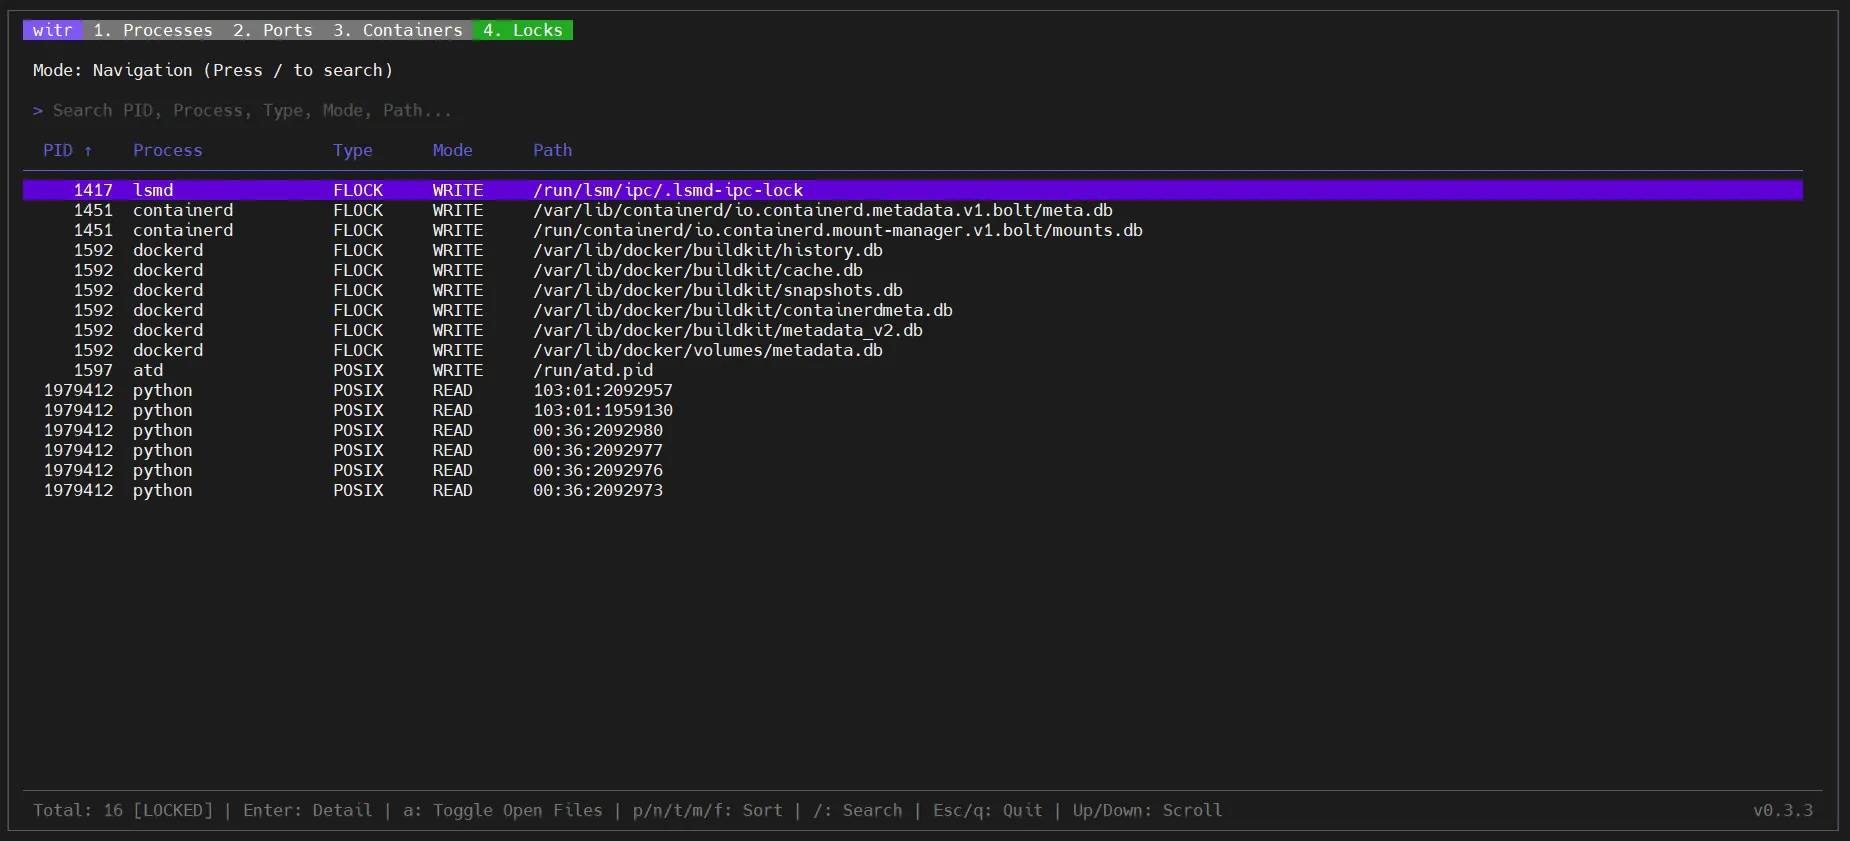
文件锁诊断
跨平台运维
开发调试
用户评论摘要:用户普遍认可其解决实际痛点的能力,但核心质疑集中在“不确定性的诚实展示”上。多数有效评论追问了孤儿进程、PID复用、WSL2无systemd、容器穿透到宿主等边界场景的准确性。开发者响应迅速,承认部分缺陷并列出改进计划,但也暴露了当前版本在孤儿进程溯源上仍可能误报的硬伤。
AI 锐评
witr 在“进程在跑什么”这个拥挤的赛道里,巧妙地切入了“为什么在跑”这个更深、也更难回答的细分领域。它用静态二进制和跨平台支持降低了上手门槛,用 TUI 和 JSON 输出覆盖了交互与脚本两种场景,产品思路相当清晰。
但它的致命弱点在于:**它回答的是“启动链”,而不是真正的“存在理由”**。正如评论中所指出的,知道“systemd 启动了它”不等于知道“为什么它应该继续运行”。当一个进程被 init 收养或parent 消亡后,witr 目前的处理逻辑(默认归因到 PID 1 或 shell)会给出一个看似合理实则错误的结论——这恰恰是工具类产品最危险的失效模式:用户基于错误的答案做出错误的生产操作。虽然作者已针对部分场景提出修复计划,但这暴露了核心算法在应对真实世界复杂性时的脆弱。
另一个值得深思的是商业价值:这是一个典型的“调试时用一下”的工具,而非“持续监控”的工具。它能否沉淀为用户日常运维流水线的一部分,取决于 `--json` 模式能否与监控告警系统深度集成,以及它能否在“孤儿进程识别”“锁竞争分析”等纵深场景做到无可替代。目前看,它更像一把精心打磨的瑞士军刀,而不是导弹发射井里的开关——好用,但尚未成为必需品。
真正的护城河不在功能堆砌,而在于**对“不确定性”的诚实声明**。如果 witr 能在所有无法确认的场景下,明确输出“此处为推断,证据如下”并附带原始数据,它就能建立远超竞品的信任度。否则,它只是另一个“偶尔好用,但不敢全信”的调试利器。
一句话介绍:Customer.io夏季发布版是一个集地理围栏、锁屏实时通知、自带SMS供应商、通知收件箱等能力于一体的客户互动平台,解决品牌在用户关键触点(如进店、锁屏、跨渠道)上“找到人但抓不住时机”的精准触达痛点。
Email
Email Marketing
Marketing
客户互动平台
营销自动化
实时触达
地理围栏
推送通知
SMS集成
AI辅助
跨渠道营销
通知收件箱
WhatsApp管理
用户评论摘要:用户评论聚焦两点:一是对AI内置于campaign builder而非附属功能表示认可,认为其减轻了分群和建流量的重复劳动;二是创始人Jeff主动征集“最期待功能”及“移动端使用场景”,评论区暂未出现具体批评或功能缺失反馈,有效信息偏少。
AI 锐评
Customer.io这轮发布本质上是一次“存量功能大补课”——地理围栏、Live Activities、自带SMS供应商、通知收件箱,这些能力在Braze、OneSignal乃至Firebase Cloud Messaging上已不算新鲜。其真正的护城河不是某个单点功能,而是“把这些东西塞进原有自动化编辑器、受众分群和统一数据模型里”的集成成本。从创始人Jeff的发言看,产品叙事从“邮件平台”转向“全渠道互动中枢”,但问题是:当核心差异化来自“All-in-one”时,它面对的竞争就不再是营销自动化同行,而是Segment(数据层)+ Braze(触达层)+ Twilio(通信层)的组合拳。用户对AI的正面反馈值得注意,但“AI帮你做分群和排流程”本质上是降低操作门槛,却并未改变底层数据质量和策略设计的上限——如果客户的数据干净、事件定义清晰,这类AI只是锦上添花;如果数据一团糟,AI只会加速放大错误。此外,138票在Product Hunt上属于中等偏下水平,评论仅一条有效信息,说明其目标客群(中大型B2C品牌)对“发布新鲜感”不敏感,更看重的是迁移成本和现有工作流的兼容性。建议关注其后续API开放程度和价格梯度——如果SMS自带供应商只是“免绑定”,而非“省成本”,那对中小客户的吸引力就相当有限。真正值得观察的,是地理围栏和Live Notifications能否在移动端跑出高留存案例,否则这只是一次“功能陈列式”的版本更新。
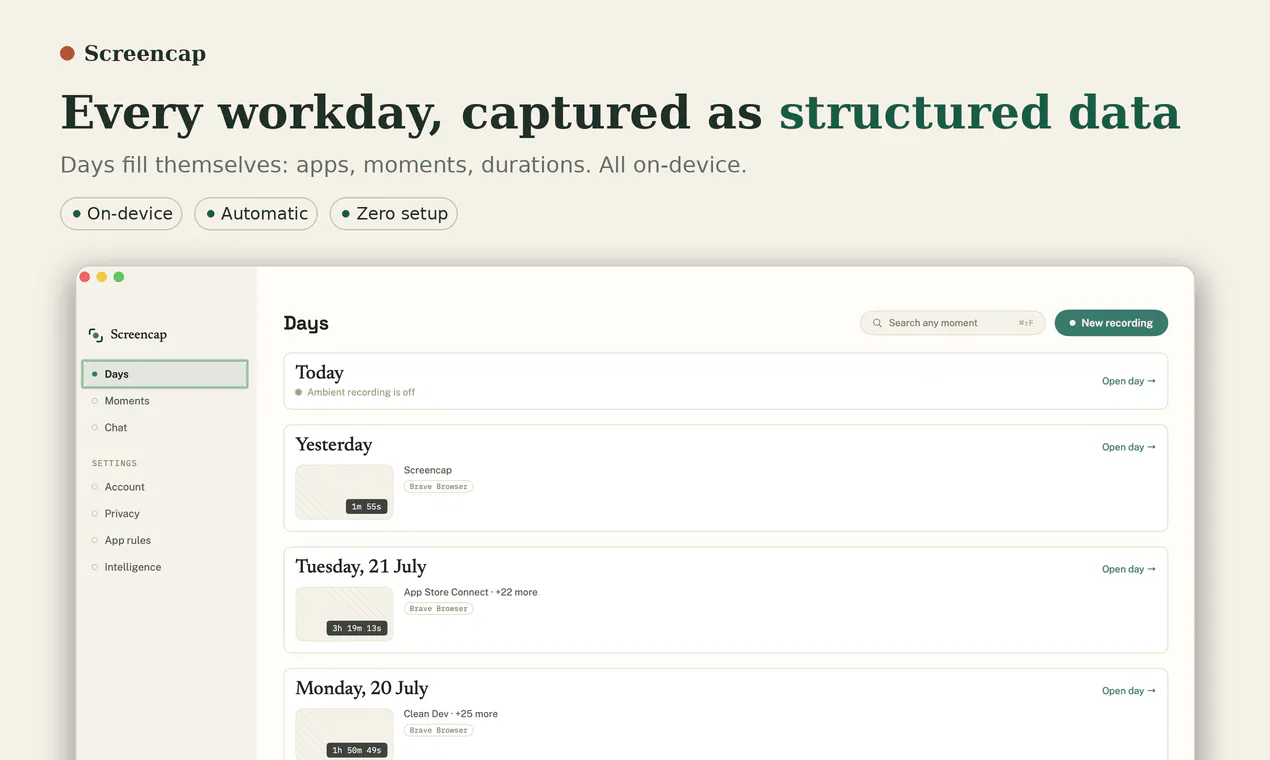
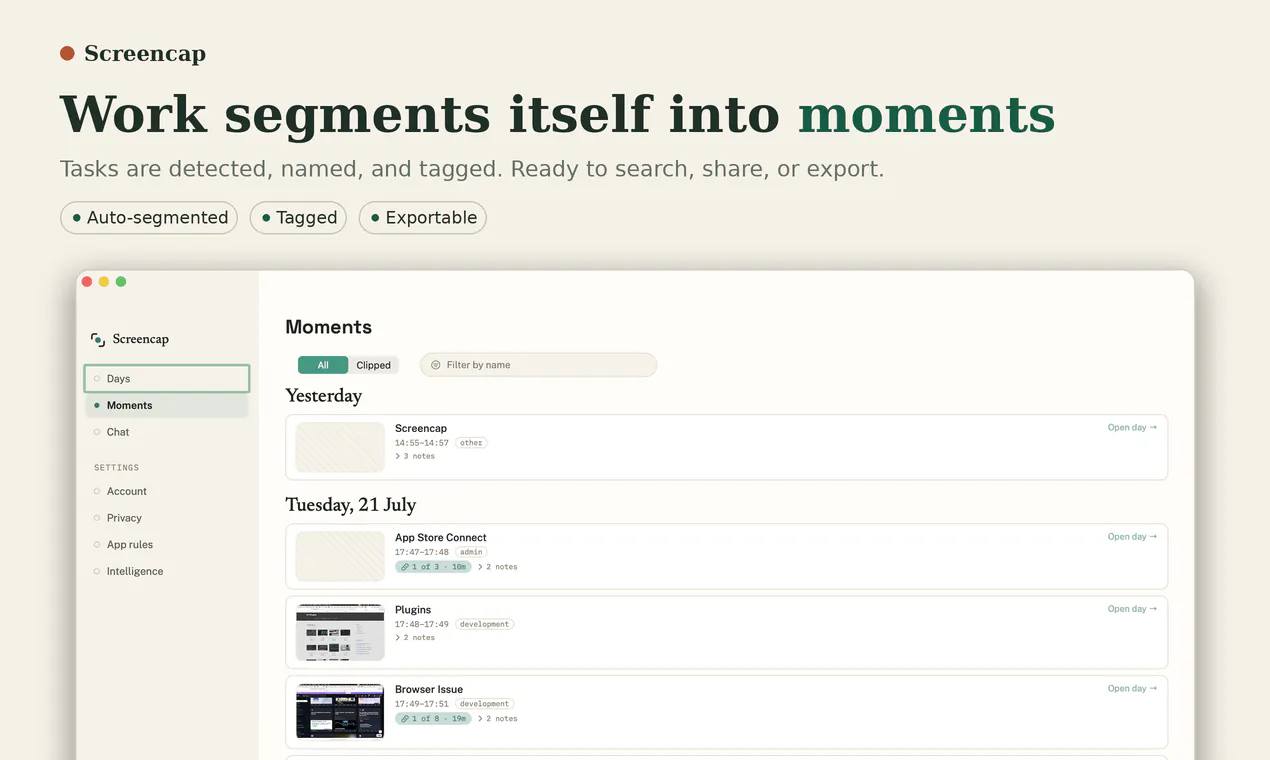
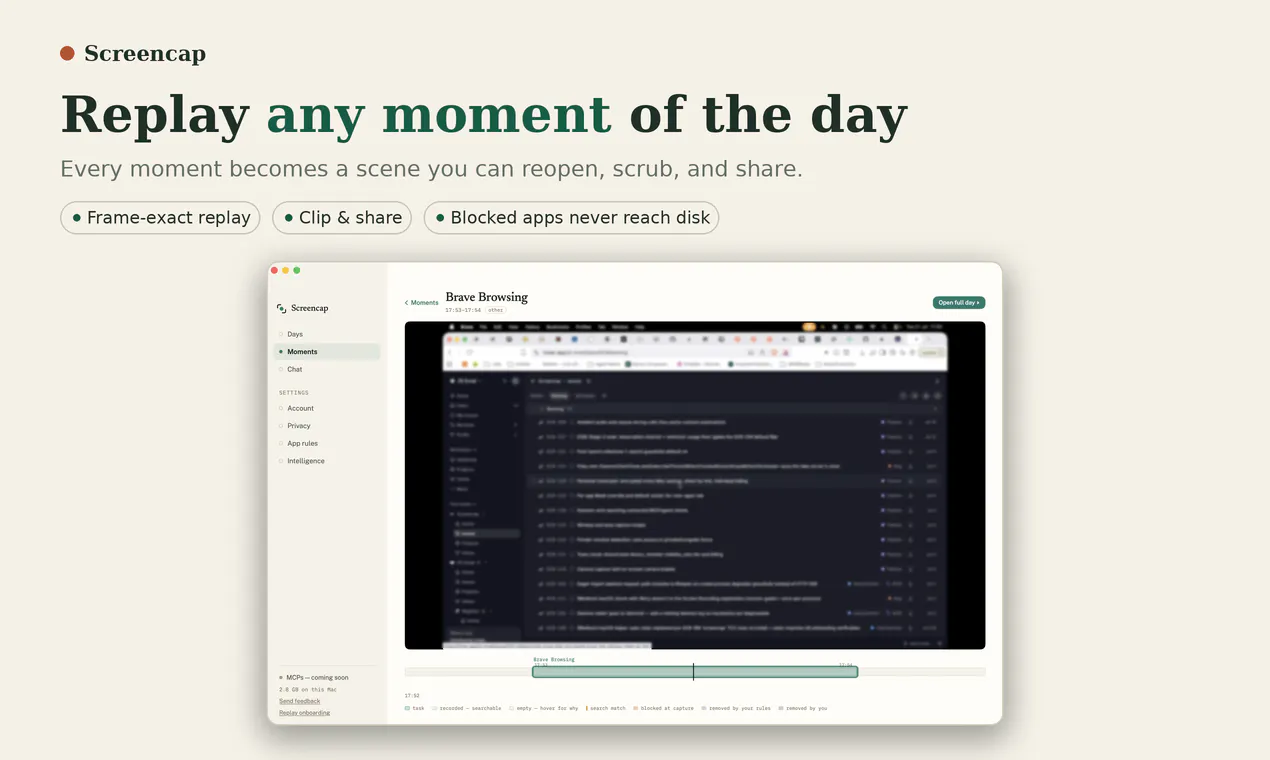
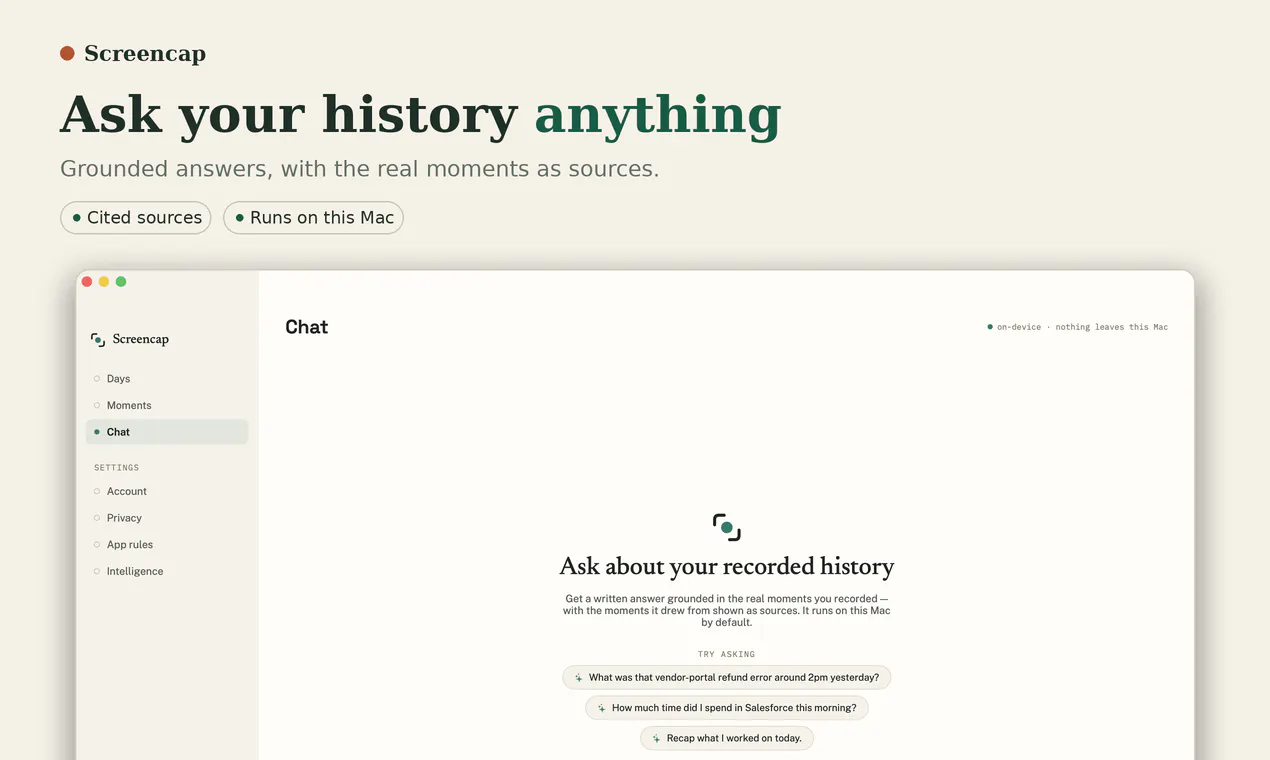
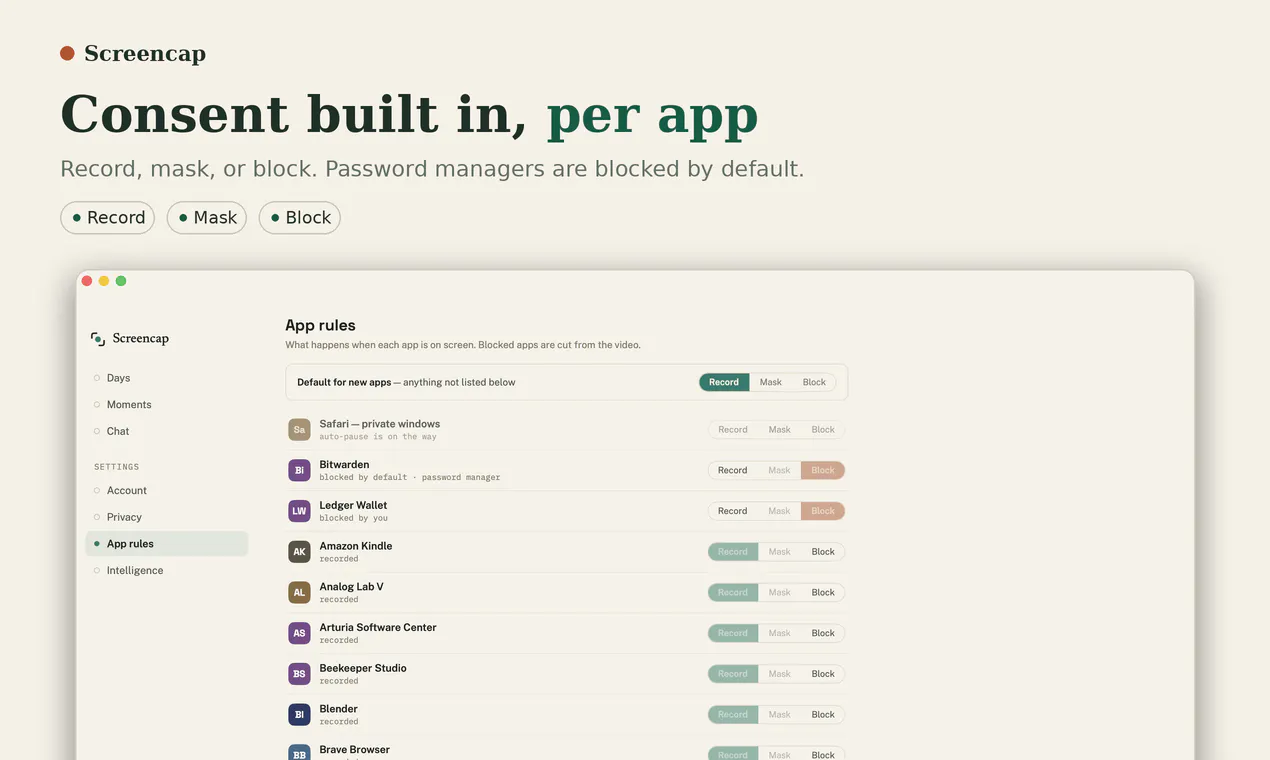
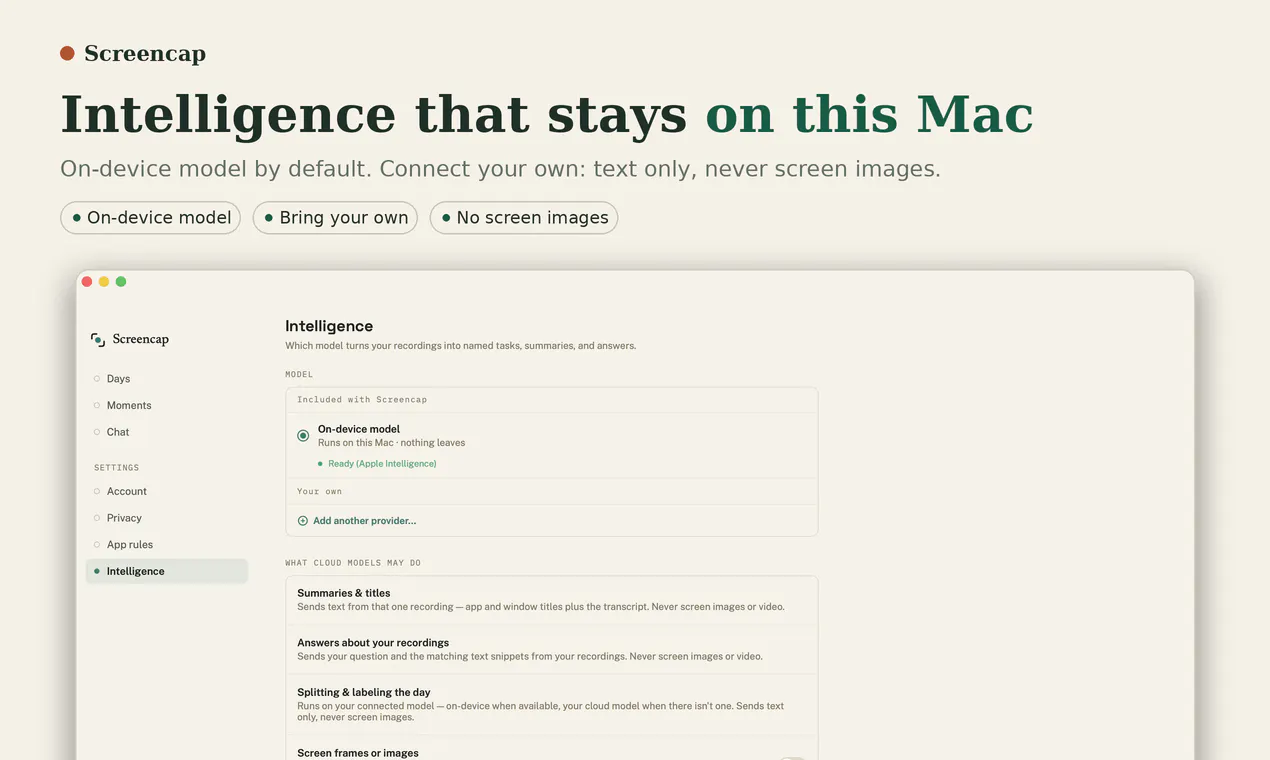
一句话介绍:Screencap是一款macOS开源屏幕记录工具,通过持续记录屏幕、点击和键盘操作,将团队真实工作流程转化为结构化数据集,用于AI训练与流程自动化,同时内置严格隐私保护机制。
Productivity
SaaS
Artificial Intelligence
屏幕录制
AI训练数据
工作流程自动化
开源
macOS
隐私保护
行为数据采集
团队知识管理
流程挖掘
本地优先
用户评论摘要:用户普遍认可隐私设计,但质疑应用级屏蔽无法覆盖浏览器标签页等敏感内容,建议采用允许名单。核心担忧是“持续录制”易演变为绩效监控——数据能否按人查询是信任边界。另有反馈称导出数据格式不明,且文档链接存在错误。
AI 锐评
Screencap踩中了两个性感的风口——AI数据饥渴与企业流程数字化。但它的本质是一个“带安全锁的员工监控软件”,这决定了其价值与风险同样尖锐。
从产品逻辑看,它确实聪明:将人类隐性操作转化为显性结构化数据,这比让员工填写文档成本低得多,且数据质量真实。但评论中那位用户的质问直指命门:**当录制数据可被按人查询,就成了装了摄像头的KPI系统。** 即便创始人强调“审查后上传”,但上传至云端后的数据主权和使用边界才是信任崩塌点——没人会向老板提交一份“我摸鱼时打开了三次推特”的log。
技术门槛上,应用级屏蔽是最弱的一环。CRM里的客户信息、浏览器Tab中的内部系统,这些内容级敏感数据在屏幕流中无处遁形。尽管回复声称有内容级掩码,但识别准确性存疑。而“上传前人工审查”在现实中会因使用成本过高而沦为摆设——用户会盲点“确认”以维持效率。
更现实的问题是数据出口。Screencap的端点价值是“AI训练数据”,但噪音数据清洗成本极高:真实工作流中的误操作、中断、等待时间如何标注?若仅做流程挖掘,现有RPA工具已能捕捉交互日志,为何需要录制整个屏幕?除非它最终希望成为“行为数据的AirTable”,让用户自行构建Agent训练集——但这又回到了隐私信任的同一堵墙。
开源是它的底牌,社区的隐私审计和自托管承诺能暂时安抚早期采用者。但商业化的天平一旦倾向“团队版”的云端聚合,所有善意都会被重新审视。**它必须在产品中显式承诺:数据不可按人检索,仅以流程片段存在。** 做不到这一点,“AI训练数据”就只是HR部门观看员工“演出”的另一种方式。当前阶段,它更适合被用于“个人AI记忆回放”而非“团队标准化”——至少,一个人对自己的数据有天然的边界感。
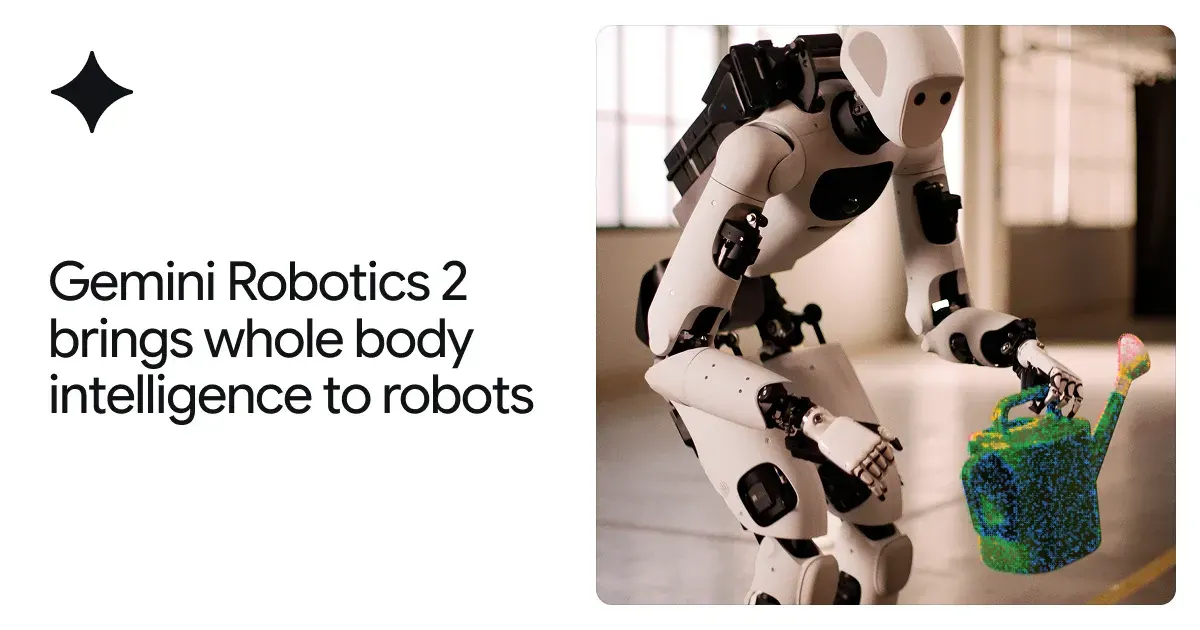
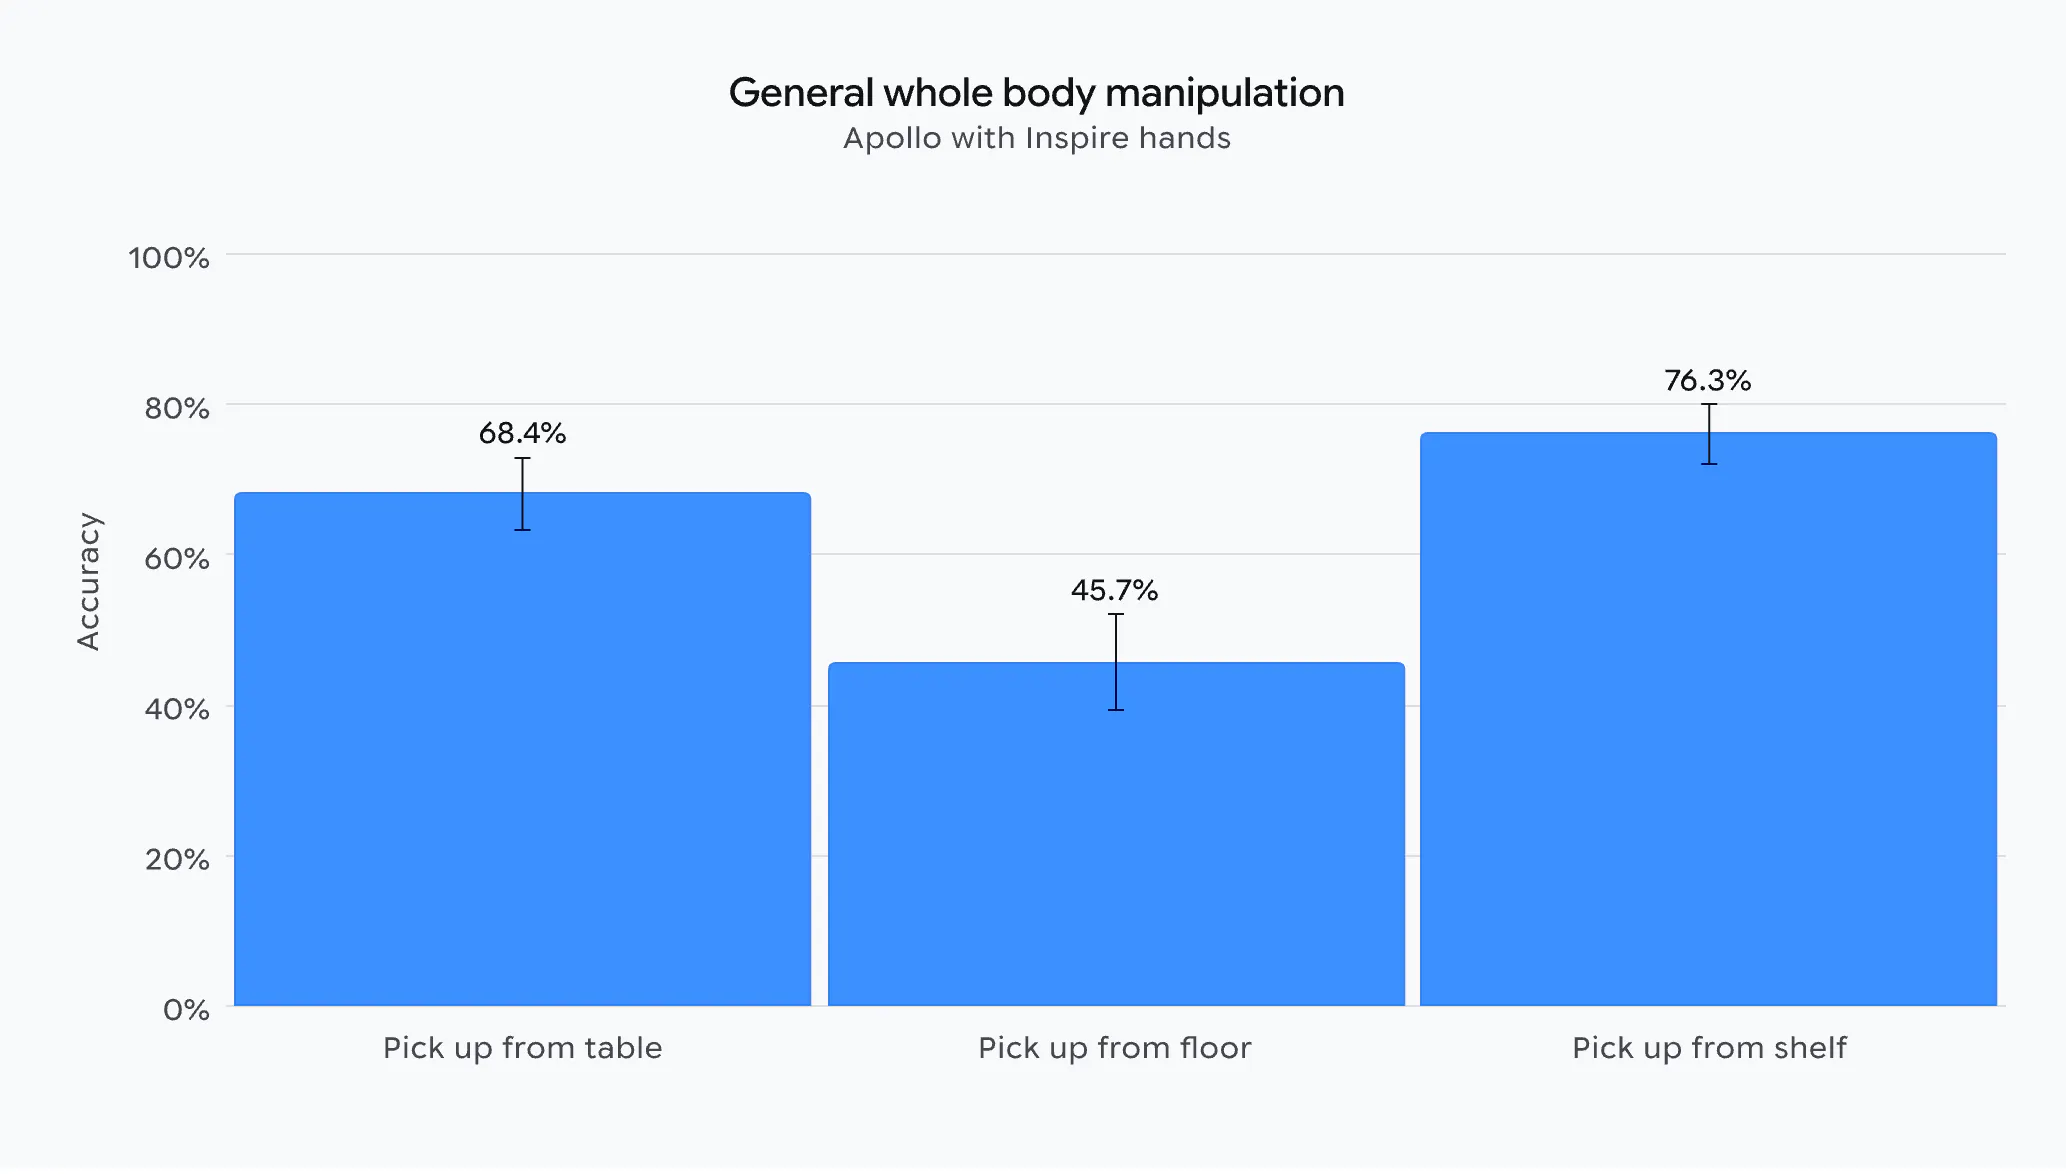
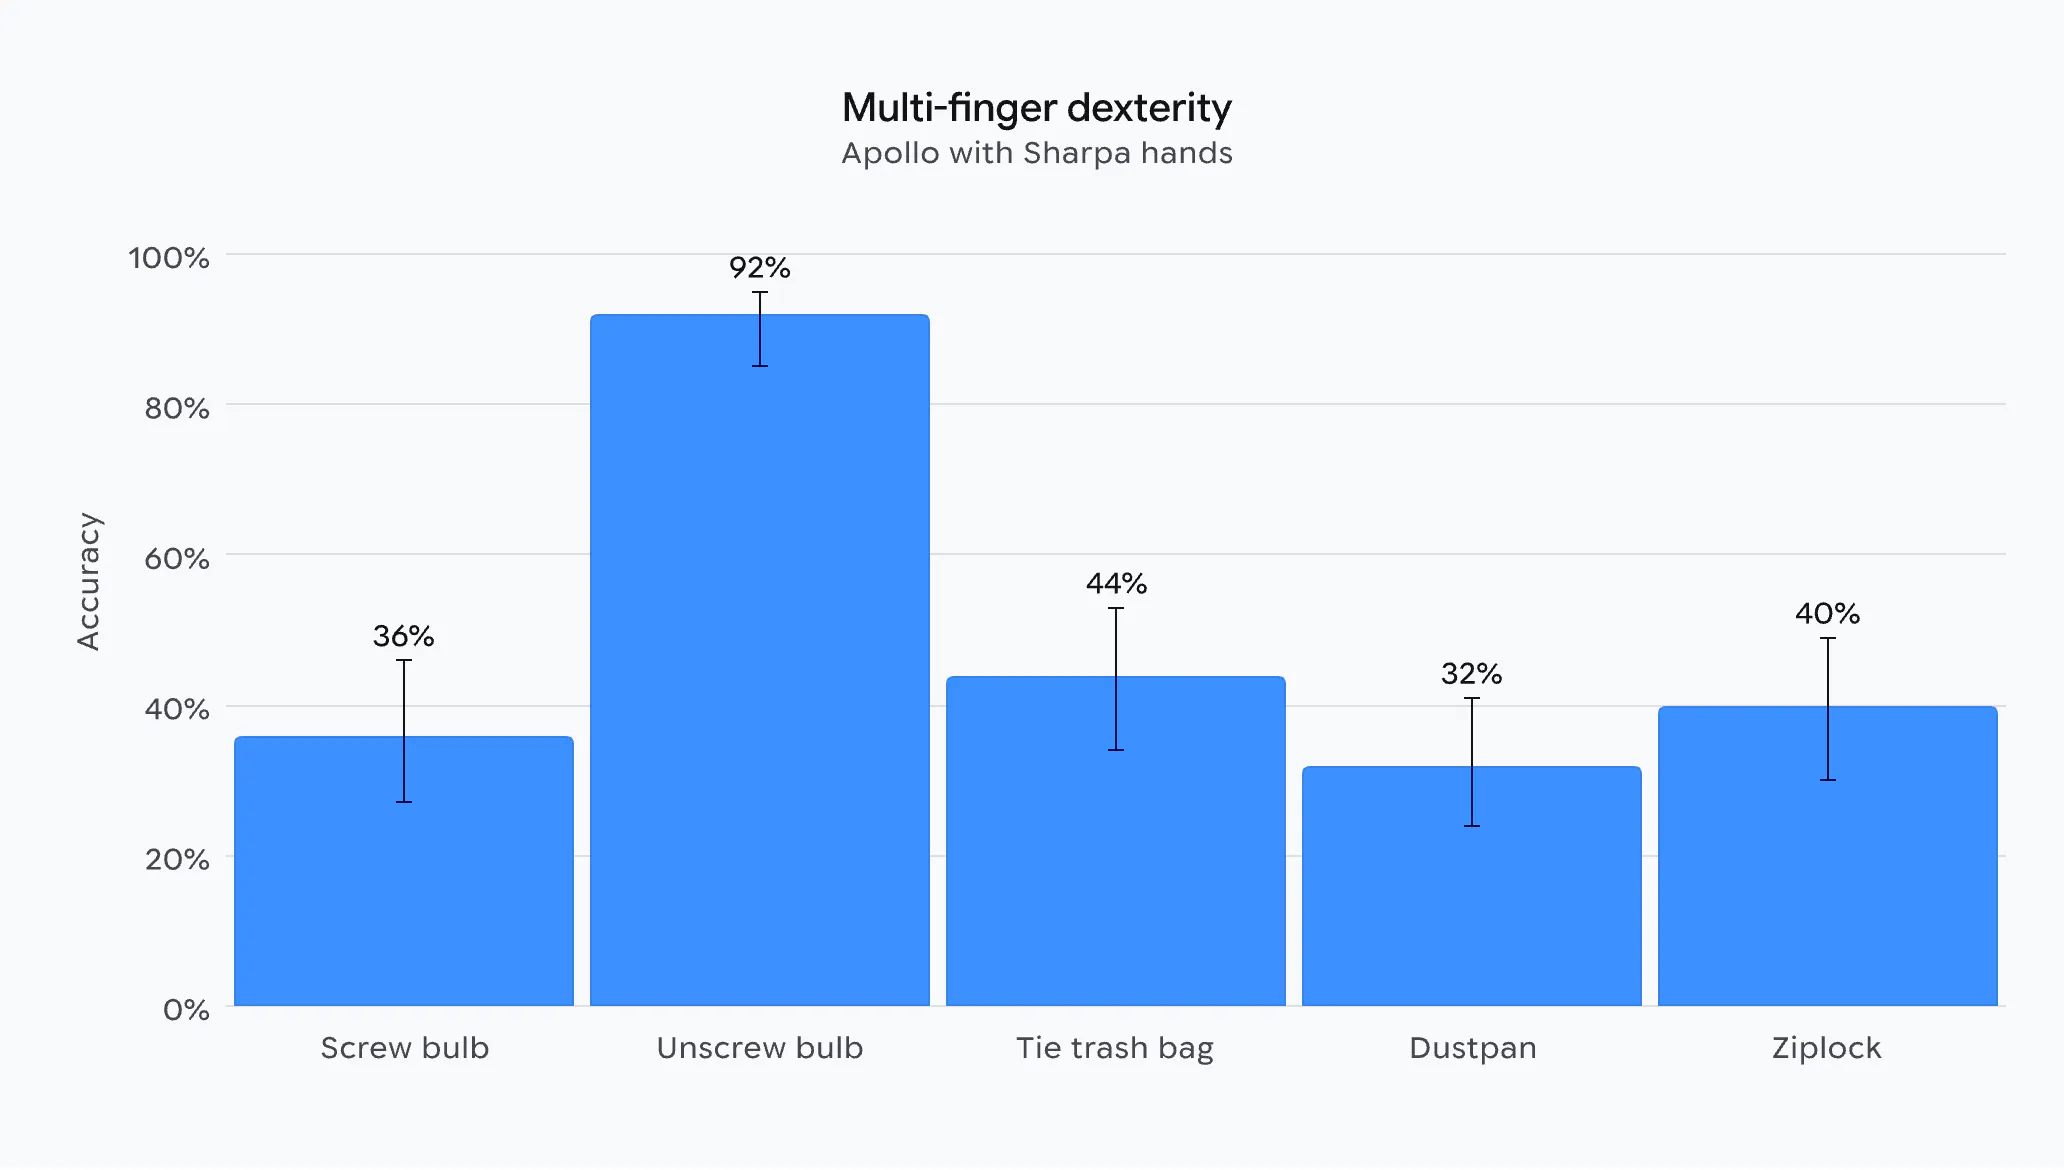
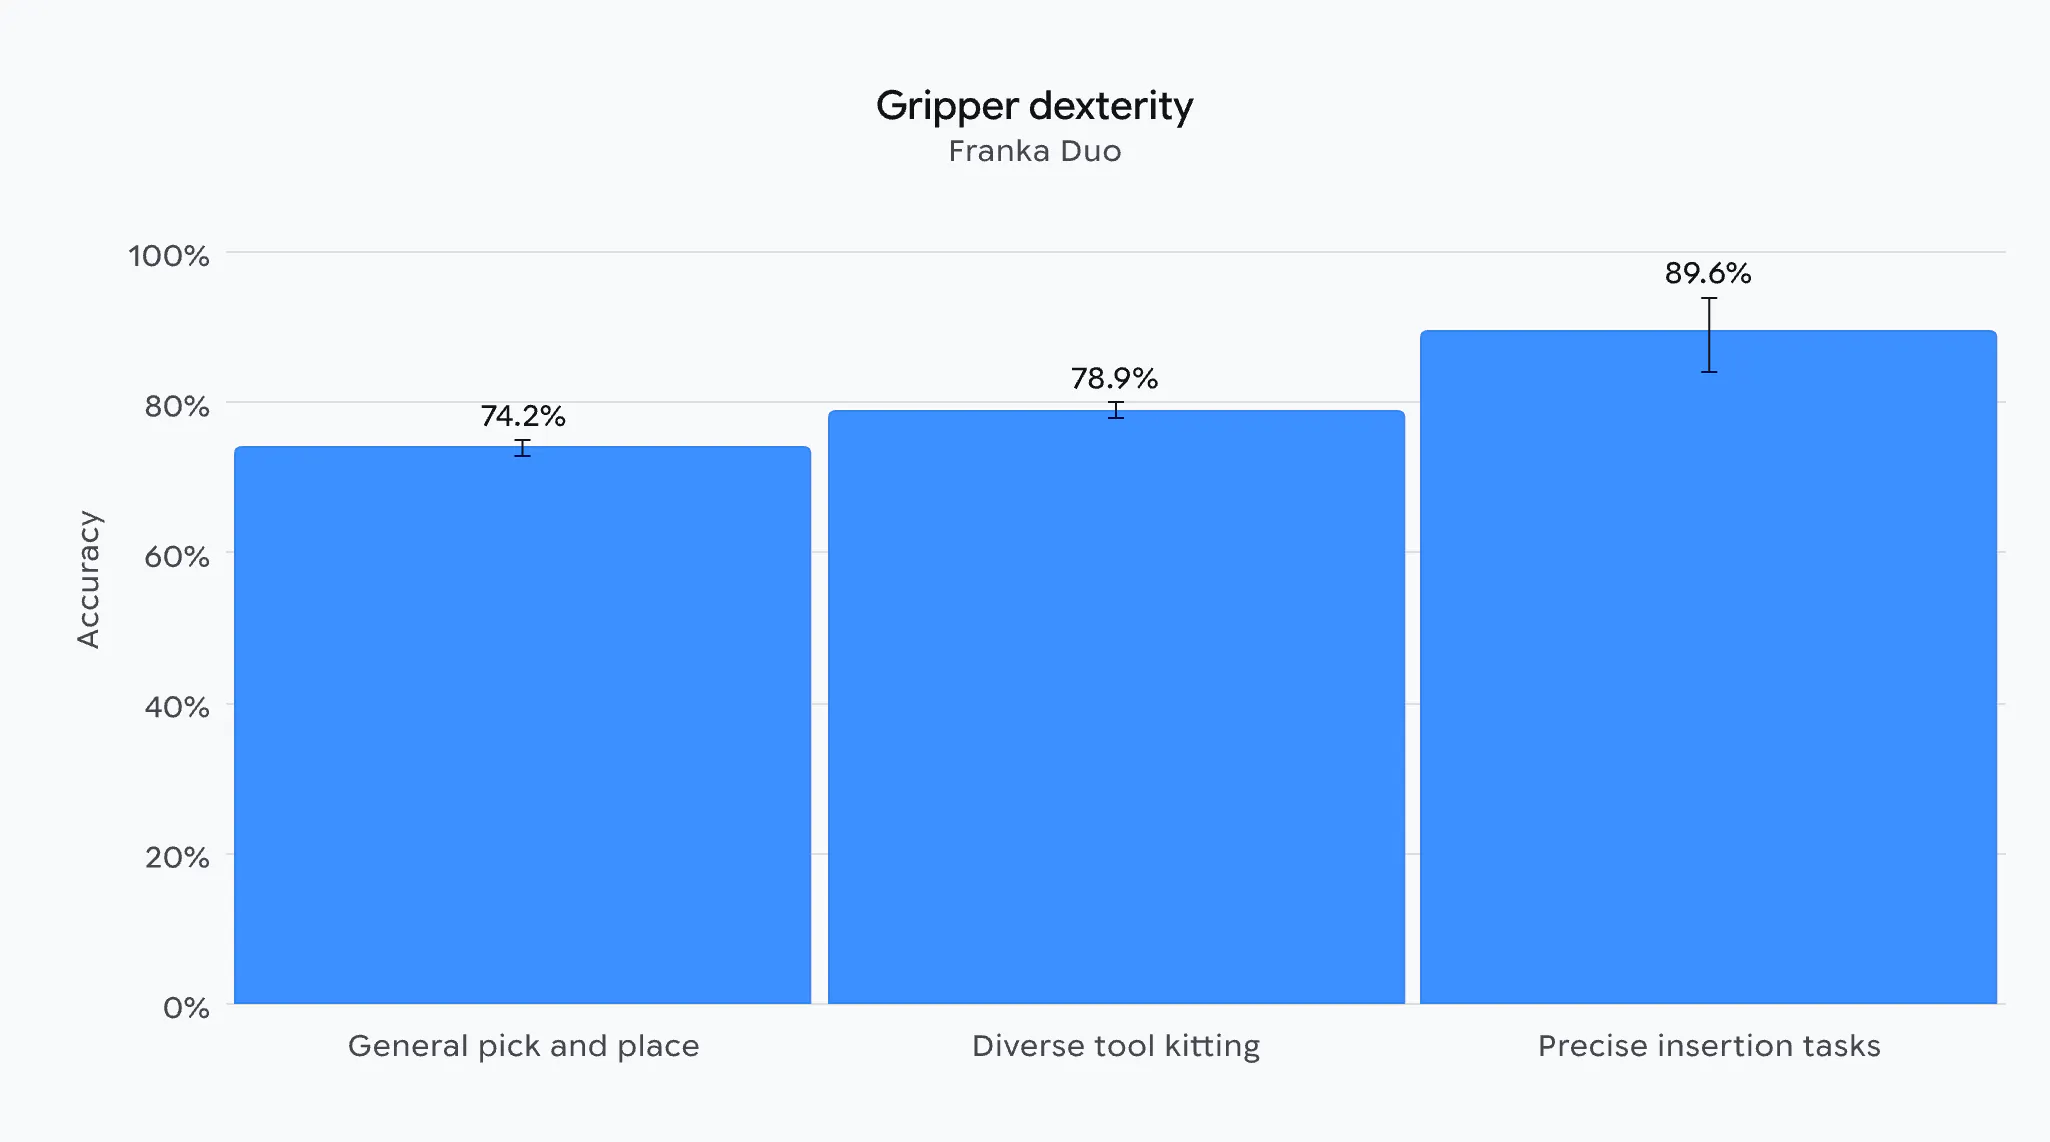
一句话介绍:Gemini Robotics 2 是谷歌 DeepMind 推出的新一代机器人“大脑”,将 Gemini 多模态大模型能力注入物理实体,让不同形态的机器人在真实世界中理解环境、推理任务并灵巧执行,主要面向工业操作、医疗辅助、多机协作等复杂物理场景,解决传统机器人泛化能力差、无法适应非结构化环境的痛点。
Robots
Artificial Intelligence
机器人AI
具身智能
多模态大模型
Google DeepMind
物理世界理解
灵巧操作
多机器人协作
自适应推理
机器人操作系统
AI前沿研究
用户评论摘要:多数用户认可物理AI是下一前沿,但批评官方发布缺乏硬核技术指标。核心质疑集中在:未见未训练环境下的任务成功率、失败恢复机制、感知到动作的延迟数据。评论认为当前更像定位声明而非可评估产品,呼吁提供技术论文或基准测试。另有医疗背景用户畅想机器人+医疗知识的颠覆性应用。
AI 锐评
Gemini Robotics 2 的发布,本质上是一次典型的“高姿态、低信息量”研究预告——它用“整机智能”“灵巧操控”等宏大词汇掩盖了当前具身智能领域最致命的短板:缺乏可复现、可量化的泛化能力证明。评论区的冷静声音一针见血:没有 unseen environment 的成功率、没有失败抓取的自恢复案例、没有感知-动作闭环的延迟数据,那么这只能被视为 Demo 而非 Product。
从技术纵深看,Gemini 模型在多模态推理上的积累确实为机器人提供了更高级的“认知前端”,但物理世界的复杂性远非语言+视觉的拼接能覆盖——接触力学、动态扰动、实时规划仍是硬骨头。即便 Google 拥有顶级算力和人才,若不能将模型能力转化为真实世界上稳定的控制信号,其价值将止步于论文引用。
更值得警惕的是,这类“概念先行”的发布正在消耗行业的信任度。当每隔两周就有一个“物理AI新前沿”刷屏,而没有任何一个产品能达到宣称的自主水平,投资者和工程师会越来越难以区分真正的技术突破与 PR 叙事。
当然,不可否认 Gemini Robotics 2 在架构设计上(如多机协作、全身控制)代表了对未来形态的前瞻思考,且 DeepMind 的学术实力使其有潜力快速迭代出实质性结果。但作为“发布”,缺数据即是原罪。建议团队尽快公开技术报告或开放评测基准,用数字替代口号——否则,它只会成为 AI 寒冬叙事里又一个过度炒作的注脚。
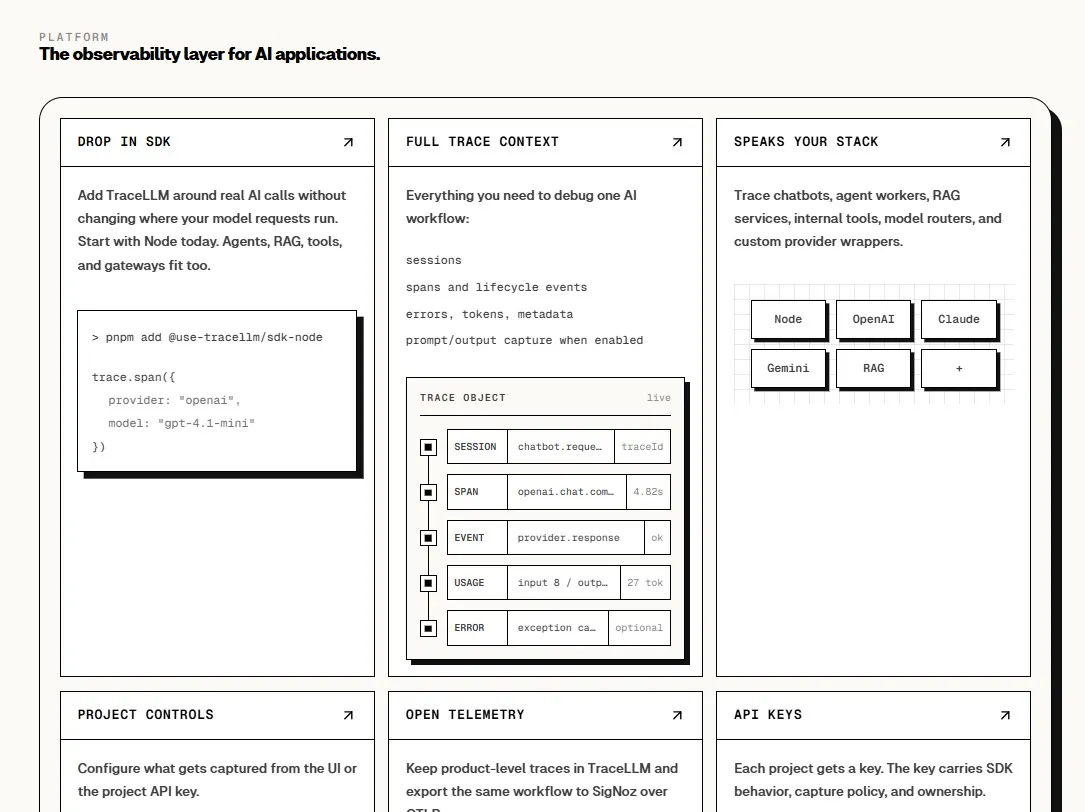
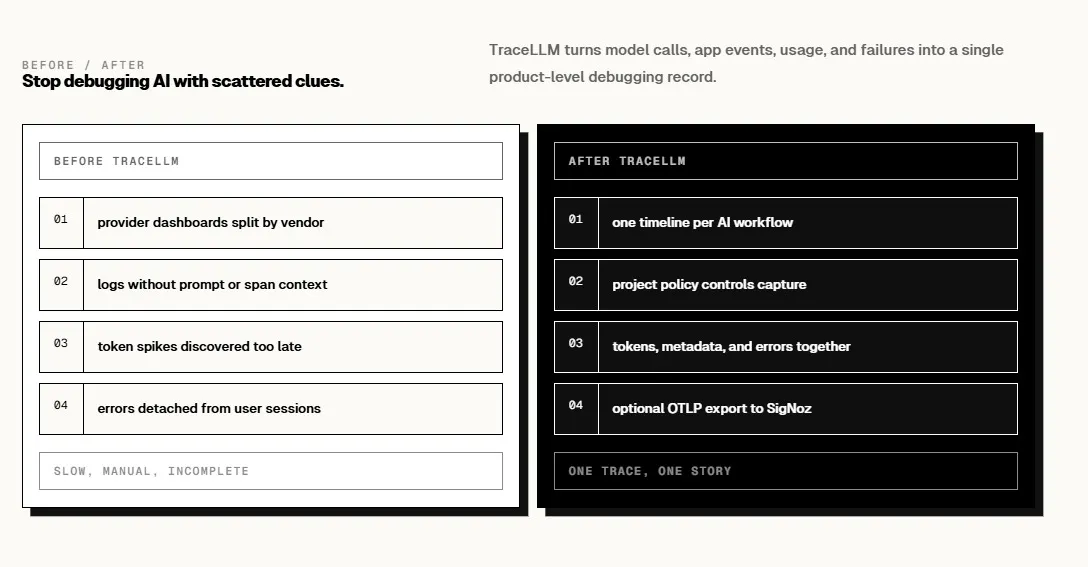
一句话介绍:TraceLLM 是一款专为生产环境AI应用打造的可观测性平台,通过OpenTelemetry(OTLP)追踪提示词执行、Token消耗、延迟、错误及模型调用,帮助开发者快速定位LLM工作流中的性能瓶颈与故障根因。
Open Source
Developer Tools
GitHub
Tech
AI可观测性
LLM监控
OpenTelemetry
提示词追踪
Token计量
延迟分析
错误追踪
模型调用追踪
开发者工具
生产环境
用户评论摘要:用户高度关注数据安全与Redaction机制,追问PII是否可在导出前按字段清洗;质疑“成功但错误”的静默故障难以捕获,建议用内容指纹(如文档ID哈希)替代全文存储;同时强烈要求MCP工具调用作为一等span,支持嵌套子span及成本属性归因,而非挂载JSON blob。
AI 锐评
TraceLLM踩准了LLM应用从“演示”到“生产”的痛感转换点:当应用开始承受真实流量,开发者发现传统的APM工具对“提示词-模型-工具”这一新调用链几乎失明。其Otel原生导出与工具Span设计直指行业短板,尤其是将工具调用从JSON blob中解放出来,并支持嵌套与成本归因,这在主流观测产品中并不常见。
但评论区的拷问远比功能列表更残酷。其一,安全与合规不是后置选项,而是能否通过企业采购的第一道闸门。尽管宣称“可配置”,但默认关闭的Grounding捕获会让最需要排查的“自信错误”完全不可见——这是产品逻辑的内在矛盾:你越是保护数据,越可能在故障发生时失去唯一线索。其二,用户提出的“内容指纹”方案(哈希文档ID与工具参数)是更为务实的折中,既能证明上下文一致性,又规避敏感数据出境,这值得TraceLLM在下个版本中作为一等公民内置,而非停留在SIG。其三,OTLP导出看似中立,实则将筛选、脱敏、保留策略的合规负担全部转嫁给运维端,若不能在SDK层提供精细的字段级Redaction策略,其“生产可用”的叙事将止步于安全评审。
产品目前更像一个高效的数据管道,而非智能诊断中枢。若不能在“幻觉归因”或“异常漂移检测”上提供超越传统trace的语义分析能力,它很容易被SigNoz或Honeycomb等平台通过插件生态模仿并吞噬。建议团队将Roadmap聚焦于:一是提供内容无关的语义指纹能力,二是打通成本与根因的因果关联,三是将MCP工具链的自动埋点从路线图提到当前迭代——这三点才是它区别于通用Tracing的护城河。
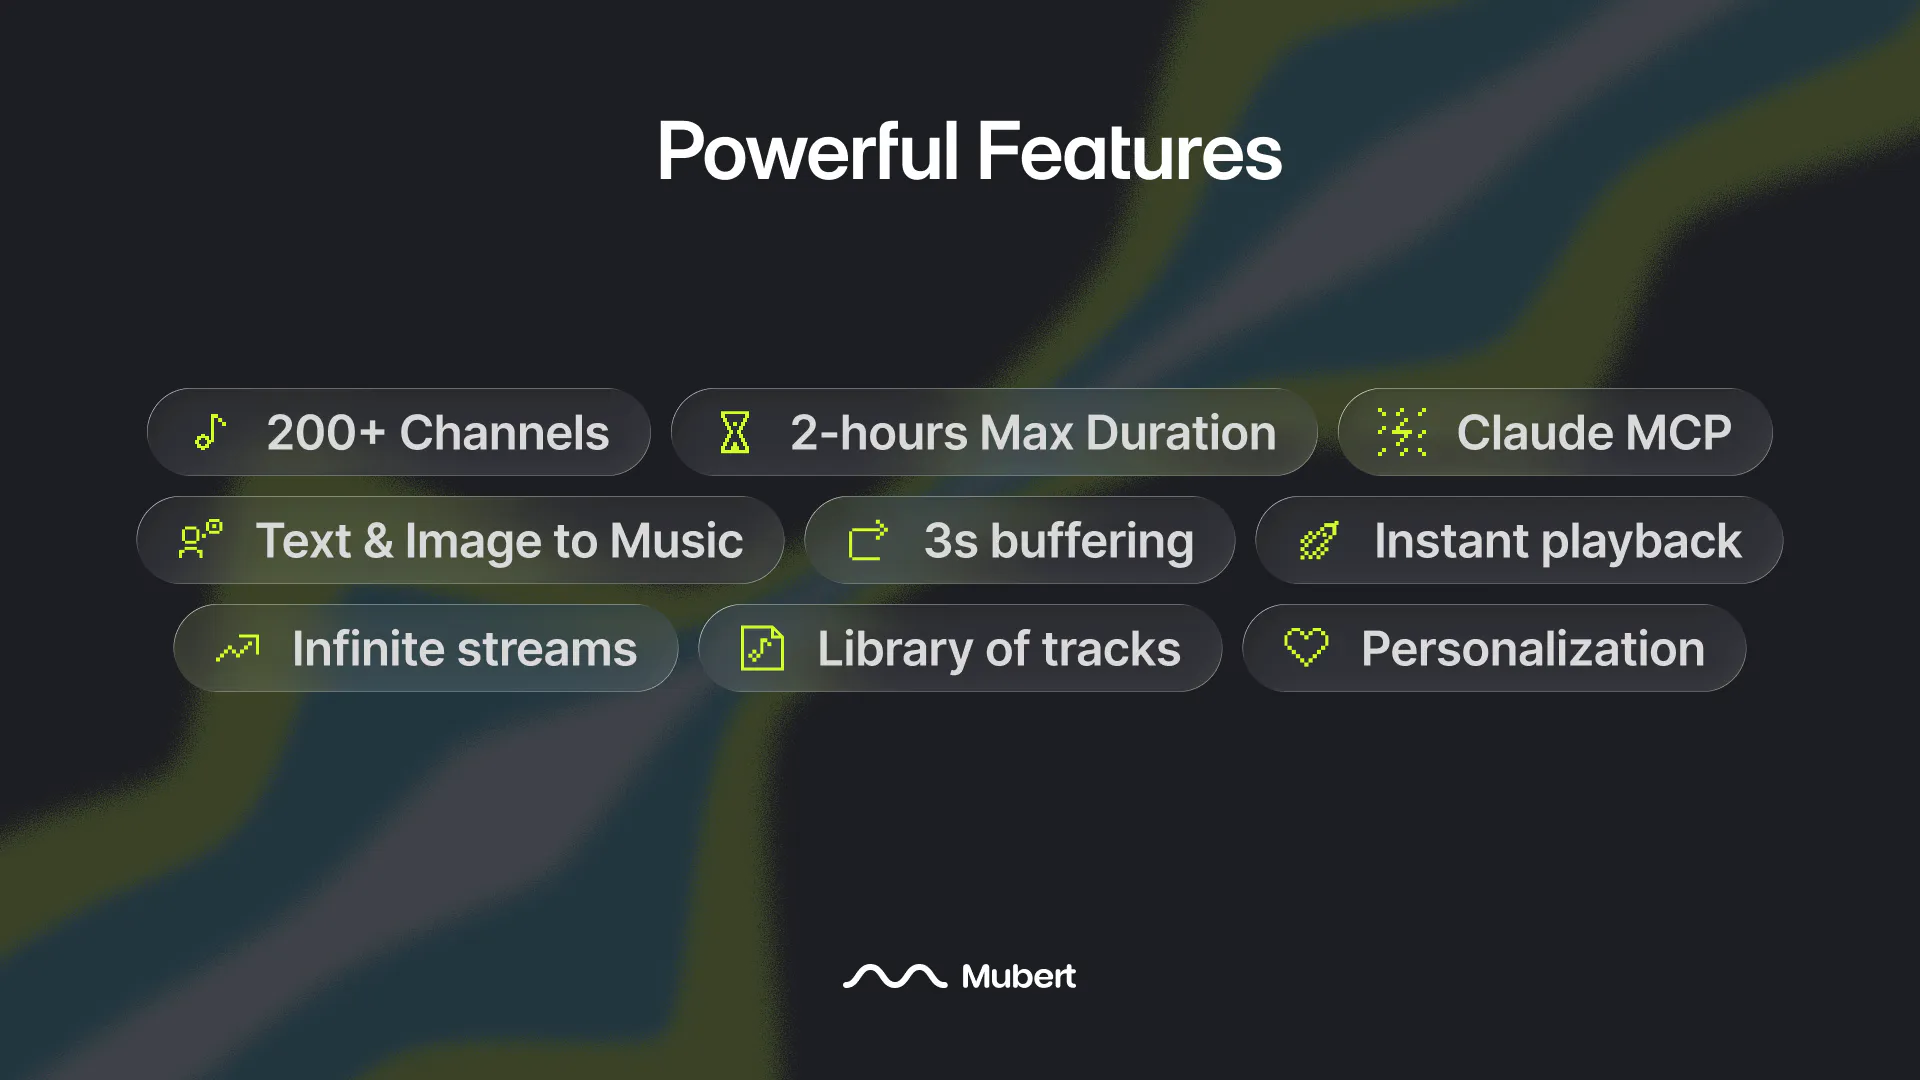
一句话介绍:Mubert API 通过全新引擎让开发者能在几分钟内将可编辑、可混音、最长两小时的实时生成音乐能力集成进自己的产品,解决了生成音乐“不可控、不可改、无法商用”的核心痛点。
Music
API
Artificial Intelligence
音乐生成API
AI音乐编辑
分轨混音
实时音乐流
开发者工具
商用音乐授权
生成式AI
音频工作流
Claude/Codex Skill
用户评论摘要:用户关注点集中在:1) 实时stem替换的响应时间;2) 同一seed和提示词跨时间的确定性与引擎版本锁定(可追溯、不可变资产);3) 编辑后输出的版权归属和商用授权边界(是否覆盖客户项目)。多数评论认可“可编辑音乐”是行业进步,但对API的契约稳定性提出质疑。
AI 锐评
Mubert API这次更新表面上卖的是“更一致的引擎”和“2小时长音频”,但评论区已经替它把真正的价值说透了:把AI音乐从“老虎机”变成了“可编辑资产”。这确实是质变——当你能单独静音或替换一个鼓组声部而不必把整首歌推倒重来,音乐生成才从玩具跨进了生产力工具的阵营,而“针对特定用途快速集成”的路线也符合开发者预期。
然而,真正决定它能否进入严肃商业市场的是评论中反复出现的两个字:确定性。目前评论区有一条灵魂拷问几乎戳穿了行业通病——引擎版本更新后,同一seed生成的音乐“更好”了,但这对需要维持一致性的品牌客户来说是灾难。如果生成的资产不能被永远寻址获取,如果引擎版本不能被pinning锁定,那么所有“编辑”功能都是建立在流沙之上。一个能随时改变你历史资产面貌的API,无法支撑任何长期内容战略。
另一个被轻描淡写的问题是版权。官方用“copyright-protected”这个模糊话术,但评论区对商用场景的追问极其精准:如果你生成音乐并交付给付费客户,版权究竟归谁?被用户编辑过的派生作品,Mubert是否保留权利主张?在API的定价和授权条款未公开透明之前,这种模糊性会直接促使企业级用户选择自托管模型——这恰恰是评论区有人走过的弯路。
最后说说真正的护城河。Stem编辑、2小时生成、实时流都是可以被竞争对手快速复制的功能,而不可变资产寻址、引擎版本快照、商用输出版权明确归属这三个看似无聊的工程细节,才是决定开发者敢不敢把它嵌入核心产品生命周期的地基。Mubert现在最紧迫的任务不是继续吹嘘音频质量,而是尽快发布一份“资产存取可追溯+引擎版本可锁定+版权责任白纸黑字”的技术承诺契约。否则,它注定只是又一款优秀的AI玩具,而非创作者经济的基建。
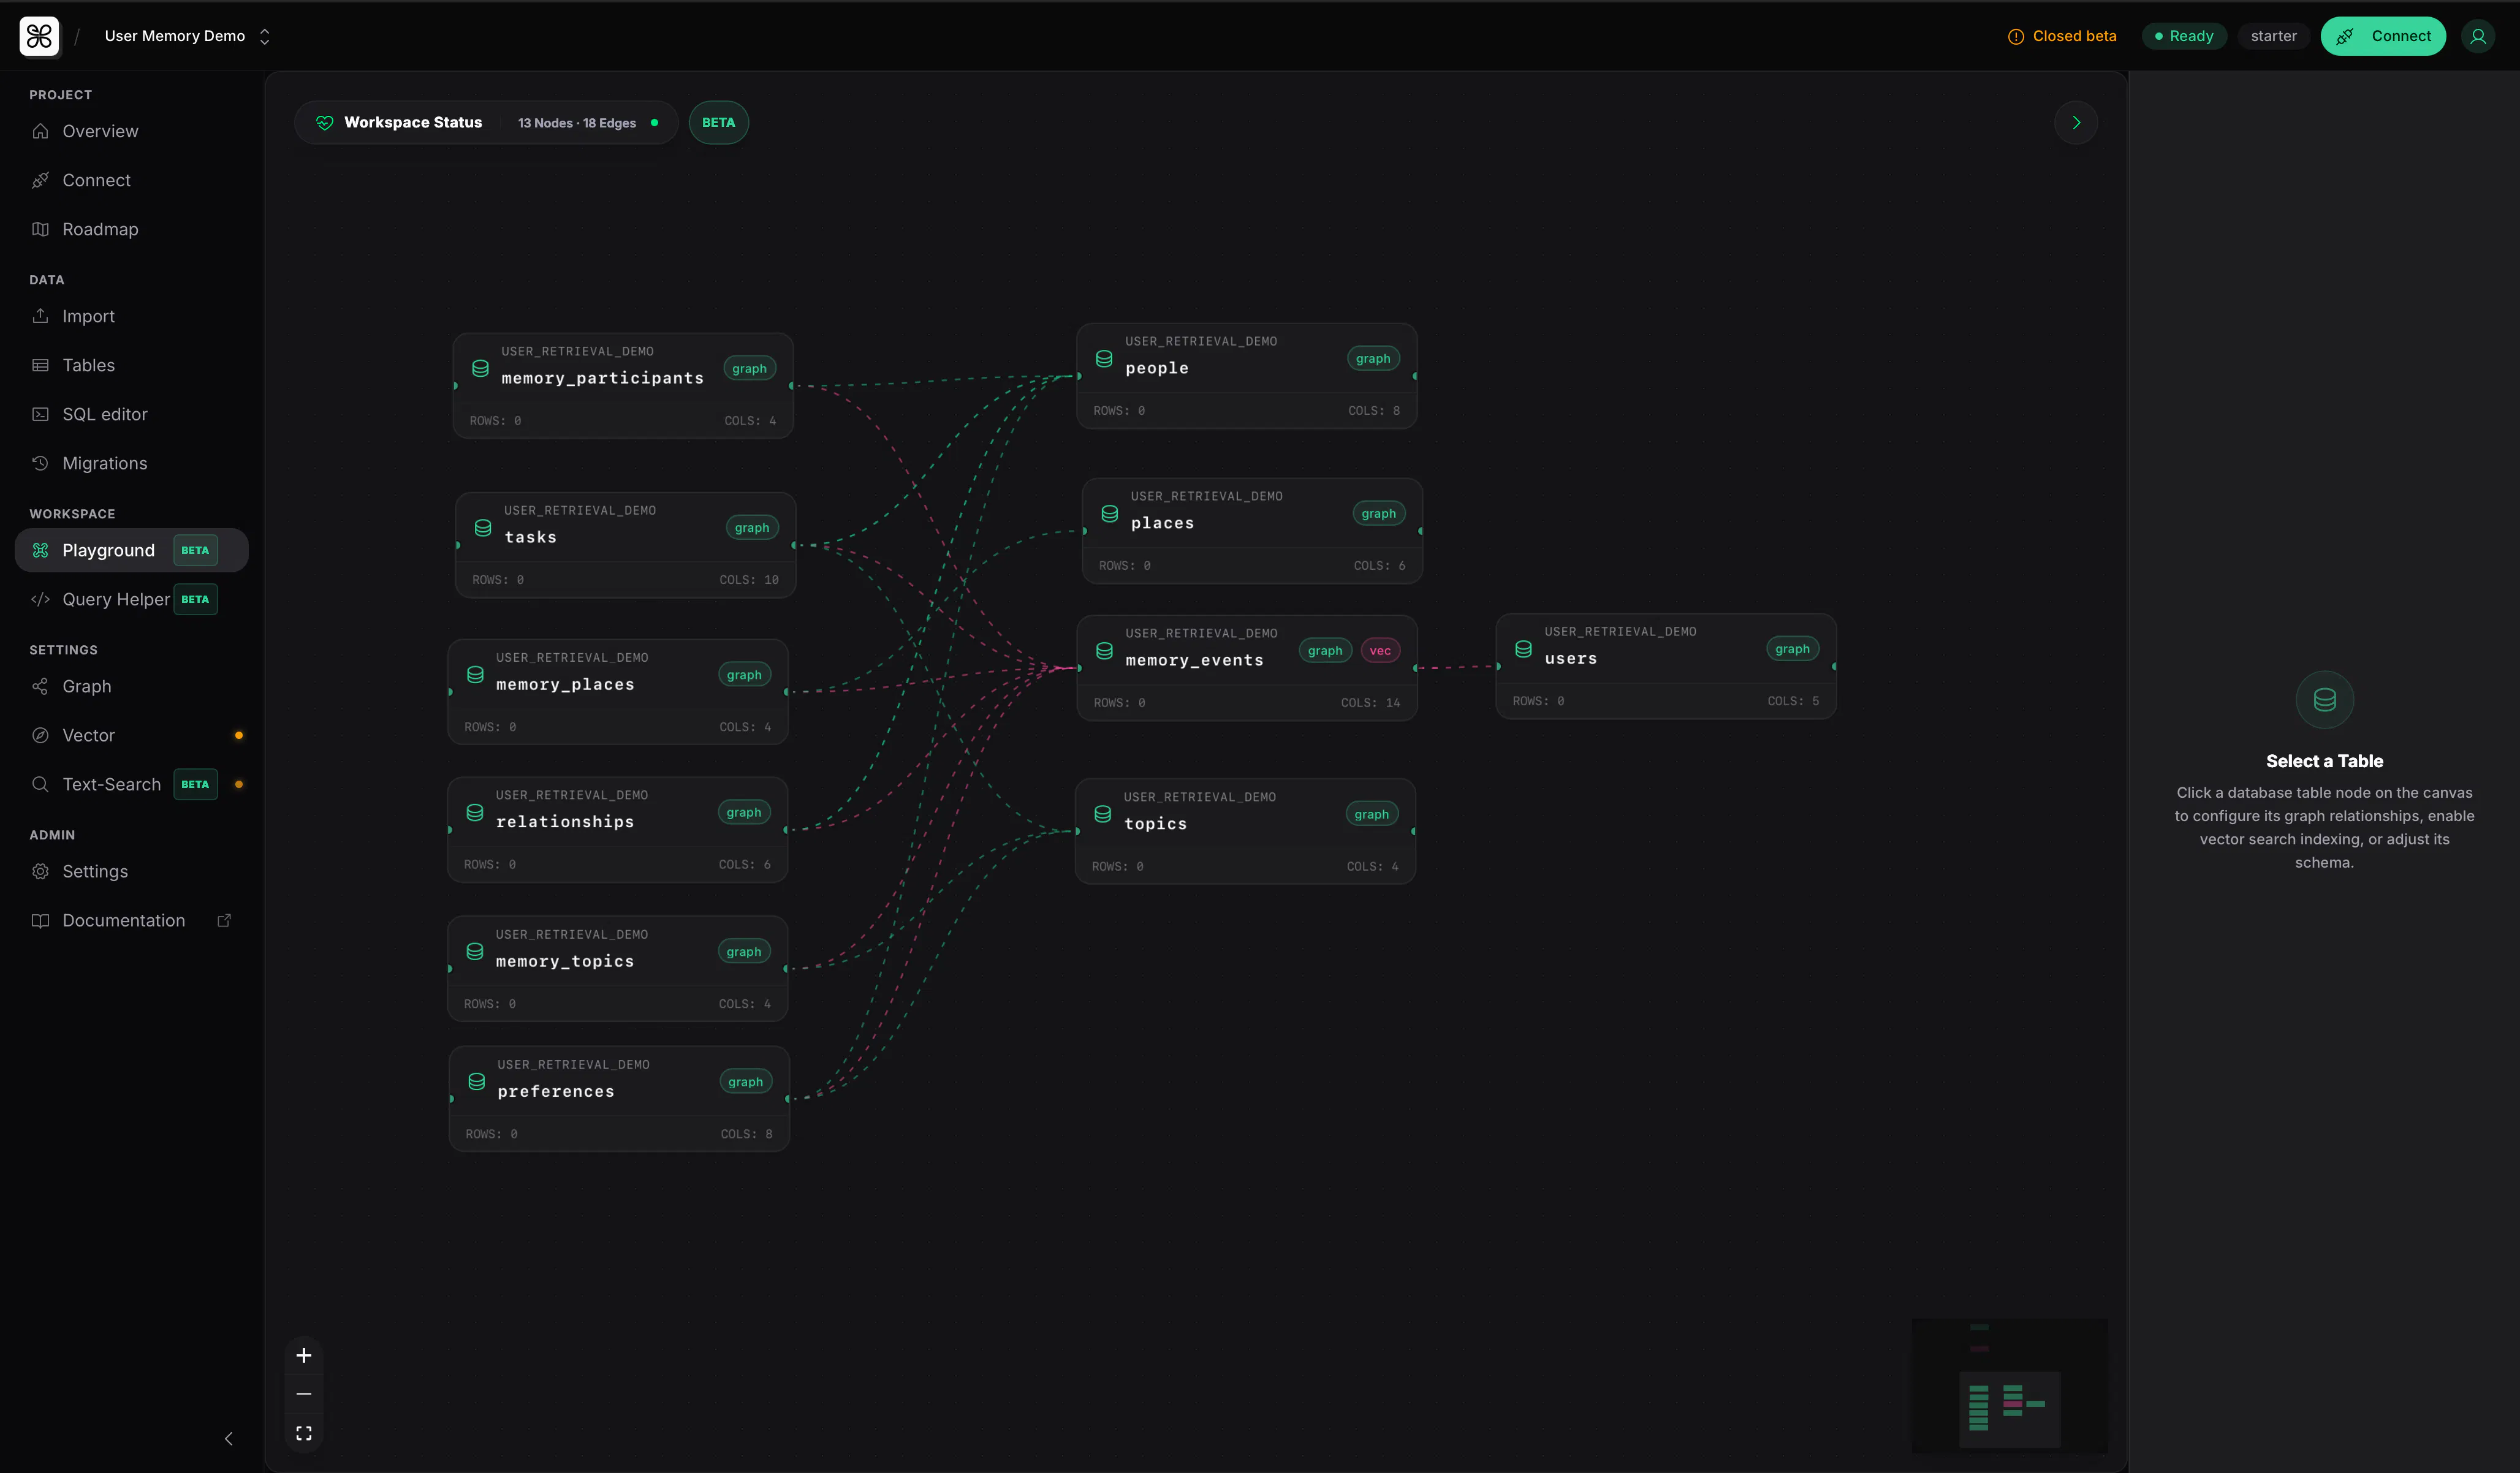
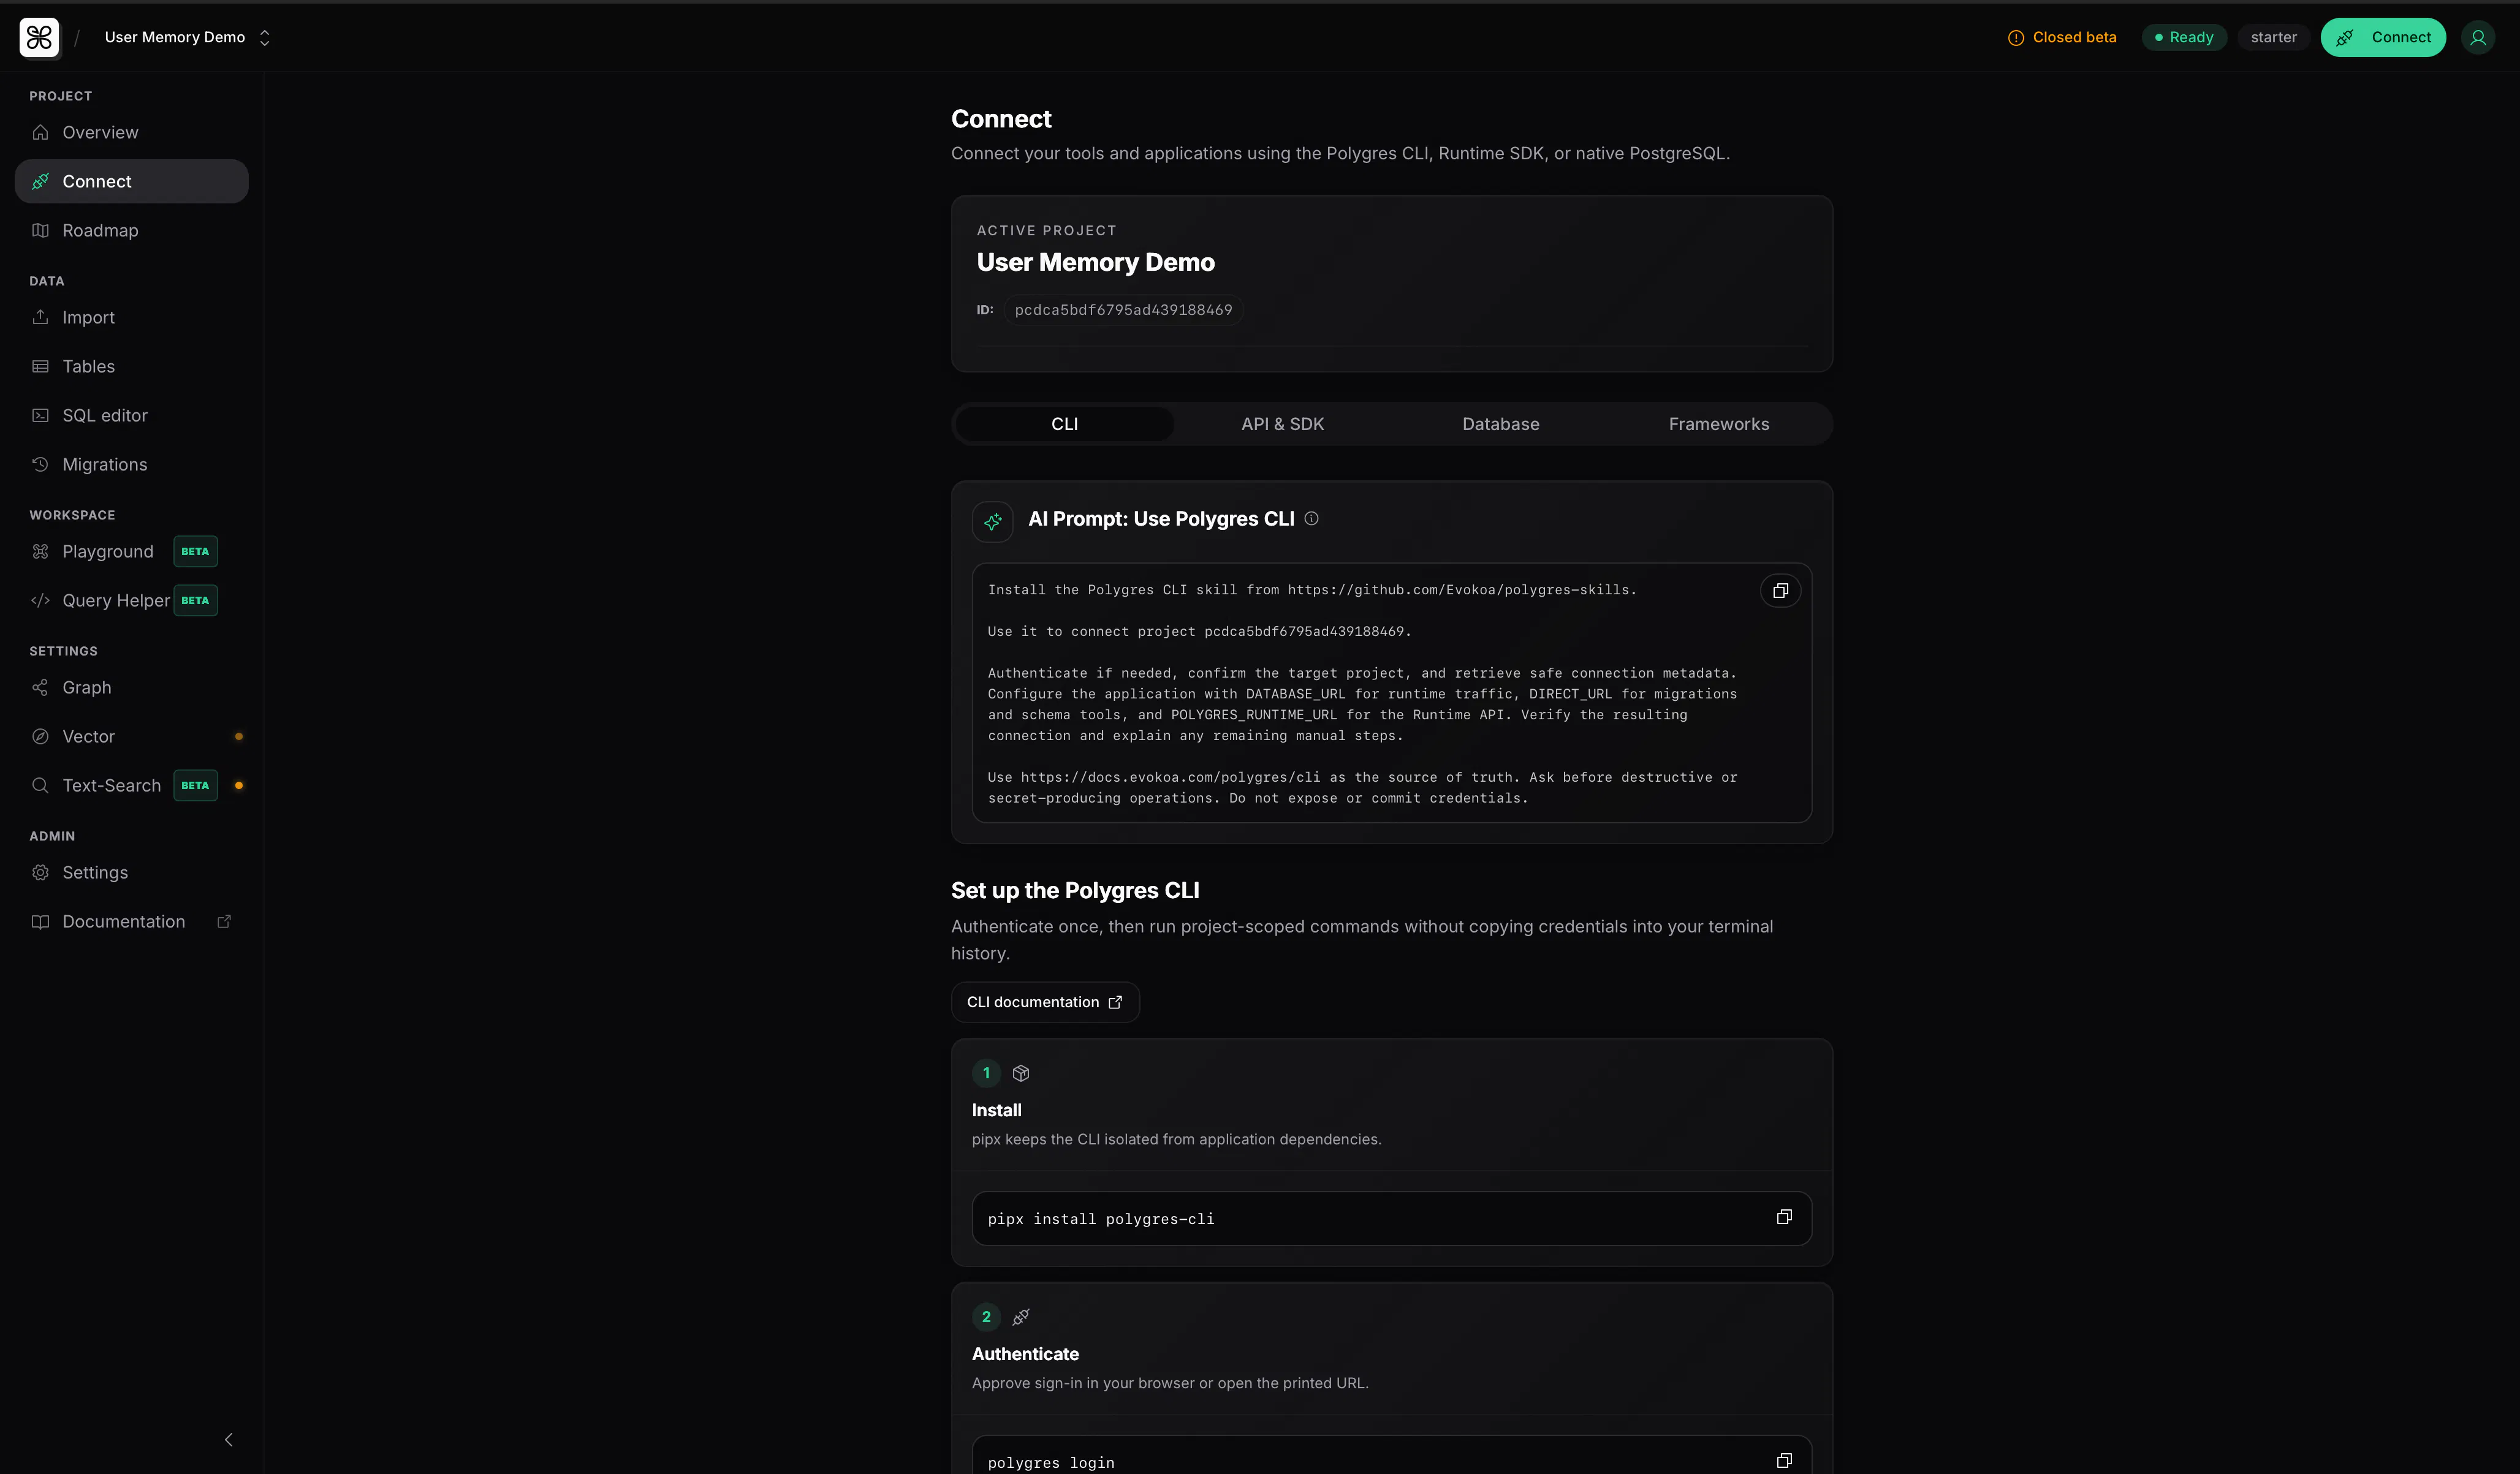
一句话介绍:Polygres将Postgres数据库直接转化为AI代理的“工作记忆”,通过统一的混合API同时检索结构化数据、关系图谱、语义向量和全文结果,省去独立的向量库、图数据库和同步管道,帮助开发者为现有数据快速构建有据可依的AI代理。
Open Source
Developer Tools
GitHub
Database
AI代理记忆
混合检索
Postgres扩展
GraphRAG
向量搜索
开发者工具
数据基础设施
开源组件
MCP集成
无限上下文
用户评论摘要:用户赞扬其消除同步管道、降低上下文成本的思路。核心问题集中在:检索速度(官方回复约20-30毫秒);“无限上下文”机制(官方解释为按需动态取数而非真正无限);数据可追溯性(有用户严肃指出需提供行ID、时间戳等“凭证”以支持事后审计);以及能否替代Algolia等专用搜索引擎。
AI 锐评
Polygres的切入点很聪明——它精准命中了当前AI应用开发中最痛的“基础设施缝合”问题。团队没有发明新数据库,而是选择在存量Postgres上做“内存扩展”,这大大降低了采用门槛。“免同步”是最大卖点,但这也正是其技术债务的藏身处。
目前收到的反馈虽热情,但缺乏深度测评数据。官方对“速度20-30ms”的回应偏向营销话术,未说明在数据量级、并发和复杂关系查询下的表现。更值得警惕的是“无限上下文”的定义——它本质是RAG的调度优化,而非技术突破,对“幻觉”和一致性问题没有提供新解法。
最有力的评论来自那位质疑“可复现性”的用户:当AI基于动态数据库做出决策时,如何回溯它当时“看到”了什么?这是所有基于实时数据的AI系统都无法回避的合规与审计问题。如果Polygres能提供类似“检索凭证”的机制(返回时附带行ID、排序、时间戳),它就能从“便利工具”跃升为“企业级可信任基础设施”。
当前定位模糊——既是开发者友好的免费工具,又宣称“企业就绪”。建议团队集中火力啃下“图关系+向量”混合查询的性能优化和审计追踪两块硬骨头,而不是急于宣传“无限”概念。毕竟,开发者会为省时买单,但只有企业会为可追溯性付费。整体方向正确,但距离“生产级”仍有距离,需观察其在这轮热度褪去后的实际留存率。
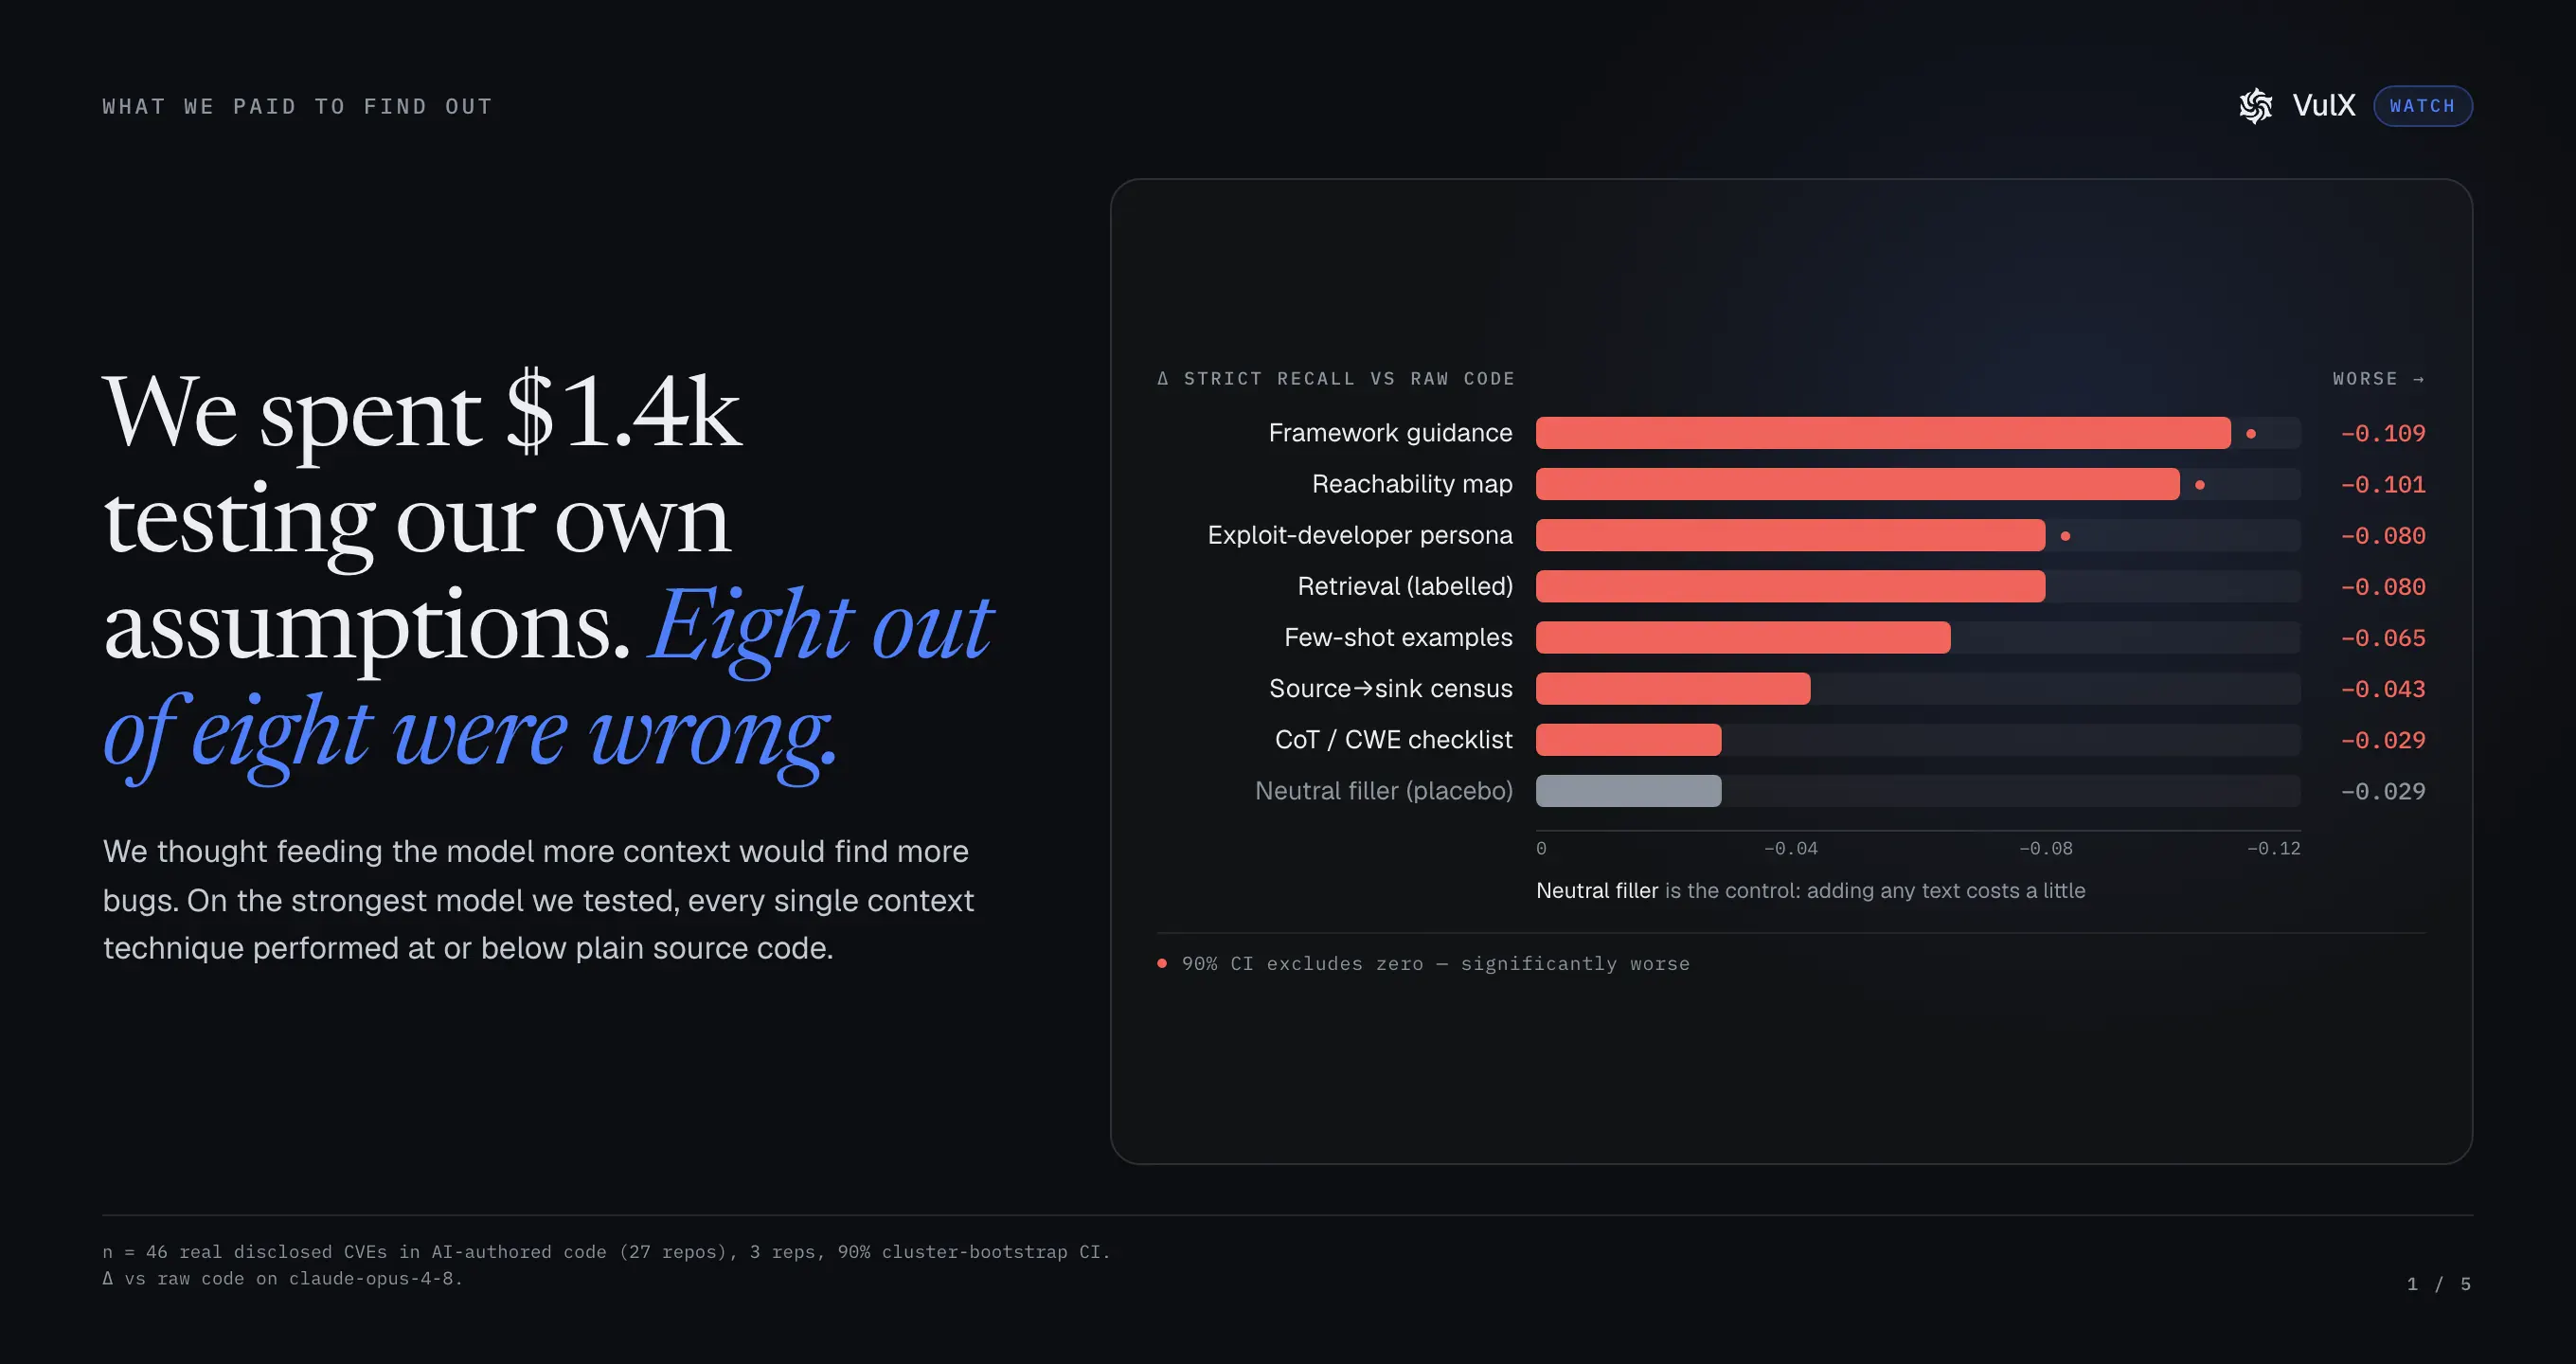
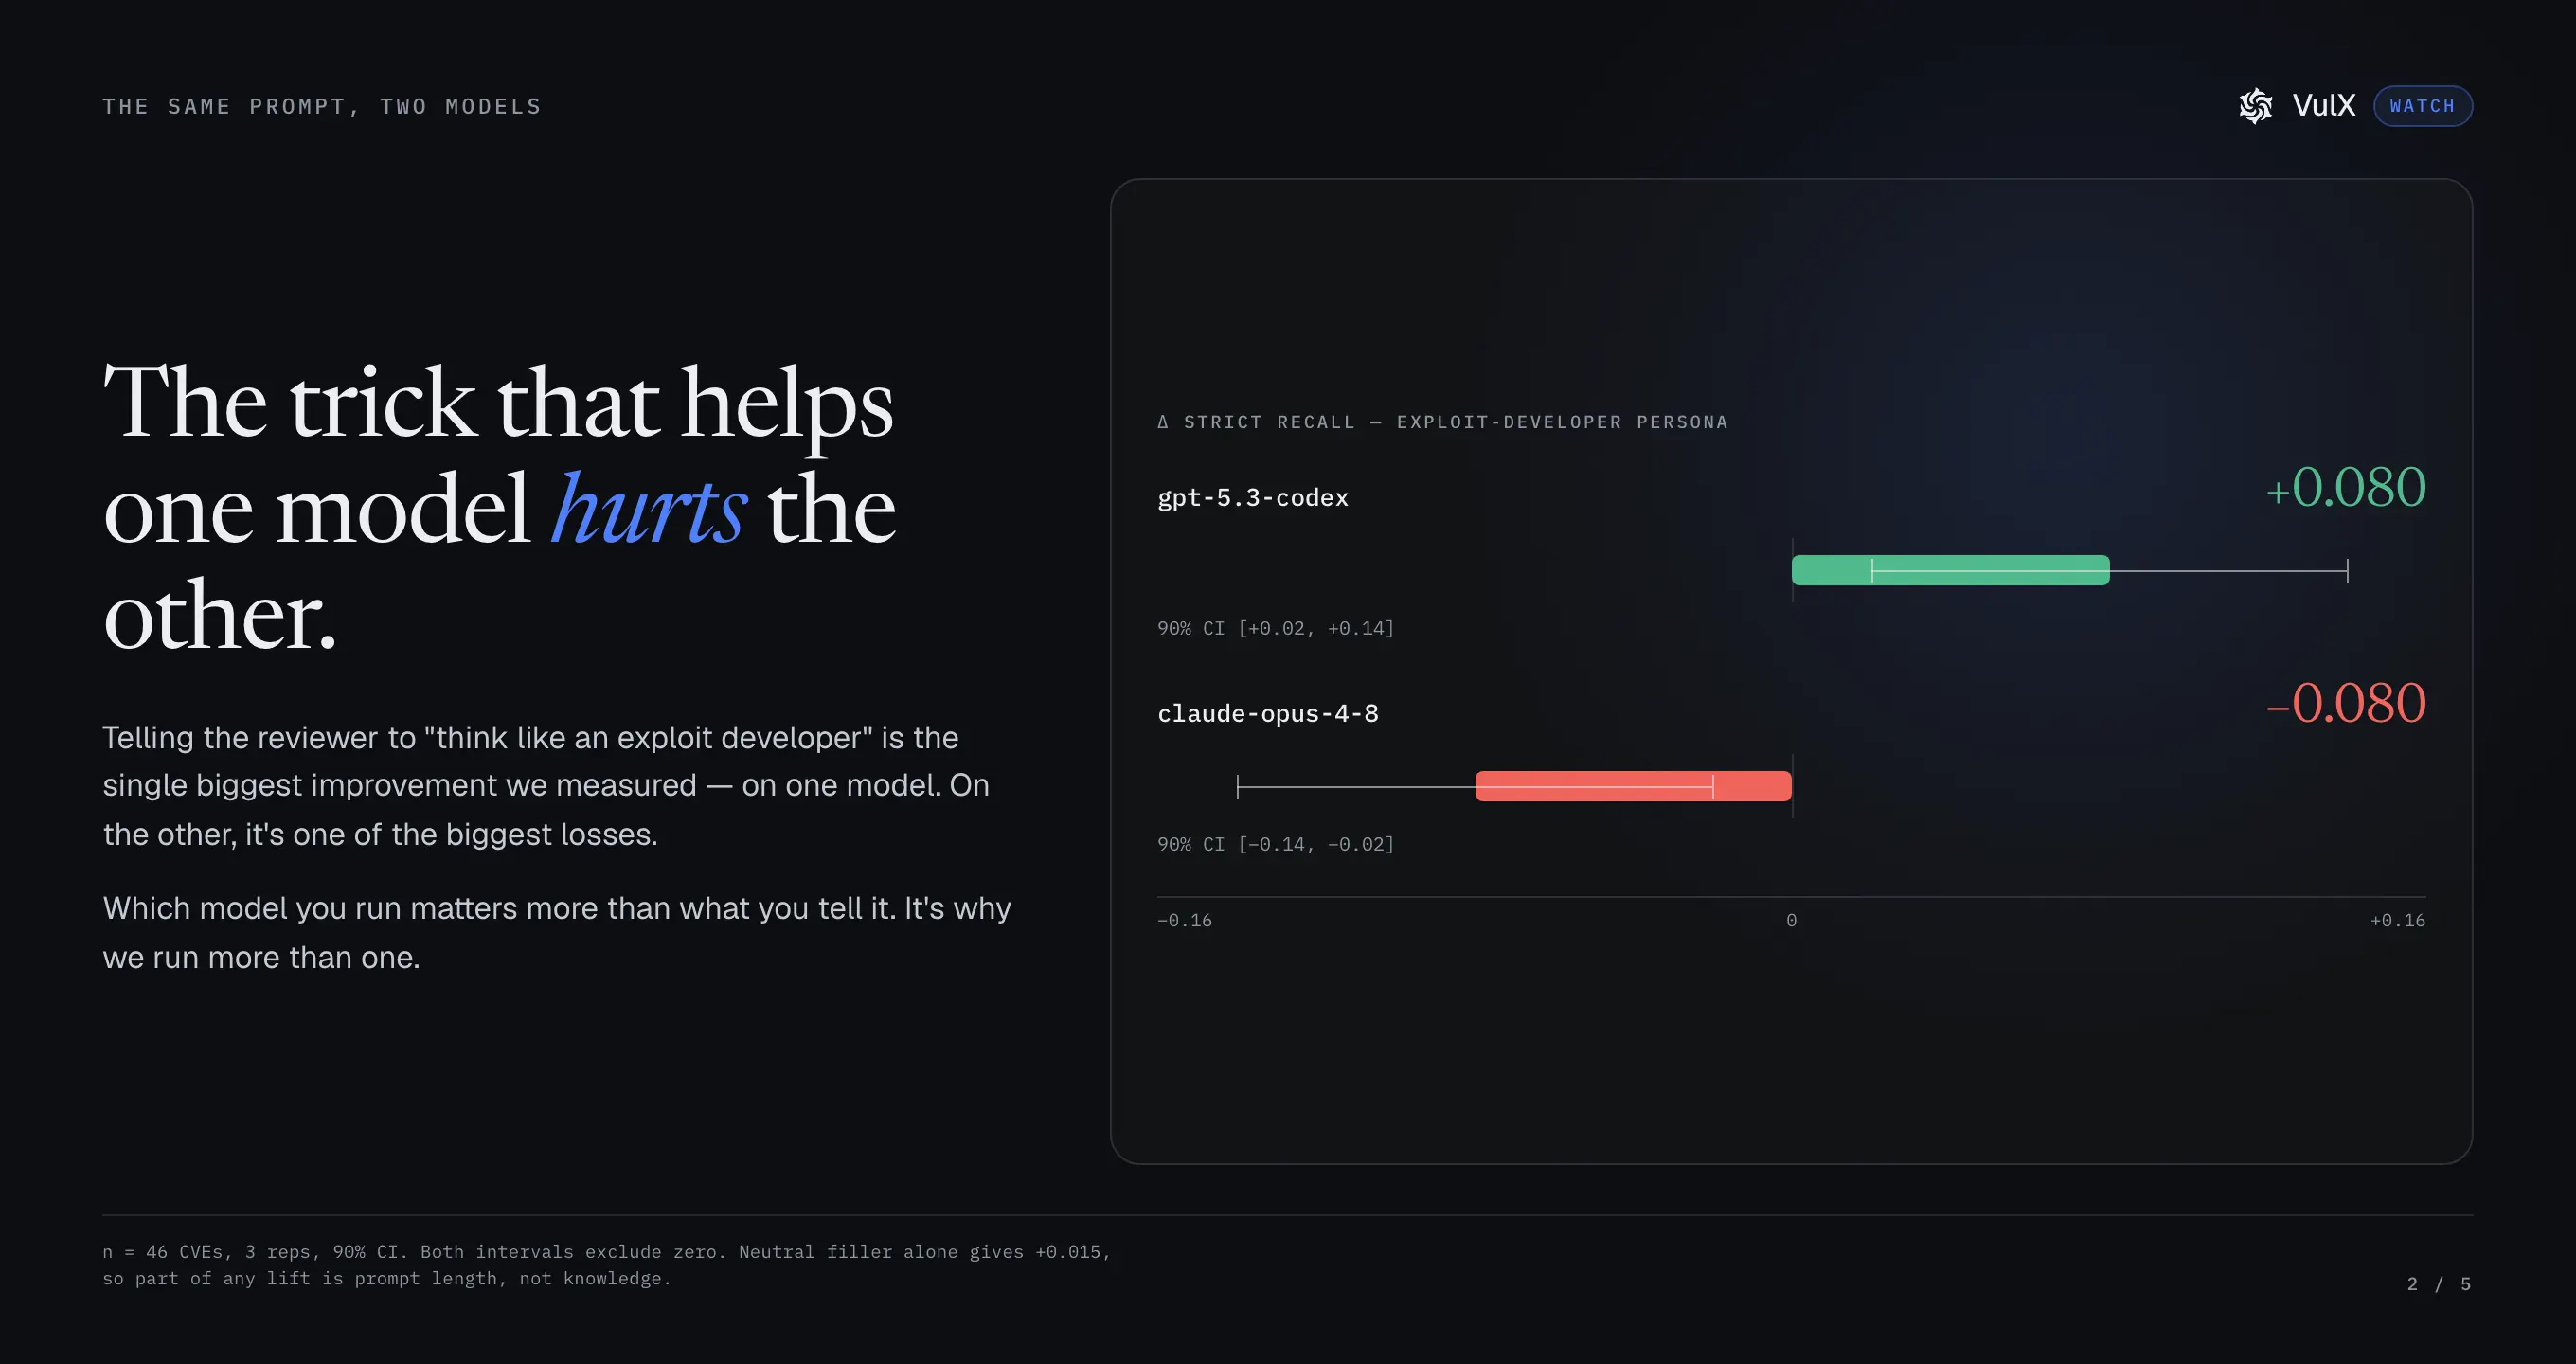
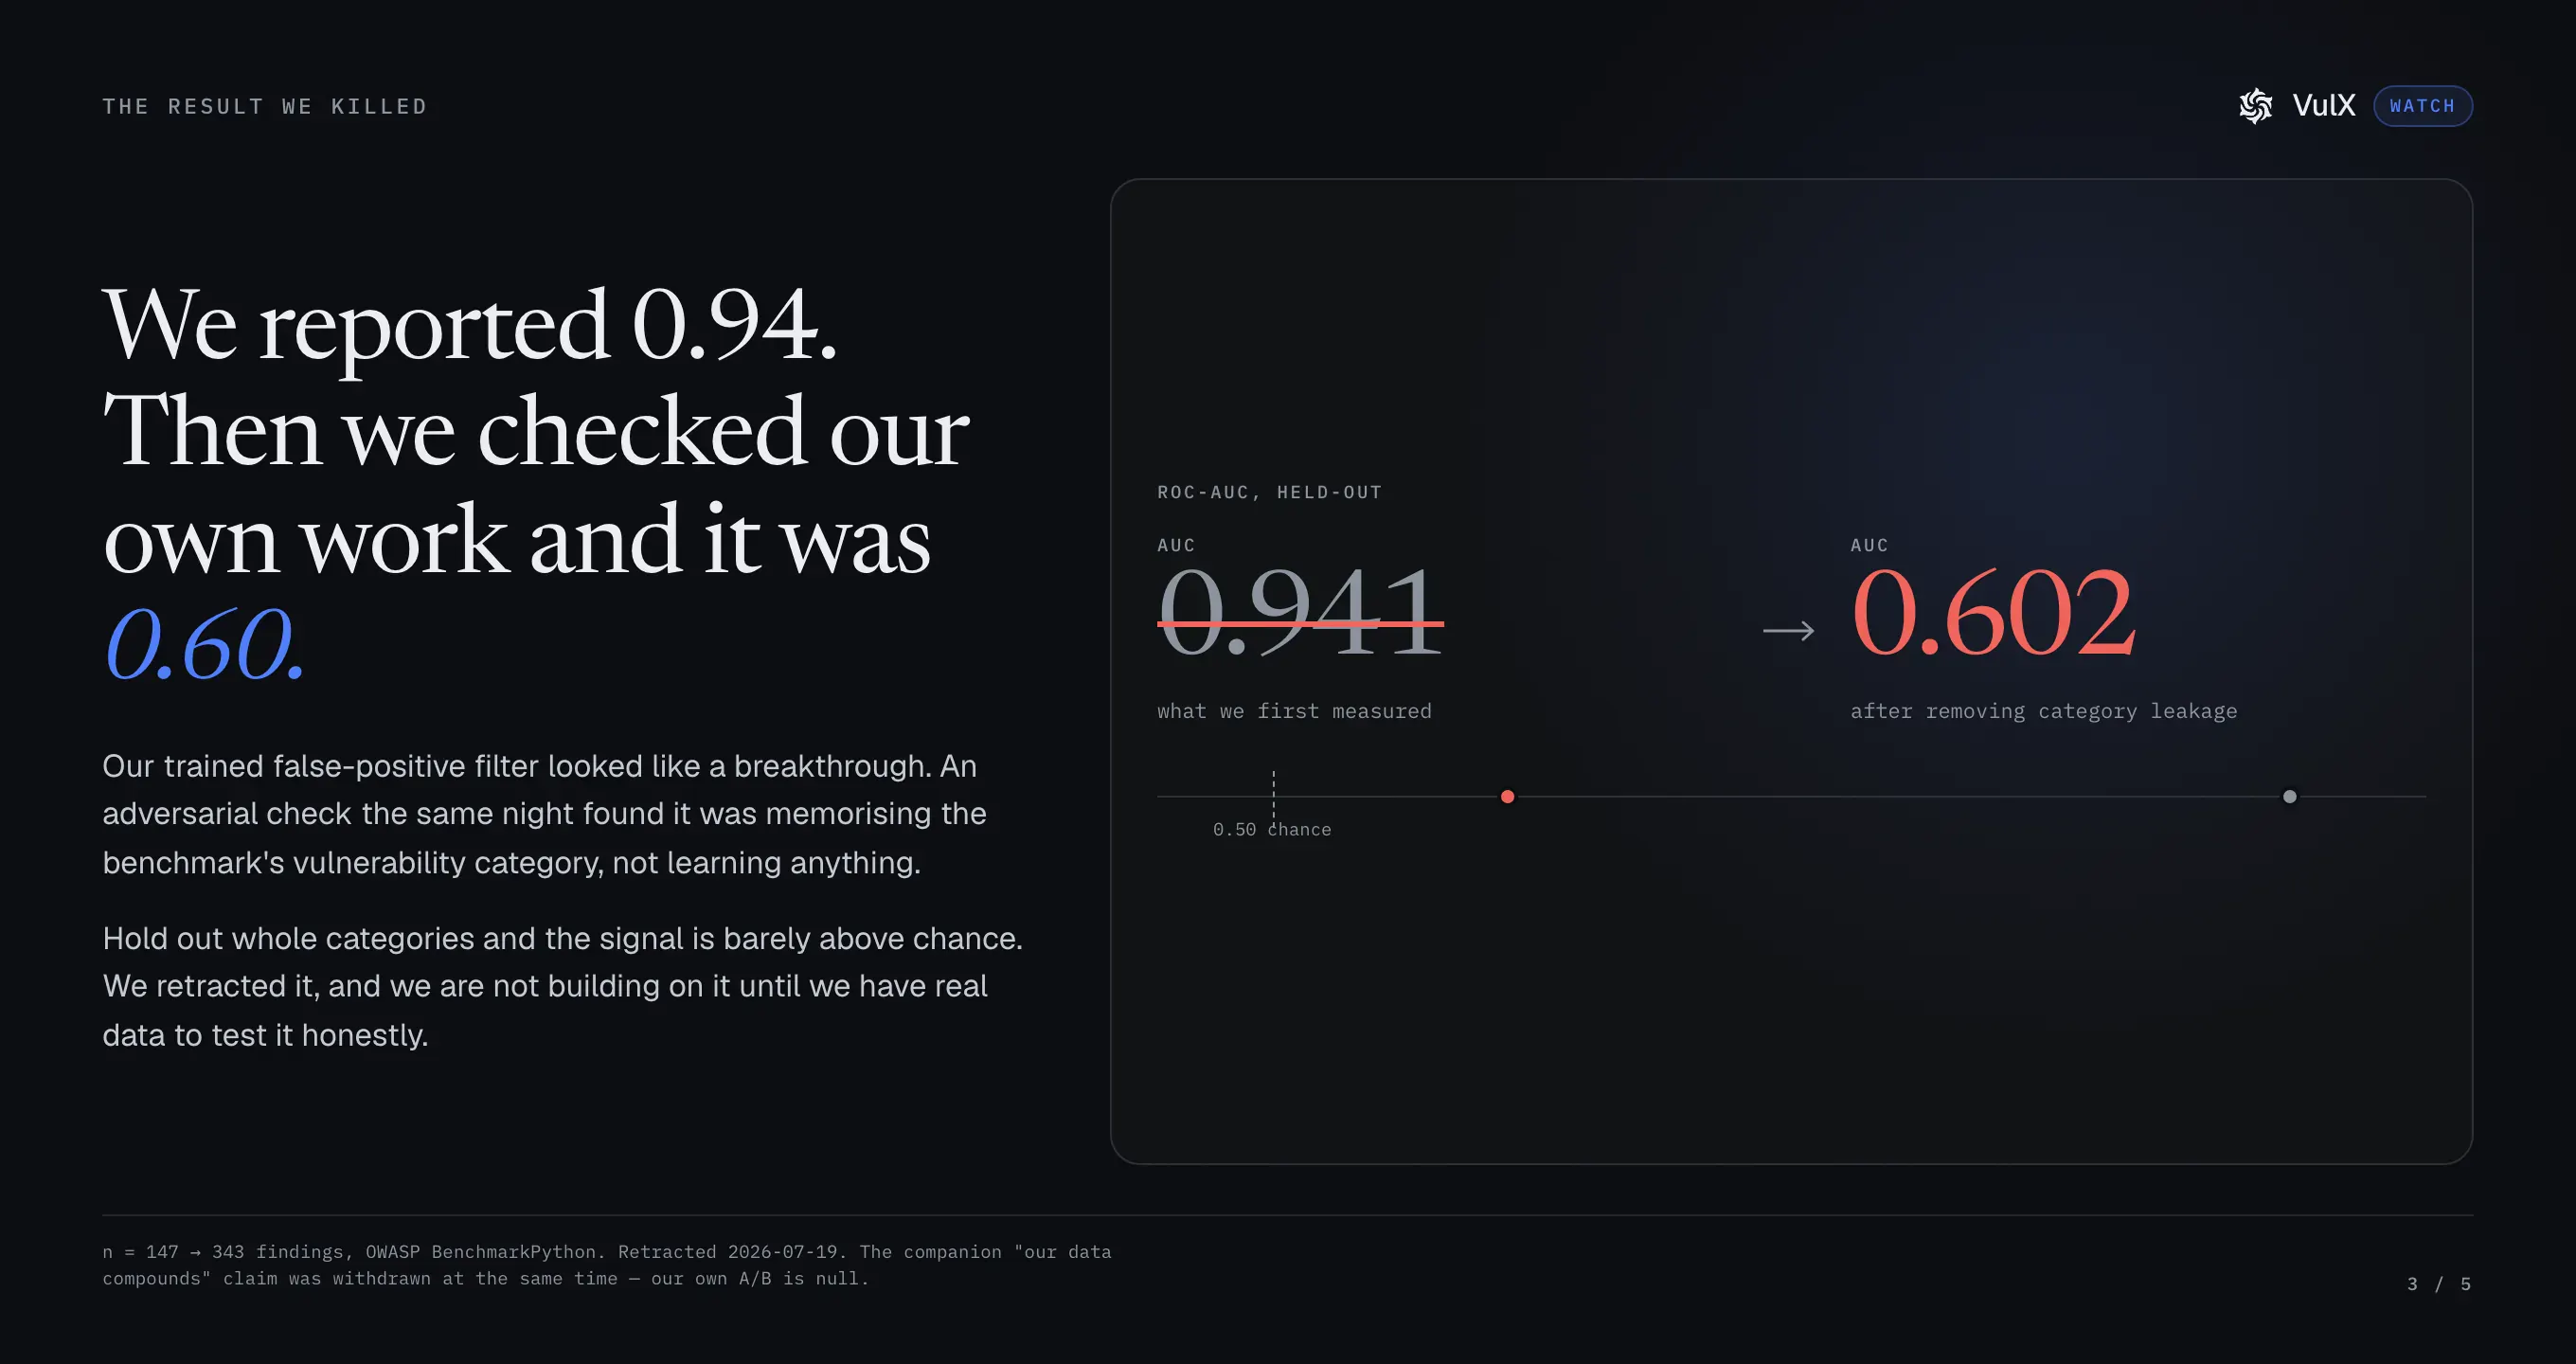
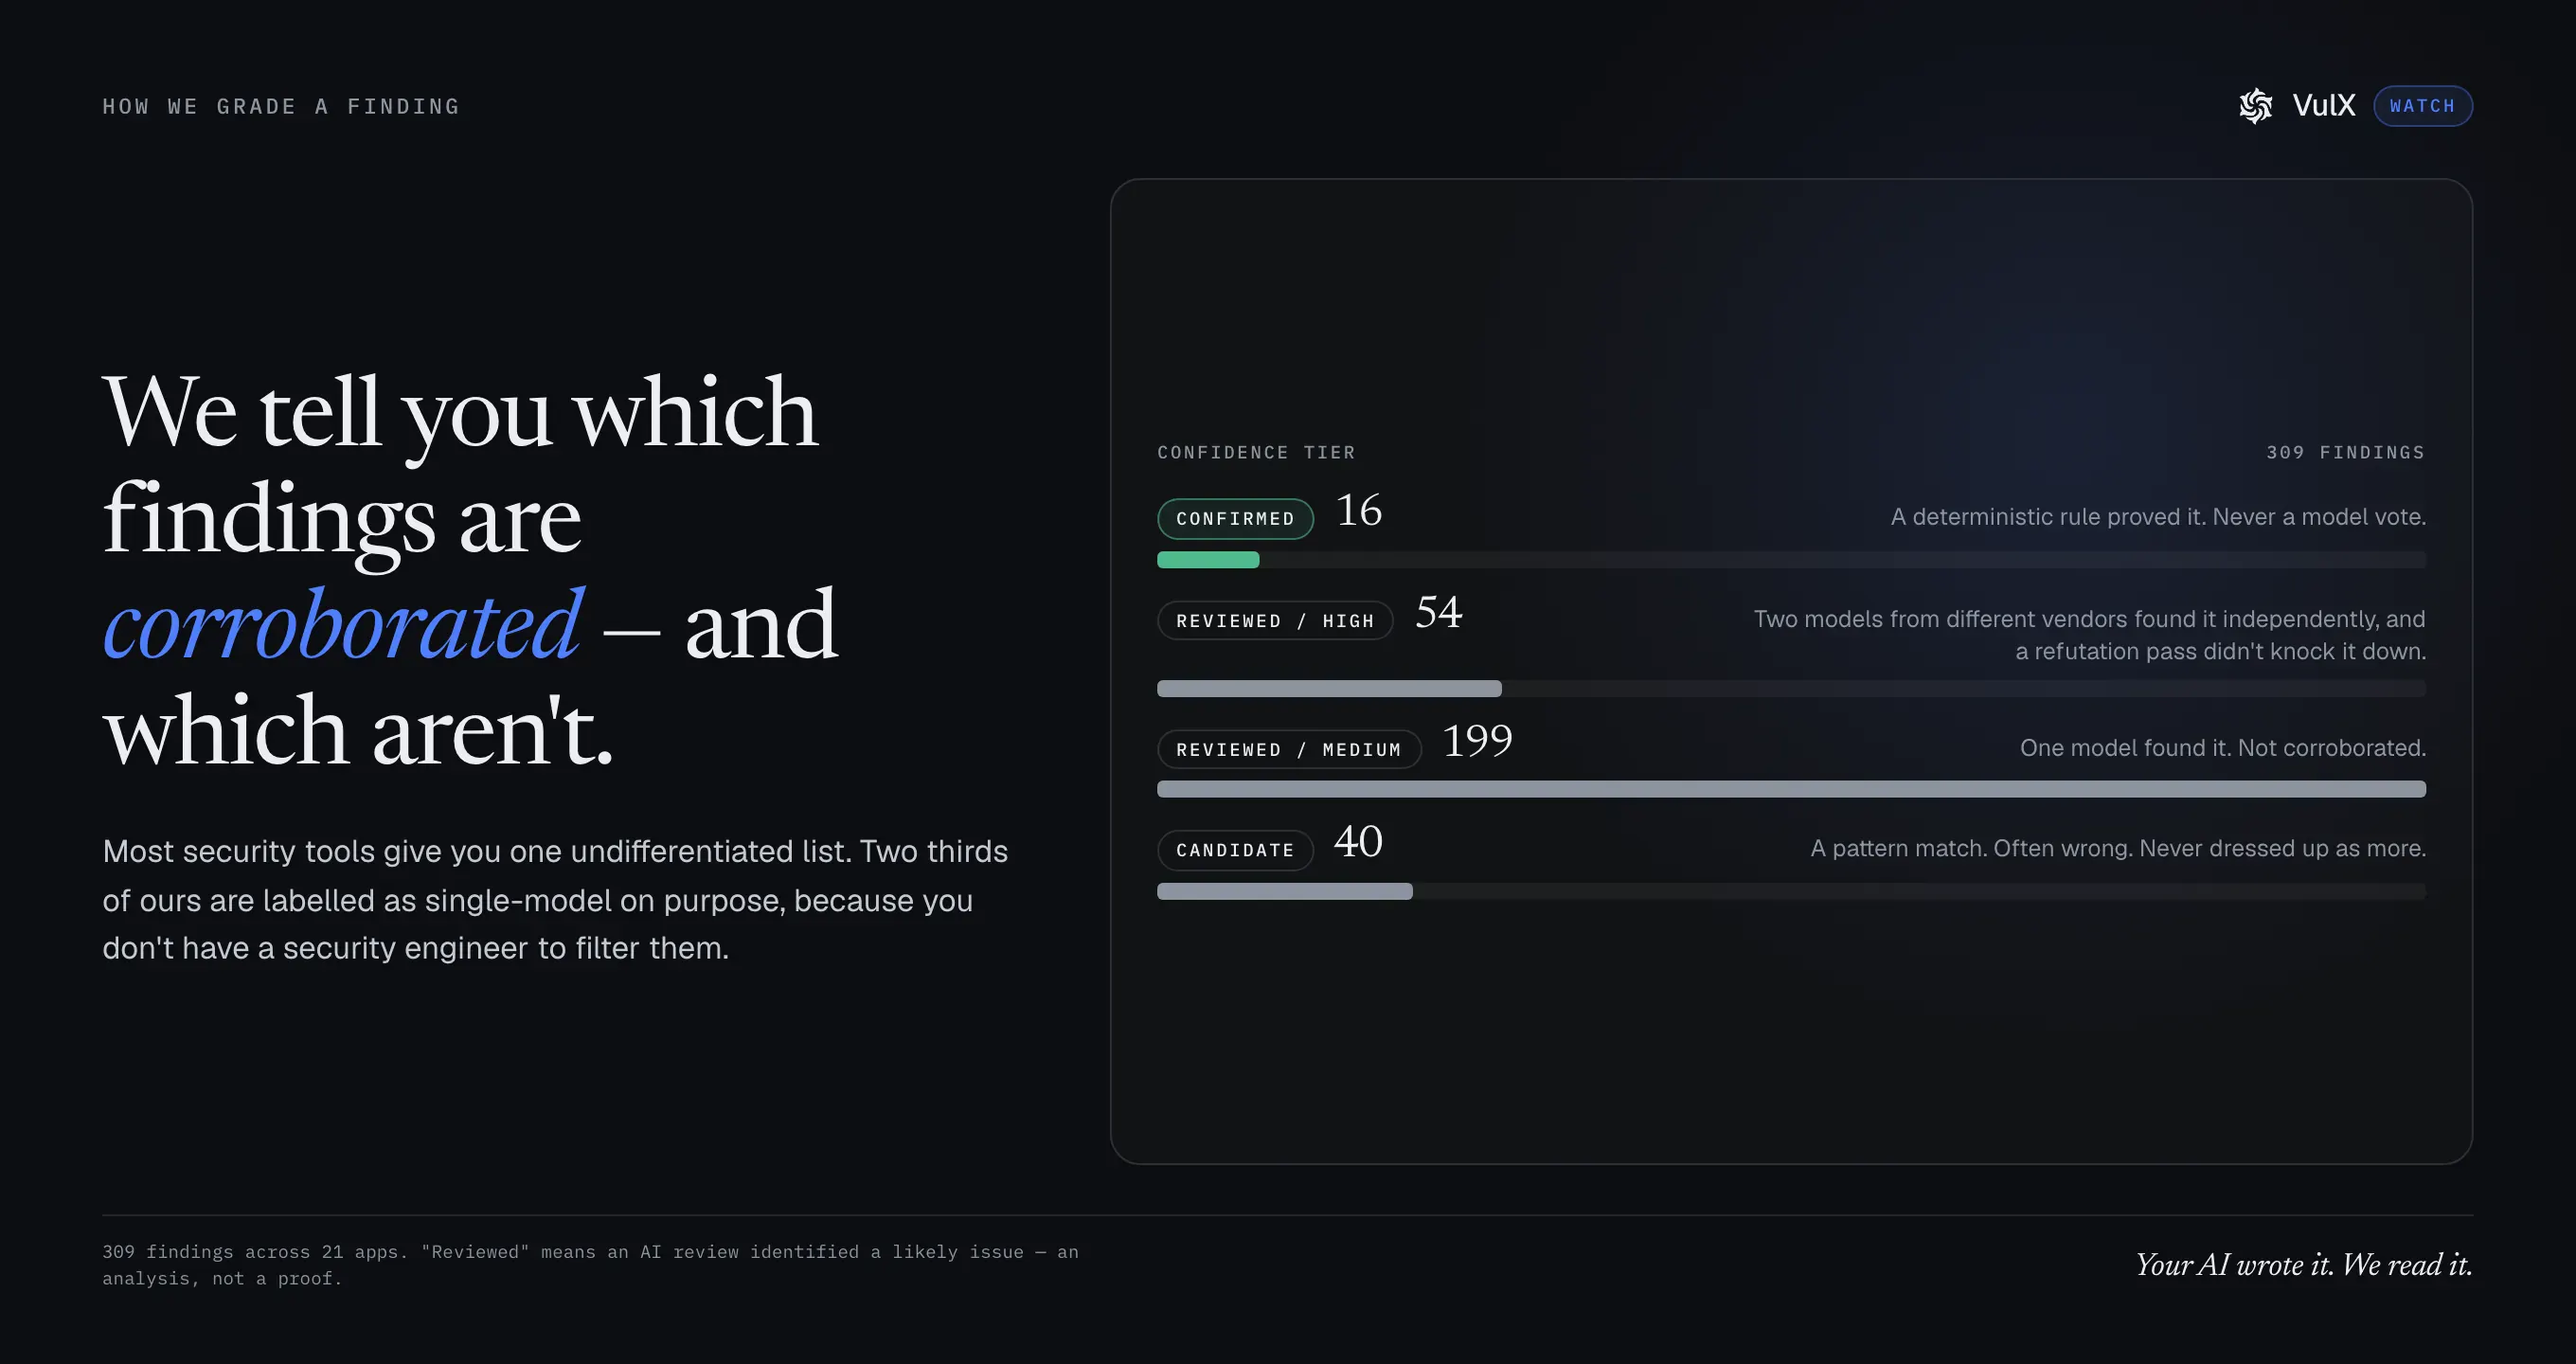
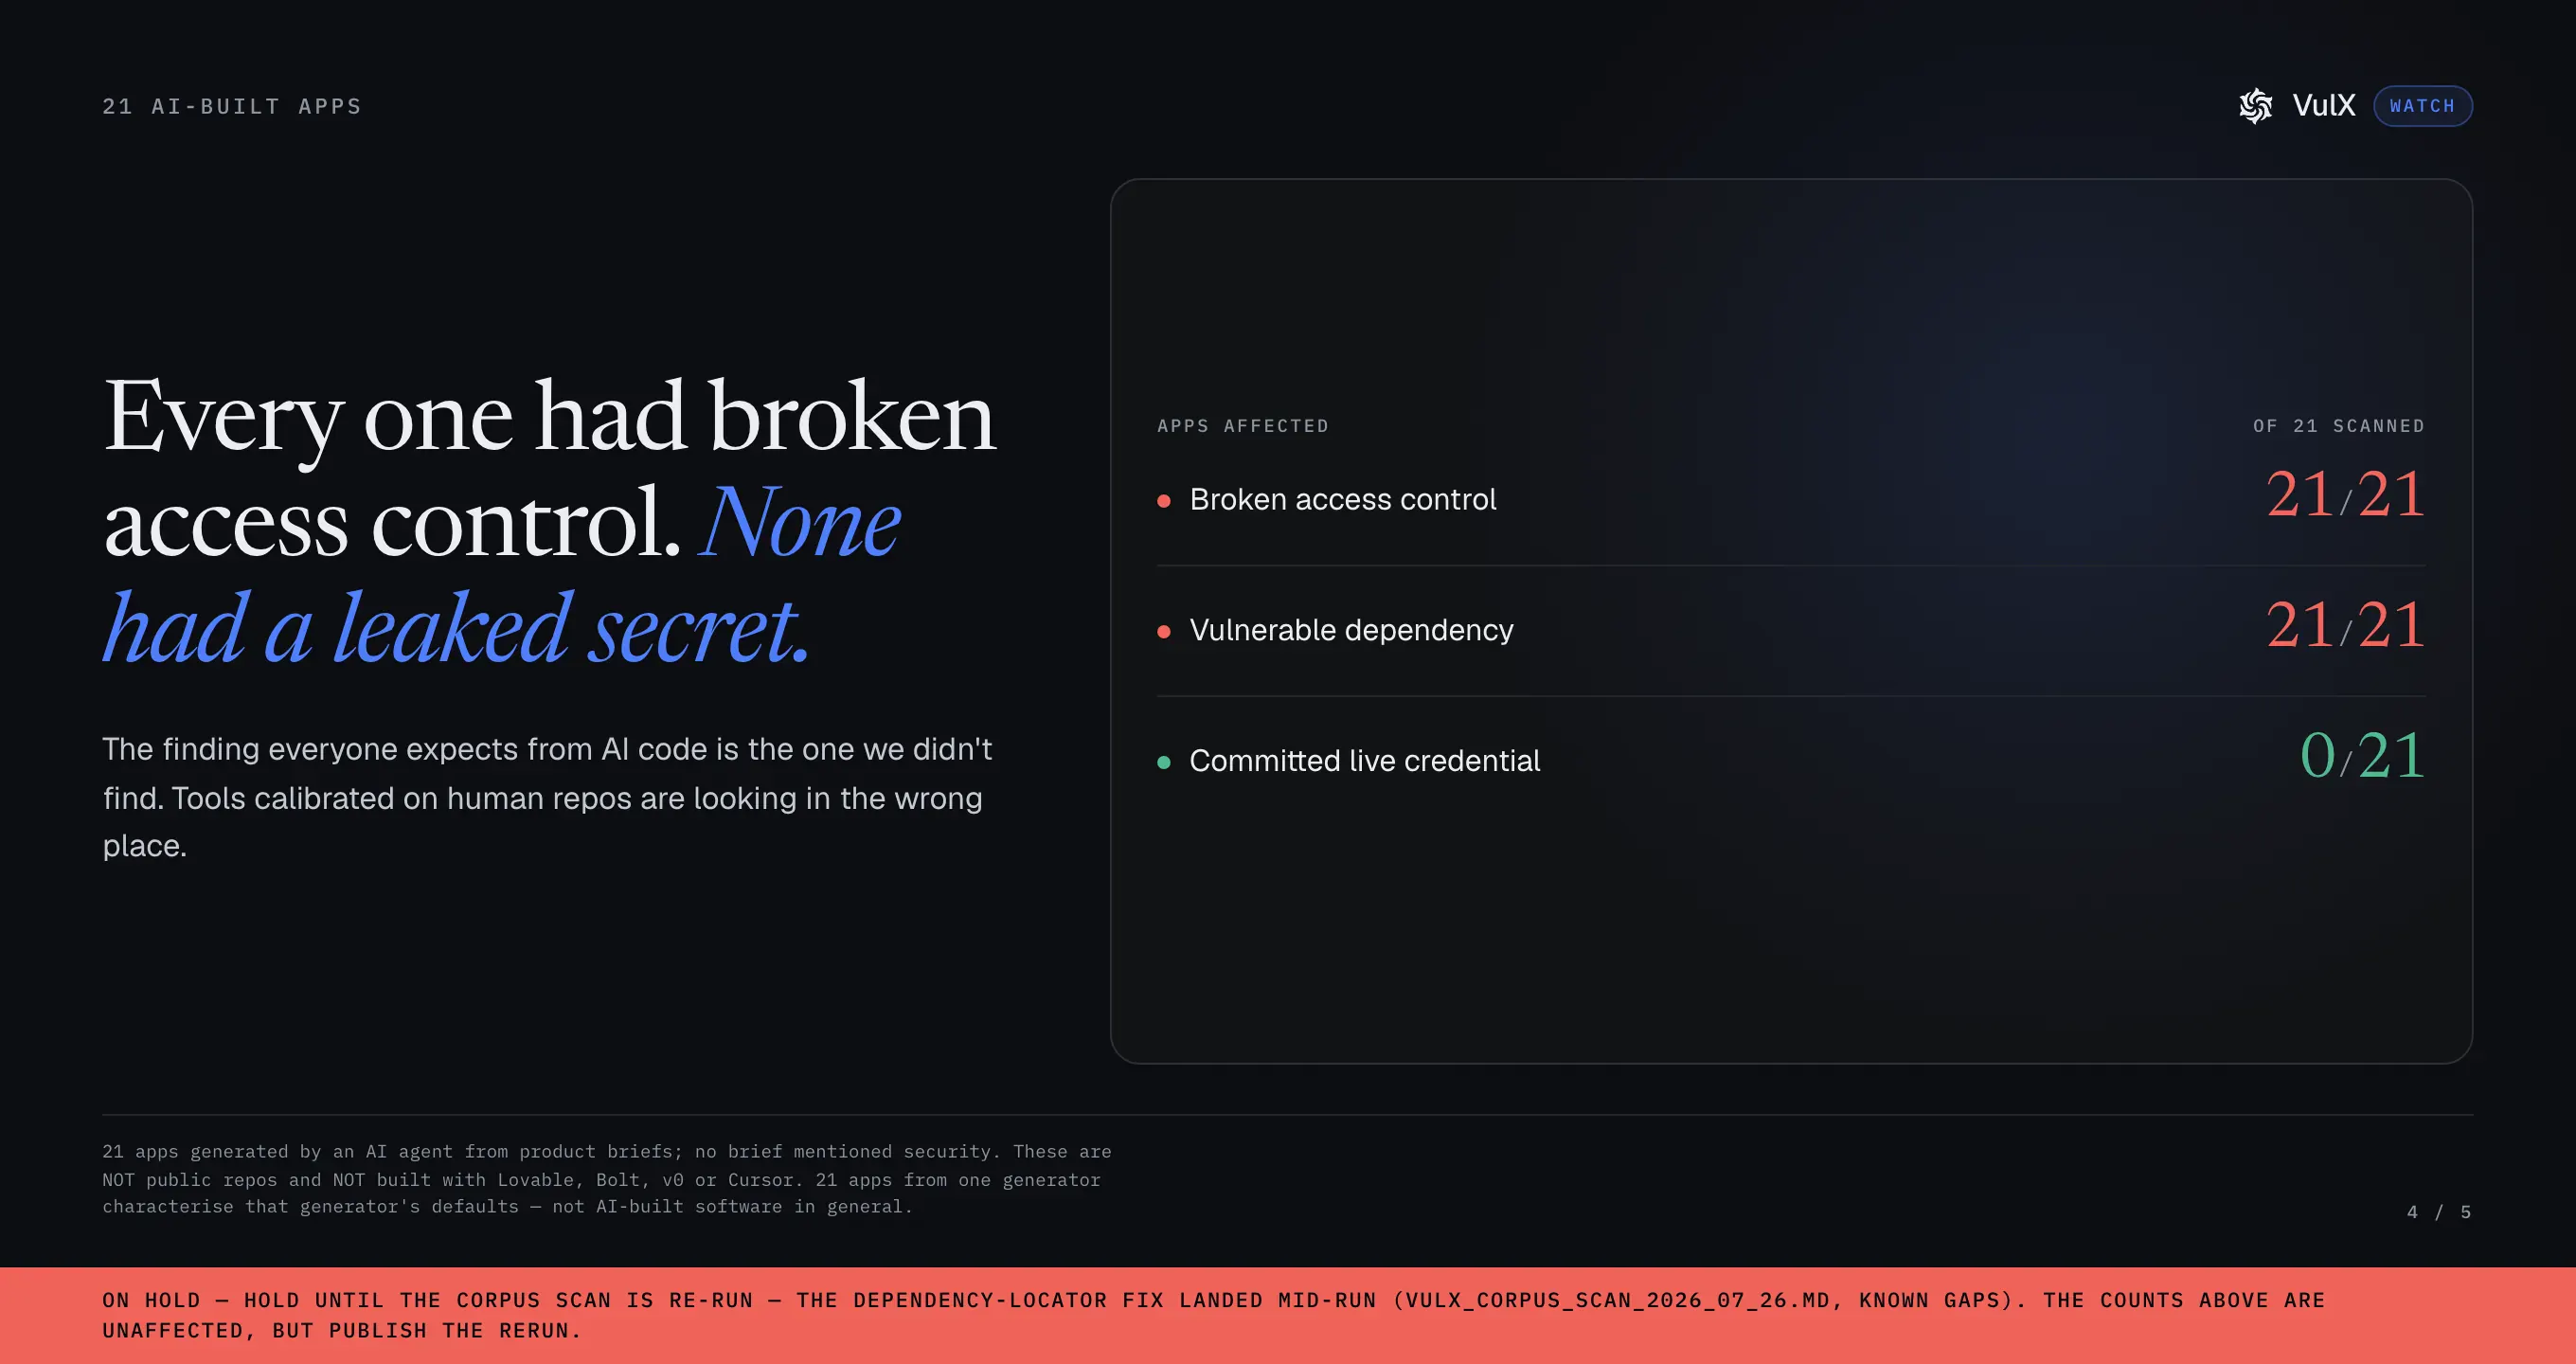
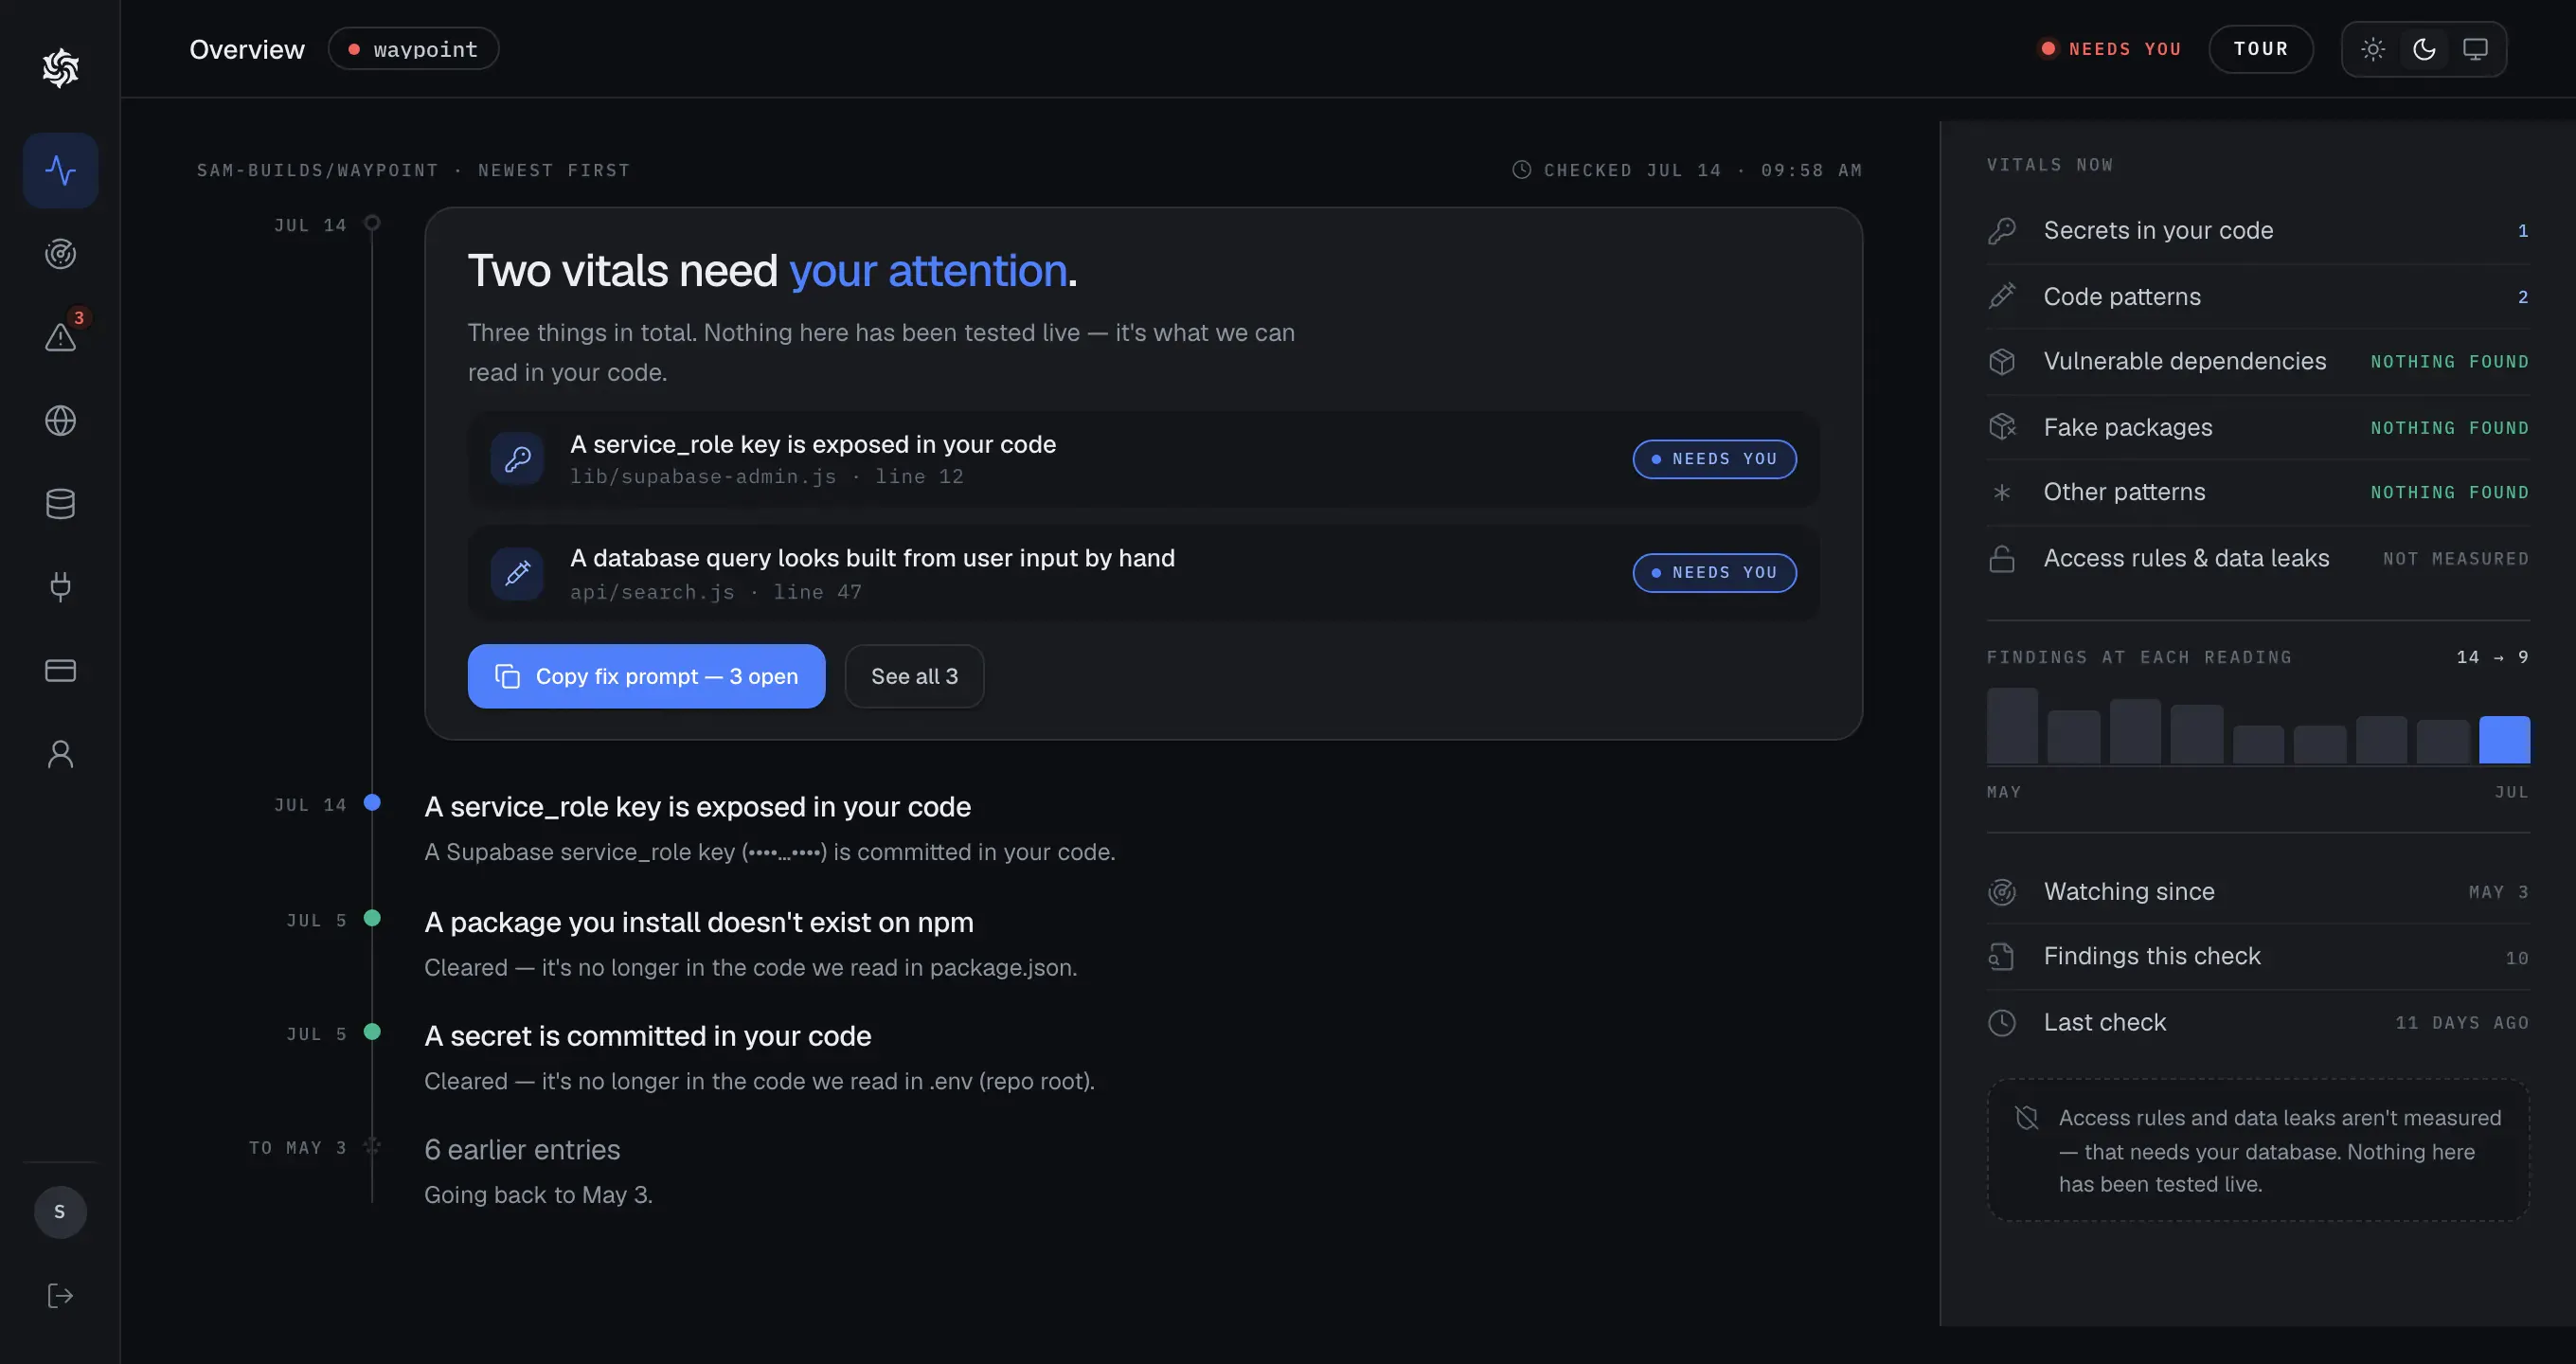
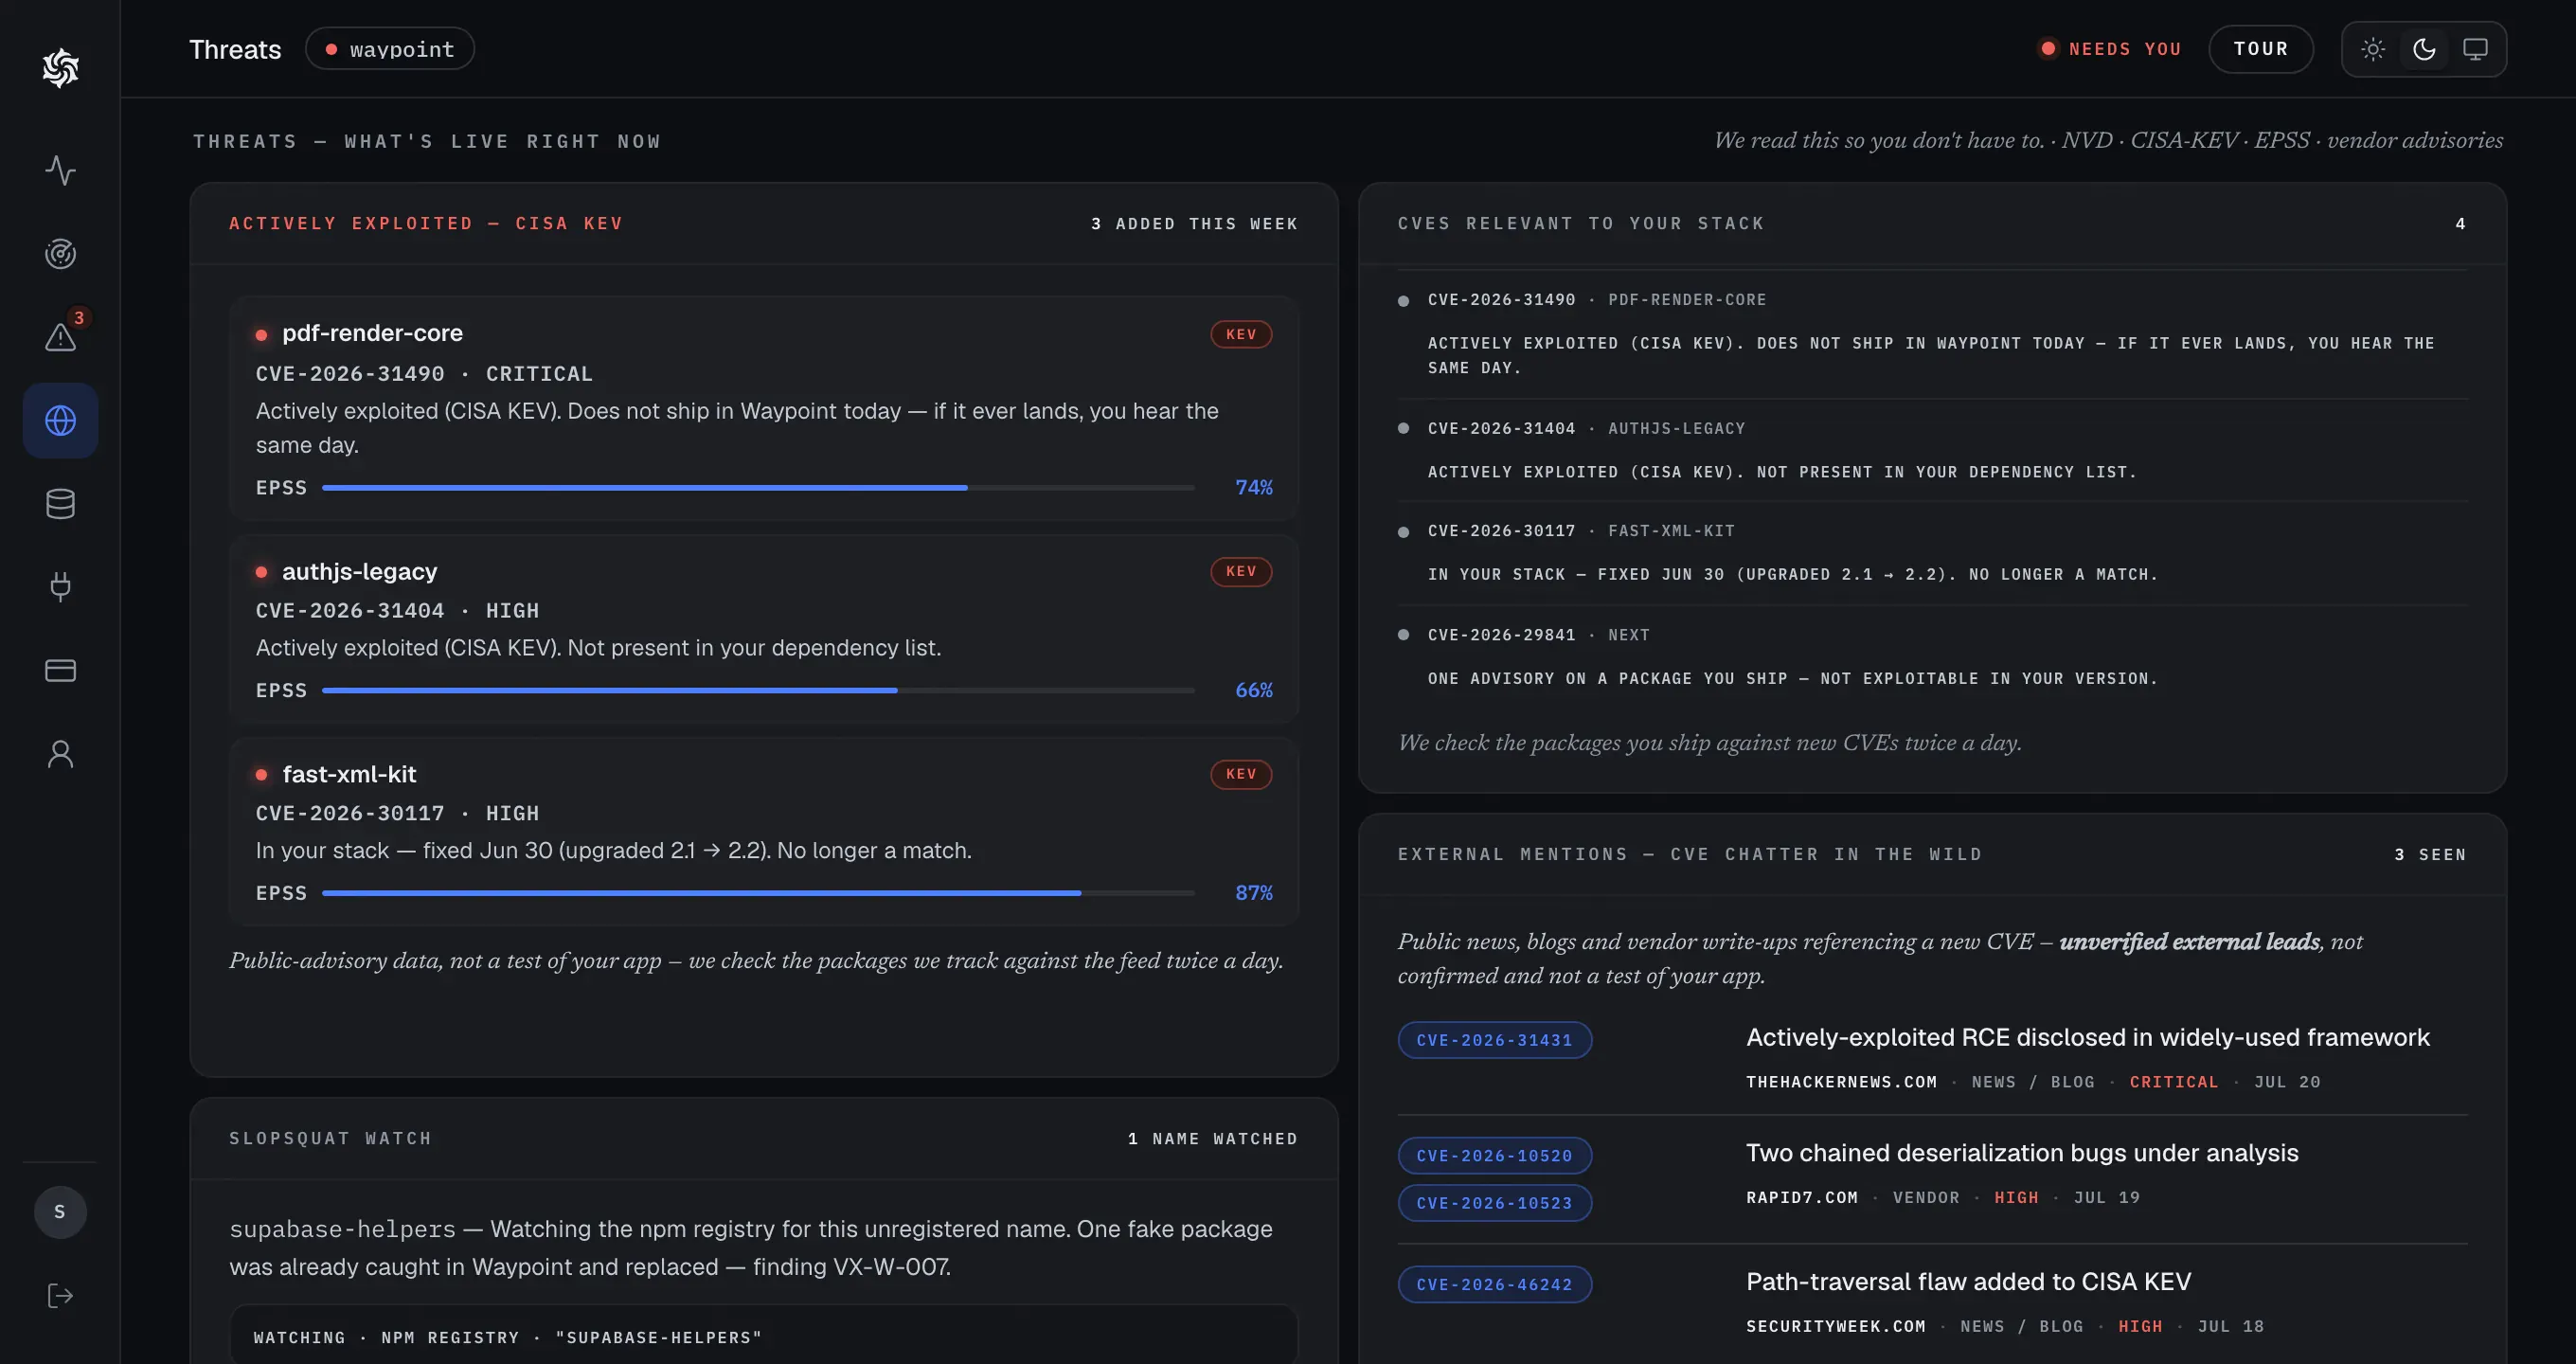
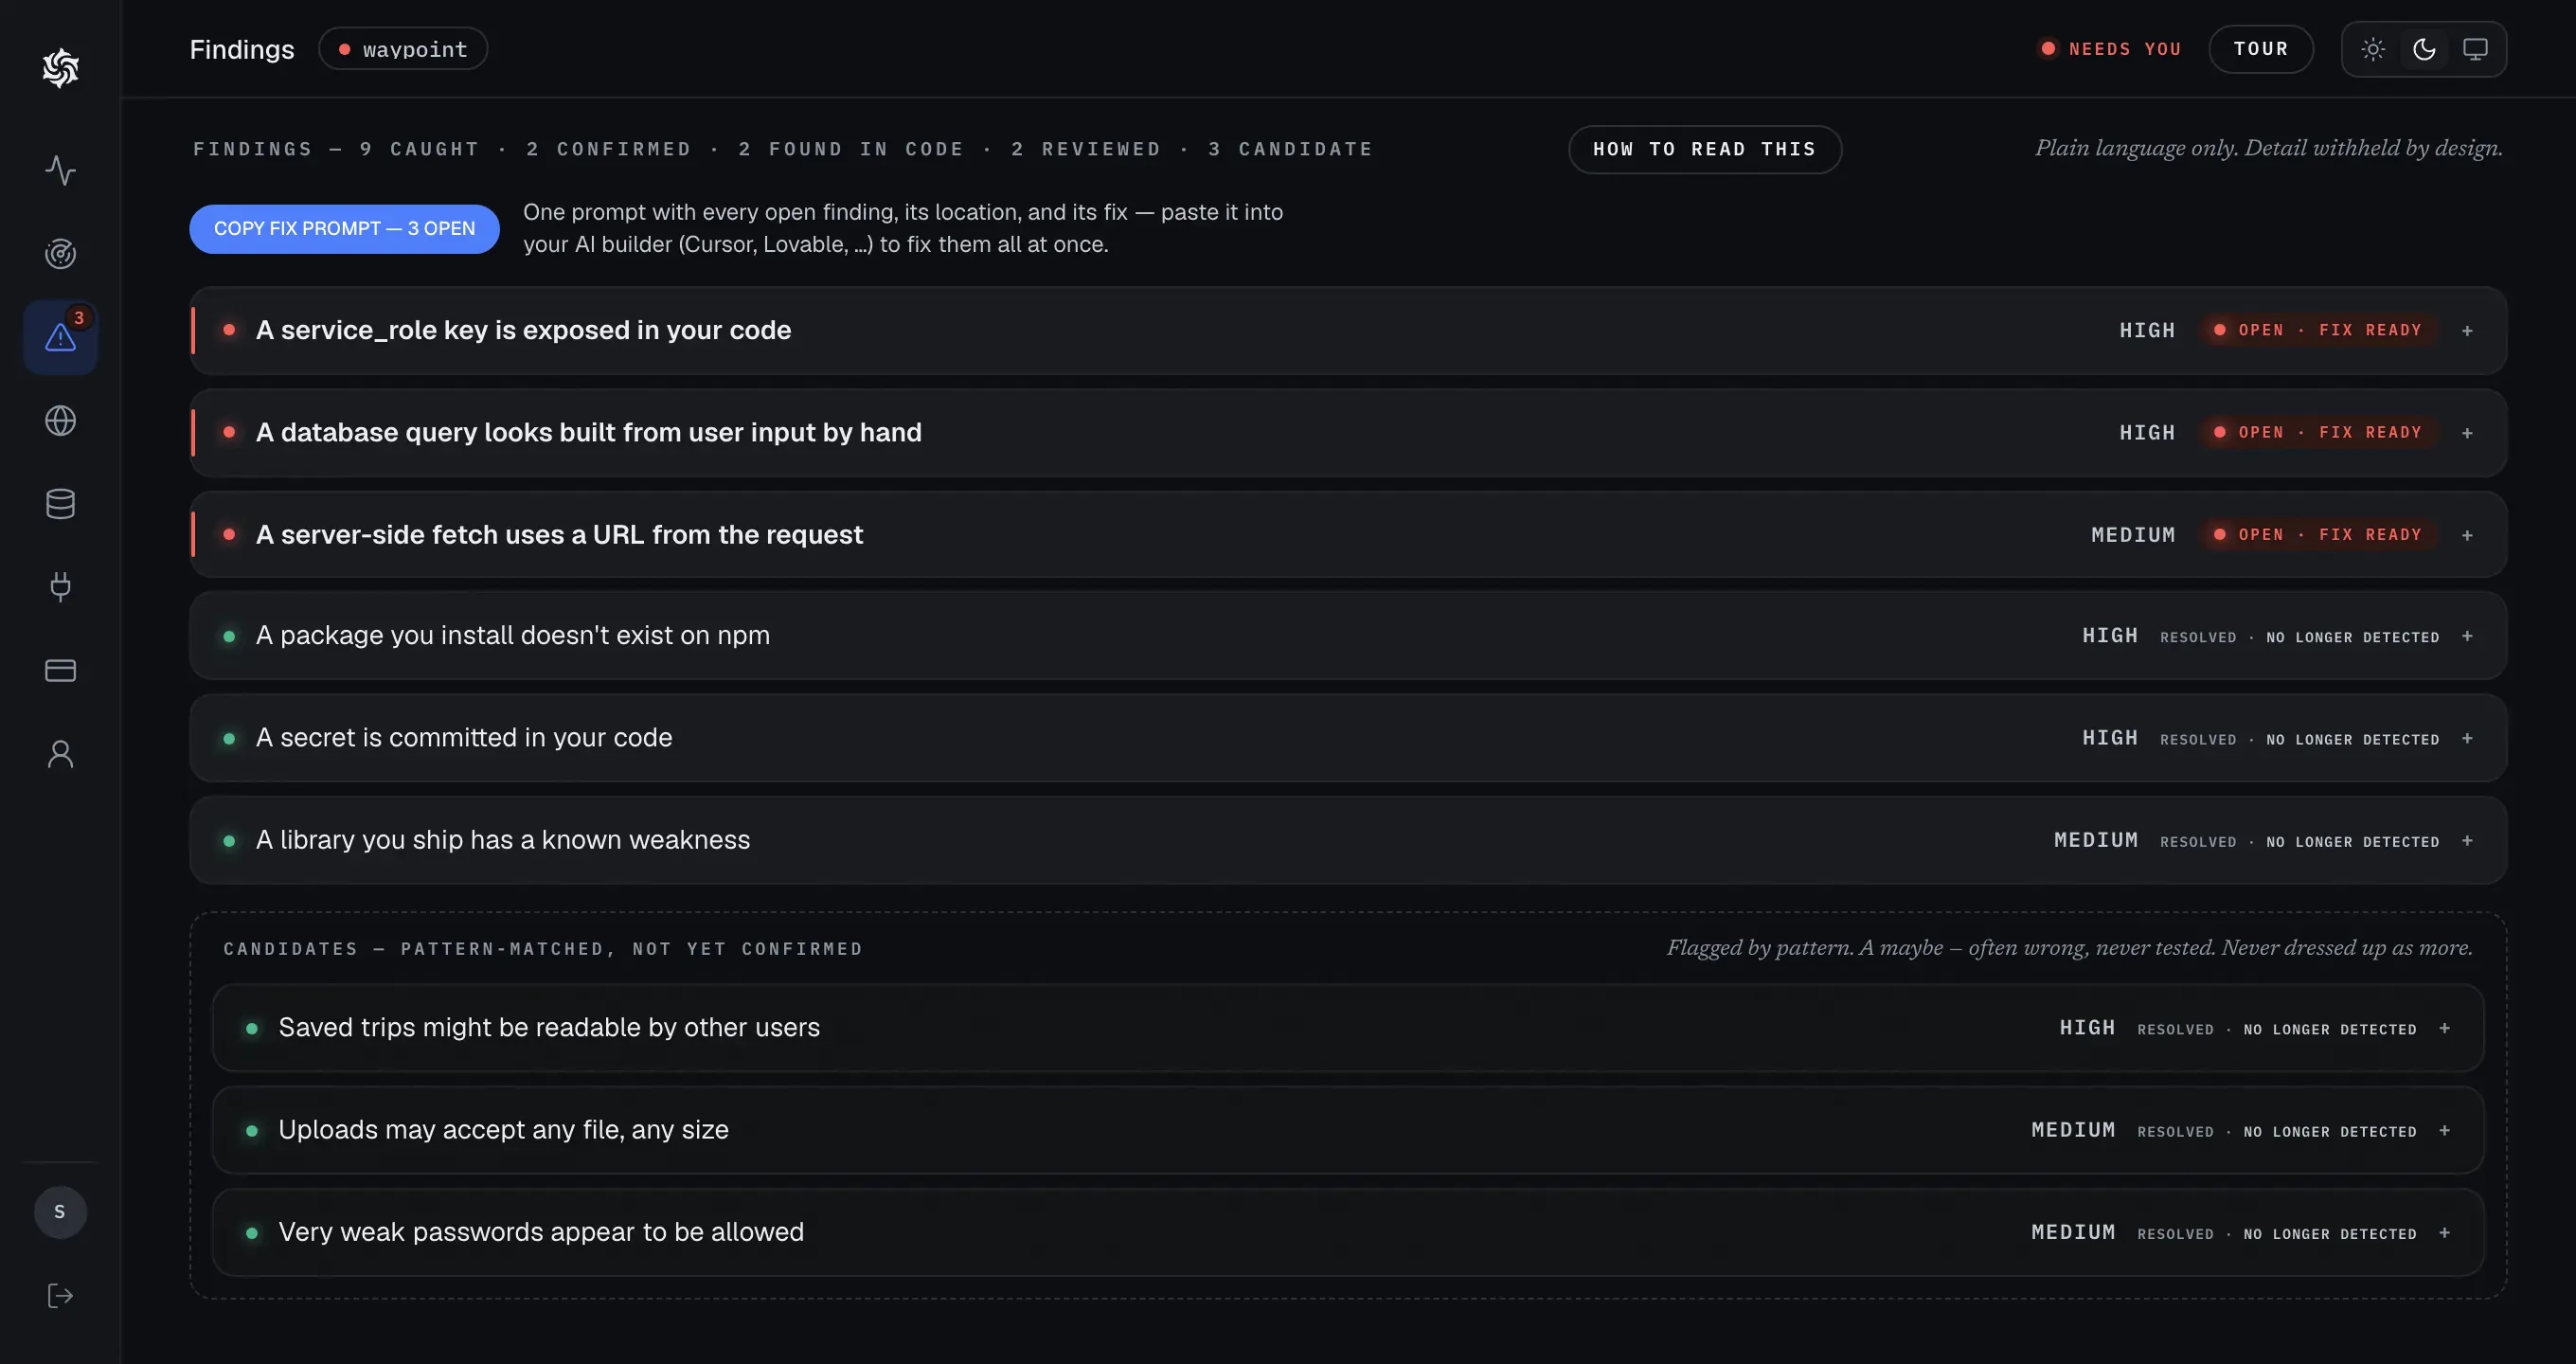
一句话介绍:VulX Watch 是一个只读的AI代码安全审查工具,连接GitHub仓库后,它能独立核查AI生成的代码是否存在漏洞,并附上证据和具体代码行,解决“AI写代码但无法自证安全”的信任痛点。
Analytics
Artificial Intelligence
GitHub
AI代码审查
AI安全
漏洞扫描
Vibe Coding
GitHub集成
供应链安全
DevSecOps
代码审计
独立验证
SaaS工具
用户评论摘要:用户普遍认可其解决“AI写码无安全兜底”的痛点,尤其适合无安全人员的小团队。主要问题集中在:发现漏洞后的通知方式是否支持Slack或邮件;以及创始人回应称产品免费,并欢迎改进建议。
AI 锐评
VulX Watch切中的是一个真实且迅速膨胀的痛点:AI编程工具让代码产出效率飙升,但安全验证能力却真空。产品定位精准——不是又一个扫描器,而是“AI的独立审计员”,直击大模型“既当运动员又当裁判”的逻辑悖论。从评论反馈看,用户不仅认可其价值,更敏锐追问了“持续监控”和“告警集成”等工程化细节,这暗示了该产品从“一次性扫描”向“持续安全运营”演进的可能性。但锐评需指出两点隐忧:其一,39票的冷启动数据反映市场竞争激烈,GitHub原生代码扫描、Snyk等老牌玩家已占位,VulX Watch必须证明其“AI代码”的专项检测能力相比通用工具存在显著代差,否则“独立验证”只是个叙事故事;其二,免费策略虽能引流,但安全工具的核心壁垒在于漏洞库的更新速度和误报率控制,若没有足够的付费客户支撑,其威胁情报的时效性可能成为致命短板。总体而言,产品方向正确,但从“工具”到“可信赖的安全基础设施”,路还很长,关键看其能否在AI代码特有的安全模式(如幻觉API调用、错误依赖引用)上建立不可替代的检测能力。
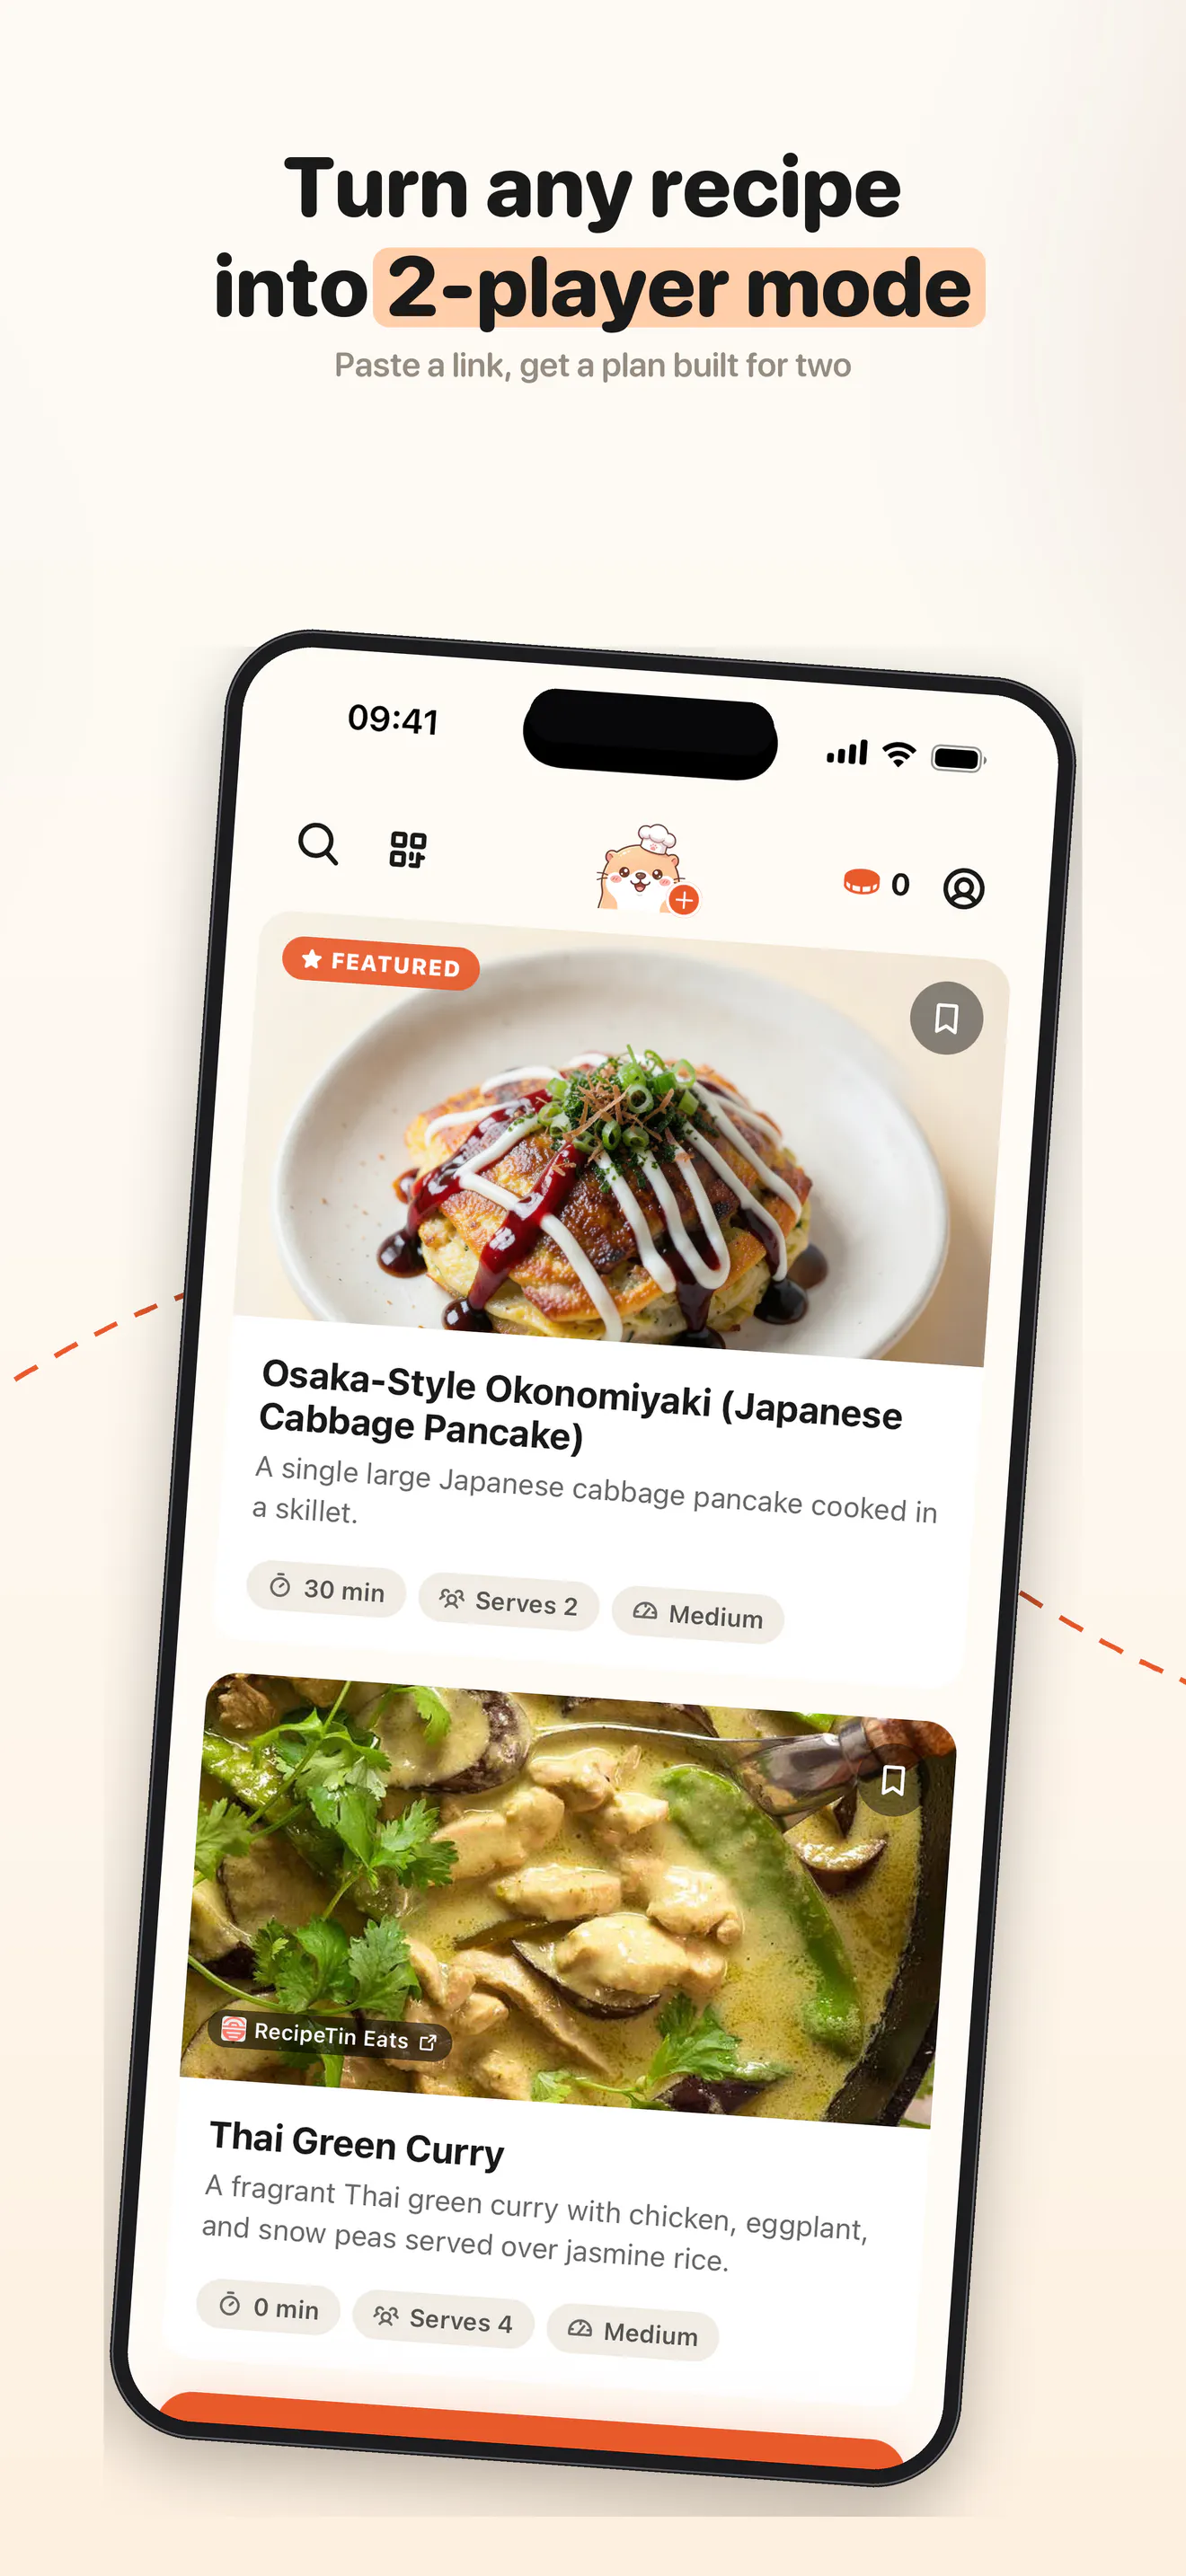
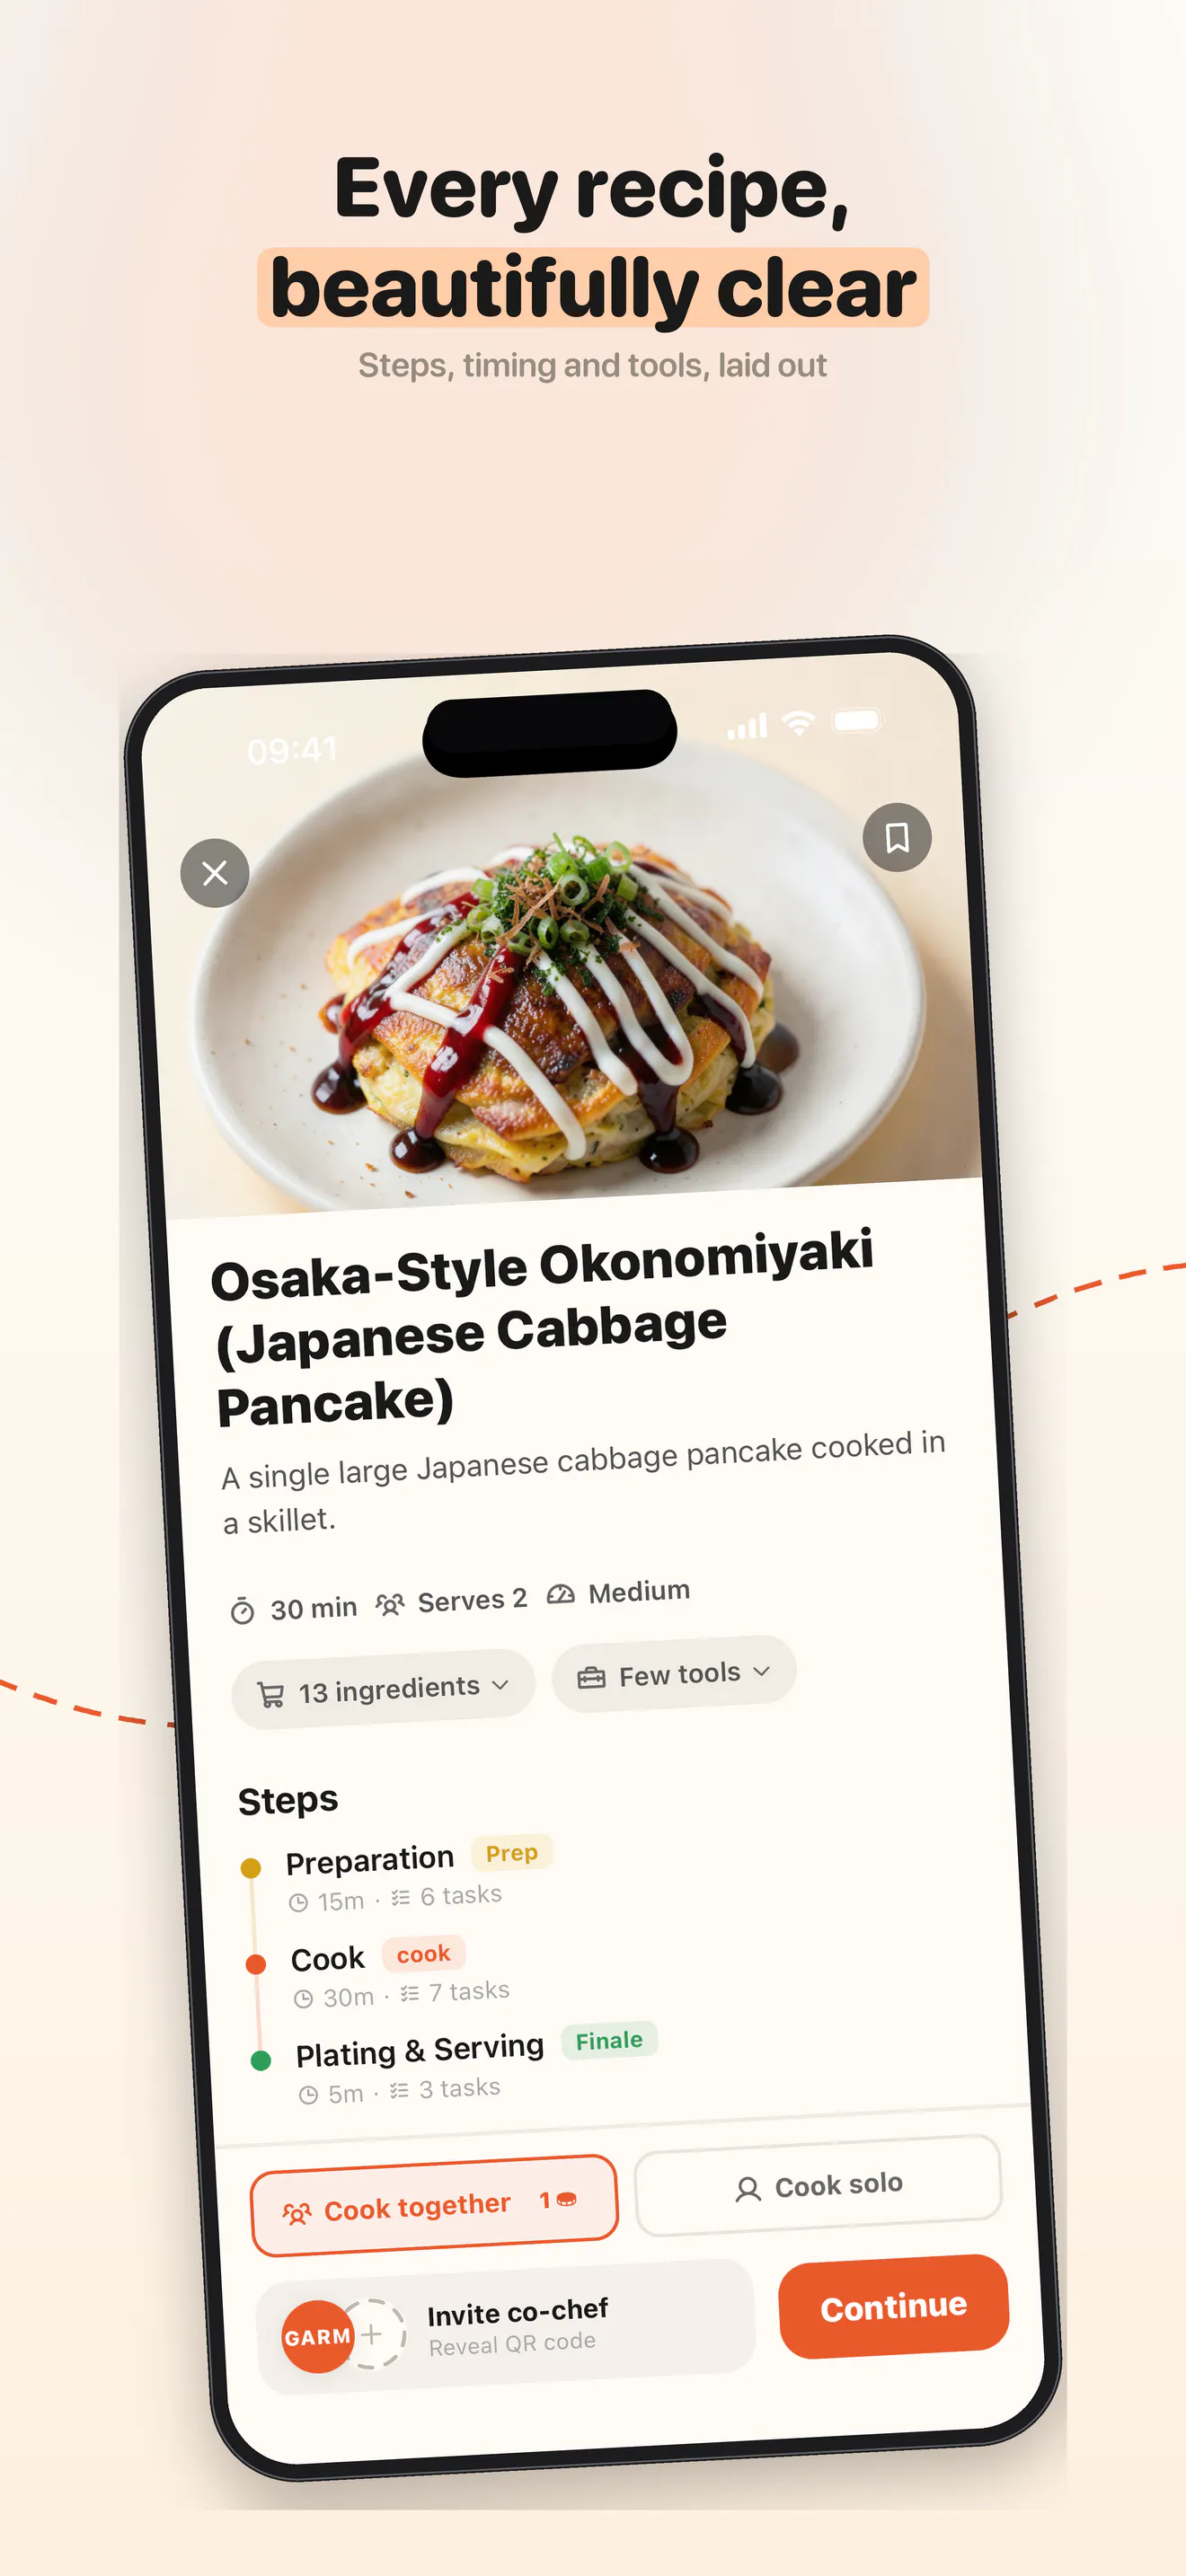
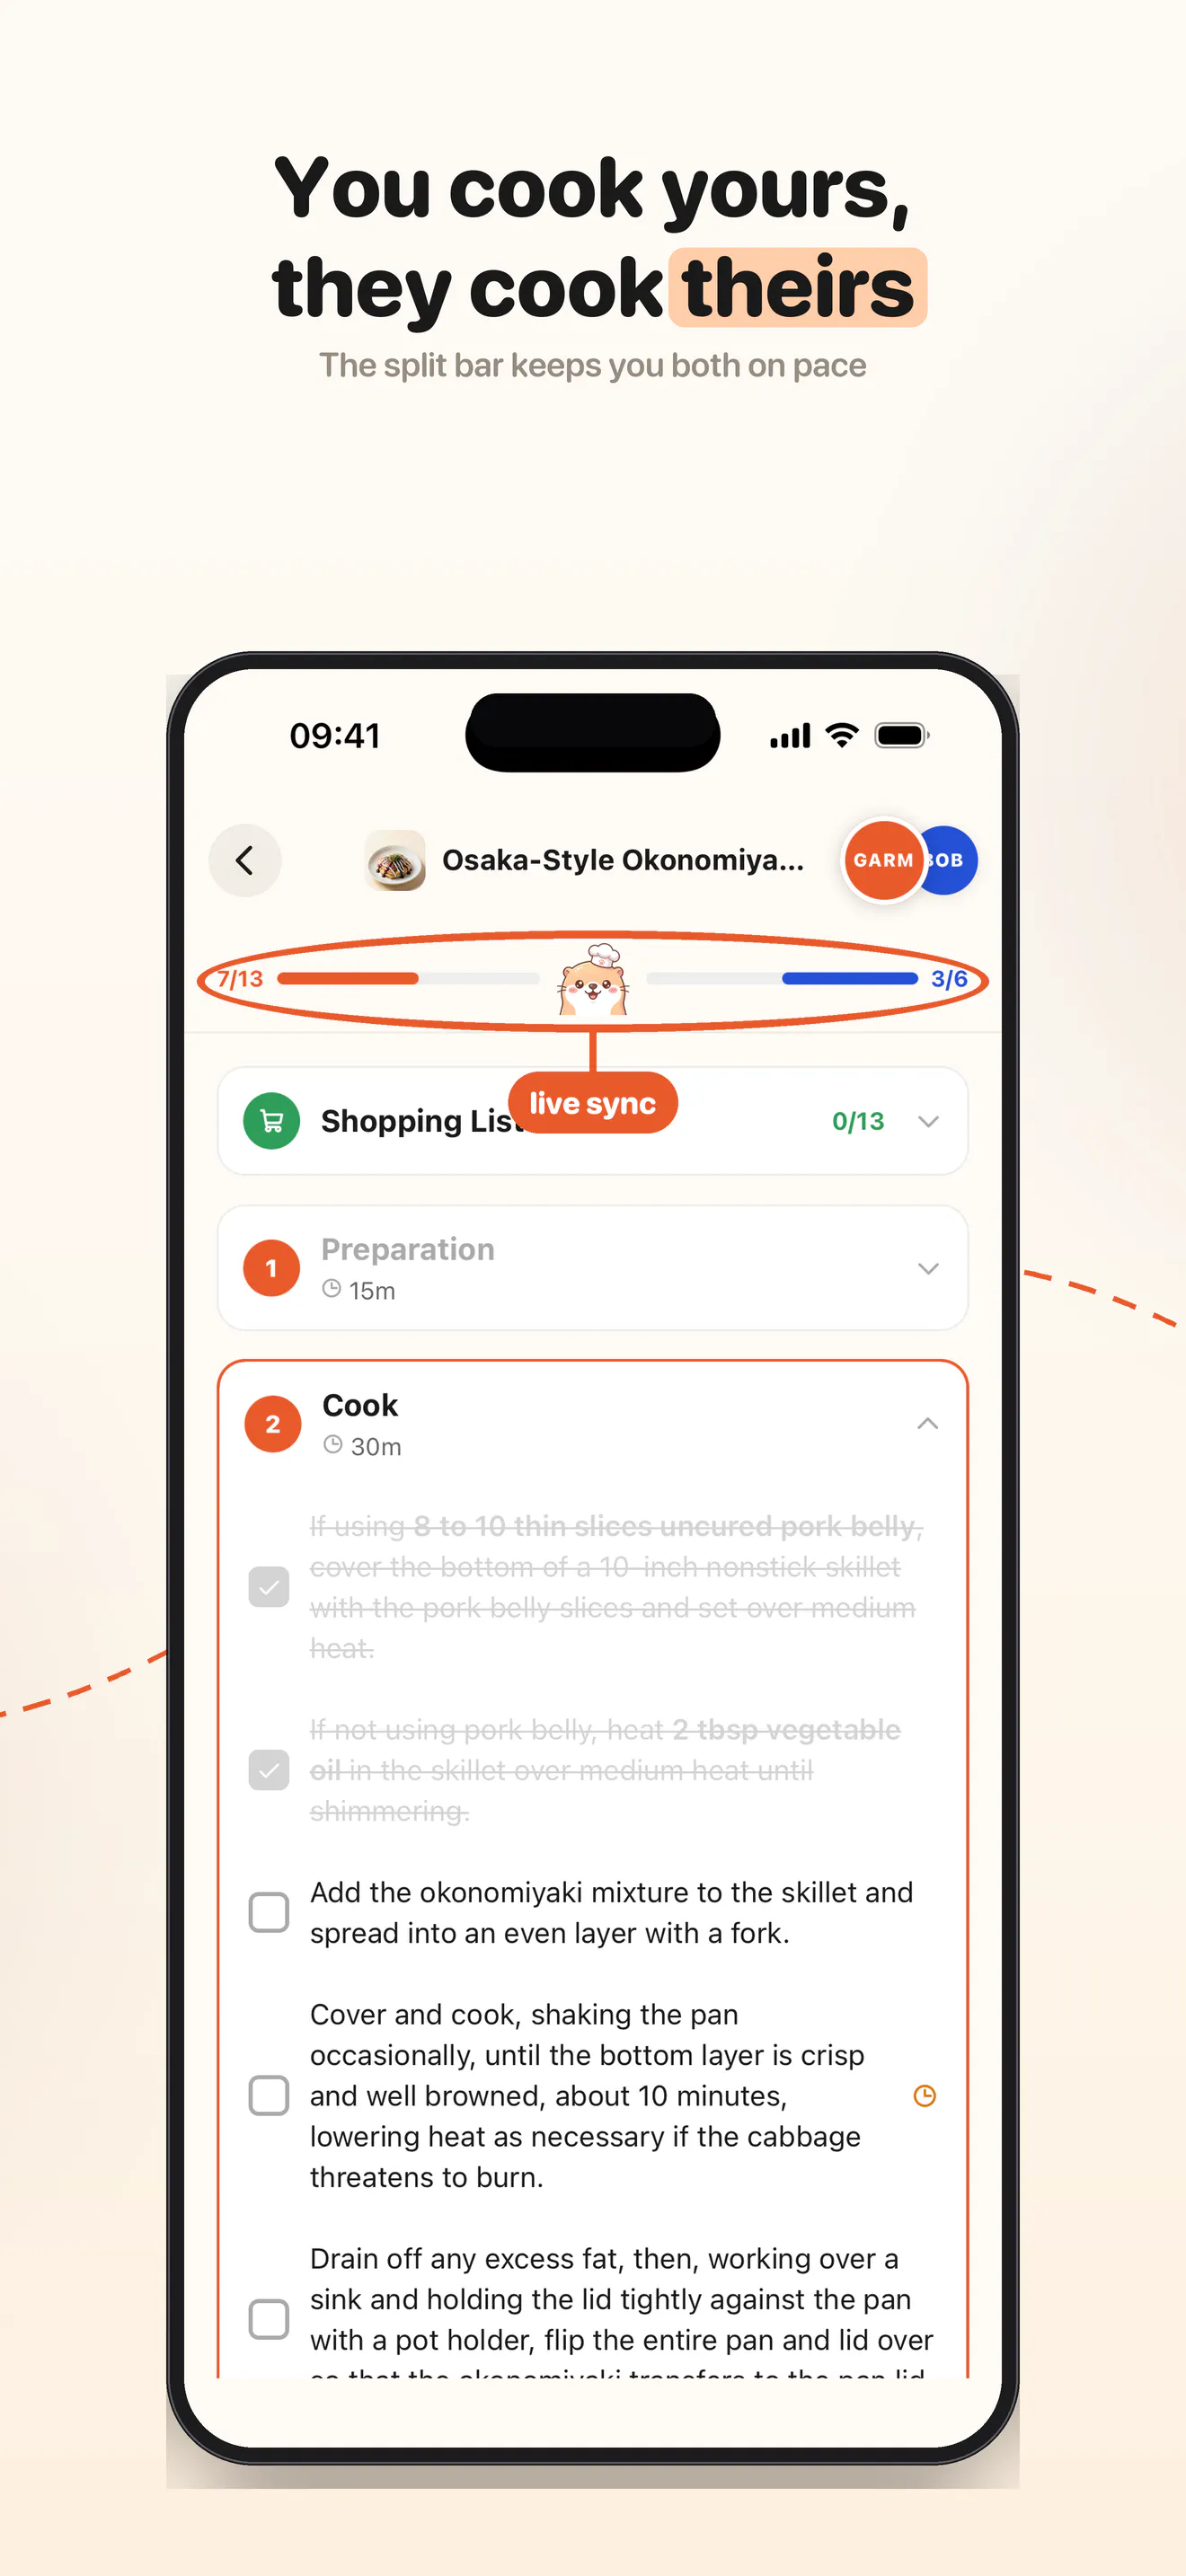
一句话介绍:Nommer.ai 将任意菜谱拆解为双人协作步骤,让情侣或搭档在做饭时各司其职、同步收尾,解决“一人指挥、一人打杂”的协作摩擦。
iOS
Cooking
Food & Drink
双人烹饪
菜谱协作
厨房效率
情侣做饭
任务分工
智能菜谱
生活工具
协作应用
烹饪体验
团队做饭
用户评论摘要:用户普遍认可双人协作的痛点真实,创始人也坦诚描述了从“不一起做饭”到“享受协作”的转变。核心疑问聚焦动态性:若某一步提前完成,是否会实时重新分配任务以避免等待?另有用户因已熟记菜谱而暂时无需求,但肯定对新手期有巨大帮助。
AI 锐评
Nommer.ai 的切入点很刁钻:它不解决“做什么饭”或“怎么做饭”,而是解决“两个人怎么同时做一顿饭”的流程管理问题。这本质上是将菜谱从信息工具重构为协作协议——把主厨的隐性调度权(“你切洋葱”“先别动锅”)显性化为并行任务流,这是对烹饪场景下“关系经济学”的精准捕捉。其商业模型也足够聪明:导入菜谱免费,只有双人协作模式才消耗积分,直接为“多人同时使用”这一稀缺场景定价,避免了与免费菜谱库的正面竞争。
但产品目前暴露的短板也很明显:最关键的动态负载均衡能力(步骤提前完成后的任务重分配)在评论中未获明确回应,这恰恰是协作类工具从“演示惊艳”走向“日常依赖”的分水岭——如果流程僵化,用户很快就会退化回“一人主导、一人刷手机”的旧模式。此外,产品过度聚焦于“情侣”这一甜蜜但狭窄的画像,忽略了合租室友、亲子协作、甚至专业后厨预演等同样高频的多人烹饪场景,这限制了其天花板。
另一个隐患是习惯迁移成本:用户已熟记菜谱后,产品的粘性会急剧衰减。要突破这一点,Nommer 需要从“菜谱执行器”进化为“协作关系的中枢”——例如记录你们最默契的任务分配模式、生成家庭专属的协作菜谱库,甚至将双人协作的数据沉淀为个性化的烹饪能力画像。否则,它终究是一个“恋爱初期的高效玩具”,而非长期厨房基础设施。从投票数和评论热度看,团队具备真实场景洞察力,但技术兑现力将是决定其生死的关键。
一句话介绍:Ctrl+Shift+3是一款主打“平静、时间线排序、纯文本优先”的社区平台,旨在为厌倦算法喧嚣和商业导向社交媒体的用户,提供一个回归Web 1.0/2.0极简交流氛围的线上空间。
iOS
Social Media
Community
社区平台
纯文本社交
时间线信息流
极简主义
反算法
隐私保护
Web 4.0
iOS应用
替代社交
慢社交
用户评论摘要:用户认可“回归简单”的定位,但质疑其商业模式能否持续,认为仅靠“不贪财”难以支撑托管与审核成本;另透露iOS版已提交审核,开发者称更优版本因苹果审核延迟发布。
AI 锐评
Ctrl+Shift+3的“反商业化”叙事精准踩中了后算法时代用户的情绪痛点——但这也恰恰是其最大的隐患。它把“Meta等平台唯利是图”作为道德出发点,却回避了所有社区产品终将面临的资源诅咒:服务器账单、垃圾信息治理、社区规模与调性平衡。评论中那句“利润足够付托管费就行”听起来理想主义,但在现实运营中,“足够”是个动态且危险的概念。当用户增长带来指数级带宽与审核成本时,所谓“简单决策”会瞬间变成复杂的融资或卖身抉择。更值得警惕的是,产品标榜“文本优先”,却只能靠“苹果审核慢”这种花边新闻引起关注,反映出其功能层面尚无任何差异化壁垒——极简UI和按时间排序是任何开源论坛脚本的默认配置,而非核心竞争力。若没有一套自洽的社区自治机制(如用户付费托管节点、去中心化存储或筛选严格的白名单邀请制),这个项目大概率会像许多“反Facebook”的乌托邦实验一样,在数百个用户阶段靠情怀运转,随后被沉默的大多数弃置。它最大的价值,或许不是作为产品成功,而是作为一份对当代社交平台“注意力剥夺”的病理学诊断书。
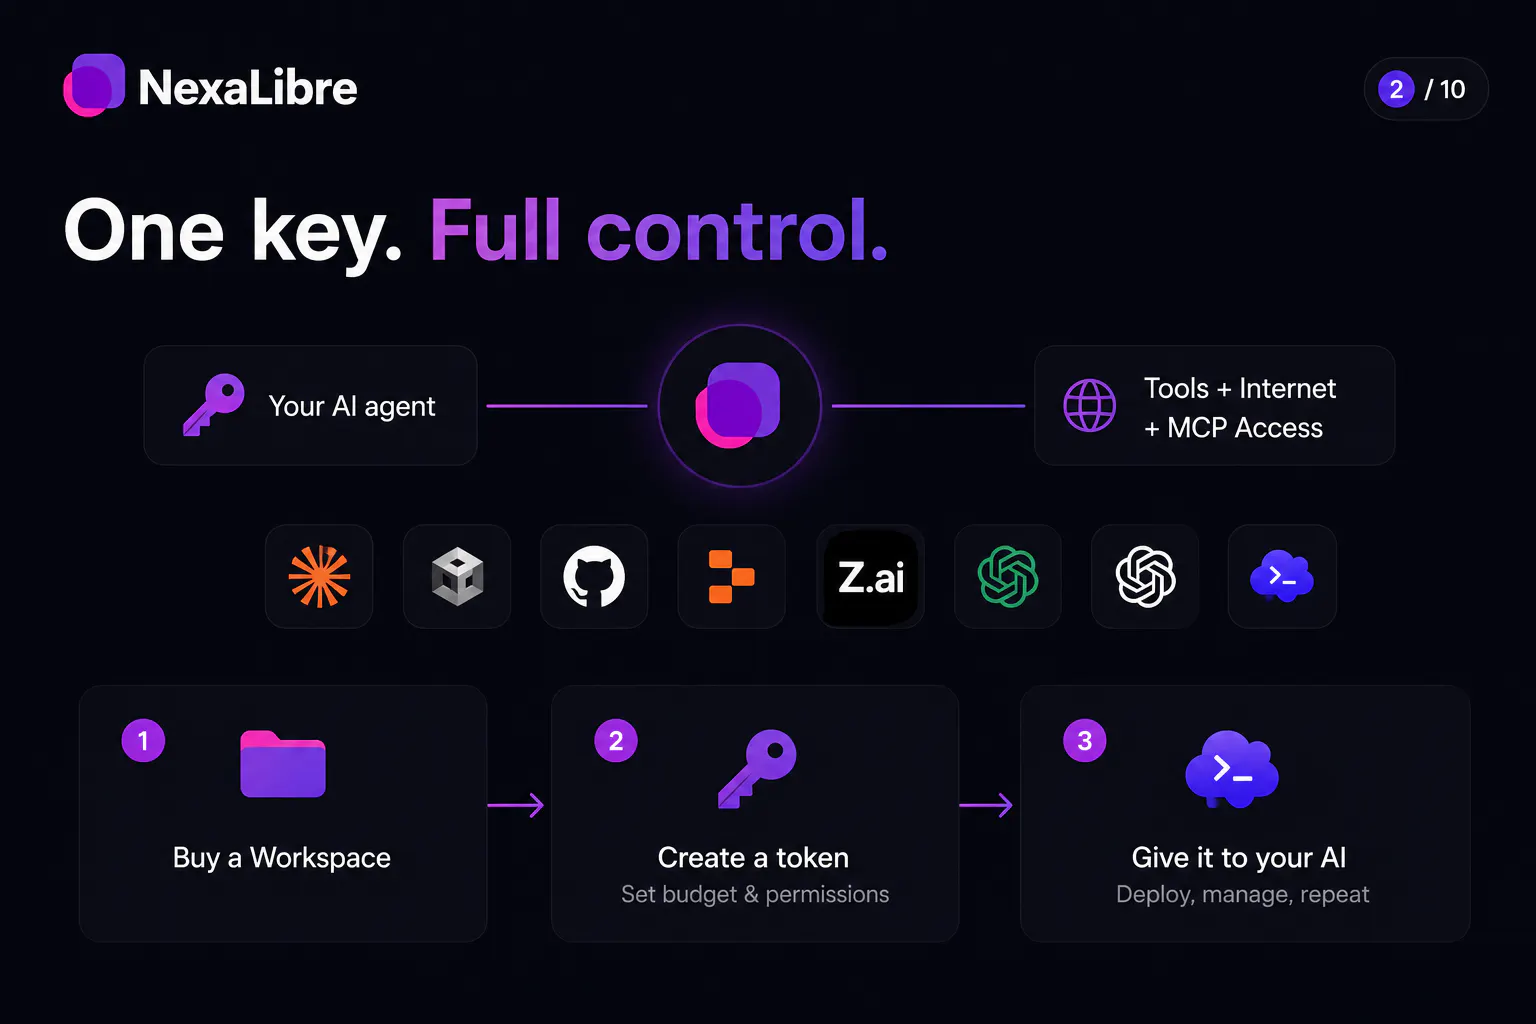
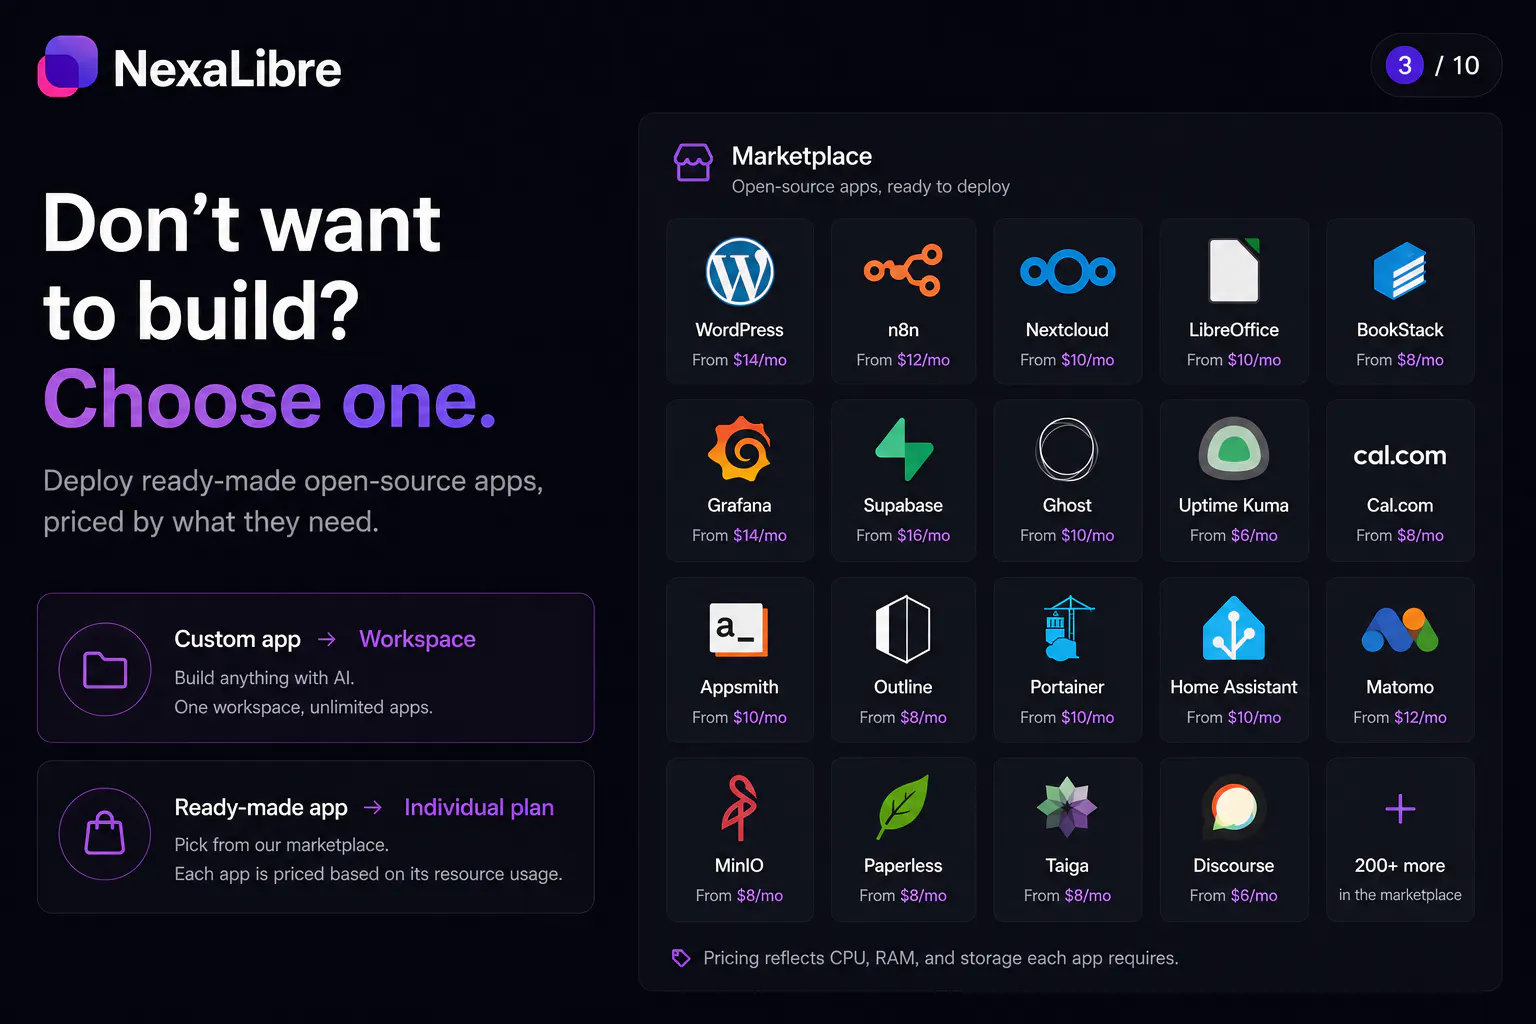
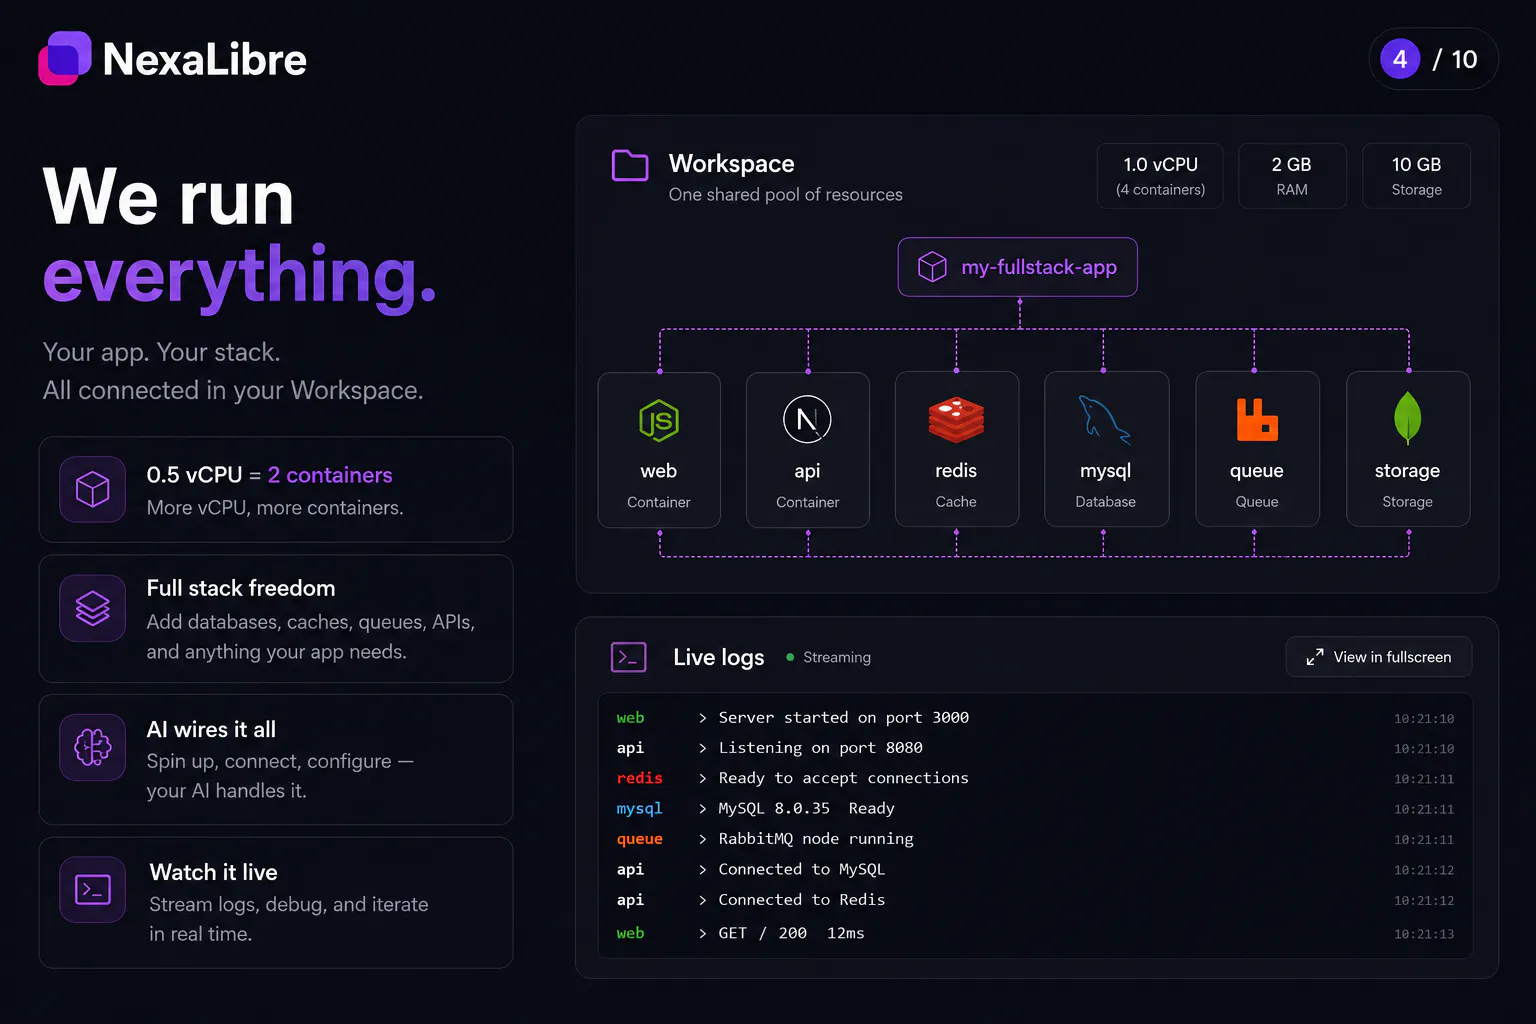
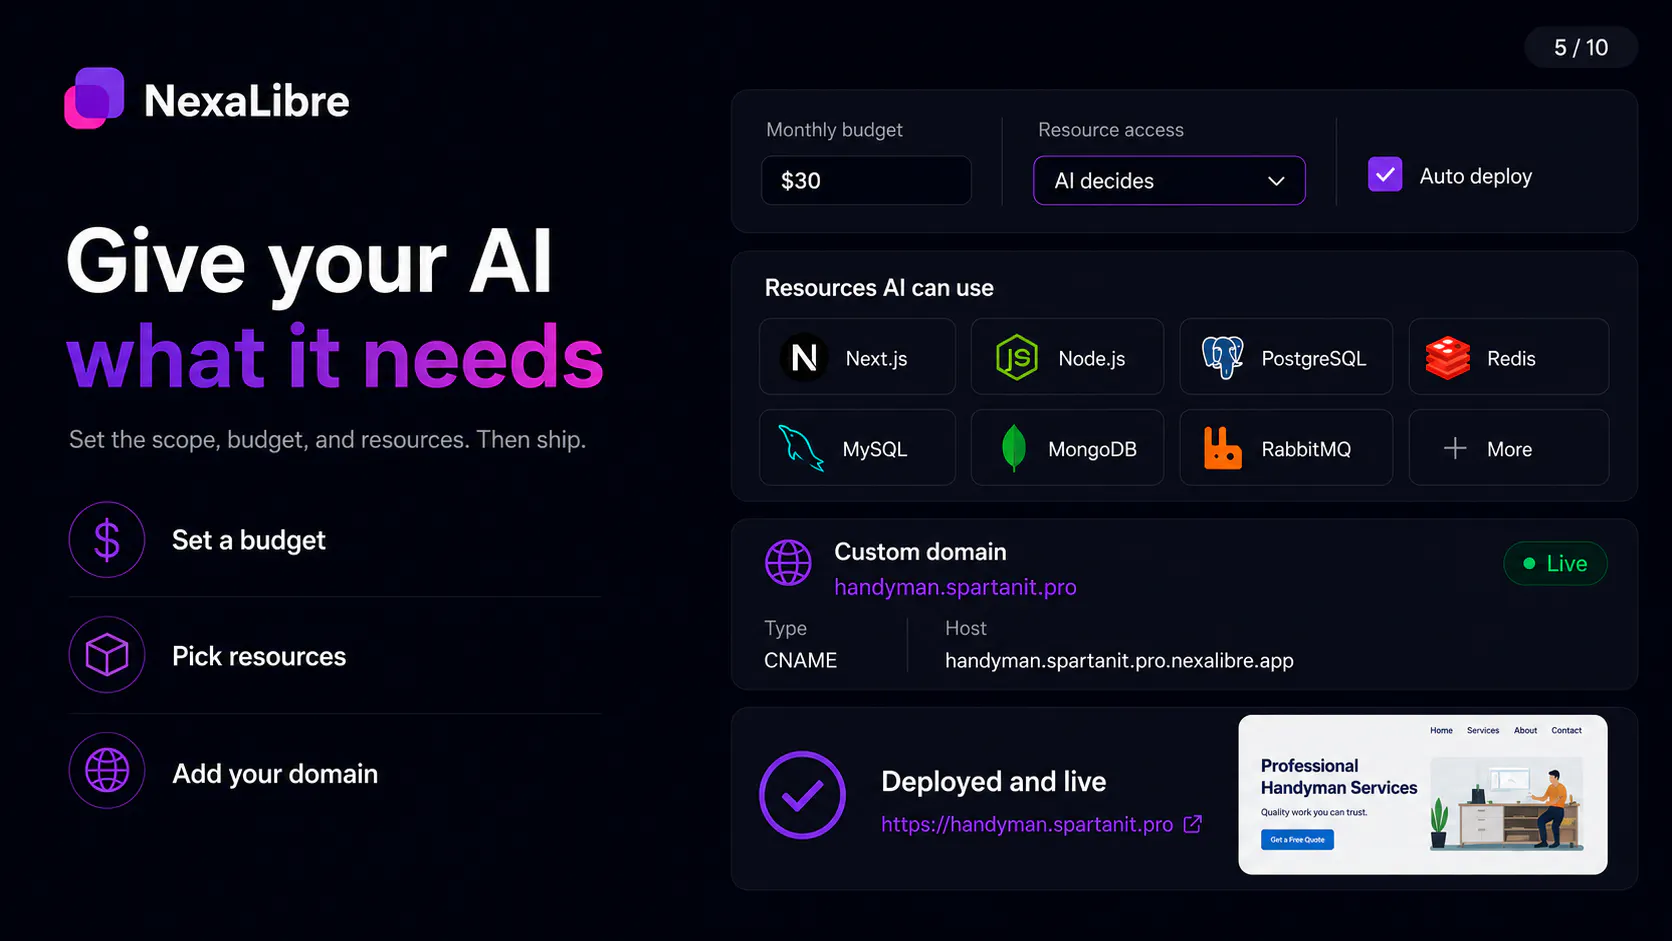
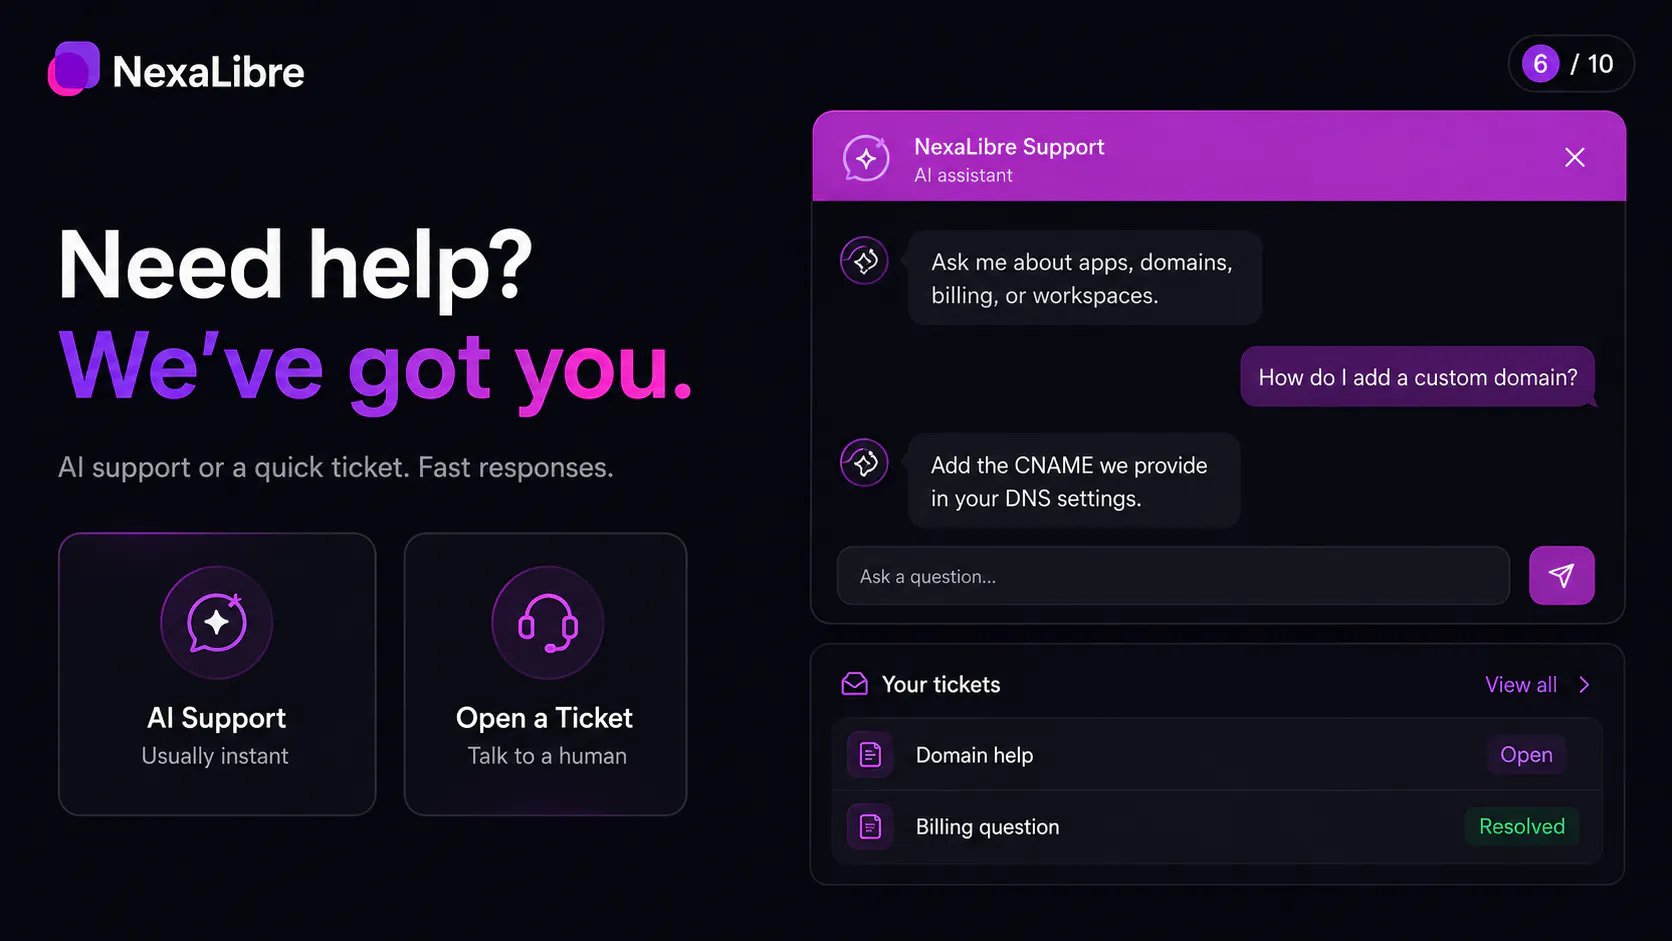
一句话介绍:NexaLibre 是一款面向AI生成代码的自动化安全托管平台,让用户无需管理服务器,即可将AI产出的应用或开源项目一键部署上线,解决从代码到可访问产品的“最后一公里”基础设施难题。
SaaS
Artificial Intelligence
Development
AI应用托管
自动化部署
无服务器运维
安全主机
HTTPS内置
一键上线
开源应用库
独立开发者工具
云基础设施
极速启动
用户评论摘要:目前评论较少,有效反馈仅一条:称赞“将AI代码转为即时安全应用”的思路,并肯定内置HTTPS与备份功能。暂无用户提出具体问题或改进建议,早期验证阶段,社区期待更多实操细节。
AI 锐评
NexaLibre踩中了当下最热但最“虚”的痛点——AI生成代码的“最后一公里”。ChatGPT、Claude们能写出看似完整的应用,但把它们跑起来涉及域名、证书、反向代理、进程守护、数据库连接,这足以劝退绝大多数非运维背景的开发者。NexaLibre本质上卖的是“AI时代的Serverless”,把复杂基础设施封装成黑盒,这方向正确且极具商业想象力。
但必须泼冷水:当前15个投票、1条有效评论,产品仍处于极度早期。该赛道竞争极其激烈,Vercel、Railway、Render已在做类似事情,且巨头如AWS(AppRunner)、Cloudflare(Workers)随时能碾压式跟进。NexaLibre真正的差异化牌是“内置对AI生成代码的适配”,但AI代码质量参差不齐,若仅做自动化部署,壁垒极低——任何托管商都能声称支持“AI生成项目”。
更关键的问题在于:它的目标用户是谁?如果是独立开发者,他们更可能选择Vercel的免费额度;如果是企业,则缺乏团队协作、审计日志、私有网络等企业级功能。产品介绍中“数百个开源应用可部署”是个亮点,但需警惕变成“应用商店”的低价值搬运工,而非真正的平台粘性。
创始人背景偏运维,这是优势也是风险——容易陷入“技术自嗨”,过度优化底层,忽略产品体验和增长。建议NexaLibre尽快明确垂直场景(如“专为Copilot代码设计”),并展示一个复杂AI项目的完整部署演示,证明其比现有通用PaaS更“无痛”。在AI编码浪潮中,工具链的机会真实存在,但只有极致简化+明确差异化,才能避免成为又一个小而美的僵尸产品。
一句话介绍:Franchise Builders™ 是一站式特许经营建设工具,帮助潜在加盟商自动生成FDD法律文件、加盟协议与运营手册,并直接对接FMLS交易市场与加盟商门户,解决特许经营启动流程复杂、专业门槛高的痛点。
Android
User Experience
Marketing
SaaS
特许经营
FDD生成
加盟协议
运营手册
加盟商门户
法律文书自动化
加盟市场
创业工具
特许经营SaaS
品牌扩张
用户评论摘要:目前仅有一条有效评论,点赞1次,认可其整合FDD、协议与手册的功能范围,称“减轻加盟商负担”。无负面反馈或具体建议,评论者身份未明,互动深度有限,缺乏对实际使用体验的验证。
AI 锐评
Franchise Builders™ 的定位非常精准——它切入的是特许经营行业里最“脏活累活”的环节:FDD(特许经营披露文件)和运营手册的编制。这两项文档通常需要律师、咨询顾问数周到数月才能完成,成本动辄数万美元,且法律合规风险极高。产品试图用“生成器”方式将其自动化,理论上能大幅降低加盟扩张的门槛,这确实是行业刚需。
但问题也恰恰出在这里。FDD不是标准化的填空题,它涉及州法差异、财务披露细节、诉讼历史等高度定制化内容,且法律效力极强。如果生成结果只是模板拼装,一旦出现遗漏或误导,加盟商可能面临集体诉讼,而平台若不对法律后果兜底,实际信任度会大打折扣。此外,仅14票的发布数据说明产品尚处早期,没有规模化用户验证其文档质量、法务审核流程是否可靠。
真正值得关注的是其“FMLS市场+门户”的闭环设想——将文档生成、项目挂牌、加盟商管理串起来,试图做成特许经营的“Shopify+ MLS”。但这也意味着它必须同时搞定法律合规(B端信任)、交易撮合(平台流量)、SaaS运营(续费率)三件难事,任何一环薄弱都会拖垮整体。目前看来,它更像一个“文档自动化工具”而非“生态平台”,价值虽有,但被过度包装。建议团队先集中火力攻下FDD的合规审核与人工法务复核机制,再谈市场野心,否则容易在早期因法律风险翻车。
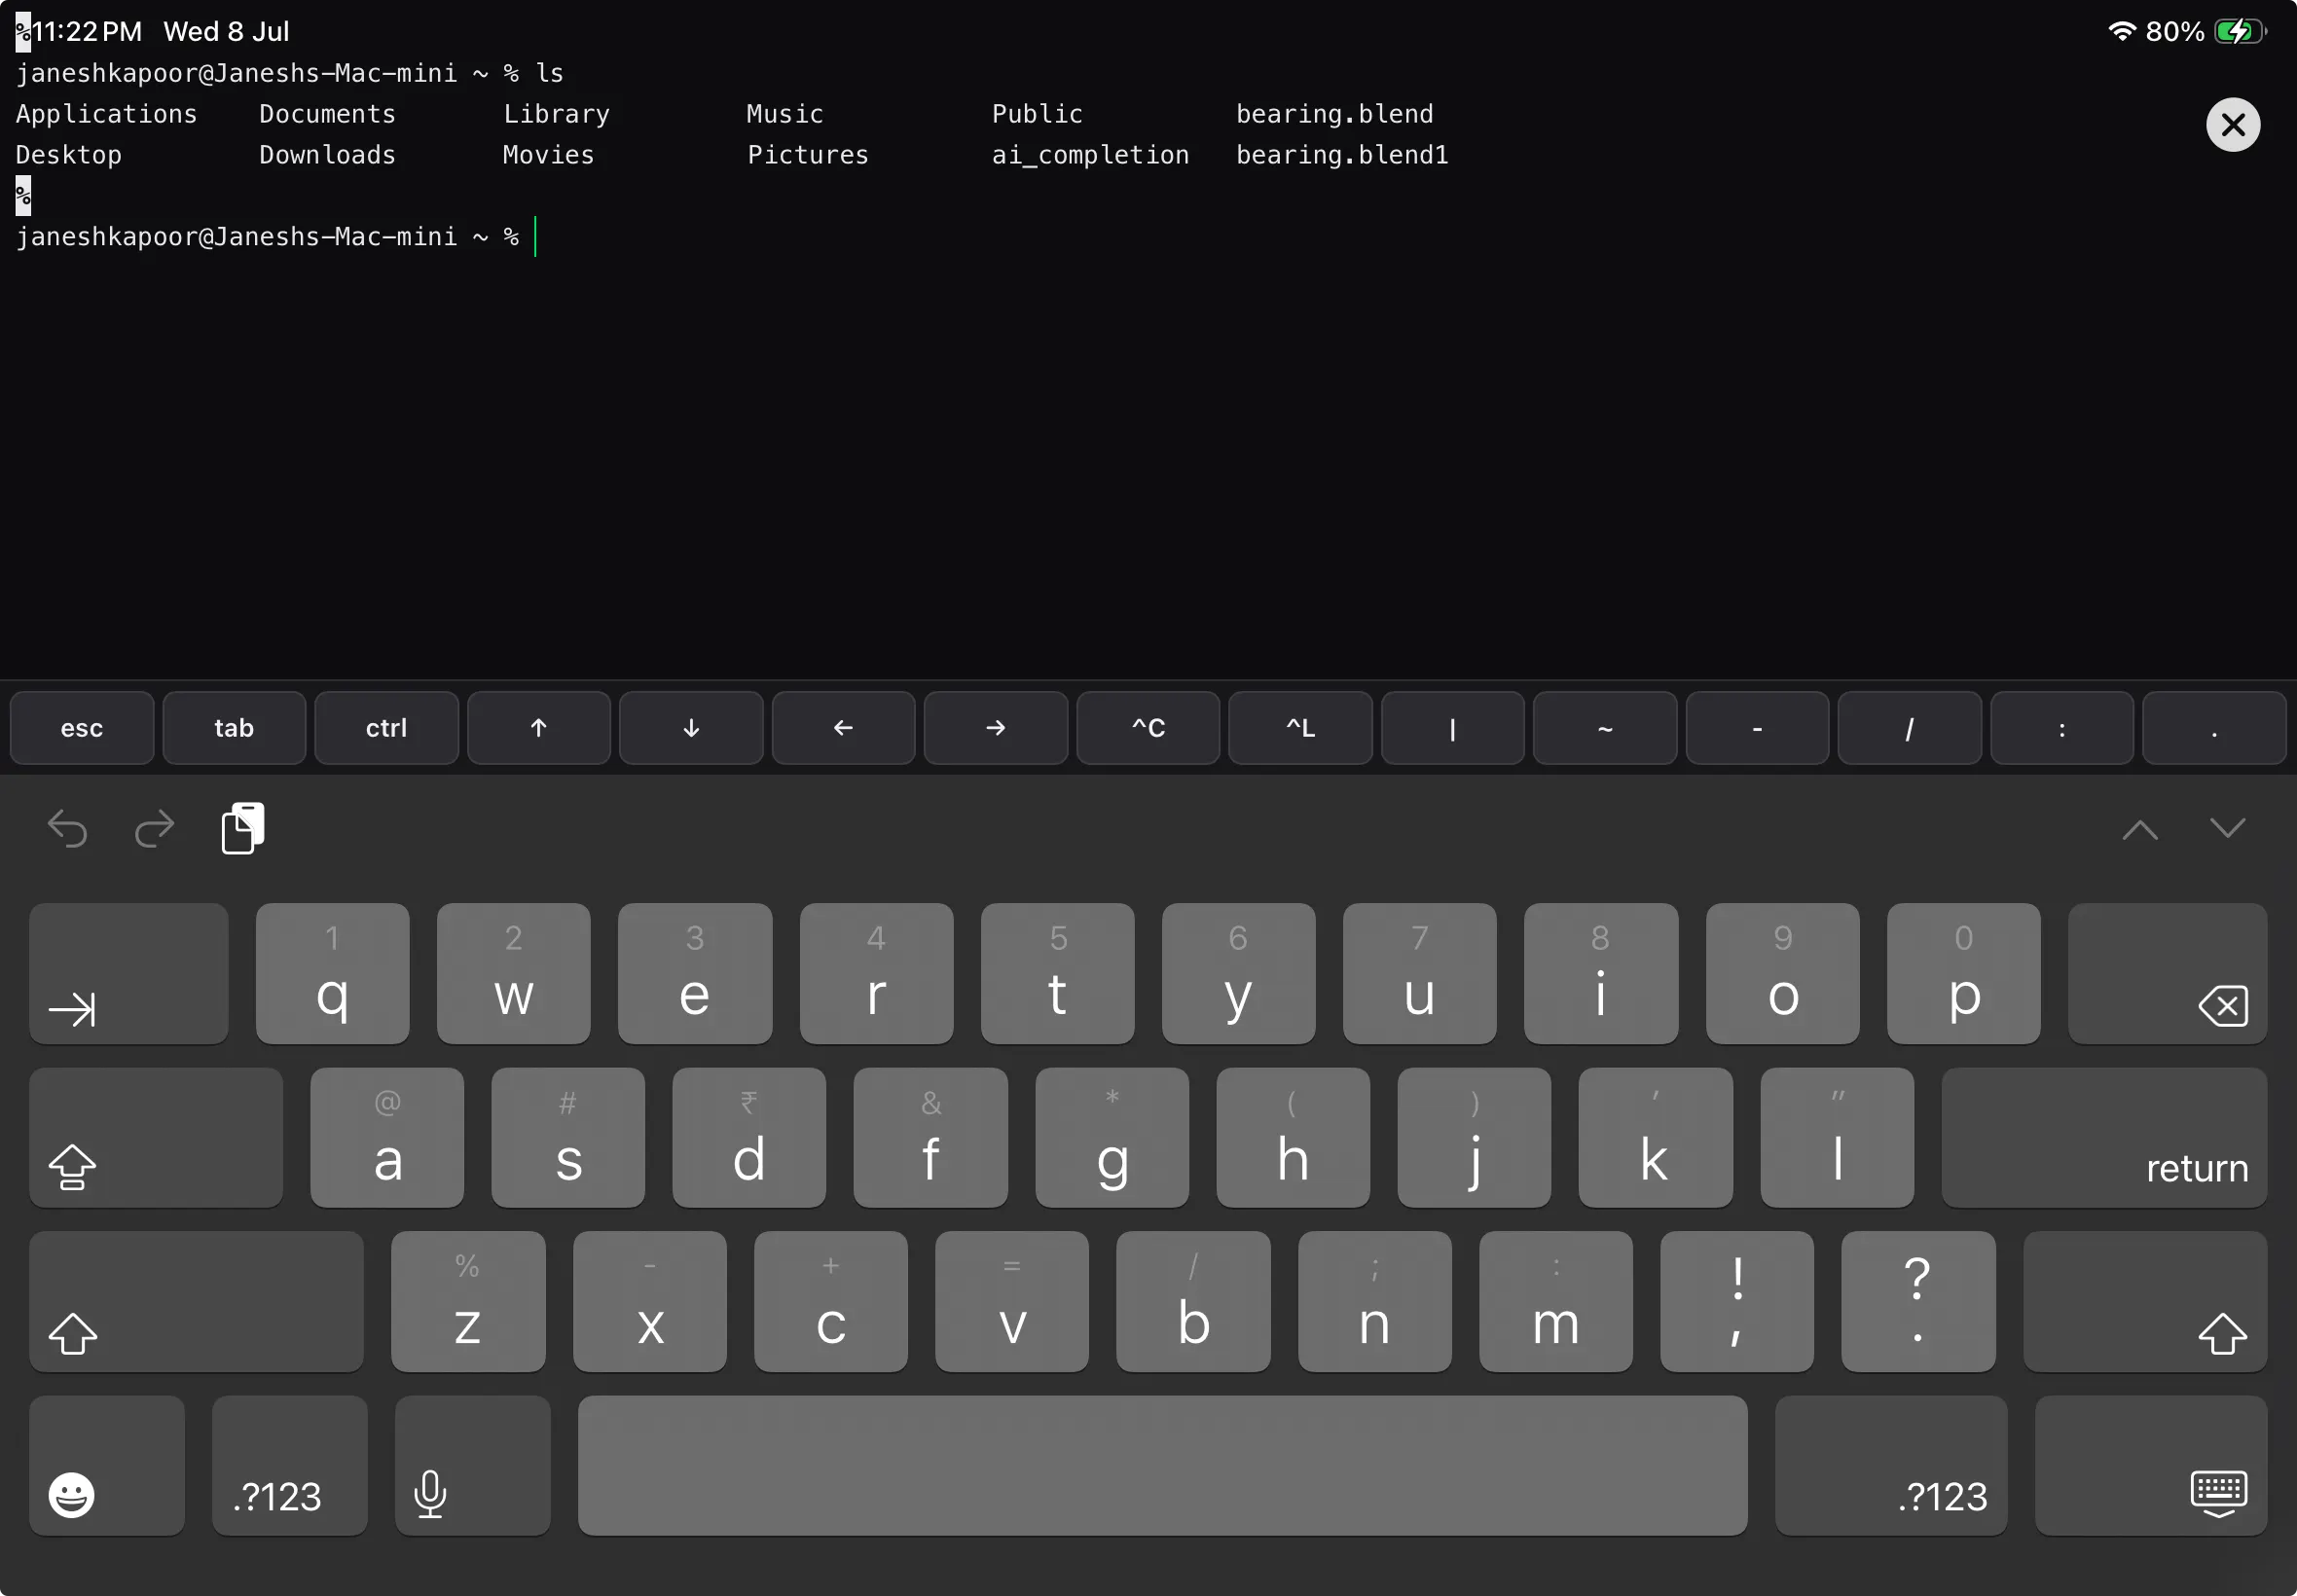
一句话介绍:Servey 将你的 Mac 镜像到 iPhone 和 iPad 上,支持完整鼠标、键盘和真实终端,通过硬件加速保障局域网流畅度、点对点加密连接实现远程控制,解决“人离开 Mac 但需要操作 Mac”的随身控制痛点。
iOS
Mac
Apple
Mac远程控制
iPad终端
硬件加速
点对点连接
桌面镜像
移动办公
键盘鼠标重定向
局域网低延迟
远程运维
iOS工具
用户评论摘要:两条评论均集中认可局域网内无延迟体验,尤其提到硬件加速在家庭网络下效果明显;iPad端终端响应迅速,操作“原生感”强。目前无负面反馈,但样本量太少,未涉及公网传输质量与安全性验证。
AI 锐评
Servey 踩中了两个微妙的需求痛点:一是“跨设备形态”的连续性,二是“终端控”对键盘与真 Shell 的执着。从产品描述看,它没有选择走 TeamViewer 或 Jump Desktop 的通用路线,而是把“硬件加速”作为局域网体验的护城河,这确实击中了不少人在沙发上用 iPad 接管 Mac 的慵懒刚需。但冷静看,12个投票、两条零点赞评论,说明它目前仍处于极早期,且评论高度同质化,缺乏对公网环境、延迟波动、安全加密、多显示器等关键维度的实测反馈。更关键的是,它面临的竞品并非弱者:macOS 原生屏幕共享、Tailscale + VNC 组合、甚至 Parsec 的串流方案,都已在“速度—功能—免费”三角中占据位置。Servey 若只停留在“局域网快”这一单点优势,很容易被大厂复制;真正壁垒应在于“真实终端”是否做到如 iTerm2 般丝滑,以及点对点模式下是否能在无公网 IP 的 NAT 穿透场景中保持稳定。建议团队尽快发布公网压力测试报告,并开放免费层验证留存,否则这更像是一个不错的个人项目,而非能够规模化商业化的产品。
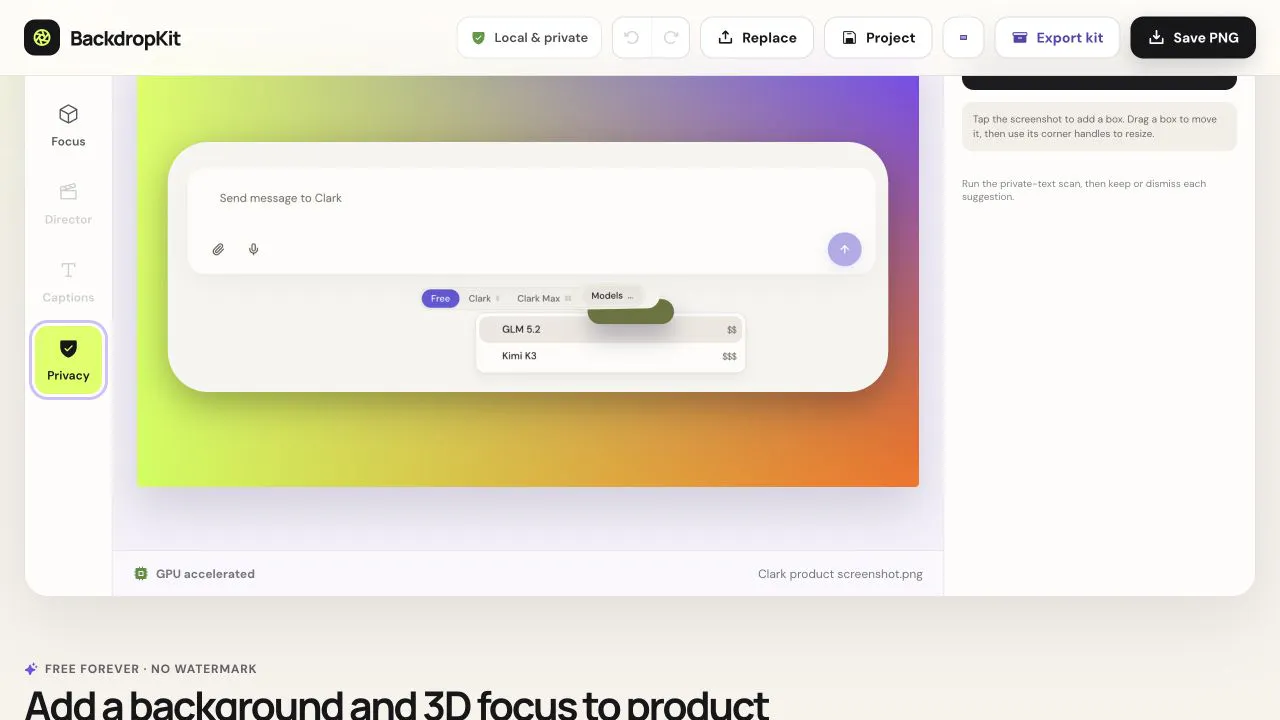
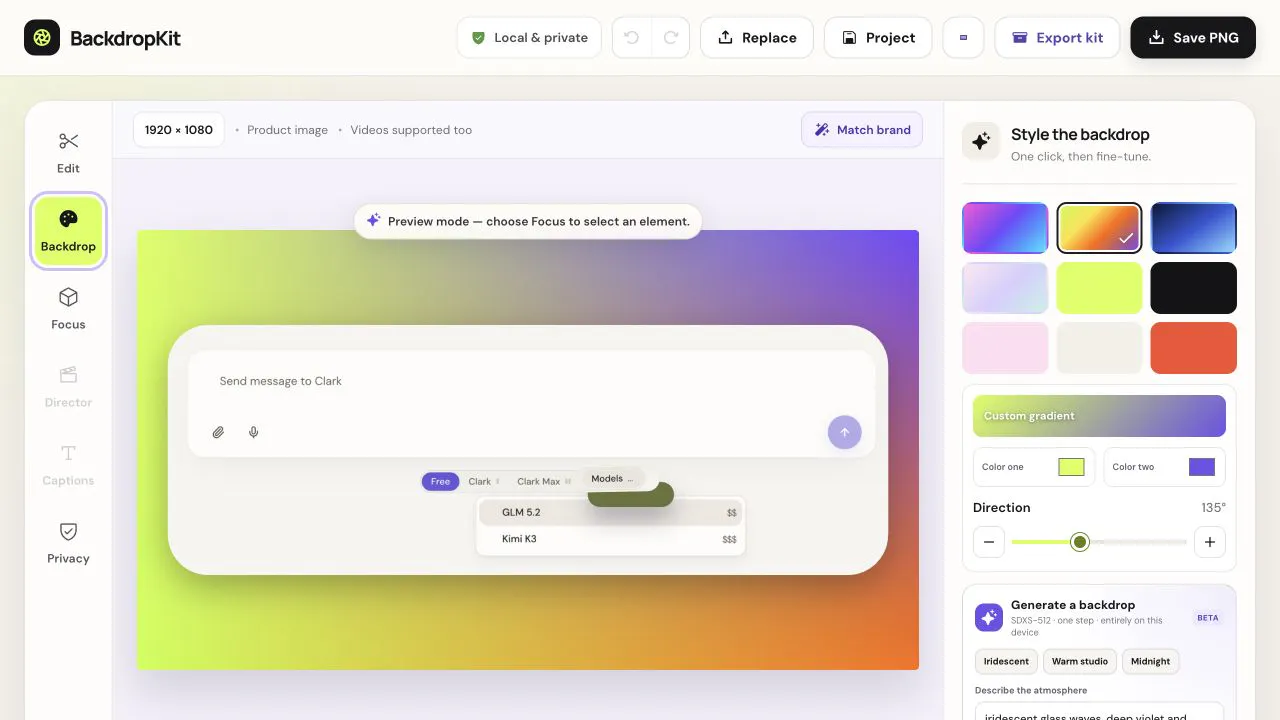
一句话介绍:BackdropKit 是一款在浏览器本地运行的发布素材制作工具,帮助开发者在不泄露隐私的前提下,将原始截图或演示视频一键加工成适配各大平台的发布级图片、视频、动图及文案。
Design Tools
Marketing
Privacy
本地隐私处理
截图美化
视频导出
发布素材
启动页设计
文本脱敏
AI背景生成
GIF制作
产品营销
无版权工具
用户评论摘要:现有评论较少,仅有一条祝贺语及一条开发者自述。有效反馈尚未形成,开发者主动询问“哪类发布素材制作最痛苦”,但暂无用户具体建议或问题。
AI 锐评
BackdropKit 切中的确实是独立开发者与小型团队在“发布前最后一公里”的琐碎痛点——不是做不出截图,而是让截图看起来不像随手截的。其“本地处理、设计上默认私密”的定位,在当前云端工具泛滥、数据泄露频发的环境下,是一个差异化的价值锚点,尤其对金融、医疗或未公开产品而言,这一卖点甚至比功能本身更诱人。但现实很骨感:12票的冷启动数据说明了两个问题——其一,Product Hunt 上“隐私友好”已非稀缺叙事,用户更关心生成效果是否足够惊艳;其二,浏览器本地处理意味着算力受限,尤其在视频生成和AI背景方面,其效果上限大概率低于云端专业渲染。若其本地生成质量无法与Canva、CleanShot X等成熟工具拉开代差,那么“私密”只能成为少数极客的勋章,而非破圈的筹码。更关键的隐患在于,产品将“导出文案、alt text”这类琐碎功能也纳入卖点,稀释了核心视觉处理能力的锐度。建议团队聚焦于“为GitHub开源项目或App Store审核场景提供一键式合规脱敏+极简视觉包装”,用更垂直的模板生态锁定特定用户群,而不是试图覆盖所有发布需求。否则,它很容易沦为“用了不错,但没到非用不可”的鸡肋工具。
Hi everyone!
@MiniMax H3 is especially good at turning a mixed set of references into finished-looking motion work.
You can mix text, images, video, and audio in one request, then simply tell H3 what you want to borrow from each reference. It can follow the same character, camera movement, voice, or overall visual style and turn everything into a 2K video with native stereo sound.
This makes H3 especially useful for commercial creative work. The output can feel much closer to a finished piece, with the typography, motion, pacing, and sound working together across product videos, motion posters, music visuals, and ecommerce campaigns.
The API is live now, and the weights are coming!
Text rendering is the claim I'd want tested hardest here, because a motion poster lives or dies on one word being right and video models have historically turned typography into soup. The useful test isn't whether it renders clean once, it's whether you can swap that word for a longer one and get the same layout back. Everything in a branding workflow is a re-render, so consistency across takes matters more than any single take. Native stereo in the same pass is the part that actually removes a handoff.
The unified text/image/audio input approach is interesting , most "all-in-one" generation tools end up mediocre at everything. How's the output quality holding up for commercial/branding use cases specifically, vs. more experimental content?
Congratulations
How can i reach out to your team?
🚀 Congrats on the launch! What stood out to me wasn't just the multimodal generation, but the potential to reduce the number of tools in a production workflow.
One question I had is about iterative editing. In a real marketing campaign, we rarely regenerate everything from scratch. We might only need to update a product image, change a headline, or swap a voiceover while keeping the same camera movement, pacing, and overall style.
Can H3 preserve those elements and edit only what's changed, or does each revision require generating a new video?
I think that workflow would make a huge difference for teams creating commercial content at scale.
thanks for eating my job. lol
ongrats on the launch, this is a strong day one showing. Mixing text, image and audio inputs in one model would make quick brand teasers way less painful, right now that is three tools and a lot of glue between them. Can I feed it a product shot plus a rough voiceover clip and have it build the motion design around both?
The multimodal breadth here is impressive: text, audio, image, video, and music under one roof is a lot to pull off well, and the ultra-long context plus strong code/agent capabilities is exactly the combination that makes these models actually useful for real workflows rather than demos. "Co-create intelligence with everyone" is a nice framing for the mission too. Curious which modality you've found resonates most with builders so far. Congrats on the launch! 🚀
is it better than flux and seedream?