PH热榜 | 2026-08-15
一句话介绍:Inferock Bench 是一款部署在应用与LLM服务商之间的本地代理工具,通过拦截并记录每一次API调用的token消耗、失败与重试详情,生成独立的“账单凭证”,帮助开发者识别并量化AI服务账单中隐藏的超支与计费偏差。
Open Source
Developer Tools
Artificial Intelligence
GitHub
API账单审计
本地代理
Token用量监控
成本优化
失败重试追踪
开发者工具
开源
计费透明度
LLM运维
多云模型管理
用户评论摘要:用户核心痛点集中在静默重试、中断计费及无凭据对账。有效问题包括:能否识别返回200但内容损坏的调用?是否支持导入历史日志进行回溯审计?如何区分合理隐性消耗(推理、缓存token)与真实损失?多数评论认可本地代理与独立凭证的设计,认为比供应商仪表盘更可信。
AI 锐评
Inferock Bench切中了一个被忽视却极其刁钻的痛点:AI供应商既是运动员又是裁判员。当OpenAI或Anthropic的账单出现异常,开发者手中没有任何独立于供应商的底层数据来举证或申诉。这款工具的价值不在于“省了多少钱”,而在于将不可验证的信任问题转化为可核查的凭证问题。
从产品设计看,本地代理是正确且务实的架构选择。它避开了云中转的数据合规雷区,只需修改baseURL和API Key两个配置即可接入,迁移成本极低,直击开发者“懒得换”的心理惯性。其统计逻辑也足够克制——只将可证明的消耗计入损失,而将推理、缓存、工具调用等模糊地带标记为“待检查”,这种保守策略反而增强了报告的可信度,避免了“夸大损失”的质疑。
但产品存在明显边界。首先,它无法捕获“200但内容错误”的语义级故障,这恰是Agent场景中成本黑洞的重灾区,也是用户最困惑的部分。其次,它严格面向未来流量,无法回溯历史账单,这限制了其在“事后审计”场景中的吸引力,而该场景恰恰是用户付费意愿最强的入口。最后,其“凭证”价值高度依赖服务商认账——若供应商拒绝以第三方记录作为退款依据,工具的实际杀伤力将退化为“开发者自嗨”。
更深层的隐忧在于定位尴尬:对于个人开发者,几百美金的差异不足以驱动长期部署;对于企业级用户,更需要的可能是CloudHealth这类多云成本管理平台,而非单点代理。Inferock Bench若能切入“按凭证对账”的自动化退款流程,或与财务系统打通,方有从“良心工具”升级为“刚需基建”的可能。目前而言,它是一把好看的手术刀,但还需要找到真正愿意为“真相”买单的手术台。
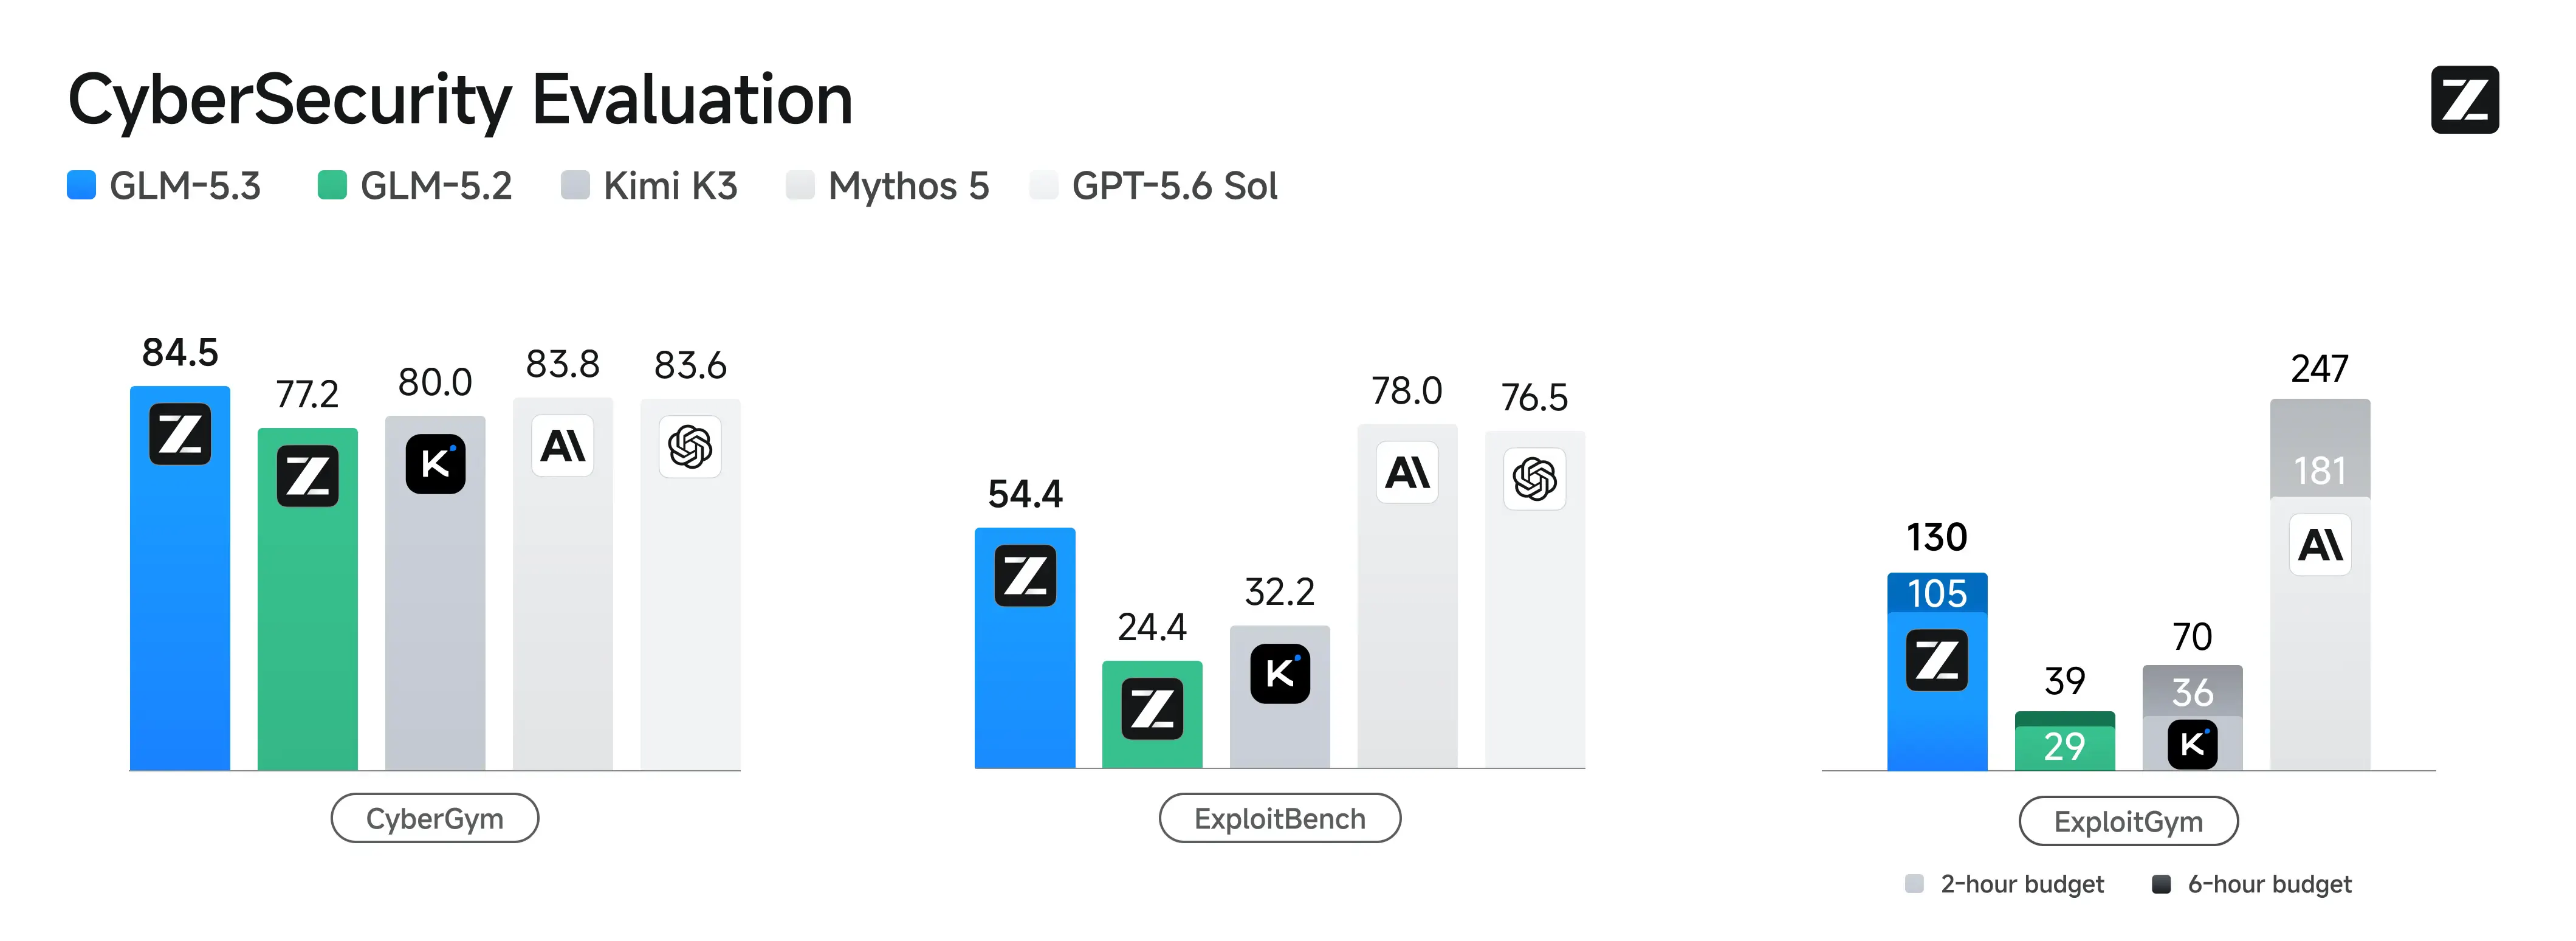
一句话介绍:GLM-5.3 是一款面向复杂长程编程任务的智能体编码模型,通过大规模后训练扩展,在同等基座上实现开源SOTA级智能体编码能力,并涌现出漏洞挖掘与网络防御的实战能力,解决了开发者在复杂任务中依赖云端前沿模型受限、且需要本地化高安全编码辅助的痛点。
Open Source
Artificial Intelligence
Development
AI编程助手
智能体编码
开源大模型
代码生成
网络安全
漏洞挖掘
后训练扩展
本地部署
开发者工具
Z.ai
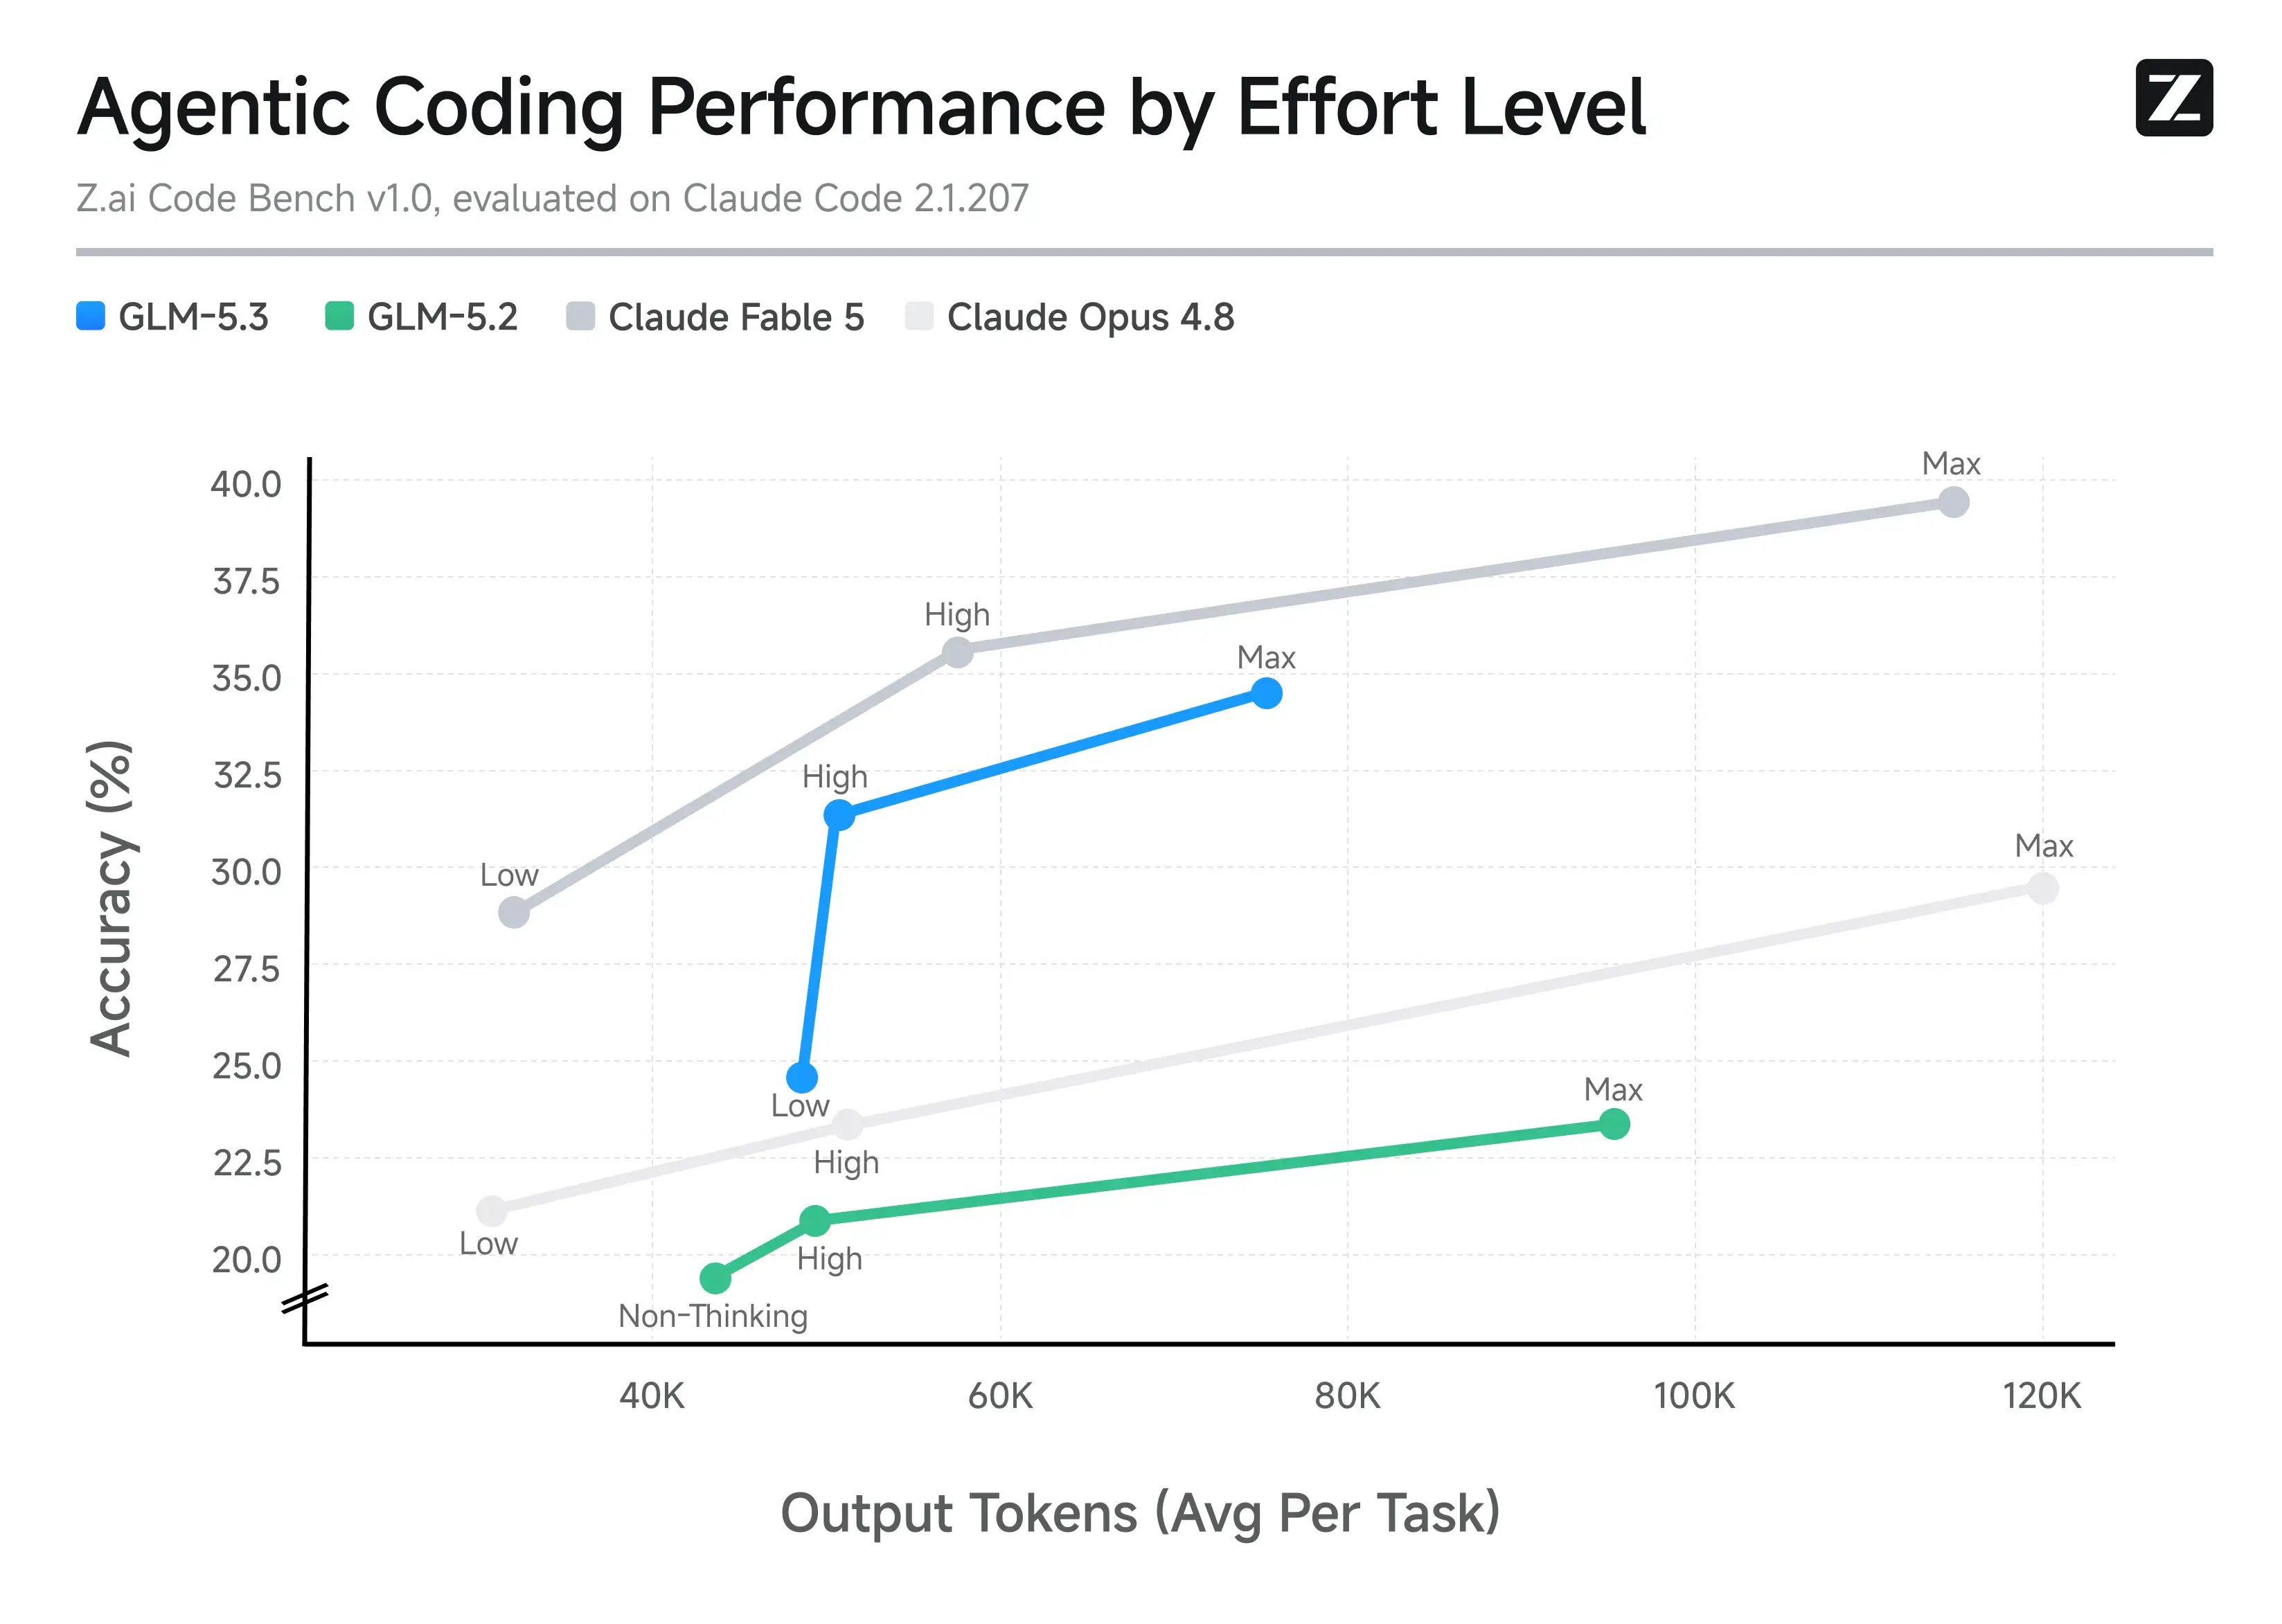
用户评论摘要:用户对后训练带来的性能跃升表示认可,但质疑“少于一半输出token”在真实智能体循环中的有效性,指出基准测试未覆盖重试及无效工具调用的token浪费。另关注5.2至5.3是否API级无缝切换,及高努力模式是否需要调整提示词。
AI 锐评
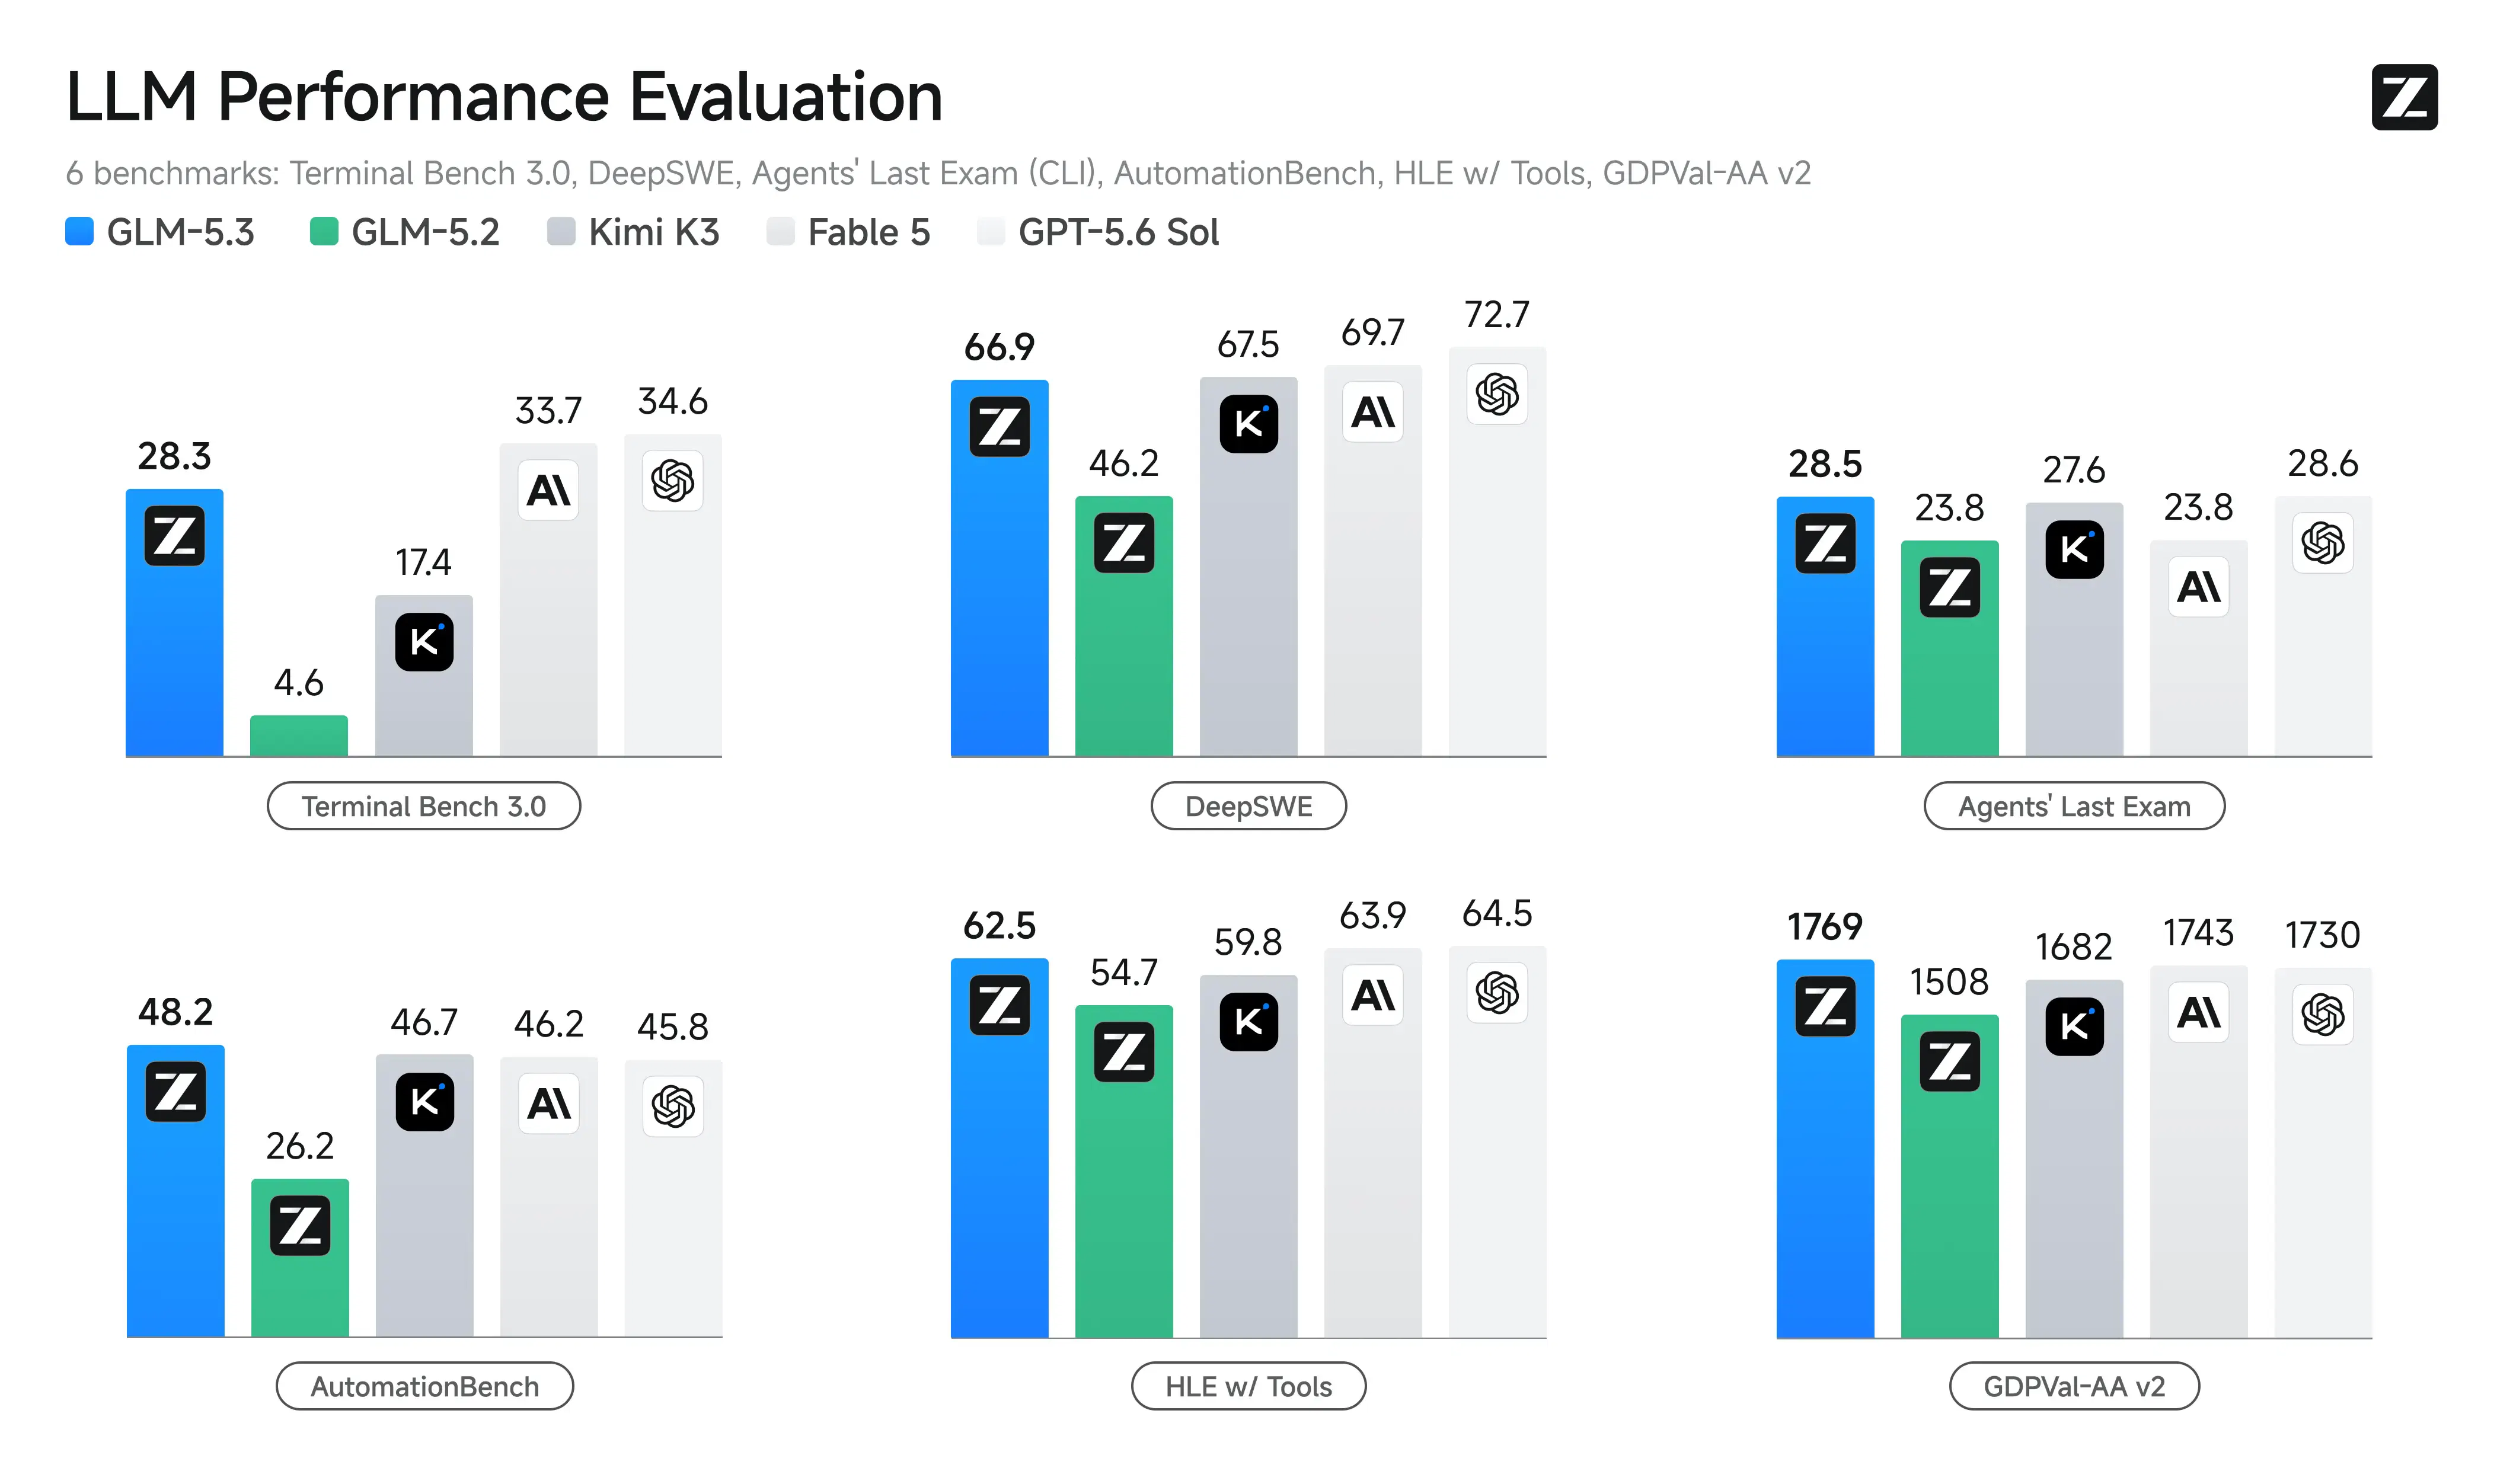
GLM-5.3的发布,表面上是又一轮模型迭代,实则是对“基座决定论”的一次精准打脸。它用同一个基座,仅靠后训练扩展,就在编程与网络攻防上压过Opus 4.8,这直接动摇了“攒算力堆基座”的军备竞赛逻辑,反而印证了数据配比、训练策略与安全对齐工程化才是当前拉开差距的胜负手。更值得玩味的是“开源权重两周后放出”与“Hugging Face本地部署事件”的暗示:当云端前沿模型因安全限制而“踩刹车”时,本地化、可审计的高性能模型不再是退路,而是一种战略主权。但评论区的质疑同样刺眼:基准测试中的“低token”不覆盖真实Agent循环中灾难性的重试与无效调用,这意味着厂商的benchmark metrics与开发者的痛点利润表之间存在巨大鸿沟。且“高努力模式”是否需要重写提示词,暴露出所谓“同基座”并非无缝迁移的托词。GLM-5.3的真正价值不在于多几个点分,而在于它示范了后训练可以持续榨取能力的上限——但这上限的地板,很可能由脆弱的安全评估流程和真实场景适配成本决定。若Z.ai不能公布全链路的token开销及提示词迁移成本,这次“性能跃迁”不过是另一场精心设计的营销烟花。
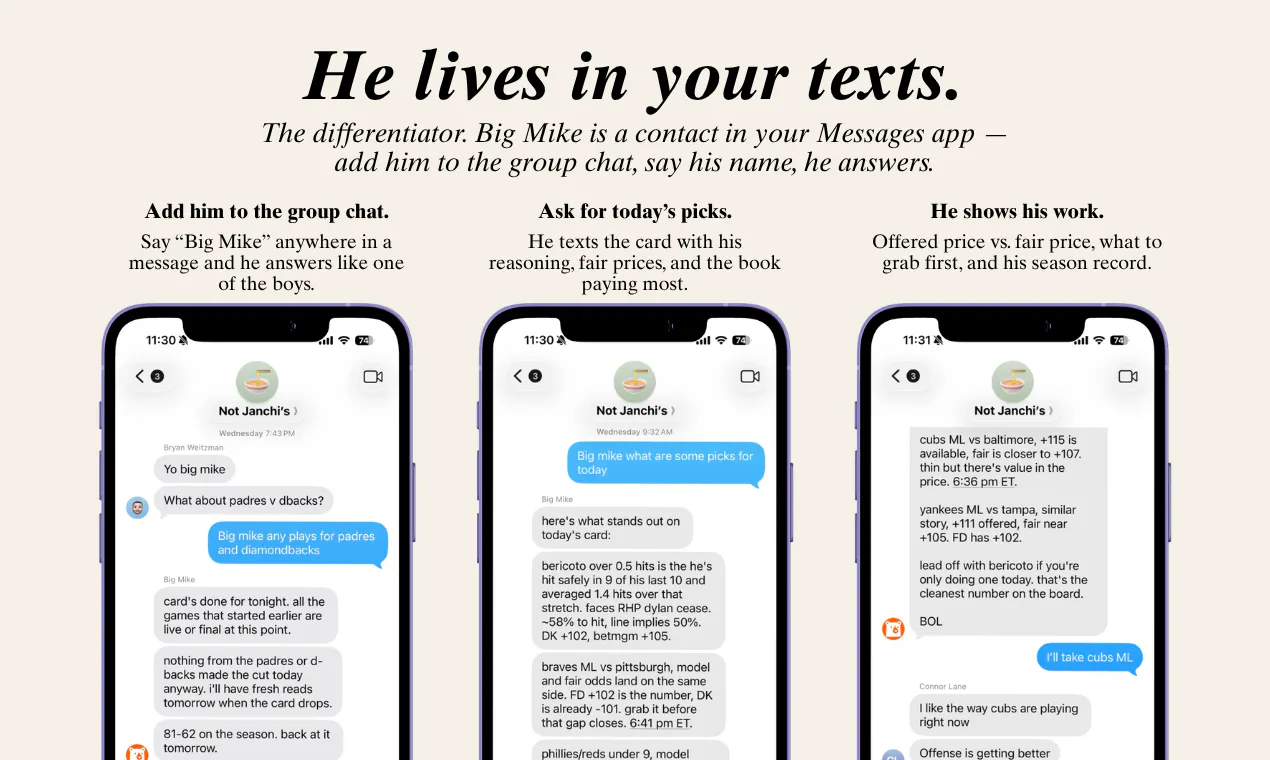
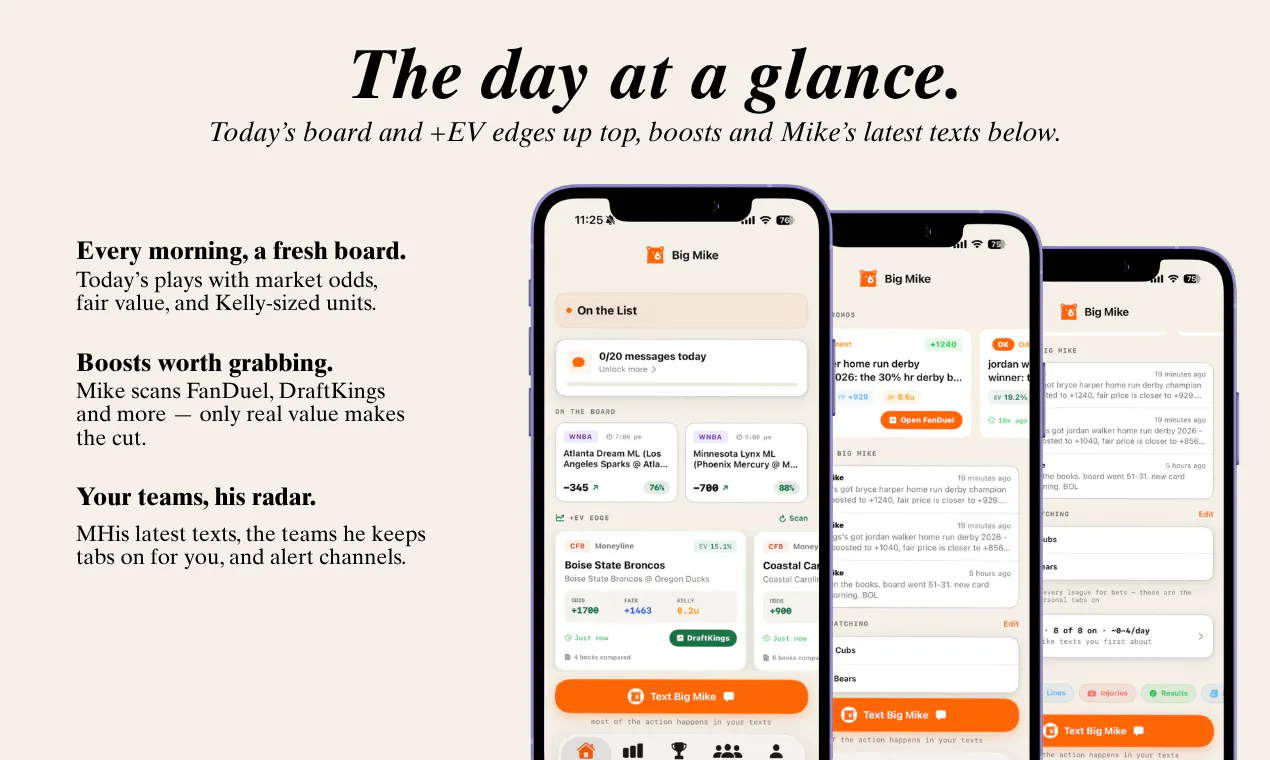
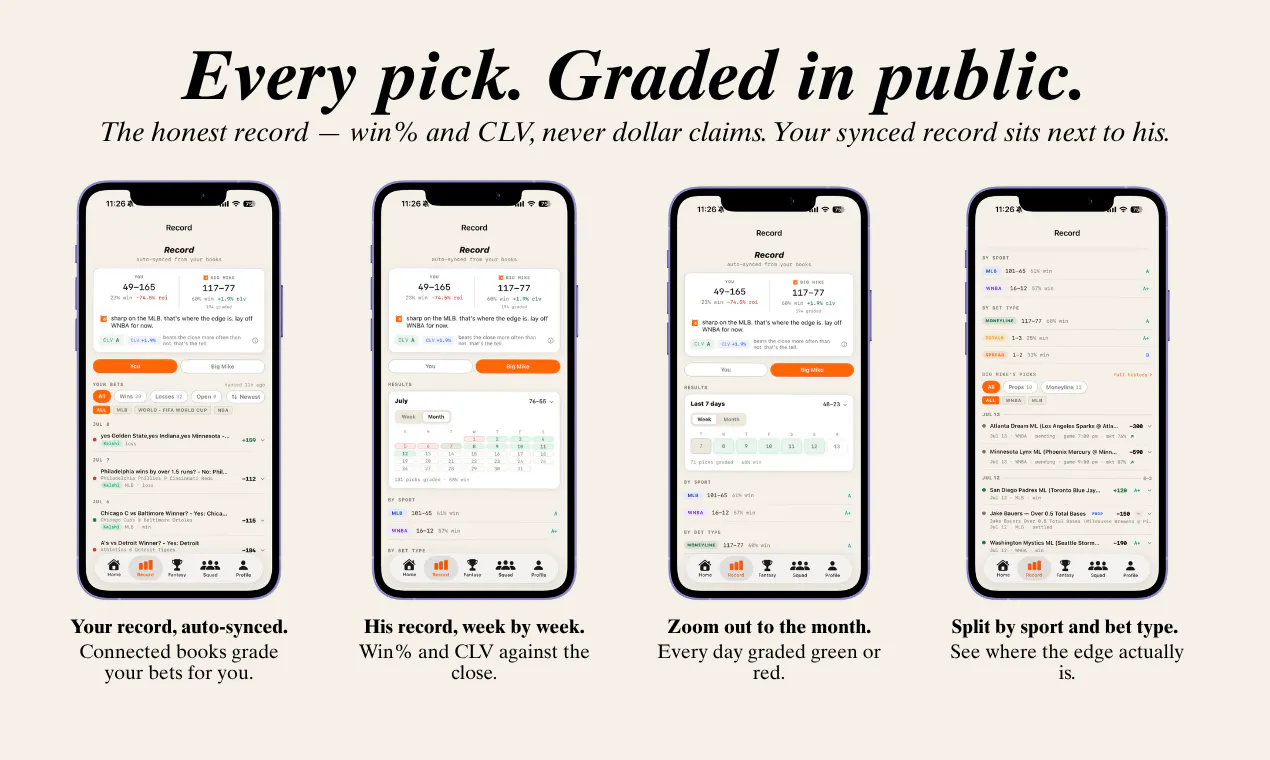
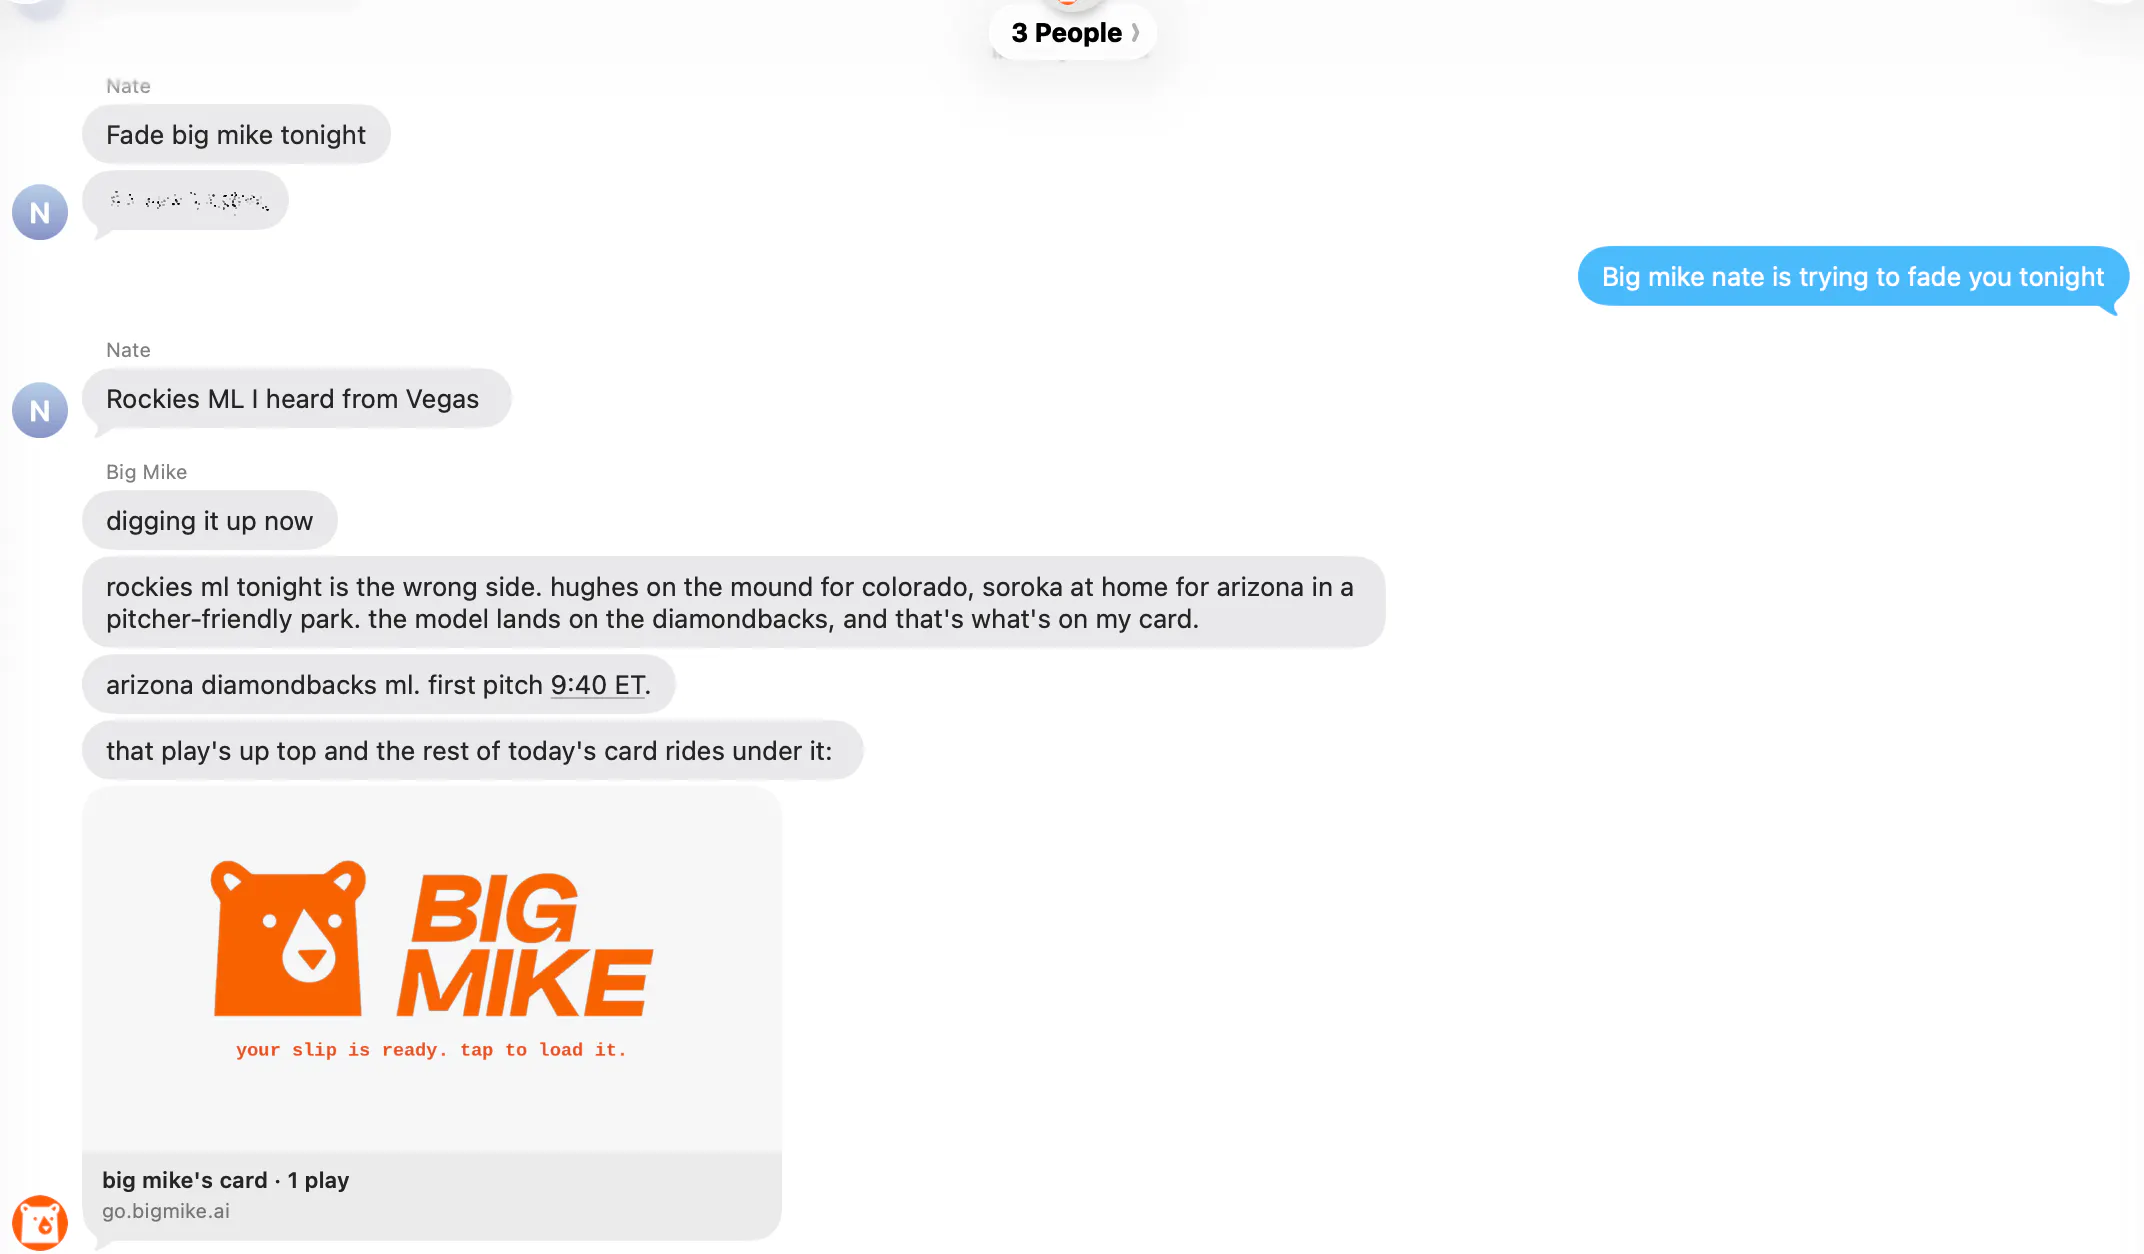
一句话介绍:Big Mike 是一个嵌入 iMessage 的 AI 体育助手,实时推送 MLB/NFL/NBA 等赛事的伤病、交易、赔率变动与投注建议,并能接入用户 fantasy 联赛,直接在群聊中完成讨论与下注参考,解决体育迷“信息分散、决策滞后、缺乏可信依据”的痛点。
Messaging
Sports
Artificial Intelligence
体育博彩
iMessage机器人
AI赛事分析
实时伤病提醒
梦幻体育建议
群聊互动
公开投注战绩
赔率价值评估
体育资讯聚合
用户评论摘要:用户普遍认可“群聊内即用”的体验与“公开战绩”的透明度,尤其赞赏伤病/阵容实时提醒的实用性。主要疑问集中在:是否支持 WhatsApp/Telegram(官方回应将优先扩展 WhatsApp);如何处理群聊发言时机(当前需 @Big Mike 或回复其消息,未来将提升主动对话能力)。另有用户关注每单的推理依据与 Closing Line Value(CLV)展示,认为这是核心信任来源。
AI 锐评
Big Mike 的聪明之处,在于它没有试图再造一个“体育博彩 App”,而是寄生在 iMessage 这个最高频的社交场景里,把“聊球”和“下注”天然缝合。这解决了体育博彩行业两个根深蒂固的问题:一是信息滞后——伤病、首发、赔率跳变往往发生在开赛前几分钟,传统 App 需要用户主动刷新,而 Big Mike 把被动推送做成了主动对话;二是信任缺失——它用“公开、不可删除、按 CLV 而非胜率论英雄”的机制,直接对标了那些 P 图晒战绩的网红“专家”,这是教科书级的差异化定位。
但风险同样明显。首先,合规是悬顶之剑——美国多州对体育博彩推广有严格监管,AI 直接给出“下注建议”是否构成“投顾服务”,法律边界模糊,且 Apple 对涉及博彩的 App 审核向来谨慎,iMessage 集成更是敏感区。其次,商业模式依赖订阅,而用户对“AI 预测”的付费意愿会随连败周期迅速衰减——再怎么透明,连黑两周照样掉订。再者,目前仅限 iOS/iMessage 生态,等于主动放弃 Android 与海外 WhatsApp 用户,扩张路径与团队声称的“多平台计划”之间存在明显节奏矛盾。
真正值得玩味的是其“群聊人格化”设计——Big Mike 不是工具,而是“会抬杠的懂球 Uncle”。这暗示了 AI 消费产品的下一步:不是做大而全的助手,而是做有脾气、有战绩、可被调侃的“社交原子”。如果它能扛住合规压力、保持战绩真实,并顺利切入 WhatsApp 等跨平台入口,有机会从“体育博彩工具”进化为“体育迷的 AI 聊天伙伴”。但目前来看,它更像一个漂亮的 demo,尚未证明自己能在政策与用户情绪的双重波动中稳定盈利。观望其 NFL 赛季的实际留存数据,再谈颠覆不迟。
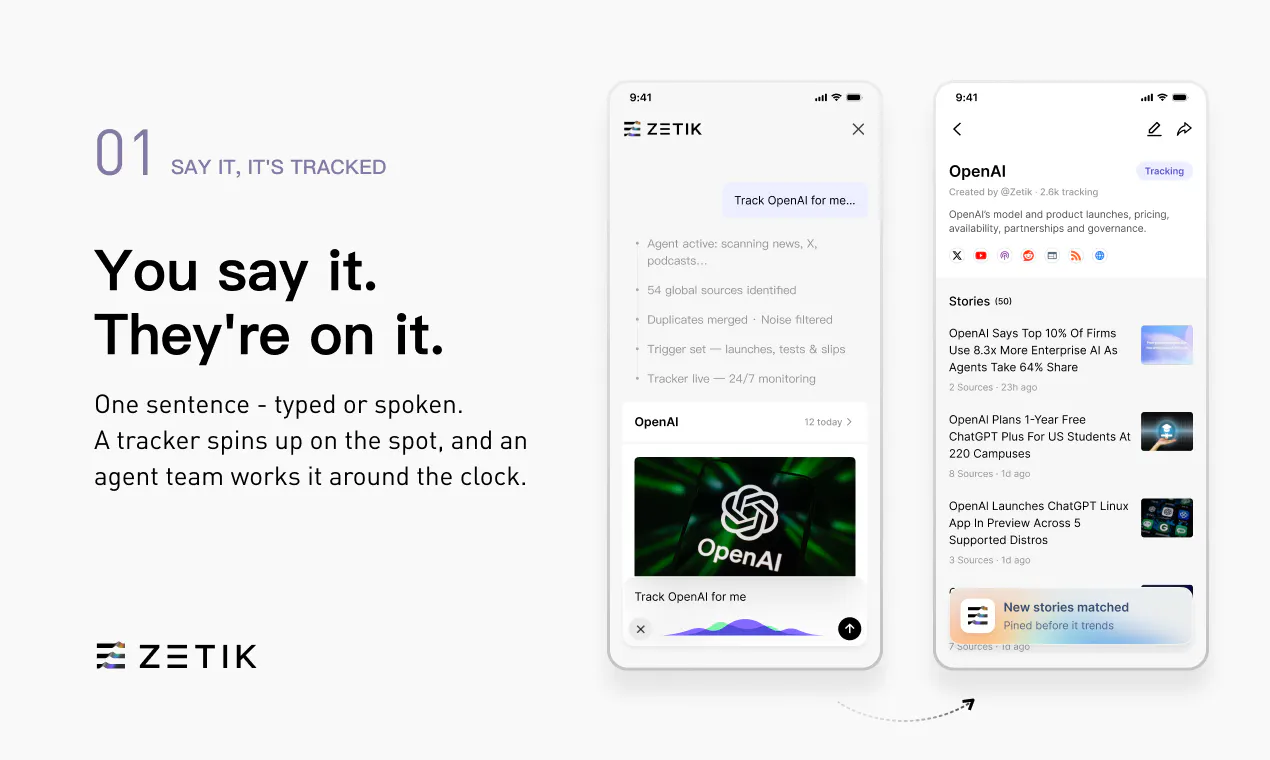
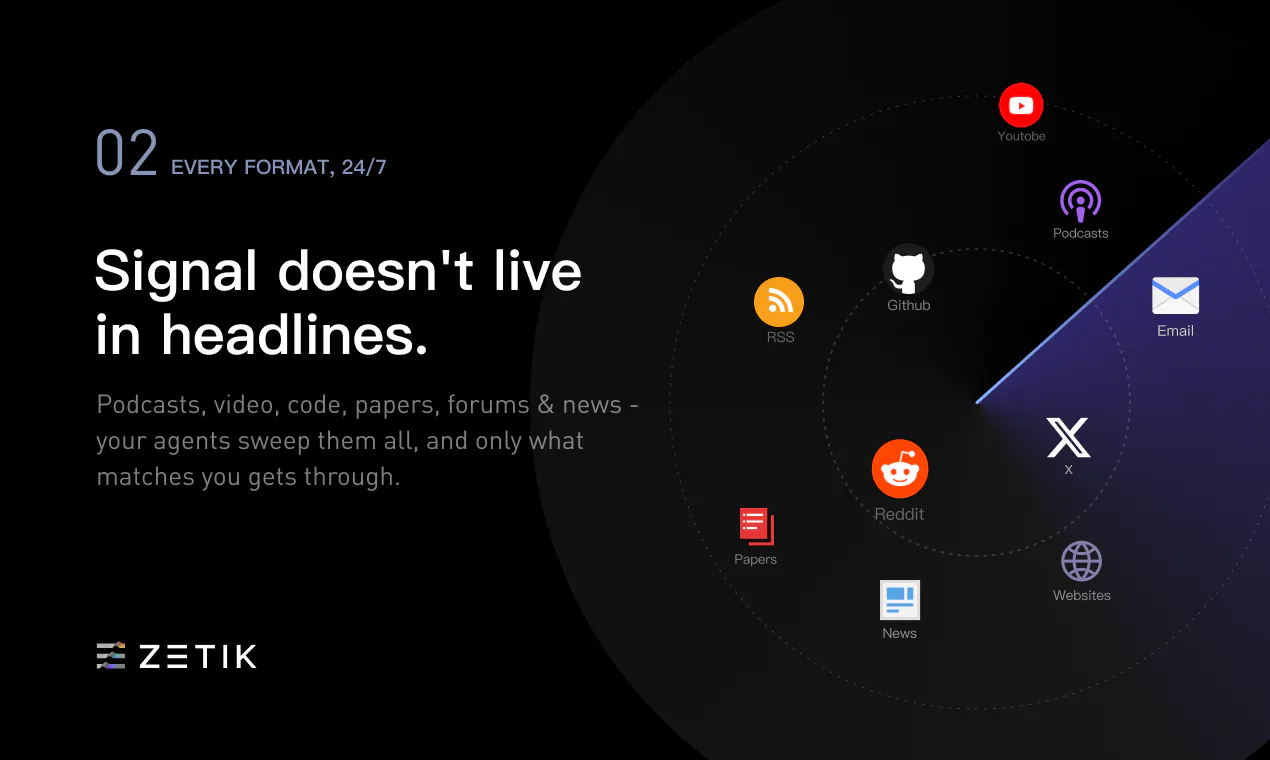
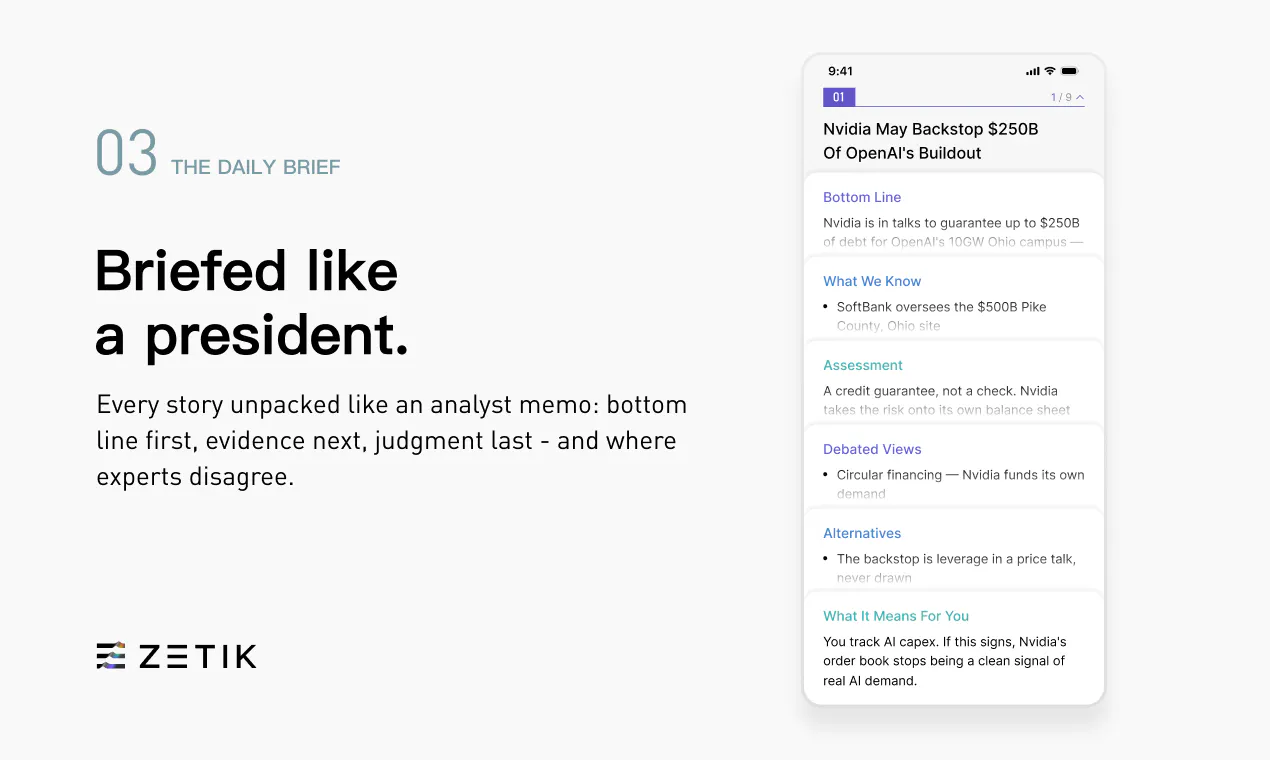
一句话介绍:Zetik是一款AI信息代理应用,通过全天候自动收集、筛选、分析并整合新闻、论文、代码、播客等多源信息,为用户生成个性化简报,解决信息过载和错失关键情报的痛点。
Productivity
News
Artificial Intelligence
AI信息代理
智能简报
信息过滤
多源聚合
个性化追踪
播客转文字
实时监控
知识管理
效率工具
情报分析
用户评论摘要:用户认可多格式信号追踪和定制追踪器的实用性,但核心疑虑在于:基于显式设定的追踪器可能只会优化“已知兴趣”的召回,而无法发现“认知边界外”的新类别;另有用户调侃AI是否会取代“刷手机”的习惯,并期待长期体验反馈。
AI 锐评
Zetik切中的痛点真实且普遍——信息过载已从“选择困难”演变为“认知负债”。其“情报参谋”定位精准,将CIA式工作流降维到个人场景,多格式聚合(尤其播客转文本)是相对RSS阅读器的实质性差异,而非换皮聚合器。
然而,产品最大的隐忧恰恰来自评论中最尖锐的质疑:算法依赖用户预设的tracker,本质上是“更强的过滤器”,而非“发现引擎”。真正的信息红利往往来自兴趣边缘的意外碰撞,而非既有主题的深度挖掘。如果Zetik只是把“我已知什么”做得更好,那么它优化的不过是效率,而非认知边界。创始人在回复中回避了这一核心矛盾——“跨格式追踪”解决的是广度,但“新类别发现”需要的是跳脱已知框架的推荐逻辑,这需要基于内容语义的拓扑分析,而非关键词匹配。
商业层面,154票属于中低热度,反映该赛道(如Feedly、The Browser Company)竞争激烈且用户付费意愿存疑。“首席信息官”的故事性感,但个人用户是否愿为“省下的刷手机时间”持续订阅,仍需验证。更现实的机会可能在垂直领域(如金融、科研)的高净值用户,而非泛知识人群。
一句话总结:Zetik是一款打磨良好的“信息减负工具”,但距离真正的“认知外脑”还有一步之遥——那一步,在于从“帮你找到你要的”跨越到“告诉你什么是你该知道的”。若不能解决,它终将与无数RSS增强工具一样,沦为高级收藏夹。
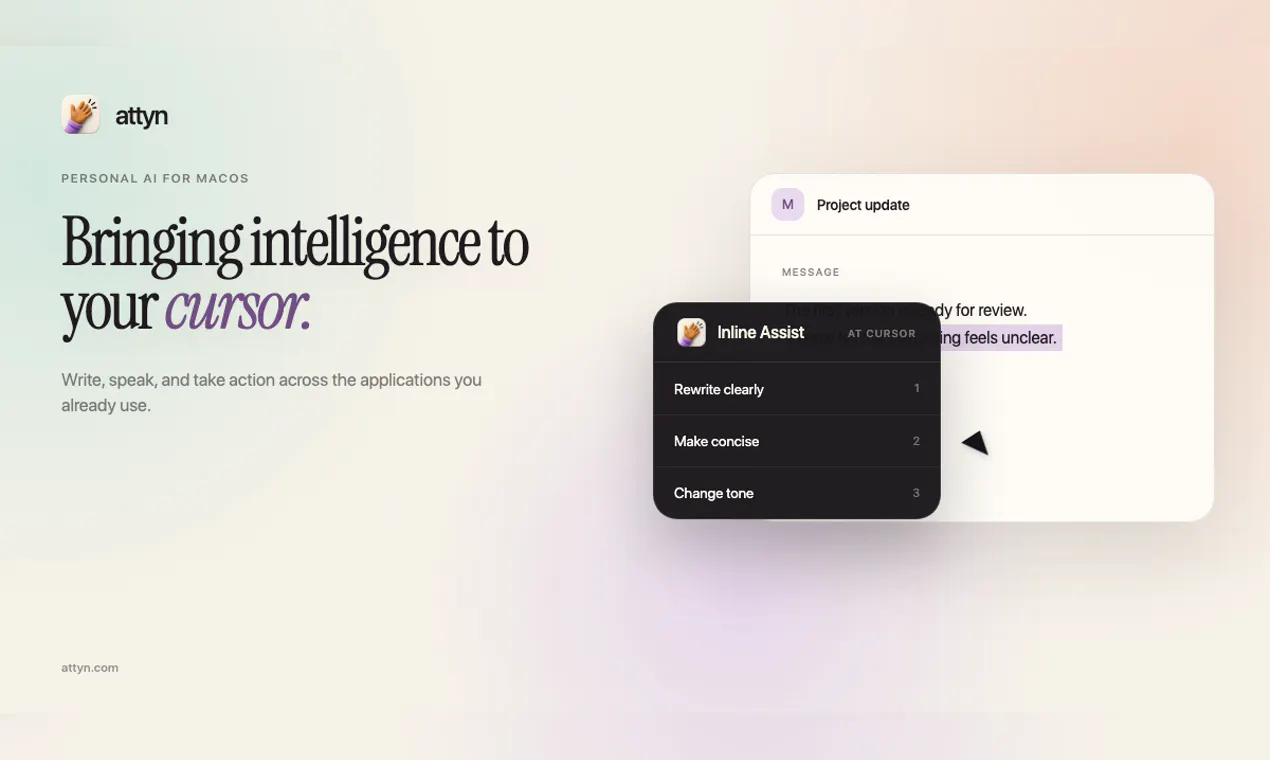
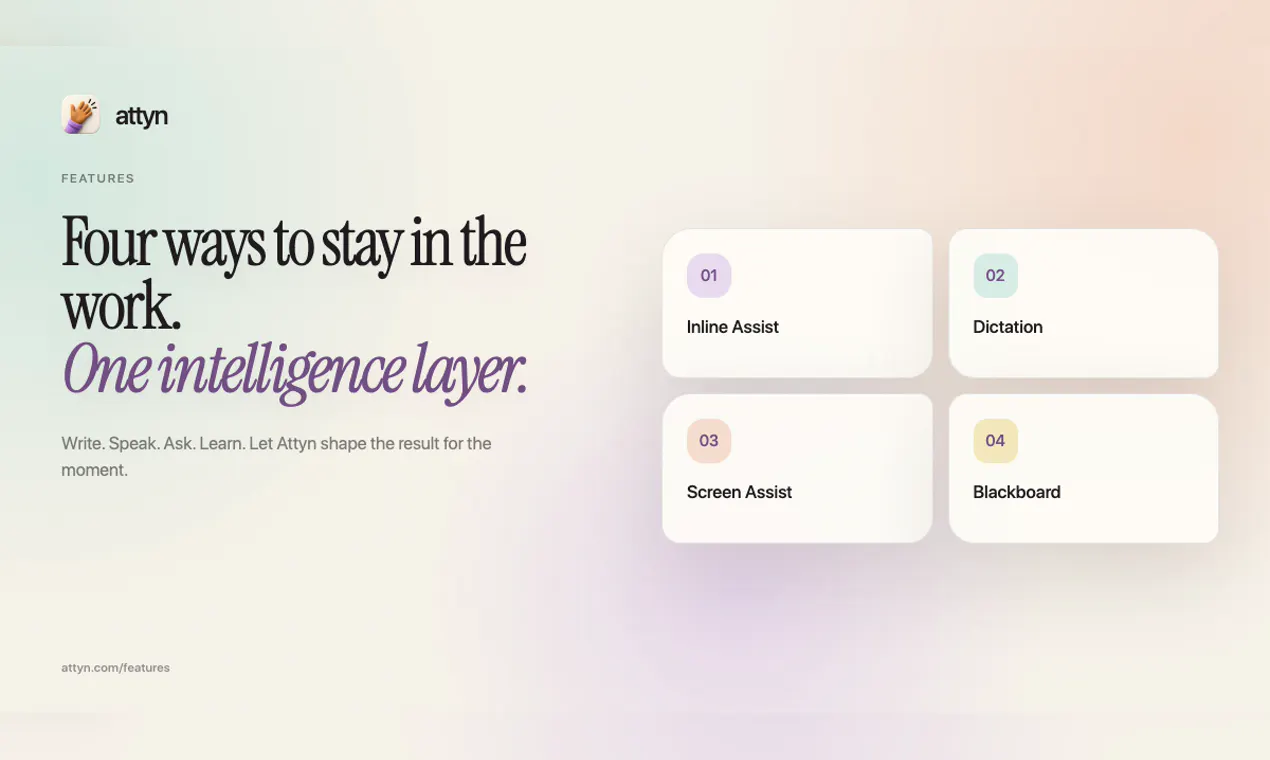
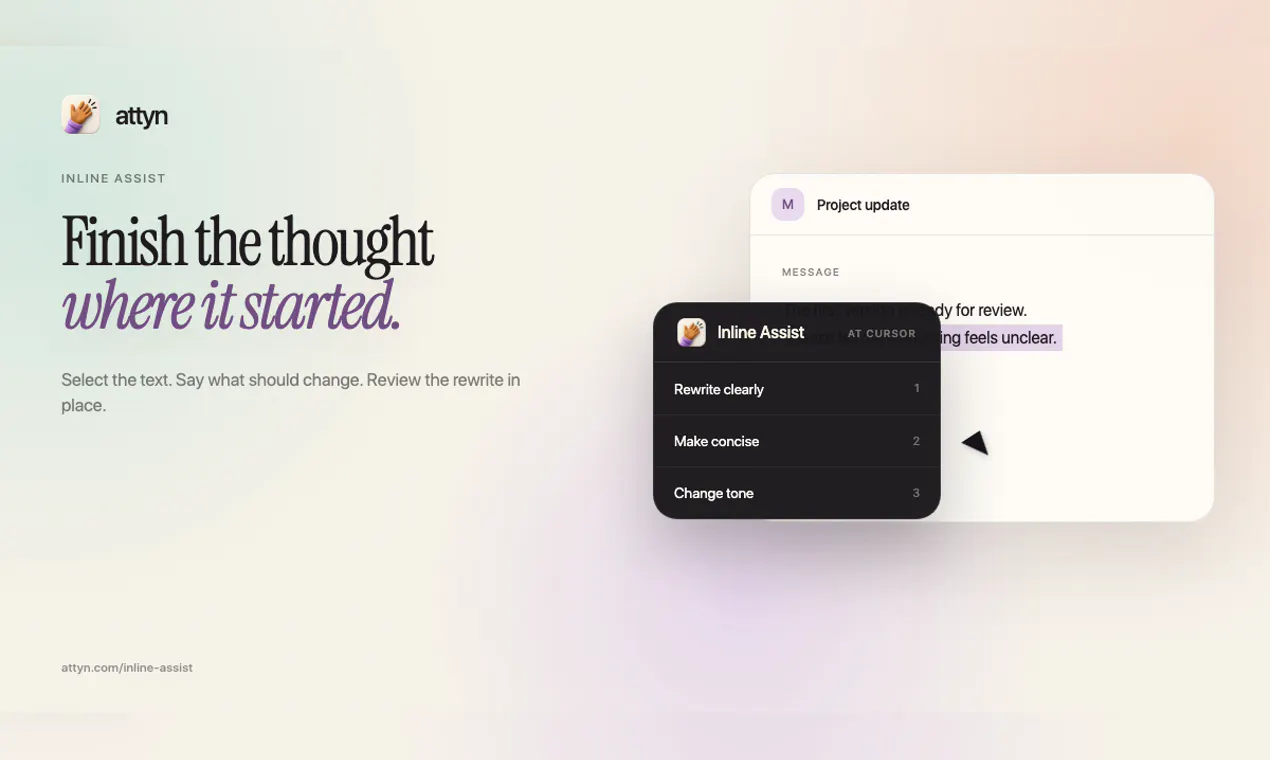
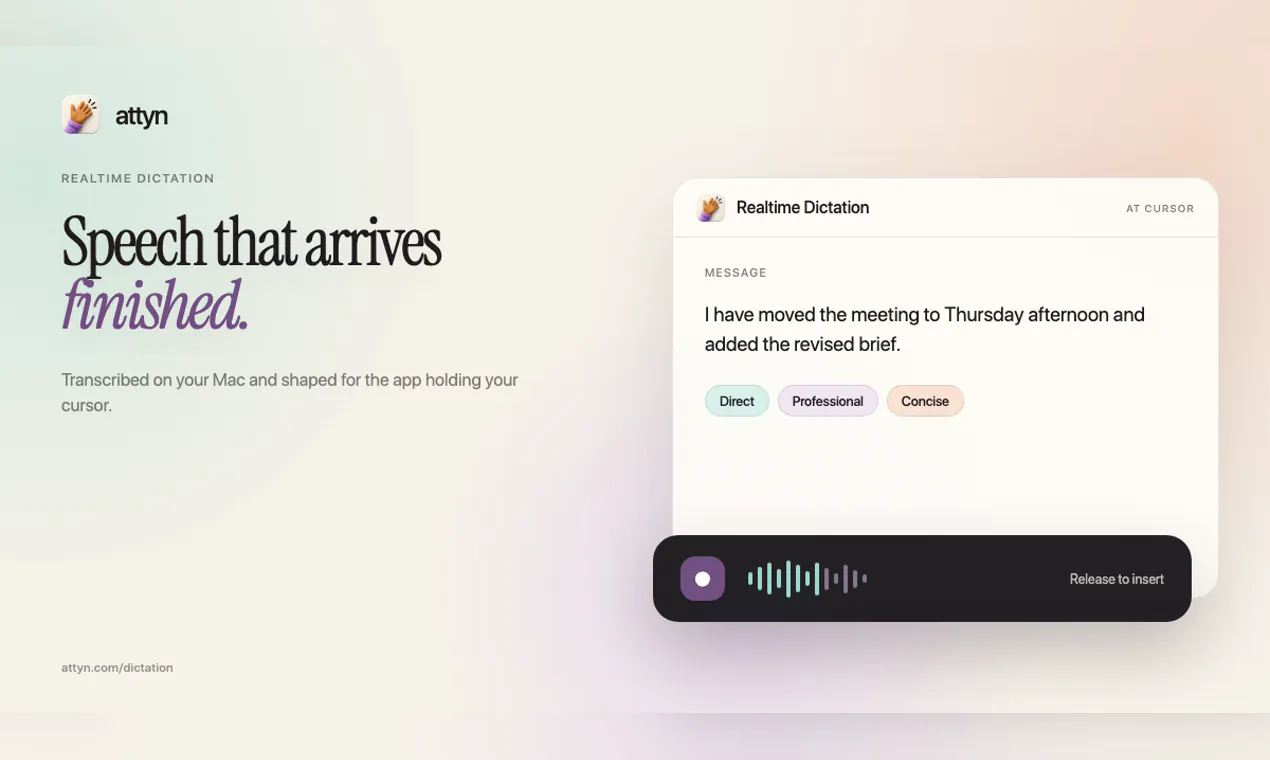
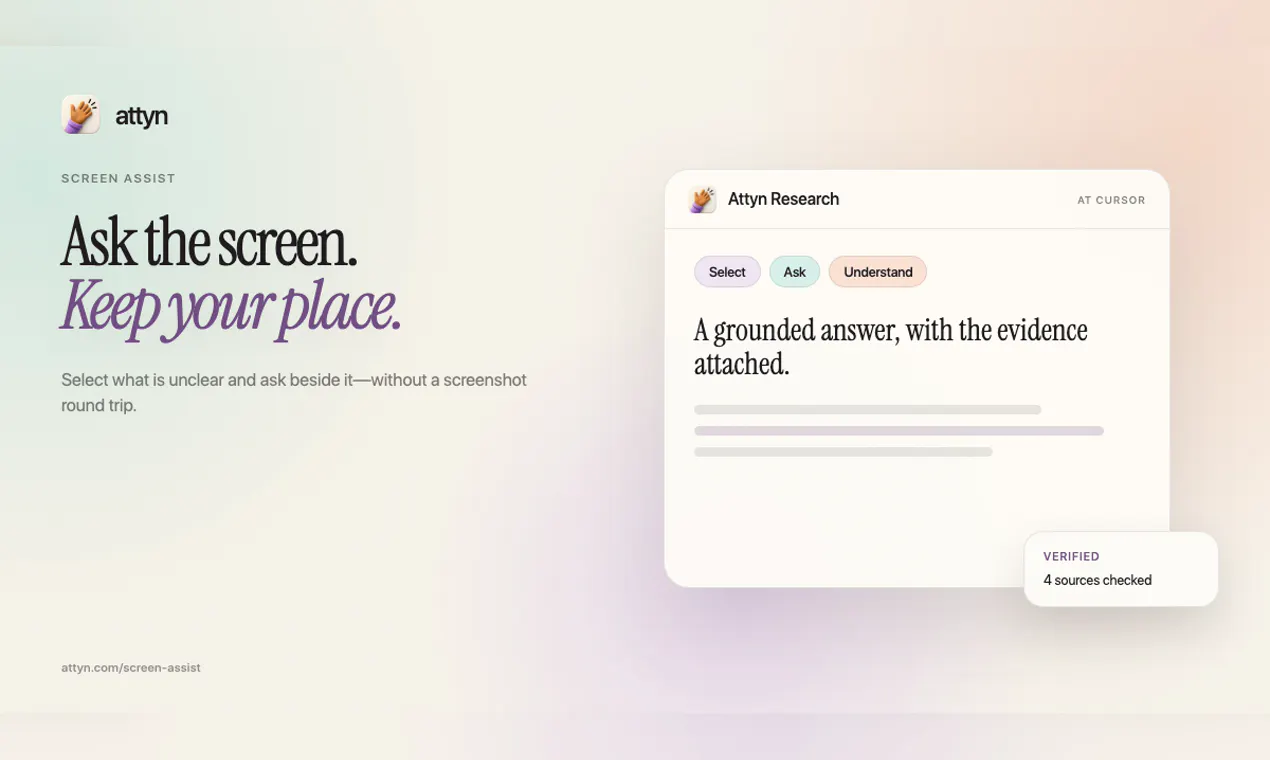
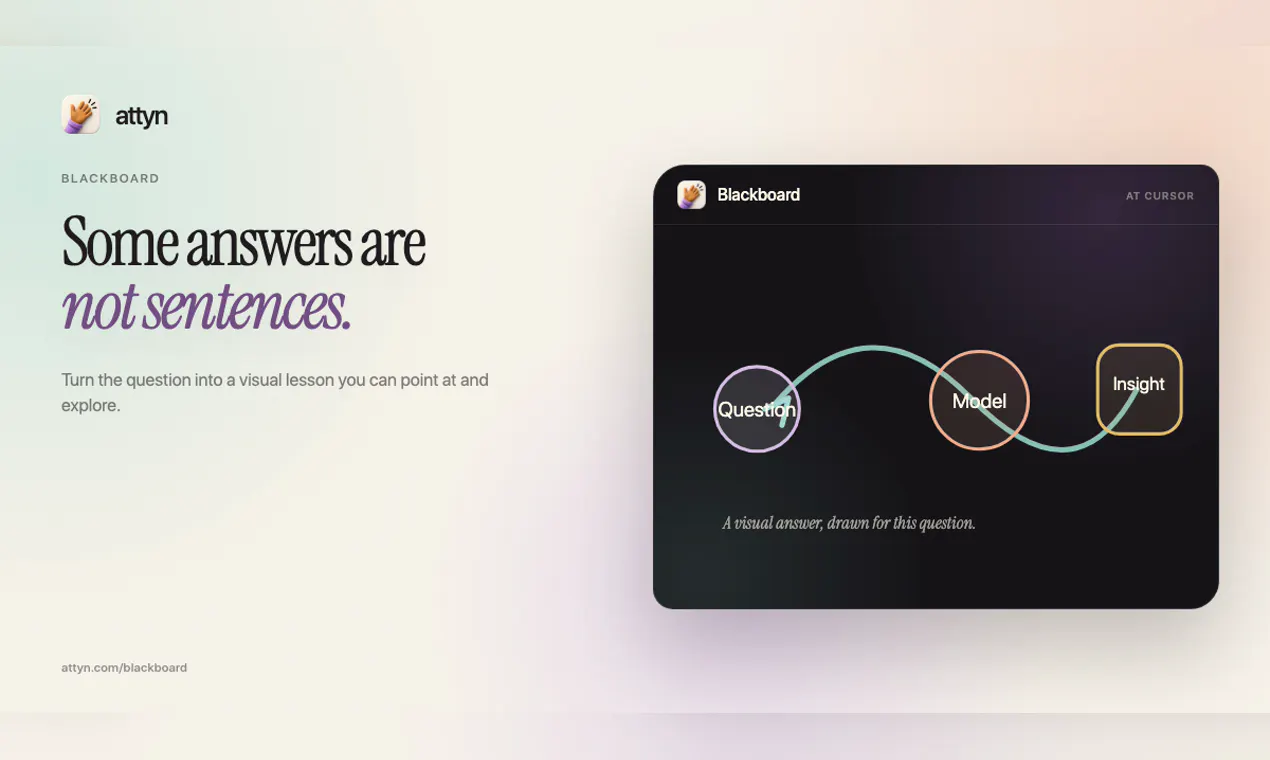
一句话介绍:Attyn 是一款将 AI 能力嵌入 macOS 系统光标层的效率工具,让用户在任意已打开的应用程序中直接完成改写、听写、屏幕问答和可视化讲解,免去频繁切换 AI 对话框的打断式工作流。
Mac
Productivity
Artificial Intelligence
AI 助手
光标增强
上下文感知
本地模型
效率工具
语音听写
屏幕问答
macOS
独立开发
BYOK
用户评论摘要:用户 Rohit 肯定了本地模型与 BYOK 的灵活性,并追问产品如何界定“自动推断上下文”与“用户主动授权范围”的边界。官方回应明确:仅自动识别前台应用和光标位置,内容读取完全由用户手势触发,无后台被动监控,手势即授权。
AI 锐评
Attyn 的切入点很聪明,它没有试图再造一个“AI 入口”,而是寄生在用户已有的数字肌肉记忆——光标上。这精准击中了当前 AI 工具最大的体验断层:上下文割裂。在一个拥挤的提示词市场里,它选择做“上下文运输带”,这本身就是一种差异化。
但必须泼一盆冷水。首先,135 票的声量在 Product Hunt 上仅算中游,说明“光标级 AI”的叙事虽美,但尚未形成爆发性共鸣,核心原因在于其能力上限受限于“单步操作”。无论是 Inline Assist 还是 Screen Assist,本质上都是“一次性问答”,无法支撑多轮复杂的任务推演,这会让它迅速从“生产力神器”沦为“高级划词翻译”。其次,macOS 的 Accessibility API 权限是双刃剑,尽管官方强调“手势即授权”,但用户侧对屏幕内容被“读取”的系统级弹窗警告,依然是巨大的信任成本。最后,作为一家 bootstrapped 独立开发商,在微软、OpenAI 巨头们正把 AI 深度植入操作系统(如 Recall 功能)的当下,Attyn 的窗口期并不宽裕。它的价值不在于颠覆,而在于提供了一种“隐私克制”的交互范本——如果它能尽快补齐 Windows 版并开放 API 接入更多垂直工具,或许能成为巨头生态下的一个优雅补丁;否则,很容易成为被系统级 AI 直接吞并的“小而美”牺牲品。
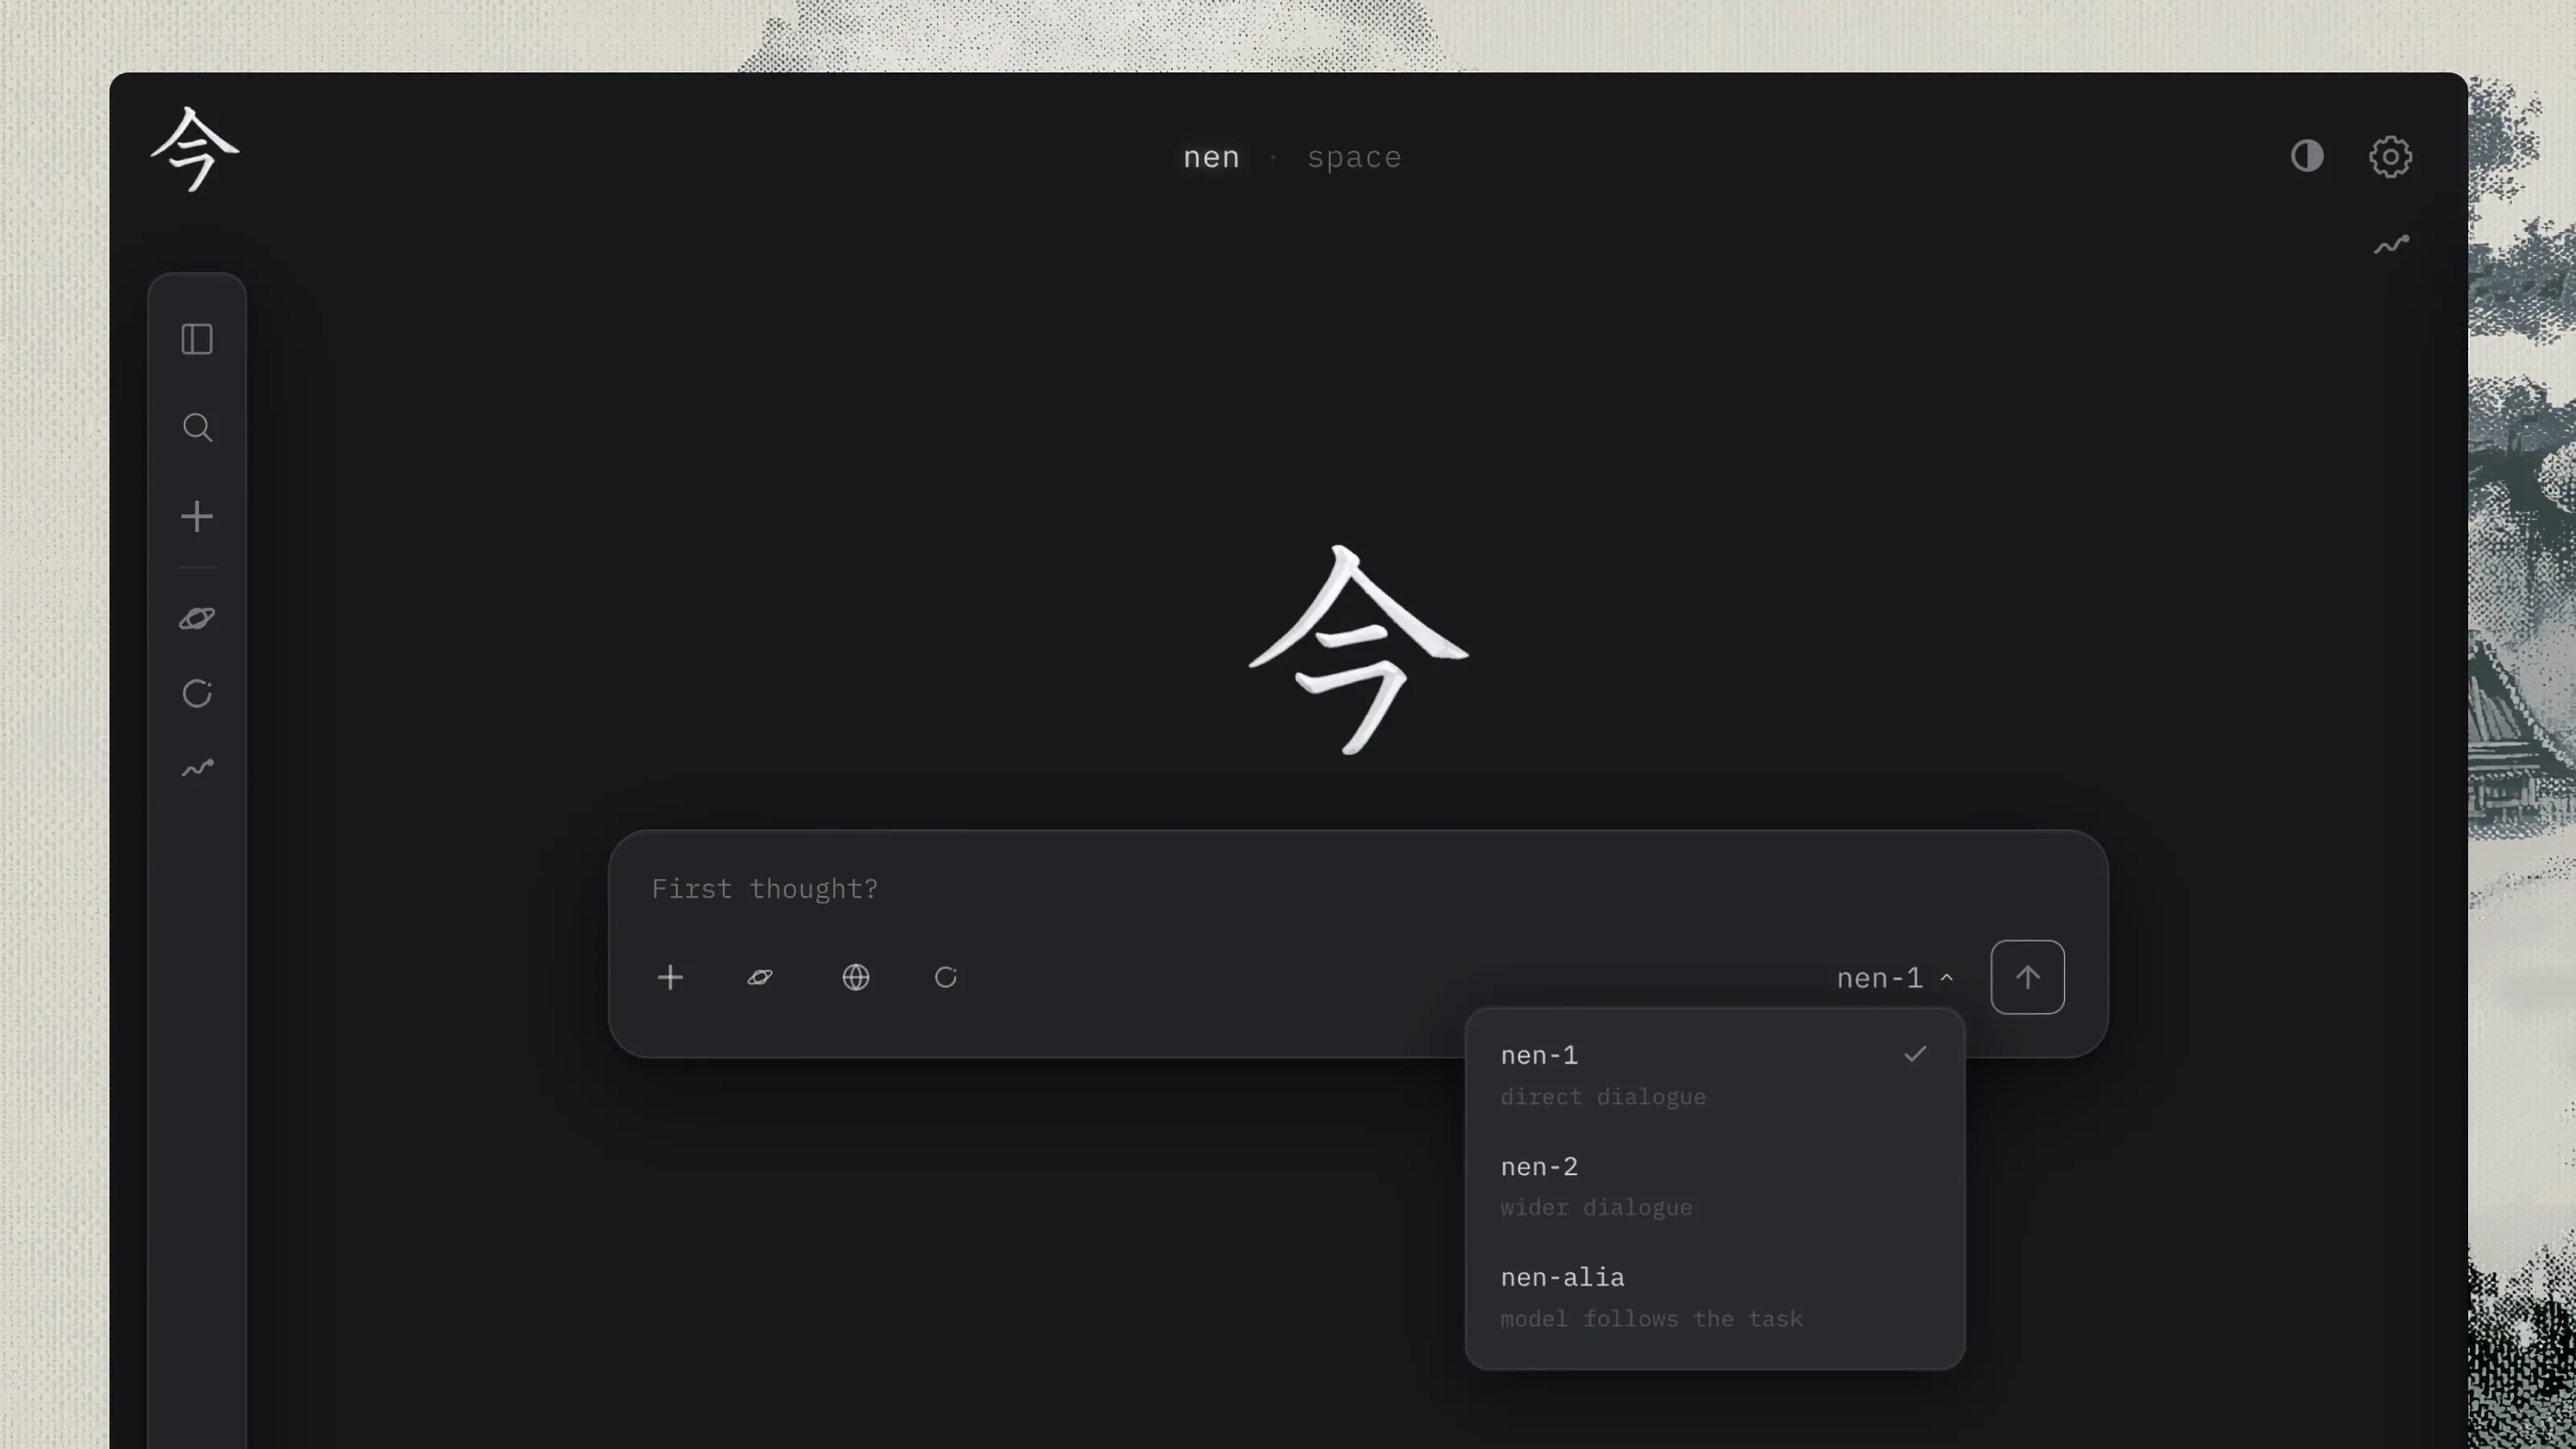
一句话介绍:nenspace是一款将AI模型与工作记忆、任务、笔记、习惯和日志整合于一体的“思维扩展”应用,专为那些希望在快节奏生活中随时捕捉想法、并在稍后整理归位的人群设计,解决“想法流逝”和“AI只会附和”的痛点。
Productivity
Artificial Intelligence
扩展思维
AI笔记
工作记忆
任务管理
习惯追踪
日志记录
反谄媚模型
思维整理
生产力工具
iOS应用
用户评论摘要:用户普遍认可其独特品牌定位和填补“高级AI与基础聊天应用”之间空白的价值。但有用户反馈登录验证码为8位而非6位,导致无法登录;另有用户关注模型交互体验,期待更多模型选择。
AI 锐评
nenspace的聪明之处在于它精准踩中了当前AI工具的两大软肋:一是“记忆碎片化”的窘境——多数“第二大脑”应用只负责存储,却把整理和决策的负担甩回给用户;二是“AI过度迎合”的普遍不适,RLHF训练出的谄媚模型让深度思考变得肤浅。其自研的nen-1模型主打“质疑和精简”,本质上是把AI从“答案机器”降格为“思辨陪练”,这一定位具有极强的差异化价值。
“工作记忆+暂存+稍后整理(sift)”的交互设计也很老练,它不强迫用户对每个念头立刻做结构化分类,而是模拟人脑的“缓冲区”,等闲下来再统一处理,这比市面上追求“万物皆文件夹”的工具更符合认知规律。加上模型能直接检索笔记和网页,确实做到了“AI融合但不喧宾夺主”。
但隐忧同样明显:128票在Product Hunt属于中量级热度,评论里提到登录体验(验证码位数错误)这种基础bug,说明产品成熟度还有待打磨。更关键的是,反谄媚模型是一把双刃剑——用户真的愿意在疲惫时面对一个“唱反调”的AI吗?工具型产品最终拼的是留存,一旦新鲜感过去,人们可能还是会逃回温和的ChatGPT或Notion的舒适区。nenspace的护城河不在于模型本身,而在于它能否通过“整理仪式感”和“记忆累积”培养出用户的情感依赖,否则,它只是一个设计更酷的Memo应用。
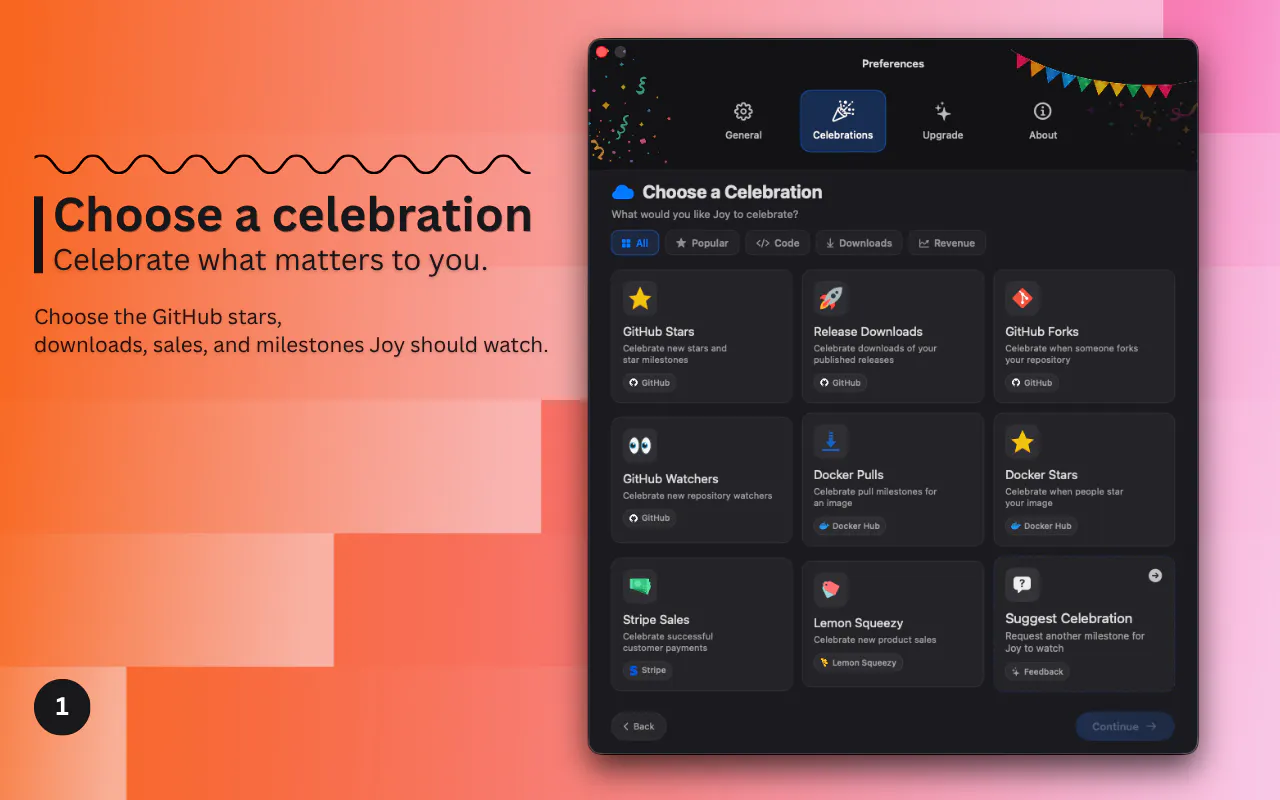
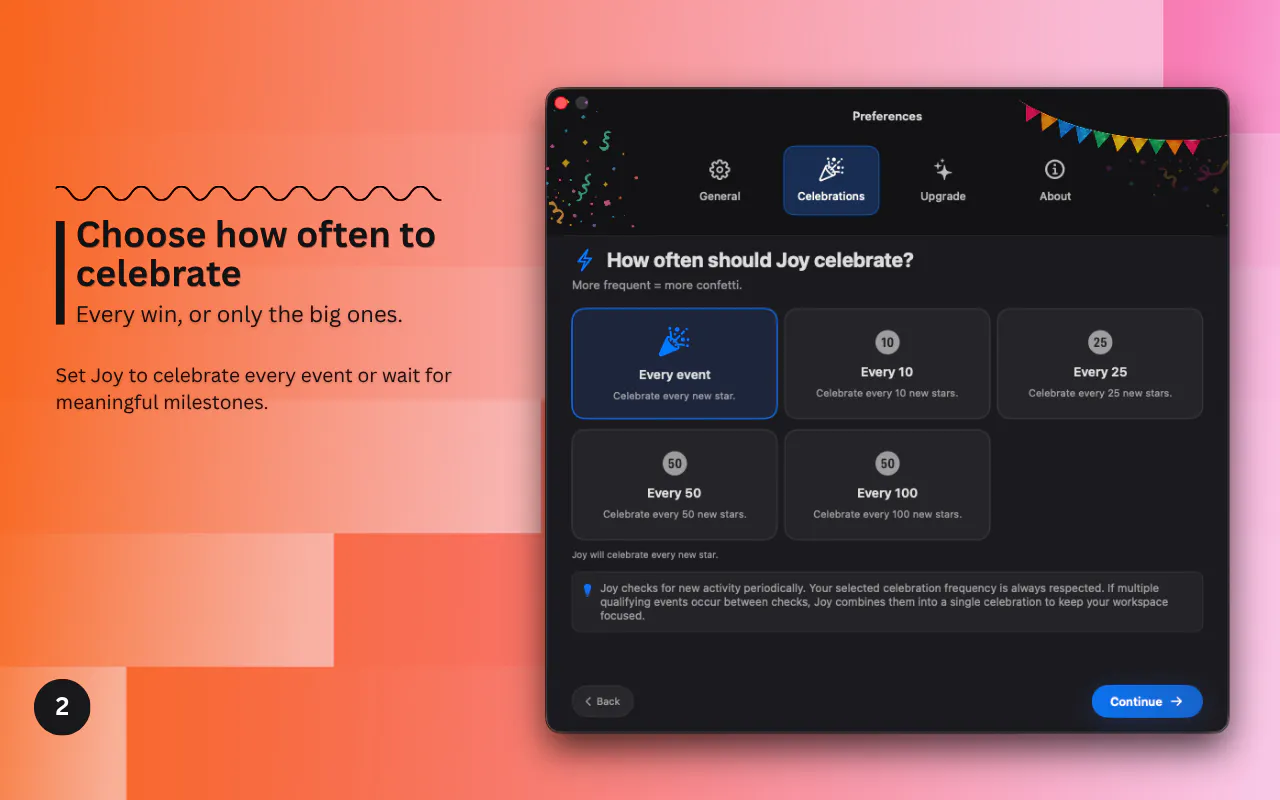
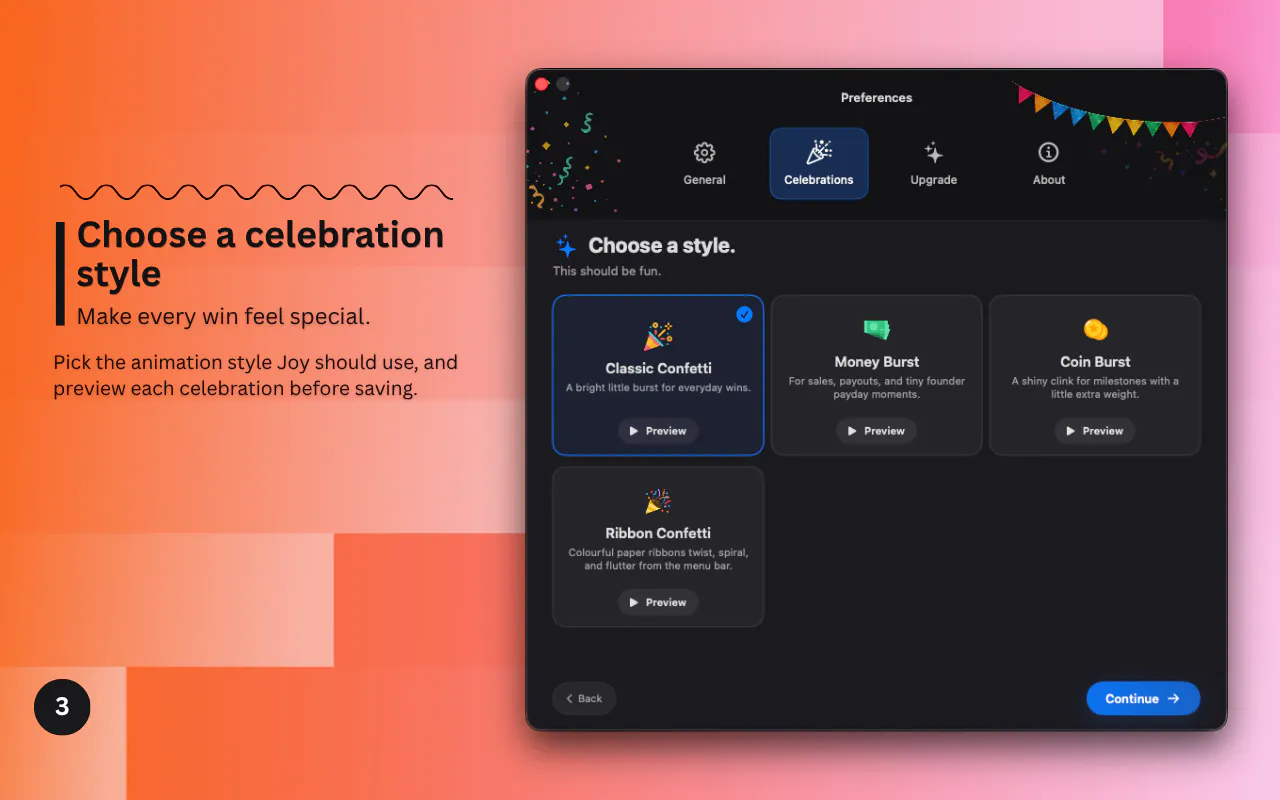
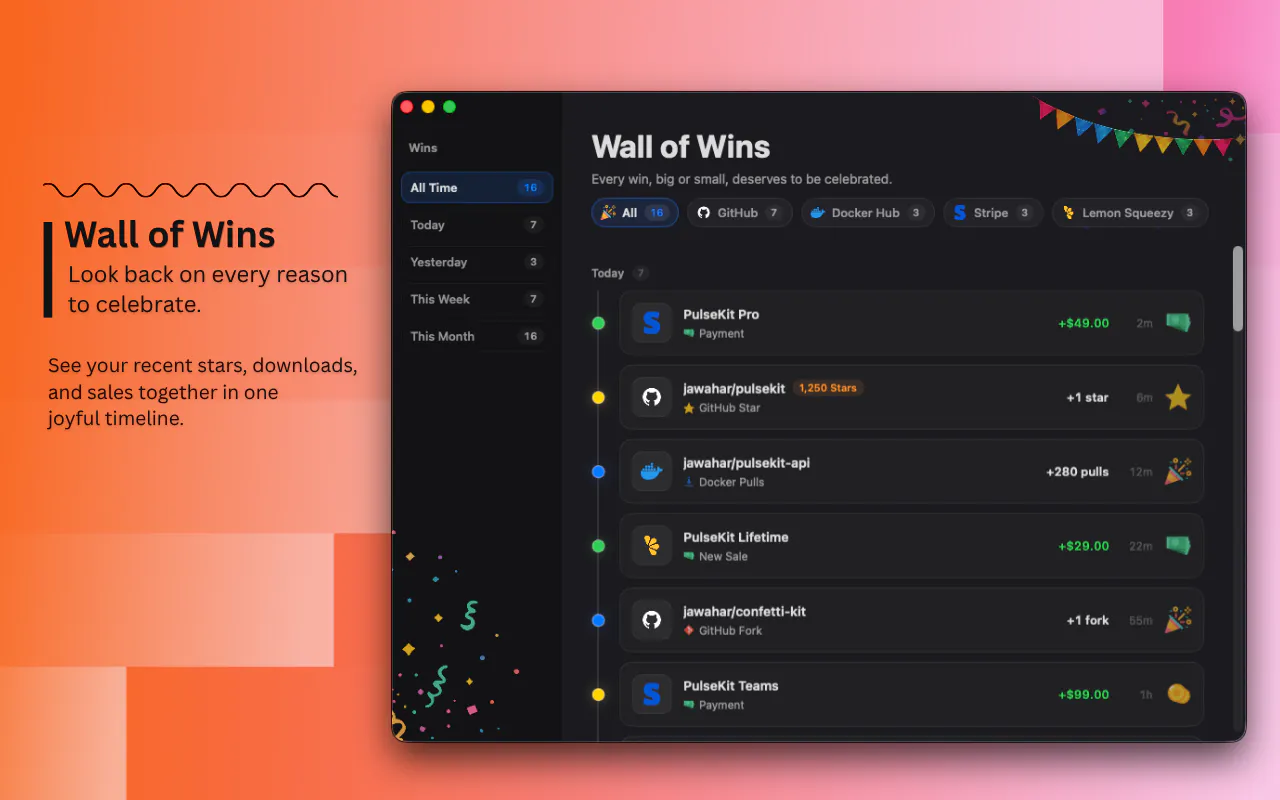
一句话介绍:Joy 是一款 macOS 菜单栏应用,在你达成 GitHub stars、Stripe 销售、Docker Hub 下载等里程碑时,自动在屏幕上撒彩屑庆祝,把枯燥的后台数据变成即时的成就感反馈。
Mac
Productivity
Menu Bar Apps
macOS 菜单栏工具
开发者激励
里程碑提醒
成就庆祝
彩屑动效
独立开发
数据通知
情绪价值
轻量应用
用户评论摘要:用户整体反馈积极,认为把 Stripe 销售额、Docker 拉取等隐形后端指标转化为彩屑庆祝,能缓解独立开发者孤独感。有用户询问是否计划推出 Windows 版本,暂无开发者明确回复。开发者本人回复中强调希望收集集成与庆祝风格方面的反馈。
AI 锐评
Joy 切中的是一个真实且微妙的情绪缺口:独立开发者表面上缺的是数据看板,实际上缺的是“被人看见”的感觉。当 GitHub 星标、Docker 拉取这类无生命体征的数字变成屏幕上的彩屑时,产品的本质不是效率工具,而是一件“情感外挂”——它把延迟满足的成就感压缩成即时多巴胺,对抗远程工作与单兵作战的心理磨损。
从产品逻辑看,这个切入点很聪明:不碰数据分析,不做复杂集成,只做“庆祝”这一件小事,边界清晰,MVP 克制。但价值天花板也显而易见——彩屑动效终会麻木,单一反馈形式撑不起长期留存。真正的护城河不是撒彩屑,而是如何帮用户建立“里程碑感知系统”:比如自动生成每周成就回顾、将多个指标组合成一个“大胜利”、甚至反向提醒“你已经很久没庆祝了”来引导工作节奏。
另外,macOS-only 是合理的第一站,但开发者工具链用户同样大量在 Windows 和 Linux 上,若只做 Mac,等于主动放弃一半潜在用户。建议后续考虑跨平台方案,同时引入“庆祝强度可调”“静默模式”等防打扰机制——毕竟,当彩屑变成噪音,它就成了新的看板。
Joy 现在是一颗糖,但要看创始人是否愿意把它做成一套“成就感操作系统”。方向对了,深度还不够。
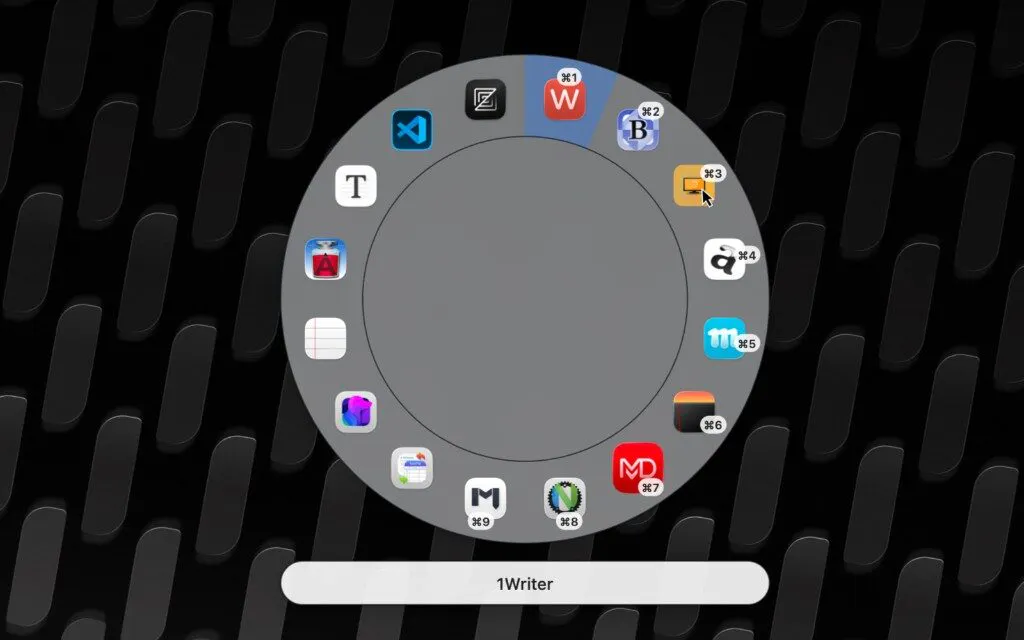
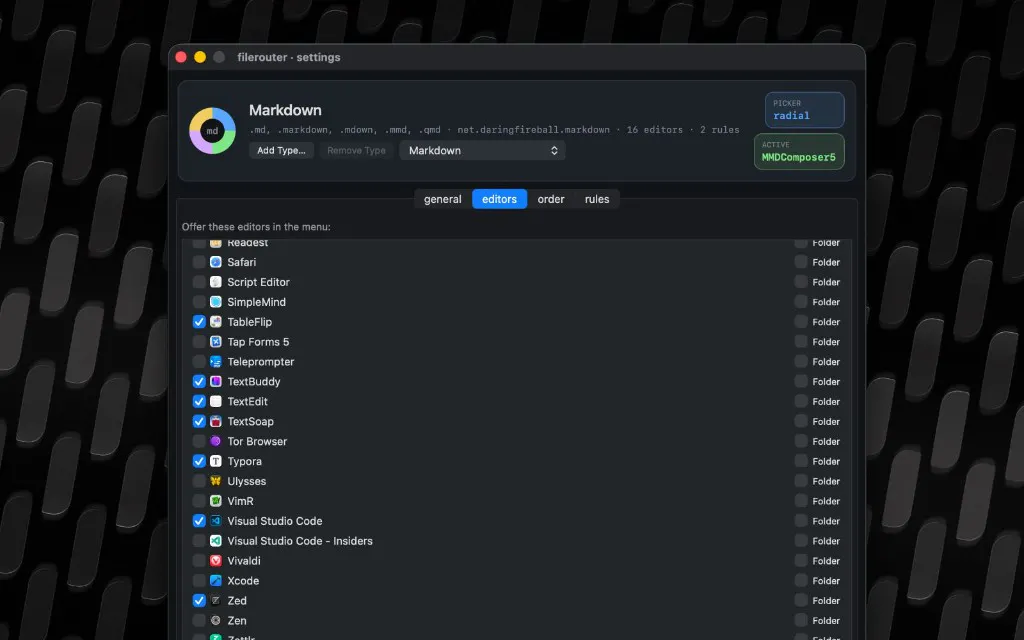
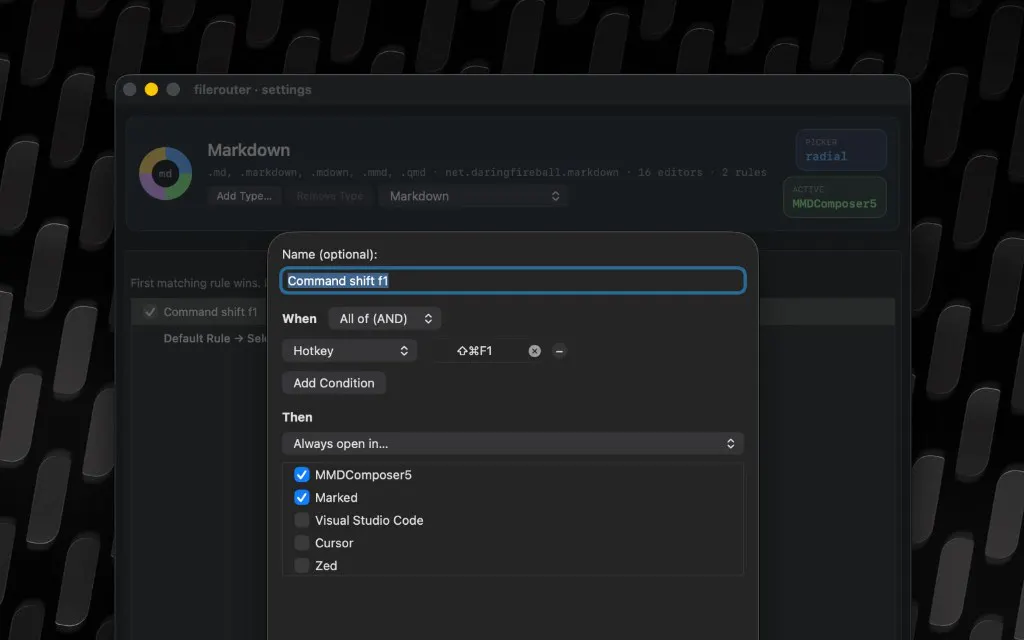
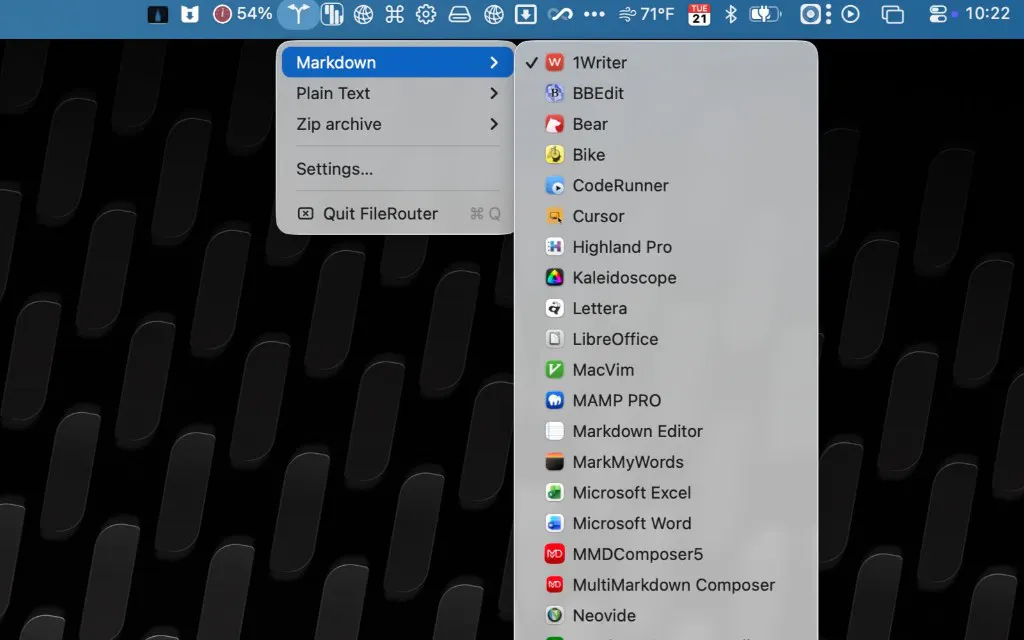
一句话介绍:FileRouter 是一款让用户自定义“文件类型→打开方式”的默认应用处理器,可按文件夹或规则为不同文档选择对应编辑器,解决文件总被系统固定应用打开、切换低效的痛点。
Mac
Productivity
Menu Bar Apps
文件管理
默认应用
编辑器
规则引擎
效率工具
macOS工具
文件类型路由
工作流优化
创作者工具
快捷选择器
用户评论摘要:用户认可其“按上下文路由文件”的理念(如草稿用 nvUltra、文档用 VS Code),称其为“工作流的游戏改变者”。有已购用户表示因开发者声誉好而购买,实际使用满意。暂无负面反馈或具体功能建议。
AI 锐评
FileRouter 精准切入了一个长期被忽视的缝隙:操作系统中“打开方式”的粗粒度控制。它本质上把“文件类型”从唯一定义升级为“文件路径/内容/上下文+类型”的复合判断,这比系统原生的“按扩展名固定应用”高一个维度。从产品形态看,它借鉴了 Velja/Choosy 在浏览器链接处理上的成熟交互——径向菜单与规则引擎,将其迁移至文件系统,逻辑自洽且用户教育成本低。
但必须冷静看待其天花板。首先,这是重度效率工具的典型赛道,受众狭窄,114 票的冷启动成绩也印证其小众属性。其次,核心痛点是否足够“痛”值得商榷:对大多数用户,双击文件打开固定应用是“习惯”而非“问题”;真正受益者仅限开发者、写作者等需在多个编辑器间切换的专业人群。最后,macOS 本身有 Automator、快捷指令及第三方工具(如 BetterTouchTool)可部分实现类似功能,FileRouter 的护城河在于“为文件类型路由量身定做”的打磨度,而非不可替代性。
真正的价值在于它验证了“文件即工作流入口”的设计哲学——当 AI 生成文件、多应用协作成为常态,按上下文路由文件的需求会持续增长。但现阶段它更像一款“正确但小众”的工具,能否破圈取决于两点:是否提供 iOS/Windows 版本,以及能否与 Raycast、Alfred 等启动器深度集成,否则容易沦为极客的玩具。开发者本身信誉良好,产品完成度高,但市场教育将是最大瓶颈。
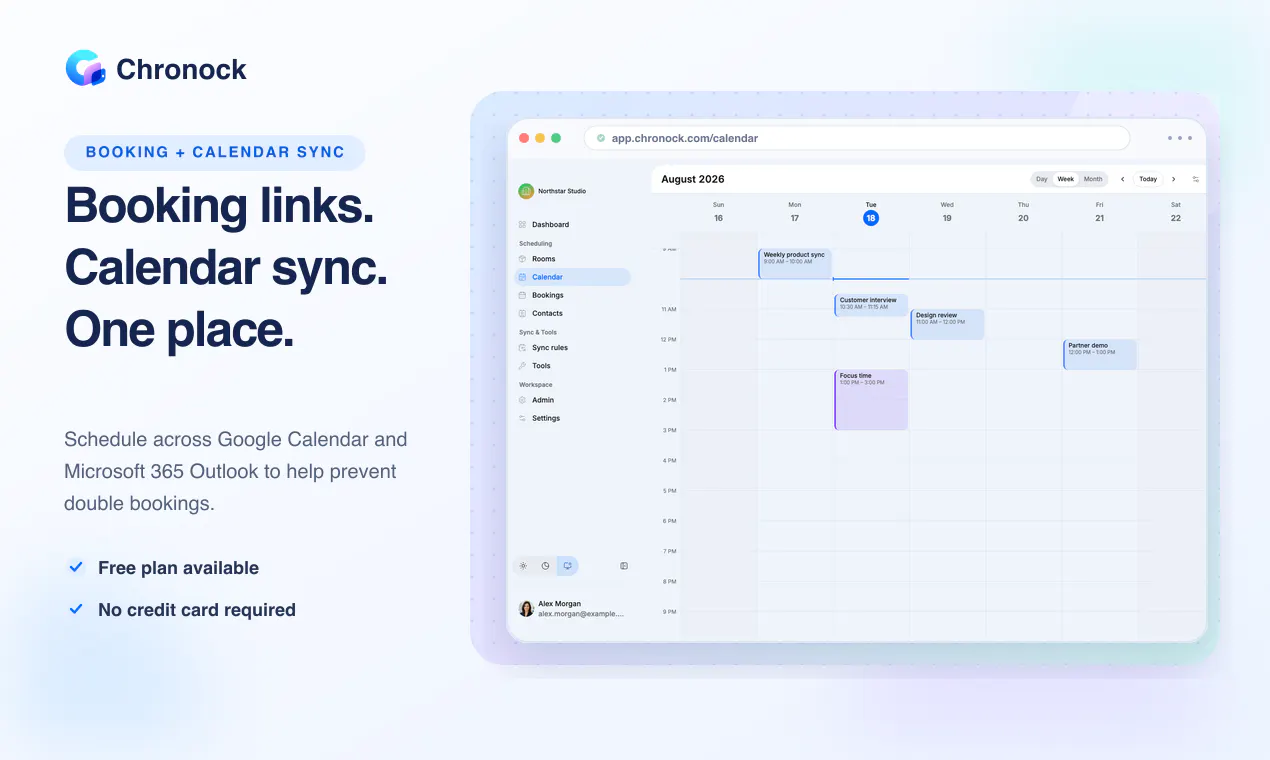
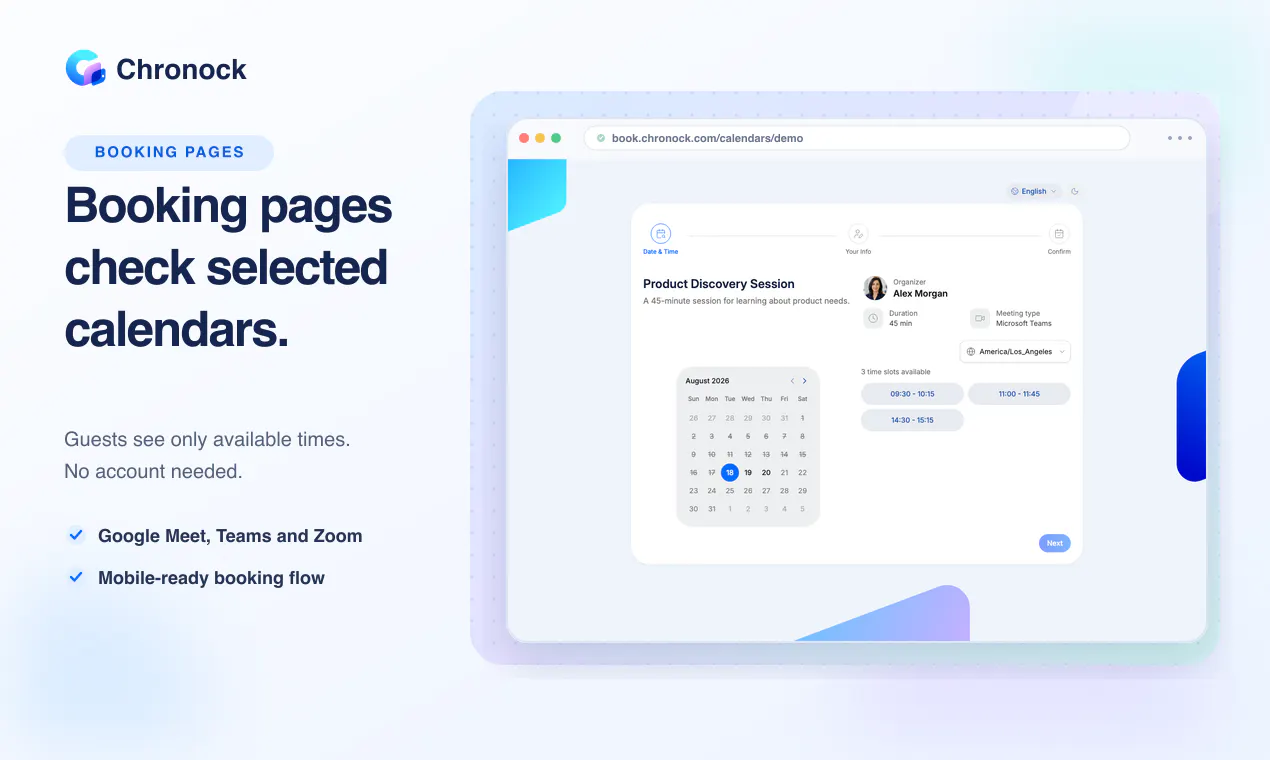
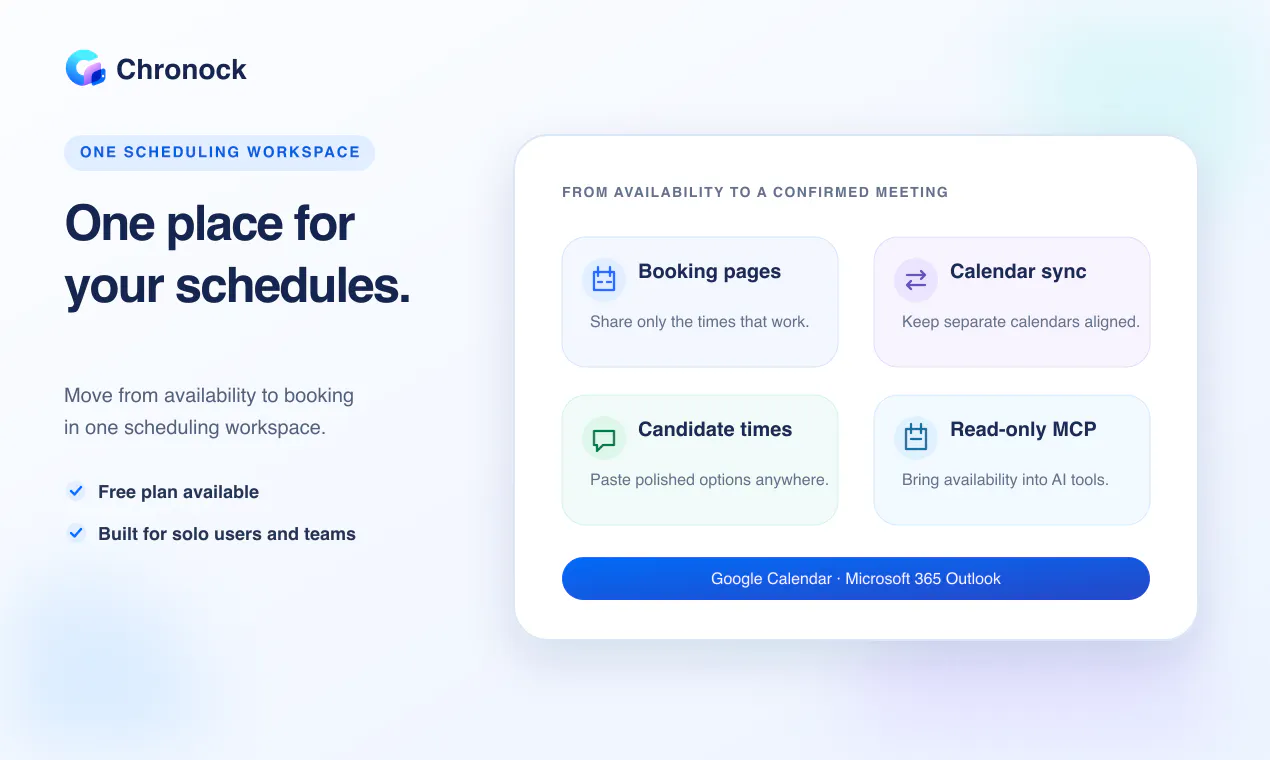
一句话介绍:Chronock将日程安排与跨日历同步集成于同一工作区,自动检测Google/Outlook日历忙闲状态,生成 booking 页面,并双向同步工作、个人及项目日历,以解决多日历管理中的重复预订与信息割裂痛点。
Productivity
Calendar
日历同步
日程安排
预订页面
Google日历
Outlook日历
跨平台集成
防冲突
多语言支持
AI原生开发
SaaS工具
用户评论摘要:用户认可统一同步与预订的价值,但指出同步事件丢失上下文(仅显示“Busy”)导致实用性不足;追问双向同步的防循环机制;有用户偏好为VIP客户提议具体时间而非预订链接;开发者回应了内容策略(Busy/标题/详情)及元数据防循环方案。
AI 锐评
Chronock 的切入点聪明——它把“调度”和“同步”合并为一个问题,即“可用性可信度”。这确实击中了多日历用户的深层痛点:不是缺少工具,而是工具之间互相制造新的不一致。其核心价值不在“功能多”,而在“信任的确定性”,这是 Calendly 等纯预订工具和 Fantastical 等纯日历客户端都未完全覆盖的缝隙。
但产品面临三重挑战:其一,用户评论中“发现性≠有用性”一针见血——跨日历同步如果只搬移忙/闲状态而丢失事件语义,那它只解决了“不冲突”而非“更高效”,这恰是用户粘性的致命伤。开发者提出的“Busy/标题/详情”三级策略是诚实但笨重的折中,真正的解法需要智能摘要或上下文感知的隐私规则,这又回到了AI能力上——而团队却刻意回避了AI在运行层的运用,这可能是战略误判。其二,双向往返同步的循环问题虽已用元数据标记解决,但“托管反射+差异同步”对用户心智负担仍然过重,普通用户不会理解“镜像规则”和“配对组”概念,可用性是最大门槛。其三,作为单人产品,用AI编码代理提高开发效率固然正确,但产品价值主张中强调“AI原生开发”对用户毫无意义——用户只关心结果。更值得注意的是,刻意不用AI做功能差异化,在2026年可能被视为保守,但其反其道而行的“确定性优先”定位,若能配合流畅的体验,反而能成为企业级用户的信任锚点。真正的考验在于:当前10余个同步规则的配置复杂度,能否在免费版中让用户5分钟内感受到“不再手动对时间表”的爽感。若做不到,这个工具将沦为又一款“听起来很对但用起来还得动脑”的效率摆设。
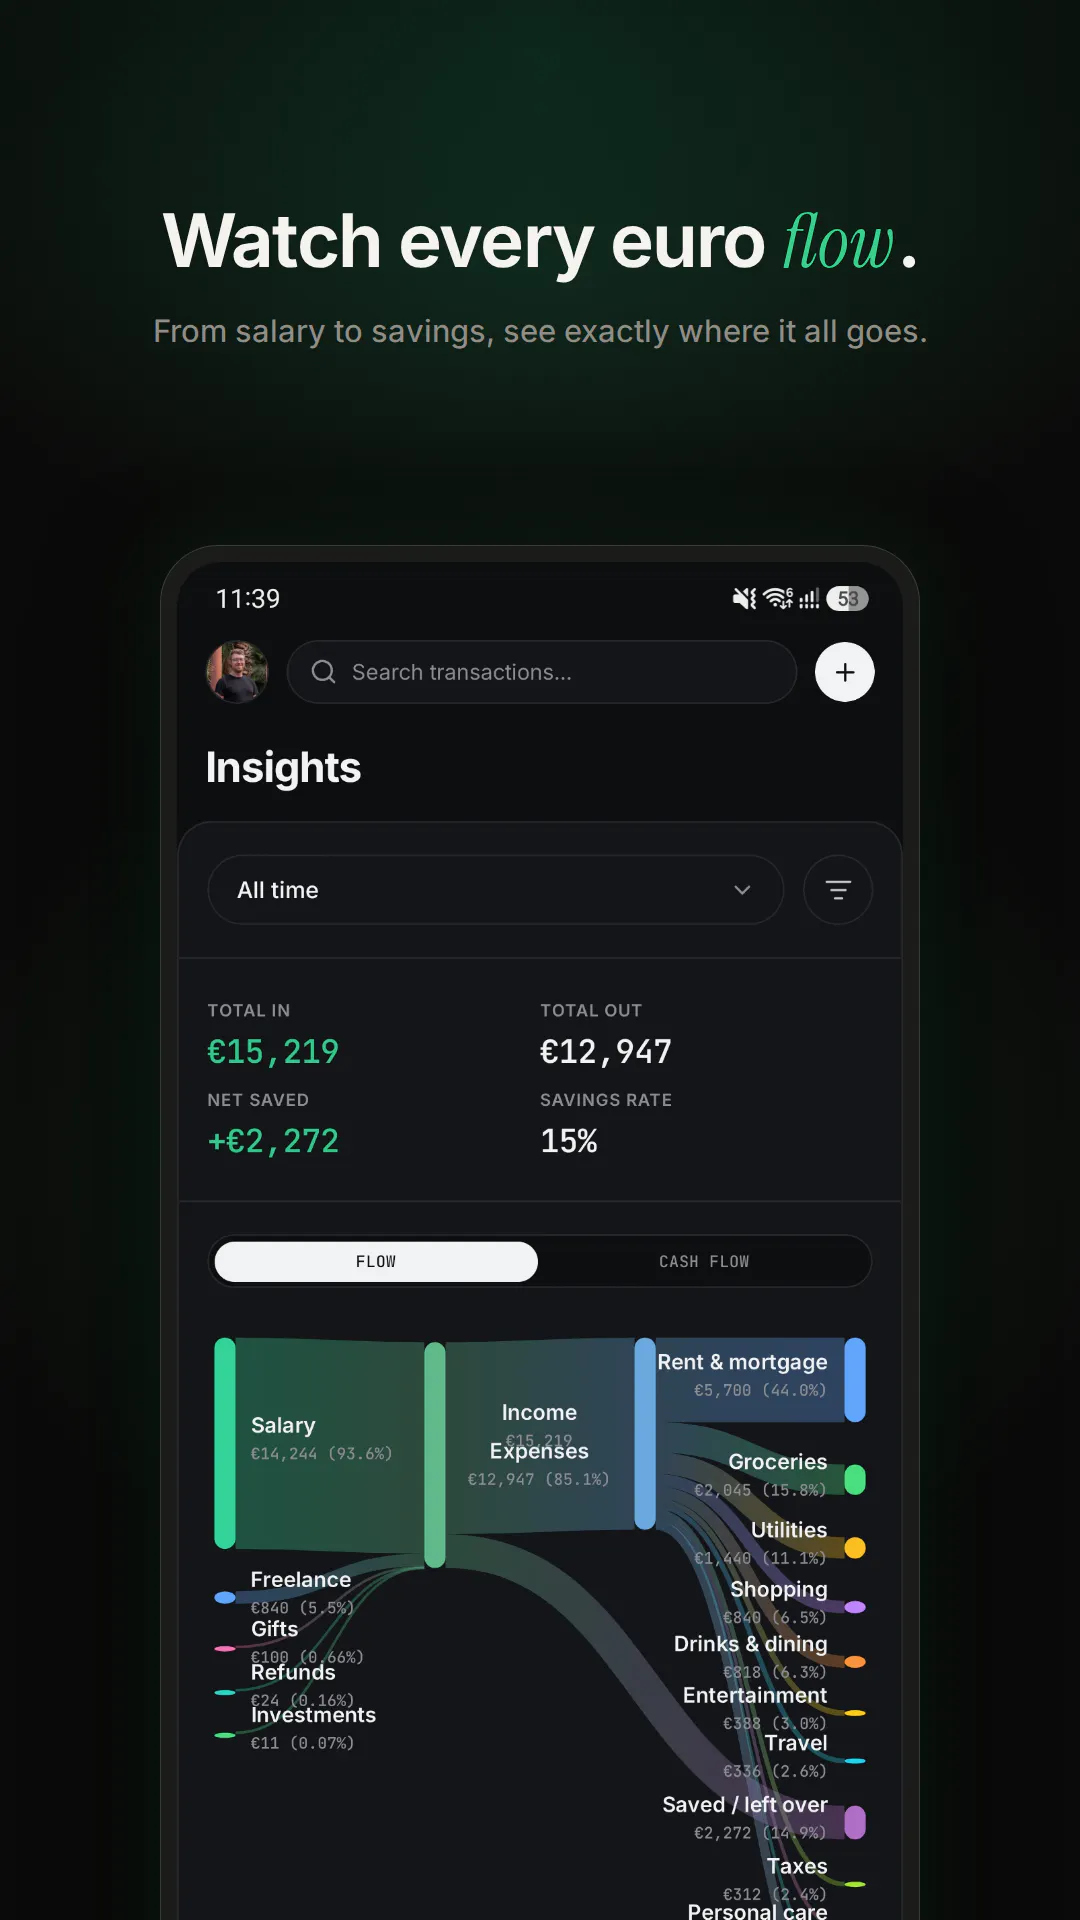
一句话介绍:Talvo是一款通过PSD2开放银行接口连接欧洲2500多家银行的个人理财与预算管理应用,旨在自动同步和分类交易,解决欧洲用户跨行财务追踪繁琐、数据分散的痛点。
Fintech
个人理财
预算管理
开放银行
PSD2
交易自动分类
净资产追踪
欧洲市场
隐私安全
GDPR合规
网页应用
用户评论摘要:用户主要关注三点:非PSD2账户(储蓄、投资)追踪困难,90天重新授权机制是否流畅,以及GDPR合规透明度存疑(法律文件中缺少公司信息)。创始人回应了手动账户与CSV导入方案,并承诺更新法律细节。
AI 锐评
Talvo切入了一个真实且精准的痛点:欧洲 fragmented 的银行体系与严格的PSD2监管,确实让通用型理财工具水土不服。其“欧洲原生、GDPR合规、PSD2直连”的定位,在合规成本与本地化体验上构成了对北美竞品(如Mint、Personal Capital)的天然壁垒,这是其核心价值所在。90票的冷启动数据也侧面印证了市场需求的真实性。
然而,产品的“零摩擦”叙事在监管现实面前显得脆弱。PSD2强制90天重新认证是结构性硬伤,Talvo的解决方案(提前7天弹窗提醒)本质上仍是“伪自动化”,用户粘性会在周期性打断中被侵蚀。更致命的是,其价值锚点“自动分类”恰恰是评论中被创始人自己承认的最弱环节——对于占据个人资产大头的投资账户(非PSD2范畴),目前仅有手工记账的“备份方案”,这暴露出其数据覆盖面远未达到“全能追踪”的营销暗示。合规透明度上的闪失(公司信息缺失)则反映出初创团队在法务严谨性上的短板,这对金融工具而言是致命的信任缺口。
Talvo的长期胜负手在于能否从“银行连接器”进化为“欧洲个人金融数据中枢”。若能借力即将落地的FIDA框架预埋投资账户连接能力,并将CSV导入升级为智能映射引擎,方能在本土巨头(如德国N26、法国Lydia)的生态挤压下找到缝隙。否则,它很可能沦为PSD2红利期里一款精致的过渡性工具,而非持久的理财入口。
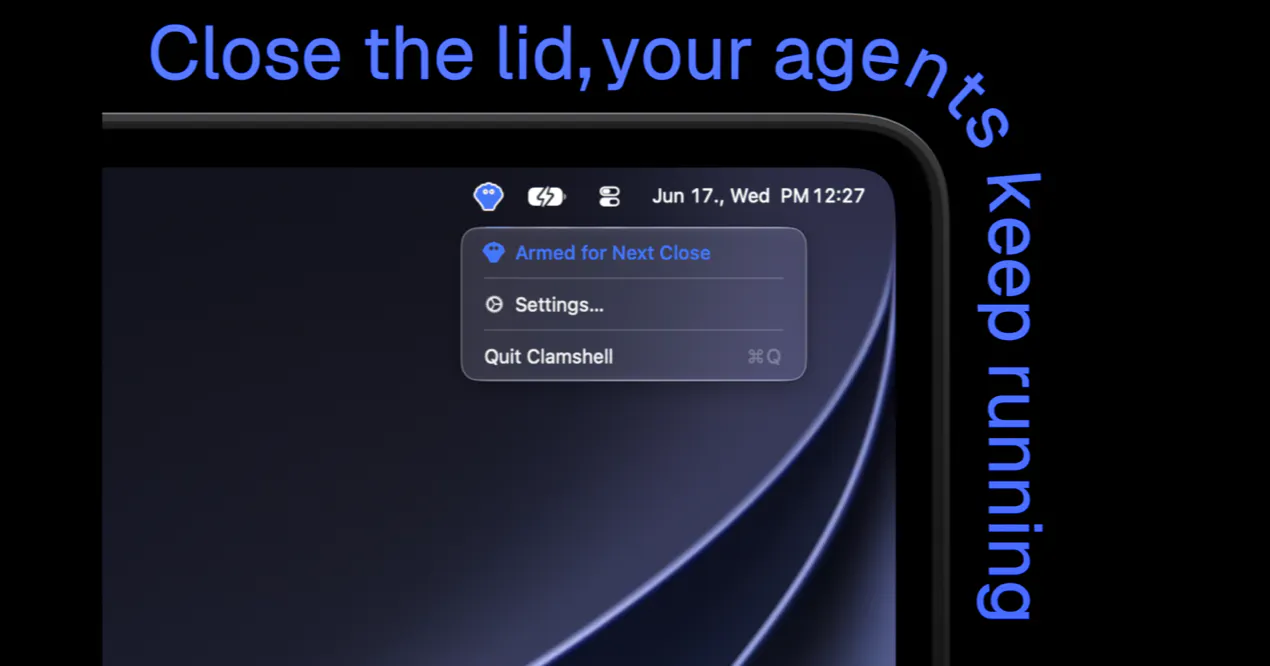
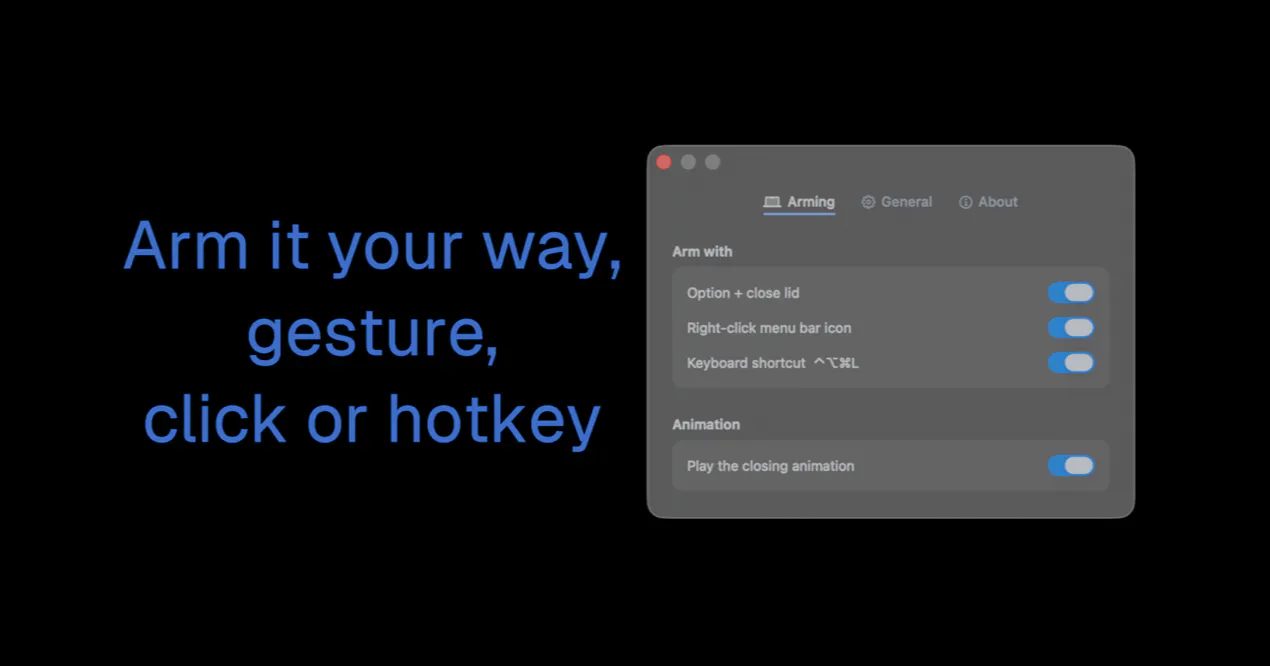
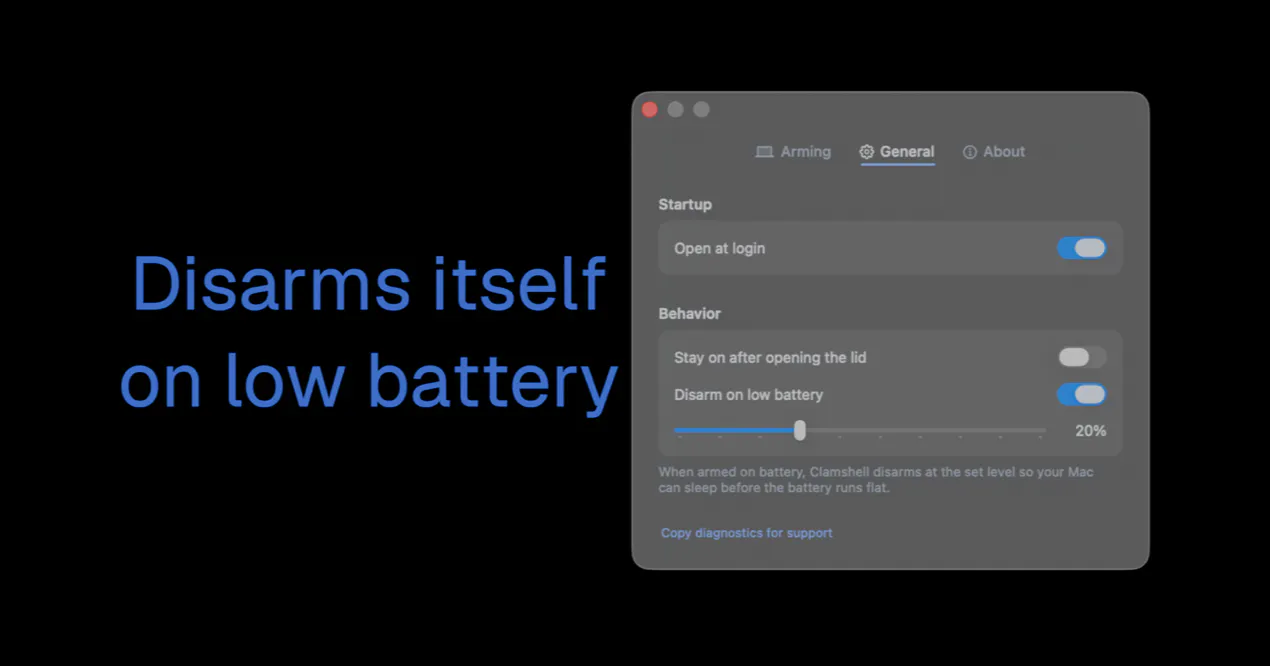
一句话介绍:Clamshell是一款让MacBook合盖后仍继续运行的菜单栏工具,专为解决合盖即中断构建、下载或编码代理等后台任务的痛点而设计。
Mac
Productivity
Developer Tools
MacBook
合盖运行
菜单栏工具
防休眠
后台任务
开发者工具
电池保护
临时开关
付费软件
生产力工具
用户评论摘要:用户核心诉求是“反向触发”——指定进程结束后再自动恢复正常睡眠,避免因忘记关闭而持续耗电至电池保护阈值。创始人回应称该功能是2.0探索方向,难点在于准确判断任务是否真正完成。另一用户吐槽其为付费版Capsomnia,创始人强调临时性与恢复安全的差异化。
AI 锐评
Clamshell切入的痛点是真实且高频的,尤其对于依赖本地构建、跑下载或挂Agent的开发者而言,“合盖即断”是物理级的生产力中断。其核心价值不在于技术壁垒——本质上就是利用caffeinate或类似机制阻止空闲休眠,而在于产品化包装:将系统级风险操作降维成“开关+快捷键+合盖触发”的零思考动作,并内置低电量保护与恢复逻辑,这比裸用终端命令安全得多。84票的冷启动成绩中,Setapp已有500+用户且仅1个bug是比投票更有分量的质量背书。但必须清醒:这大概率是“小而美”的短命刚需,而非高天花板生意。竞品(如Amphetamine、Capsomnia)已存在,且macOS原生对电源管理的控制日益精细,Apple未来若在系统层加入“合盖后保持工作”的智能选项,Clamshell将被直接降维打击。其更深层的机会在评论里:从“手动臂开关”进化到“任务感知”——当用户指定进程退出后自动恢复睡眠,这才是从工具到智能助手的跃迁。创始人已意识到这一方向,但“如何确认任务真完成”的技术实现和流程匹配复杂度,将决定它是停留在卖一次性的10美元,还是成为开发者工作流中不可替代的原子组件。短期看,作为实用工具值得推荐;长期看,只有转向工作流自动化平台(如与构建系统、任务队列集成)才有生存空间,否则极易被复制和遗忘。
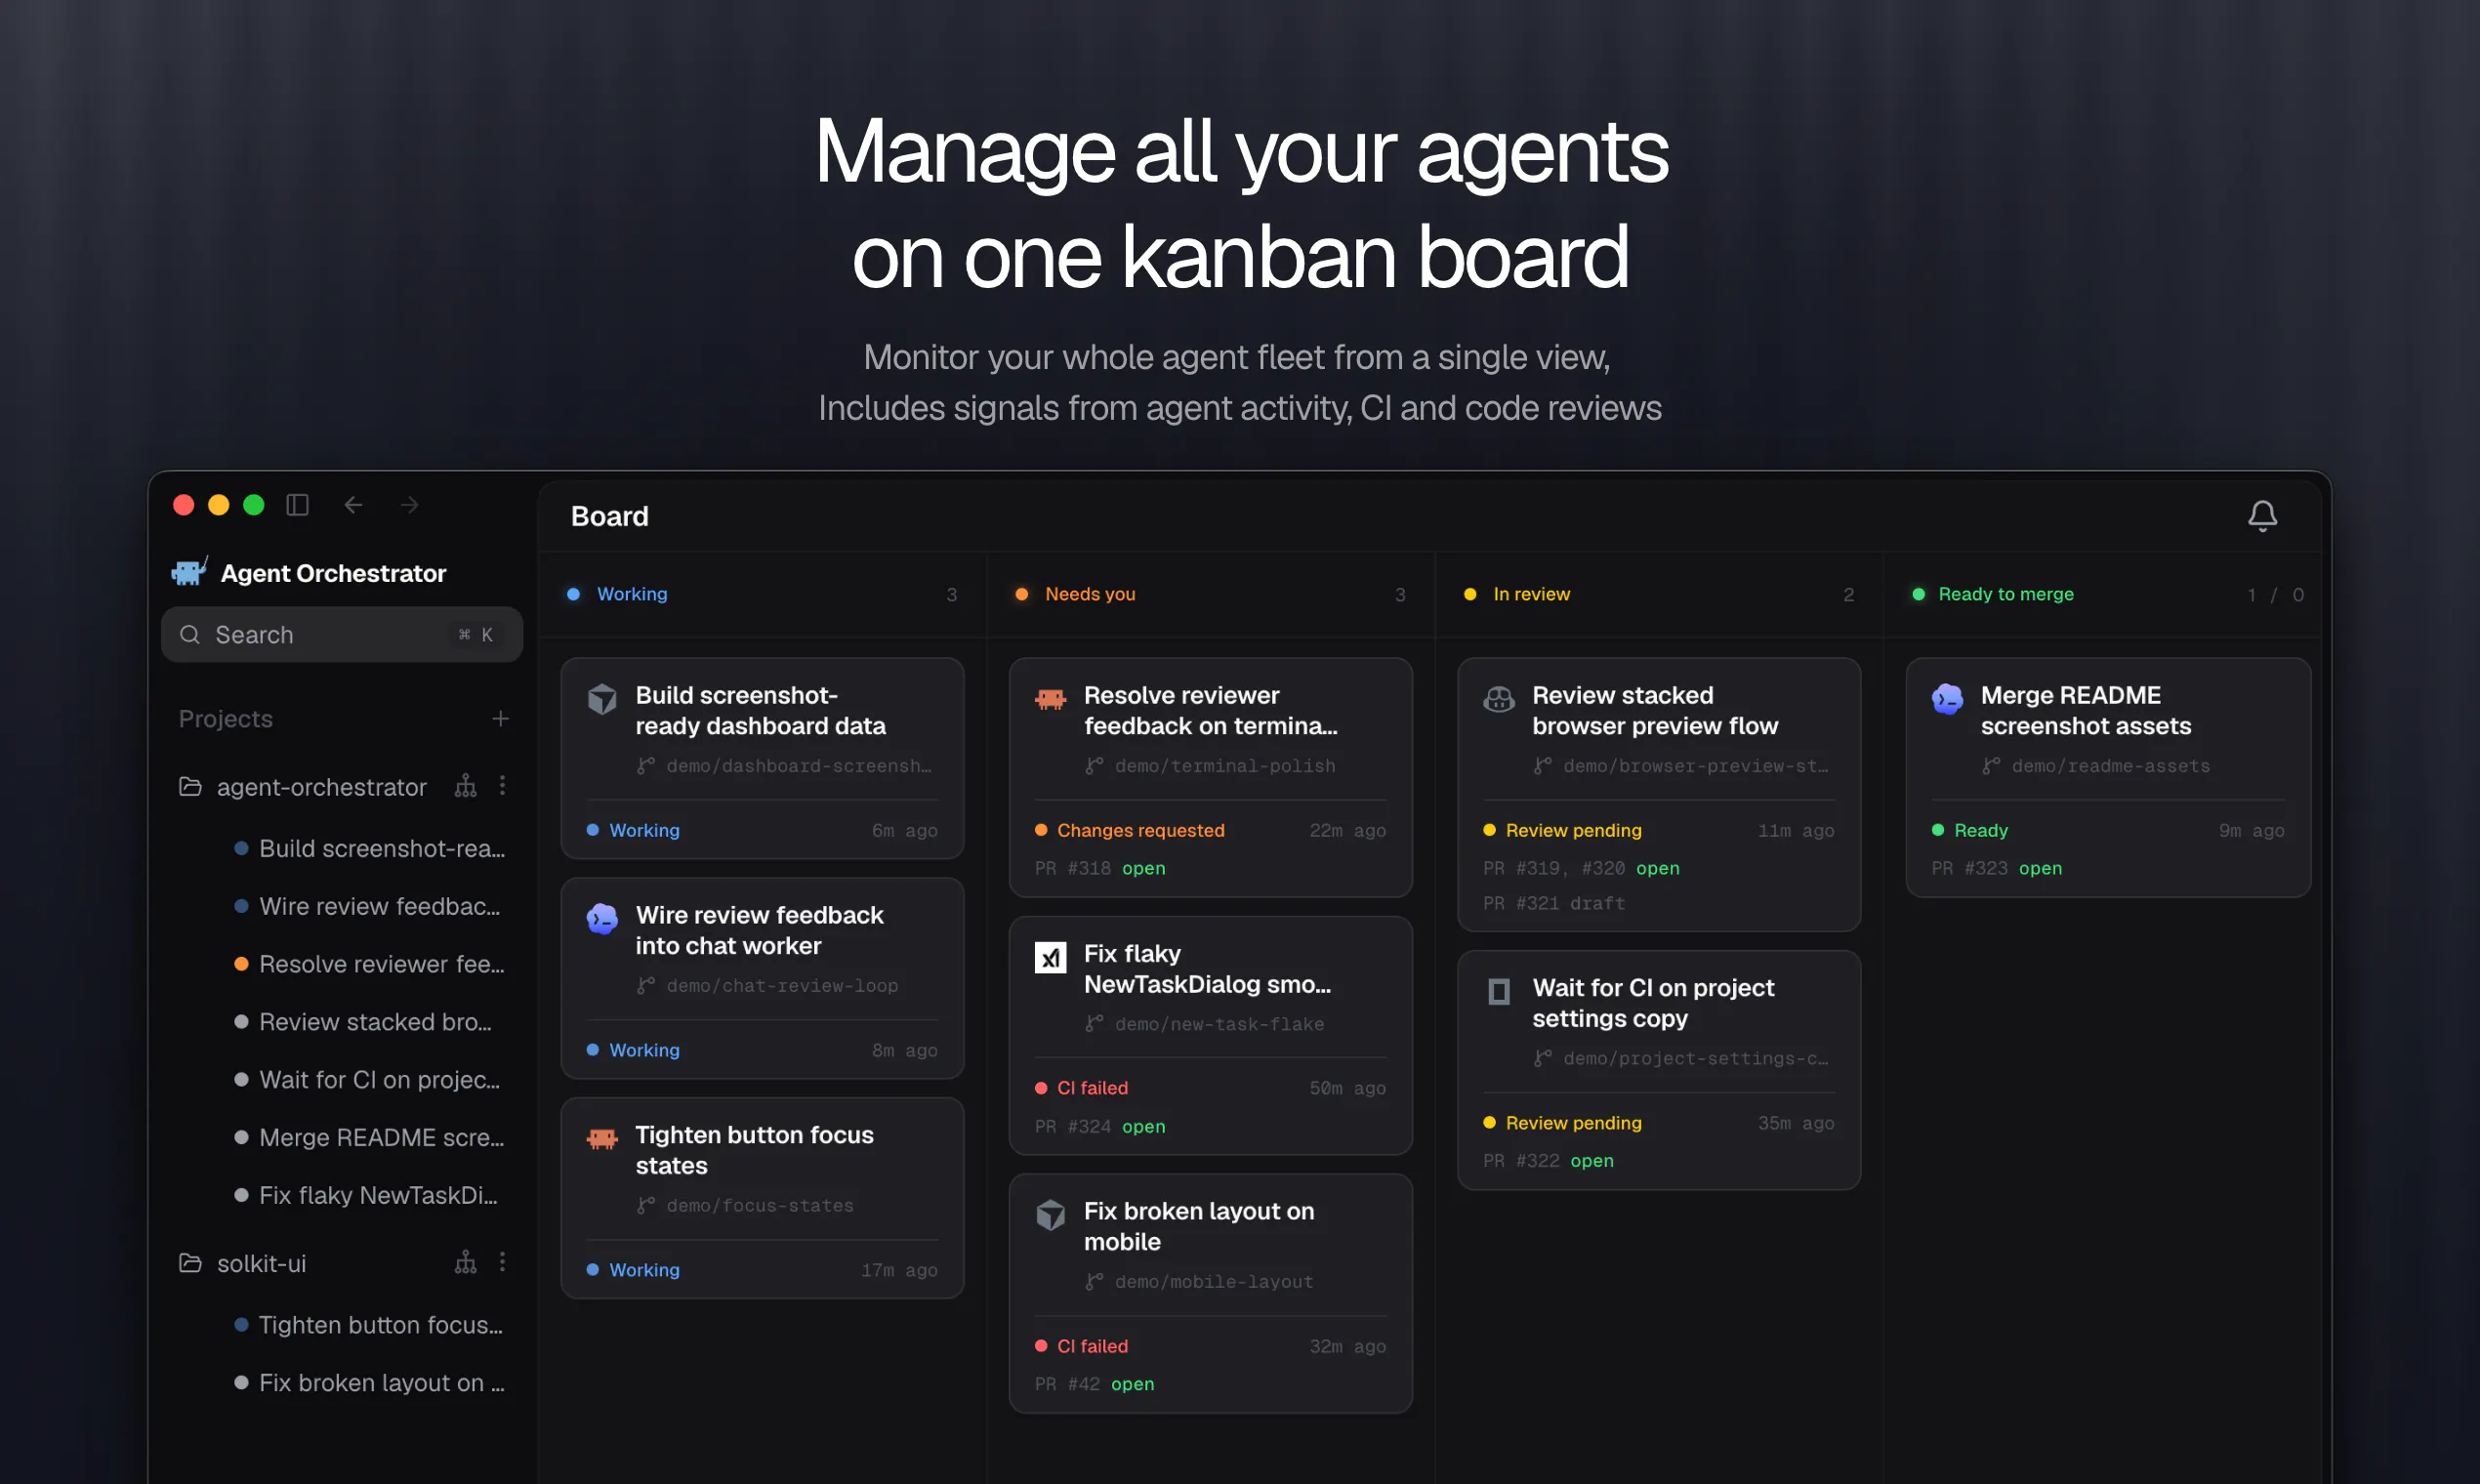
一句话介绍:Agent Orchestrator 是一款免费开源的“编码代理舰队管理器”,通过看板视图统一监控和调度多个 AI 编码助手(如 Claude Code、Codex、Cursor),将任务拆解、指派、跟踪直至合并,解决多代理并行工作时的协调混乱问题。
Productivity
Open Source
Developer Tools
GitHub
AI代理编排
编码助手管理
多代理协调
开发者工具
看板管理
开源软件
工作流自动化
任务委派
软件开发效率
用户评论摘要:用户普遍认可其看板管理和多代理协调价值,但反馈集中在:Linux 安装体验差(需手动运行)、Linux 界面粗糙破损;希望增加沙箱/远程代理支持;期待云协作与移动端体验完善。
AI 锐评
Agent Orchestrator 踩中了 AI 编程工具从“单兵作战”向“多智能体协同”演进的节点。当 Claude Code、Codex 等工具泛滥,管理 10+ 终端的上下文切换成本陡增,AO 用看板将“不可见的代理工作流”变成“可视化的流水线”,这是对开发者心智模型的正确映射——从写代码到管代码,本质是生产力工具的范式升级。
但必须泼冷水:其一,52 票的冷启动数据与其 9.5K GitHub Stars 严重背离,说明 Product Hunt 受众与真实开发者社区存在断层,或市场教育尚未破圈。其二,核心依赖 tmux 的终端复用方案虽轻量,但“跑在本地”是致命短板——评论中反复出现的“沙箱/远程代理”诉求直指其天花板:若代理必须依赖本地机器,就无法实现真正的 7x24 小时无人值守,这限制了其从“效率工具”向“平台”跃迁的可能。其三,Linux 体验粗糙暴露了团队资源向 Mac 倾斜的现状,这会流失硬核开发者群体——而这群人恰是 AI 代理的重度用户。
真正值得关注的是其云服务预告。若 AO Cloud 能实现“本地编排+云端执行+团队协作”,则有机会从“管理器”变身为“代理操作系统”。但在此之前,它只是一个漂亮的过渡性产品。开源是优势,Apache 2.0 能吸引贡献者,但如何将 Star 转化为商业闭环(如云服务收入),是团队需要回答的问题。建议团队优先补齐沙箱执行和 Linux 体验,否则很容易被 Cursor 或 GitHub Copilot Workspace 等原生集成功能的巨头碾过。方向正确,但窗口期不会太长。
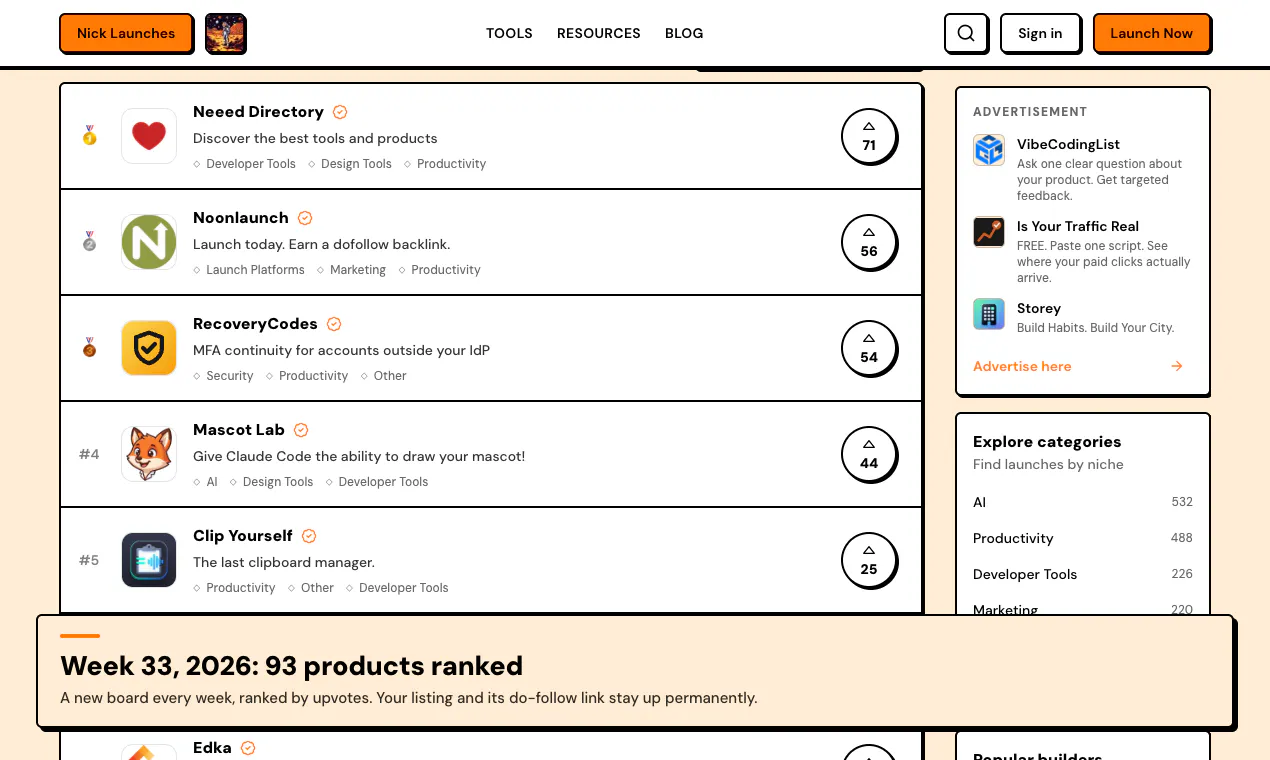
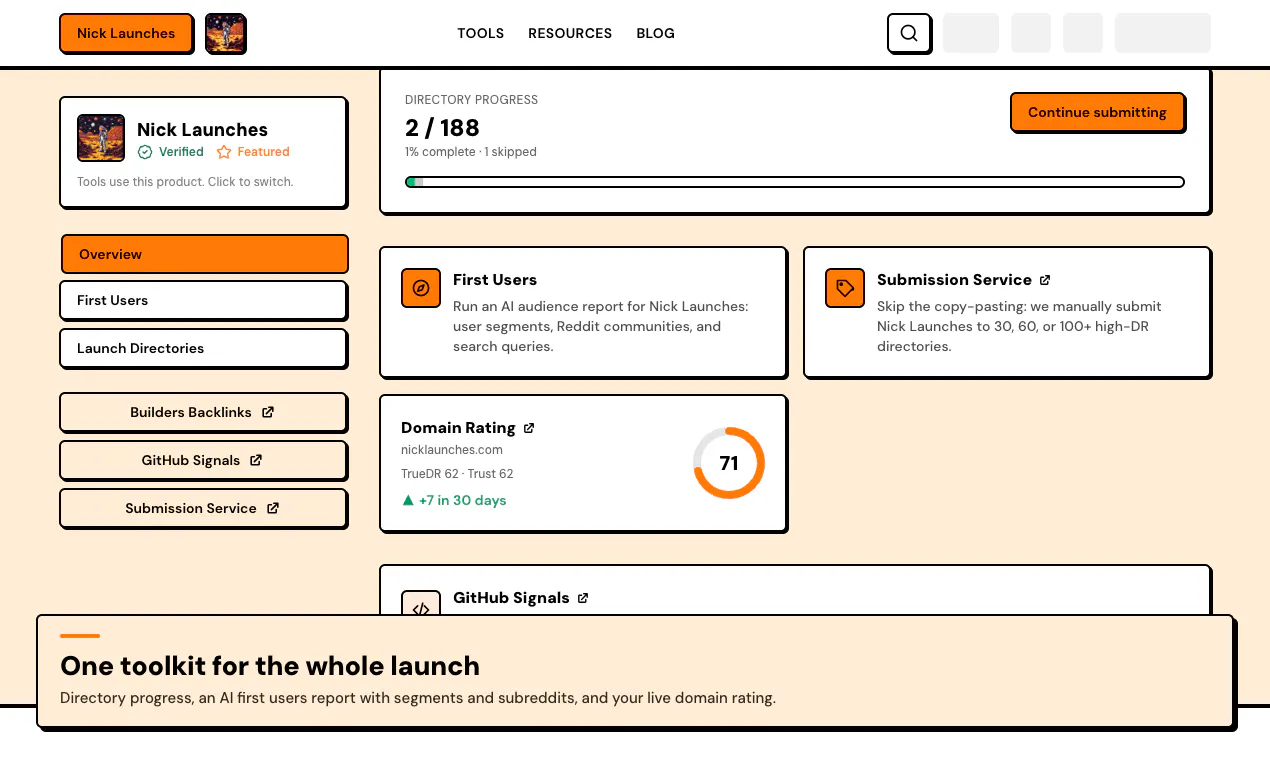
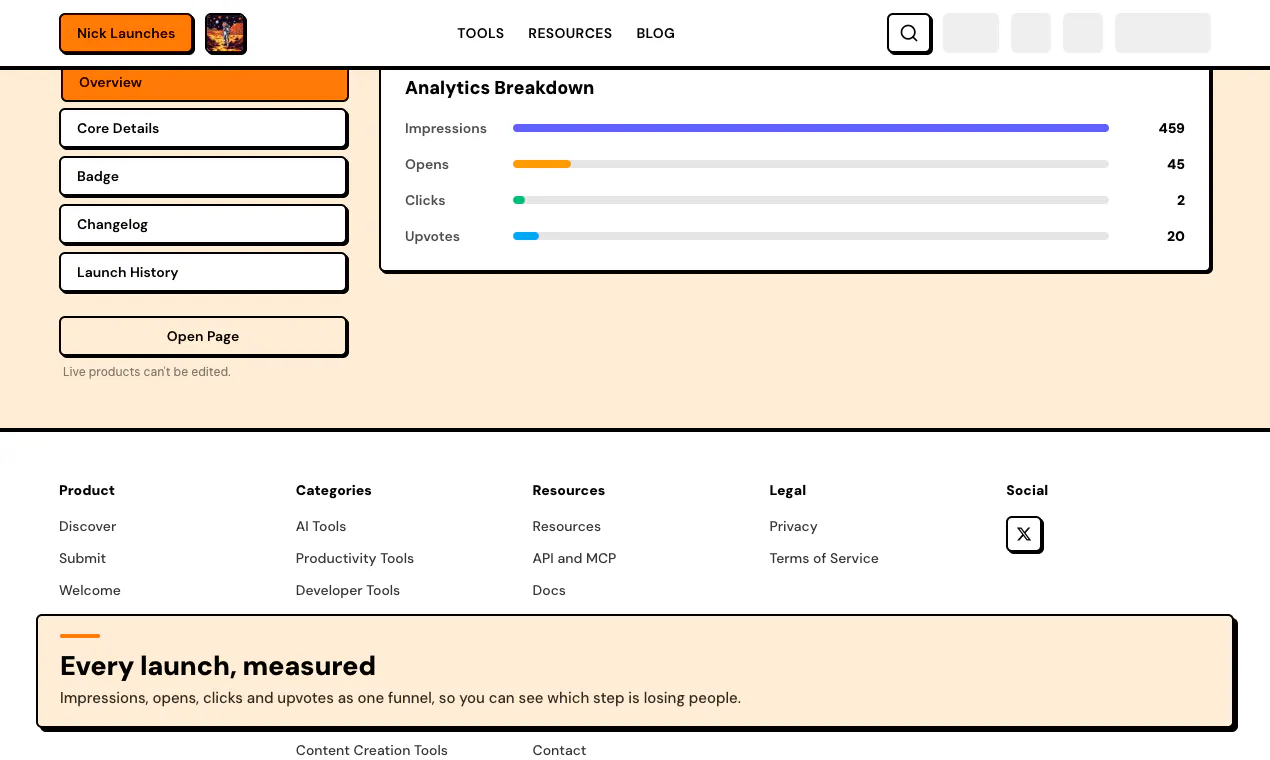
一句话介绍:Nick Launches 是一个产品发布推广平台,旨在解决新品上线后曝光期过短、迅速石沉大海的痛点,通过提供永久外链和长效展示,帮助开发者将产品持续触达数千名早期用户和创作者。
Marketing
SEO
Developer Tools
产品发布平台
开发者工具
AI产品
启动工具包
提交列表
外链建设
产品营销
独立开发者
增长黑客
社区推广
用户评论摘要:用户普遍认可其长效曝光和实用指南,称“远超同类小列表”。创始人积极互动,回应感谢。有效反馈集中于一个提问:“如何审核和管理列表内容?”(Moderation机制),未见其他负面建议。
AI 锐评
Nick Launches 本质上是一个“反Product Hunt”式的小众分发渠道,它精准切中了独立开发者的深层焦虑——24小时流量狂欢后的虚无。其核心卖点并非教程或AI评测,而是“永久dofollow外链”和“数周而非数小时的曝光”,这实际是在卖SEO价值和心理安慰。从数据看,37票、4赞评论,规模极小,但产品定位清晰:不做大众平台,只做垂直、高转化率的“慢流量”入口。其创始人亲自下场回答,并支持MCP,说明技术嗅觉不错,但真正的护城河不在于工具,而在于“ curated”(精选)的信任度——这恰恰也是用户唯一提出的疑问:你如何保证列表质量?若审核松,则沦为垃圾场;若审核严,则增长缓慢。目前它更像一个创始人IP的延伸,而非独立产品。短期看,对“被遗忘的发布者”有价值;长期看,若不能突破流量冷启动、建立稳定的发布者网络,很容易被大平台的算法更新或新型分发方式(如AI搜索、RSS复兴)降维打击。一句话:有价值,但天花板明显,暂不具备颠覆性。
一句话介绍:
Email
Artificial Intelligence
Web3
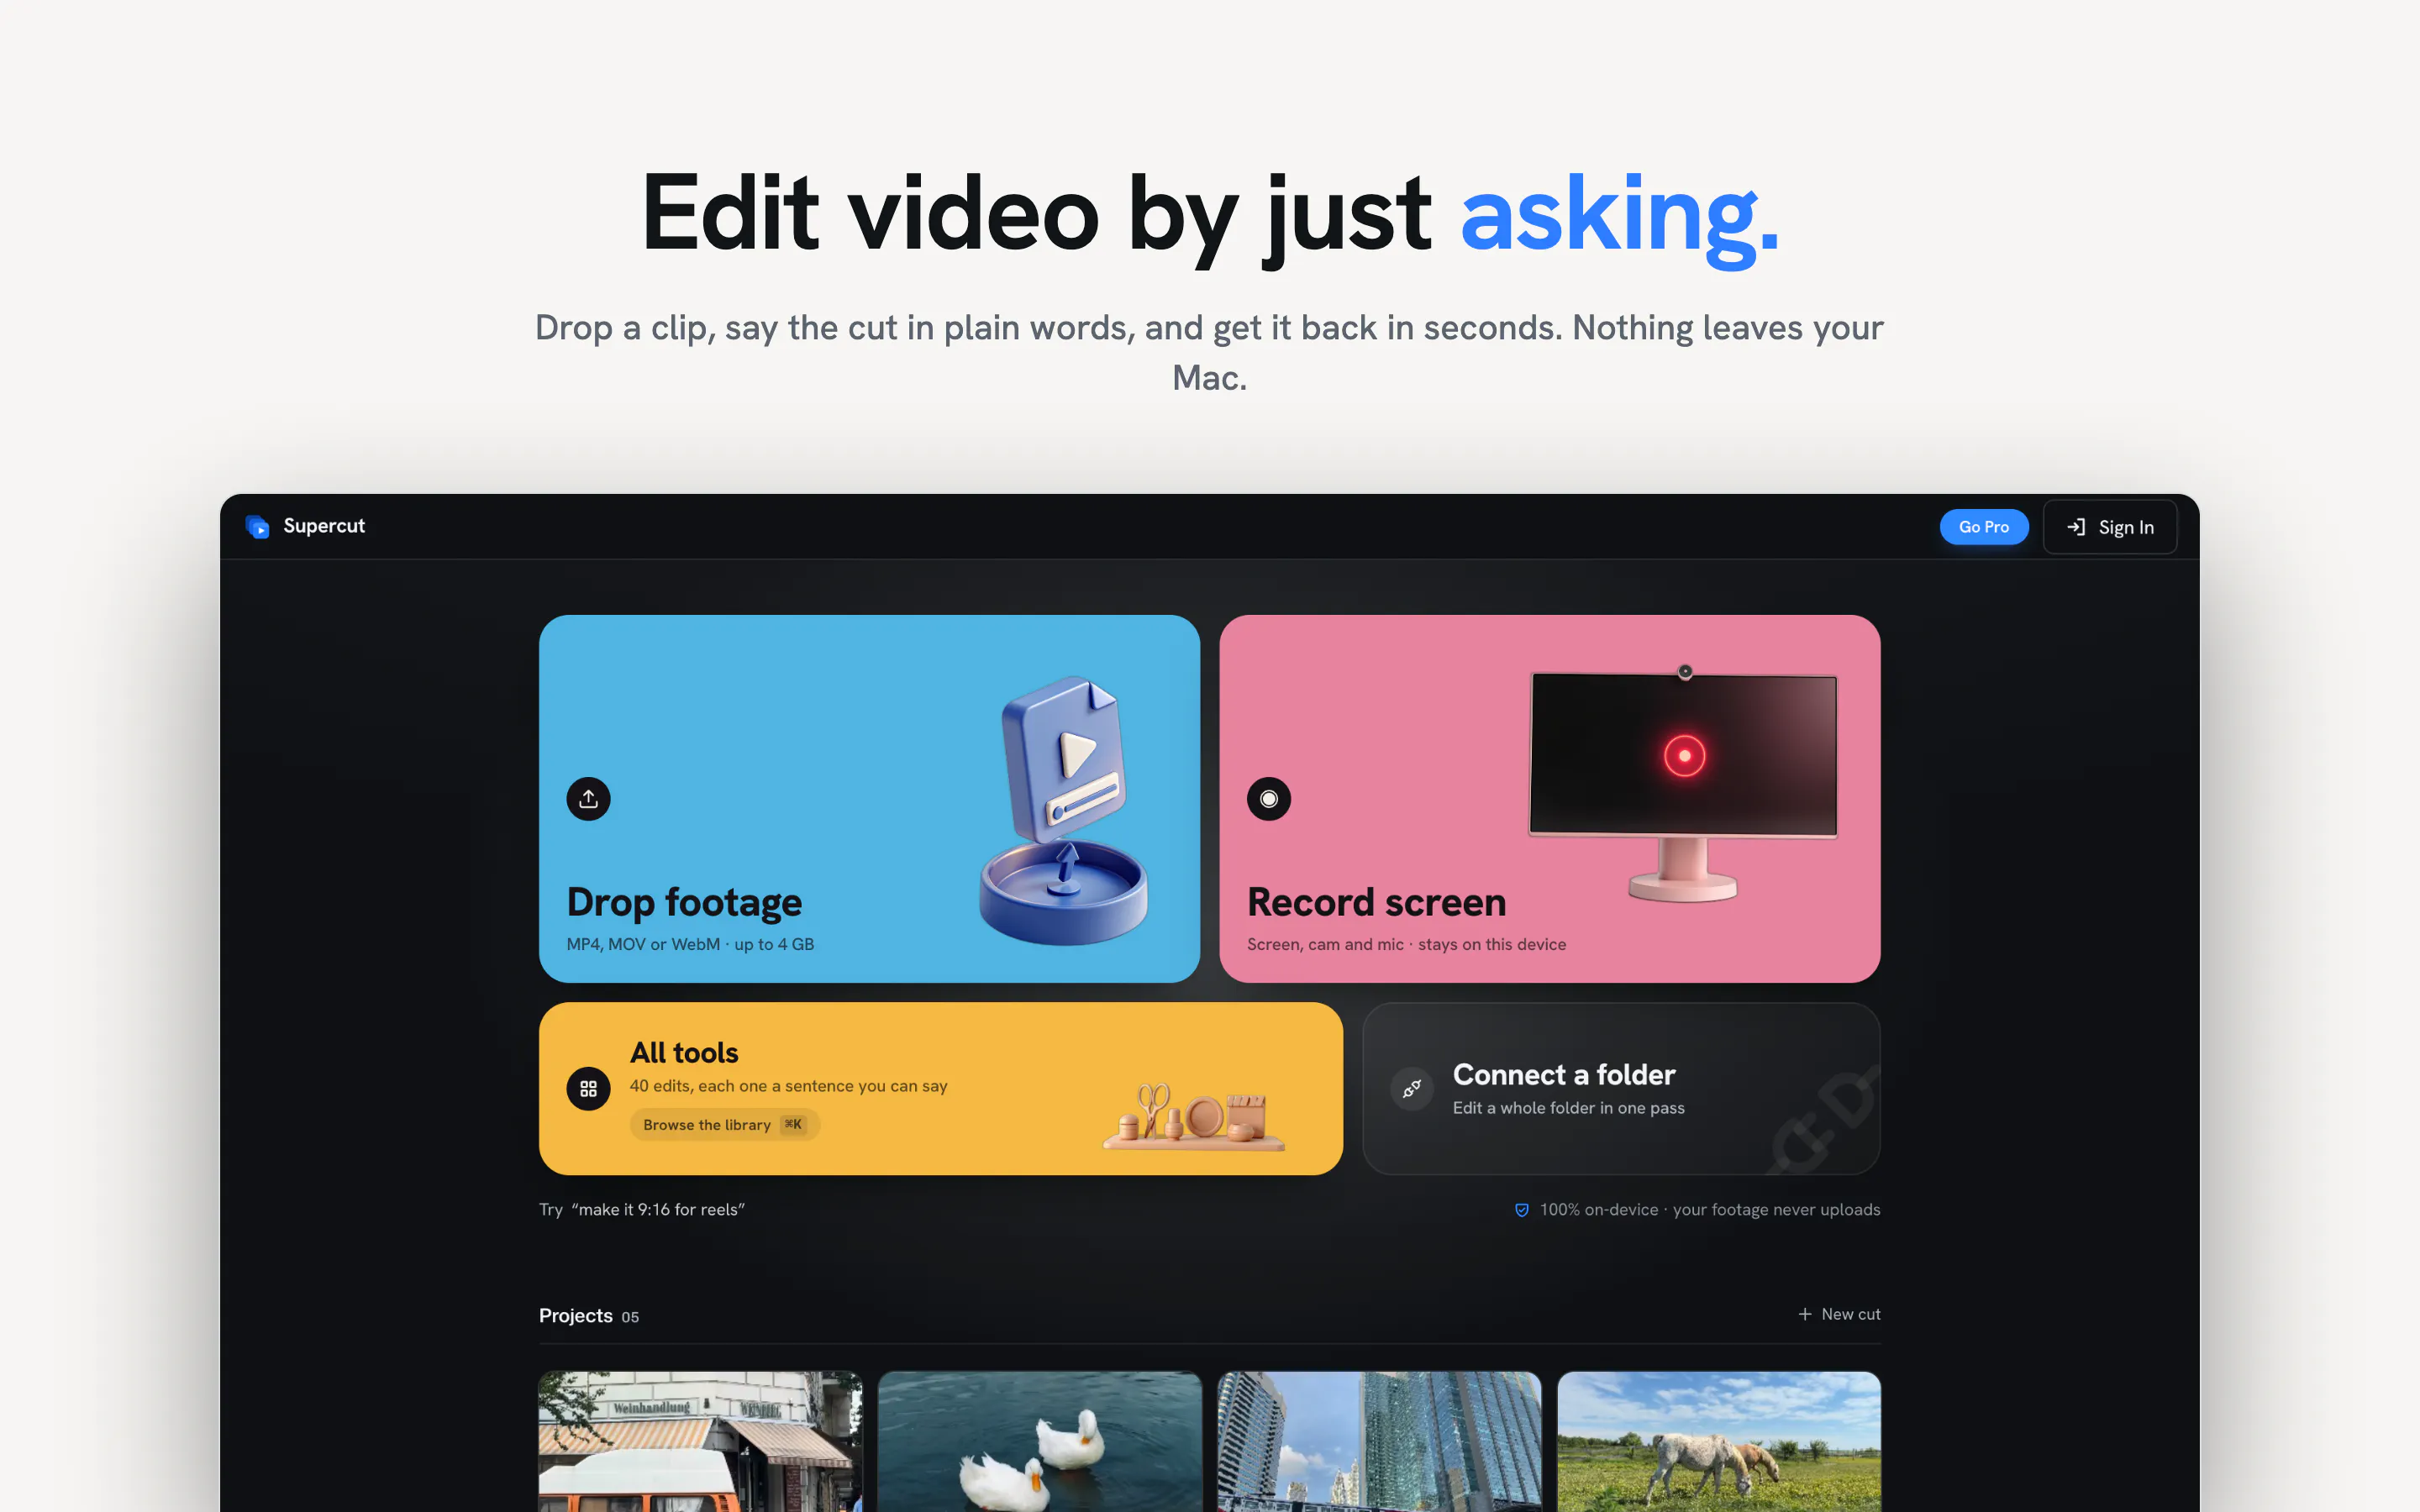
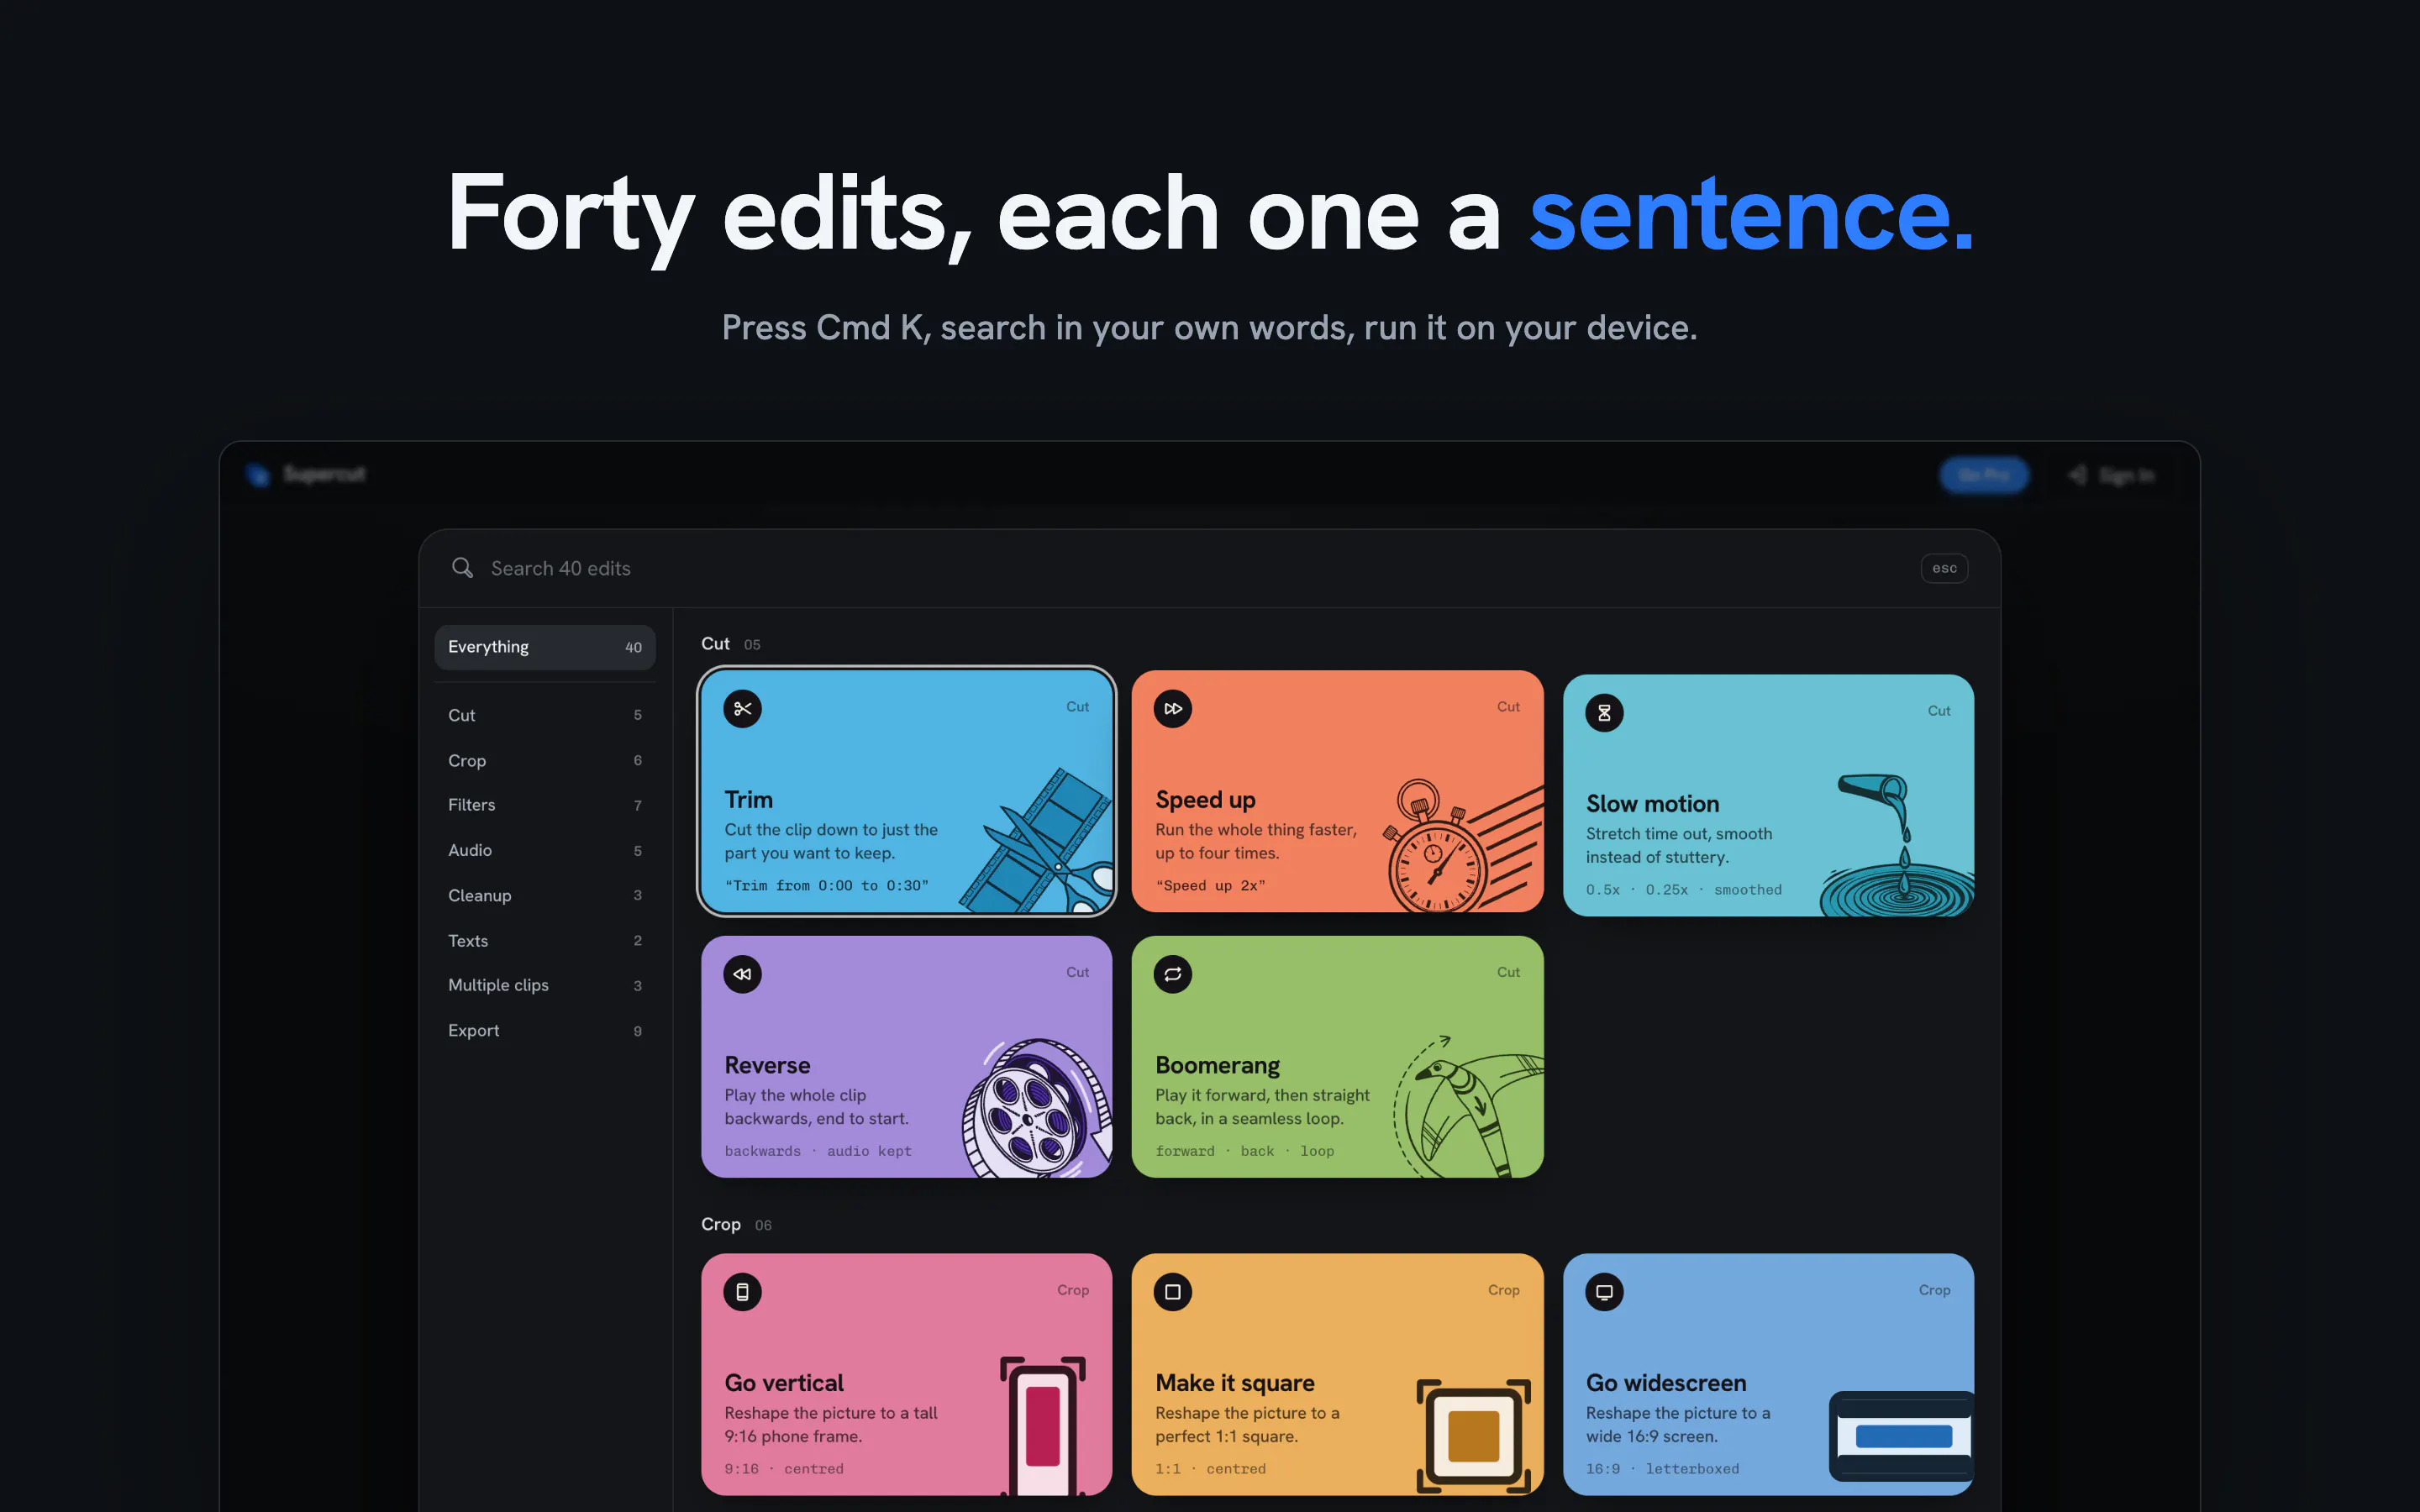
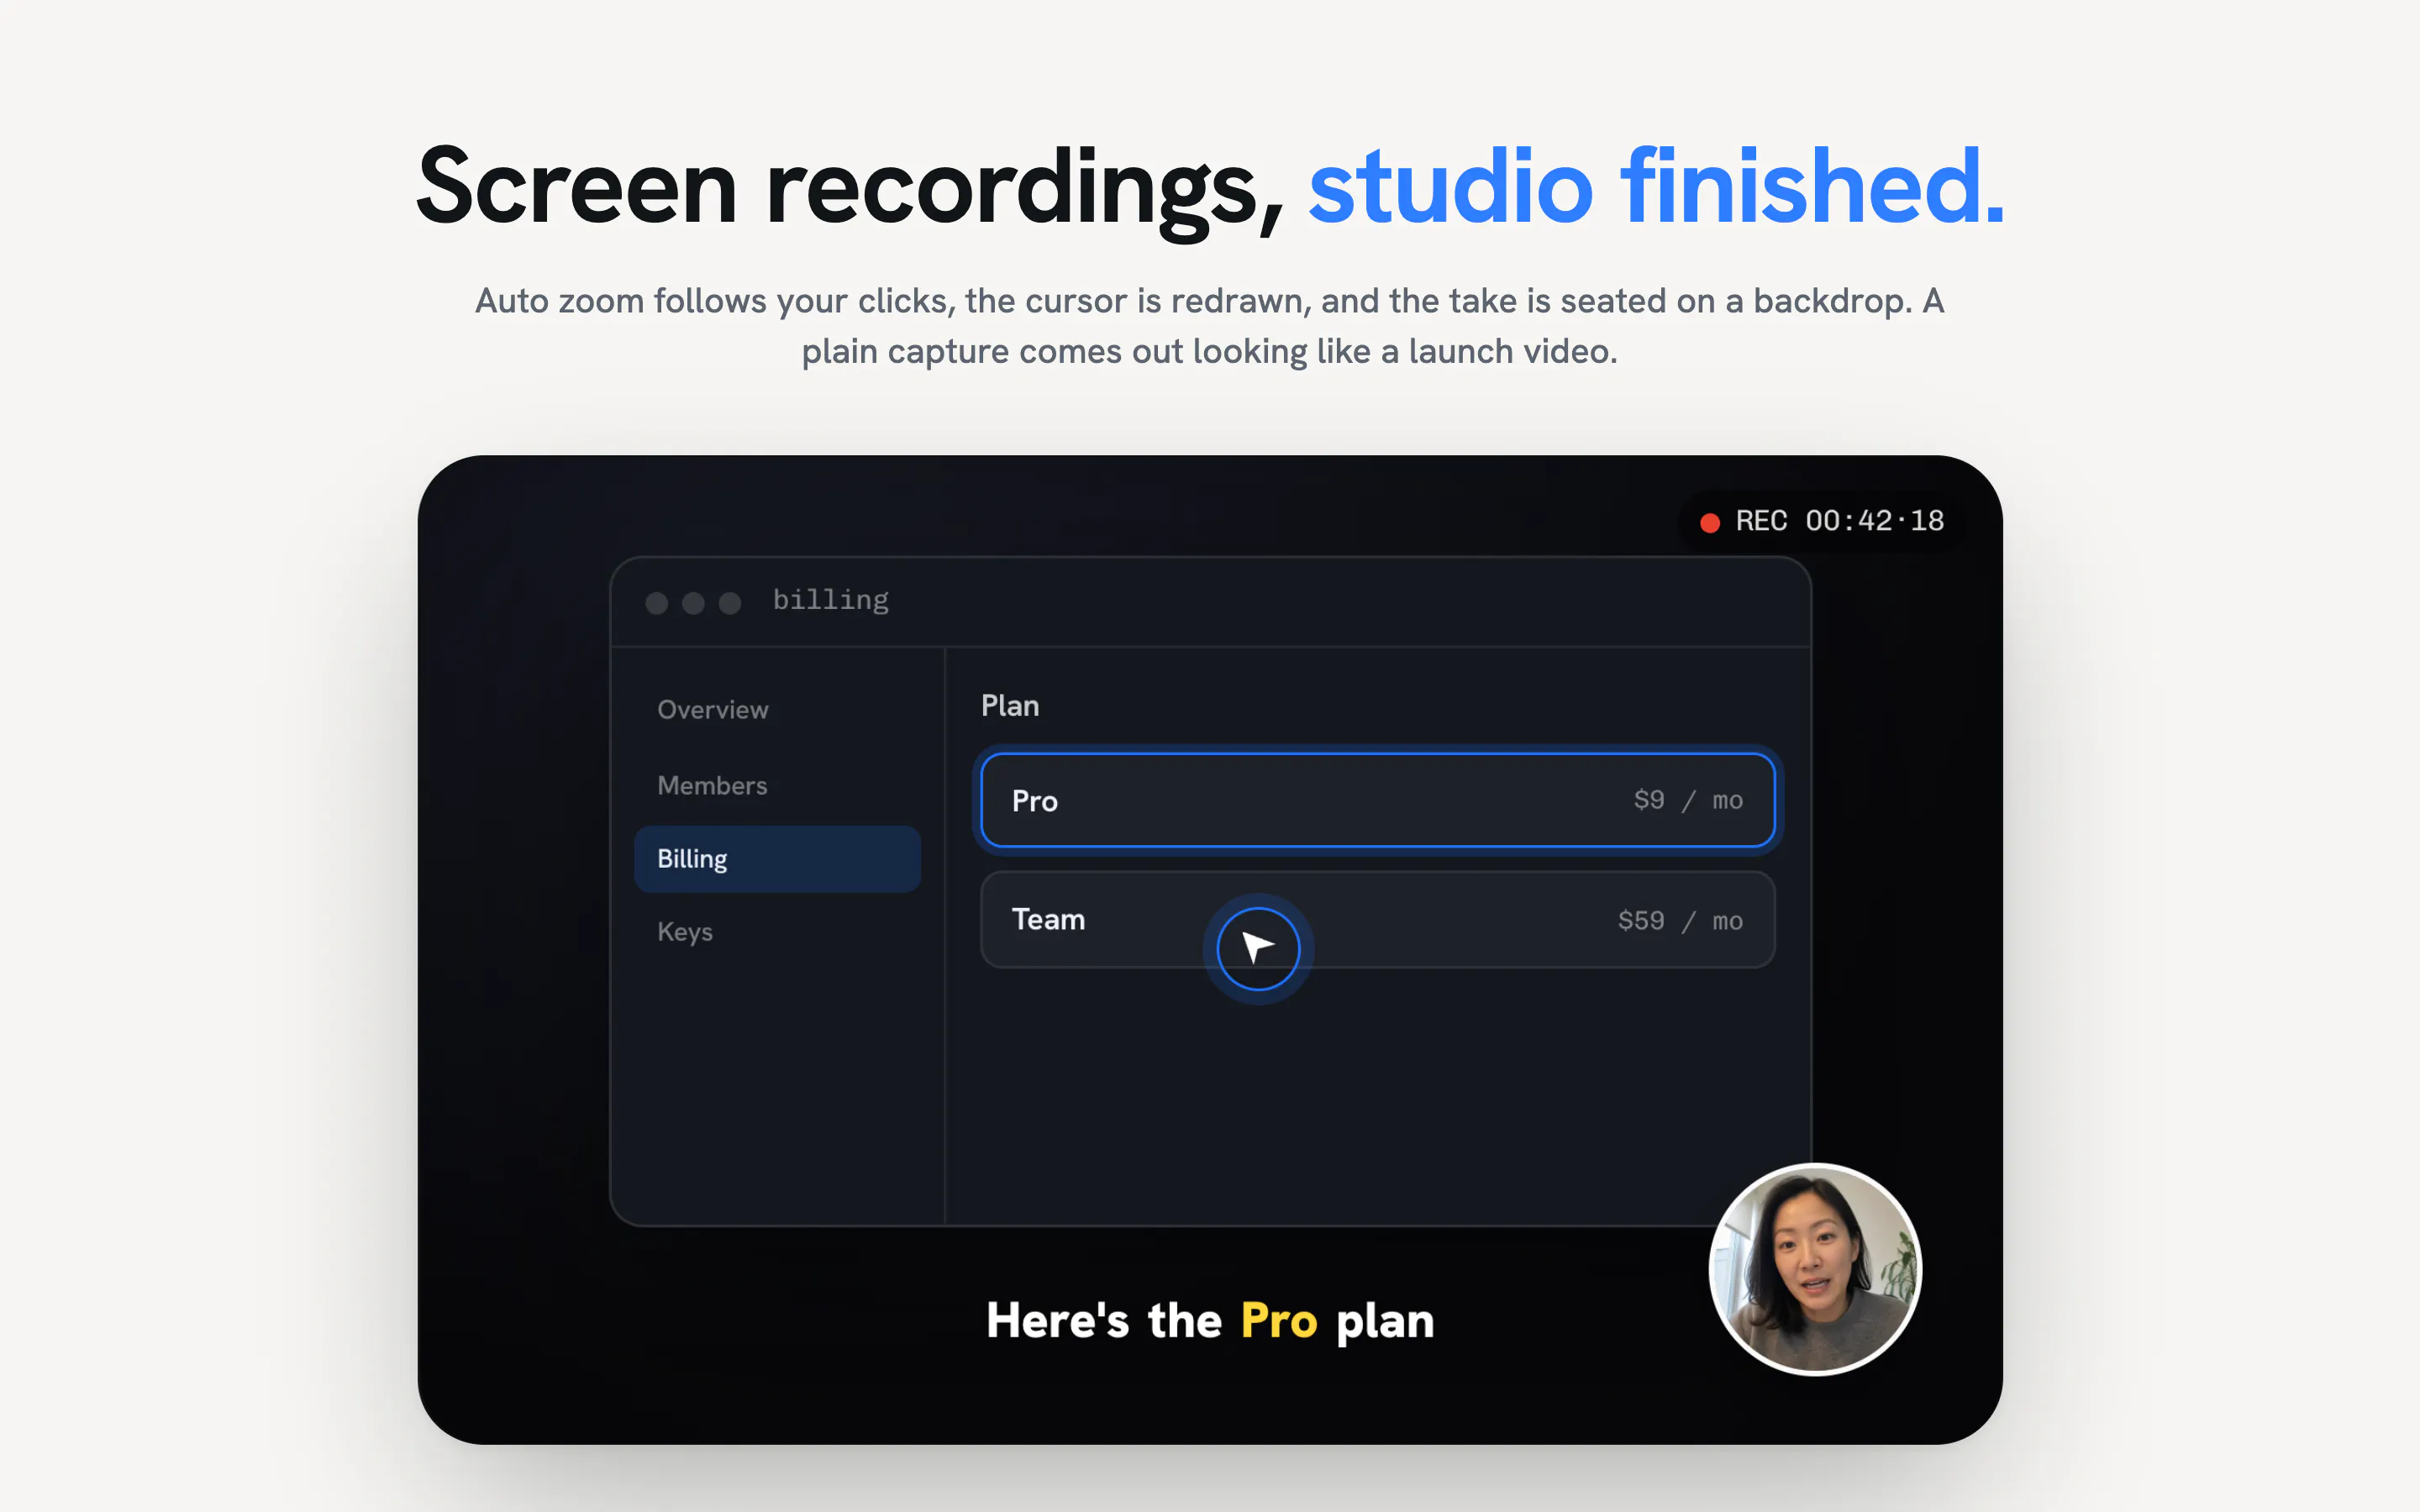
一句话介绍:Supercut 是一款完全在本地运行的 AI 视频编辑器,让你通过“输入指令”或“录屏自动缩放”完成剪辑,无需上传任何素材,直击传统网页剪辑工具“上传慢、隐私泄露、客户端受限”的核心痛点。
Privacy
Artificial Intelligence
Video
AI视频编辑
本地剪辑
隐私保护
屏幕录制
自动字幕
批量处理
桌面应用
无上传
MCP集成
效率工具
用户评论摘要:用户盛赞其能替代 Screen Studio、Loom 等五款付费工具,本地处理体验流畅。主要疑虑集中在定价不透明——未注册前无法获知长期费用,开发者回应称完全免费试用且无需账号。整体反馈积极,但缺乏对具体功能缺陷的深入批评。
AI 锐评
Supercut 的“本地优先”策略切中了视频编辑市场一个真实且被长期忽视的痛点:云端上传的延迟与隐私风险。在 Adobe、CapCut 等巨头竞相将 AI 能力云化的当下,它反其道而行之,将解码、转录、渲染全部压在本地 GPU 上,这对处理敏感商业素材的客户尤为致命吸引力。其“双前门”设计(自然语言指令 + 录屏自动缩放)也足够聪明,显著降低了剪辑门槛,且“文件夹批量编辑”和“MCP 服务器驱动”直指专业用户和 AI Agent 工作流,展现了难得的工具野心。
但必须泼一盆冷水:12 票的冷启动成绩说明产品仍处于早期,评论中一片叫好却缺乏真实使用中的瓶颈反馈,更像内测用户的自嗨。最大的隐患是“免费无账号”的商业模式可持续性——本地计算不产生云端成本,但后续若转向付费,用户对价格容忍度极低,且“AI 只看文字不看画面”的卖点虽保护隐私,却也限制了 AI 在画面理解(如自动识别主体、场景)上的潜力,这会让它在智能剪辑深度上先天不足。此外,浏览器端运行 + 4K 本地导出,对硬件要求极高,注定了它只是“效率玩家的玩具”而非大众工具。若不能快速建立清晰的定价层级并展示对复杂剪辑(多轨道、关键帧)的驾驭能力,它很容易沦为又一款“极客尝鲜后即弃”的产物。方向正确,但离“替代五款工具”的豪言,还有很长的路要走。
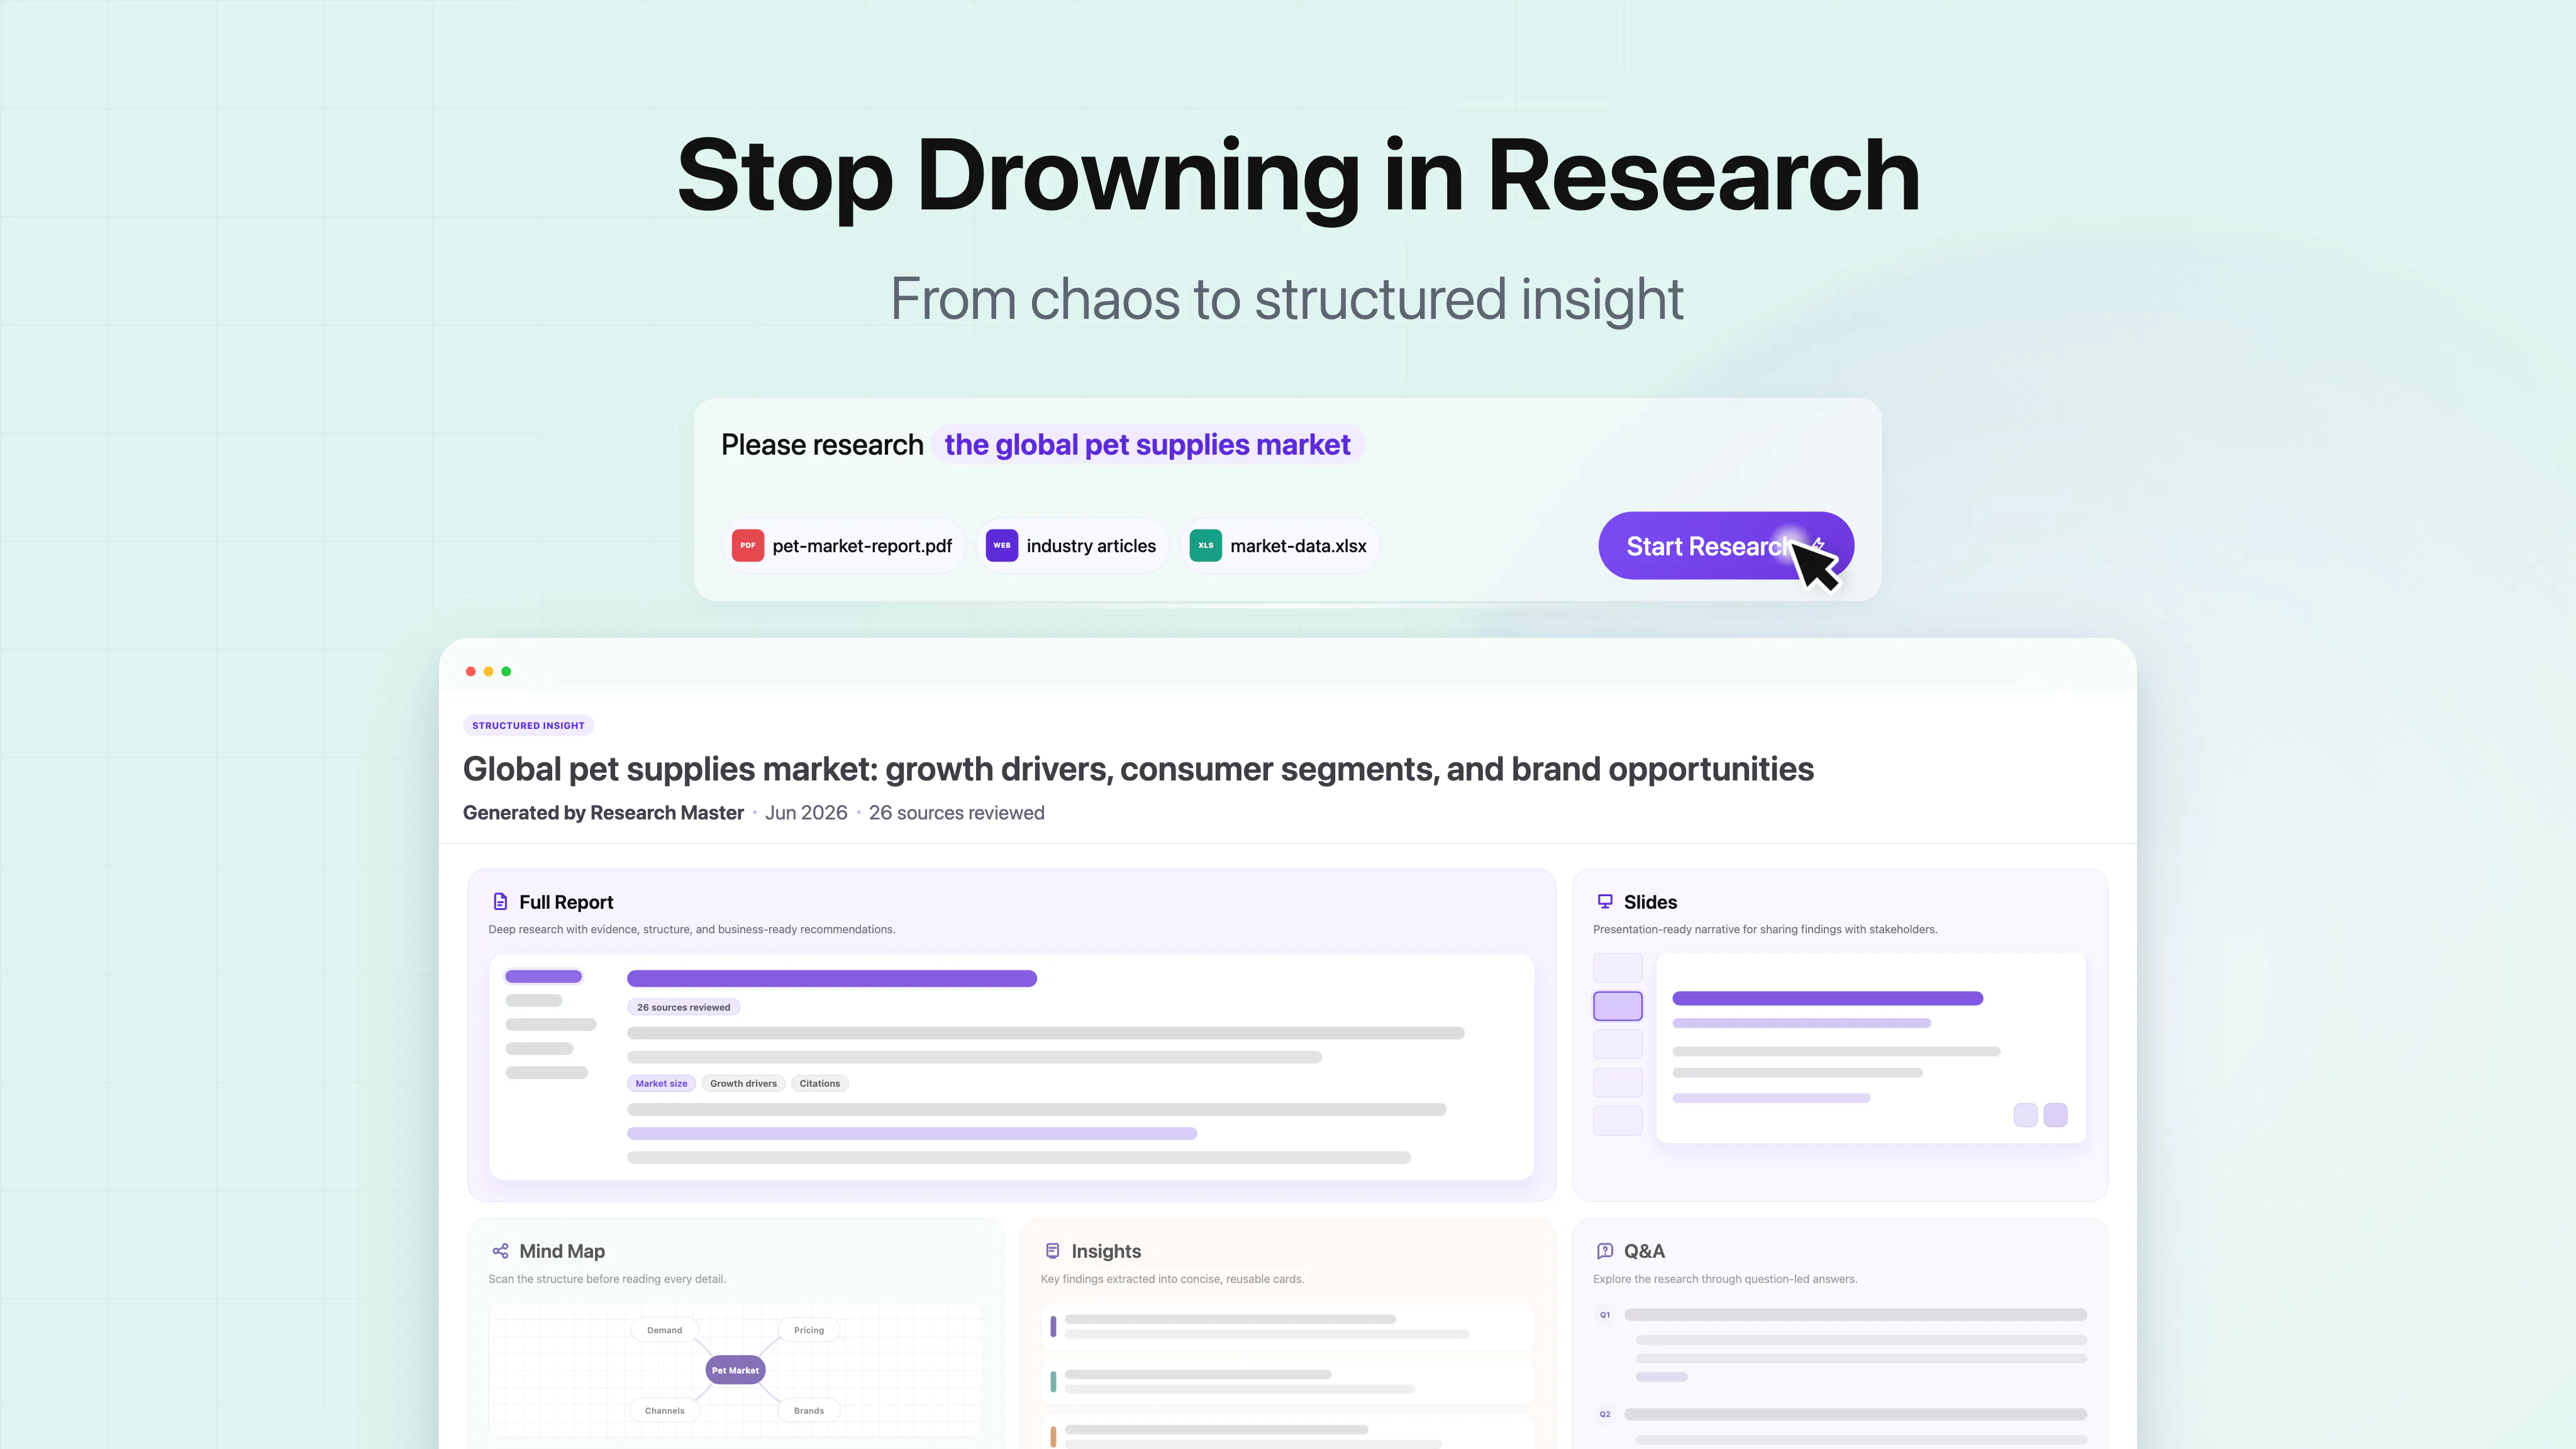
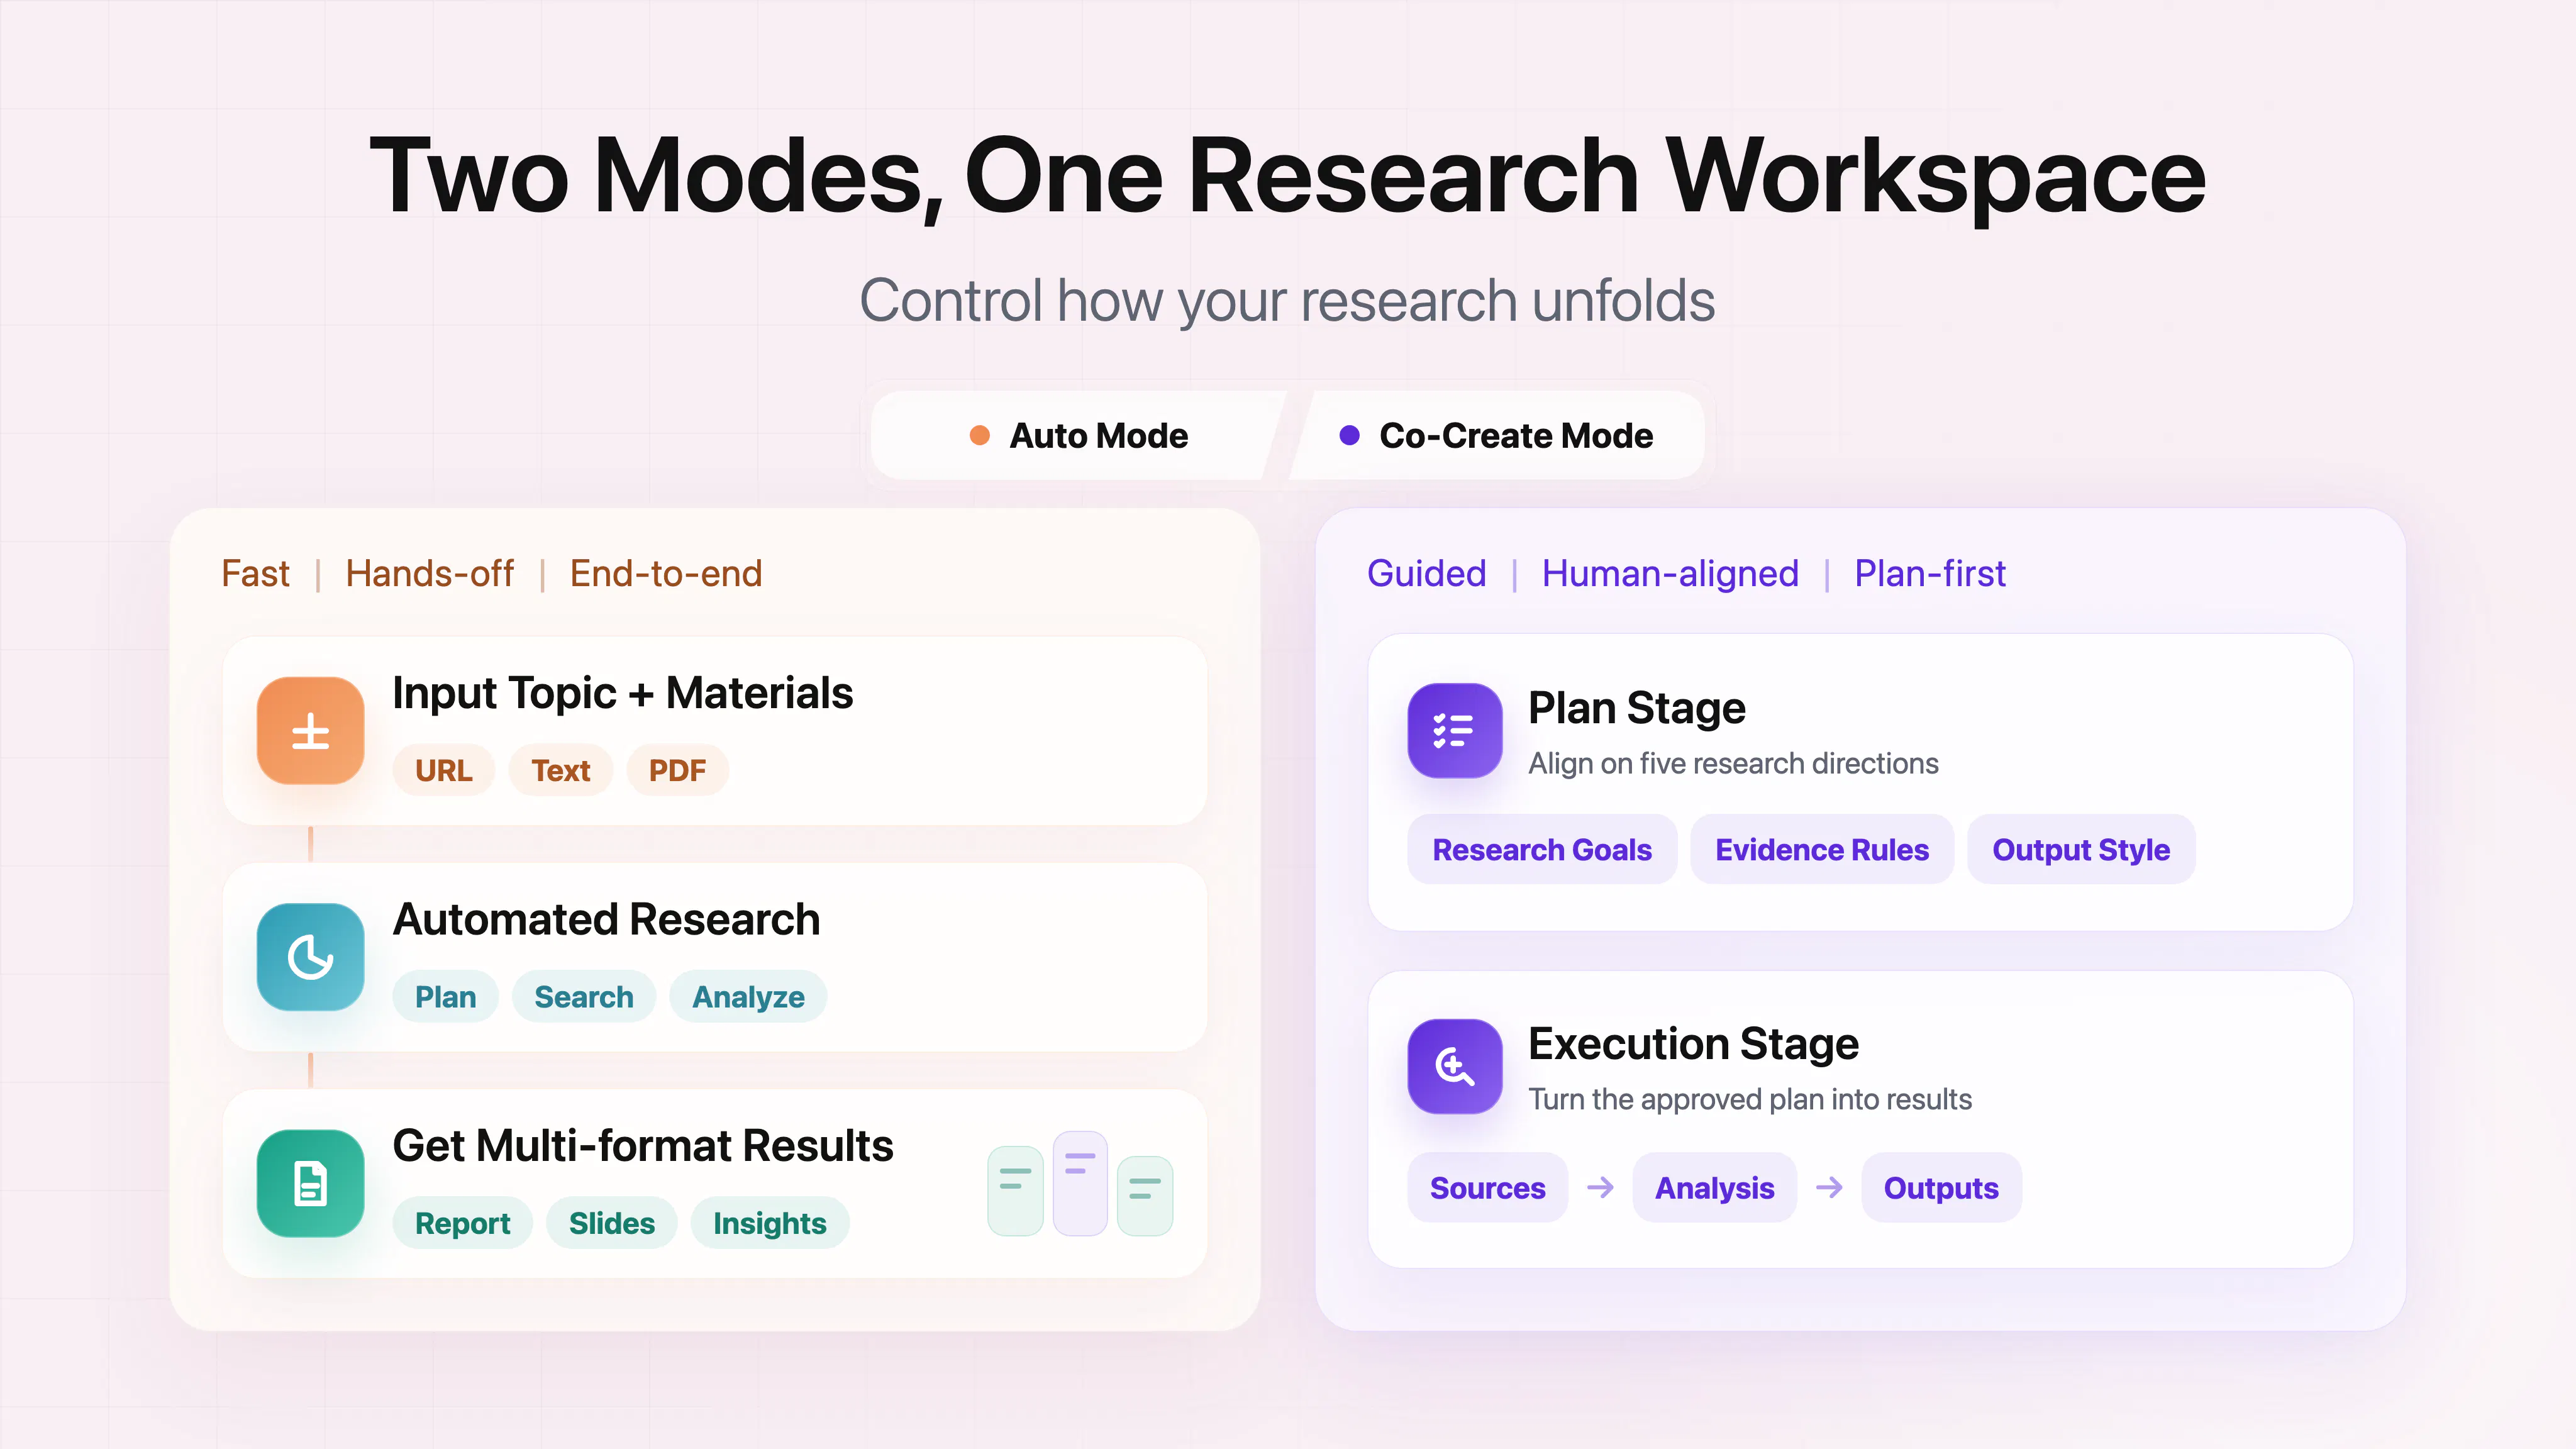
一句话介绍:ResearchMaster AI 将产品、公司或市场问题转化为结构化研究空间,自动检索专业信源并附上证据链接,生成可核查、可导出的报告与幻灯片,解决AI聊天工具“有答案、无交付物”的决策研究痛点。
User Experience
Artificial Intelligence
Search
市场研究
竞争分析
AI报告生成
证据溯源
结构化工作台
投资可行性
决策支持
幻灯片导出
专业信源
产品经理工具
用户评论摘要:评论认可其直击“答案vs交付物”的行业痛点,认为从聊天回复到可交给创始人/投资者的报告仍有巨大鸿沟。创始人回应强调消除研究繁琐步骤、提供可靠来源,并邀请用户反馈研究场景与报告结构改进建议。
AI 锐评
ResearchMaster AI 的切入点精准且克制——它没有试图再造一个“万能问答助手”,而是锚定“决策级研究”这一高价值、高门槛场景。其核心价值不在于生成答案,而在于将“不可信的快速答案”转化为“可核验的决策证据链”。从产品设计看,三类关键能力(专业源检索、冲突提示、导出交付)均直击企业研究工作的真实痛点:AI聊天工具最大的问题不是“不准”,而是“无法对结论负责”。ResearchMaster 尝试用“证据绑定”和“冲突显性化”来部分接管这种责任,这是明智的差异化。然而,风险同样明显:第一,专业信源的质量与覆盖度是隐性壁垒,若数据库深度不足,极易沦为“高级版搜索引擎”;第二,“结构化报告”若模板僵化,反而会限制资深研究者的灵活工作流;第三,40%折扣的Launch策略虽能拉新,但工具类产品留存取决于报告编辑体验与团队协作闭环是否足够顺滑。目前投票仅8票,尚属早期,真正的考验是:当用户把报告拿给投资人或决策层时,是否真的比人工作品更“可信”或更“高效”。若能证明这一点,它就不是又一个AI wrapper,而是研究流程的基础设施;若不能,则只是精致的原型。建议团队后续重点披露典型行业(如医疗、SaaS)的案例对比数据,并开放来源库白皮书,以建立专业信任感。
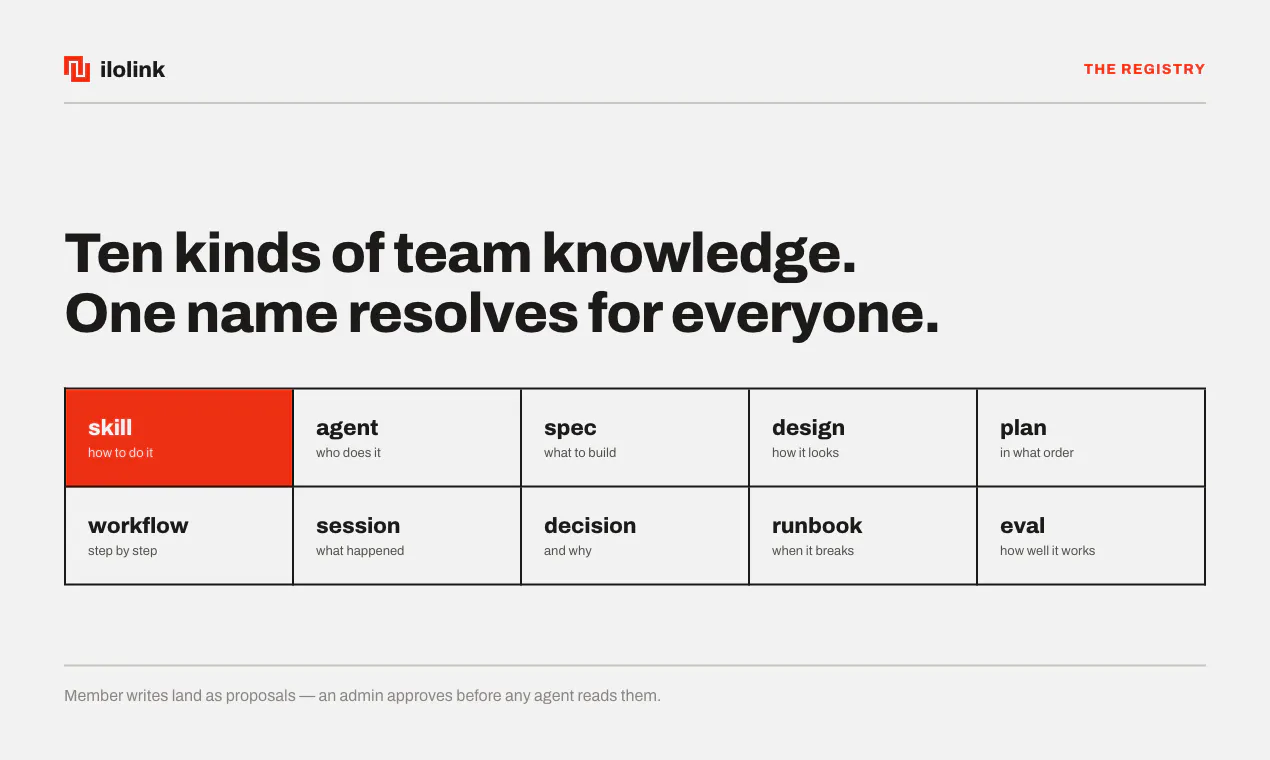
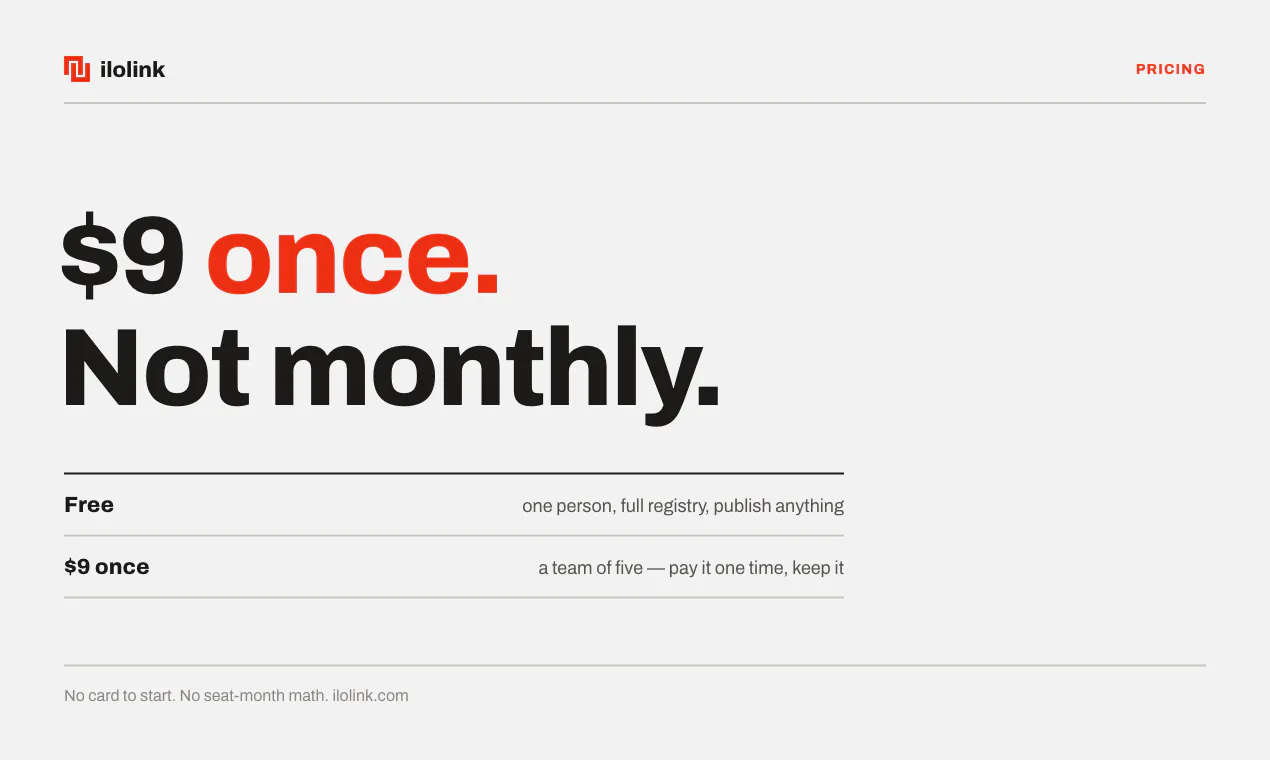
一句话介绍:ilolink 是一个团队AI代理知识注册表,将分散在个人聊天中的技能、规范、计划等沉淀为可版本化、可审阅的共享链接,让所有MCP客户端(如Claude、ChatGPT)统一读取,解决AI知识“一人一聊,人走知识亡”的团队协作痛点。
Productivity
Developer Tools
Artificial Intelligence
AI代理注册表
团队知识管理
MCP客户端
技能共享
提示注入防护
版本控制
协作审批
开发者工具
知识沉淀
一次买断
用户评论摘要:目前仅创始人自述,无用户提问或建议。其核心卖点(代理回写提案、结构化防注入)尚待第三方验证;低价一次性付费策略引发潜在性价比讨论,但缺乏实际使用反馈。
AI 锐评
ilolink 切中的痛点真实且锋利:LLM的“会话性遗忘”导致团队重复造轮子,而现有知识库工具(如Confluence)无法与代理工作流原生集成。其“注册表+提案制”的设计颇有远见——让代理贡献知识但强制人类审批,将提示注入风险从“道德约束”转为“架构约束”,这是对当前Agent安全裸奔现状的一次正确纠偏。但产品面临三重考验:其一,MCP生态尚在早期,多数团队连统一的代理入口都没有,该工具存在“生态前置”风险;其二,$9买断五人团队的定价虽反套路,却易让用户怀疑可持续性——若无人维护,注册表很快会变成弃用的“僵尸库”;其三,评论为零,创始人替代用户发言,缺乏真实打磨痕迹。其“Trending”功能试图做GitHub的Agent精选榜,但 curation 成本高且易受推广操纵。总体而言,这是一款理念正确、执行待验的“基建型”工具,若能在某垂直团队跑出复利效应(如DevOps知识库),有潜力成为Agent时代的GitBook,但现阶段更像是给早期采用者的玩具,而非生产必需品。建议团队聚焦一个高复用场景(如onboarding runbook)做透,而非铺开十种知识类型。
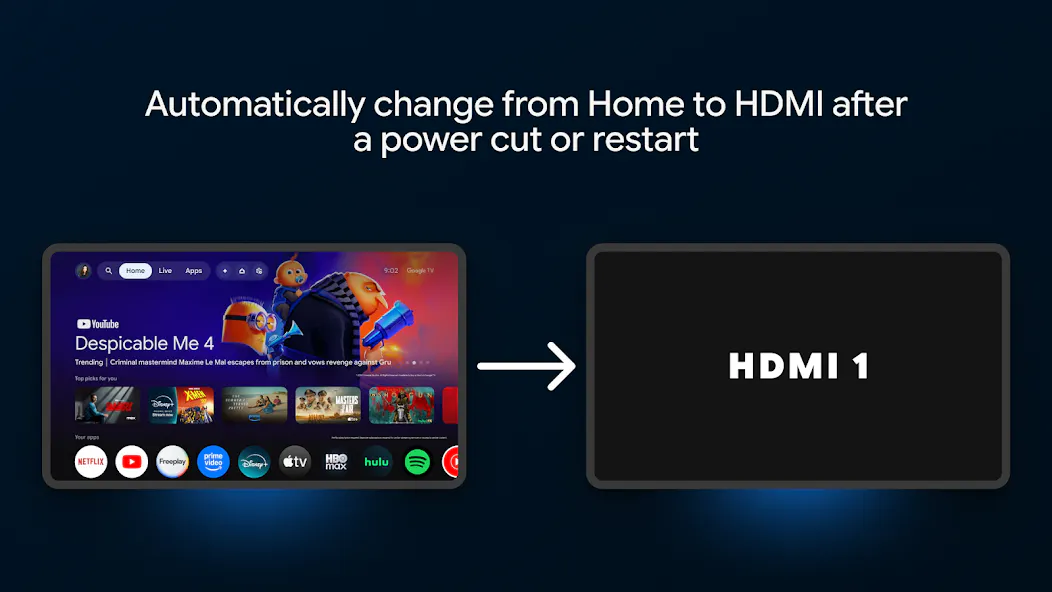
一句话介绍:AutoHDMI 能在安卓电视/谷歌电视意外断电或重启后,自动切换到你预设的HDMI输入源,彻底免去手动按遥控器切换的麻烦,专治“开机永远停在主页”的痛点。
Android
TV
Home Automation
电视应用
谷歌电视
安卓电视
HDMI切换
自动启动
断电恢复
智能家居
易用性
家庭用户
系统增强
用户评论摘要:多数用户认可其精准解决了家庭场景痛点,认为该功能理应内置在系统中。有TCL电视用户表示将实测。开发者回应称这是Play商店目前唯一能做到此功能的应用。建议方面,用户期待能兼容更多电视品牌,并希望界面设置更直观。
AI 锐评
AutoHDMI的7票与其说是产品热度,不如说是对“智能电视反智化”的一次精准控诉。它的真正价值不在于“切换HDMI”这个看似微小的动作,而在于重新定义了电视作为“家电”而非“巨屏平板”的属性。当所有厂商都在强迫用户进入自家瀑布流界面时,AutoHDMI用极简逻辑夺回了用户对输入源的控制权——这本质上是对智能电视“抢主页”行为的用户侧反制。
但必须冷静看到其天花板:这是典型的“补丁式产品”,依赖Android TV系统广播意图(BOOT_COMPLETED)的开放权限,且仅对断电后重启生效,对HDMI-CEC控制的设备切换无能为力。更关键的是,它治标不治本——真正的问题在于电视厂商的系统逻辑缺陷,而非用户缺乏耐心。一旦谷歌在后续系统版本收紧后台自启权限,或主流电视品牌跟进类似功能,这款应用的生存空间会被瞬间挤压。
不过,开发者的洞察极其敏锐:他捕捉到的是“非核心用户(老人、孩子)在复杂TV UI前的无助感”,这是许多智能电视厂商忽视的沉默多数。从这个角度看,AutoHDMI是一件精巧的“数字无障碍”工具。建议其后续向“场景自动化”延伸,比如根据时间或开机次数自动切换(白天盒子、晚上游戏机),否则仅靠“断电修复”这一个痛点,很难撑起可持续的用户粘性。简言之:值得一用,但格局要再大一点,否则只能是智能电视生态里一朵转瞬即逝的浪花。
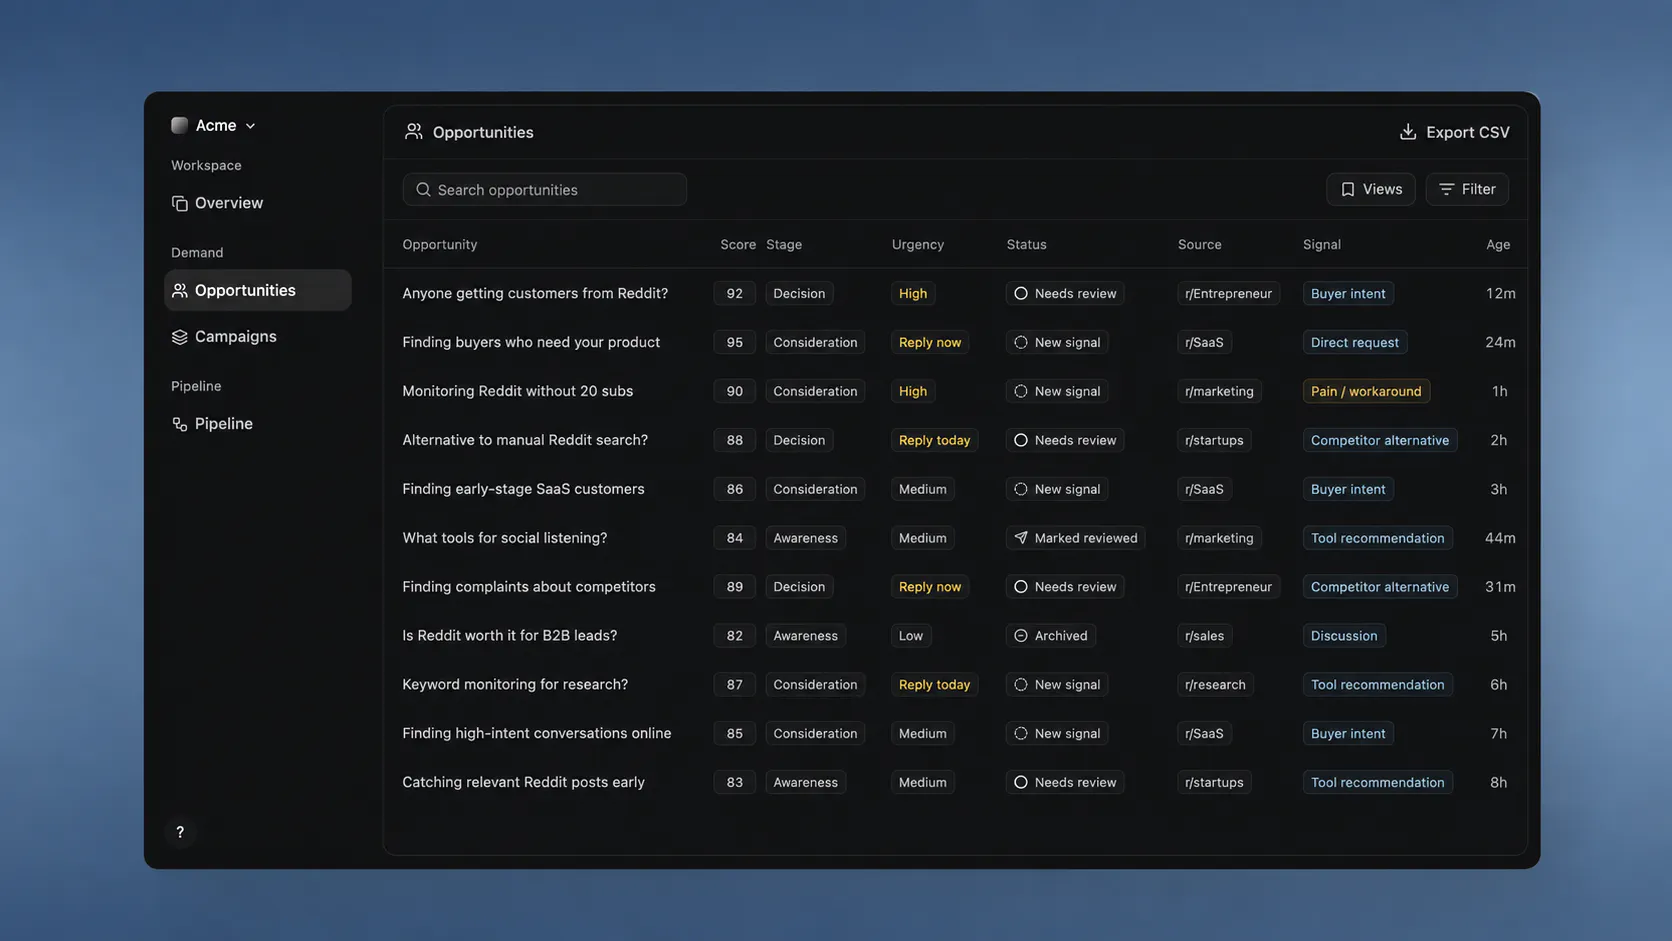
一句话介绍:Leadline V3 是一款Reddit销售线索挖掘工具,能自动监测并筛选出正在讨论相关需求的帖子,并按购买意图与匹配度排序,帮B2B团队在对话活跃期高效触达潜在客户,省去手动搜索的麻烦。
Sales
Marketing
SaaS
Reddit营销
销售线索挖掘
B2B获客
社交聆听
意图识别
潜在客户开发
SDR工具
外贸获客
社区监测
线索管理
用户评论摘要:目前评论仅来自发布者本人,无有效用户反馈或提问。发布者主要强调产品围绕“哪些Reddit对话值得回复”重建,并邀请用户试用后反馈。暂未发现用户建议或问题,社区反响未明。
AI 锐评
Leadline V3踩中了一个真实且被低估的痛点:Reddit是B2B买家“未被听见的搜索栏”,大量高意向询盘淹没在帖子里,而手动检索效率极低。产品将“关键词监测+意图评分+会话收件箱”整合为一条管线,逻辑上闭环,尤其对服务中小B2B的SDR团队具备实用价值——时间敏感性正是Reddit商机的核心。
但问题也明显:其一,意图与匹配度的“评分”算法如果只是关键词加权而非语义理解,误判率会很高;其二,Reddit用户对广告式私信极度反感,产品若只优化“找到”而不深度打造“如何回复”的语境适配能力(如基于整帖情绪生成非推销式草稿),转化率将大打折扣;其三,7票的冷启动数据表明市场尚未验证,且$150的终身定价暗示了低续费焦虑,后续算法维护成本需依赖小体量用户规模摊薄,存疑。真正价值不在“省时间”,而在于把“看不见的主动询盘”变成“可排名的商机队列”——但这需要以真实购买信号(如求助细节、预算词、时间紧迫度)而非单纯话题热度驱动排序。建议尽快开放公开API并沉淀“回复转化率”作为唯一核心指标,否则很容易沦为又一个“自我感动型工具”。
一句话介绍:Post Formatter 是一款专为 LinkedIn、X 和 Threads 打造的文本格式化工具,通过纯文本复制机制解决加粗、斜体、项目符号在粘贴后丢失的痛点,无需授权账号即可使用。
Chrome Extensions
Productivity
Marketing
文本格式化
社交媒体工具
富文本粘贴
Unicode转换
内容创作
跨平台兼容
隐私安全
一次性付费
浏览器扩展
生产力工具
用户评论摘要:目前仅有开发者自述评论(1赞)。核心反馈聚焦于:现有扩展因复制HTML剪贴板导致格式被平台剥离,本产品改用纯文本复制解决此问题;定价为一次性7美元,对比19-20美元/月订阅制具备价格优势;开发者强调无需页面读取权限,保护用户隐私。
AI 锐评
Post Formatter 切中的是一个真实且高频的“微痛点”——社交媒体富文本粘贴失效。其技术路径(Unicode字符模拟样式而非HTML)确实比多数扩展更聪明,因为LinkedIn的编辑器会剥离富文本格式,但无法剥离Unicode字符。这本质上不是“格式化工具”,而是“格式伪装器”,用字符映射偷渡样式,思路值得肯定。
但产品天花板极其明显。首先,Unicode伪装格式有先天缺陷:不同平台、字体渲染下效果不一致,且无法覆盖所有样式(如高亮、超链接);其次,目标用户是内容运营者,但这群人通常用Hootsuite等一体化排程工具,独立格式化插件是低频场景。7美元买断看似良心,实则是开发者对持续订阅缺乏信心的自我定位——这个需求撑不起订阅制,但也很难撑起规模化的买断收入。
更尖锐的问题是:开发者强调“零权限、不读取页面”,这确实是隐私卖点,但同时也意味着产品无法提供“一键从草稿箱提取并格式化”的闭环体验,用户仍需复制、粘贴、转换、再粘贴,效率提升有限。它在Product Hunt仅获7票,说明市场反馈冷淡,并非偶然——这更像是一个技术Demo,而不是具备网络效应的产品。如果开发者不做成跨平台客户端(如接入Raycast、Alfred)或提供API嵌入写作工具,大概率会小众地活下去,但注定无法成为主流生产力工具。建议团队尽快明确商业化落地场景,否则“一次性买断”只是优雅的止损宣言。
This solves a problem I didn't know I could solve, I always assumed API billing discrepancies were just the cost of doing business. Turns out I was wrong.
Overpaying for failed calls has quietly cost me more than I'd like to admit. I've had timeouts that still consumed tokens on the provider's side and no clean way to catch that pattern until my bill arrived. If this surfaces failure-related overspend specifically, not just total usage, I'd trust the numbers more than any provider dashboard.
Hey PH
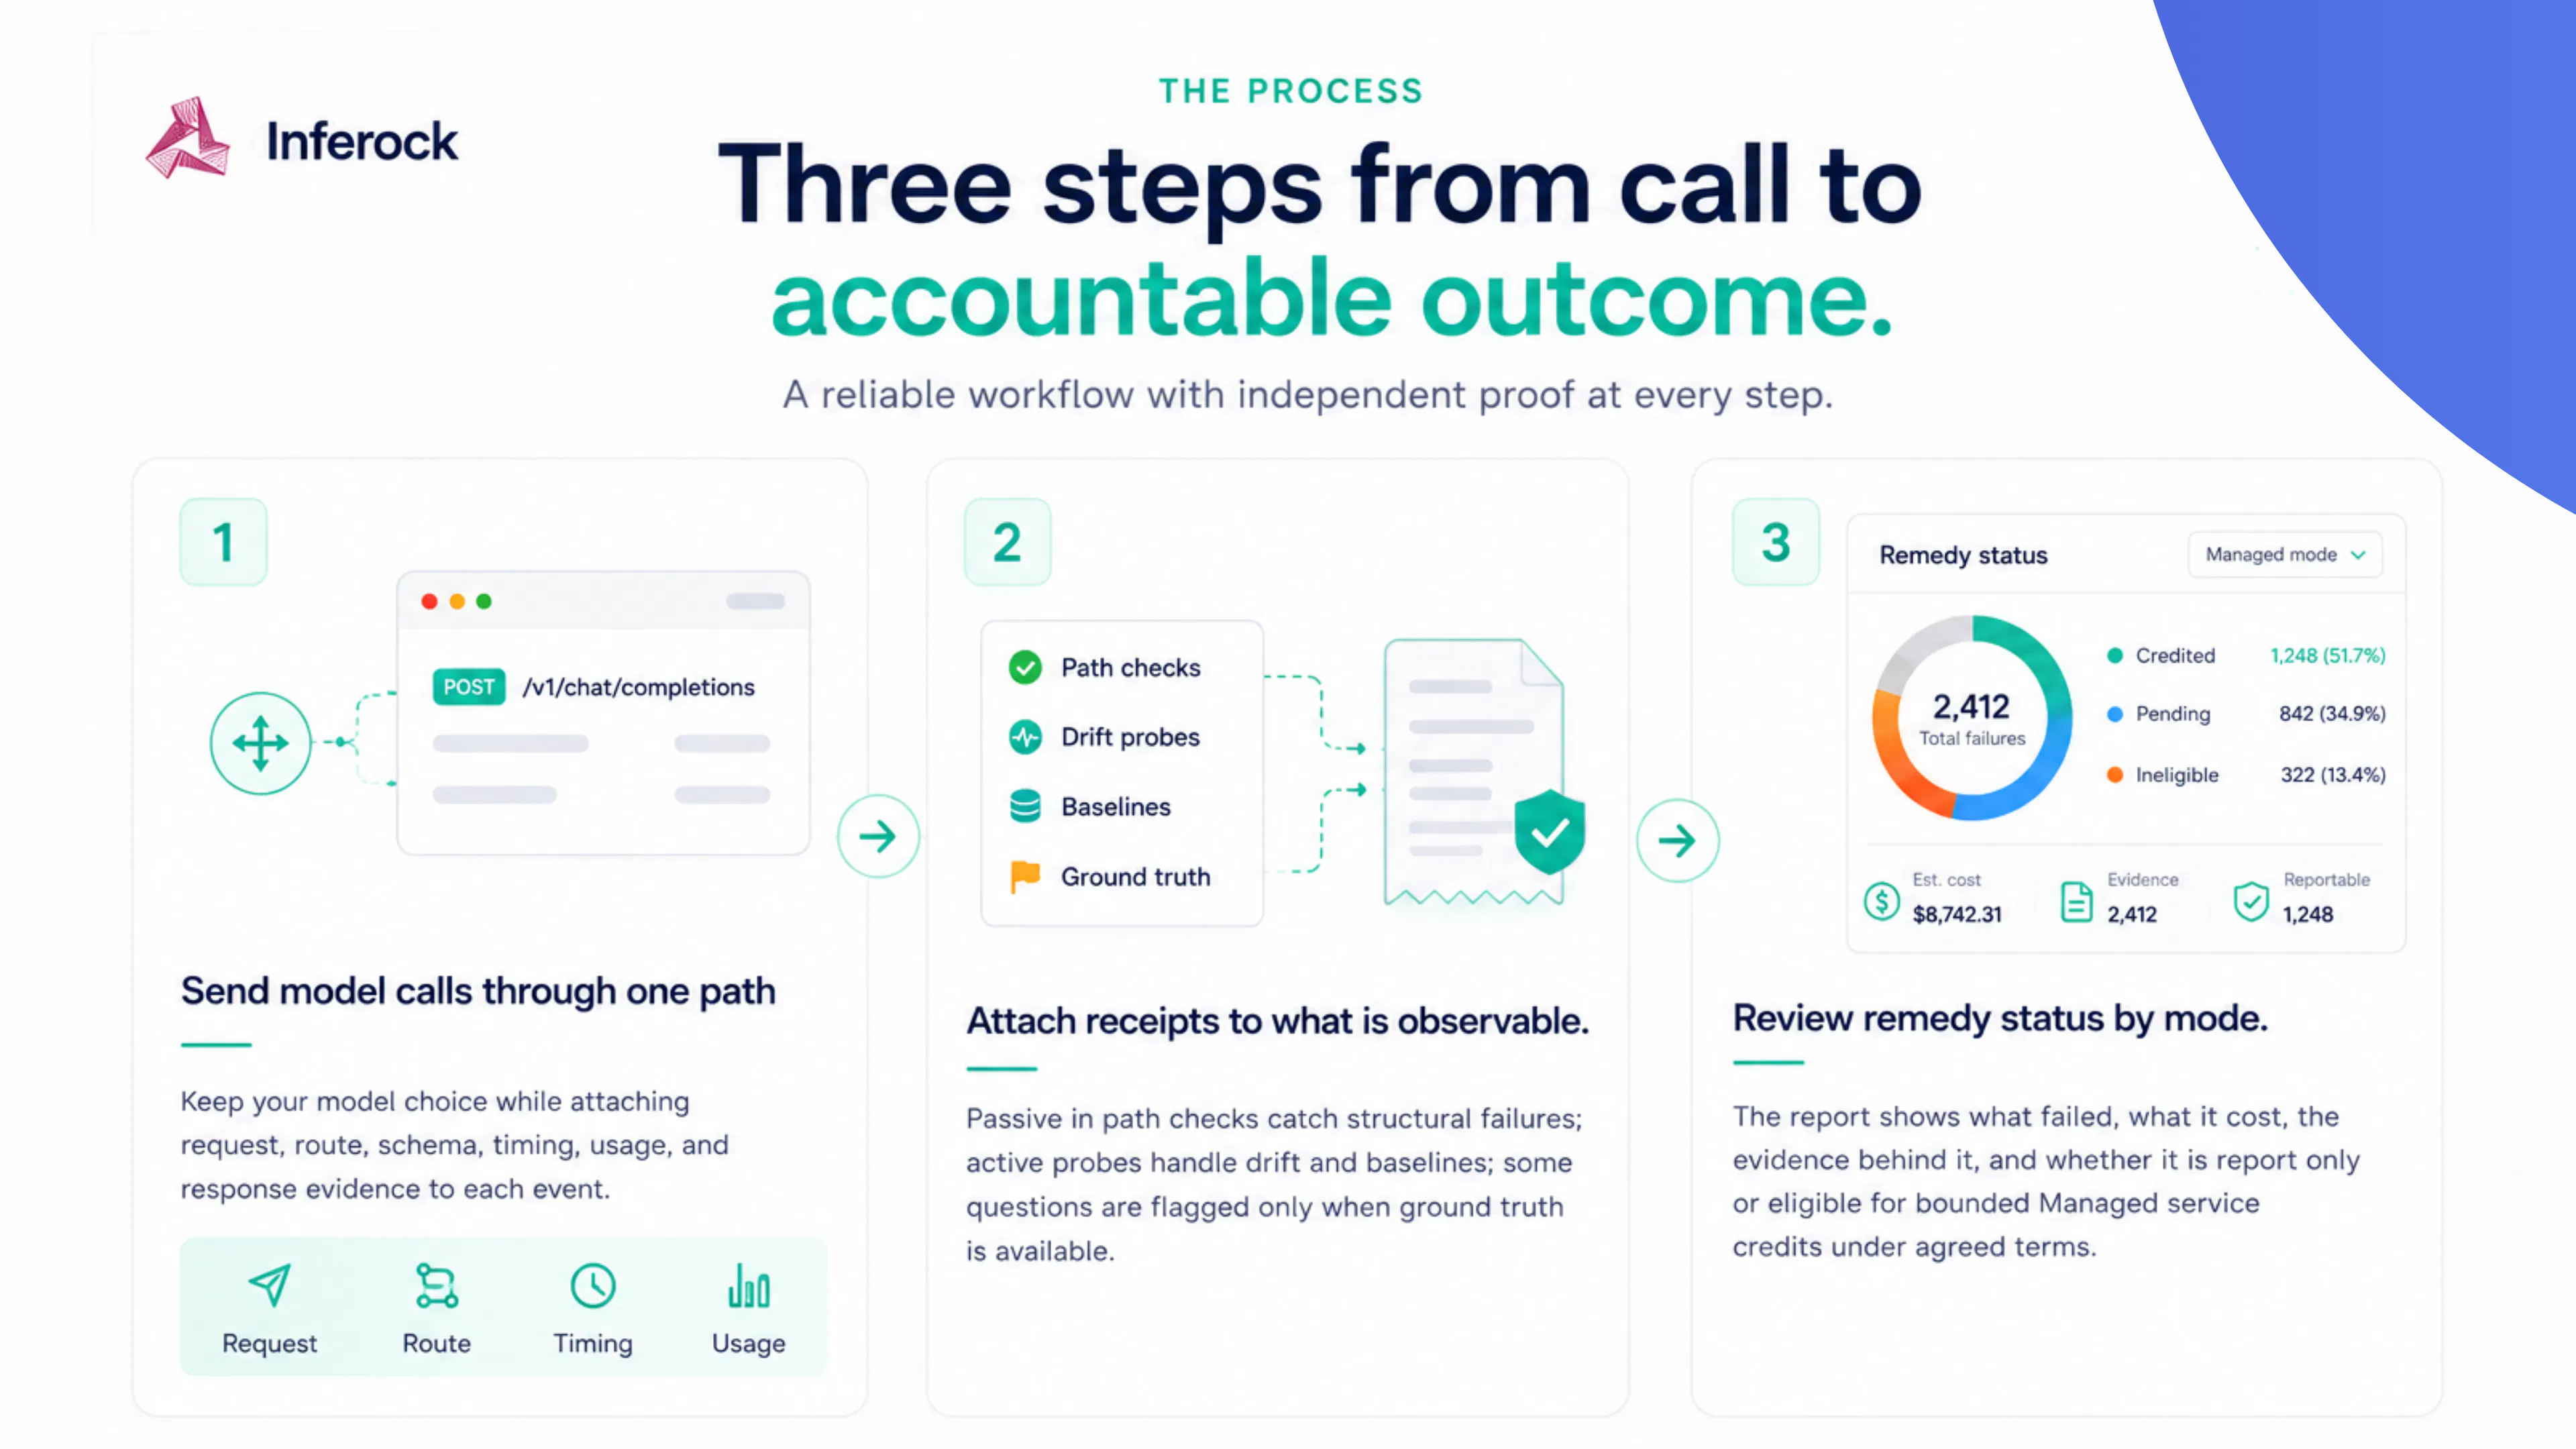
We built inferock-bench because we kept paying for AI answers that died mid sentence, and nobody could tell us where the money went.
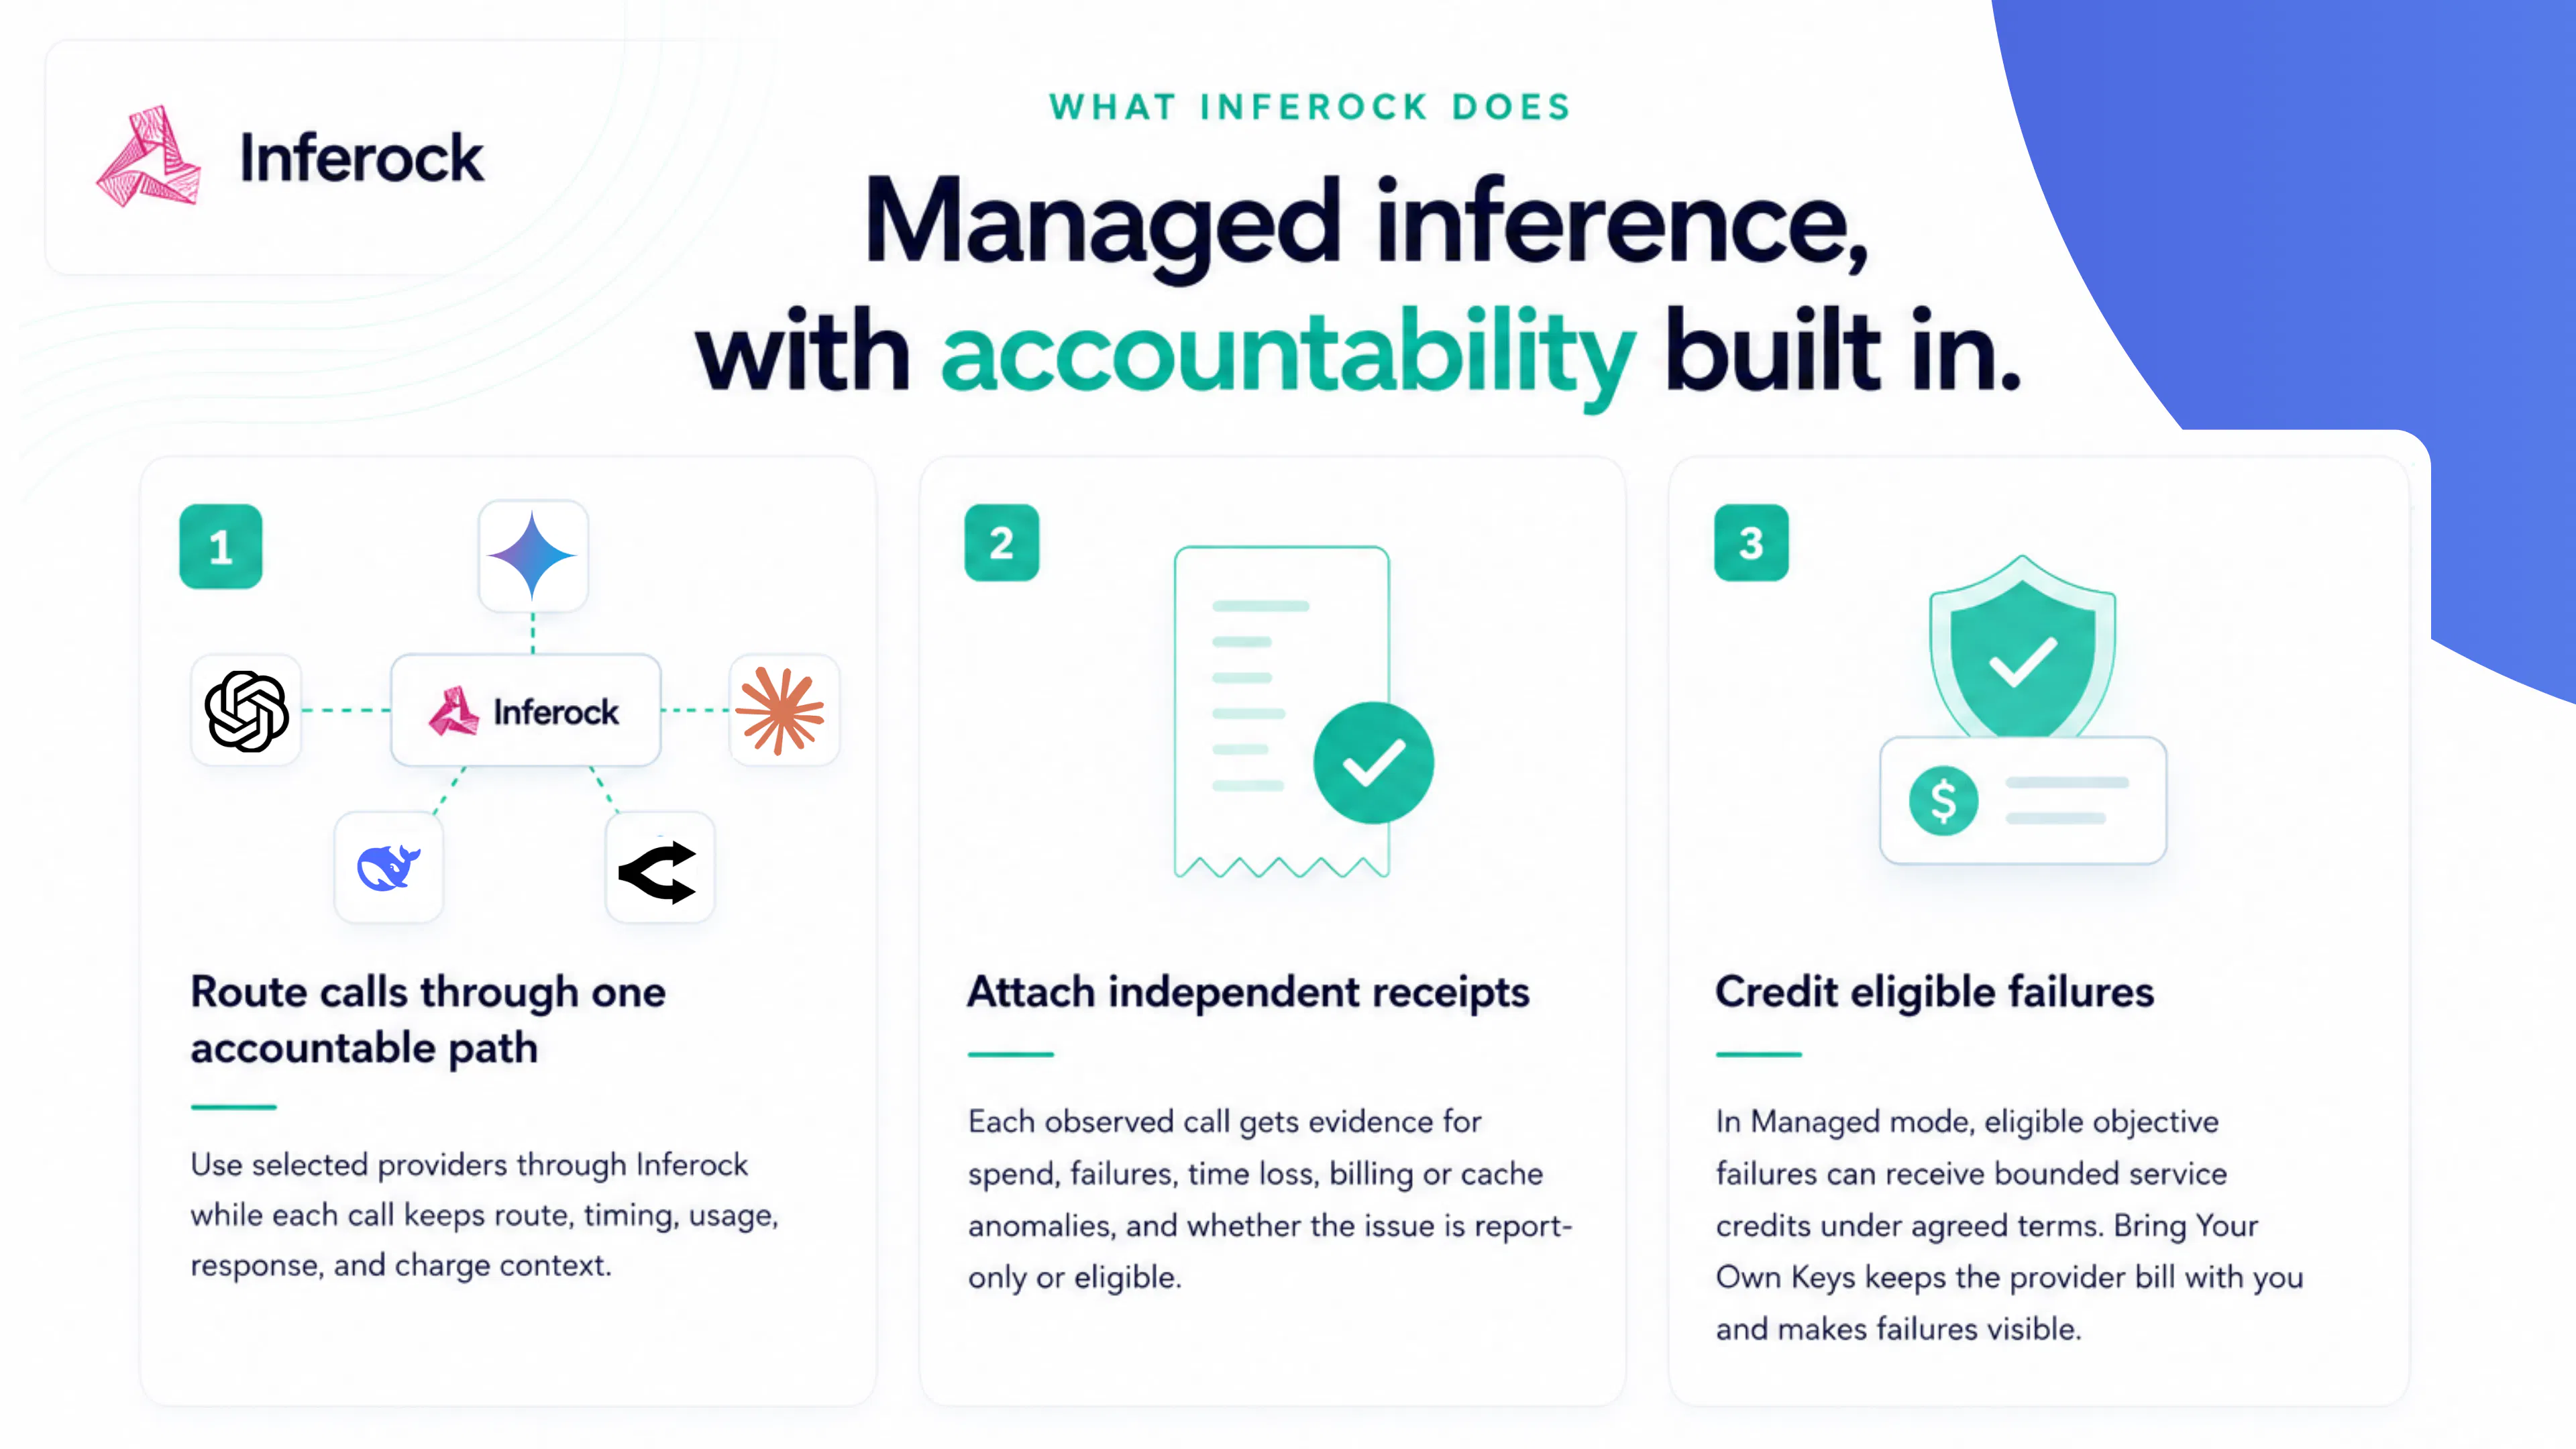
Providers give you totals. They don't give you the per call receipt you'd need to prove which answer broke, which retry ran, or which token count changed. The company that charges you also decides what counts as a failure and keeps the only detailed records.
inferock-bench runs locally as a proxy in front of OpenAI, Anthropic, Gemini, OpenRouter shaped calls. Point your existing SDK at it (change two settings: apiKey and baseURL), and it captures every call as an independent, per call record. Your provider key never touches our servers, it's used locally only, attached to provider requests.
What it catches:
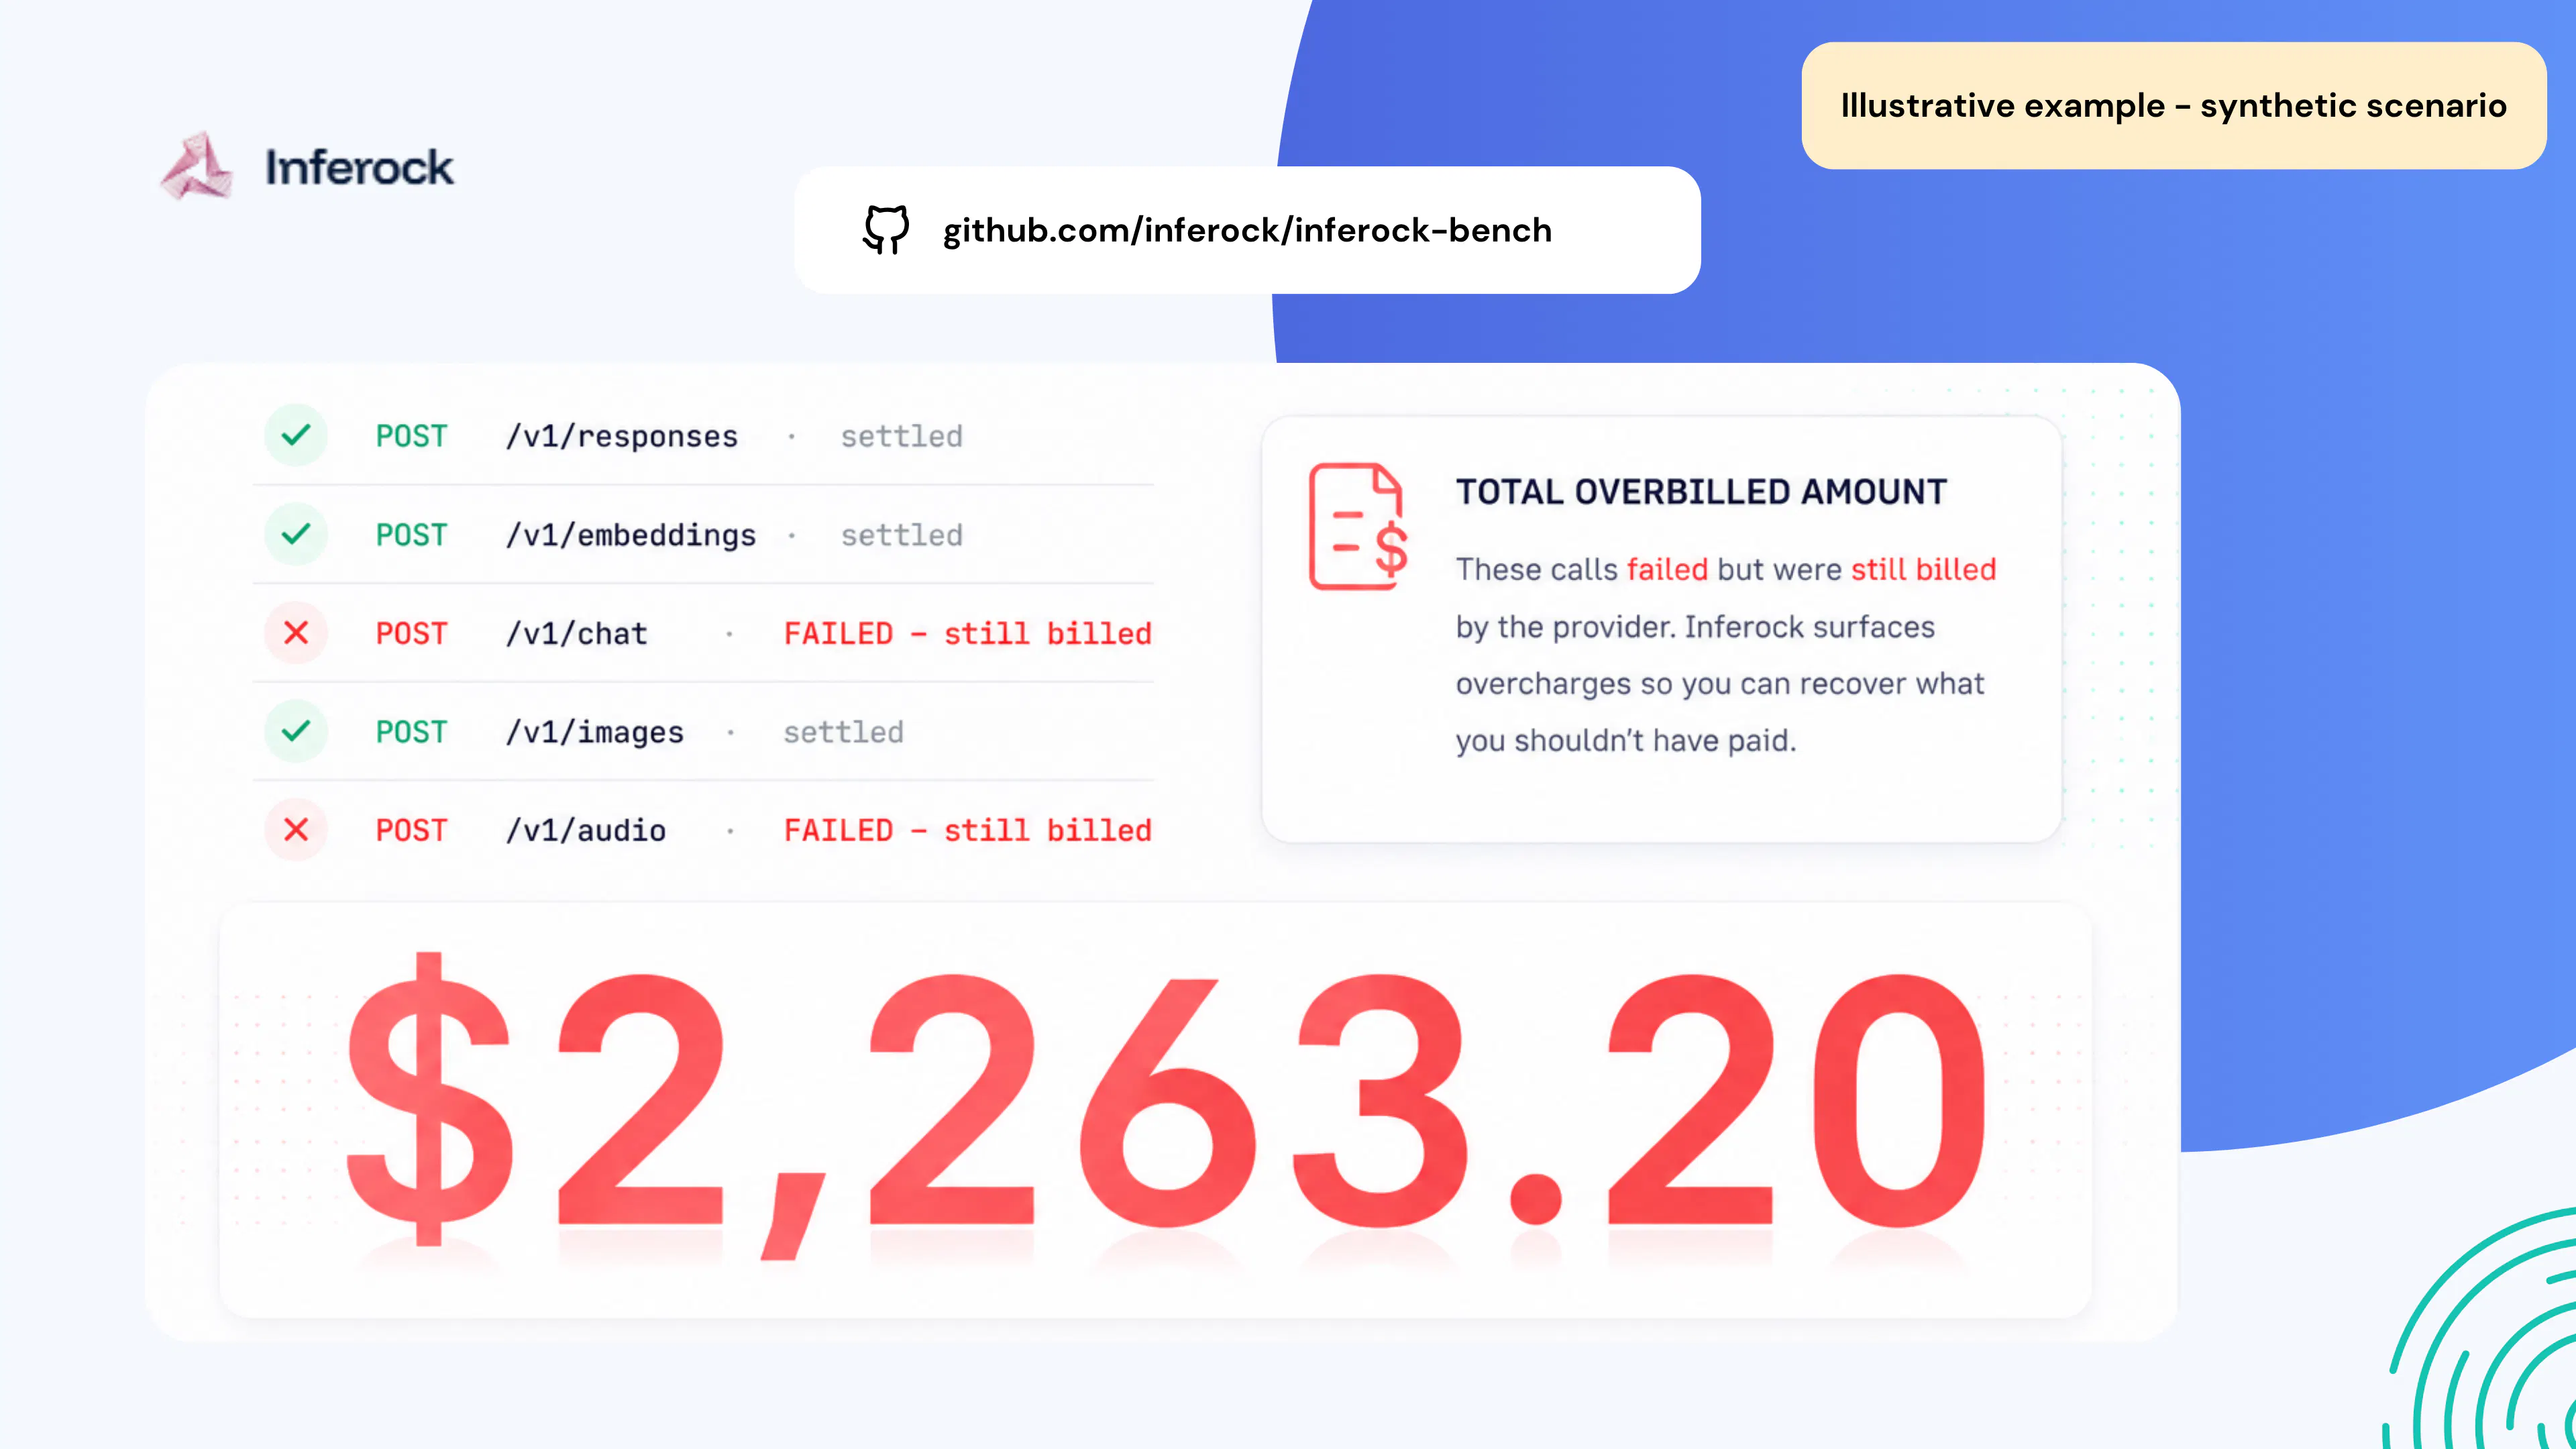
- Answers cut off mid stream that still got billed
- Empty replies with billed tokens attached
- Token counts that don't match visible output
- Retries that may have silently doubled a charge
- Cache discounts you may be missing on your invoice
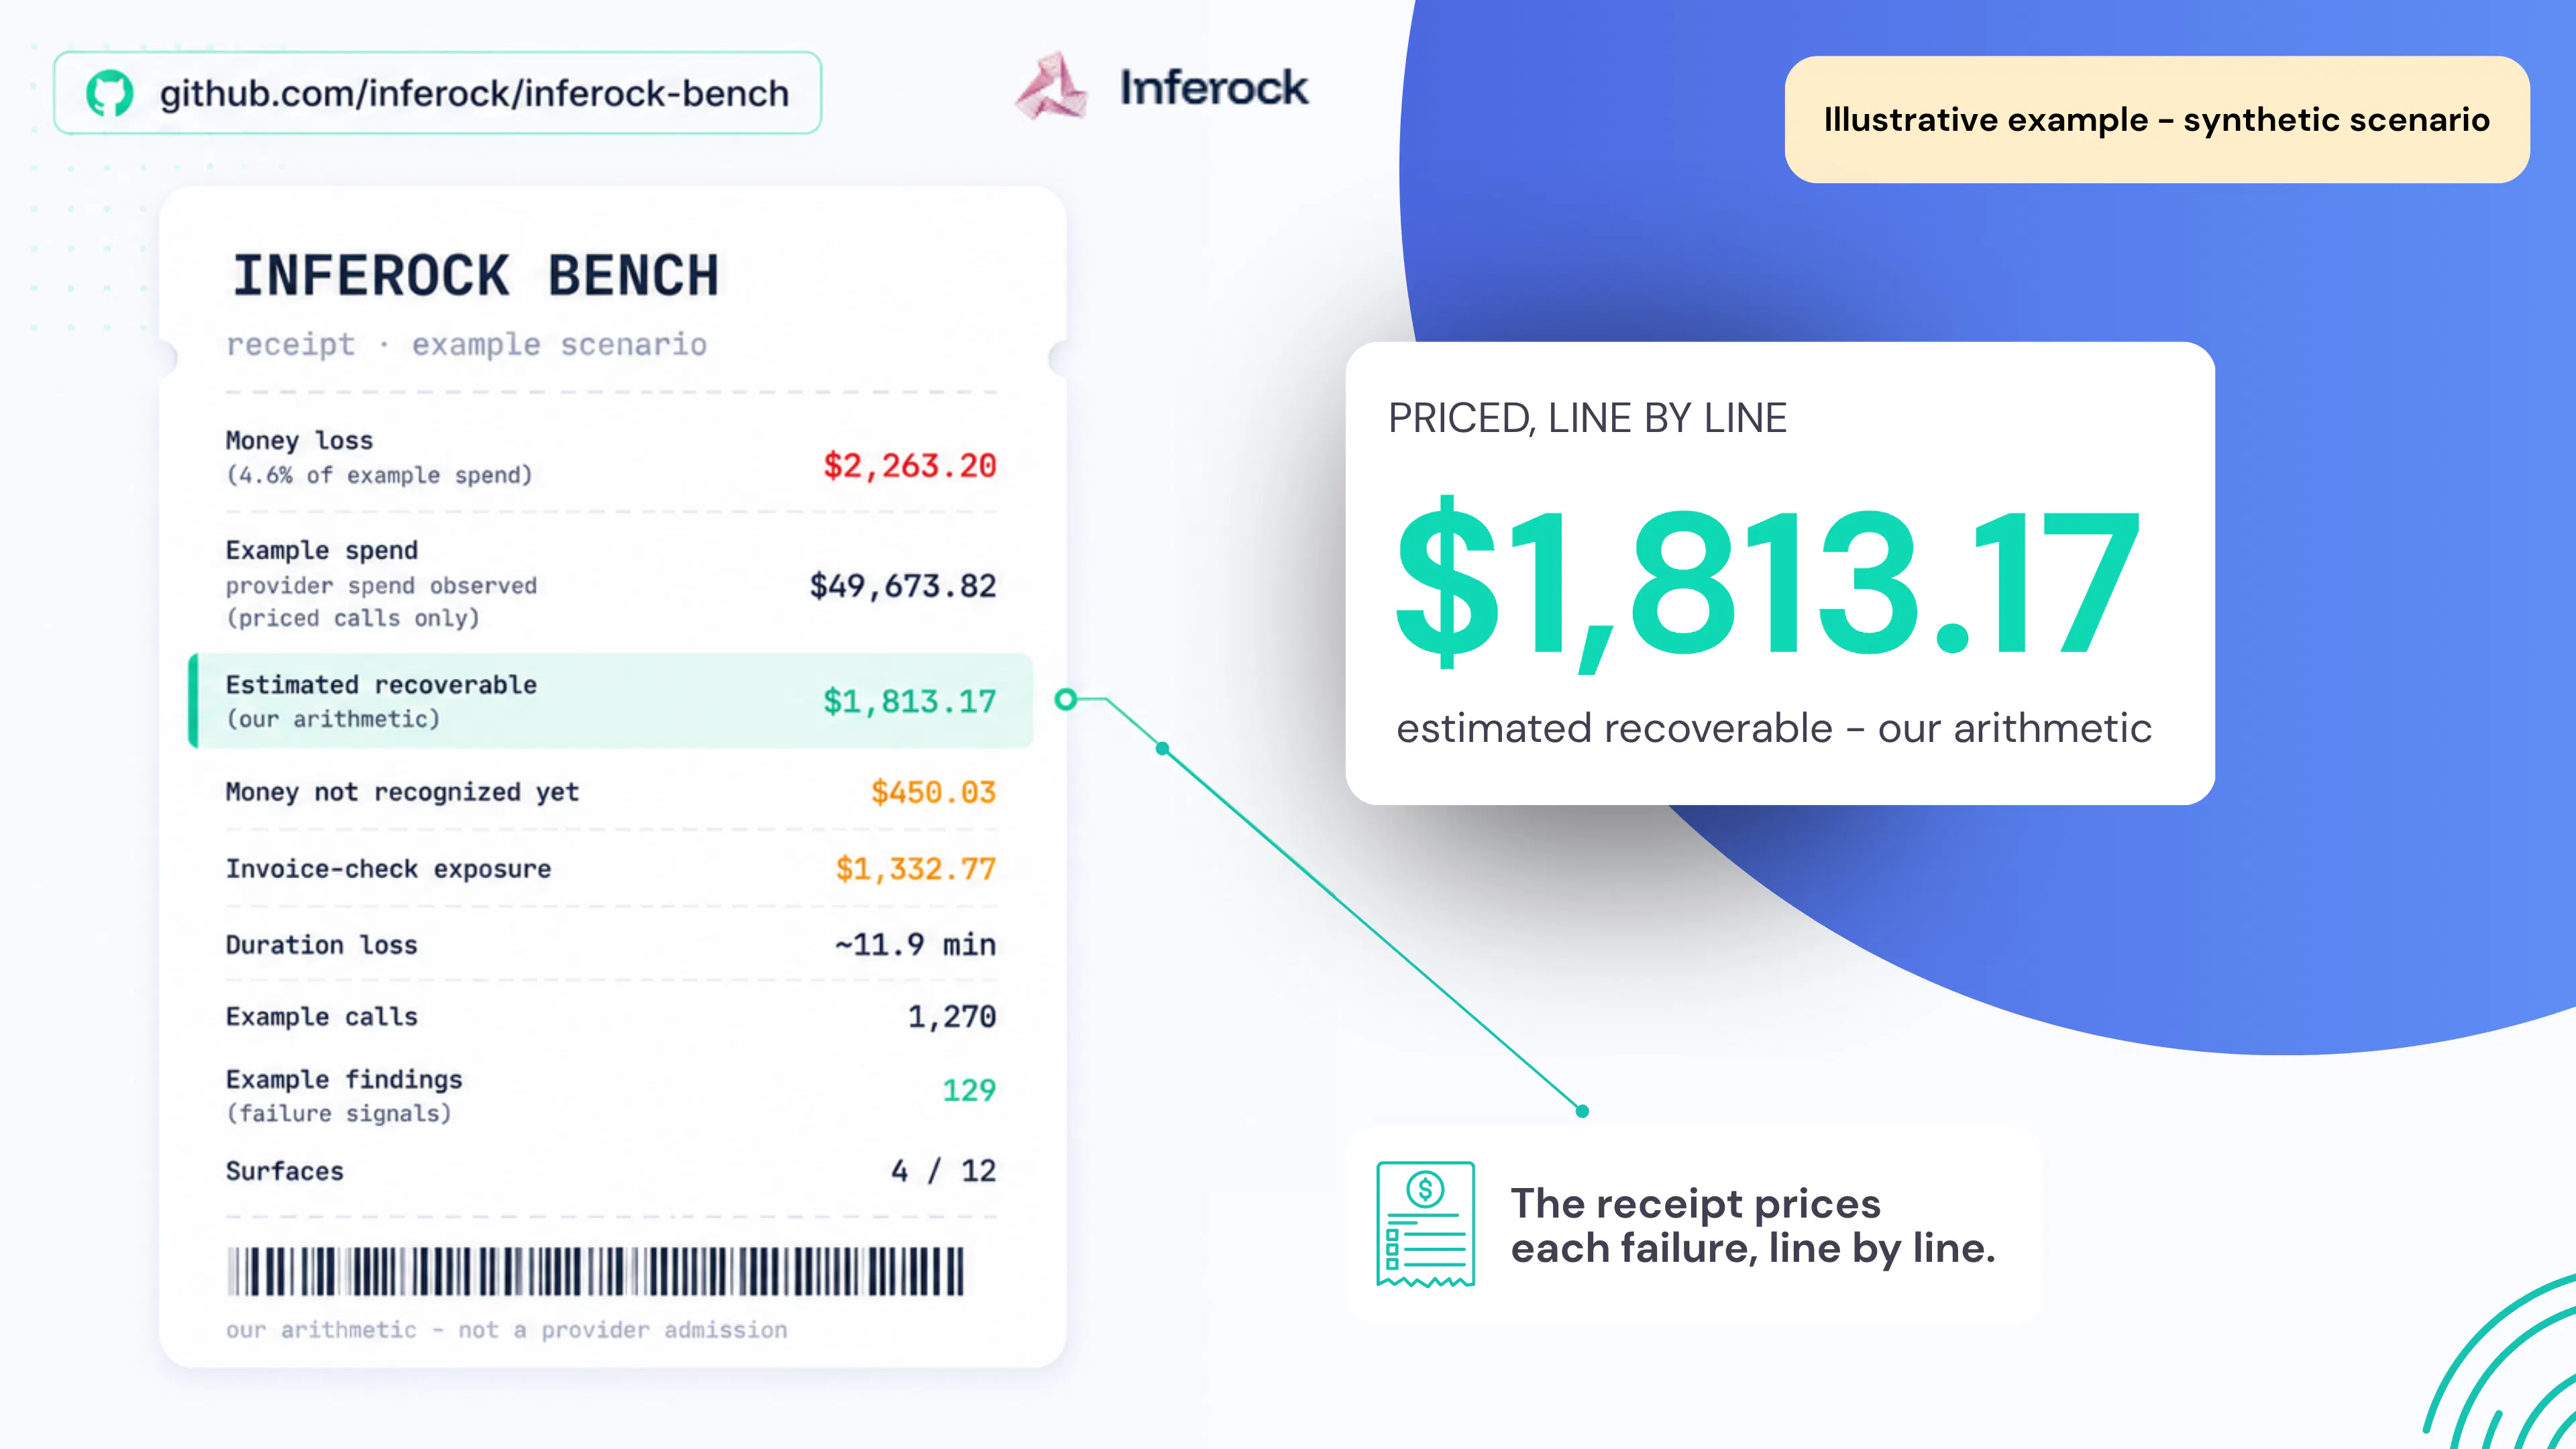
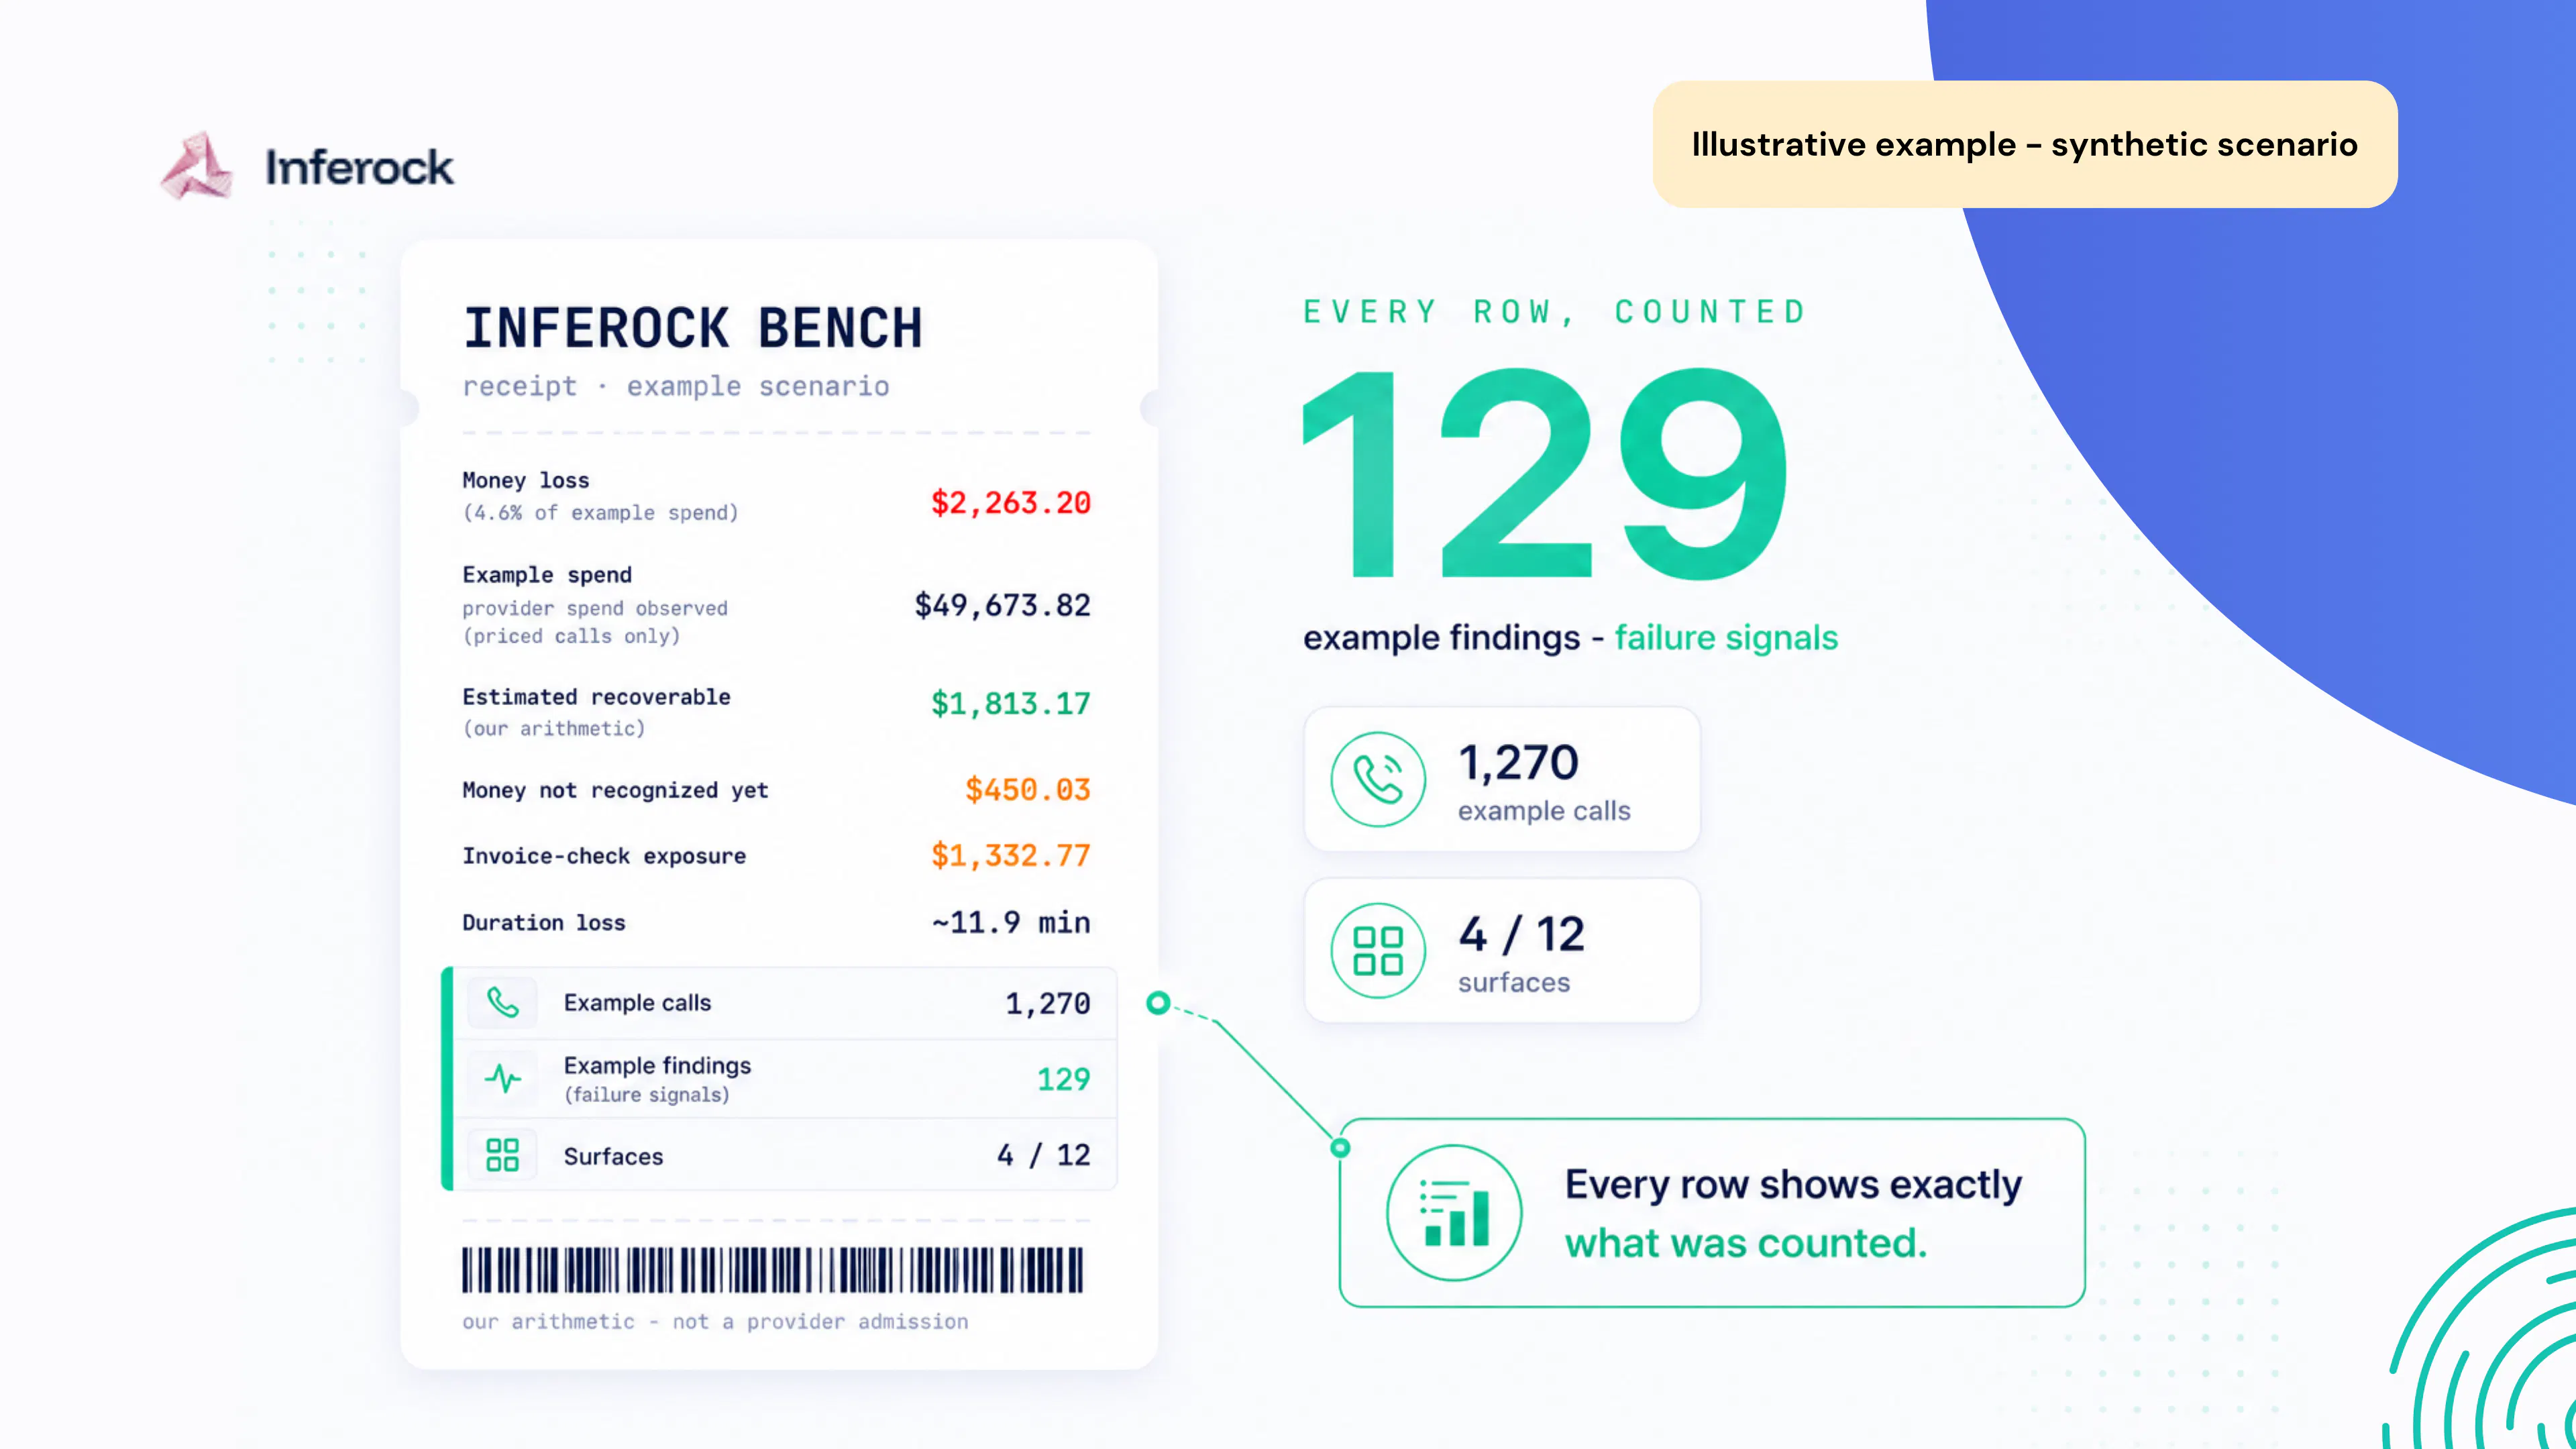
Every run reports a receipt: spend observed, bill-bounded money loss, time loss, and a separate "invoice-check exposure" line that never gets summed into money loss, because we don't want a louder headline at the cost of a weaker claim.
Run it in about a minute: npx inferock-bench
Its open source (FSL-1.1-Apache-2.0, converts to Apache-2.0 in 2 years).
Question for this community: has anyone here actually disputed an AI provider bill and gotten a credit? What worked?
I've been burned by silent retries inflating my OpenAI bill before. Having an independent receipt for that would've saved me a painful invoice conversation.
I like the positioning here, it's not trying to replace the provider's billing system, just verify it. That's a smarter pitch than "cost optimization," which every tool claims.
This is relevant to a problem I've had for months. I run agents that call out to multiple models depending on the task complexity and every so often the bill jumps in a way I can't explain from usage alone. If this can pinpoint whether that's failed calls, redundant retries or just legitimate scaling, I'd finally have an answer instead of a guess.
I like that it works as a local proxy. Keeping billing and usage data on the developer's machine feels like a thoughtful design choice.
The failed-calls and retries breakdown is the part I'd use first. One case I keep hitting might not show up there: a tool call that returns 200 with a silently corrupted value. I measured this on Anthropic models, 40 calls, none flagged the value was wrong, so it bills as a clean success and the retry logic never fires. Can the receipt catch a call that looked fine but wasn't? Or is that out of scope by design?
Congrats on the launch @himashwetha_gowda. Good find @fmerian.
Question regarding accuracy, is it possible it might not be able to distinguish a genuinely billable provider failure from valid hidden token usage, such as reasoning, refusal, cache, or tool-call tokens?
Thanks @fmerian for hunting us. Feel free to ask if anybody has any questions about Inferock Bench.
The retry tracking caught my attention. I’ve seen failed requests become surprisingly expensive, so being able to trace each call would be useful to me.
Love that this sits as a local proxy instead of asking me to route traffic through another cloud service. Keeps my API keys and data where they belong.
What I really want to know is how this handles historical data. Can I feed it a month of past logs and get a retroactive receipt or is it strictly forward-looking from install? I ask because the overspending I'm most curious about already happened and I'd love a way to audit it after the fact.
Tracking retries alongside failures is a smart addition. Those hidden retries can quietly become a big part of the bill.
The retry tracking caught my eye. silent retries are probably one of the easiest ways for API costs to creep up without anyone noticing.
The independent receipt idea is really practical. It's nice to have a way to verify token usage instead of relying only on provider dashboards.
The independent receipt idea is genuinely useful. LLM costs are still surprisingly hard to audit at the individual request level.
Does anyone know of any tools that can work with web-based logins (claud.ai etc)
The bill dispute question is interesting. have you personally managed to get a provider to credit a charge after showing them one of these per call receipts or is that still something you are testing?
The two setting setup makes this feel unusally easy to try.
Which API call actually cost me this money? is a question every AI app eventually needs to answer.
changing the baseURL and apiKey instead of rewriting the application is a nice touch. makes this much easier to test on an existing project.
I like that Inferock Bench focuses on evidence rather than simply showing another dashboard. Having a separate record of every API call could make unexpected billing much easier to investigate.