PH热榜 | 2026-08-16
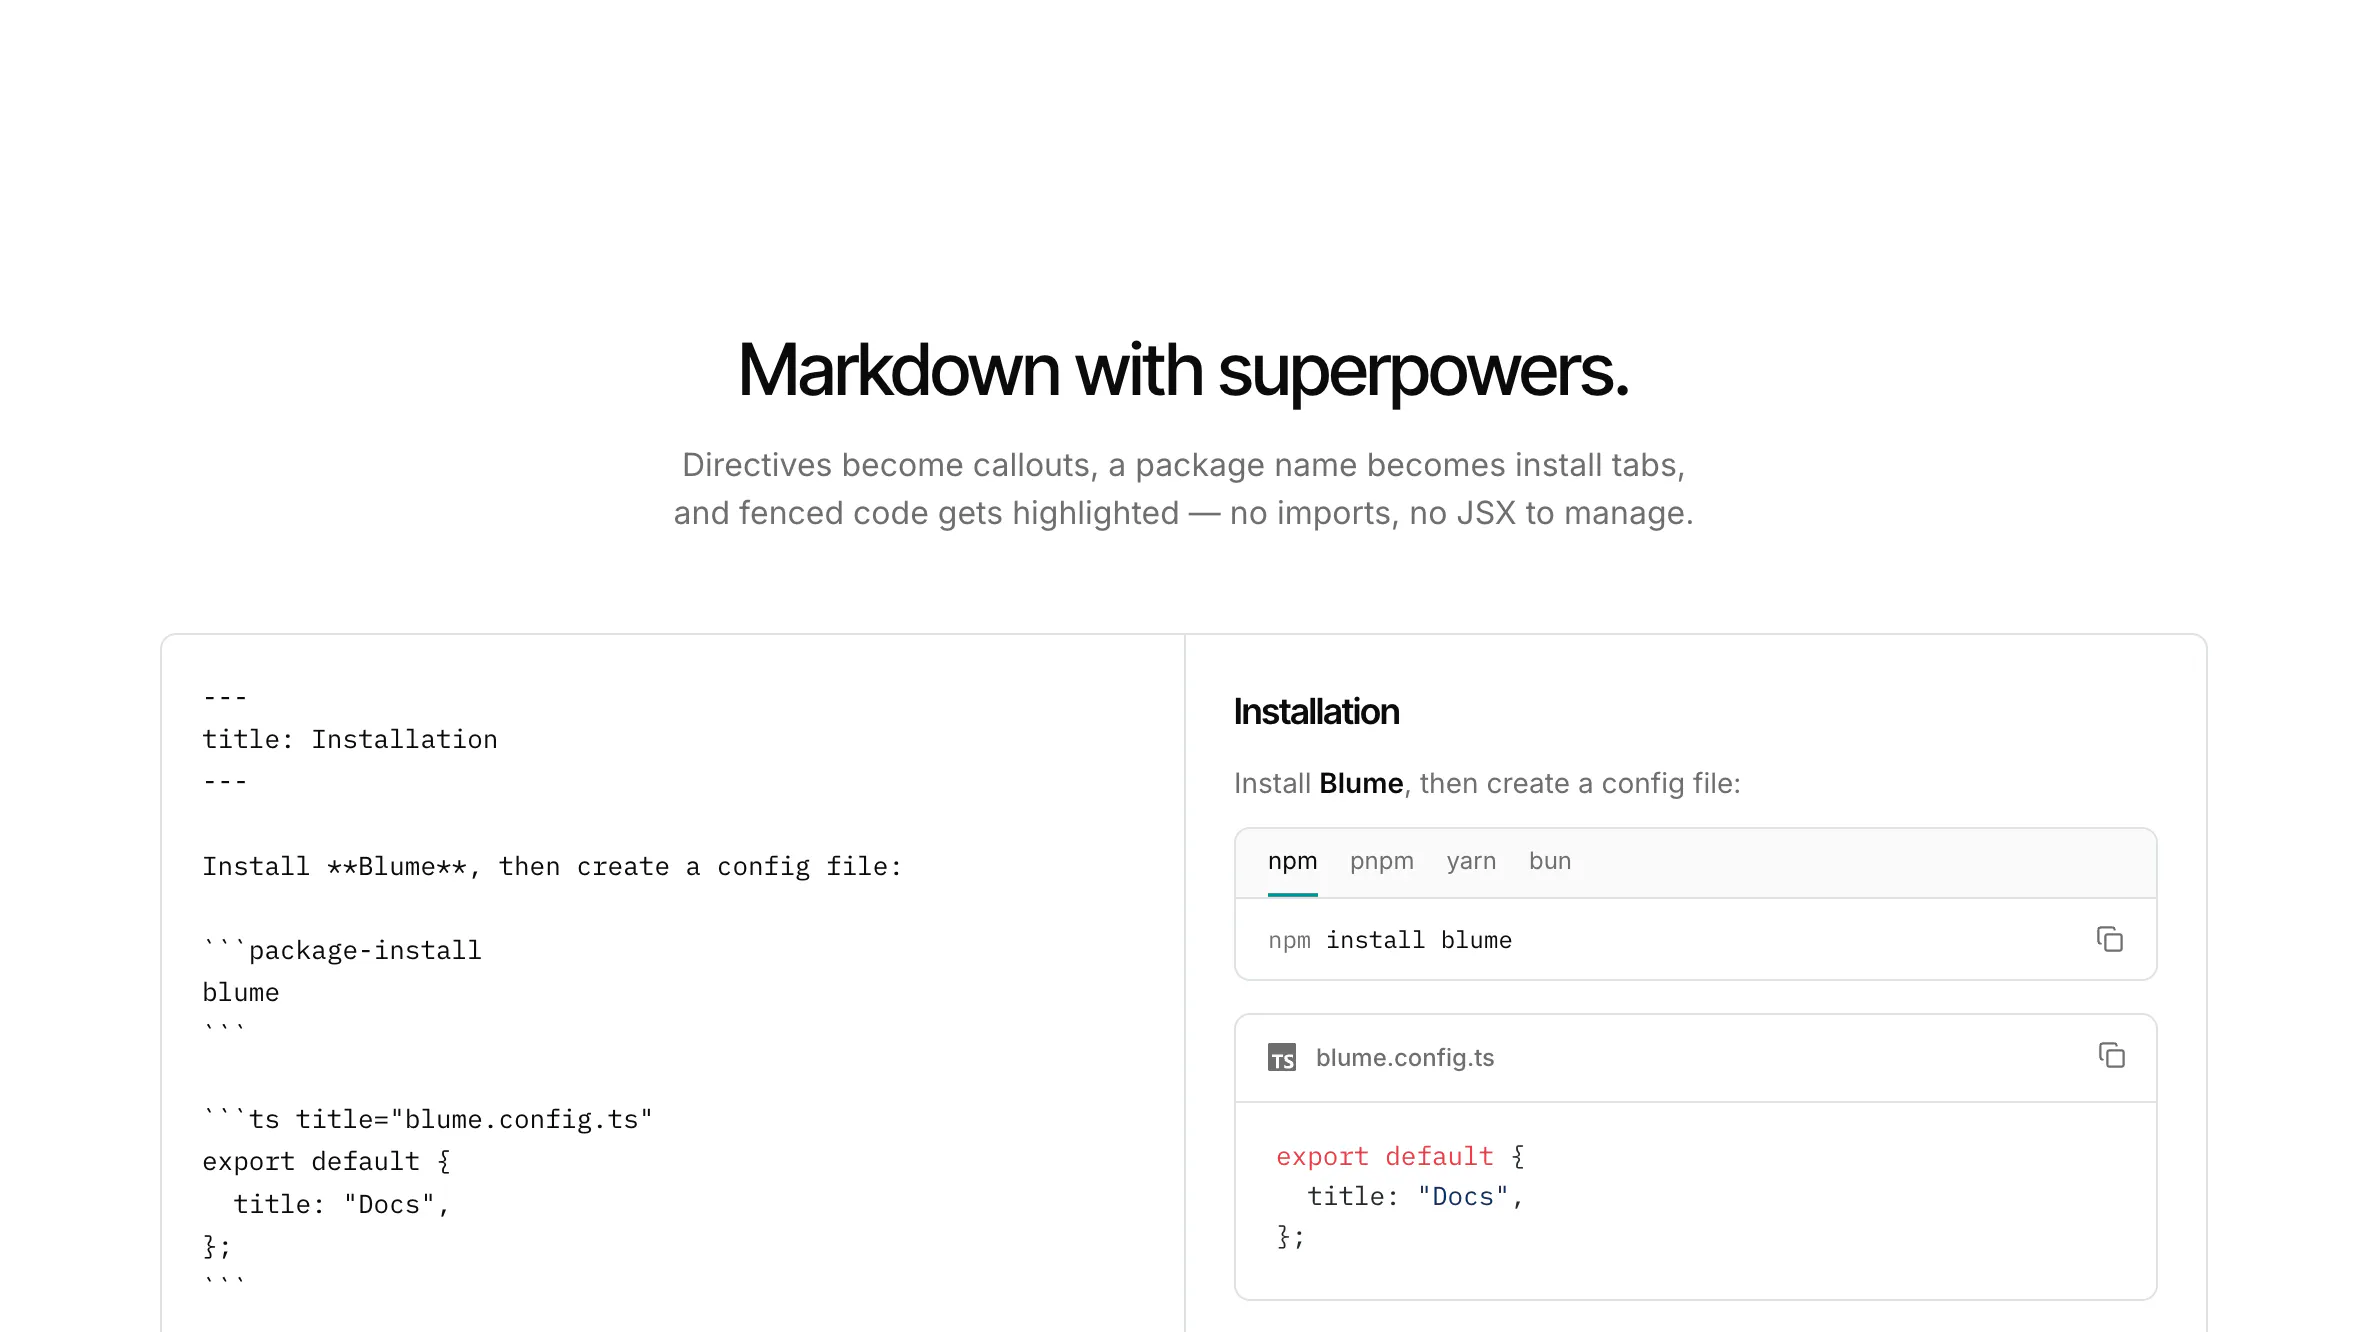
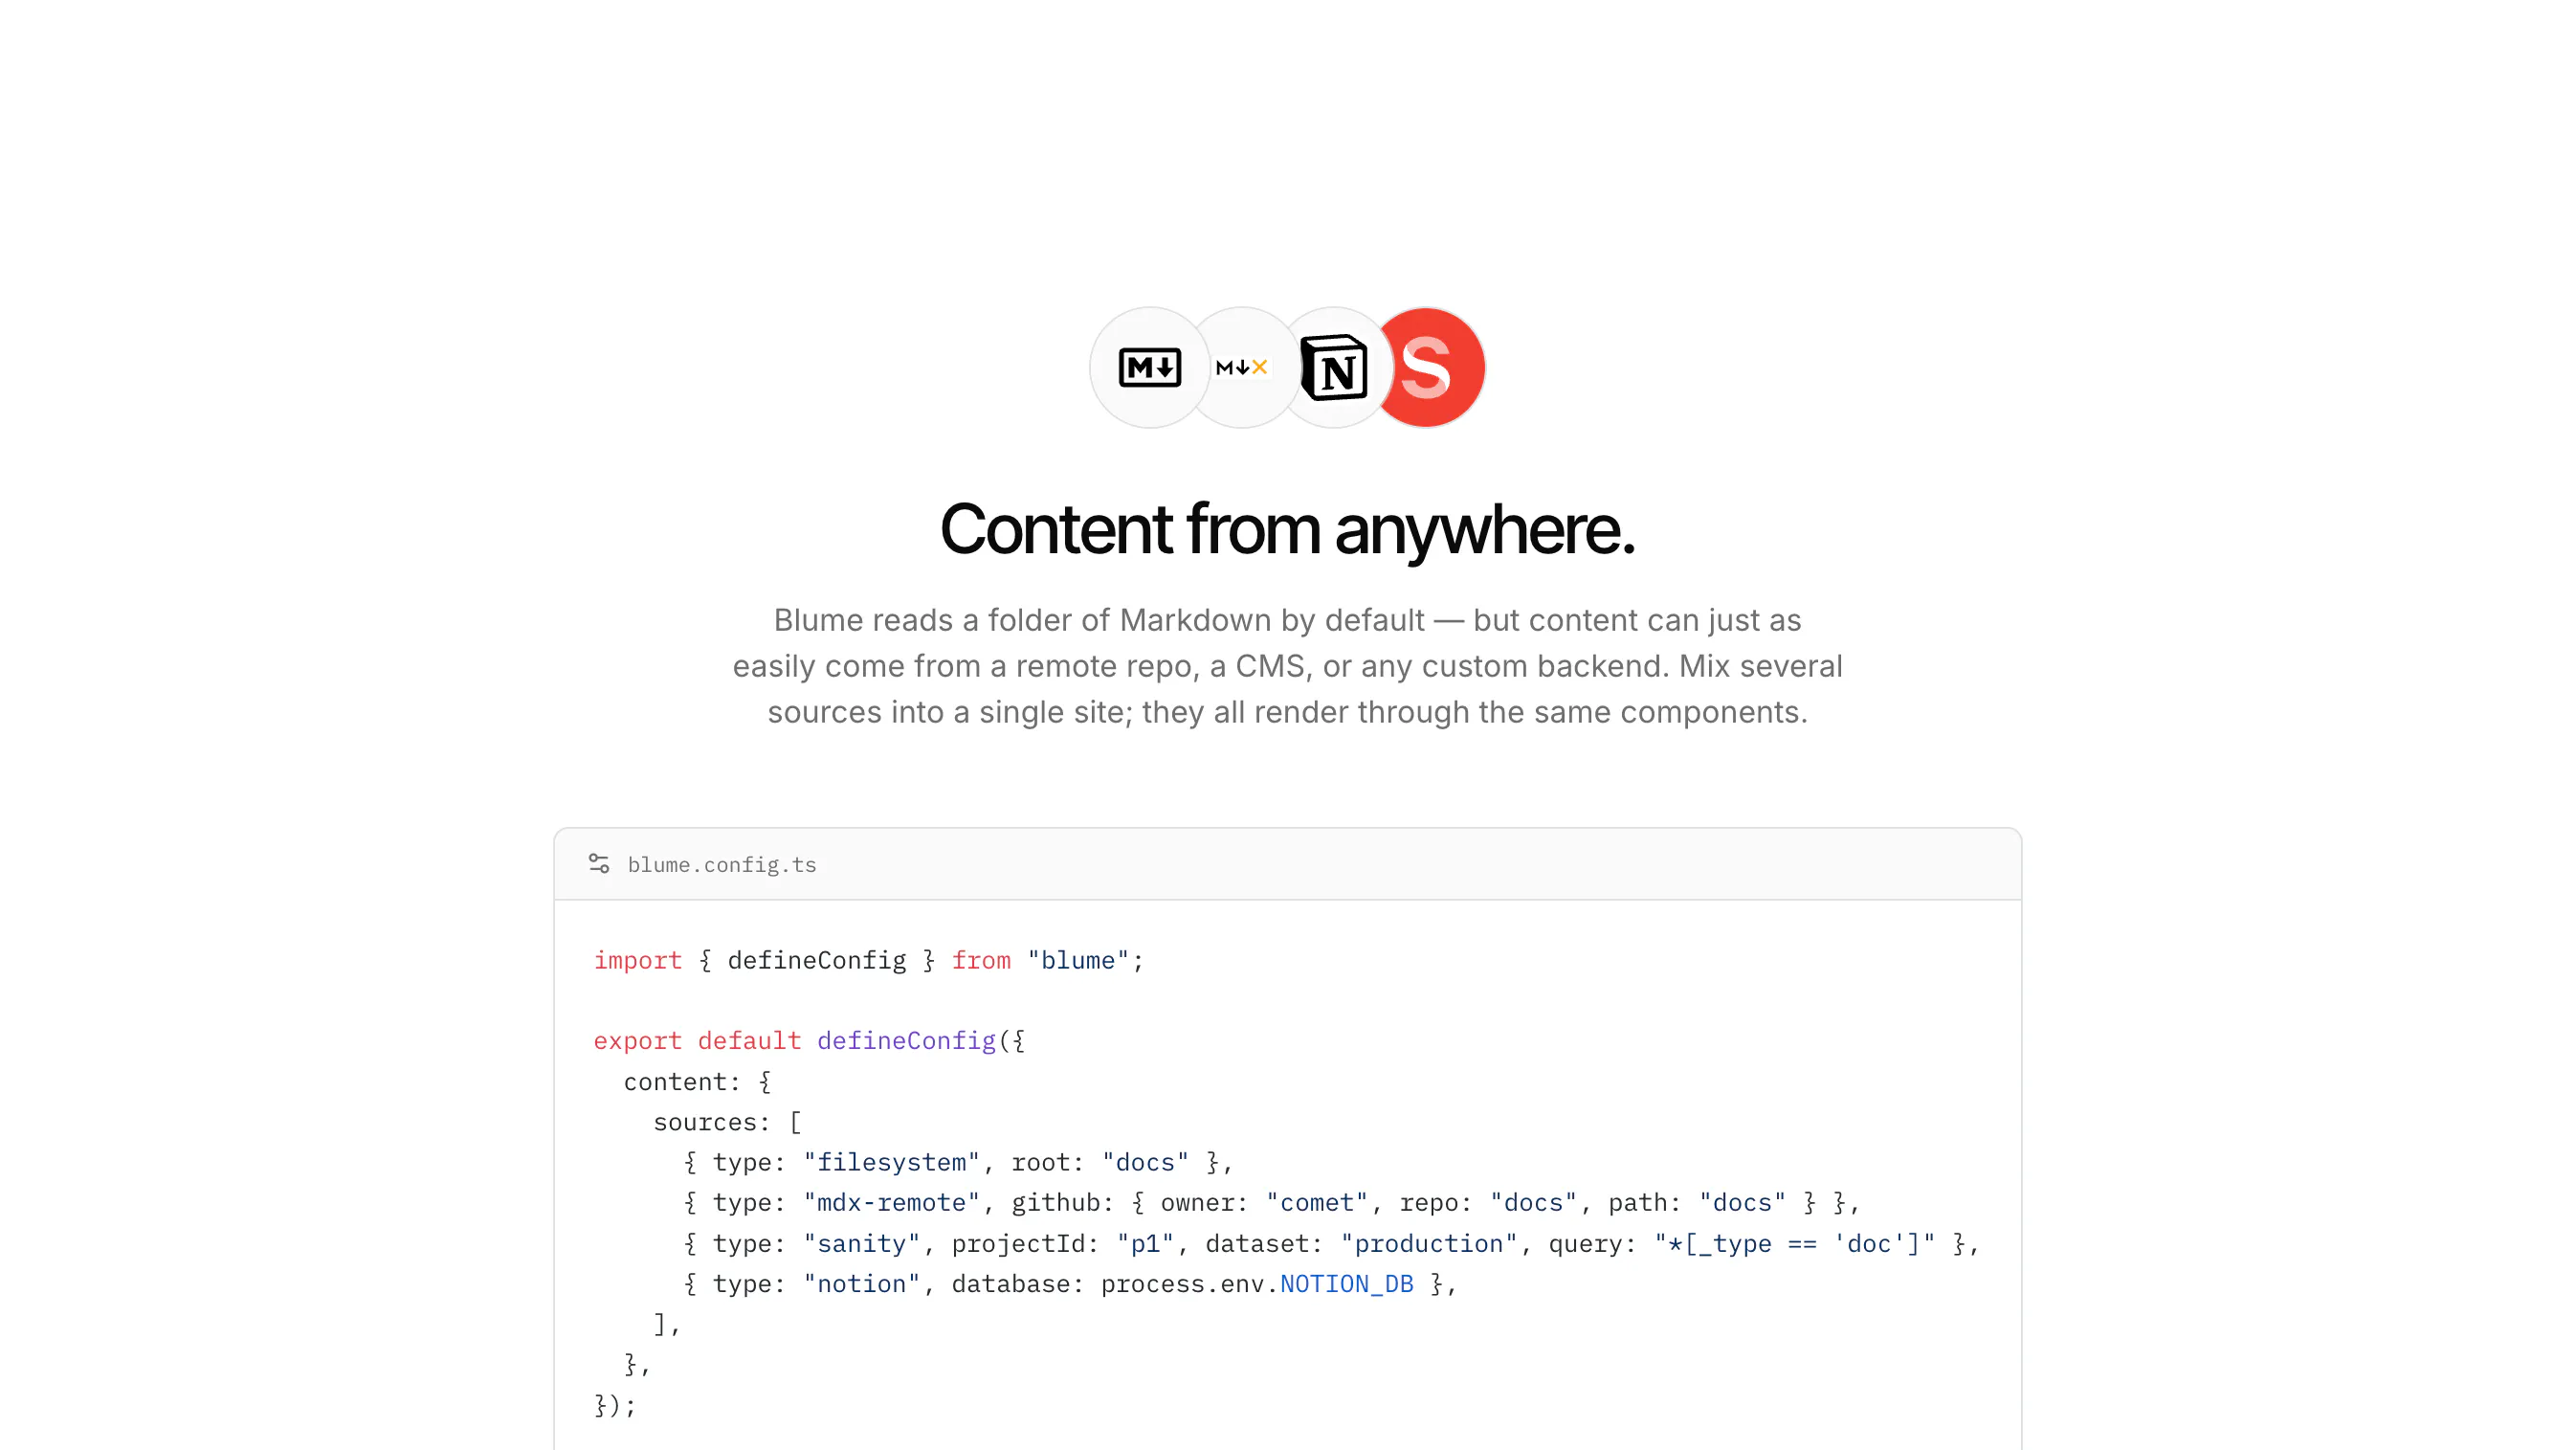
一句话介绍:Blume 是一个基于 Markdown 的文档框架,主打“AI-ready”与零配置部署,帮助开发者快速构建美观、快速、可被 AI 代理高效读取的文档站点,解决传统文档工具在内容结构、部署复杂度和 AI 检索适配上的痛点。
Developer Tools
文档框架
Markdown
AI-ready
开源
零配置
Astro
Vite
开发者工具
SEO
静态站点
用户评论摘要:用户普遍好奇“AI-ready”的具体实现,追问是否内置 llms.txt、结构化输出或 schema。也有人担心文档与API漂移问题,询问是否有校验机制。多数评论表达对作者高产能力的惊叹,部分实测反馈出现空白页问题,整体认可开源替代Mintlify的定位。
AI 锐评
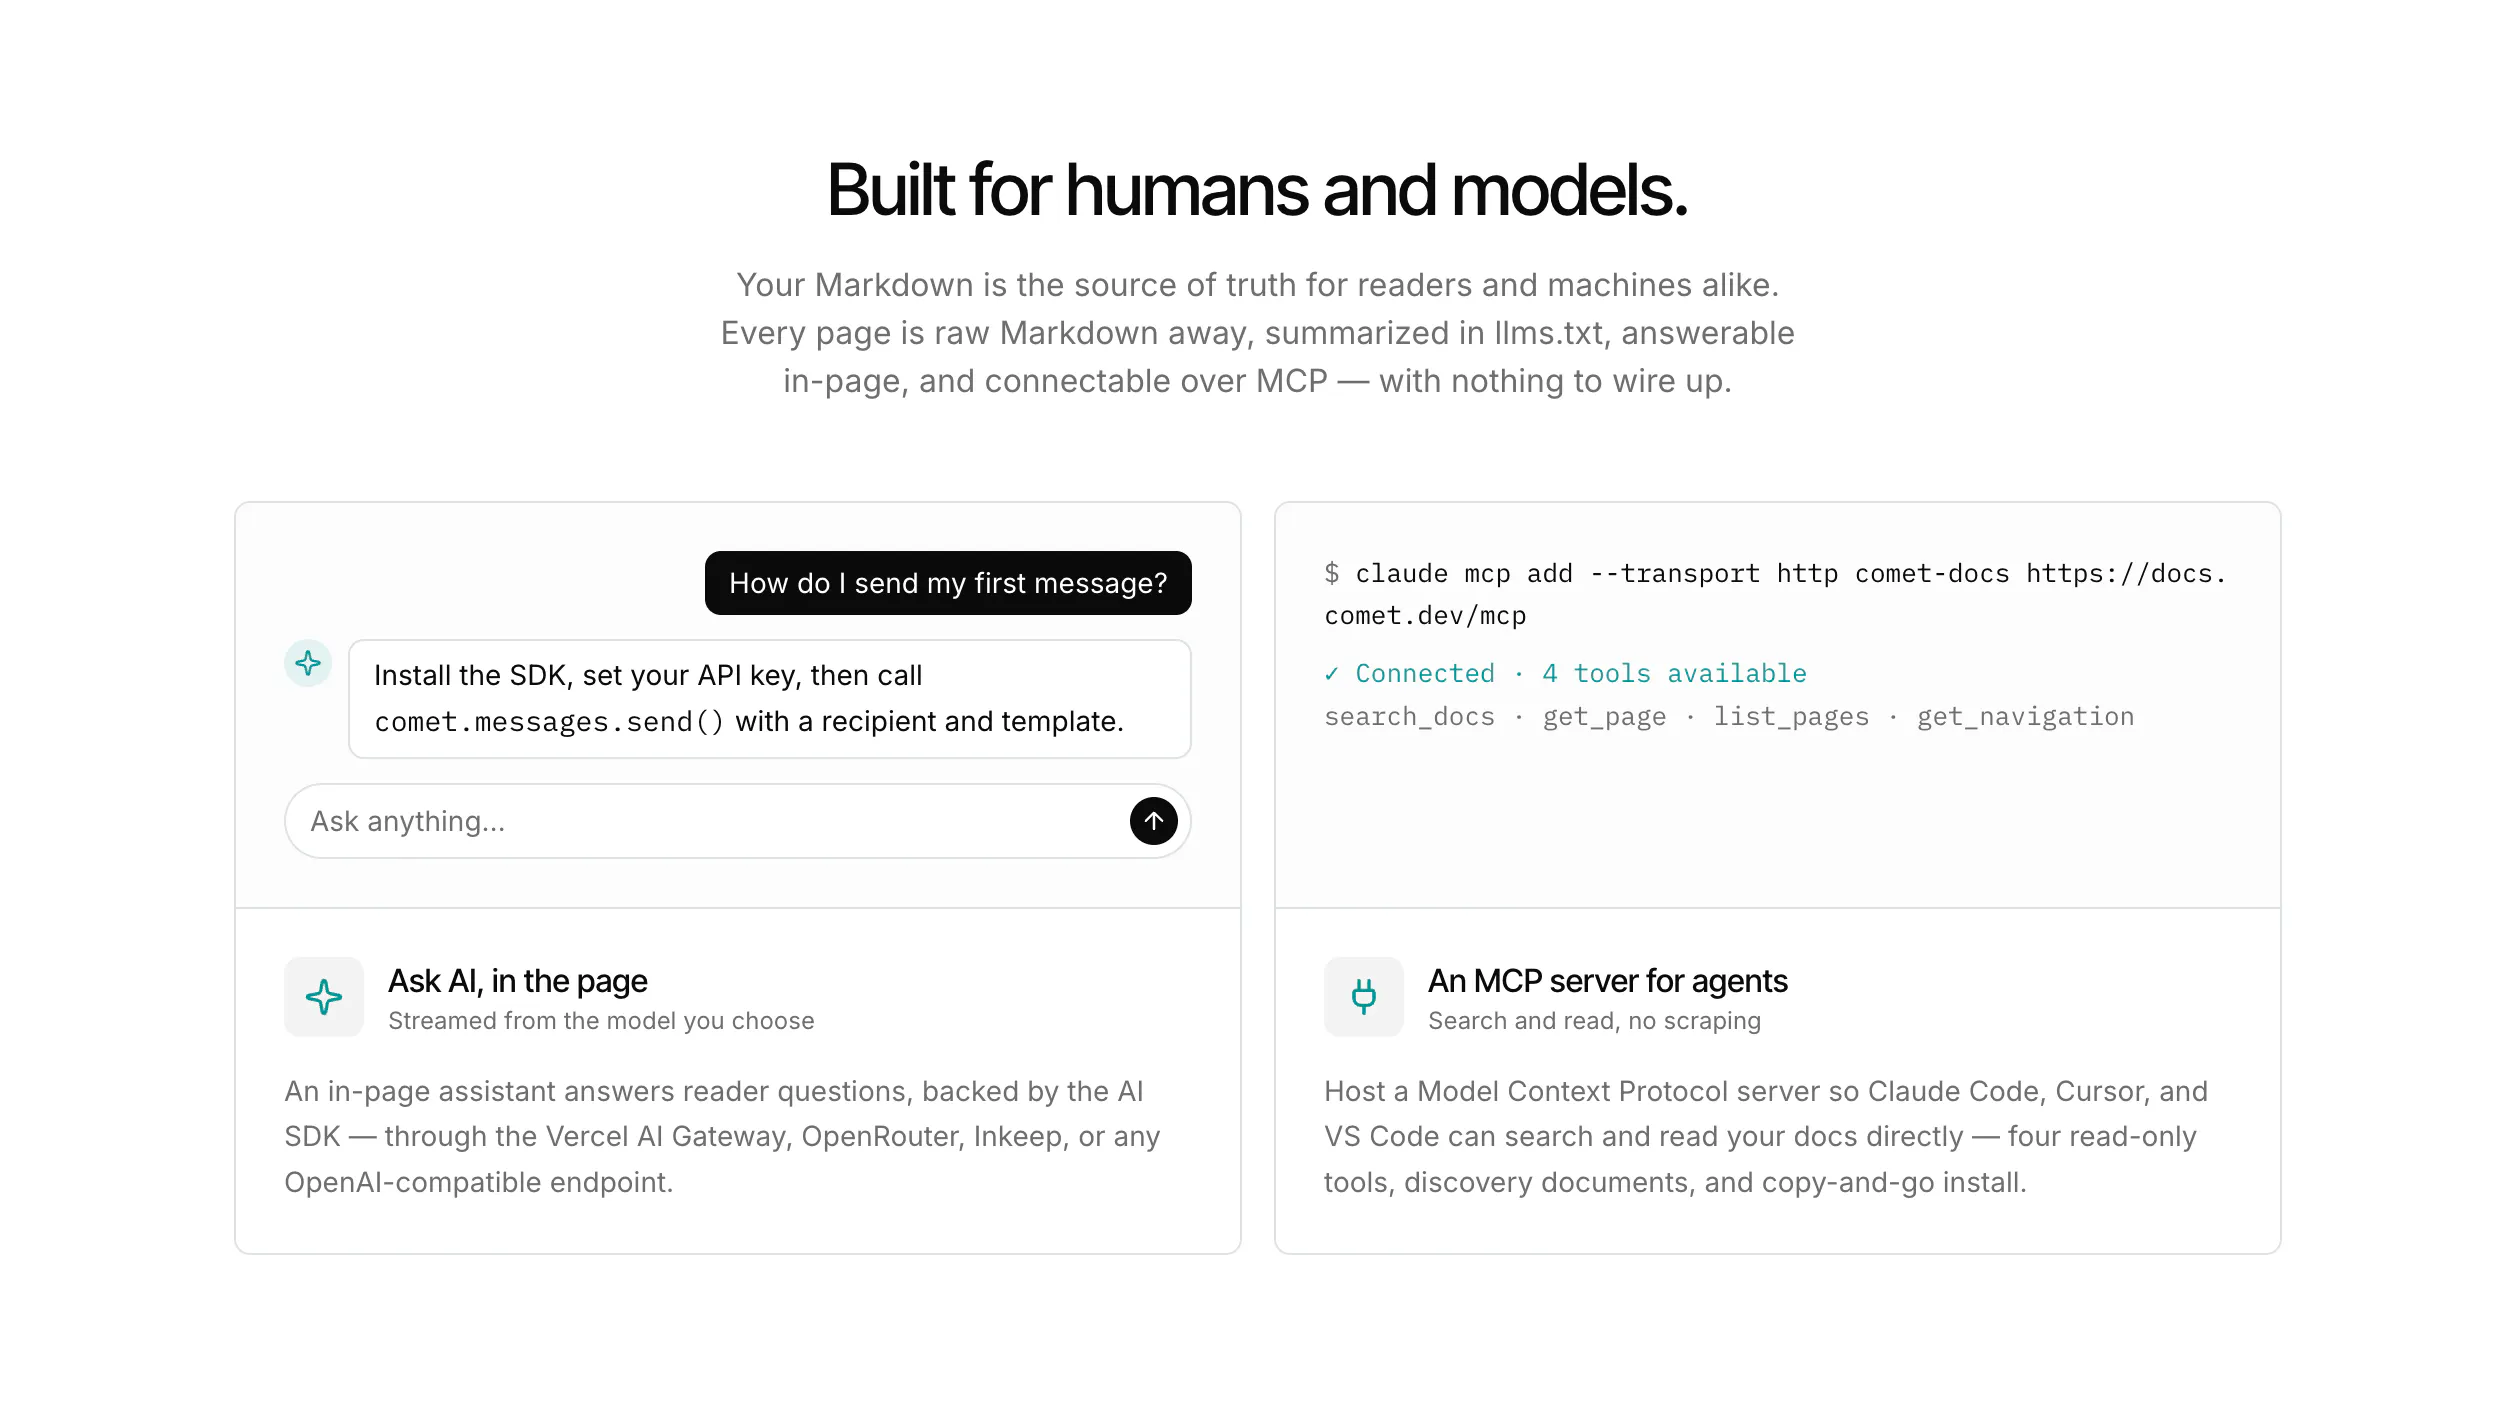
Blume 踩中了两个真实痛点:一是文档工具链的割裂——传统框架要么重配置(Docusaurus),要么闭源且贵(Mintlify),要么AI支持停留在“语义化HTML”这种伪需求;二是LLM应用爆发后,文档不再是给“人”读的,更是给“代理”读的。它用llms.txt、内容协商、MCP服务器等一揽子方案,把“AI-ready”从营销词变成工程配方,这是比“美观和SEO”更硬核的价值主张。
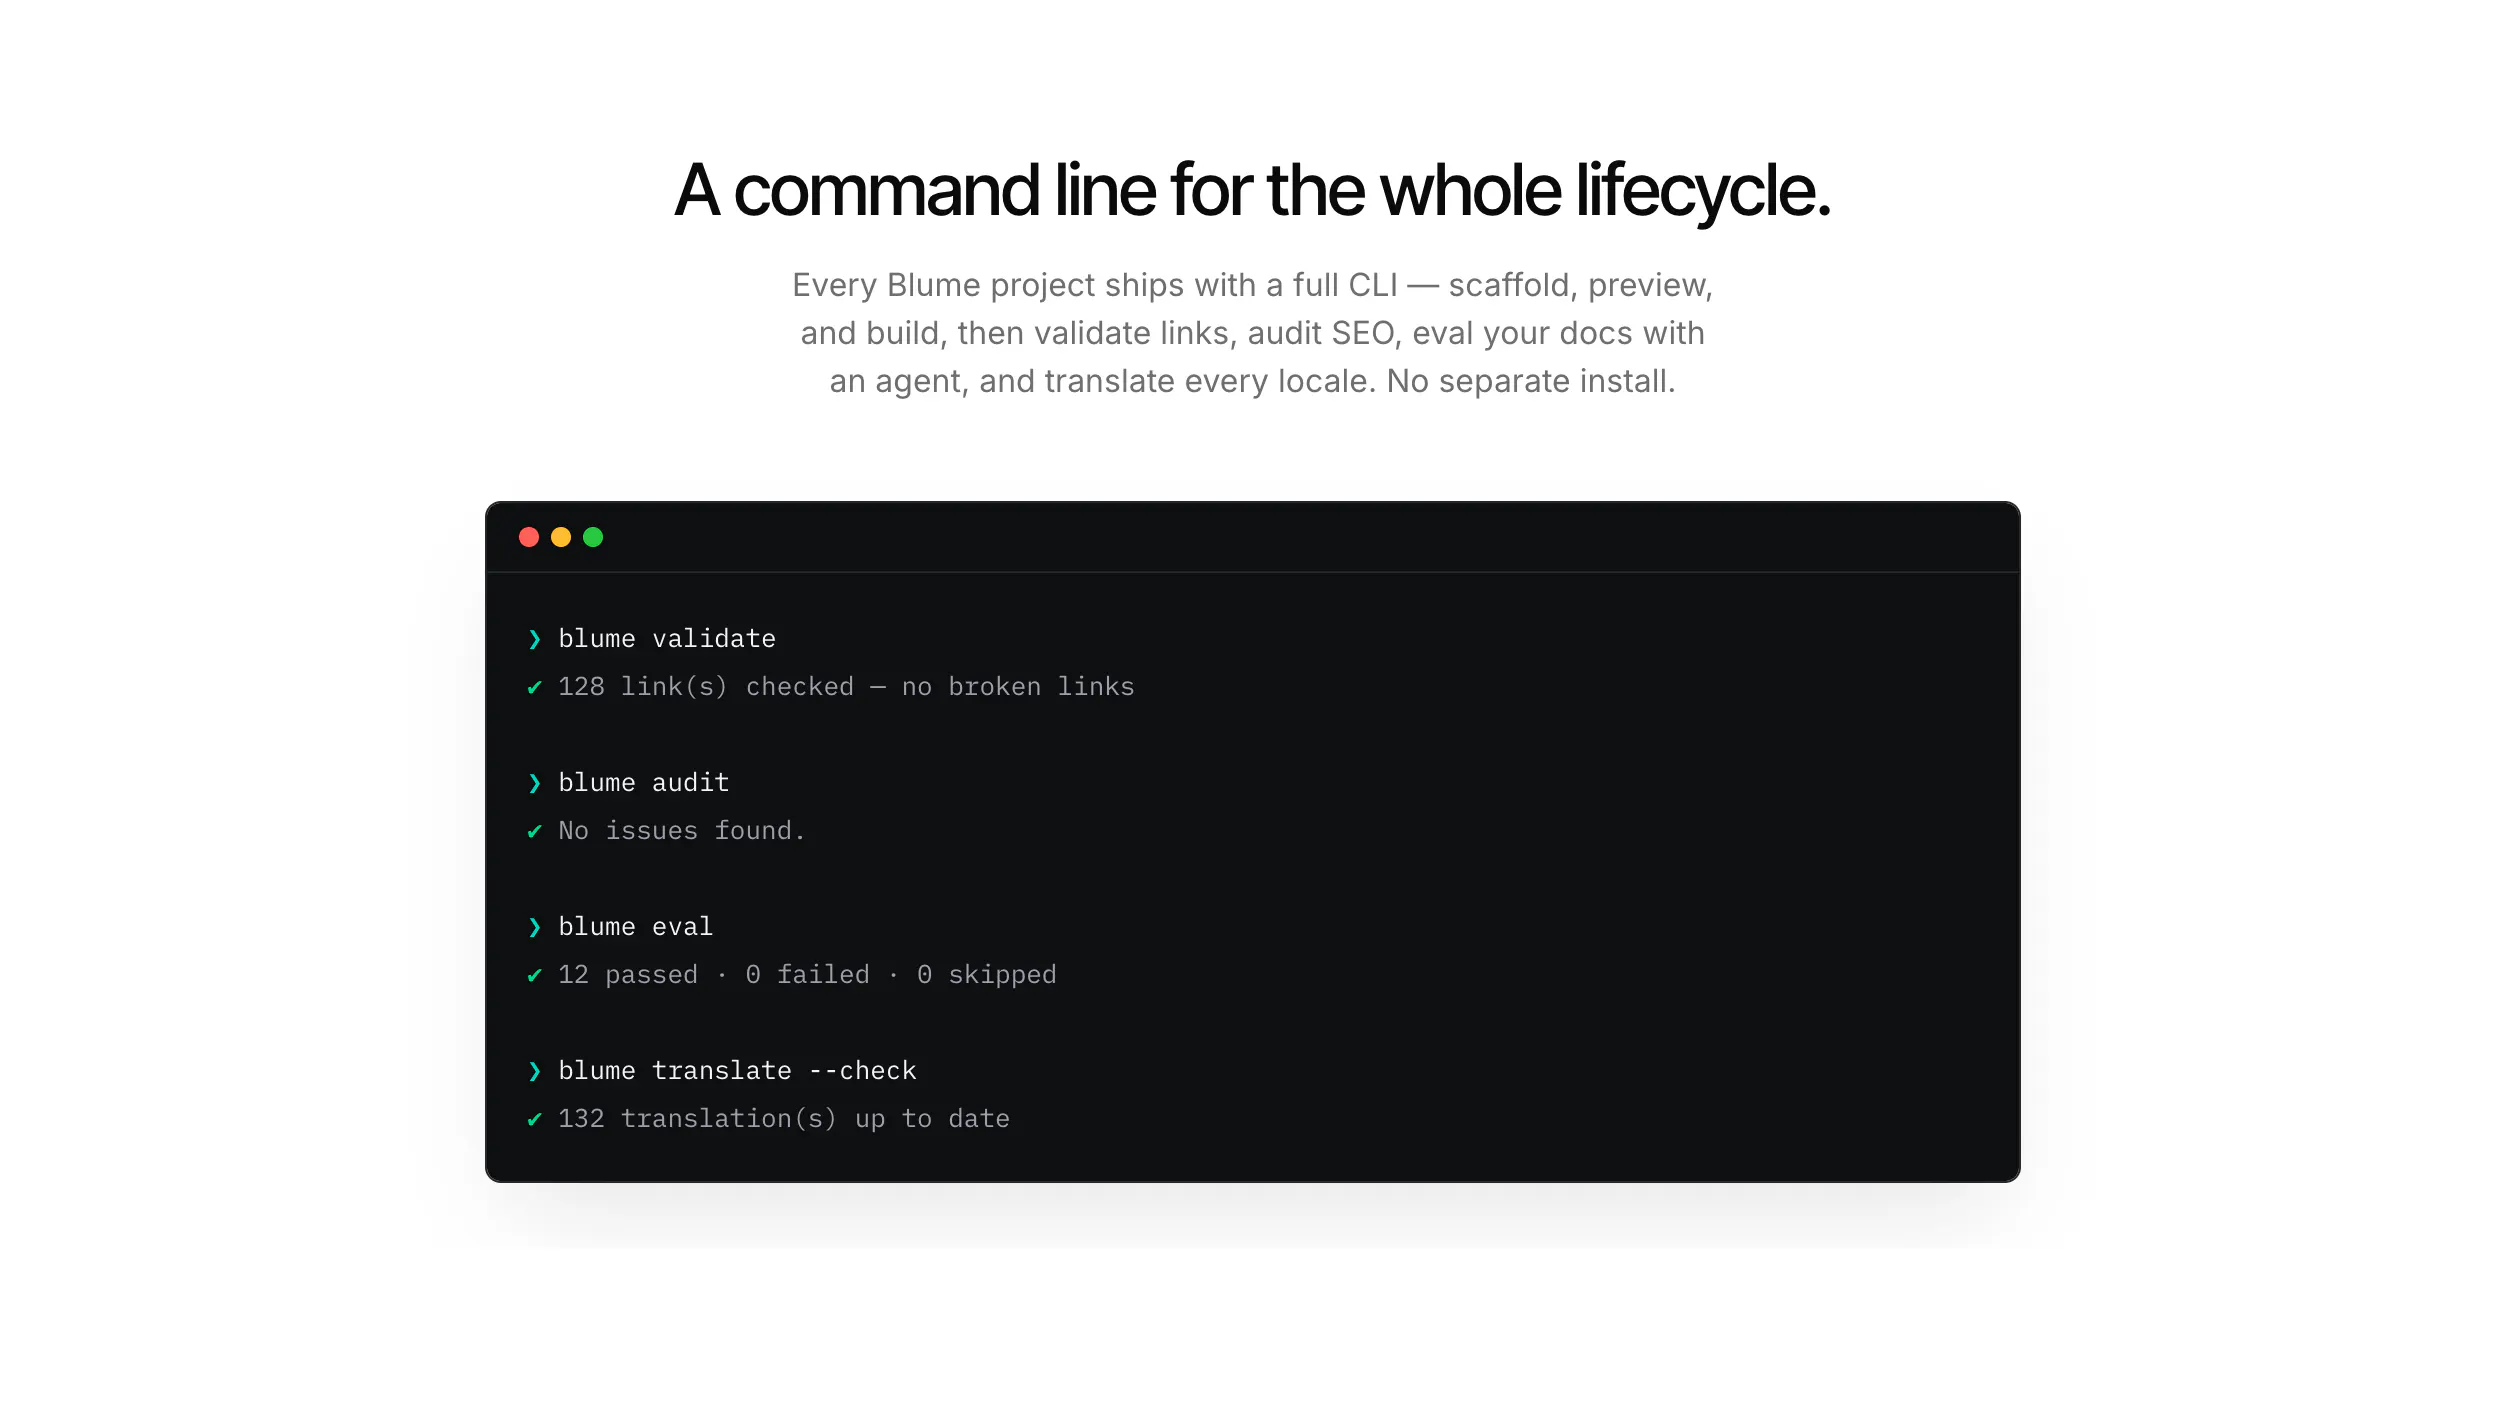
但评论区的质疑同样致命:当用户问“如何检测文档与API漂移”时,回答是“未来用skills弥补”——这暴露了当前版本本质仍是“渲染层”,而非“知识管理层”。AI-ready如果只解决“读取格式”,不解决“内容保鲜”,那顶多算降本,不算提效。另外,零配置是把双刃剑:它牺牲了深度定制能力,一旦用户需要复杂布局或权限控制,会迅速撞墙。开源策略是亮点,但生态尚未成型,插件与主题数量将决定其天花板。
一句话评价:Blume 是文档生成框架里的“性能党+AI原教旨主义者”,值得关注,但别急着把生产环境迁移过去——等它回答完“内容如何与世界同步”这个问题再说。
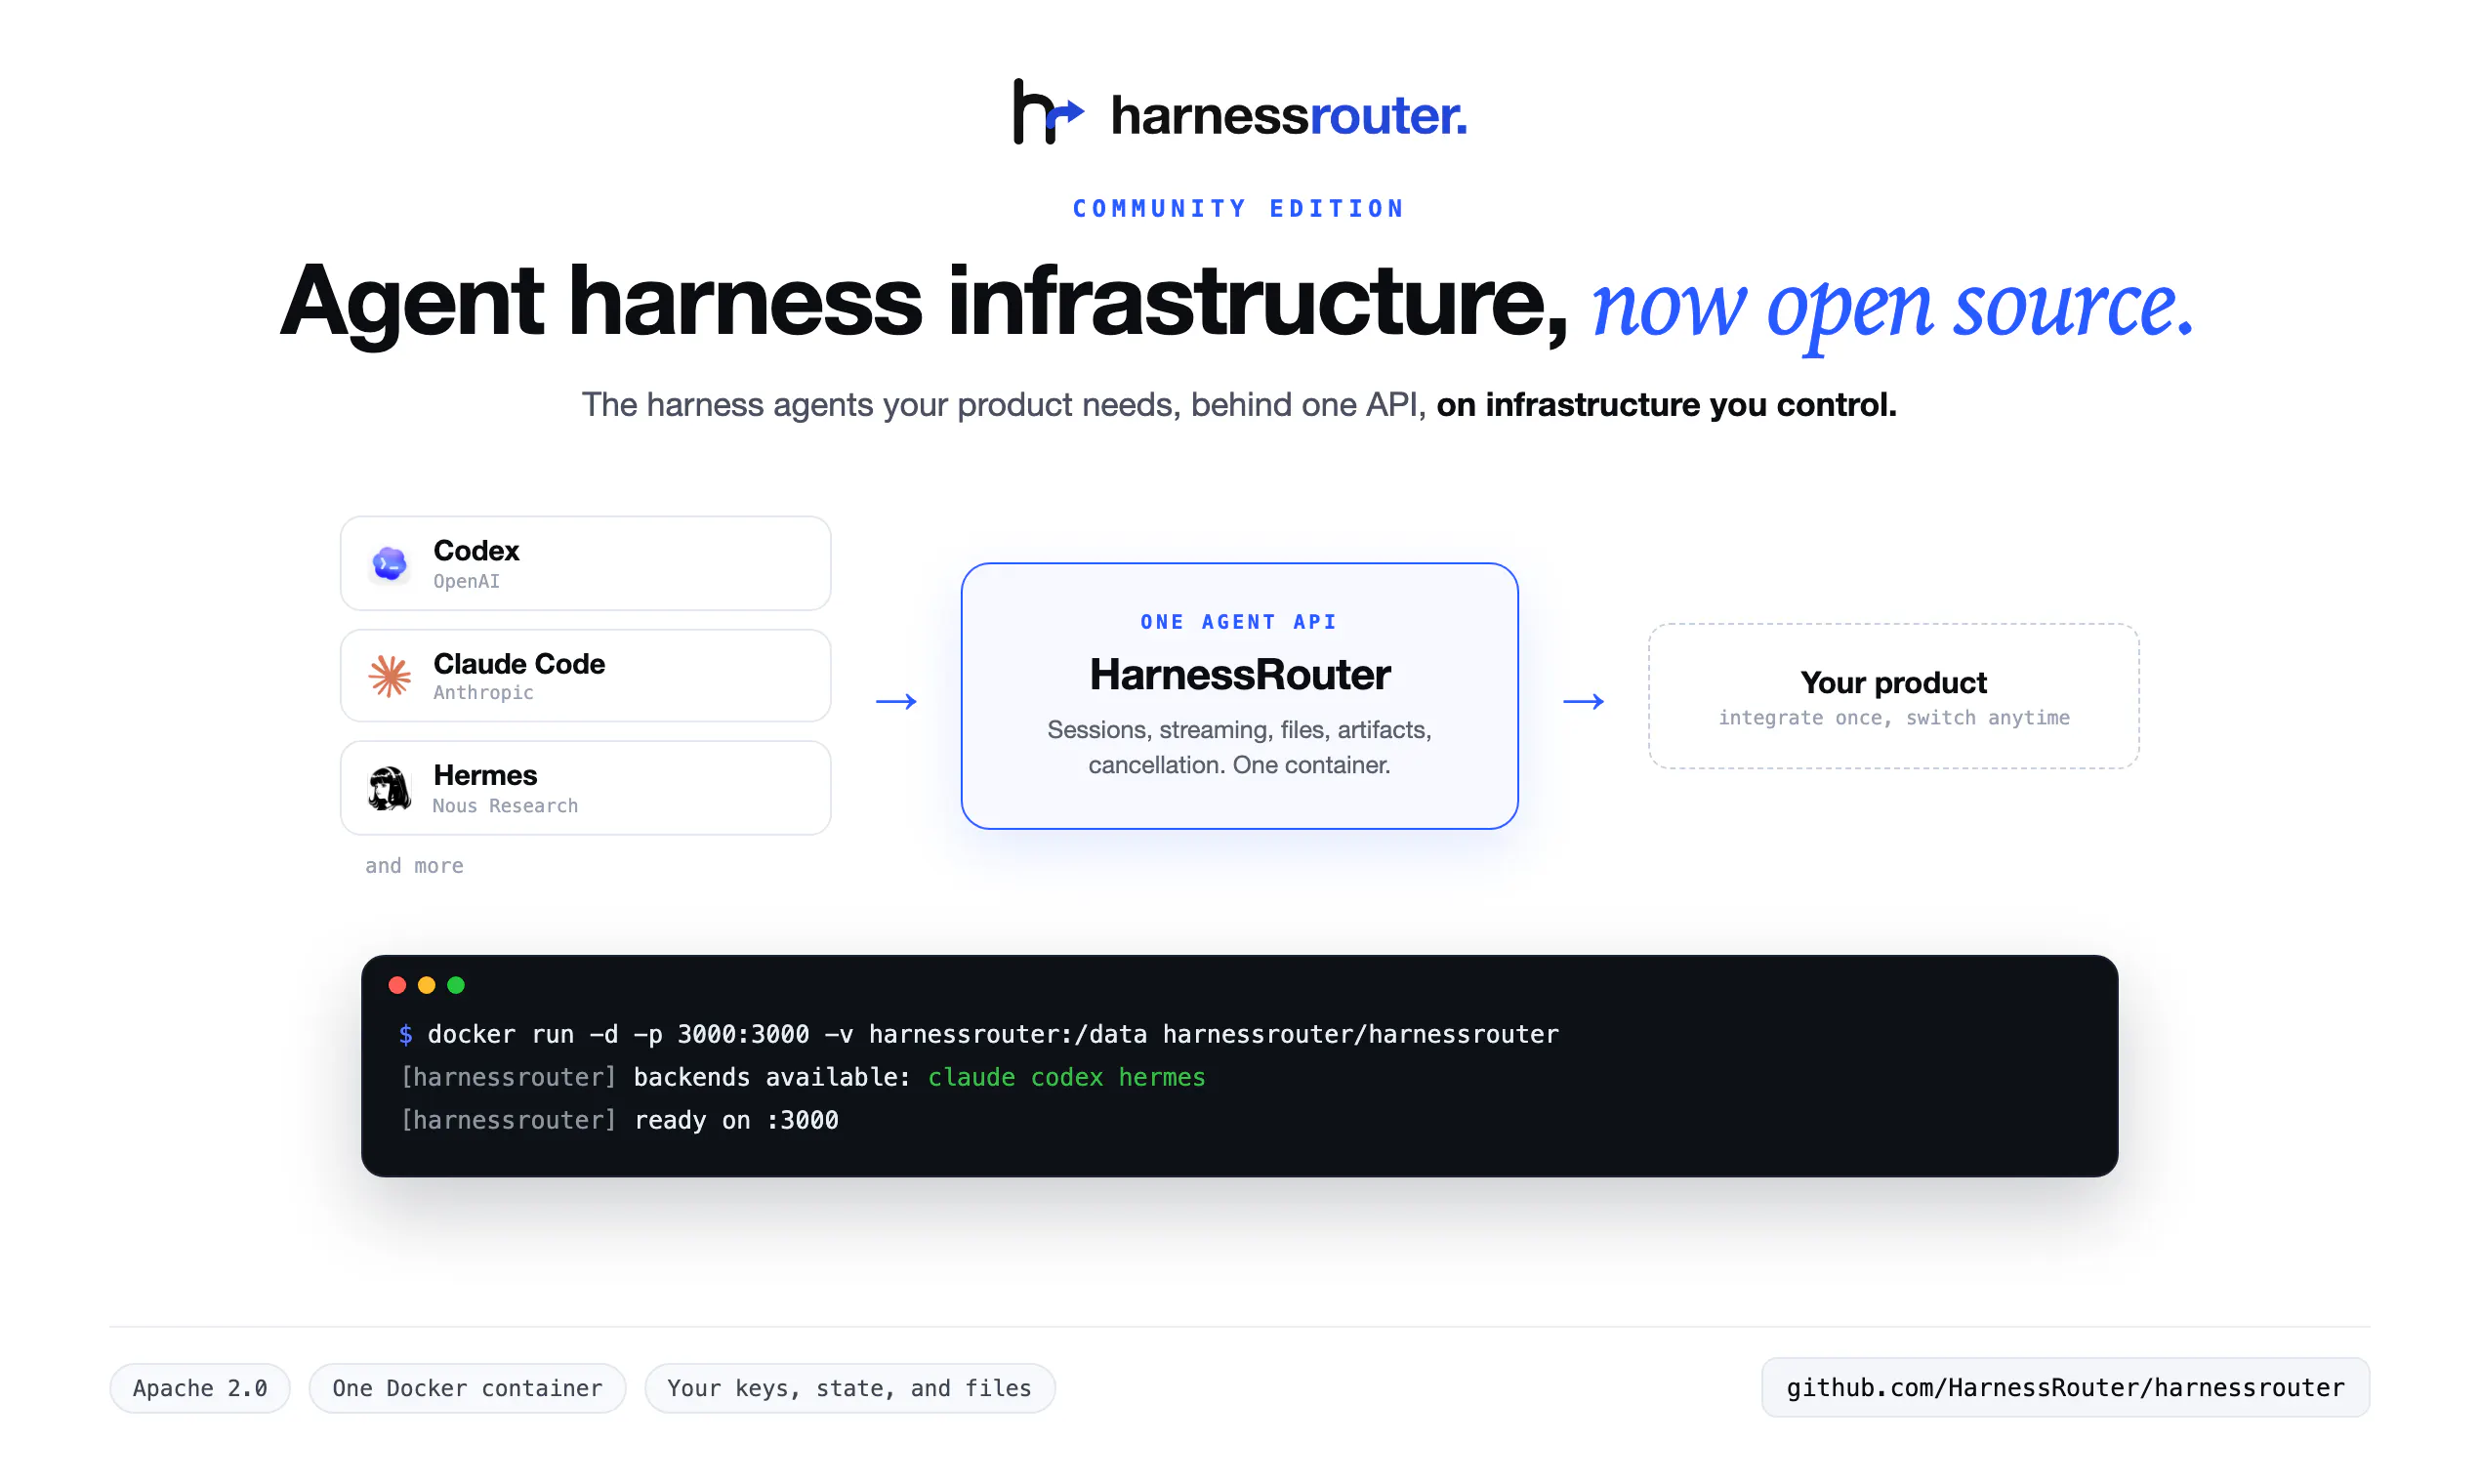
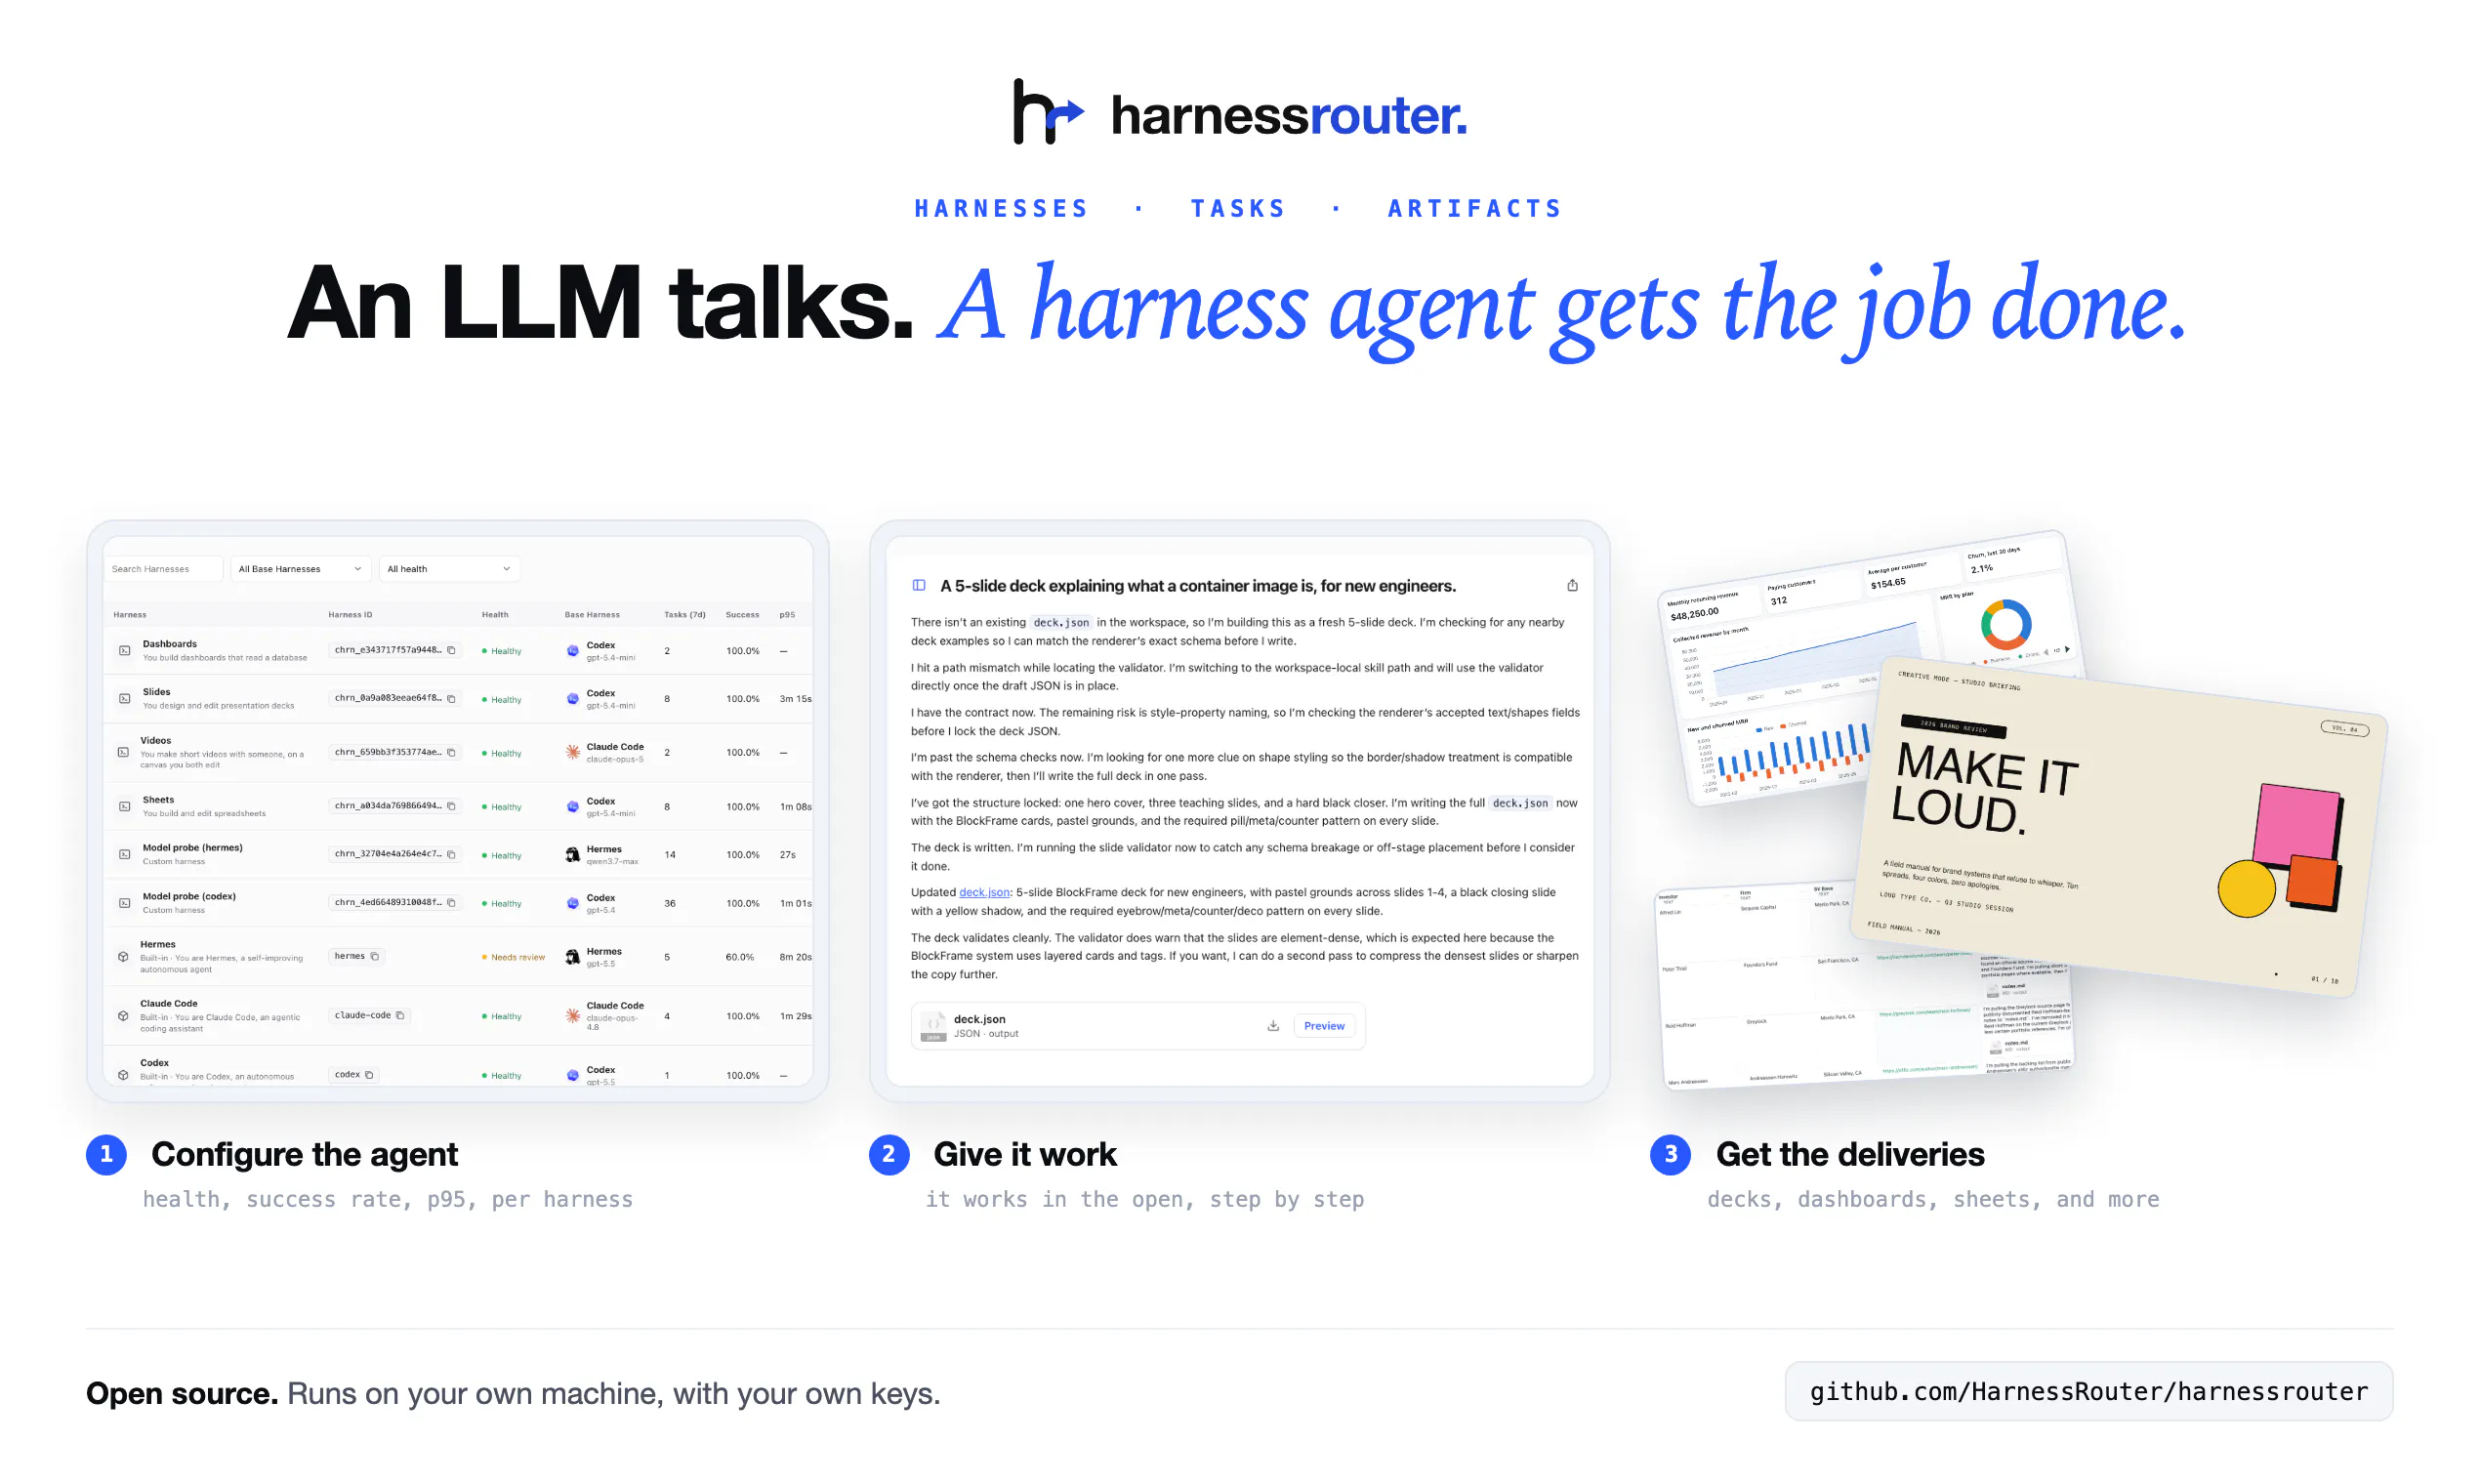
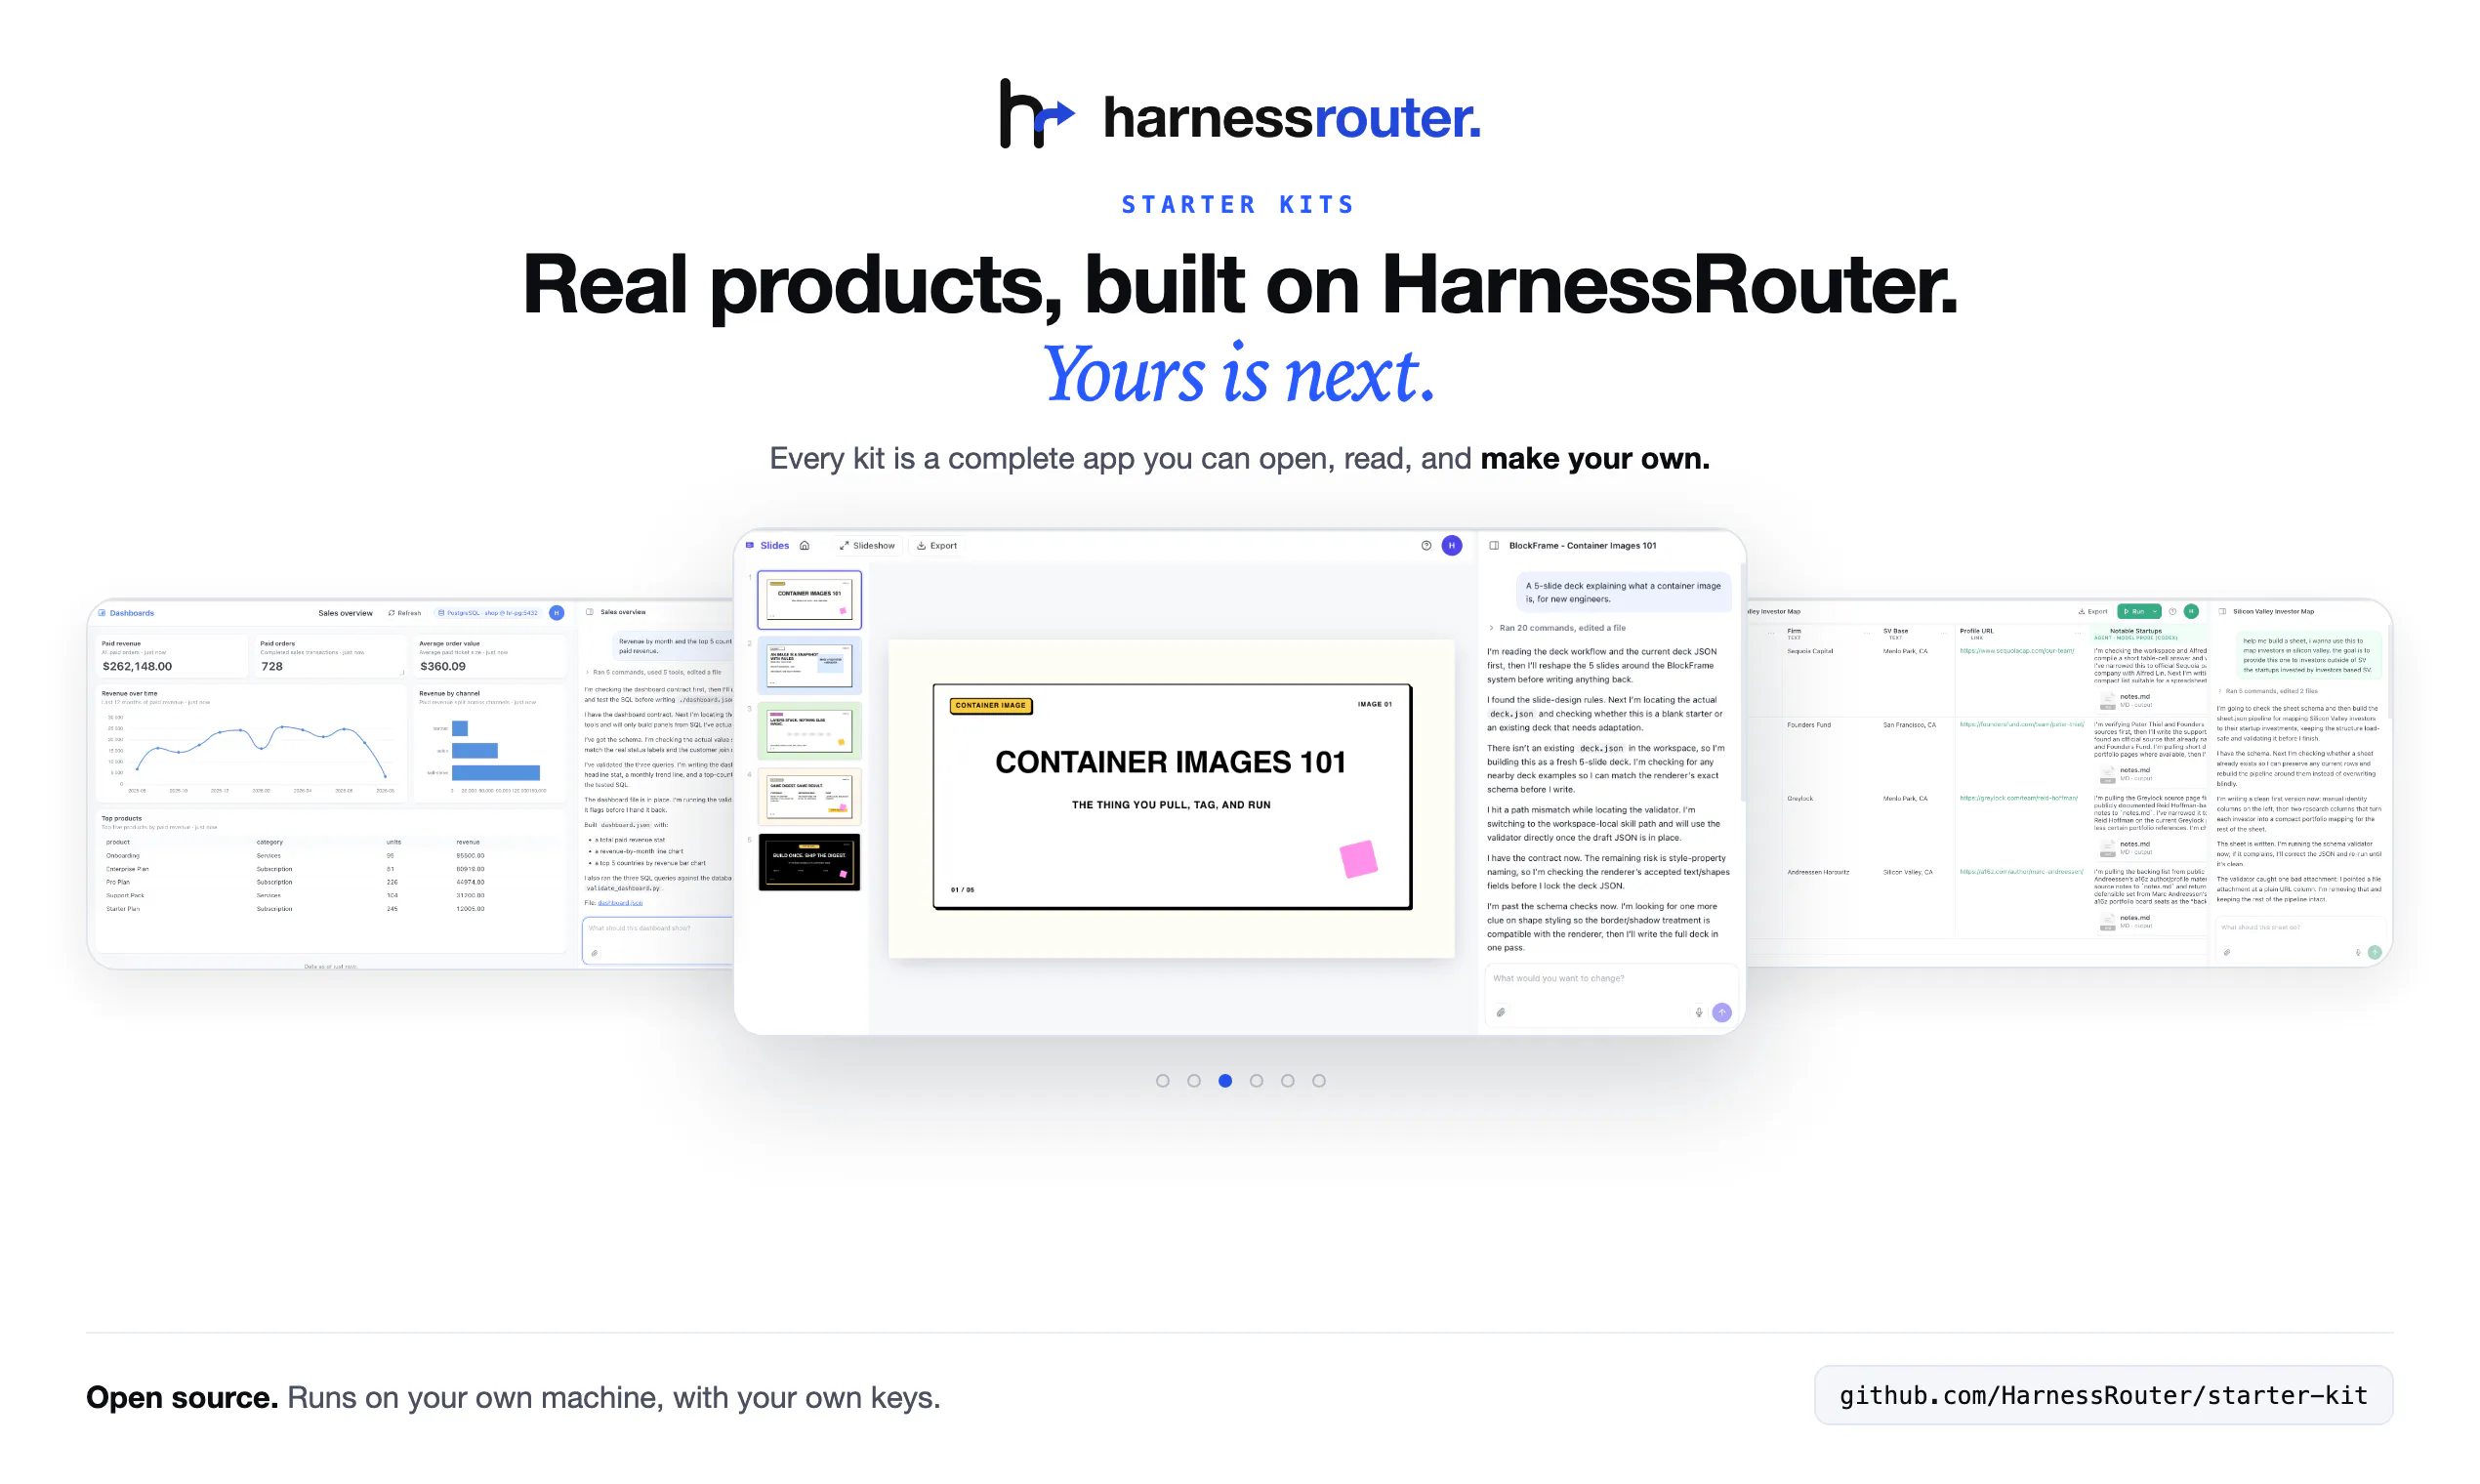
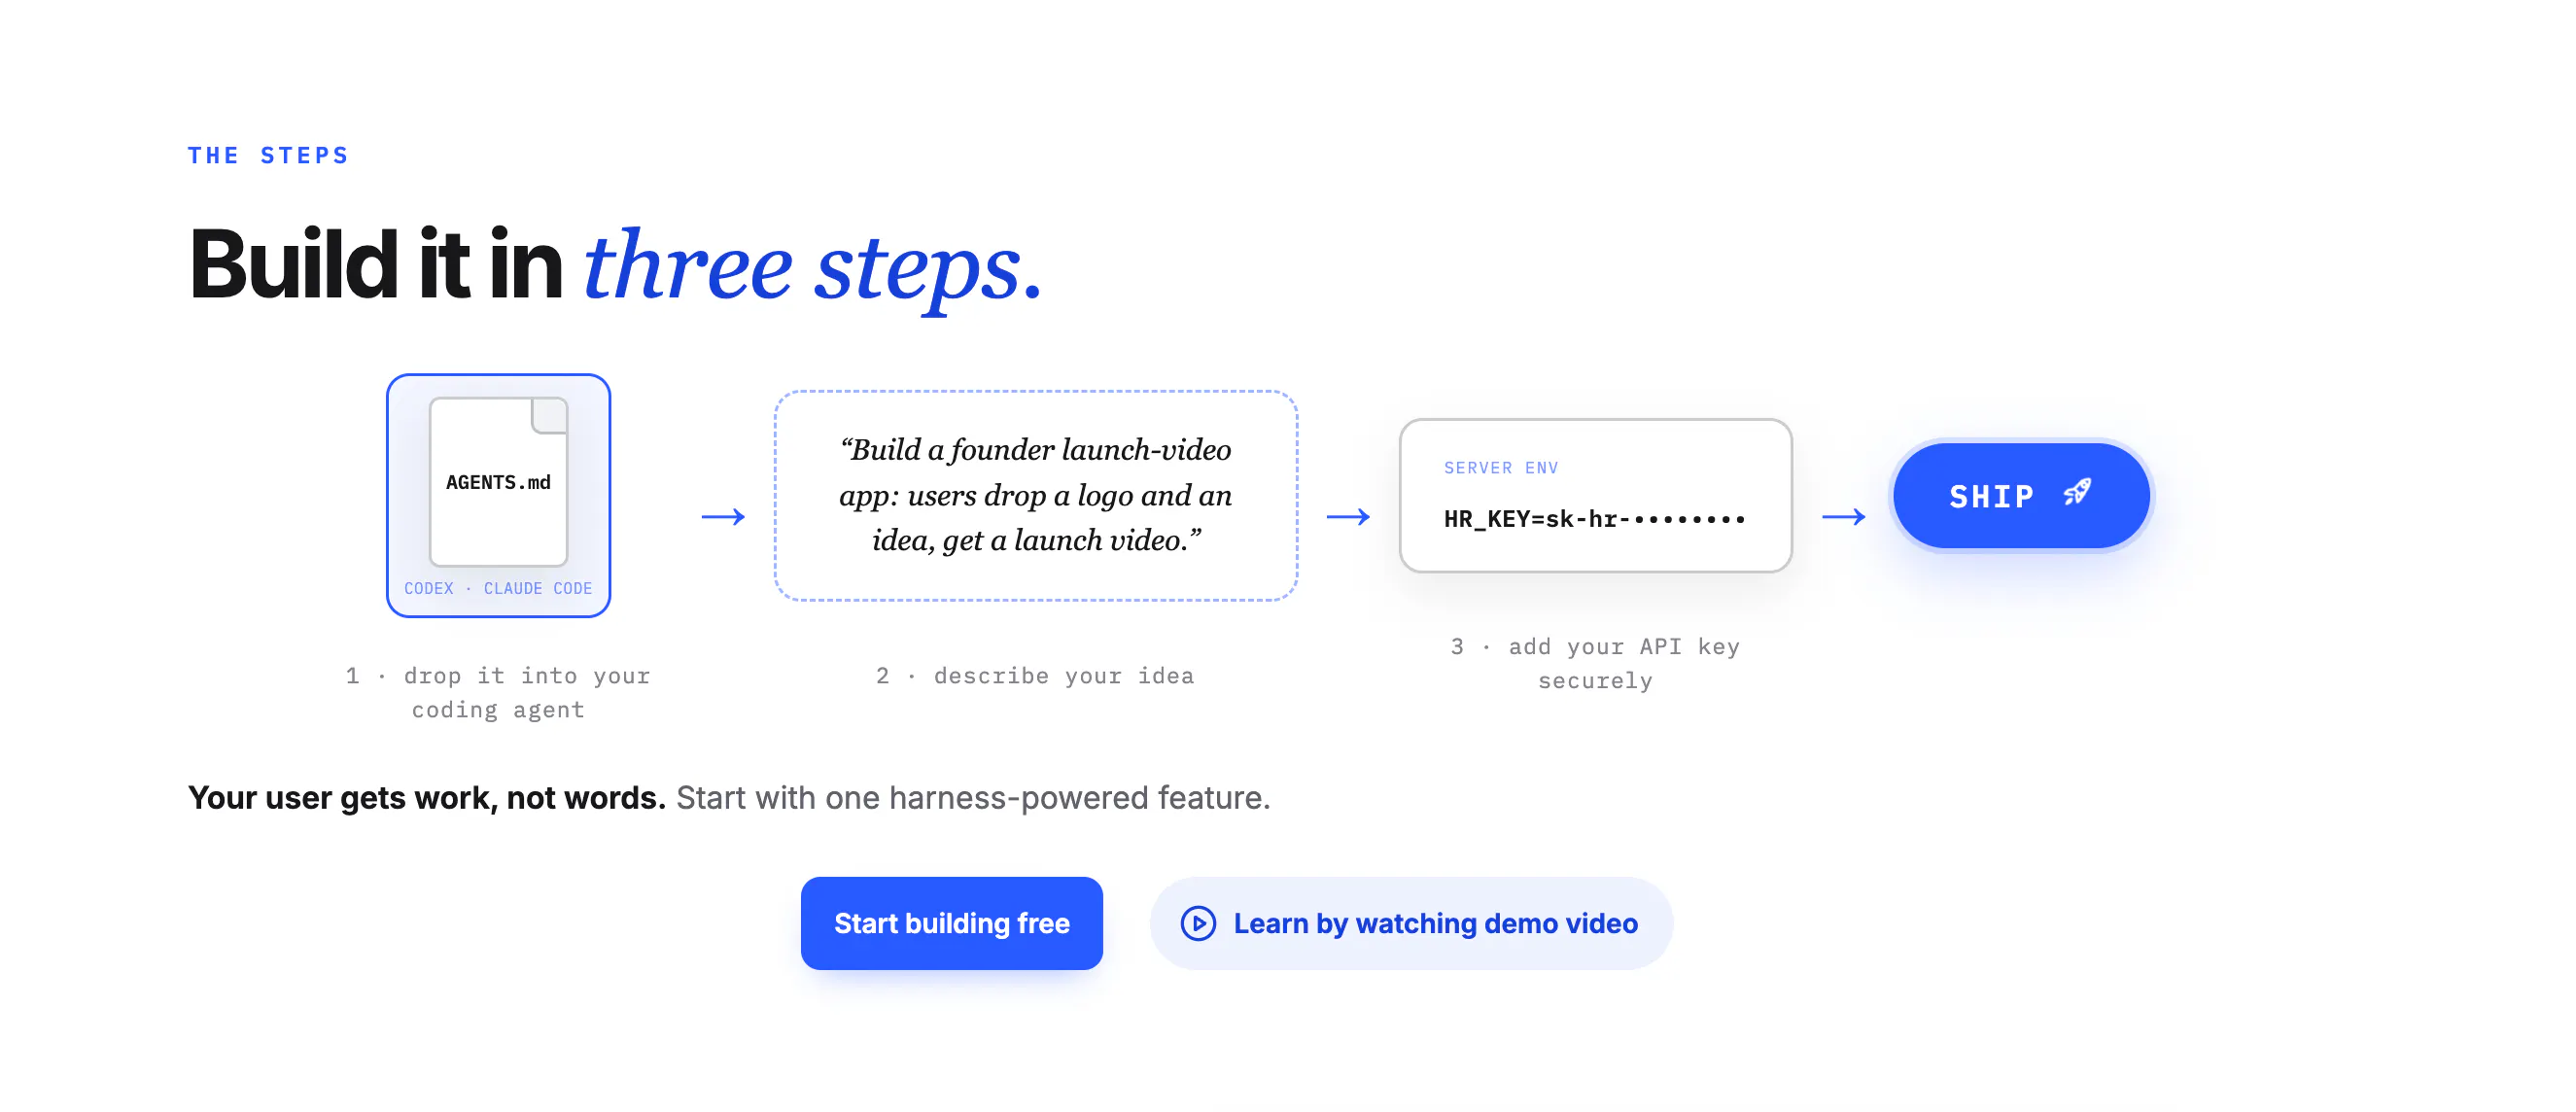
一句话介绍:HarnessRouter Community Edition是一个开源的统一接口层,通过单一API无缝接入Codex、Claude Code和Hermes等主流Agent harness,让开发者无需重建后端即可在自有基础设施上快速切换和调用成熟的智能体运行时,大幅缩短交付周期并提升Agent质量。
API
Developer Tools
Artificial Intelligence
GitHub
Agent编排
开源
统一API
Harness管理
智能体网关
基础设施
Apache2.0
协议标准化
开发者工具
DevOps
用户评论摘要:用户普遍认可Apache 2.0许可及社区版与云版同构的策略,认为这避免了锁定。核心讨论集中在:如何避免“最弱共同点”限制异构能力(如权限流),协议对不可正常化特性的显式支持机制,以及与DeepSeek开源harness的差异和组合方式。部分用户关注数据隐私处理模式。
AI 锐评
HarnessRouter的定位精准且锋利——“OpenRouter for agent harnesses”一句道破了当前Agent工程化的核心矛盾:底层模型趋同,而围绕模型封装的harness(会话管理、流式传输、容错恢复)才是决定交付质量和效率的护城河。它巧妙地把竞争从“重造轮子”引向“租用轮子”,将Codex和Claude Code等商业harness视为可插拔组件,这本身就是对生态现状的清醒认知。
该项目真正的价值不在于提供又一容器编排工具,而在于其押注的**统一Harness协议(UHP)**。评论区的焦点——能力协商避免“LCD(最弱共同点)”陷阱——直指协议设计的灵魂。如果UHP能如同LSP之于语言服务器那样,在harness与上层应用之间构建一个成熟的能力发现与降级机制,它将从根上重塑Agent应用的架构方式。其精心设计的47项一致性测试,更是为协议的可信度提供了硬性背书。
但风险同样显著。Apache 2.0开源的社区版与云版共享API,是典型的“开源获客,云上变现”路径,短期有效,但长期若社区创新活力不足,协议演化将可能被商业需求牵引。此外,产品押注“商业harness(如Codex)将持续领先”,这在开源社区如DeepSeek等快速迭代的背景下存疑——若开源harness追上且免费,HarnessRouter的差异化将受到削弱。最后,协议层设计得越完善,也就越复杂,其学习与适配成本可能抵消部分“即插即用”承诺。它现在解决了“选哪个harness”的焦虑,但下一代问题——“谁该拥有harness的默认策略”——将持续考验这个项目的治理智慧。总体而言,方向正确,执行力尚待时间检验,值得开发者密切关注。
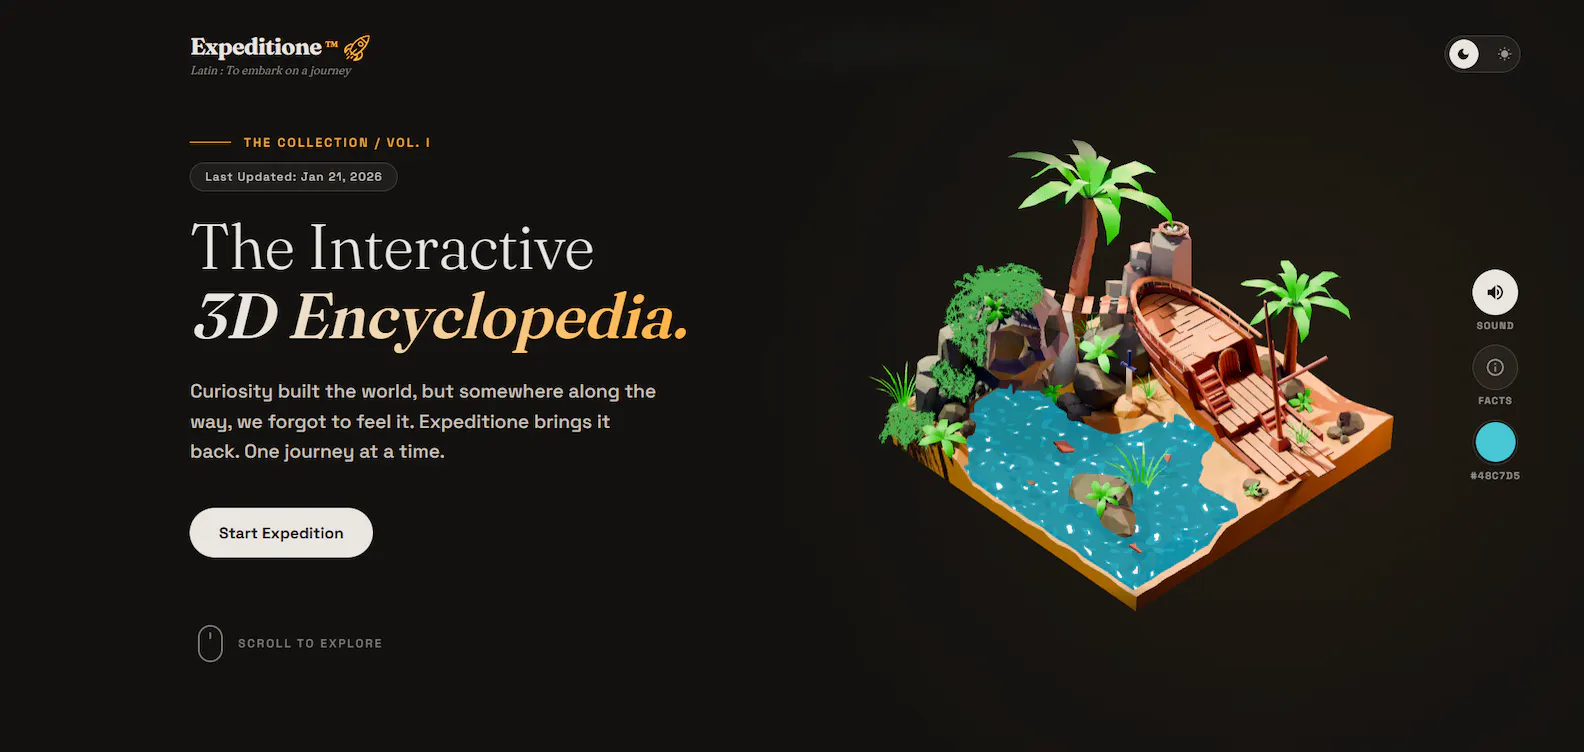
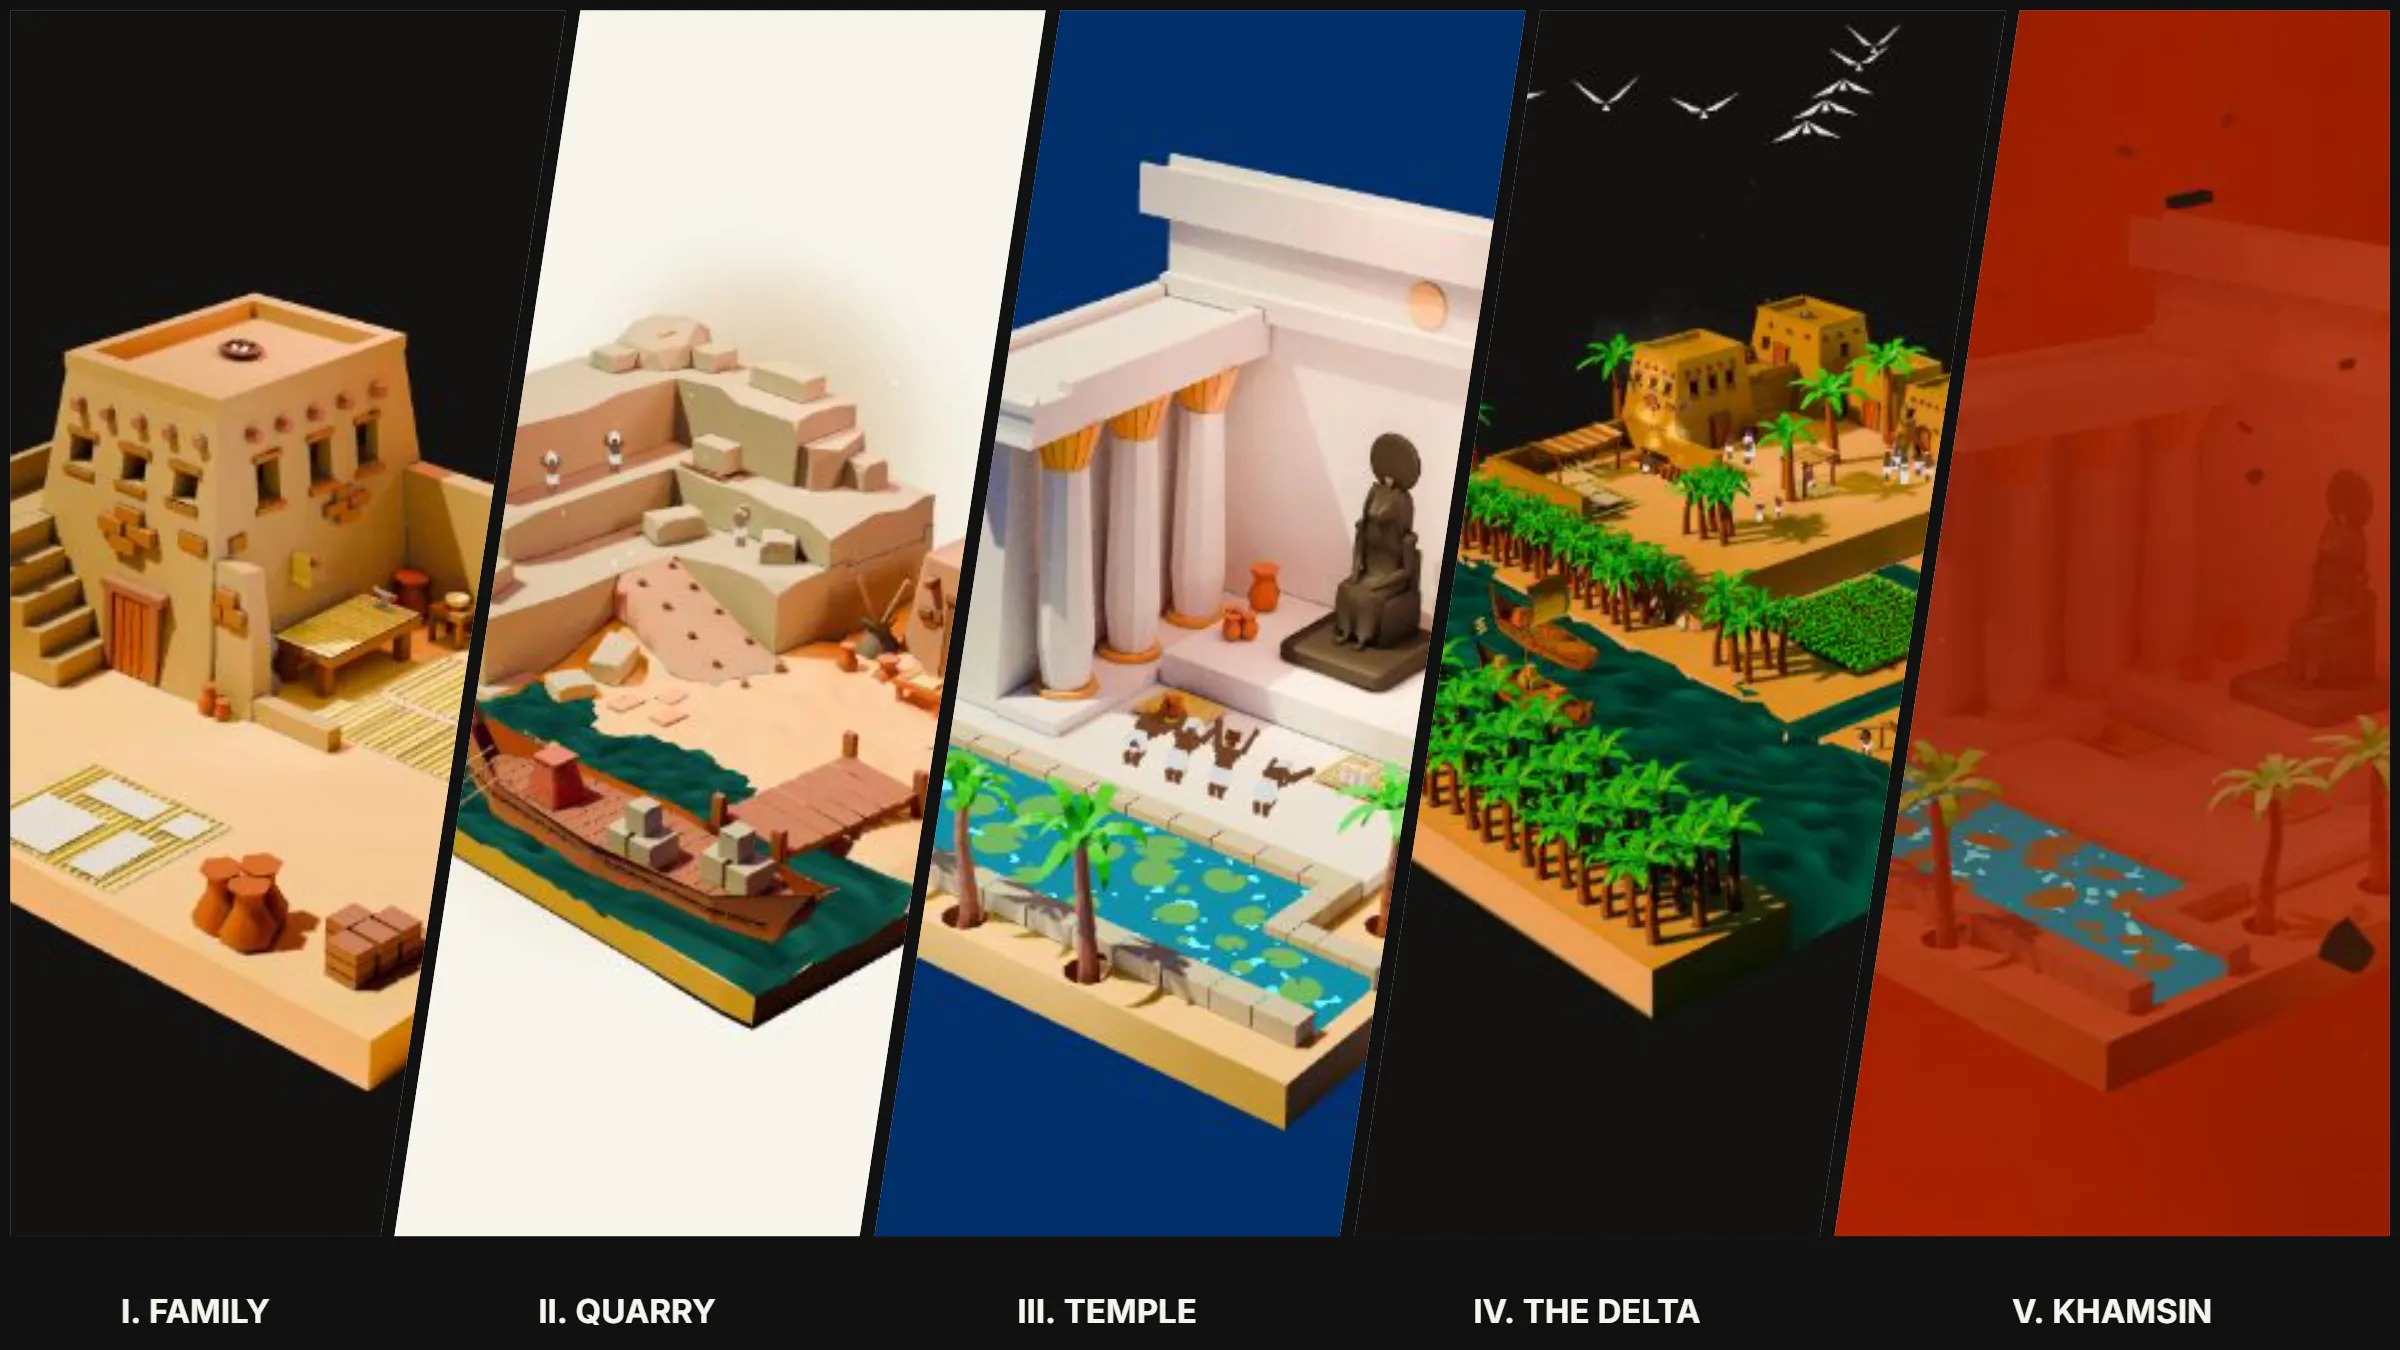
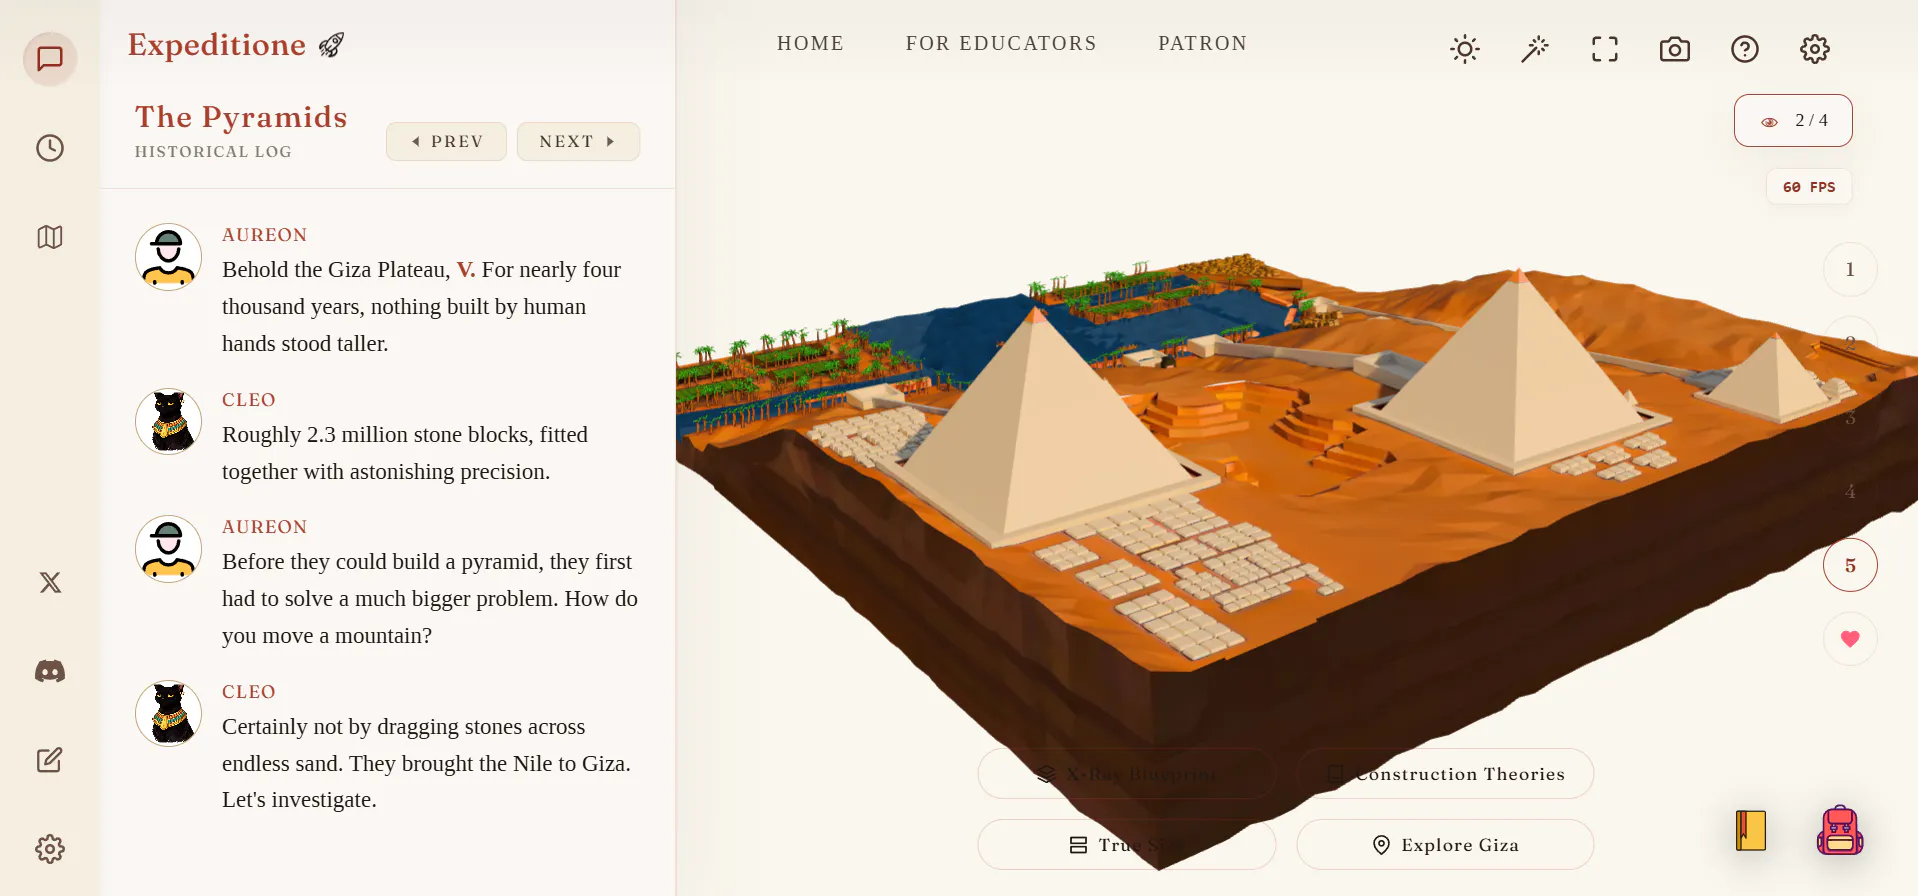
一句话介绍:Expeditione 是一款浏览器端的交互式3D百科全书,通过让用户亲手探索手工搭建的历史场景(如古埃及),将“阅读知识”变为“体验知识”,解决传统图文学习枯燥、记忆不牢的痛点。
Education
3D Modeling
Web Design
3D百科
交互式学习
教育科技
古埃及
浏览器应用
独立开发者
无登录
轻量化
沉浸式体验
课堂工具
用户评论摘要:用户普遍惊叹于单人开发的完成度与轻量化优化(1MB内)。主要建议包括:希望增加更多主题(如机场、太空、影视场景);有计划推出面向学校的课堂通行证(免登录);部分用户认为工作日发布能获得更多关注,但开发者回应因首页推荐被移至周日。
AI 锐评
Expeditione 的价值不在“百科”,而在“证明”。它用1MB的体积和1000小时的个人投入,狠狠打了当下动辄几十MB、依赖高配GPU的“伪3D教育”一记耳光。其真正亮点有二:一是将“重3D”与“轻网页”这对矛盾体成功调和,这为未来教育内容的传输与分发提供了极具想象力的技术范式——无需下载、无需账号、即开即用,完美适配课堂与低端设备;二是其场景选择极具智慧,聚焦“采石场”而非“金字塔”,直击历史教育的盲区,将劳动过程可视化,传递了比“奇迹”更珍贵的历史唯物主义视角。
然而,冷眼观之,其暗面亦不容忽视。作为单人项目,其可持续性存疑——你如何对抗拥有引擎级团队和资本的3D内容平台?目前“社区投票决定下一主题”的模式,极易让内容走向猎奇化(如网友建议的星球大战场景),从而稀释其严谨的教育基因。更重要的是,1MB的精巧是“线性展览”的副产品,一旦加入用户自由创造或复杂物理模拟,体积必然膨胀,技术神话将难以复刻。另一个隐患是商业化路径模糊,免费+教育资源的路线固然高尚,但若无法提供持续收入,这个宏伟的百科宇宙恐将止步于古埃及的沙土之中。它目前是一件惊艳的艺术品,但要成为改变教育格局的产品,还需在“单点突破后的平台化”与“可持续盈利模式”上拿出更务实的答案。
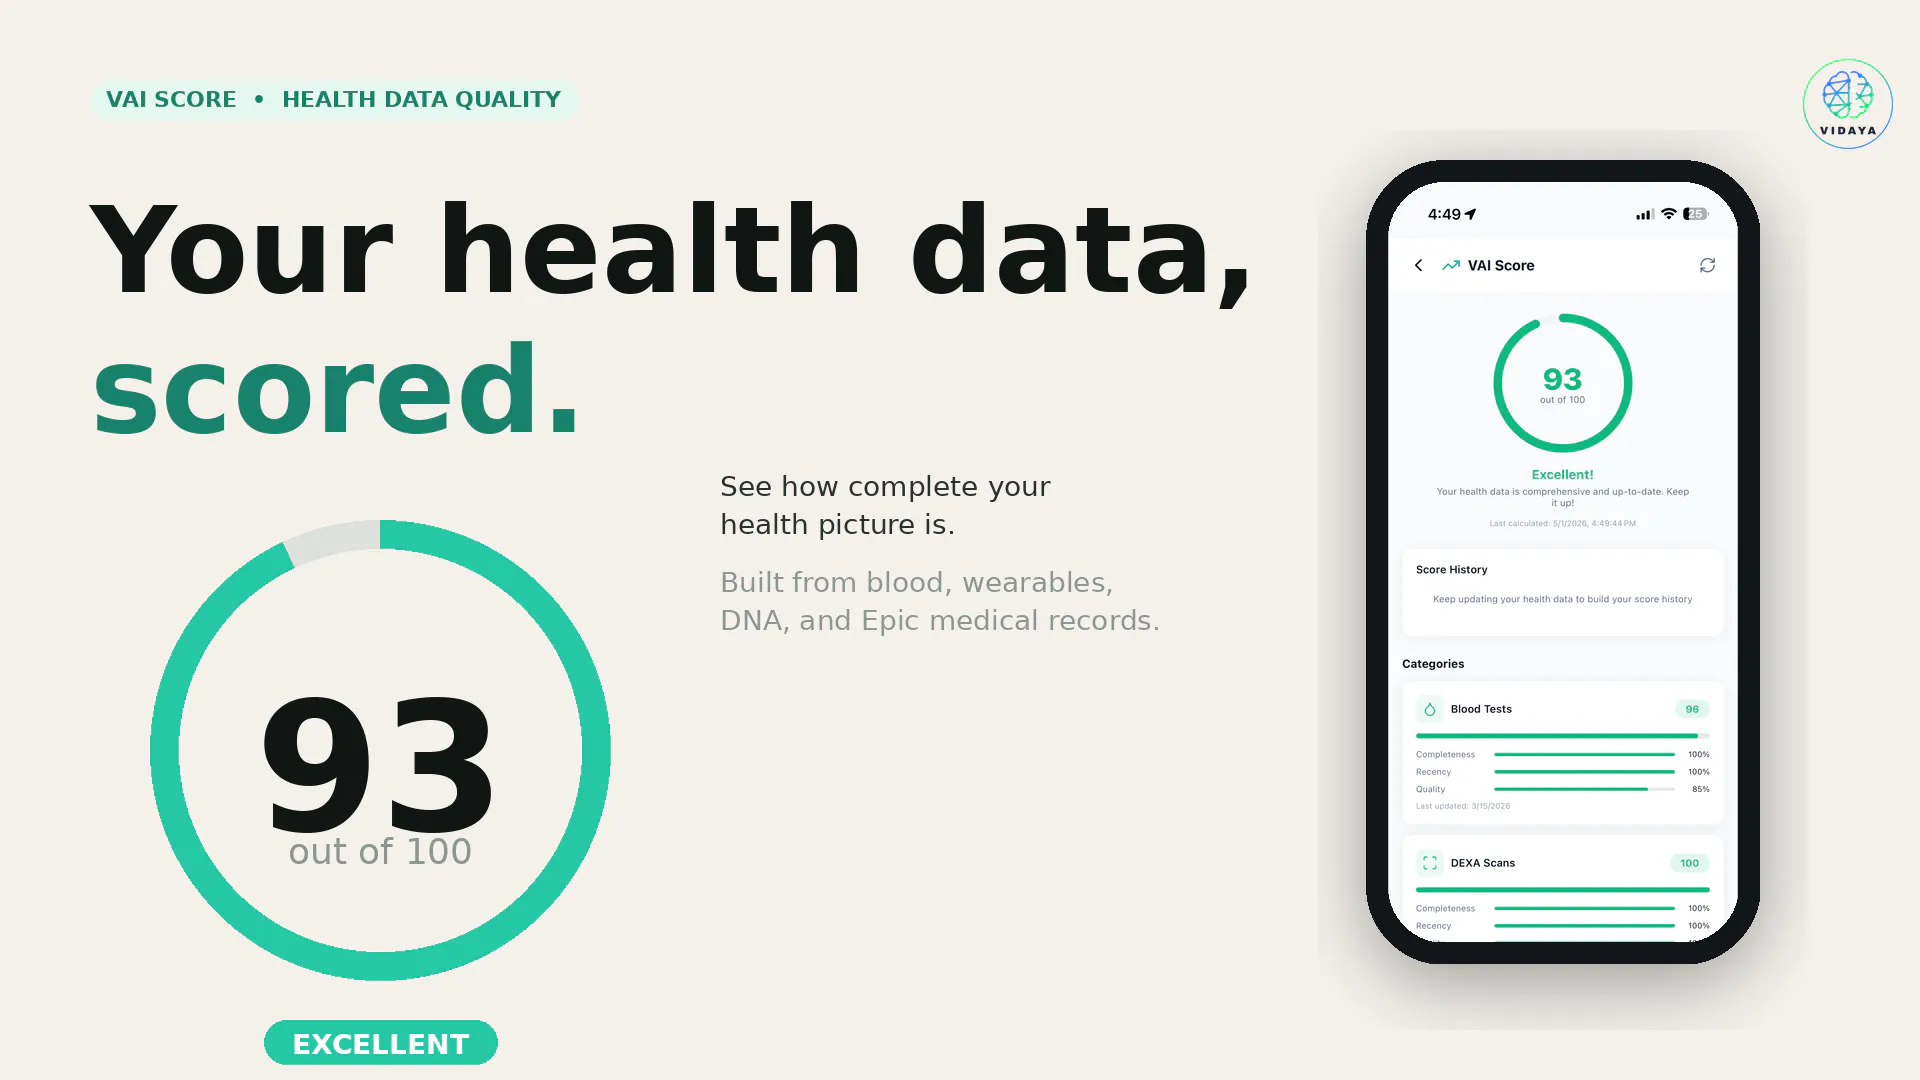
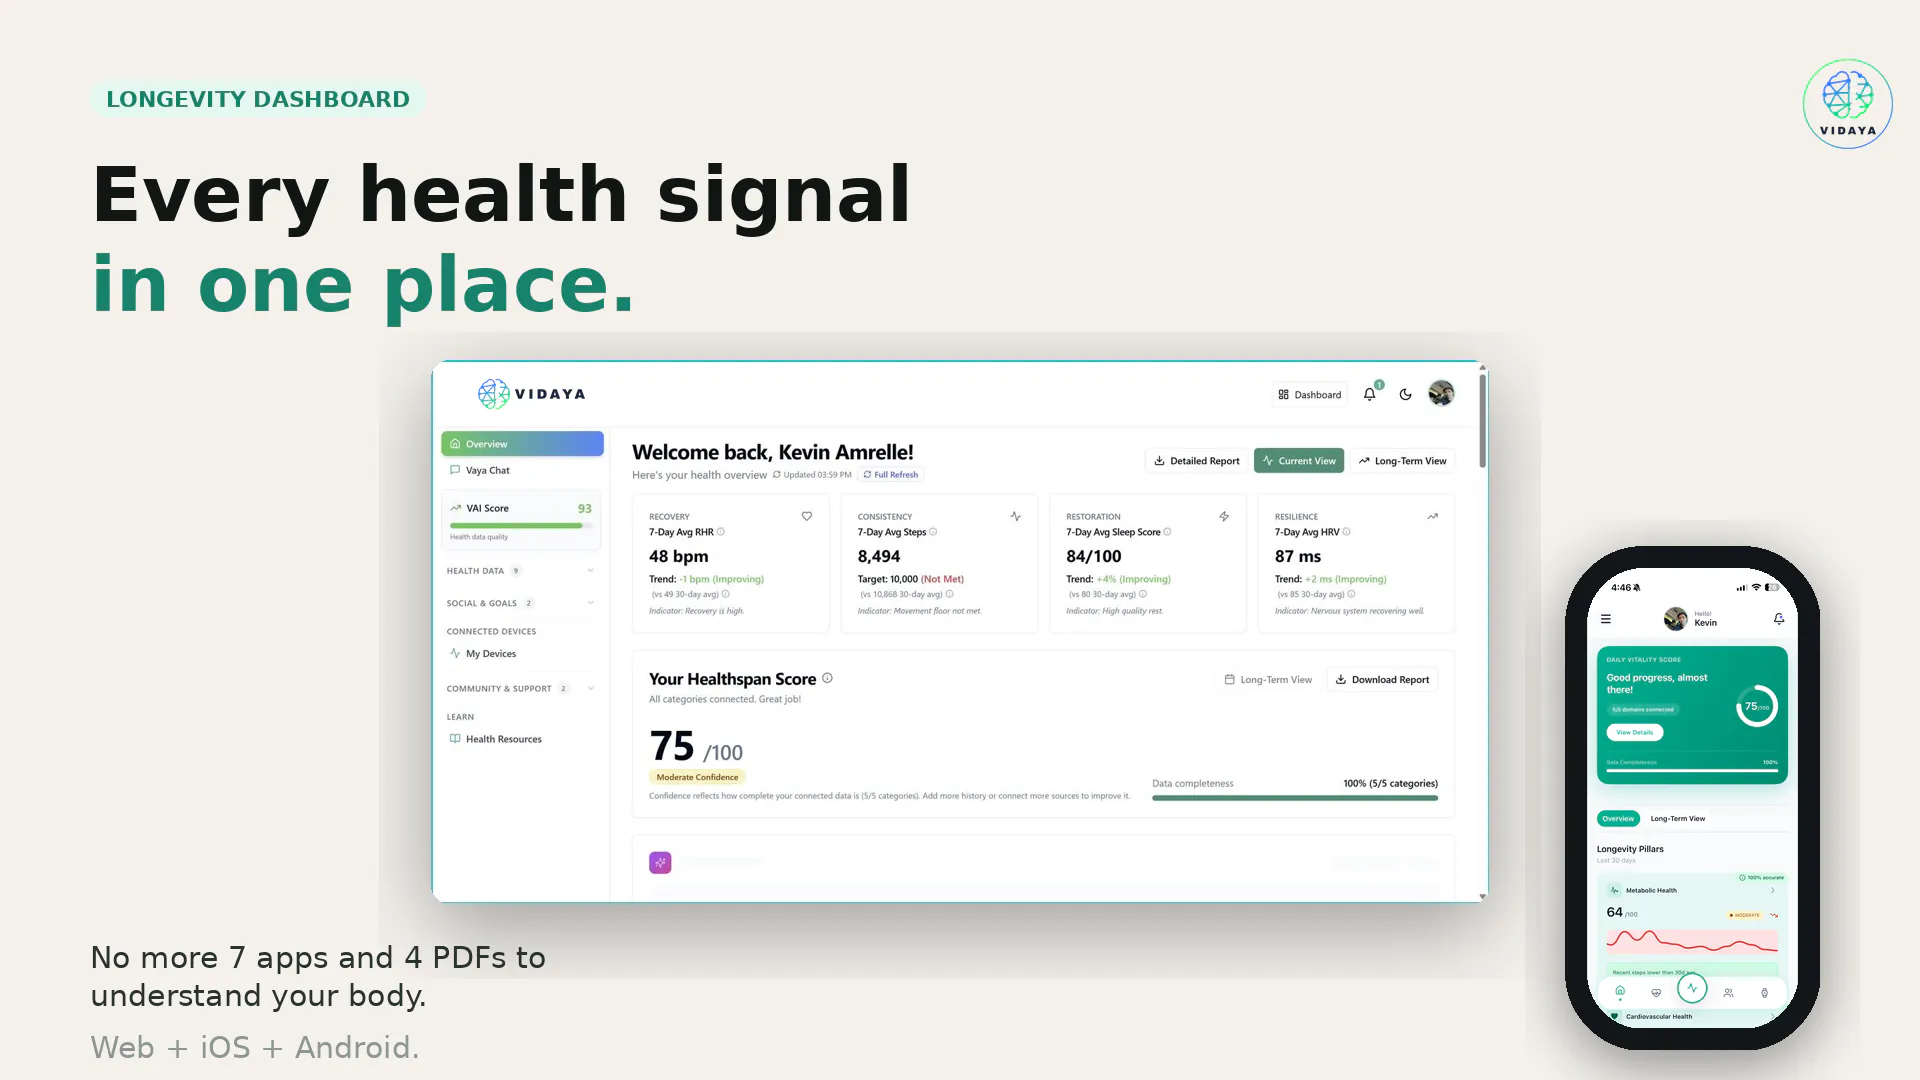
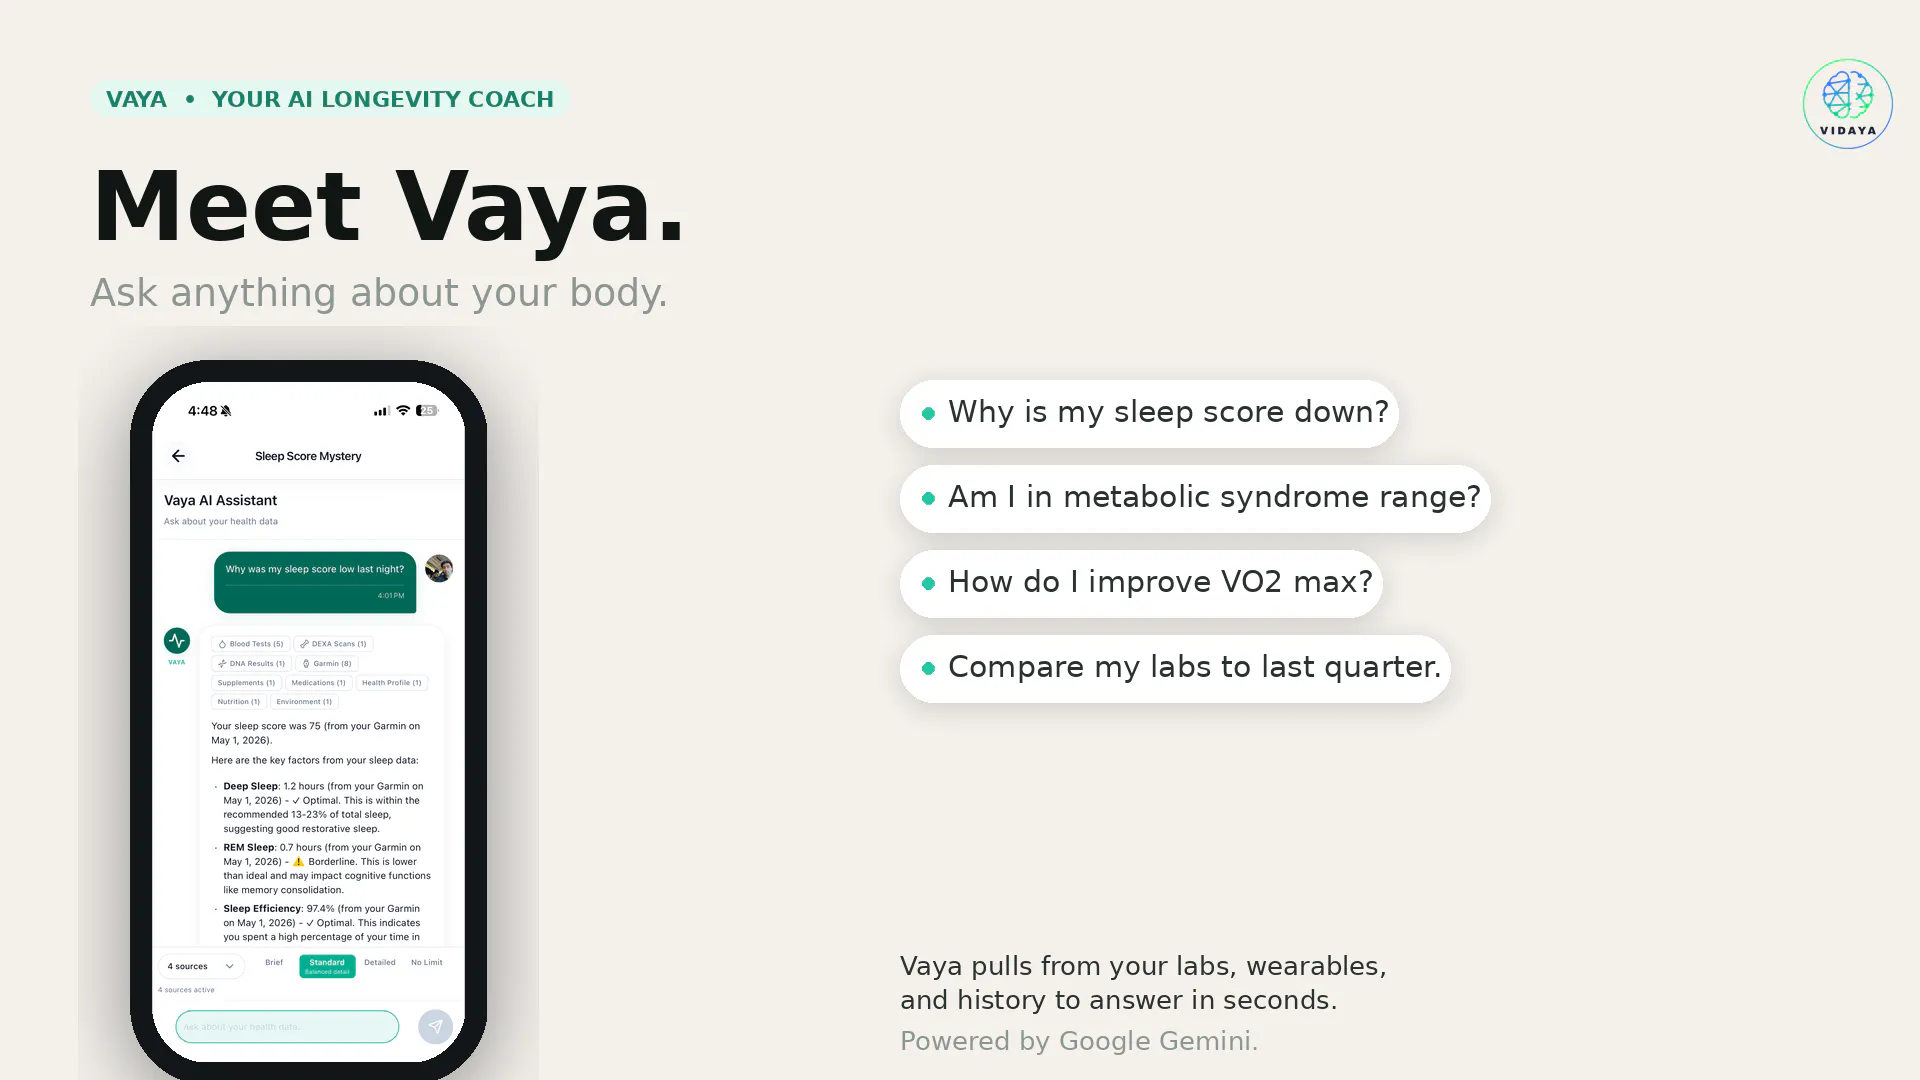
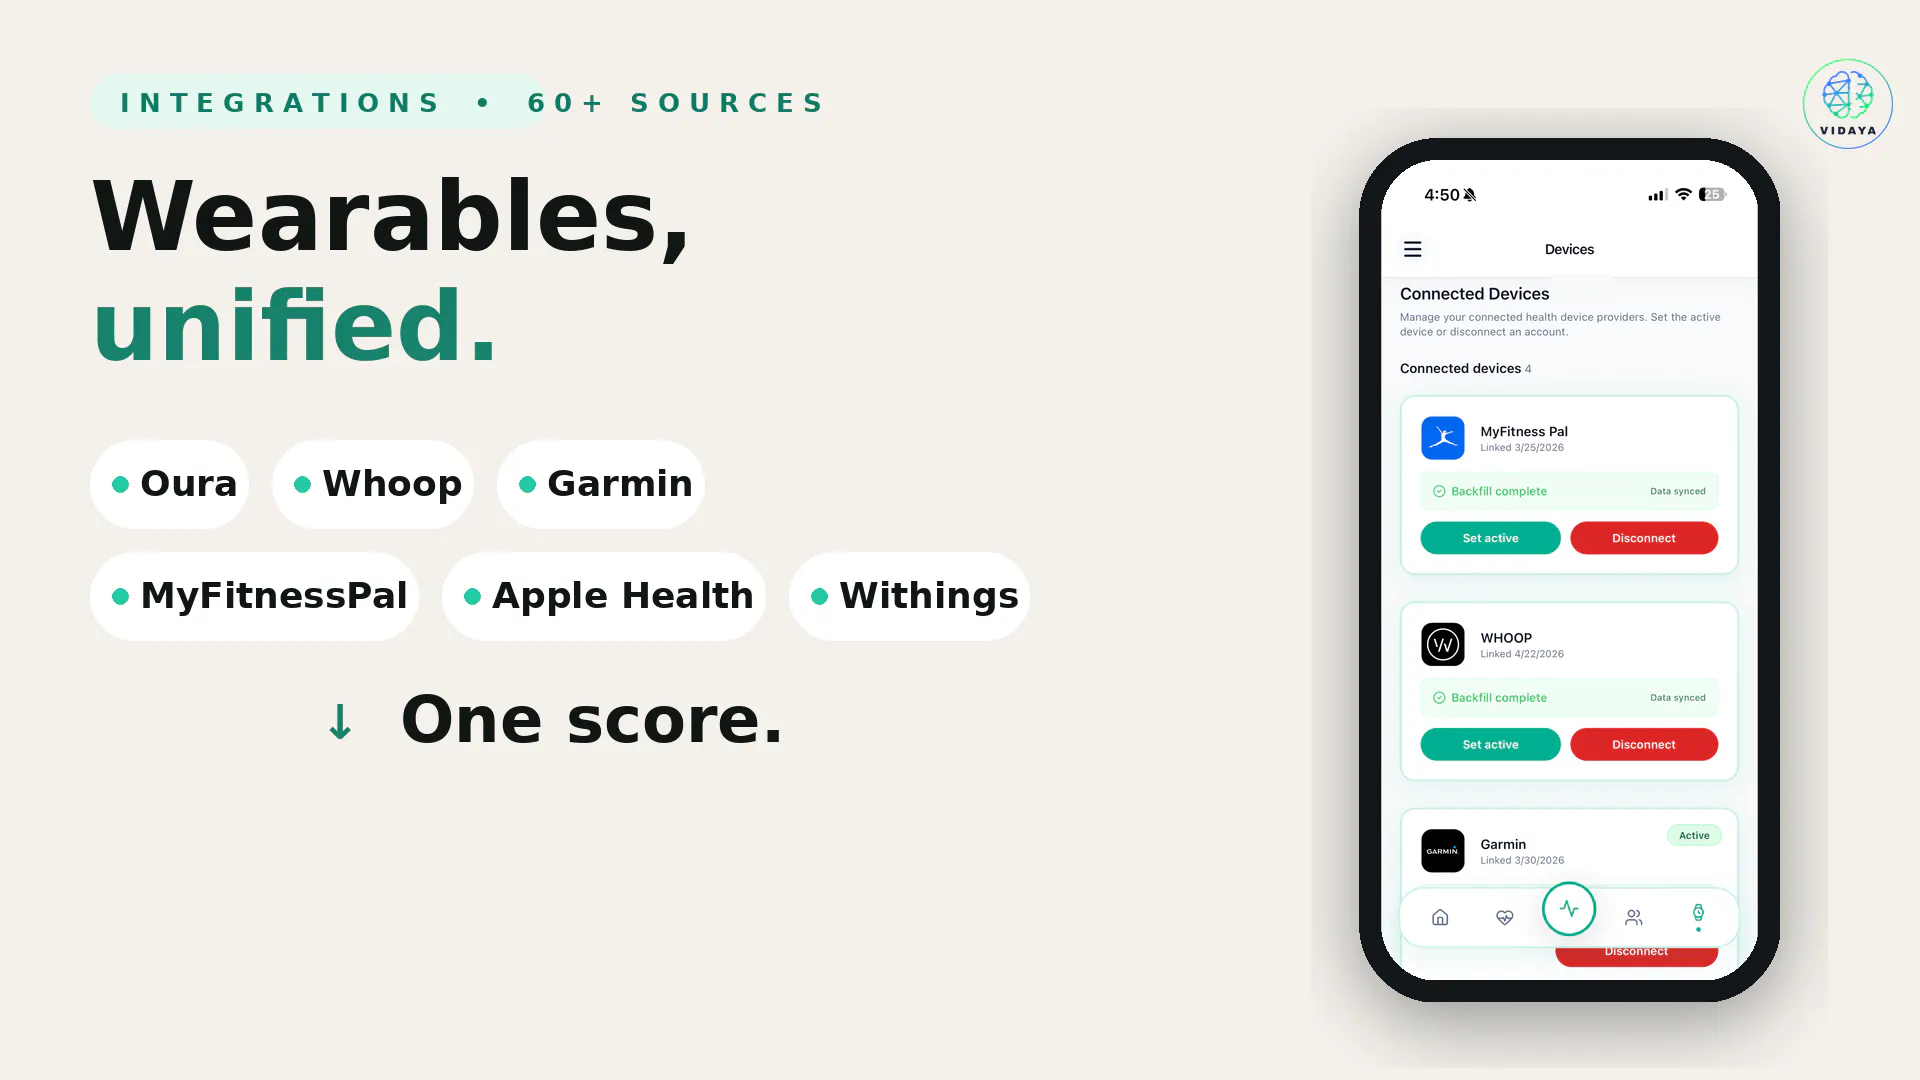
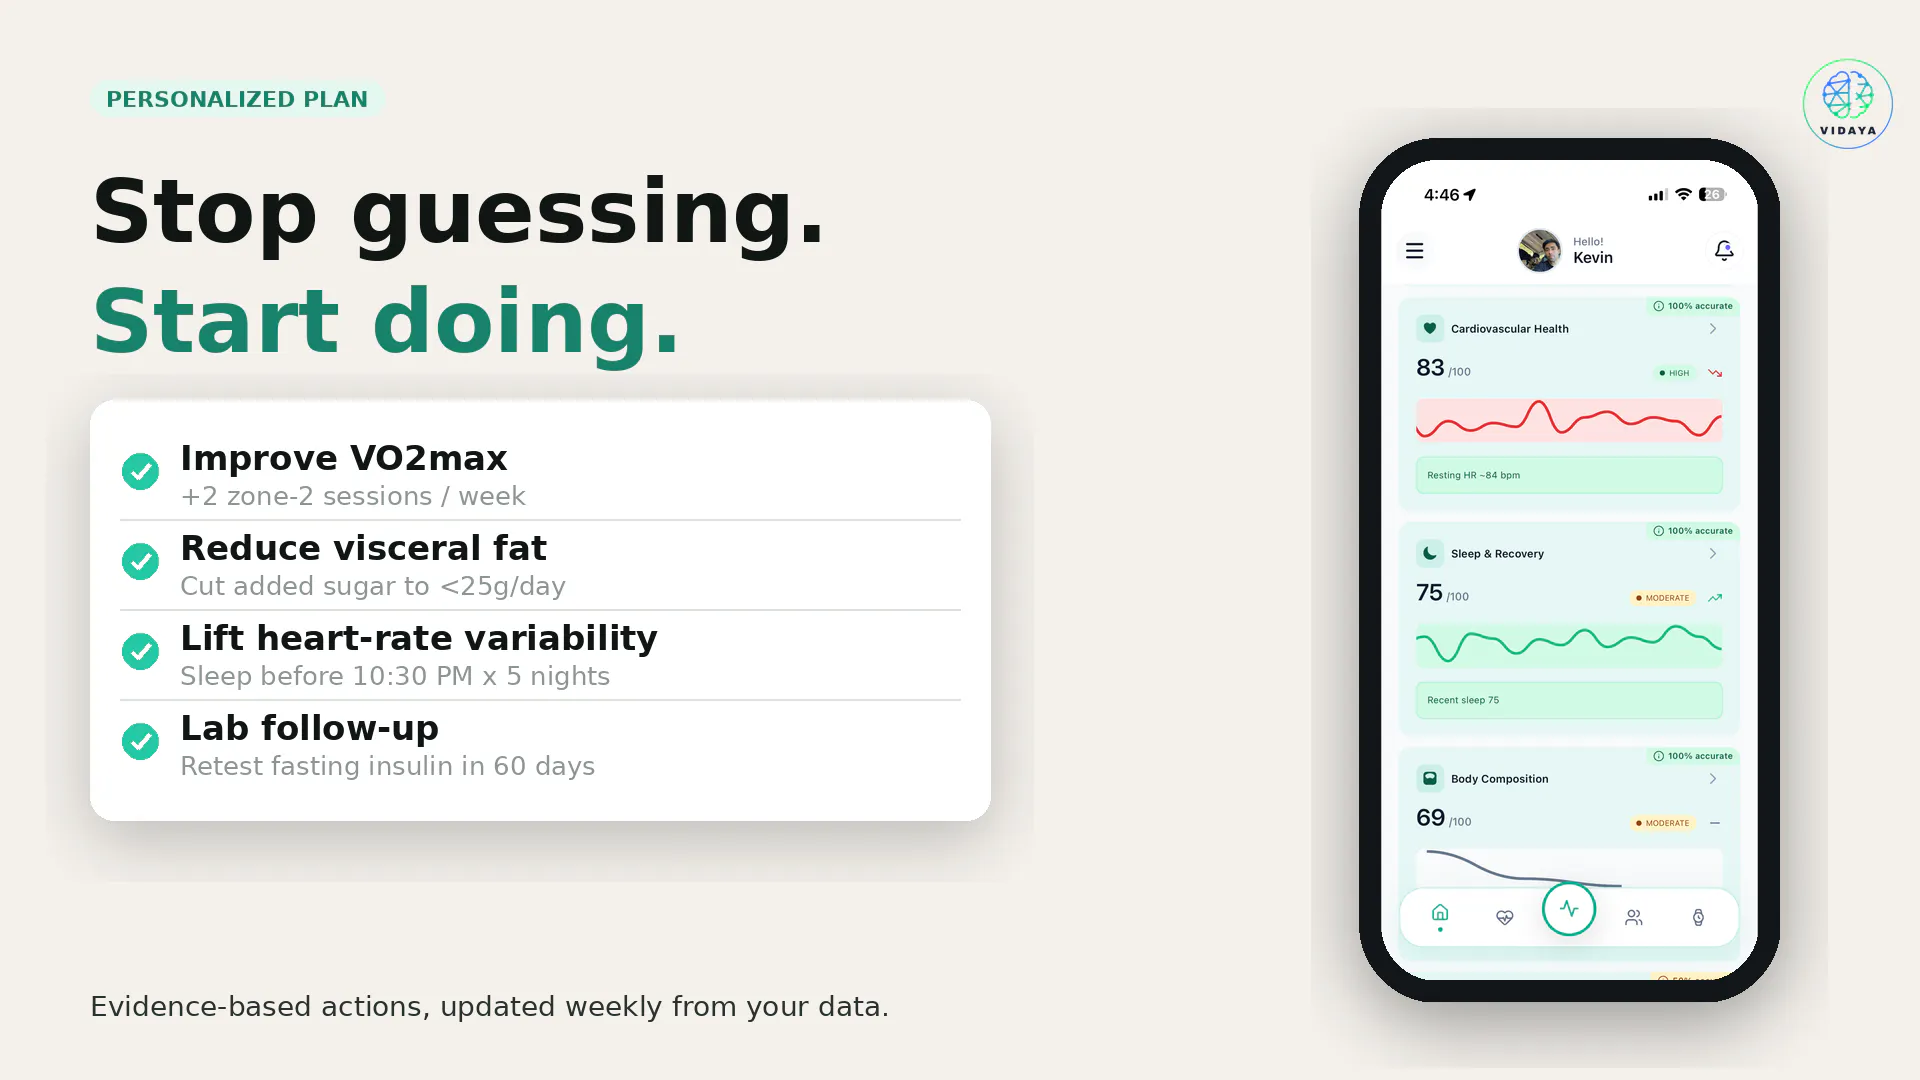
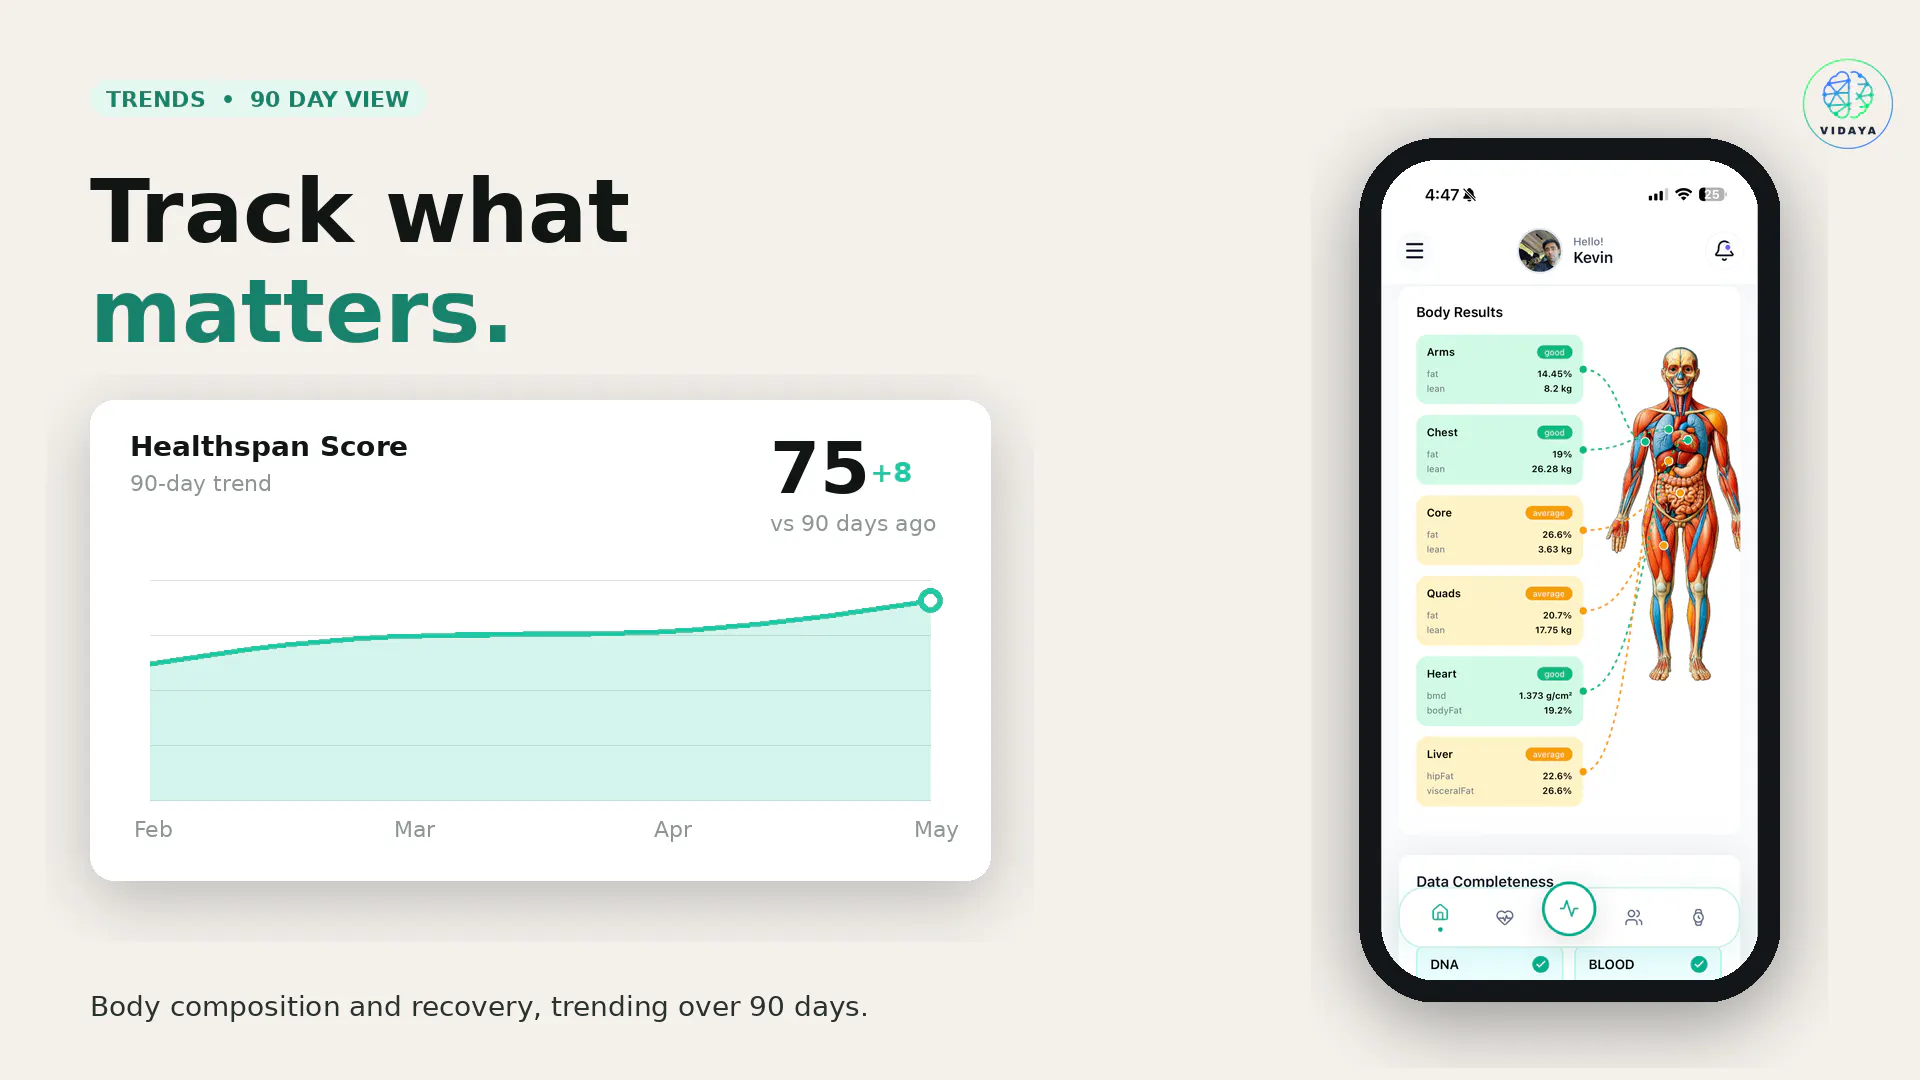
一句话介绍:Vidaya是一款将智能穿戴、化验报告、DNA检测等60+来源的健康数据整合为“健康寿命评分”并提供个性化行动方案的AI长寿管理平台,解决用户“数据分散在各App、只看到数字却不知道下一步该做什么”的核心痛点。
Android
Health & Fitness
Productivity
Artificial Intelligence
AI健康管理
长寿科技
健康评分
聚合平台
个性化建议
智能穿戴整合
医疗数据互联
健康数据分析
AI教练
健康趋势追踪
用户评论摘要:用户普遍认可“从碎片数据到行动建议”的定位,赞赏趋势可视化与AI引证机制。主要问题聚焦:评分模型透明度、数据不足时如何回应、家庭账号支持、以及向医生导出完整报告的需求。另有用户关心急救与处方等安全边界,创始人均承诺数据不足时坦诚相告并引导就医。
AI 锐评
Vidaya的聪明之处在于,它精准地击中了量化自我运动中最大的挫败感:数据收集得越多,却越不知道自己该干什么。创始人以自身高血压漏诊故事切入,将产品叙事从“仪表盘”升级为“行动指令”——这确实是极具说服力的卖点。
然而,深度审视后,其价值主张面临几重现实拷问。第一,商业化悖论:整合60+数据源是重资产维护模式,而技术壁垒不高——真正的护城河并非数据来源的广度(可被Apple Health或Google Fit逐步吞噬),而是跨源关联的洞察质量与医疗级准确性。专利尚在申请中,能否形成有效防御存疑。第二,信任红线:尽管团队强调HIPAA合规与0幻觉审计,但“方向而非诊断”的边界话术,在真实健康焦虑场景下容易让用户产生误解——当Vaya错误地忽略某个早期病变信号,法律与伦理风险瞬间放大。其AI依赖1000条文献库+7B级模型,属于稳妥但无革命性的工程实现。第三,商业模式粗糙:年费39美元的低价策略,与“医疗保险式”的长期价值预期不匹配,难以支撑持续研发成本;而家庭Squads功能虽能扩展场景,儿童数据合规与亲子监控的伦理灰度都可能成为隐患。
总体而言,Vidaya是“数据聚合+提示工程”的成熟产品,胜在产品心智清晰,但要成为长寿赛道的真正颠覆者,它尚需回答“AI建议如何让医疗决策链真正落地”这一终极问题——否则,它终将沦为一个优秀的“趋势仪表盘”,而非通往健康长寿的AI导航仪。
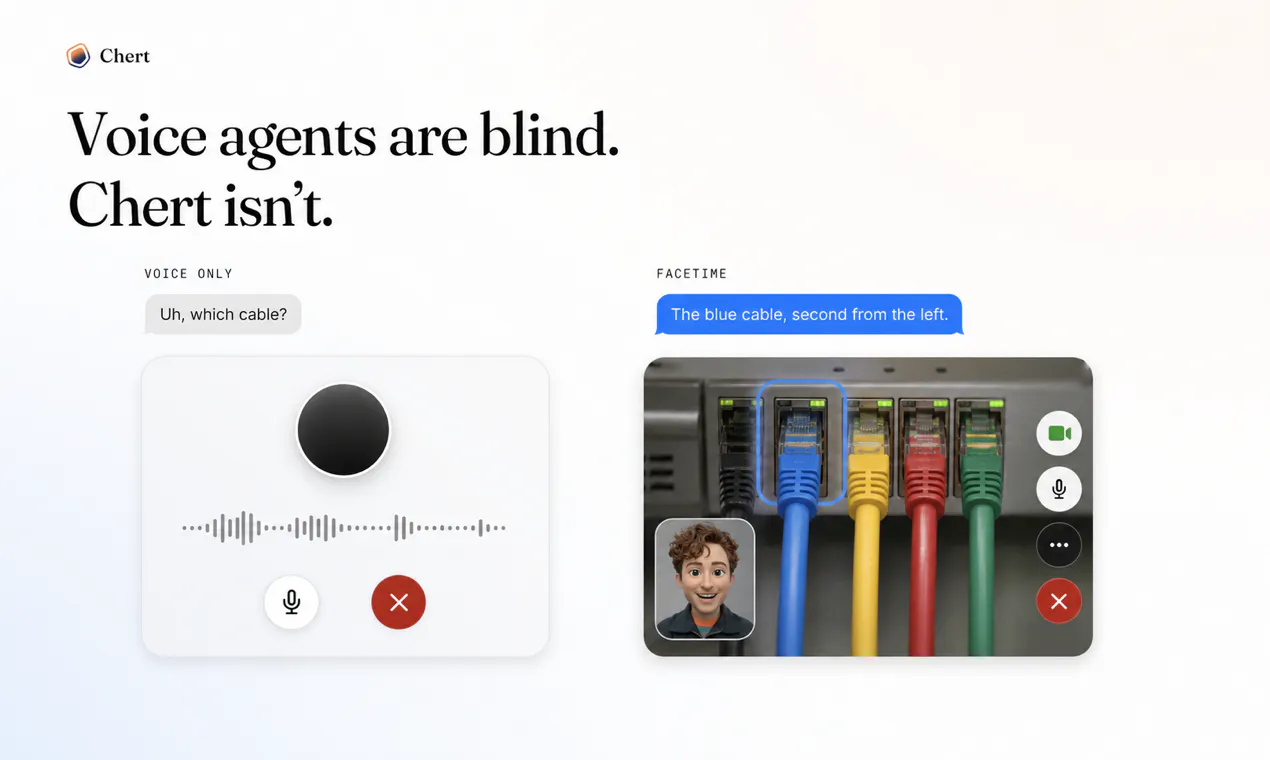
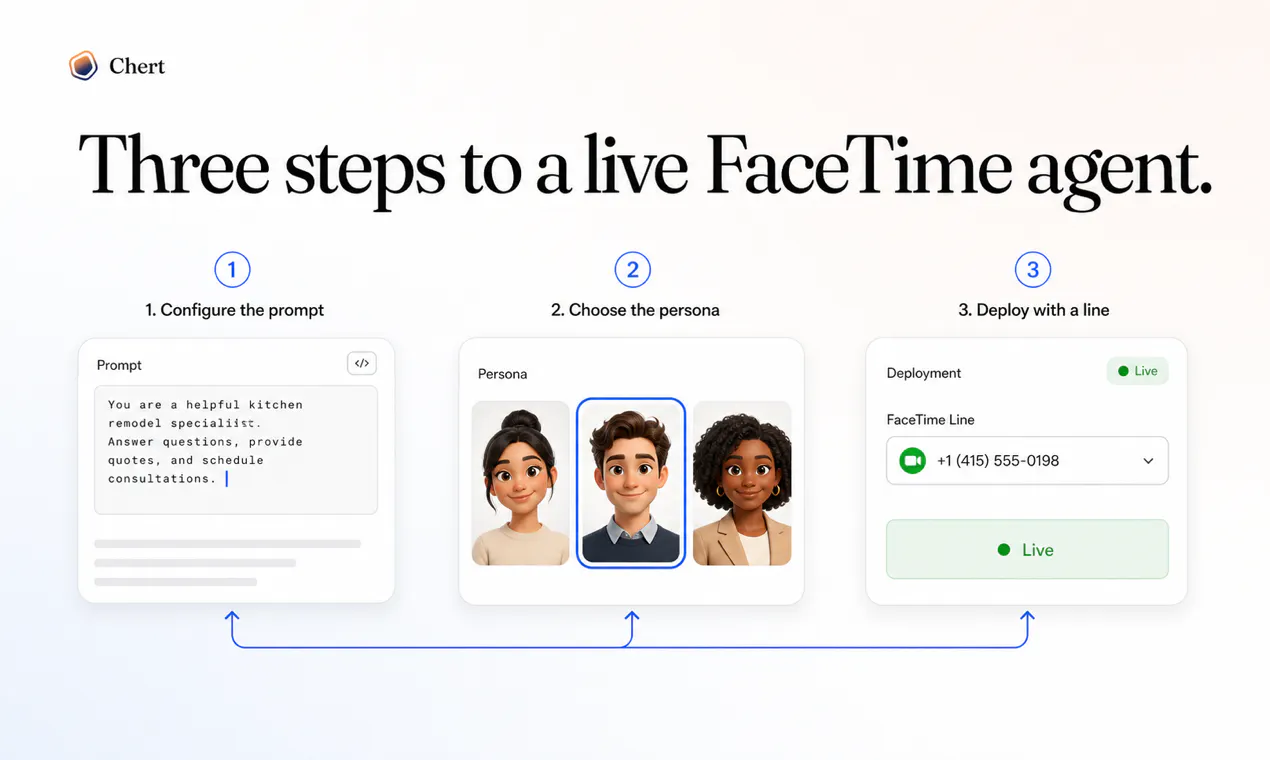
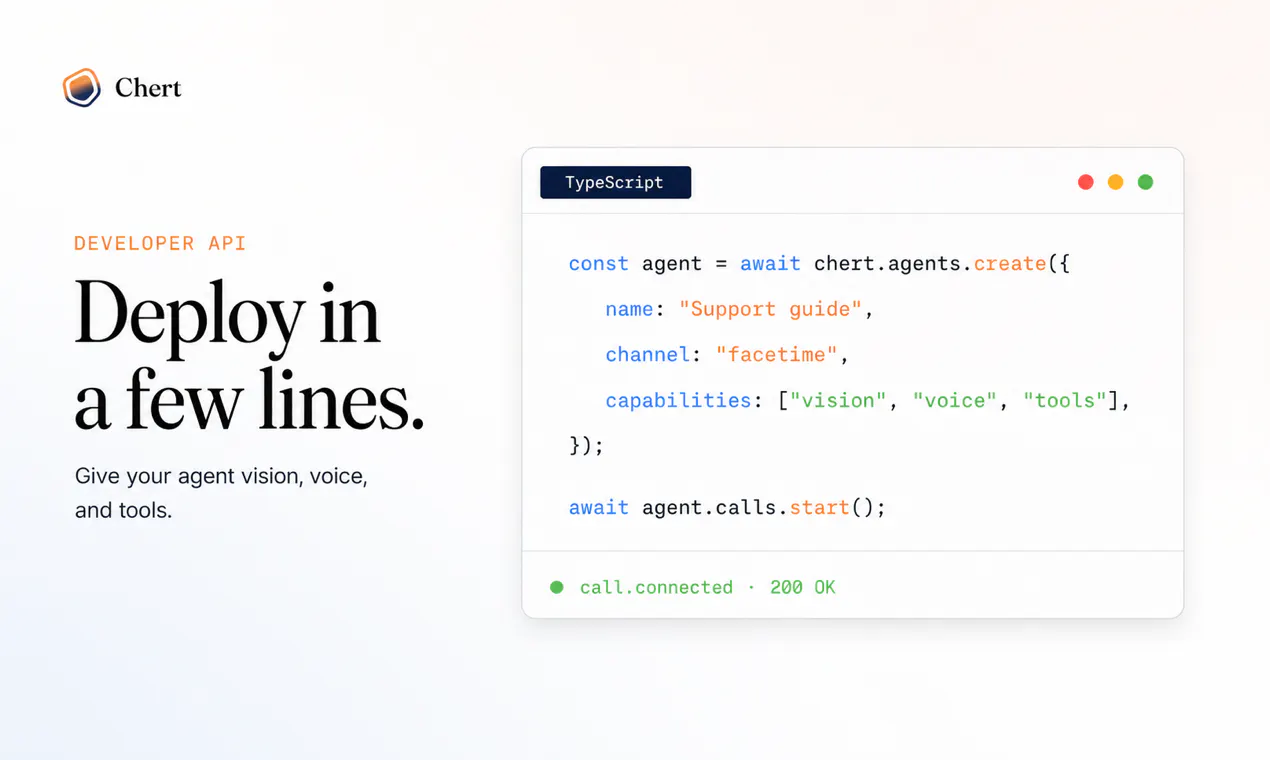
一句话介绍:Chert 是“FaceTime 版 Vapi”,用几行代码即可构建能主动拨打/接听 FaceTime 视频通话的 AI 代理,让 AI“看见”用户摄像头画面并实时响应,解决远程支持、 telehealth 等场景中“光靠语音描述不清”的视觉痛点。
API
Developer Tools
Artificial Intelligence
AI视频代理
FaceTime集成
视觉语音Agent
远程支持
telehealth
低代码开发
实时视频对话
开发者工具
Vapi替代
Apple生态
用户评论摘要:用户普遍认可“让语音代理不再瞎”的定位,实时演示延迟低于预期。主要疑问集中在隐私合规(视频流加密)、跨平台扩展(WhatsApp等全球渠道),以及KYC/身份验证等垂直应用;创始人回应称已规划多平台,并强调数据加密。
AI 锐评
Chert 的聪明之处在于没有发明新入口,而是直接寄生在苹果最强势的“信任型通讯协议”上——FaceTime 的免安装、强隐私背书和 iOS 原生集成,让 AI 视频代理第一次有了“打陌生电话不被拒”的可能。这比做独立 App 或网页端 WebRTC 的冷启动成本低一个量级,确实是“事后看来显然”的机会。
但它的天花板同样清晰:第一,FaceTime 是封闭生态,欧美市场之外(尤其东南亚、拉美)用户基数有限,而评论中“WhatsApp 才是全球市场”的质疑正中要害——若不能迅速打通 WhatsApp 视频,Chert 只能吃下苹果生态内的高净值客户,这或许能撑起一家精品公司,但撑不起“Vapi for FaceTime”这个宏大叙事。第二,隐私合规是悬顶之剑。尽管创始人声称“加密用户信息”,但在医疗、金融等强监管场景里,光靠传输加密远不够,还需要可审计的调用日志、用户明确的动态知情同意机制以及与 HIPAA 等标准的合规认证,这些隐性工程成本远超“几行代码”的营销话术。第三,技术壁垒存疑:实时视频理解 + 低延迟对话的架构(如视觉 loop 的端到端延迟)是真正的护城河,但评论中仅以“试试看”带过,缺乏可量化的延迟基准。Vapi 在纯语音赛道上已经卷到价格战,Chert 若不能证明自己在视觉推理上有独特模型优化,很容易被大模型厂商的视觉 API 降维打击。
总体而言,这是一个精准切入“被忽视的 FaceTime 接口”的漂亮产品,适合小步快跑验证需求。但要在 2024 年后的 AI 基础设施赛道上立足,它必须尽快回答两个问题:如何打破苹果围墙花园?如何在视觉 agent 成本与延迟上建立真正的指数级优势?否则,它可能只是大厂视频通话功能里一个“AI 特效”的预演版。
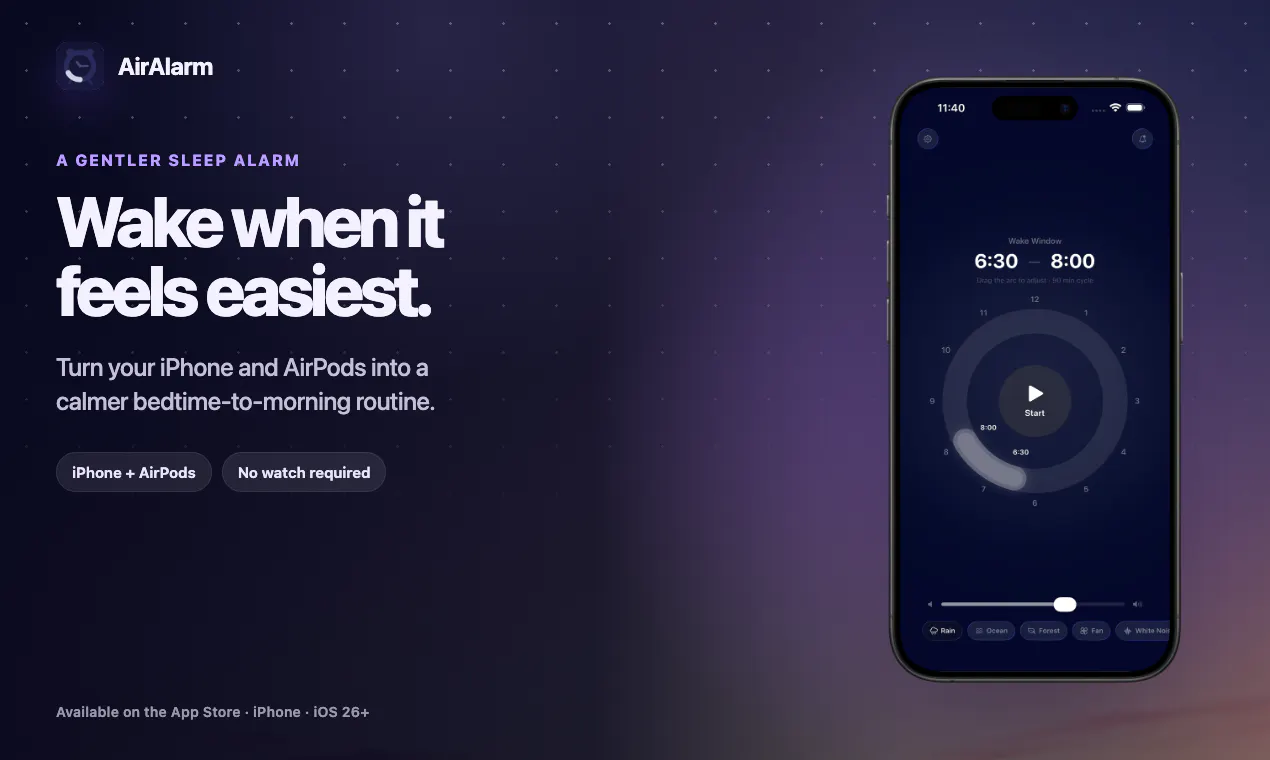
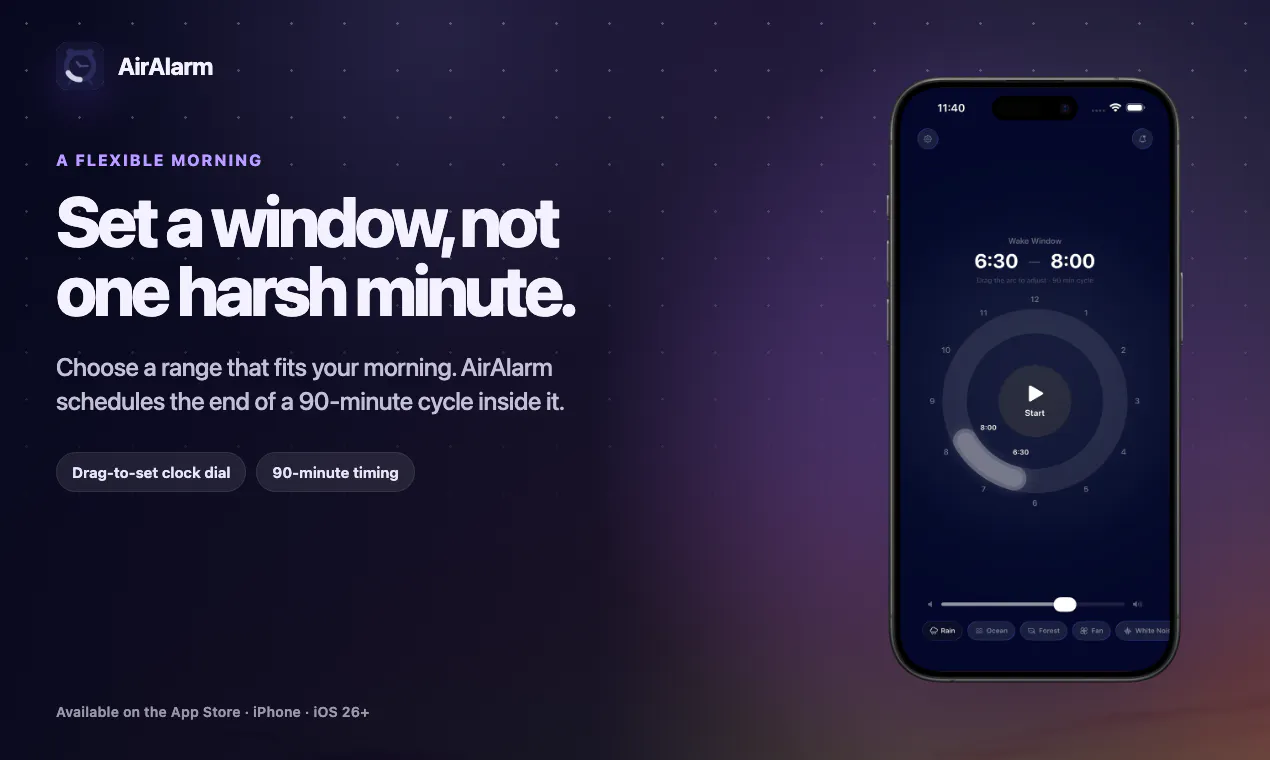
一句话介绍:AirAlarm将iPhone与AirPods转化为智能睡眠闹钟,让你设定最晚起床时间,在90分钟睡眠周期结束的自然节点轻柔唤醒,告别被精准闹钟硬生生惊醒的痛苦。
iOS
Health & Fitness
Audio
智能闹钟
睡眠周期唤醒
AirPods
iOS应用
无穿戴设备
隐私保护
无广告
睡眠辅助
健康科技
用户评论摘要:用户普遍赞赏“唤醒窗口”概念取代固定闹钟的做法,认为更贴合自然醒来习惯。主要问题集中于是否有Android版本,开发者回应因依赖AirPods入睡检测功能,暂无安卓计划。另有用户肯定无账号、本地存储睡眠数据的隐私设计。
AI 锐评
AirAlarm的聪明之处,在于它精准地切入了“闹钟焦虑”这一现代人普遍却未被充分满足的痛点,并用“90分钟周期+唤醒窗口”这一科学逻辑,取代了传统闹钟冰冷的“精确到分钟”的机械逻辑。它没有试图制造一个复杂的睡眠监测硬件生态,而是巧妙利用了用户已拥有的AirPods和iPhone,以极低的用户迁移成本,提供了“更聪明”的起床方案。这在产品策略上是典型的“降维打击”。
然而,其核心竞争力也恰恰是其最大的战略天花板。深度绑定AirPods的入睡自动暂停检测,使其功能逻辑与苹果生态强耦合,这种“护城河”在短期内是优势,但长期看却主动放弃了基数庞大的Android市场。评论中用户的多次询问已表明需求真实存在,但开发者的回应虽坦诚却略显保守,在可穿戴设备(如华为、三星)同样具备睡眠监测能力的安卓阵营,技术替代方案或许并非完全不存在,只是需要更大的开发投入。此外,该产品本质上是“睡眠周期闹钟”这一成熟理念的精致化封装,并非颠覆性创新。在Apple Watch已自带类似功能的背景下,AirAlarm必须持续证明其独立存在的价值——即“无穿戴设备”这一极简主义卖点能否形成足够强的用户忠诚度,足以抵御苹果官方功能的迭代侵蚀。其隐私承诺是很好的差异化标签,但若不能将这种“轻量、隐私”的体验转化为社区或口碑的复利效应,很容易在功能同质化中沦为小众工具,最终被平台功能吞没。
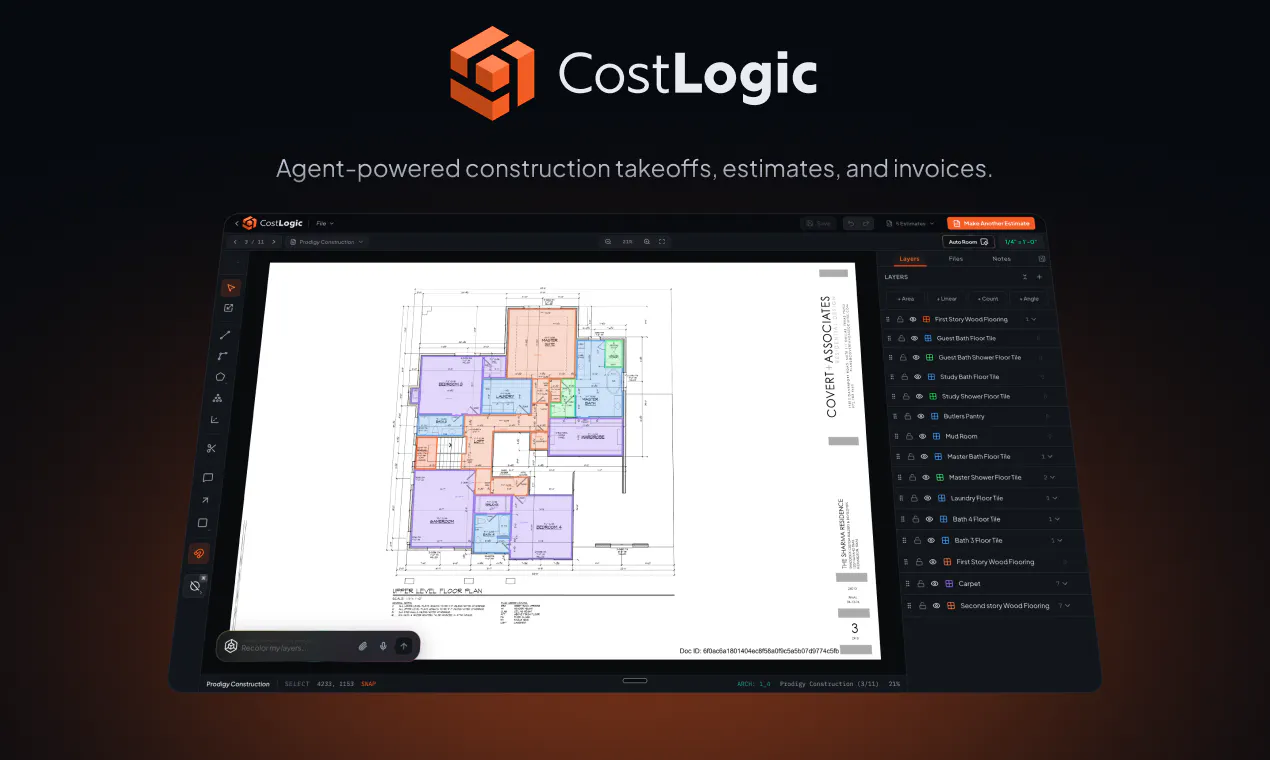
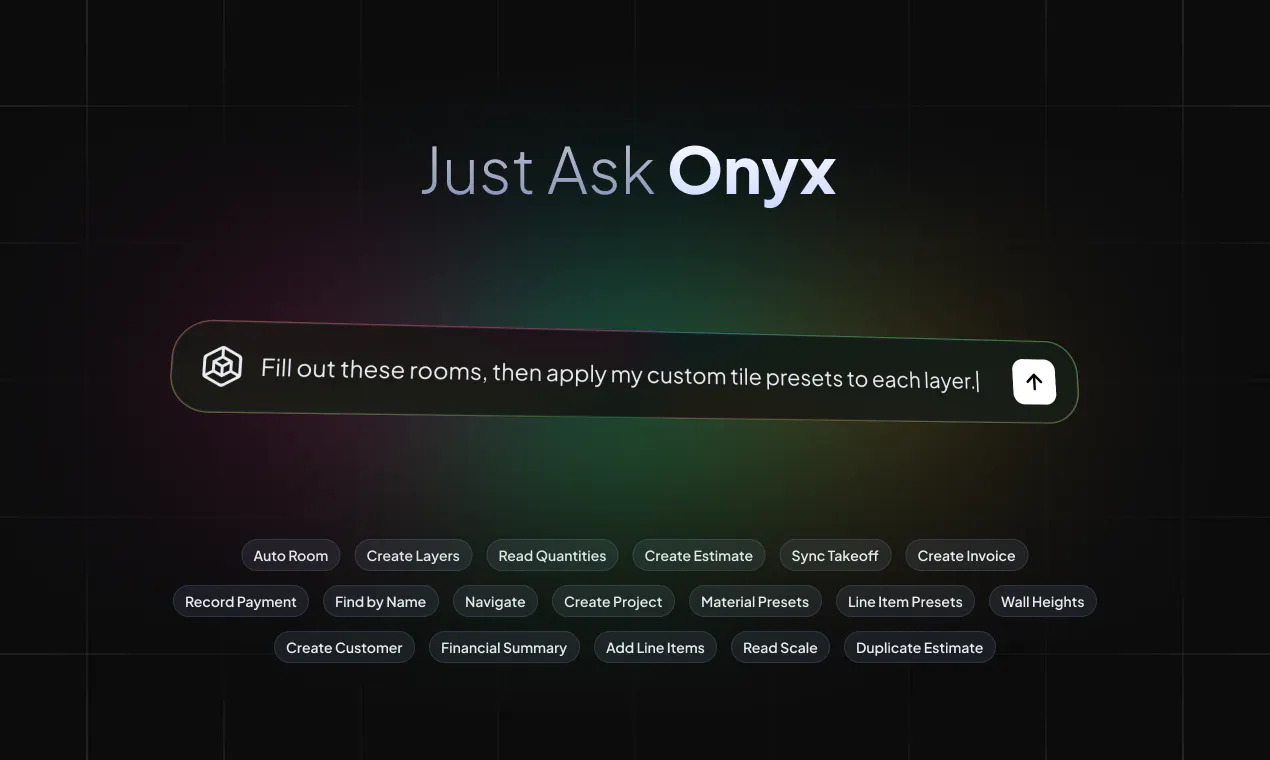
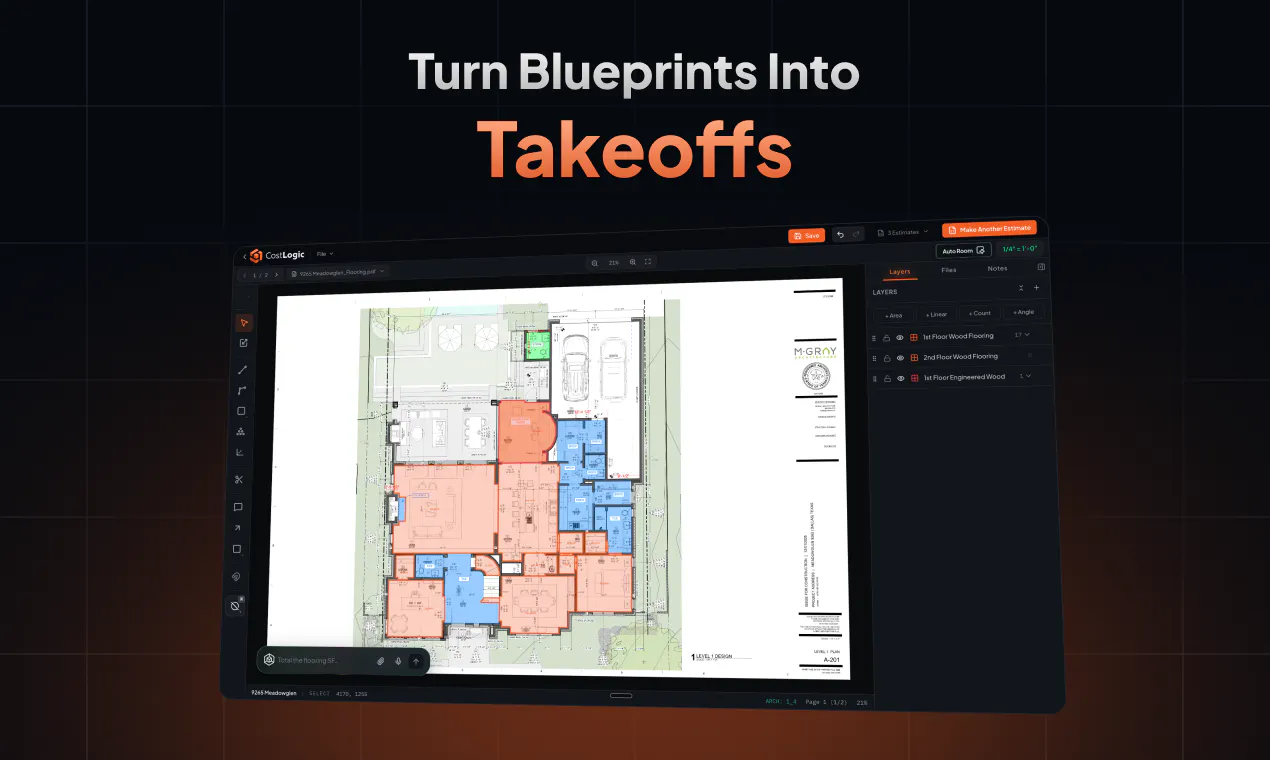
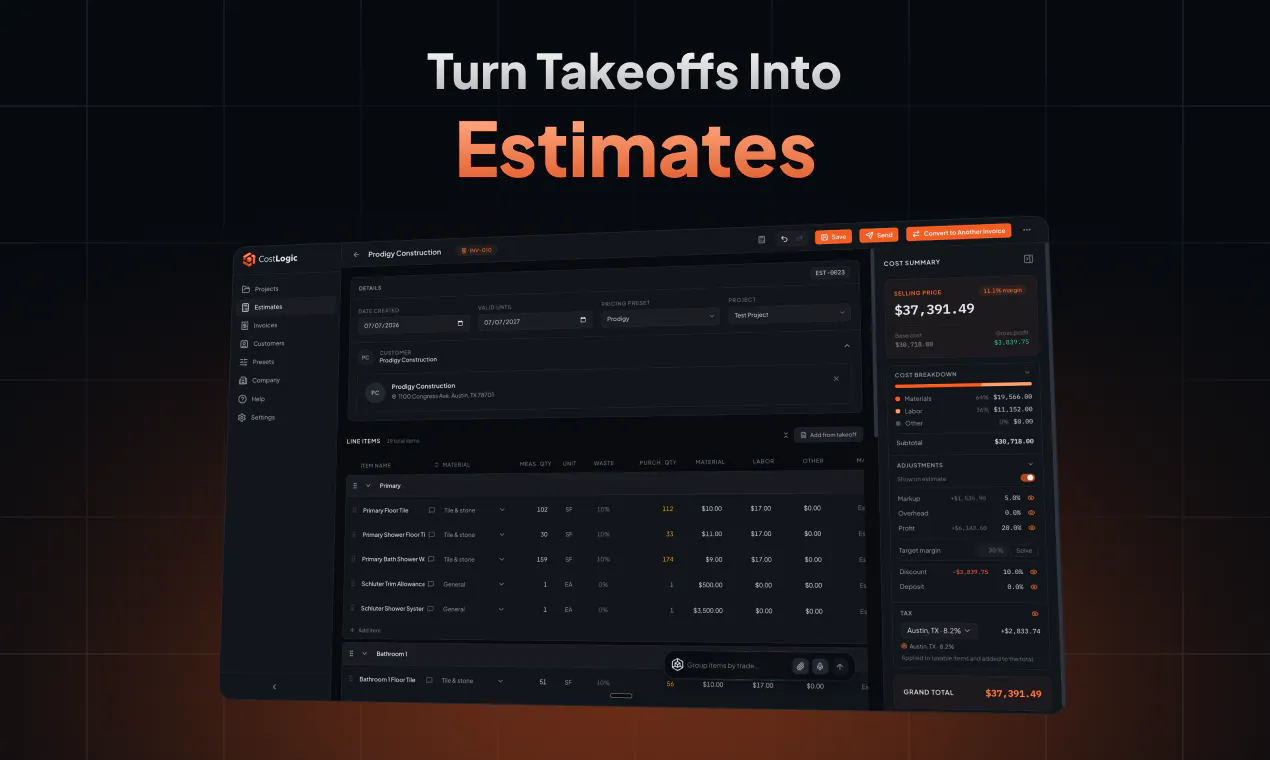
一句话介绍:CostLogic 是一个面向建筑行业的 AI 测量与成本管理平台,通过智能体 Onyx 自动完成从图纸上传、房间识别、尺度校准、工程量计算到报价单与发票生成的全流程,让承包商在同一个浏览器工作区中告别多工具切换,将原本数天的估算工作压缩至几小时甚至几分钟。
Artificial Intelligence
Operations
Construction
建筑科技
AI估算
工程量清单
施工报价
智能体
图纸识别
成本管理
发票生成
云端协作
效率工具
用户评论摘要:创始人强调行业现有工具老旧(2005年级别)或GPT包装易出错,他们致力于“速度与可控性”平衡。回帖用户认可该定位,认为AI应去除繁琐工作但保留人工对关键数字的最终把关,避免引发信任危机,期待产品在估算可靠性上持续突破。
AI 锐评
CostLogic 的切入点是精准的:建筑估算行业长期被两种劣质选择绑架——老旧的桌面软件(如 Bluebeam 的复杂宏)和只会胡诌价格的 GPT 套壳。它的价值不在于“AI 自动算量”这个单点功能,而在于将“算量→估算→发票”这条必须连贯的业务链整合进一个智能体工作流。Onyx 的“替你干活”属性,实际上是针对行业最深的痛点:数据孤岛与人工转录误差。106票虽不算高,但评论区的质量远胜于普通 to C 产品,反映出专业用户的审慎期待。真正的护城河不是模型能力,而是“尺度校准”和“房间识别”这类垂直领域的数据飞轮——越用越准,越准越敢用。但风险同样明显:建筑行业容错率极低,一次 4 万美元的 AI 幻觉足以摧毁客户信任。创始团队明白“保留人工在环”是对的,但如何定义“关键时刻”的交互边界(是每项数字都需点击确认,还是仅在高风险项拦截)将是产品体验的分水岭。如果 CostLogic 能在可追溯性(每个数字来源可查)和审计日志上做到极致,它不仅能替代工具箱,更可能成为建筑承包商的财务操作系统。当前唯一的问题是:它能否避免成为又一个“演示惊艳、落地拉胯”的 AI 精益创业案例。建议团队尽快公开一组与人工估算误差对比的基准测试,用数据消除专业用户的怀疑。
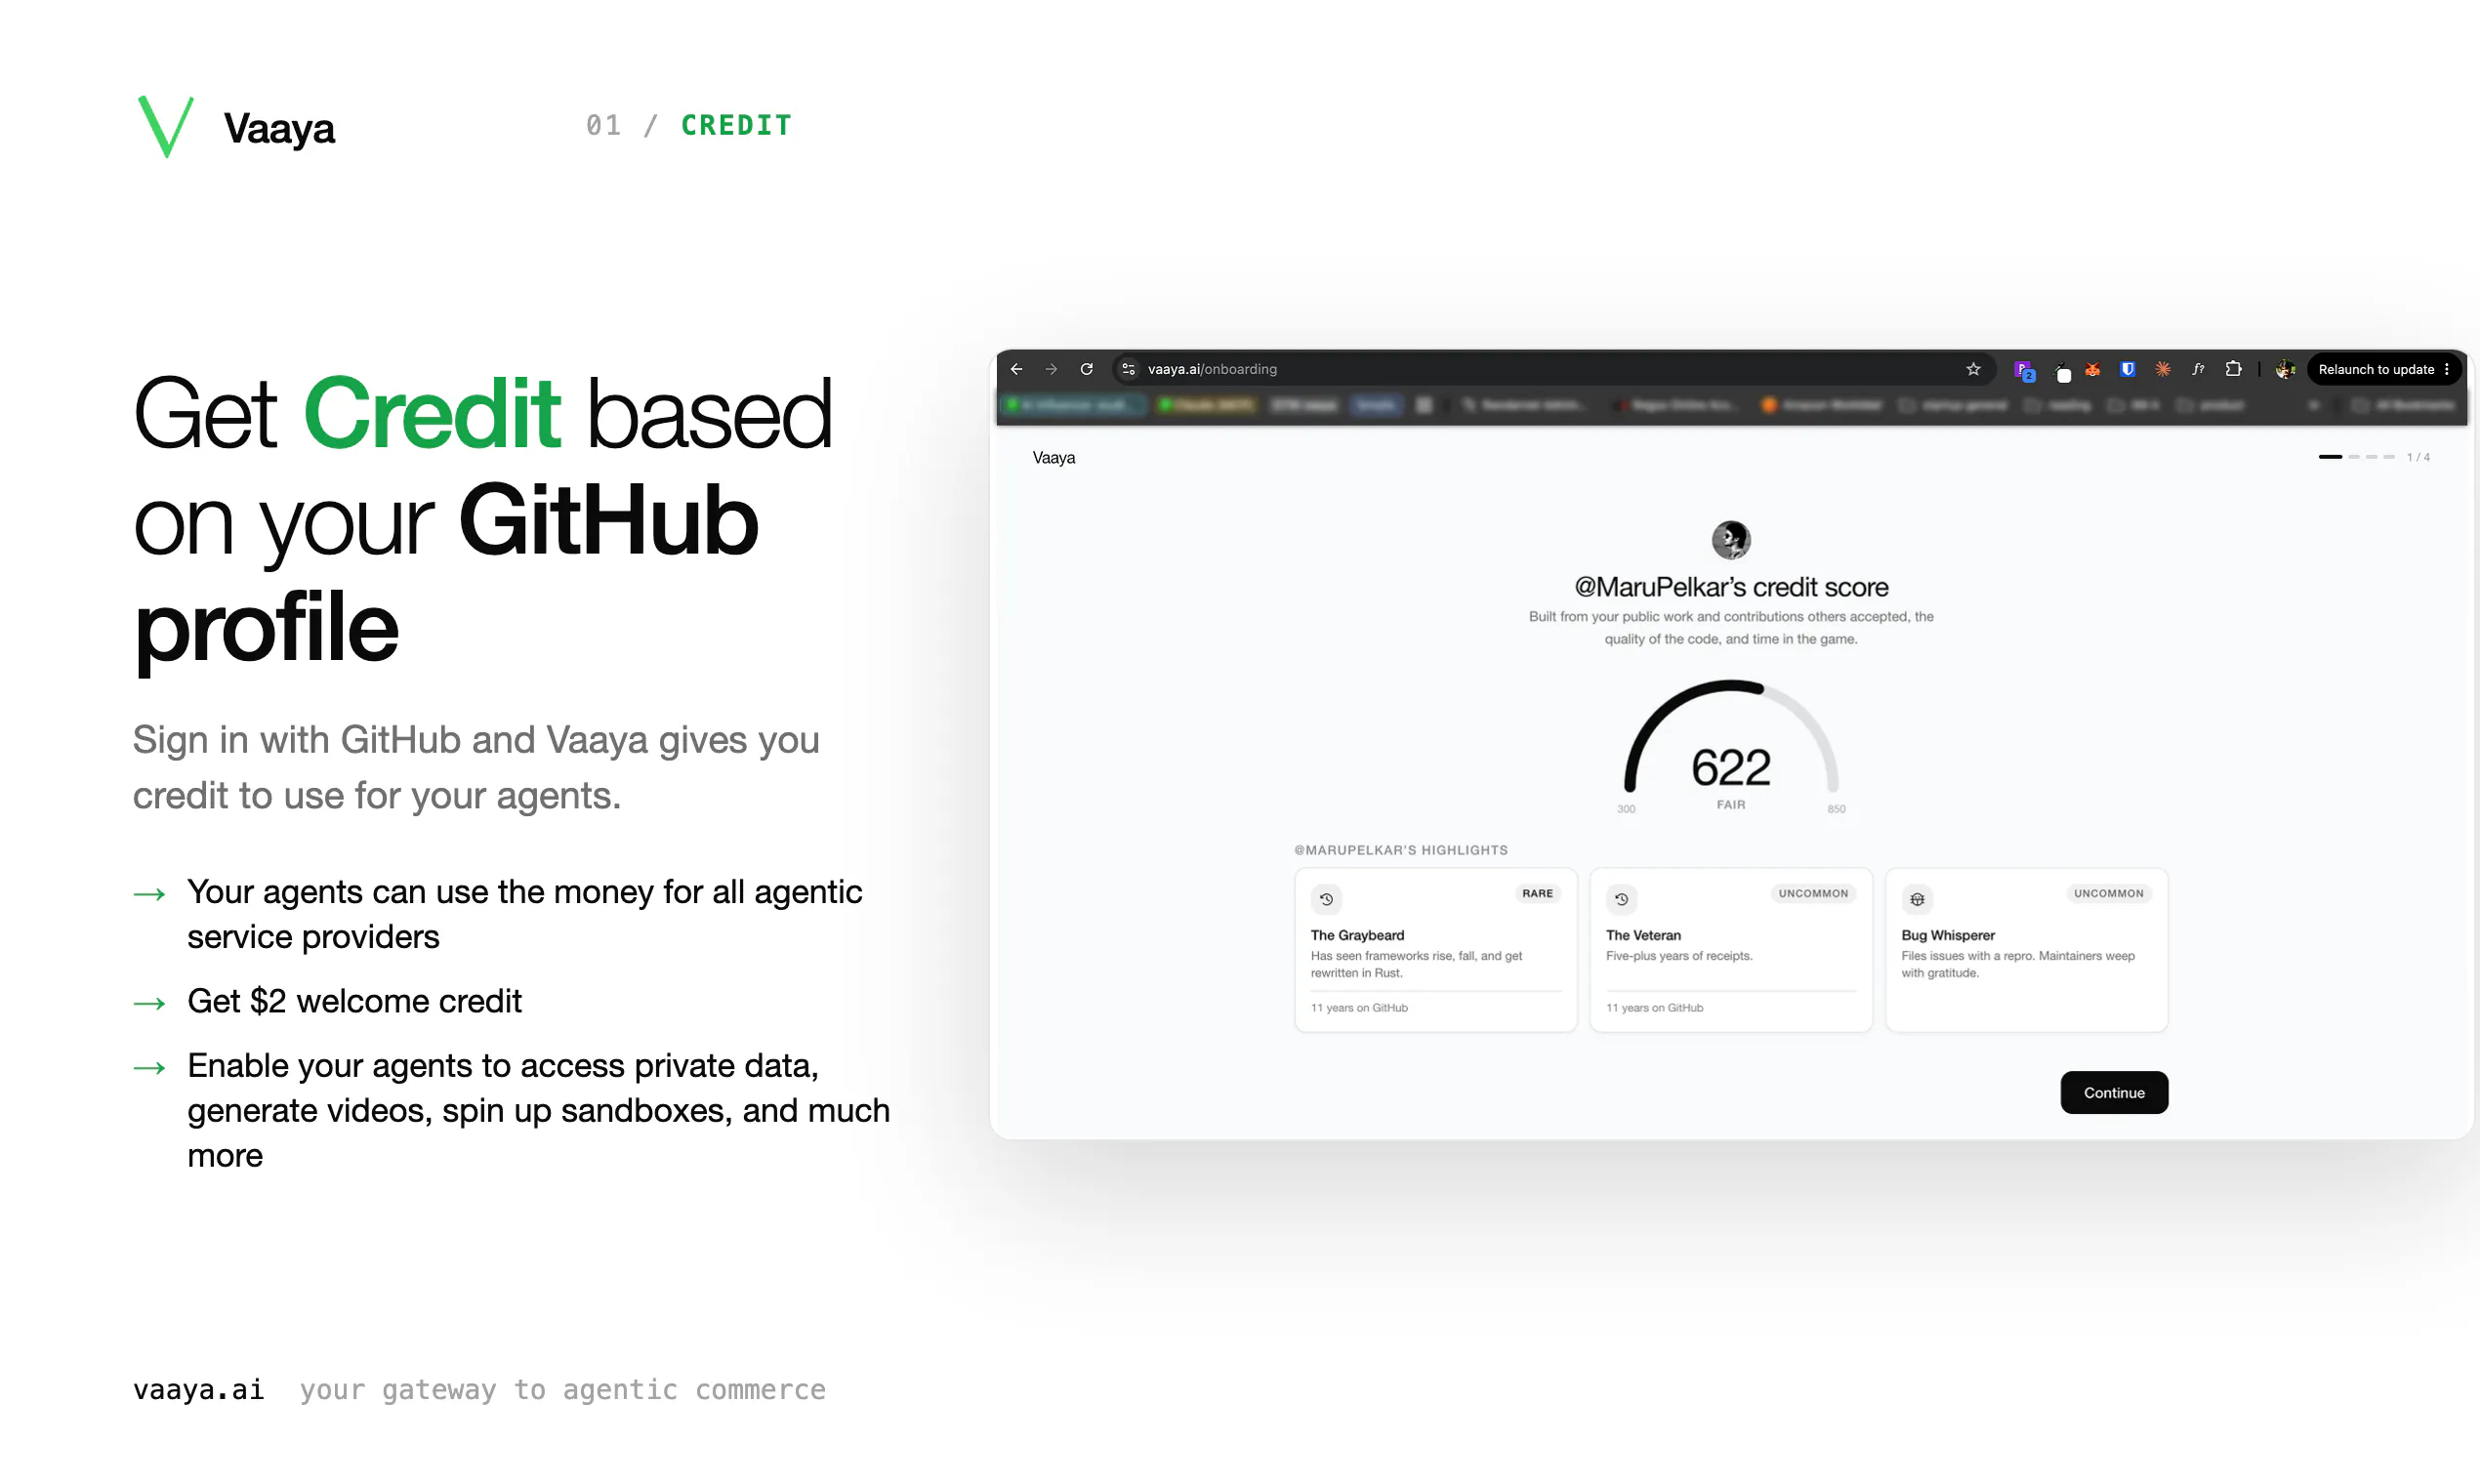
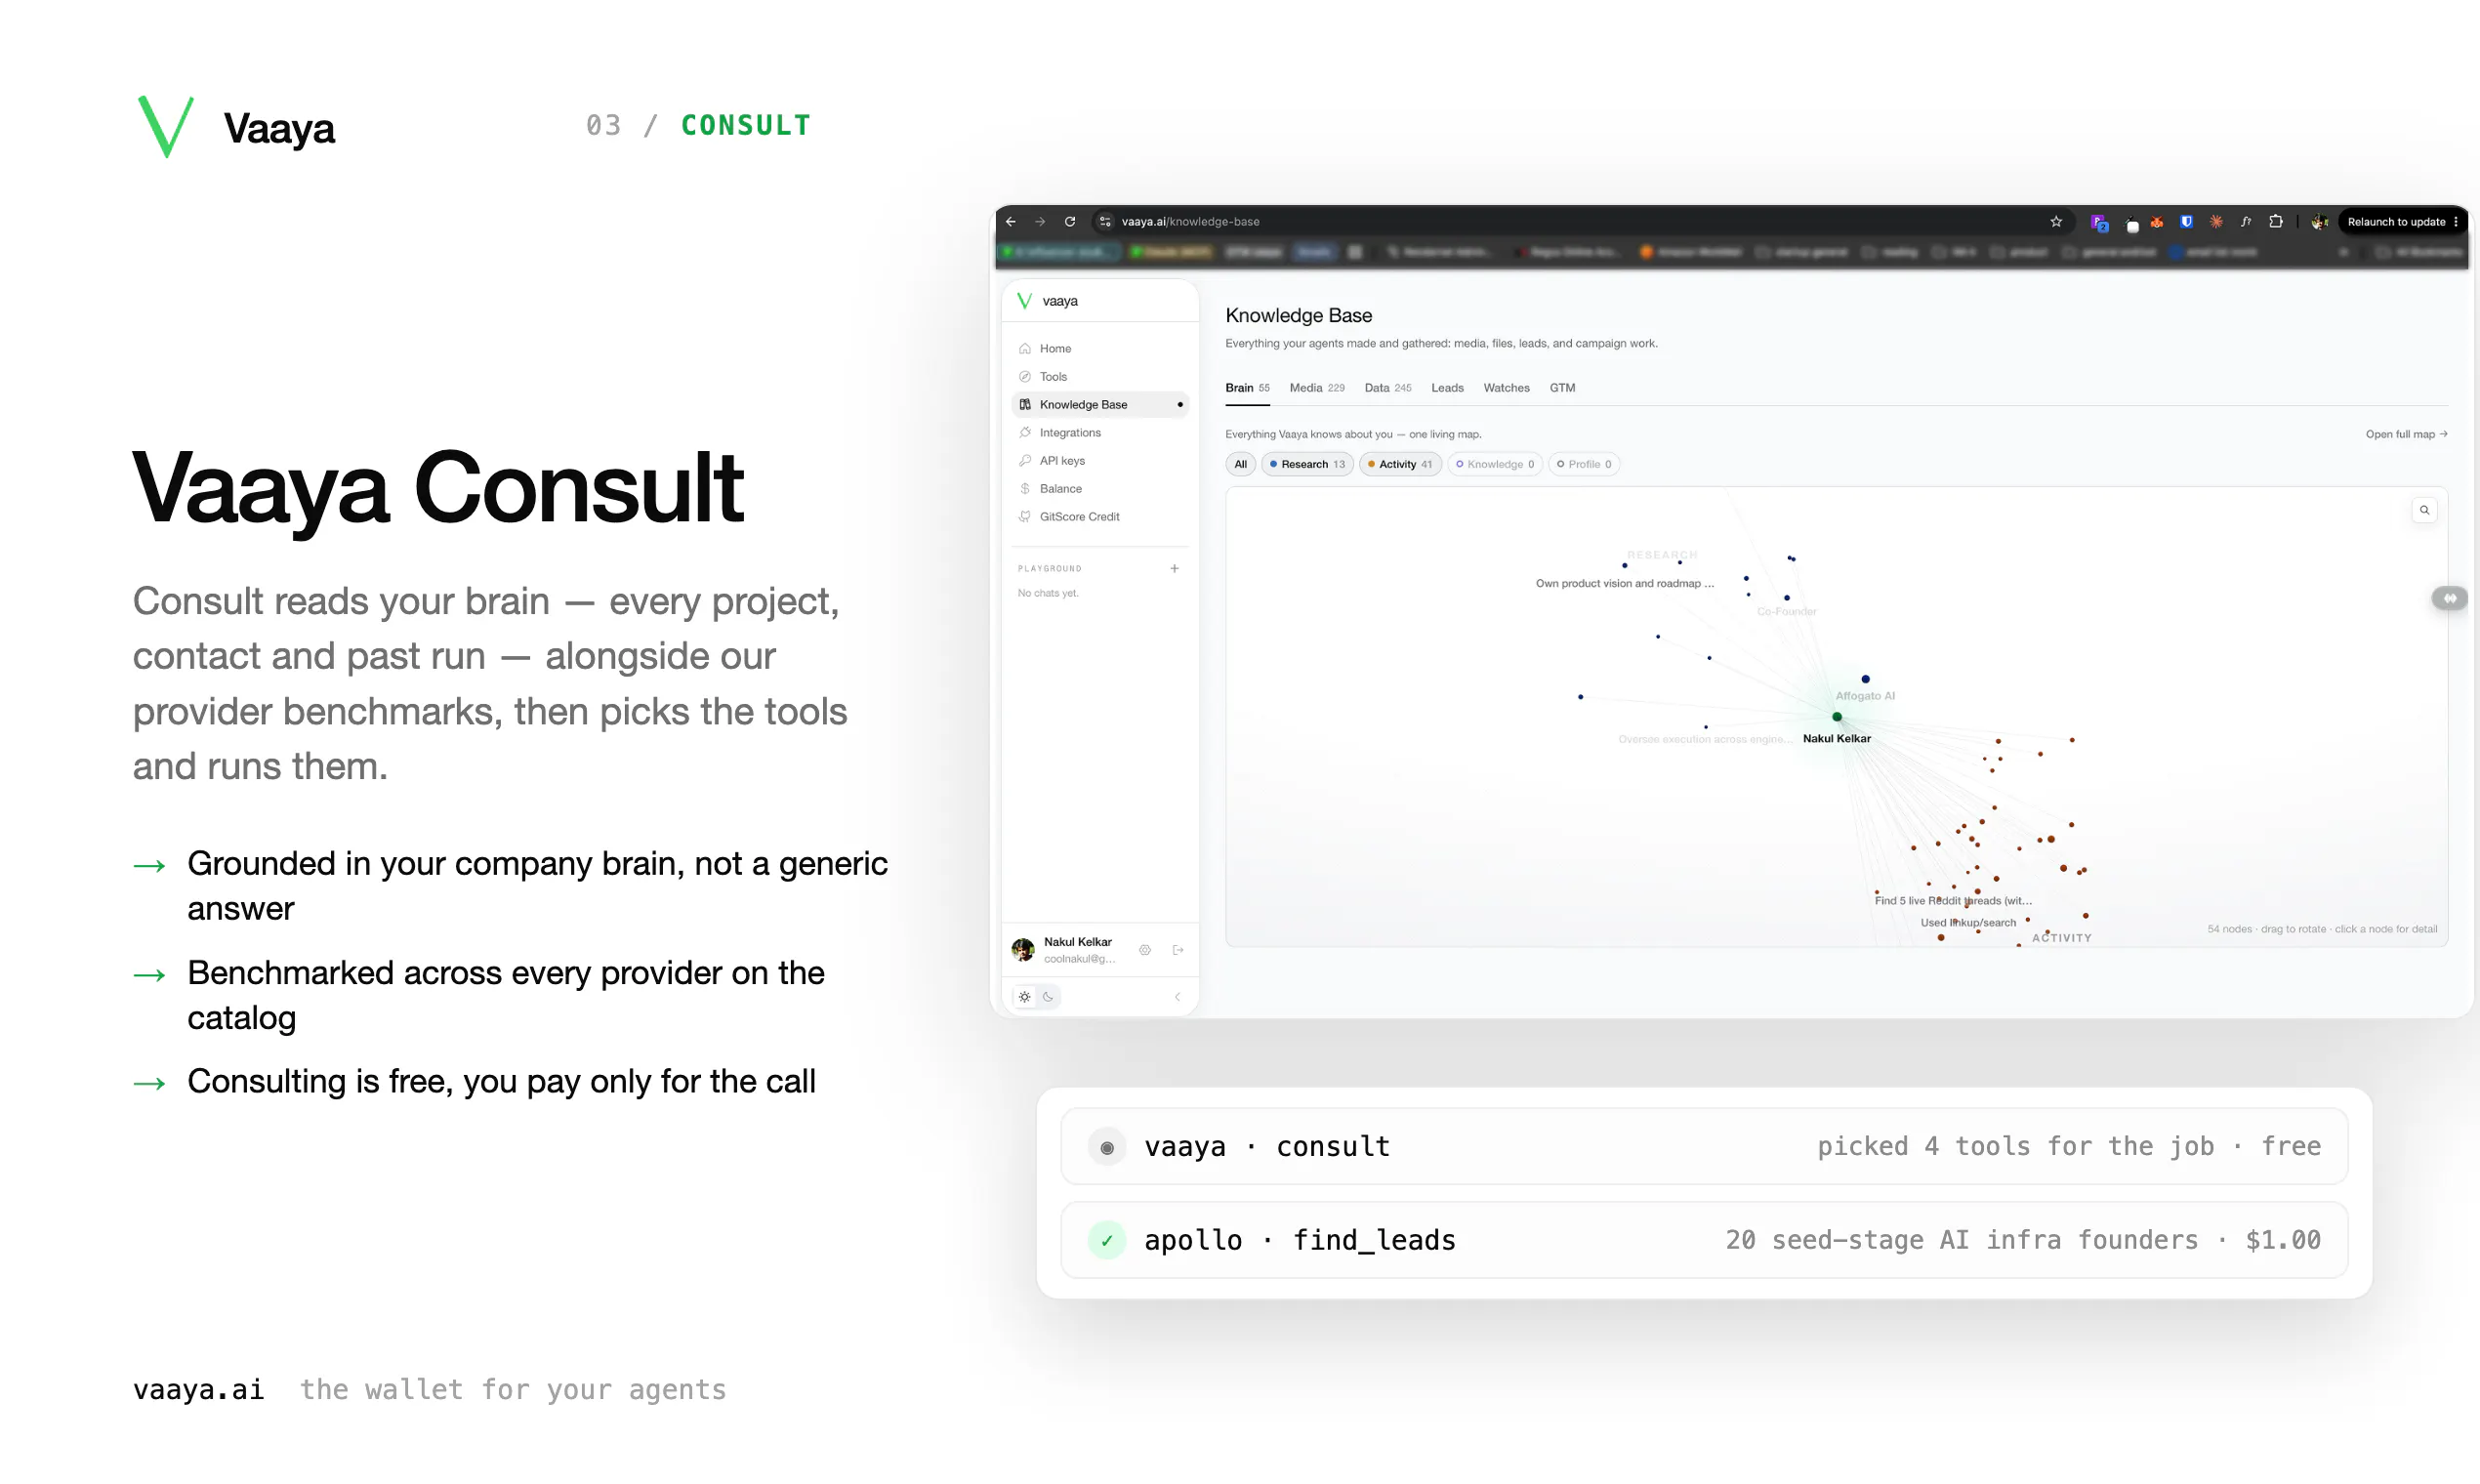
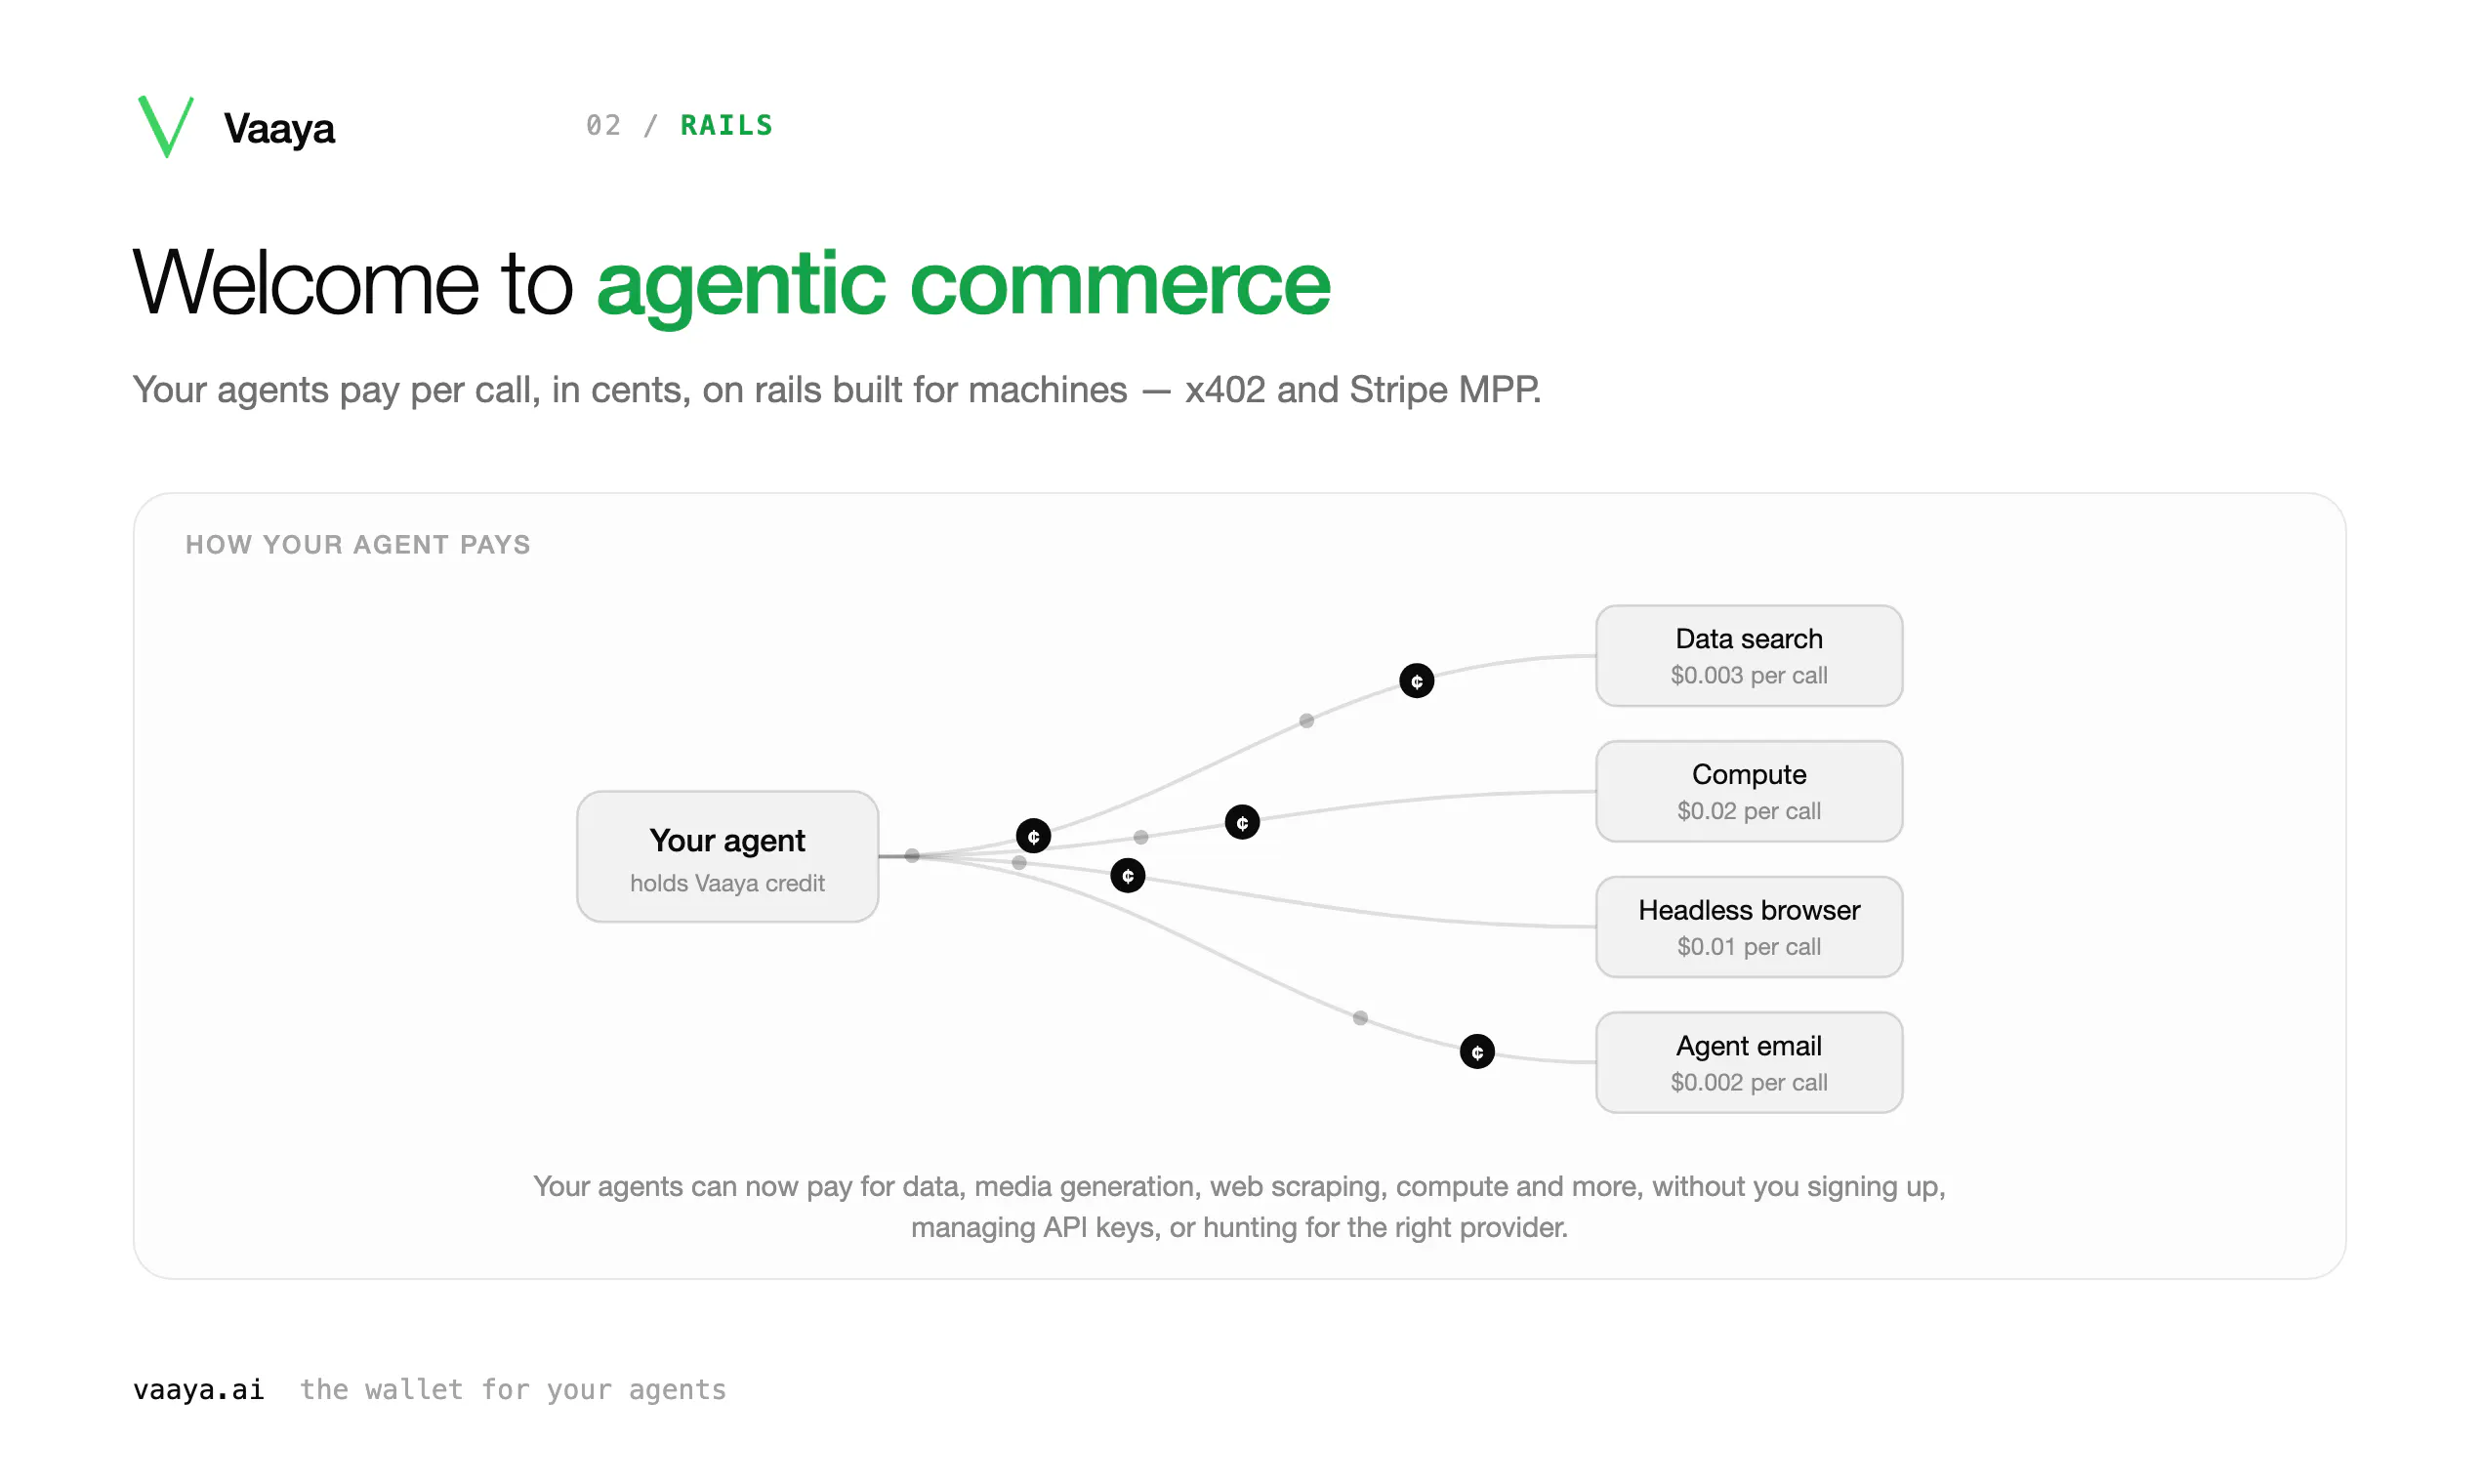
一句话介绍:Vaaya 将开发者的 GitHub 资料转化为代理(Agent)的信用额度,提供统一的 MCP 接口,让 AI 代理无需预充值即可调用超过 1400 个付费工具与服务。
Payments
Developer Tools
GitHub
代理支付
信用评分
MCP
AI Agent工具
开发者基础设施
无预充值
x402
身份认证
金融科技
自动化工作流
用户评论摘要:用户认可创意并惊叹于实际应用(如自动支付图形生成)。核心质疑集中于信任模型:GitHub 身份可伪造或租用,存在刷高额度后赖账风险;另有开发者询问如何处理不在 x402 或 Stripe 协议内的服务商。
AI 锐评
Vaaya 的实质是给 AI Agent 装上一张“信用卡”,试图解决代理经济的最后一块短板——支付。将 GitHub 作为信用背书是个讨巧且低门槛的增长策略,但正如用户犀利指出,这是建立在流沙上的风控模型。GitHub 档案的廉价可制造性决定了它只能作为冷启动的引子,而非信用锚点。创始人在回复中承认了这一点,并揭示了真正的算法:以“消费-还款”的历史记录来构建代理的 FICO 分。这才是 Vaaya 真正的护城河,也是其隐藏在“工具聚合”表象下的金融野心。短期看,1400+ 工具是诱饵,用于吸引开发者产生真实消费行为;长期看,它是在收集代理的信用数据,试图成为代理经济中的征信局。其潜在风险在于,如果“先消费后结算”的模式无法跑通,坏账率会迅速吞噬利润,同时严格的卡门禁(Card-gated)策略也限制了其宣称的“无摩擦体验”。这并非一个简单的开发者工具,而是一场围绕代理数据与信用评估的金融博弈,值得持续关注其风控模型的演进。
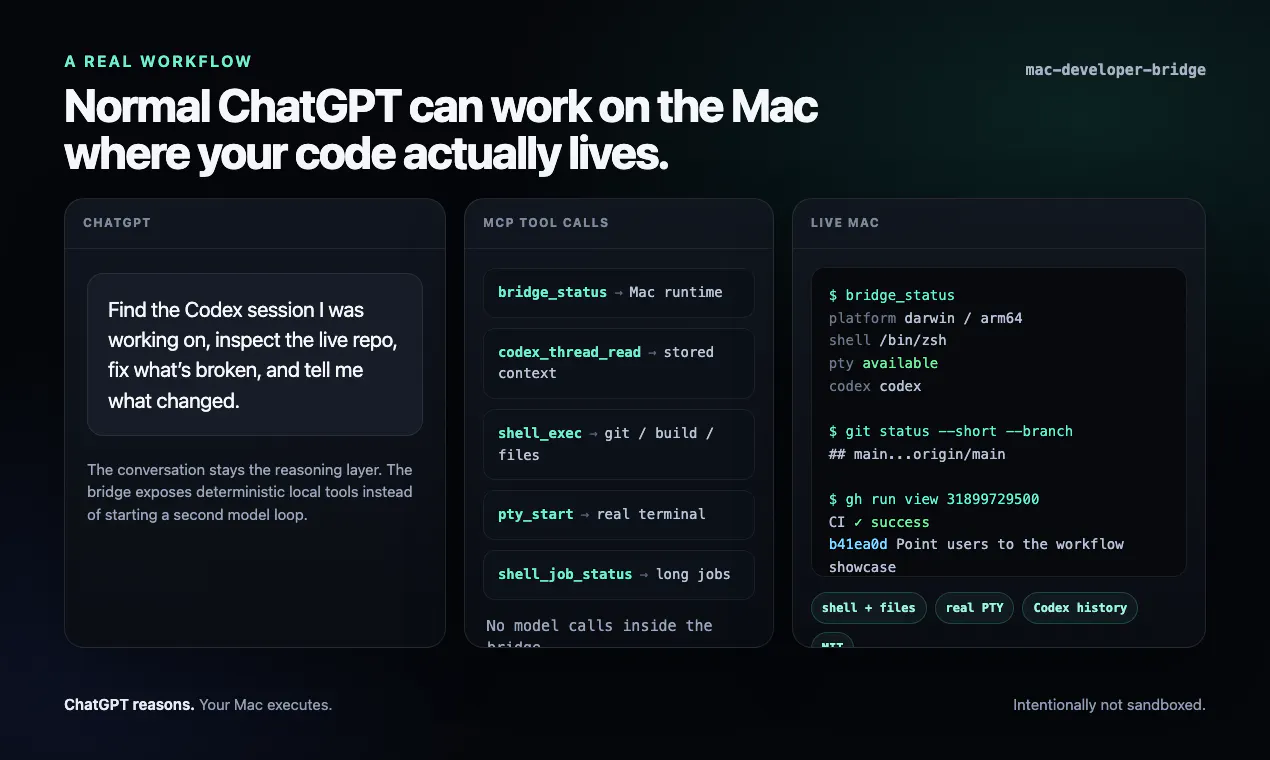
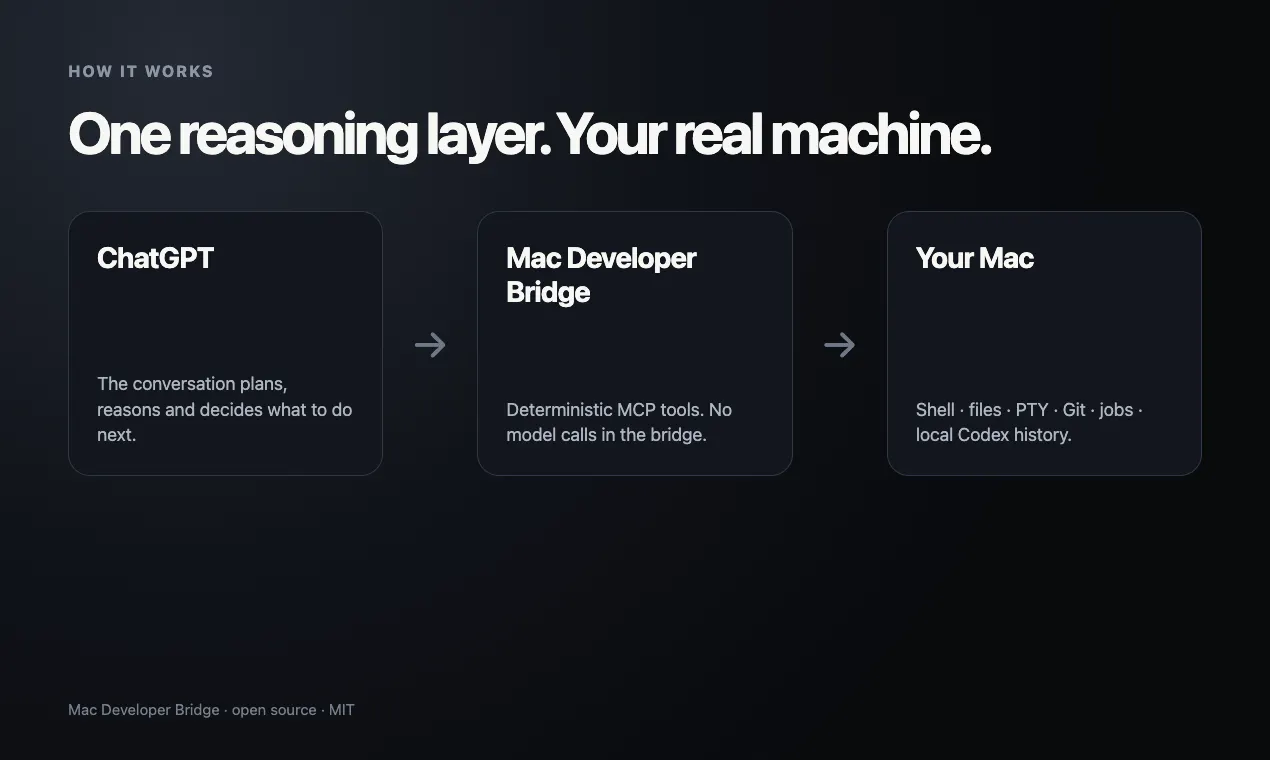
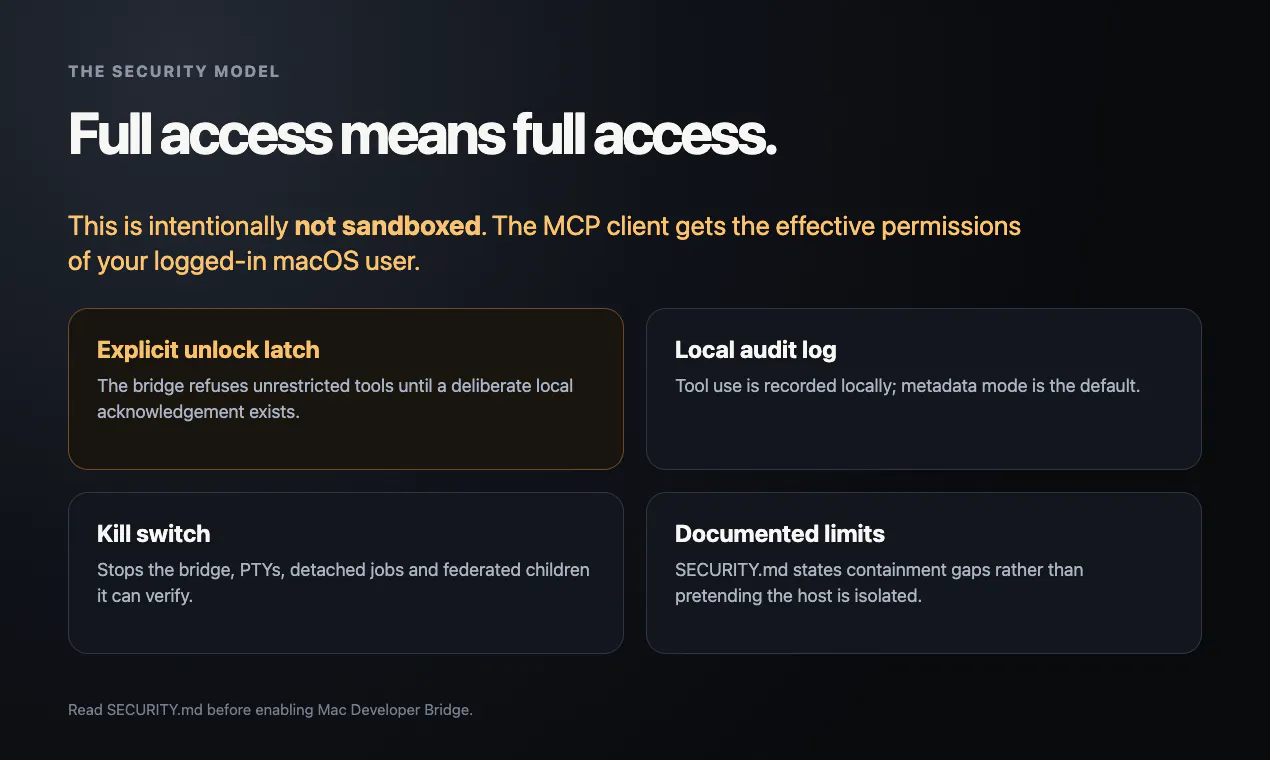
一句话介绍:Mac Developer Bridge 是一款开源 MCP 桥接工具,让 ChatGPT 能直接操作你 Mac 上的真实终端、文件系统和后台任务,摆脱“人工复制粘贴”的低效循环。
Mac
Open Source
Developer Tools
开发者工具
MCP服务器
AI终端控制
开源
本地自动化
PTY会话
文件系统访问
Codex集成
无沙箱
安全审计
用户评论摘要:用户认可开源属性和“ChatGPT做大脑、Codex做手脚”的架构分工,并确认其核心价值在于免去手动搬运prompt和输出。但暂无负面或使用细节反馈,仅对安全模型表示谨慎关注,未暴露具体痛点。
AI 锐评
Mac Developer Bridge 的价值不在“给 ChatGPT 一个终端”这个表面功能,而在于它重新定义了 AI 协作中的职责边界:让推理与执行彻底解耦。它精准击中了高级开发者最烦躁的环节——在多个 AI 工具间来回搬运上下文和命令,本质上是把“人肉胶水”替换成了协议。但它的激进之处也恰恰是致命弱点:“非沙箱”设计意味着一旦 ChatGPT 的推理被恶意 prompt 注入,你的 Mac 就是裸奔的。虽然作者提供了 kill switch 和审计日志,但这只是缓解而非解决,它把安全责任全数推给了用户,这在企业或生产环境中几乎不可接受。此外,14 个投票和仅一条评论说明它仍属极客玩具,距离“开发者默认工作流”尚远。真正的考验在于:当 Codex 或 Claude 原生支持持久化终端操作时,这种第三方桥接的生存空间会被迅速挤压。它现在更像一个精致的概念验证,而非可持续的产品。对于个人开发者,它值得尝试;对于团队,请三思后行。
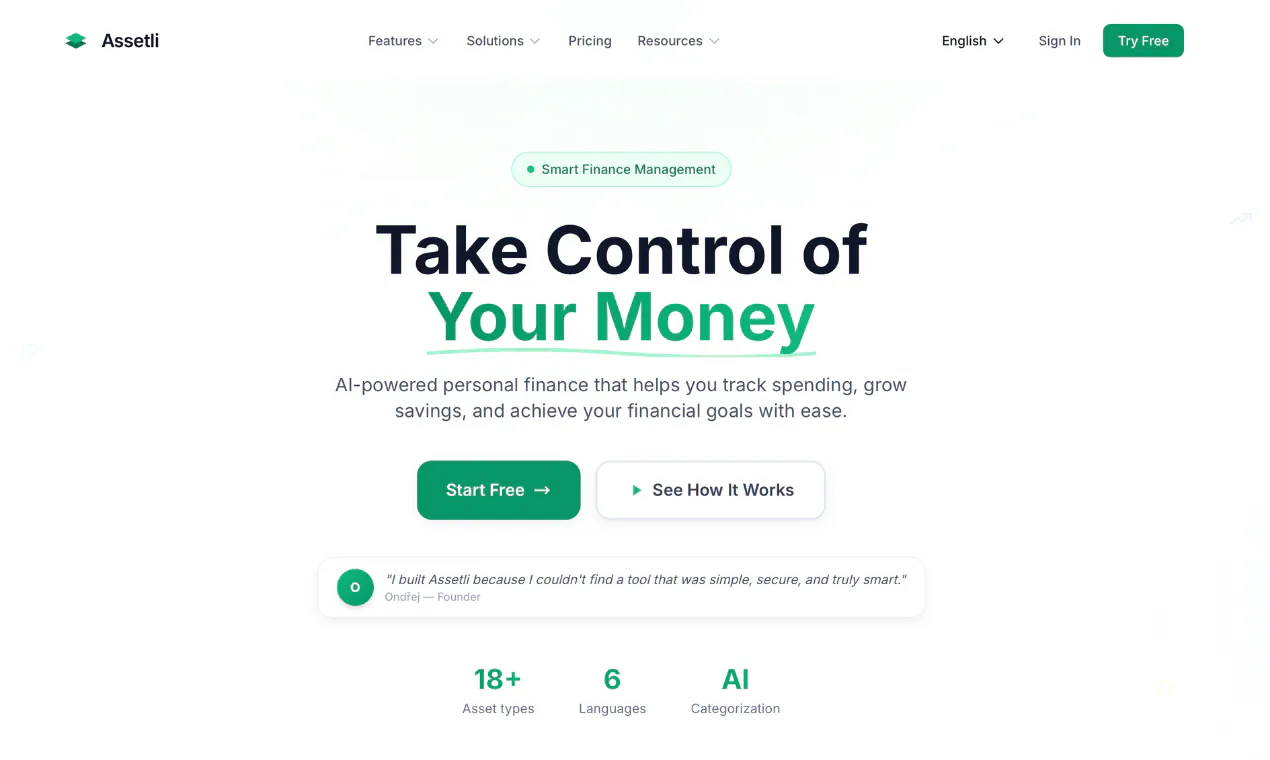
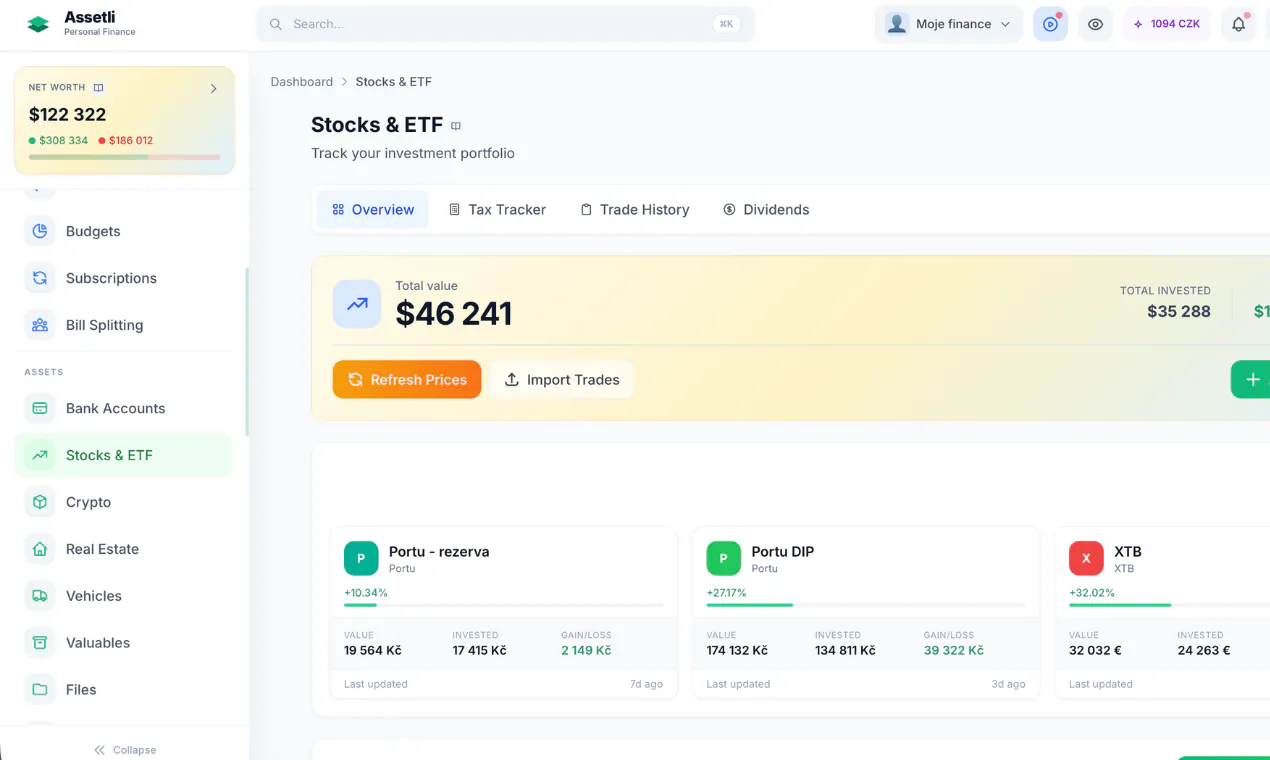
一句话介绍:Assetli是一款无需强制绑定银行账户、支持通过CSV/PDF导入数据,并能直连Claude或ChatGPT(经MCP协议)让AI读取及更新个人财务与净资产数据的记账工具,旨在解决“安全顾虑”与“复杂数据整理”之间的两难痛点。
Fintech
Artificial Intelligence
Personal Finance
个人理财
净资产追踪
AI集成
MCP协议
手动导入
多资产类别
FIRE计算器
隐私安全
独立开发者
订阅制替代
用户评论摘要:目前仅有一条来自开发者本人的介绍性评论,无其他用户有效提问或建议。核心信息聚焦于AI集成功能与隐私安全设计,有待后续用户实测反馈验证。
AI 锐评
Assetli的12票和唯一一条开发者自述评论,使其更像一个“概念验证”而非成熟产品。其核心卖点“让AI用你的数据”确实切中了当前金融App“只读不智”的痛点——多数应用把数据锁死在面板里,而MCP协议接入Claude/ChatGPT是首个真正实现“双向操控”的务实尝试(AI不仅能看,还能改账),这比那些徒有其表的“AI记账分类”高出一个维度。
但锐评必须指出三点硬伤:其一,**数据导入是双刃剑**。CSV/PDF导入虽规避了银行API的安全红线,但也将繁重的“账目整理”成本转嫁给用户。对普通用户而言,每月手工整理对账单的摩擦成本,足以使活跃度在两周内断崖式下跌——这几乎是所有“手动记账”类产品的宿命。其二,**“AI更新账目”是危险裸奔**。允许LLM直接写入财务数据,一旦AI因上下文污染或工具误调用产生错误写入,其溯源与纠错成本极高。开发者未展示任何“AI操作审计日志”或“写前确认机制”,这在金融场景中属于合规与体验的双重缺失。其三,**生态位尴尬**。它既不如Copilot Money等自动化工具便捷,又不如纯Excel灵活,唯一差异化的AI MCP接口,目标用户是“会搭MCP的高阶玩家”——这群人更可能自己写脚本,而非用一个12票的早期产品。
真正的价值点在于:它证明了一个轻量级、隐私优先的“AI-CFO”本地化方案是可行的。如果开发者能将CSV/PDF解析做成“智能纠正+一键确认”的AI流程,并给AI写入操作加上像Git一样的版本回滚机制,同时强化FIRE/房贷计算器的决策联动,或许能在“自动化巨头”与“手动硬核用户”之间的夹缝中,找到一批忠实的隐私敏感型高净值用户。否则,这将又是一款开发者自嗨的“个人作品集”项目。
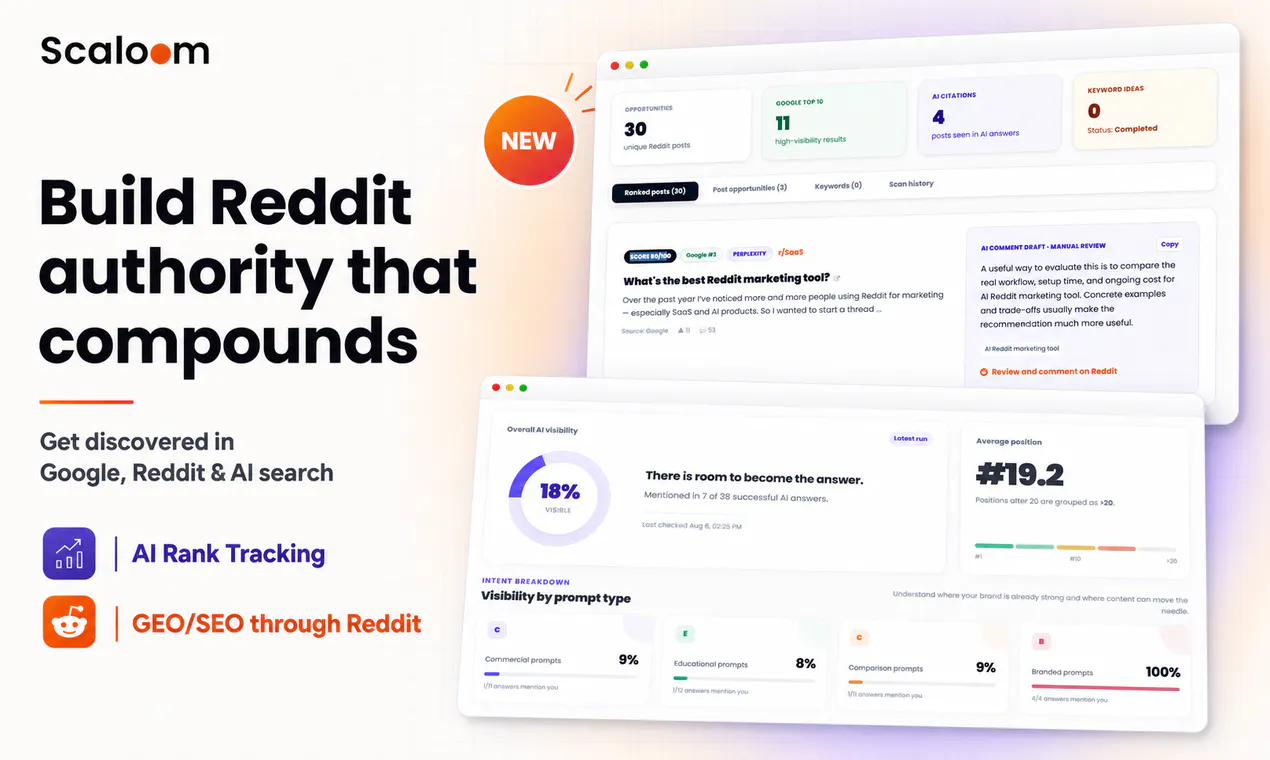
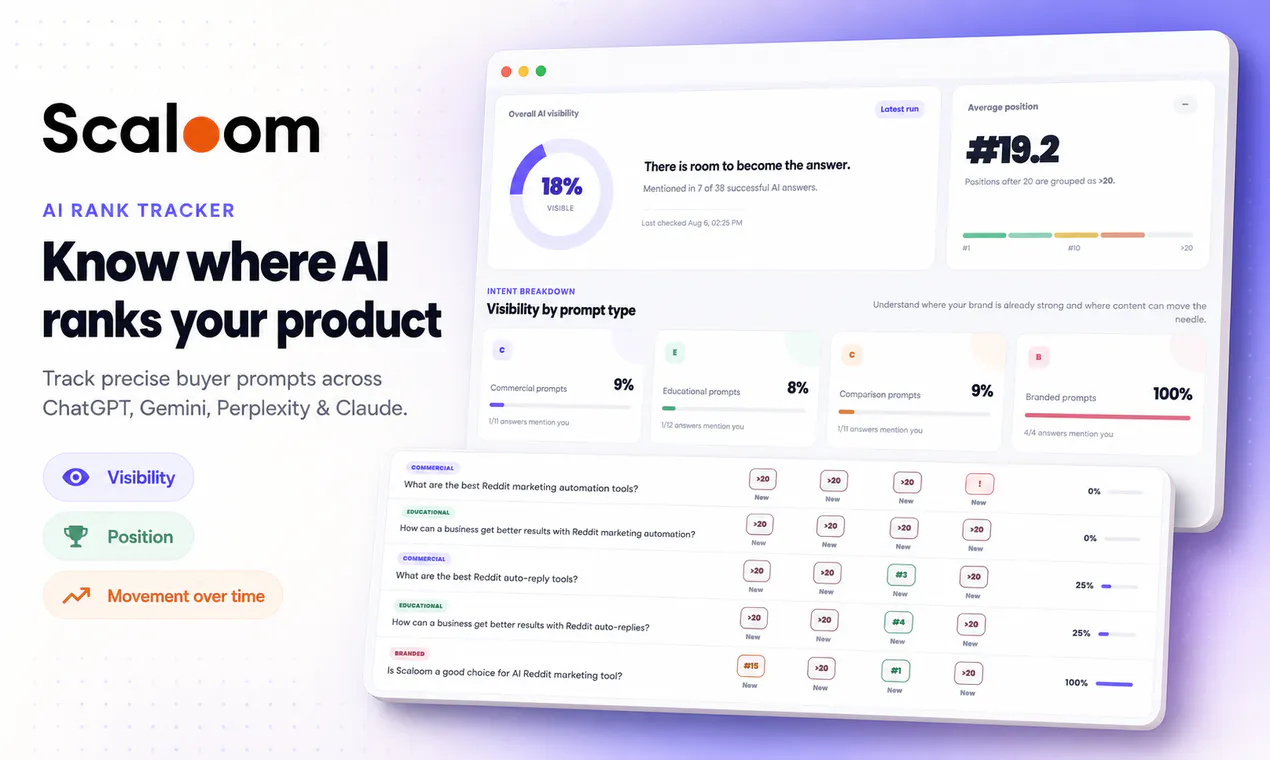
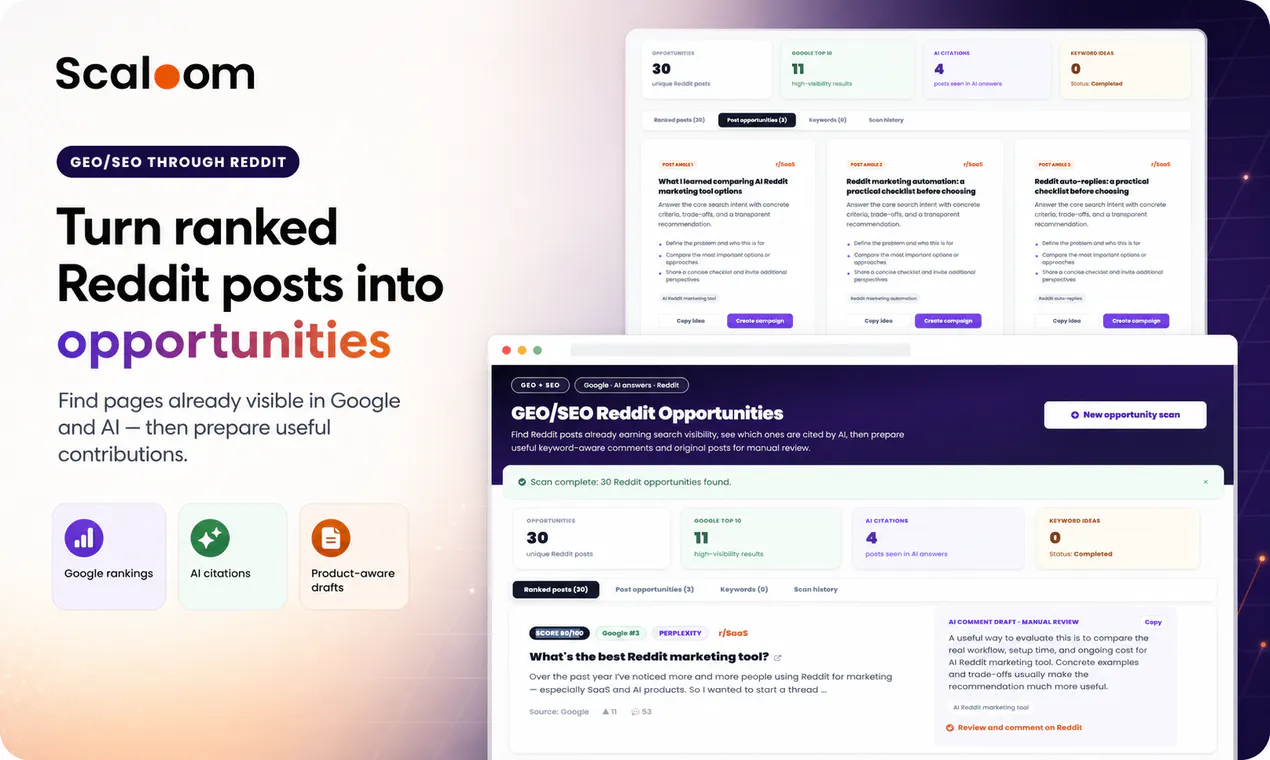
一句话介绍:Scaloom是一款AI驱动的Reddit营销平台,帮助创始人通过养号建立信任、发现高相关讨论并生成人工审核的回复,从而将Reddit转化为可被Google及AI搜索引擎收录的流量获取渠道,解决品牌在Reddit上冷启动难和搜索可见性低的痛点。
Marketing
Artificial Intelligence
Social media marketing
Reddit营销
AI营销工具
账号养号
品牌监测
GEO优化
SEO工具
AI搜索优化
社区运营
创始人工具
搜索引擎可见性
用户评论摘要:目前仅有一条创始人发布的介绍性评论,无用户反馈或建议。评论内容主要阐述产品从养号工具升级为“Reddit到搜索可见性”平台的逻辑,并邀请用户对AI可见性追踪和GEO/SEO功能提出意见,属产品自述而非有效用户反馈。
AI 锐评
Scaloom踩中了两个看似性感的趋势:Reddit的流量价值重估,以及AI搜索对内容来源的偏好。逻辑上,它试图把“Reddit营销”从玄学变成工程——养号防封、找已排名帖子、追踪ChatGPT/Perplexity的引用,这确实是很多独立开发者和中小品牌刚需。但问题同样刺眼:第一,Reddit官方对自动化营销的打击越来越严,任何“养号”工具都游走在封号边缘,Scaloom把“安全”当卖点,本质是平台对抗的灰色生意,风险极高。第二,投票数仅8,评论为零用户反馈,说明产品尚在早期,所谓“AI回复”和“多引擎追踪”大概率是浅层API调用加规则匹配,深度和准确性存疑。第三,它强调“帮助品牌被AI搜索引用”,但GEO(生成式引擎优化)目前并无成熟方法论,Scaloom更多是提供监控仪表盘而非增长引擎,价值停留在“看见问题”而非“解决问题”。真正务实的定位应该是:作为Reddit内容策略的辅助分析工具,而非自动营销黑科技。如果无法解决Reddit封号风险,以及证明其AI回复能真实带来有效流量,这产品最终只会沦为一款昂贵的“数据监控面板”。建议团队优先打磨合规性,并拿出可复现的案例证明“Reddit帖子→Google排名→品牌曝光”的转化链路,否则难以说服精明的Reddit用户群。
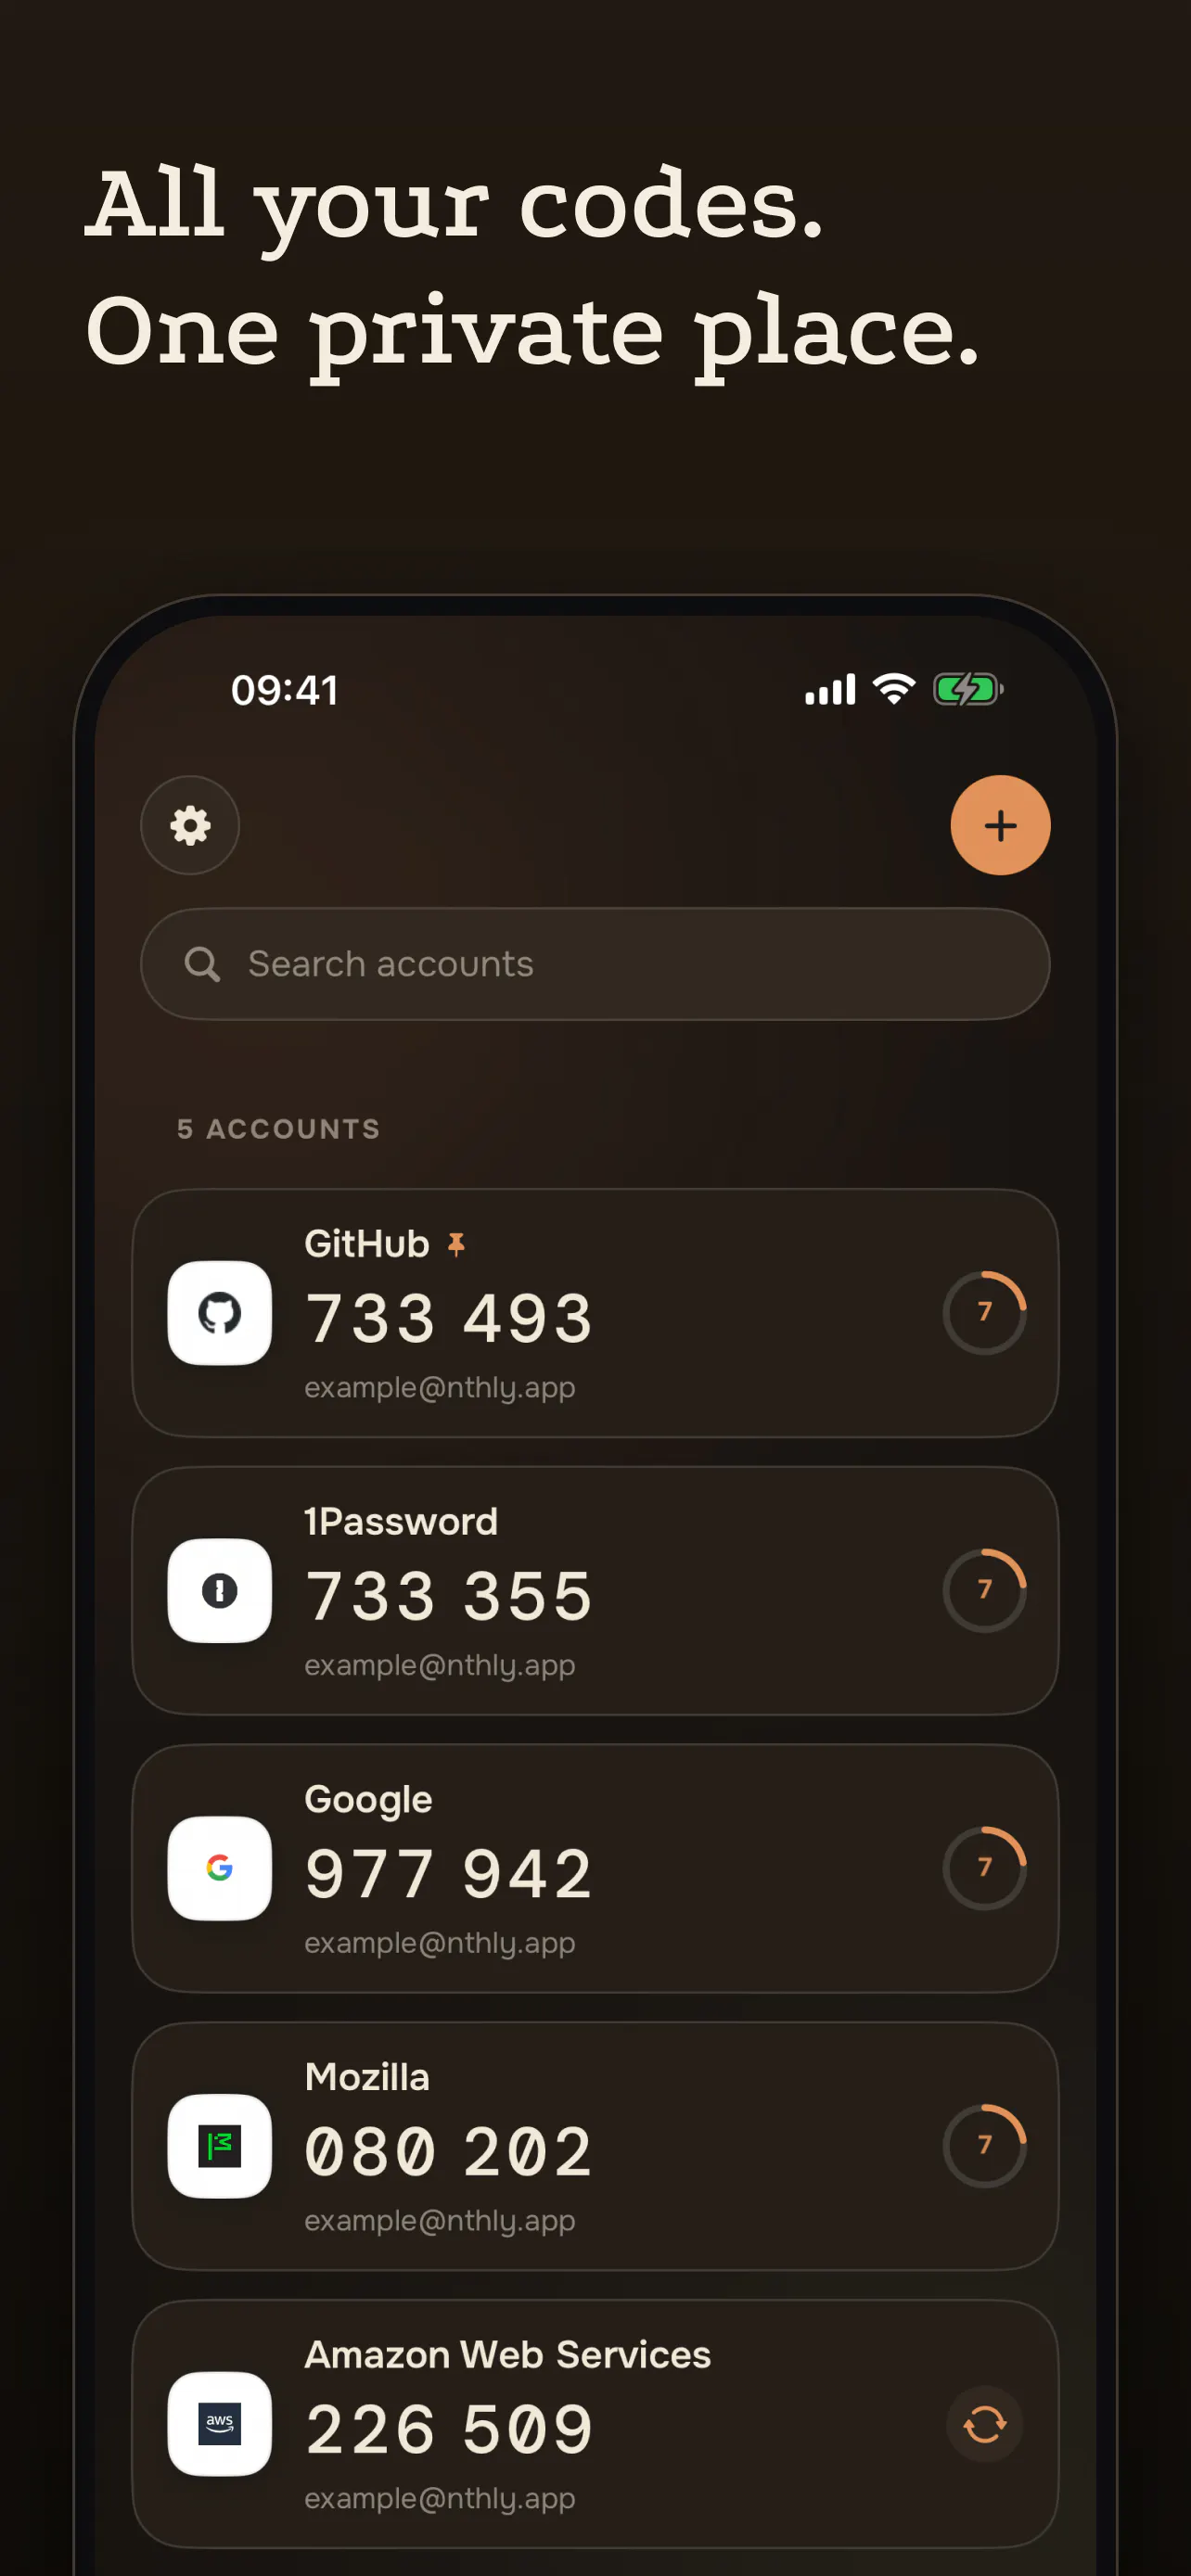
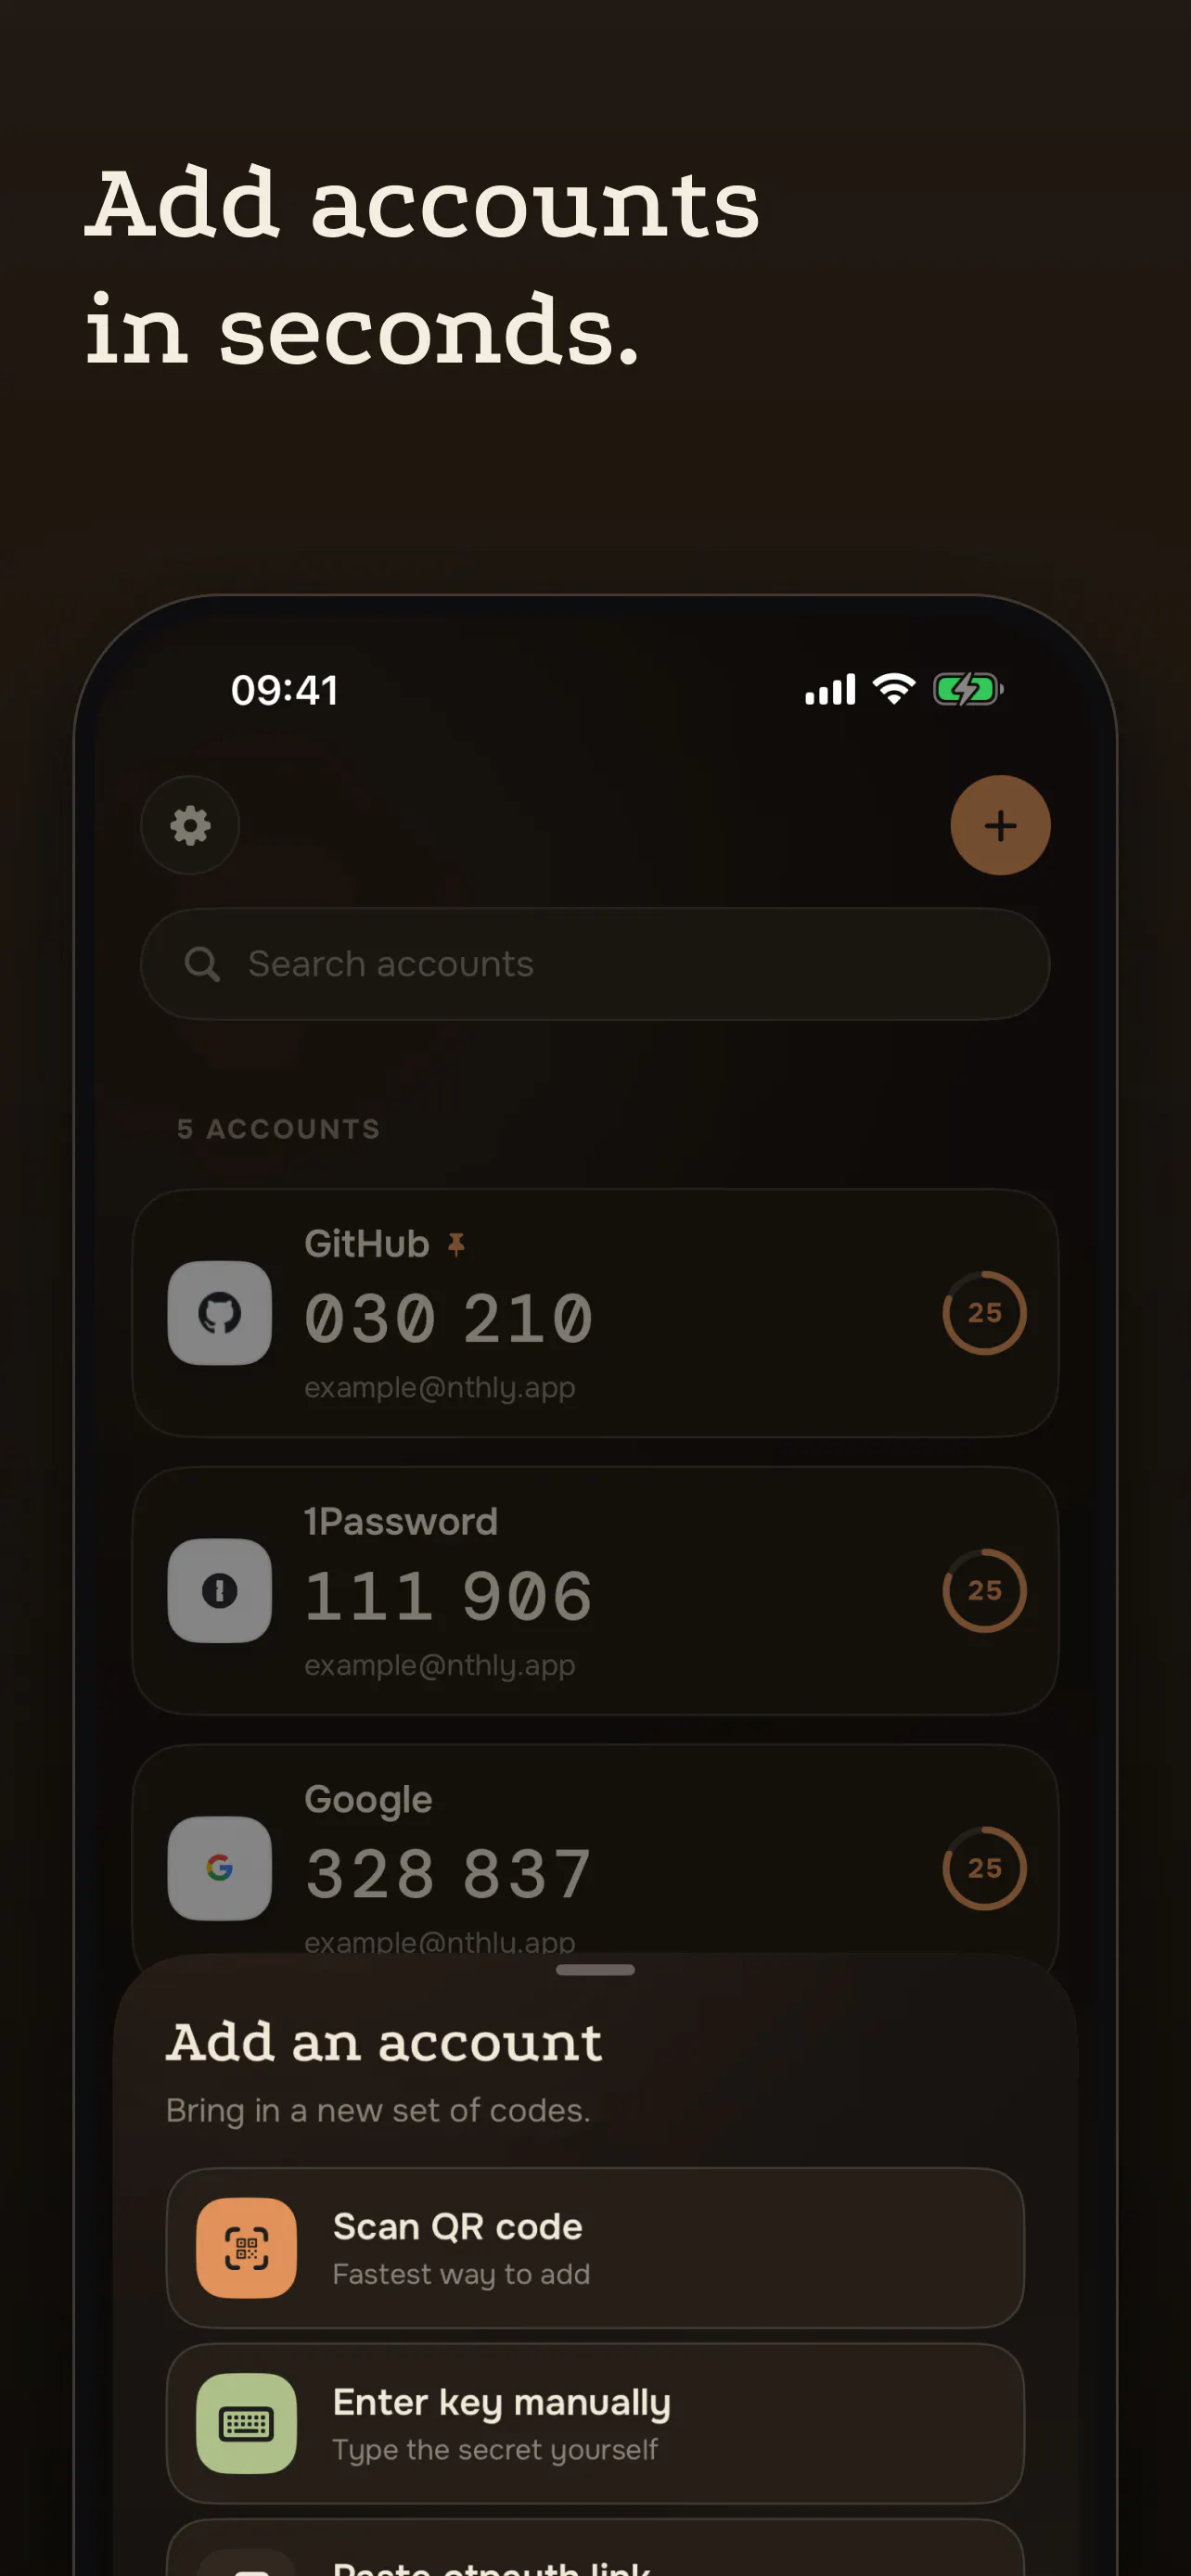
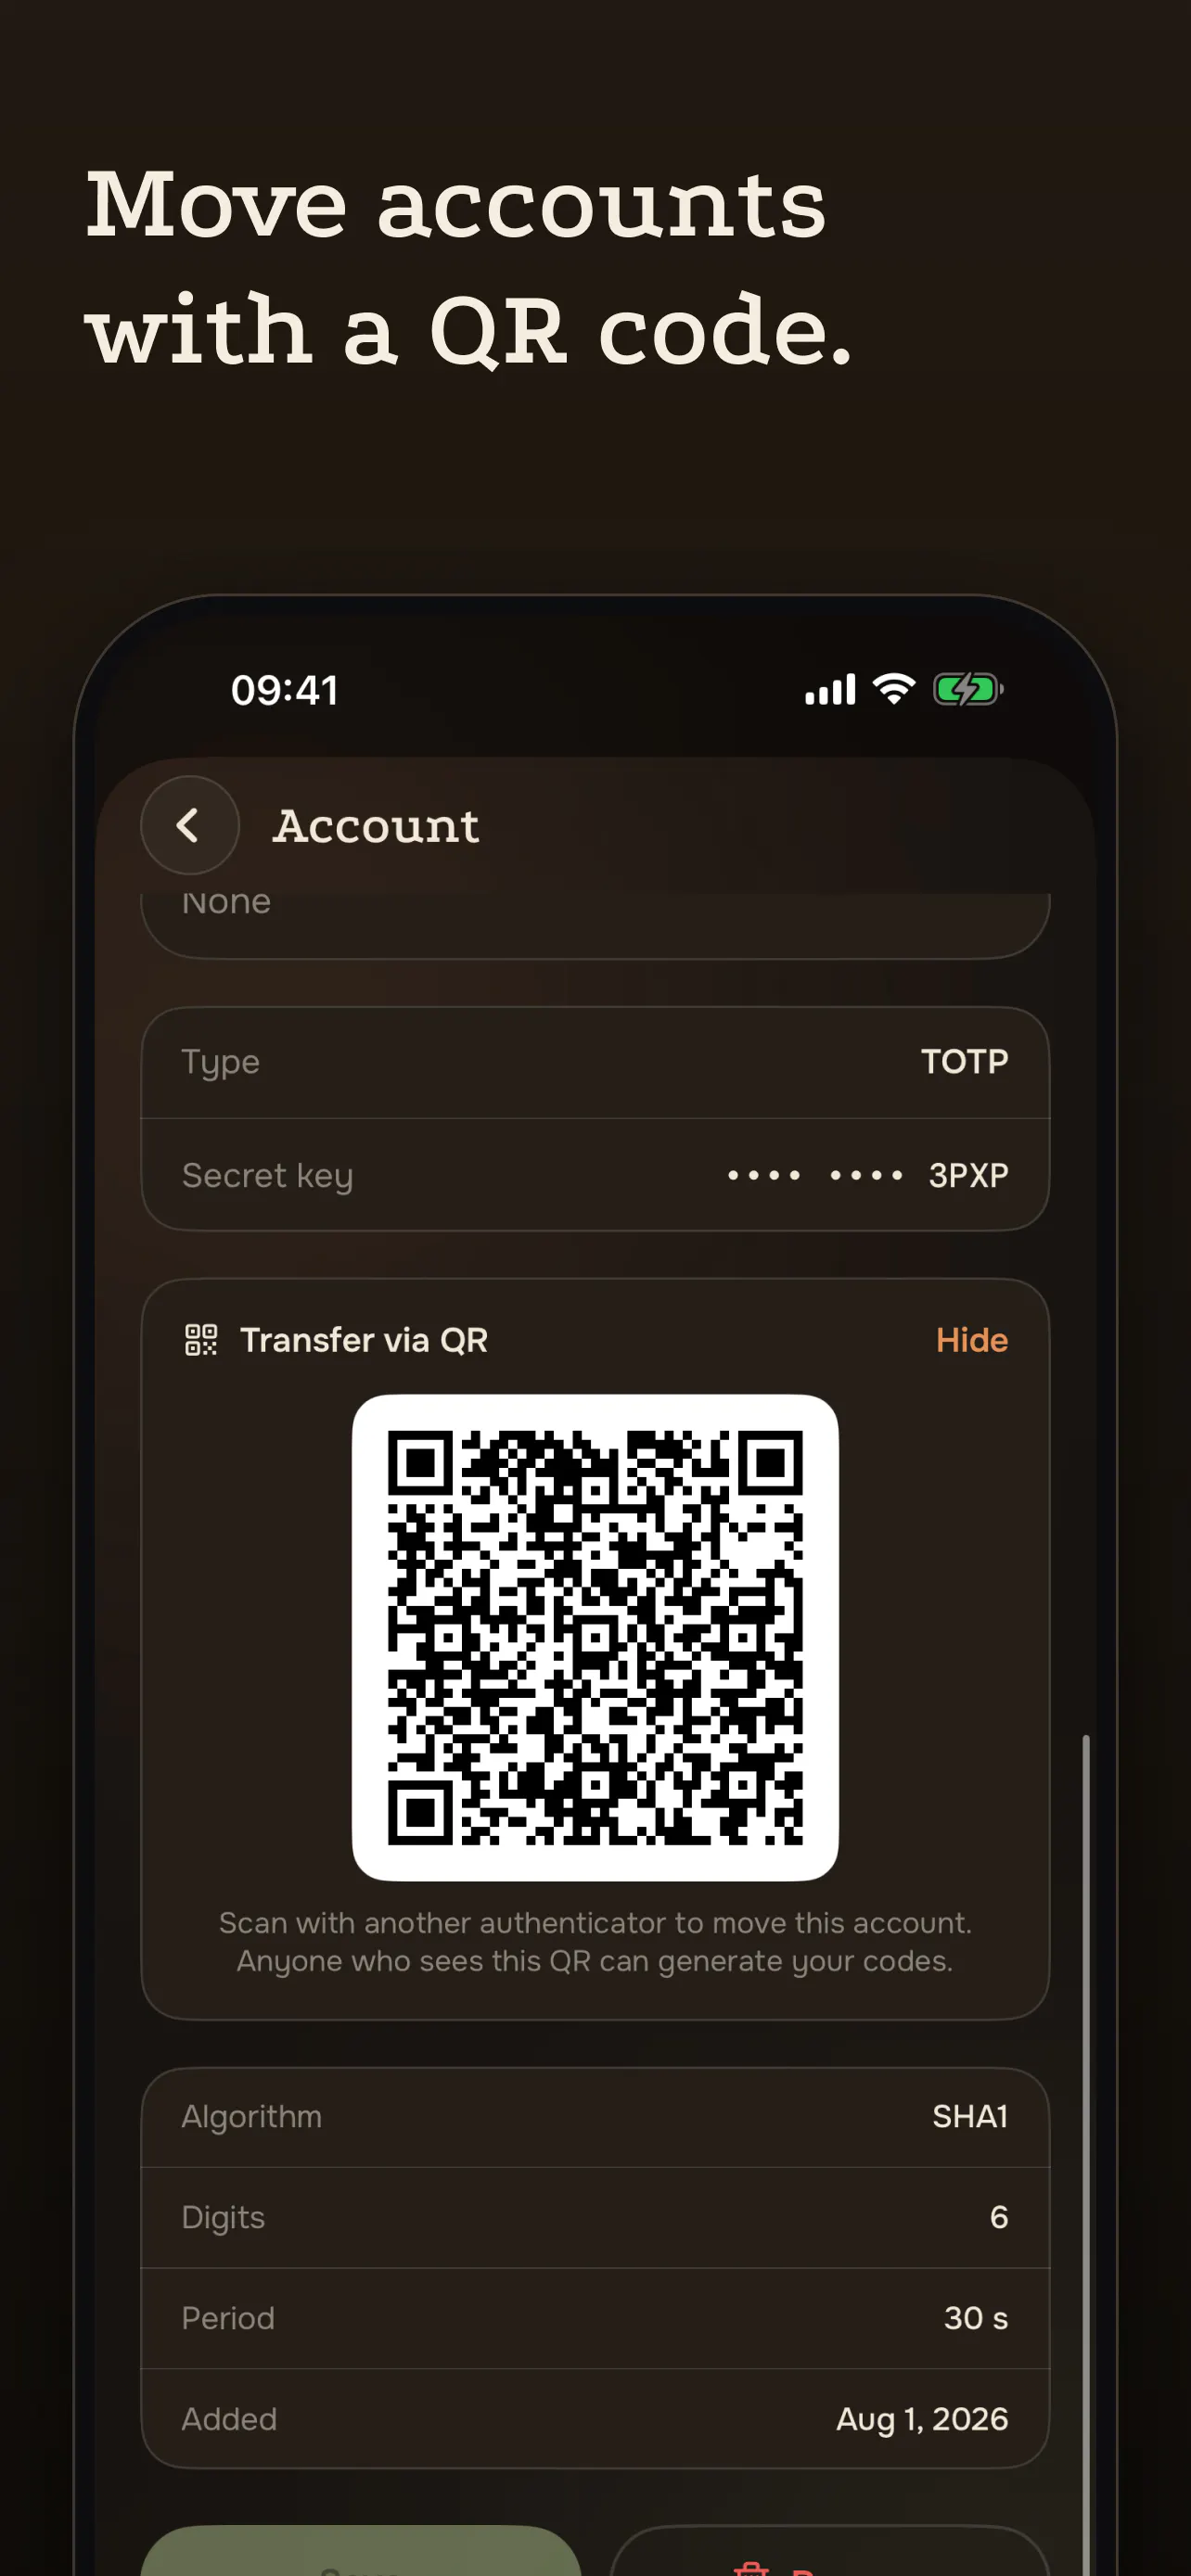
一句话介绍:Nthly 是一款纯本地离线运行的苹果端双因素认证(2FA)应用,通过 TOTP/HOTP 标准生成动态验证码,让用户在不依赖任何第三方服务器或账号体系的前提下,安全登录各类在线服务。
Productivity
Developer Tools
Security
2FA验证器
双因素认证
TOTP
HOTP
隐私安全
离线生成
苹果生态
iOS应用
免费无订阅
密码管理
用户评论摘要:用户普遍认可其隐私与免费特性,但痛点集中在平台覆盖不全——目前仅支持 iPhone,用户明确期待 iPad、Apple Watch、Mac 版本及 iCloud 同步功能。开发者回应称 iPad 版接近完成,macOS 版也将很快推出,但未提及 Watch 与同步时间表。
AI 锐评
Nthly 的本质是一款“政治正确”的极简主义安全工具——它用“无账号、无服务器、纯本地”换取了隐私洁癖者的信任,但这恰恰也是其最大的商业与功能天花板。投票数仅8,评论寥寥,说明它尚未在拥挤的 2FA 赛道(Google Authenticator、Authy、1Password、Bitwarden)撕开任何口子。它的真正价值不在技术(TOTP/HOTP 是公开标准,任何开发者都能实现),而在于对苹果生态的深度绑定与“免费无内购”的诚意——对不想折腾、又警惕云同步泄密的普通 iPhone 用户,这是一剂有效安慰剂。但致命问题在于:2FA 的核心痛点早已不是“生成密码”本身,而是“跨设备无缝恢复与迁移”。当前只支持 iPhone 且无 iCloud 同步,意味着一旦手机丢失或升级,所有账户的安全入口将同时失守——这恰恰是安全工具最不能容忍的失败模式。开发者承诺 iPad、Mac 版将至,却回避了 Watch 与同步具体规划,这暴露了产品仍处于“能用”而非“好用的”阶段。建议团队放弃“纯本地”的道德高地,改为端到端加密的 iCloud 同步(参考 Raivo OTP 的折中方案),否则它只会是少数极客的玩具,而非大众所需的安全刚需。在 Authy 已支持多设备加密同步、苹果原生密码管理器已内置验证码功能的当下,Nthly 若不做差异化(如基于 Face ID 的快捷填充、设备迁移二维码、自动备份审计日志),其“免费”标签将很快被遗忘。一句话结论:有初心,无壁垒,需要跑得更快。
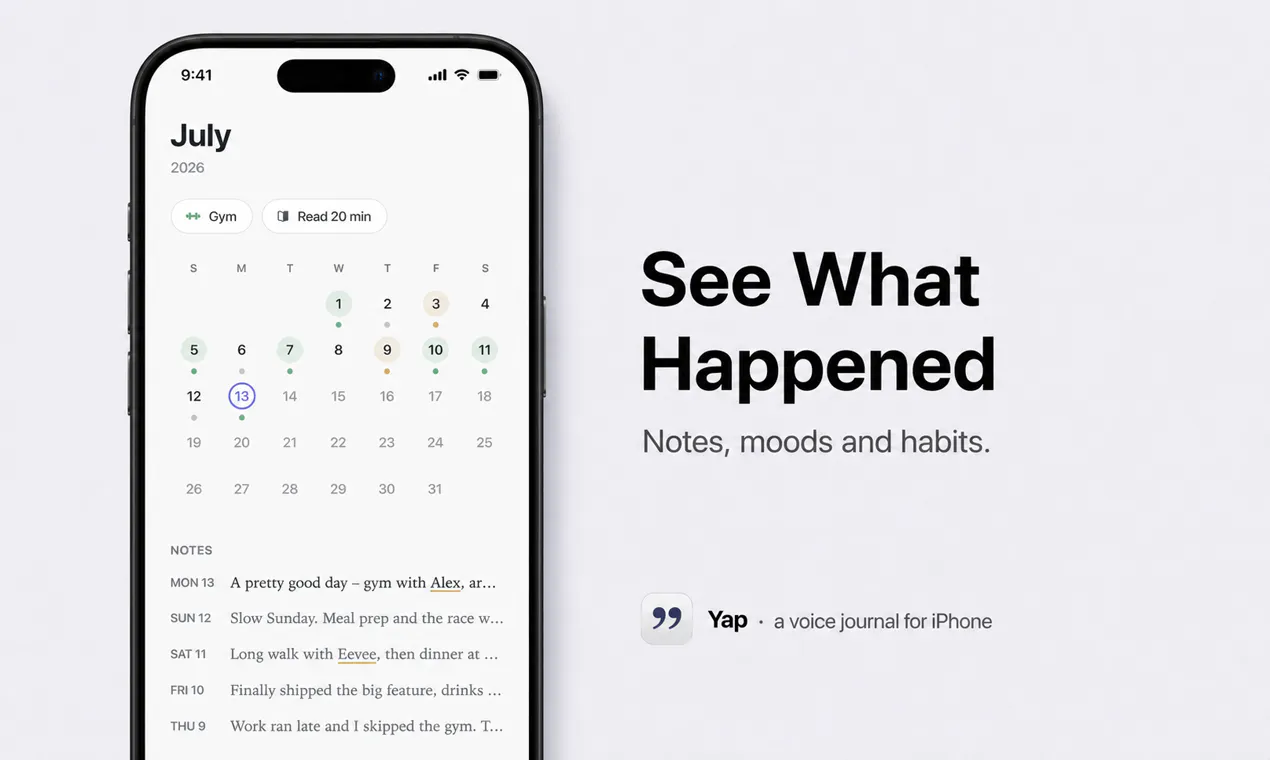
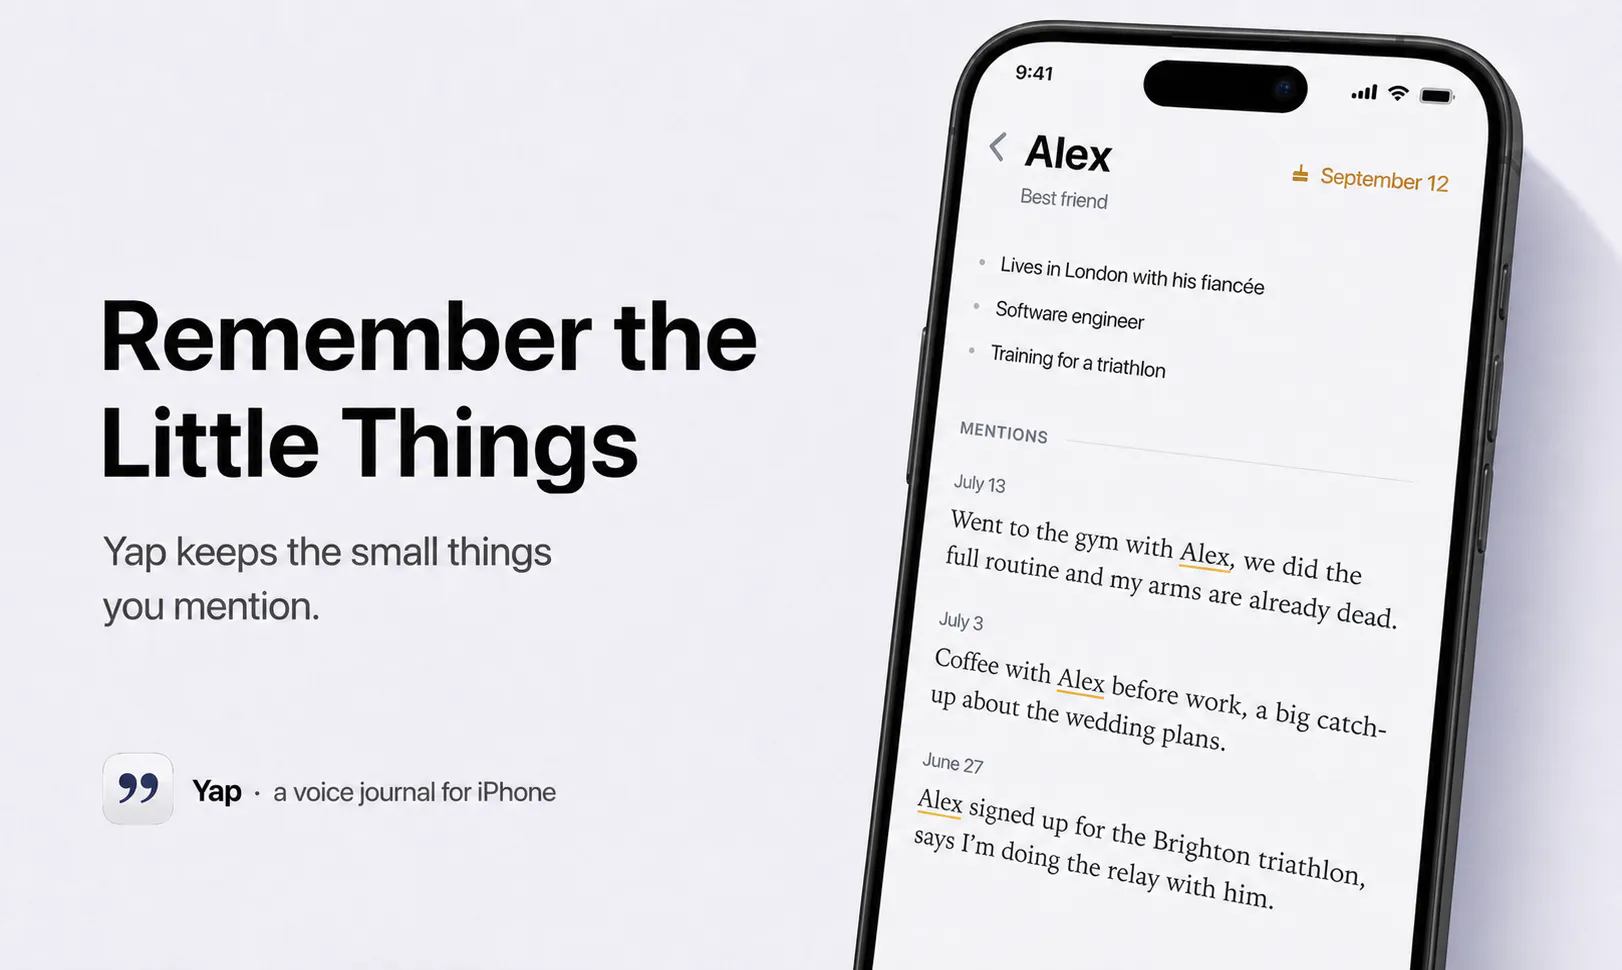
一句话介绍:Yap是一款用“说”代替“打”的语音日记应用,用户按住按钮口述一天经历,自动整理为结构化摘要,并追踪情绪、习惯与待办,解决“想记日记但懒得打字”的痛点。
Health & Fitness
Productivity
Task Management
语音日记
Journaling
AI整理
本地隐私
情绪追踪
习惯记录
待办事项
无账号
语音转文字
效率工具
用户评论摘要:多数用户认可无需打字、无连续打卡压力的设计,称赞界面简洁。但一位用户反馈严重缺陷:录制15分钟无法保存、无法回看、多次报错,最终删除应用。开发者已道歉并请求联系排查,产品稳定性待验证。
AI 锐评
Yap的切入点很聪明——它承认“写日记”是反人性的,转而用语音降低启动成本,并用本地LLM自动提炼结构化信息(情绪、待办、人际关系),这确实比传统录音或手写高出一个维度。但8票的冷启动与一条“无法保存”的差评直接戳穿了它的软肋:AI整理是锦上添花,而“可靠记录”是生死线。用户按下按钮说15分钟,结果什么都没有,这不是bug,是产品失信。更值得警惕的是,它宣称“本地LLM”和“数据私有”,但小团队在移动端跑本地模型,往往意味着更差的识别率和更长的延迟,这可能在低端设备上成为灾难。从策略看,无账号、无连续打卡、允许导出,都是为了降低心理负担,但“本地数据”也意味着换机即失忆,反成为迁移门槛。目前它更像一个精美的demo,而非可依赖的日常工具。建议团队先修好“保存”和“回溯”这一核心闭环,再谈情感化设计——毕竟,用户不会为“未来可能变得好用”买单,但会为“现在丢了日记”愤怒卸载。
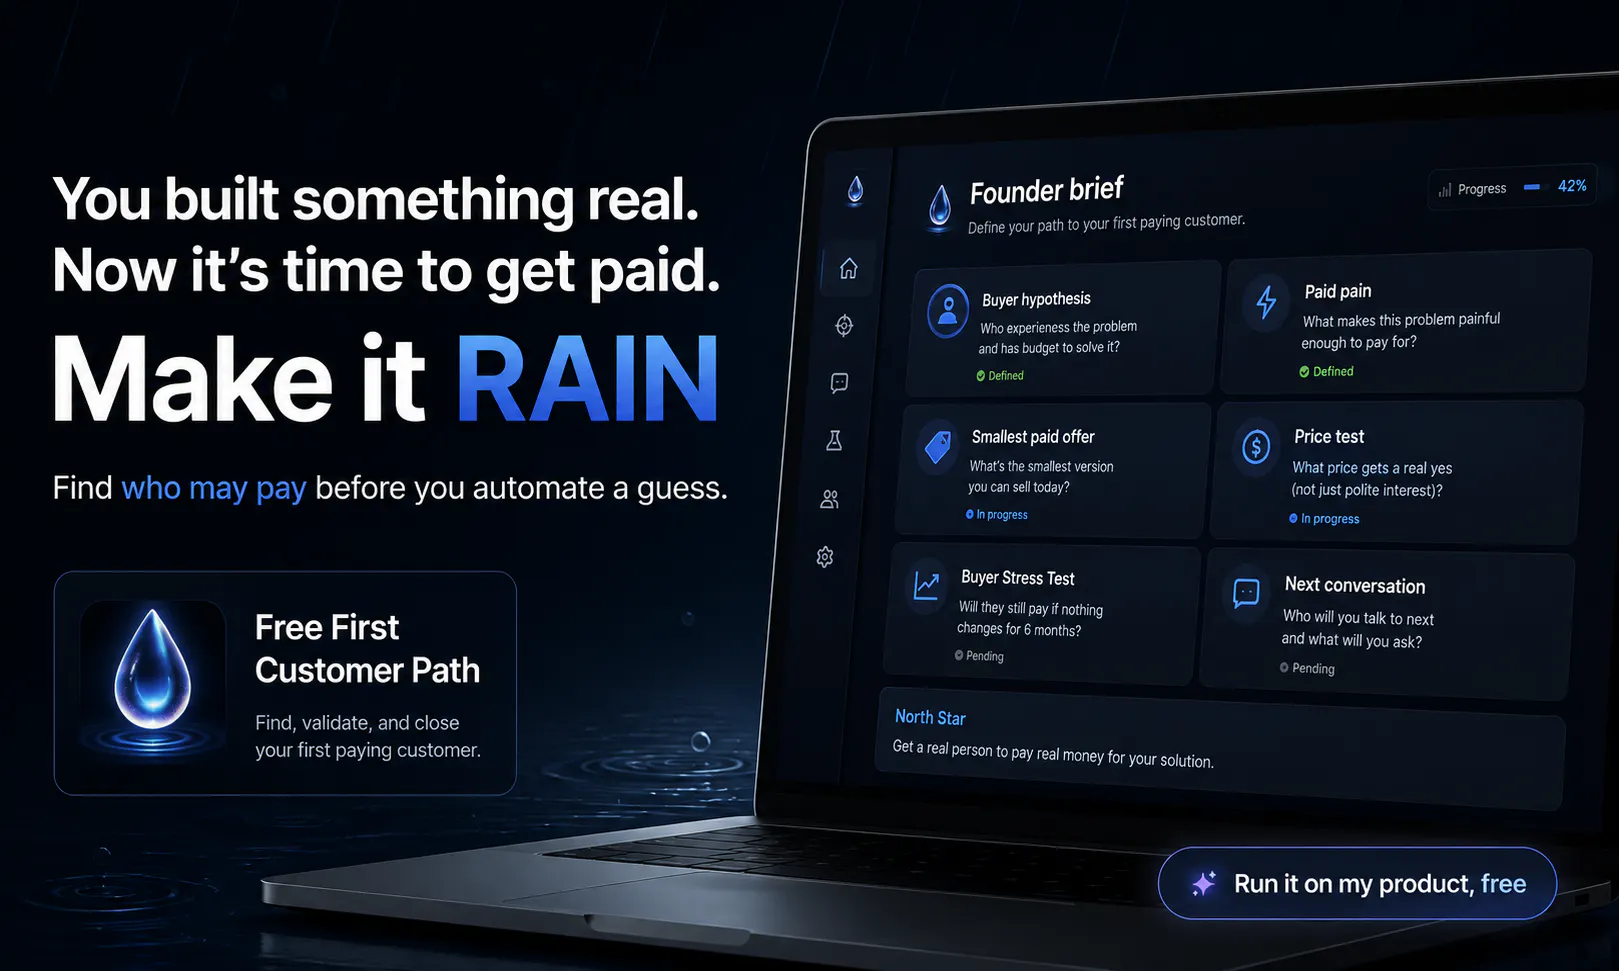
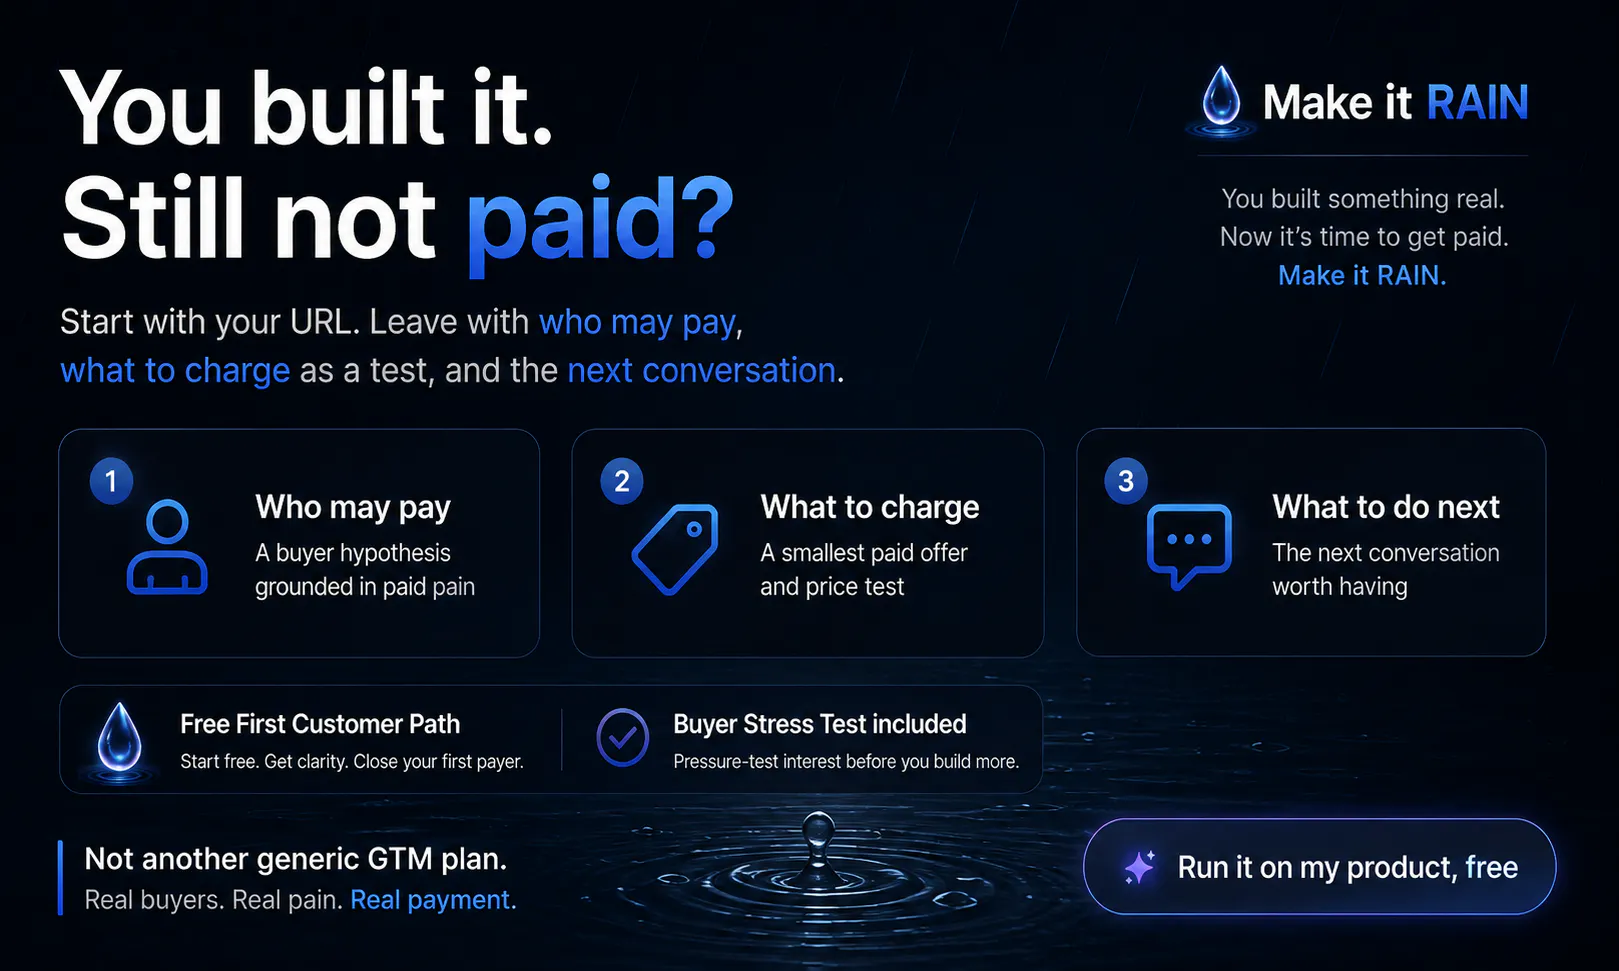
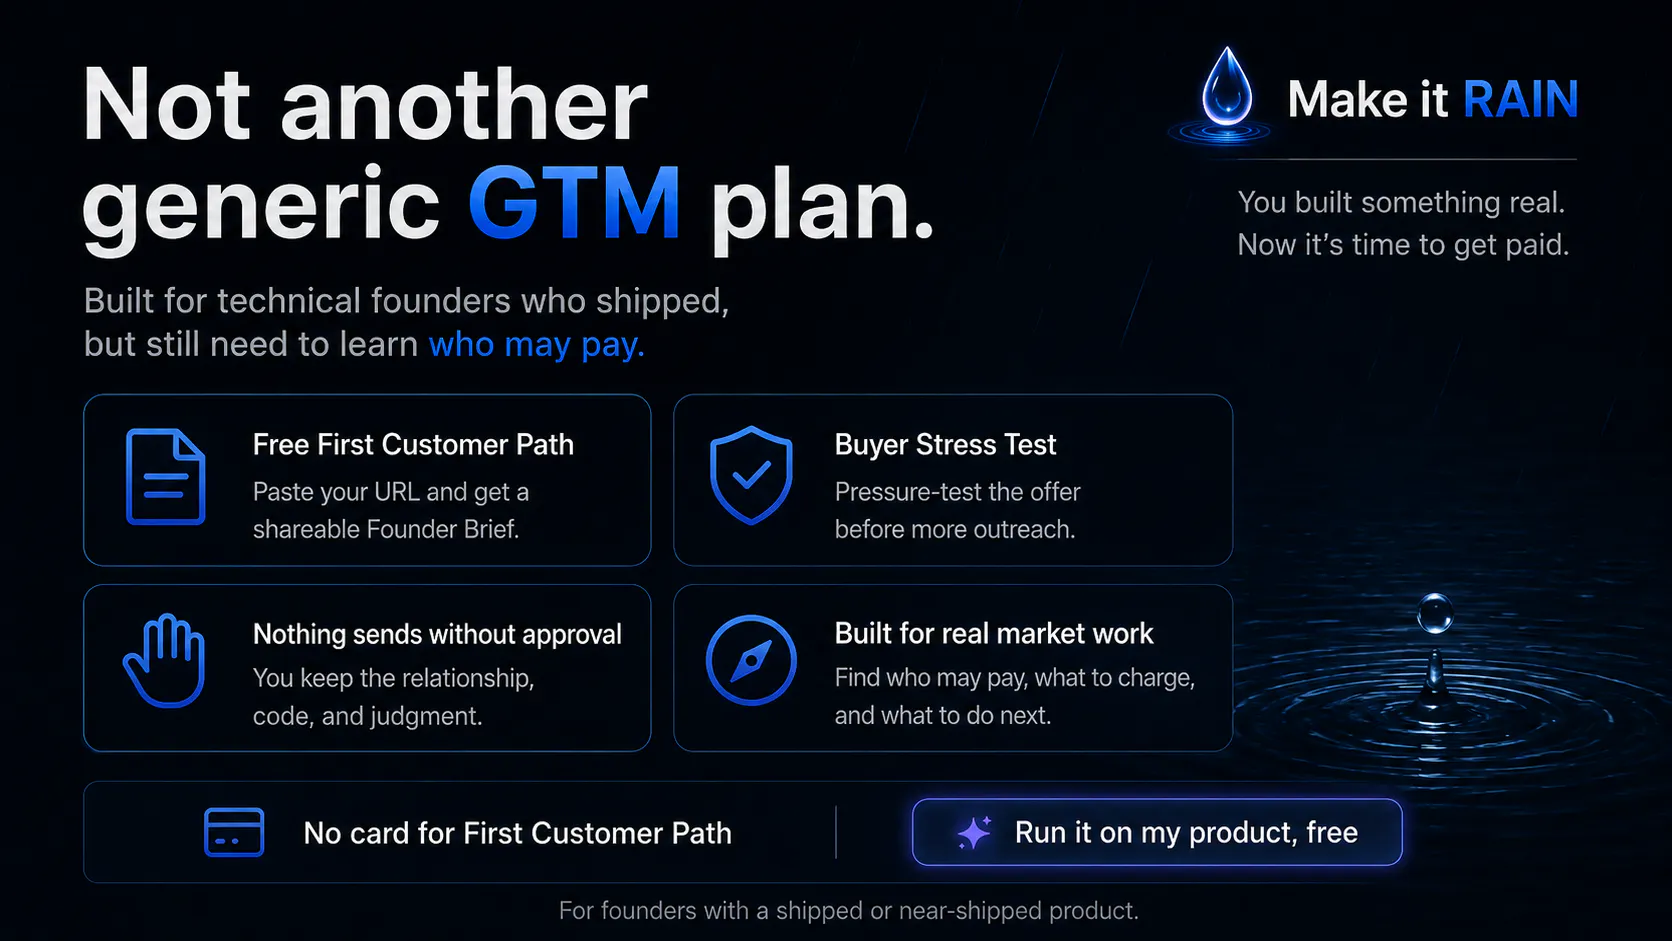
一句话介绍:Make it RAIN 面向已上线产品但尚未找到付费用户的技术创始人,通过粘贴产品 URL 自动生成“首个客户路径”报告,用买家压力测试替代盲目获客,在正式外联前验证谁可能付费、痛点是否值钱及定价是否成立。
Sales
Marketing
Vibe coding
SaaS工具
付费验证
客户发现
定价测试
买家假设
技术创始人
市场匹配
GTM策略
产品上线后
无代码门槛
用户评论摘要:用户认可 URL 直连的低摩擦 onboarding;强调“把买家和价格视为假设”比 AI 假装验证需求更可信;指出产品解决“上线后不知道找谁”的真实痛点;创始人留言最关注 Buyer Stress Test 能否在盲目外联前攻击 offer 弱点,并欢迎用户指出市场判断错误。
AI 锐评
Make it RAIN 切中的是技术创始人“发布即迷茫”的真实断层——代码能跑通,但市场假设全凭猜测。它的核心价值不在生成报告,而在于把“付费意愿”从伪命题变成可证伪的实验:通过 Buyer Stress Test 模拟怀疑买家来攻击 offer,迫使创始人承认“买家和价格只是假设,除非用行为证明”。这比市面上泛滥的 GTM 模板或线索列表更接近商业本质,也避免了 AI 生成“虚假确定性”的通病。
但必须泼冷水:投票仅 8 票,评论几乎全是自问自答式背书,缺乏独立第三方验证。URL 解析生成的“买方假设”大概率基于网页文本的语义猜测,对复杂B2B场景可能浅薄;而“最小付费 offer”和“价格测试”若没有真实对话数据支撑,仍只是精心包装的启发式建议。产品真正的护城河应该是后续的“对话反馈闭环”——即每次买家互动后如何自动修正假设并优化下一步动作,如果这部分仅停留在“建议下一步对话”而没有系统跟踪行为结果,那它仍是一个高级问卷生成器,而非增长引擎。技术创始人最危险的是用工具获得“我验证过了”的错觉,本质上仍是逃避与真实市场对话的痛苦。所以,请把 Buyer Stress Test 延伸到真实销售对话的复盘里,否则它只是让焦虑者更心安理得地原地踏步。
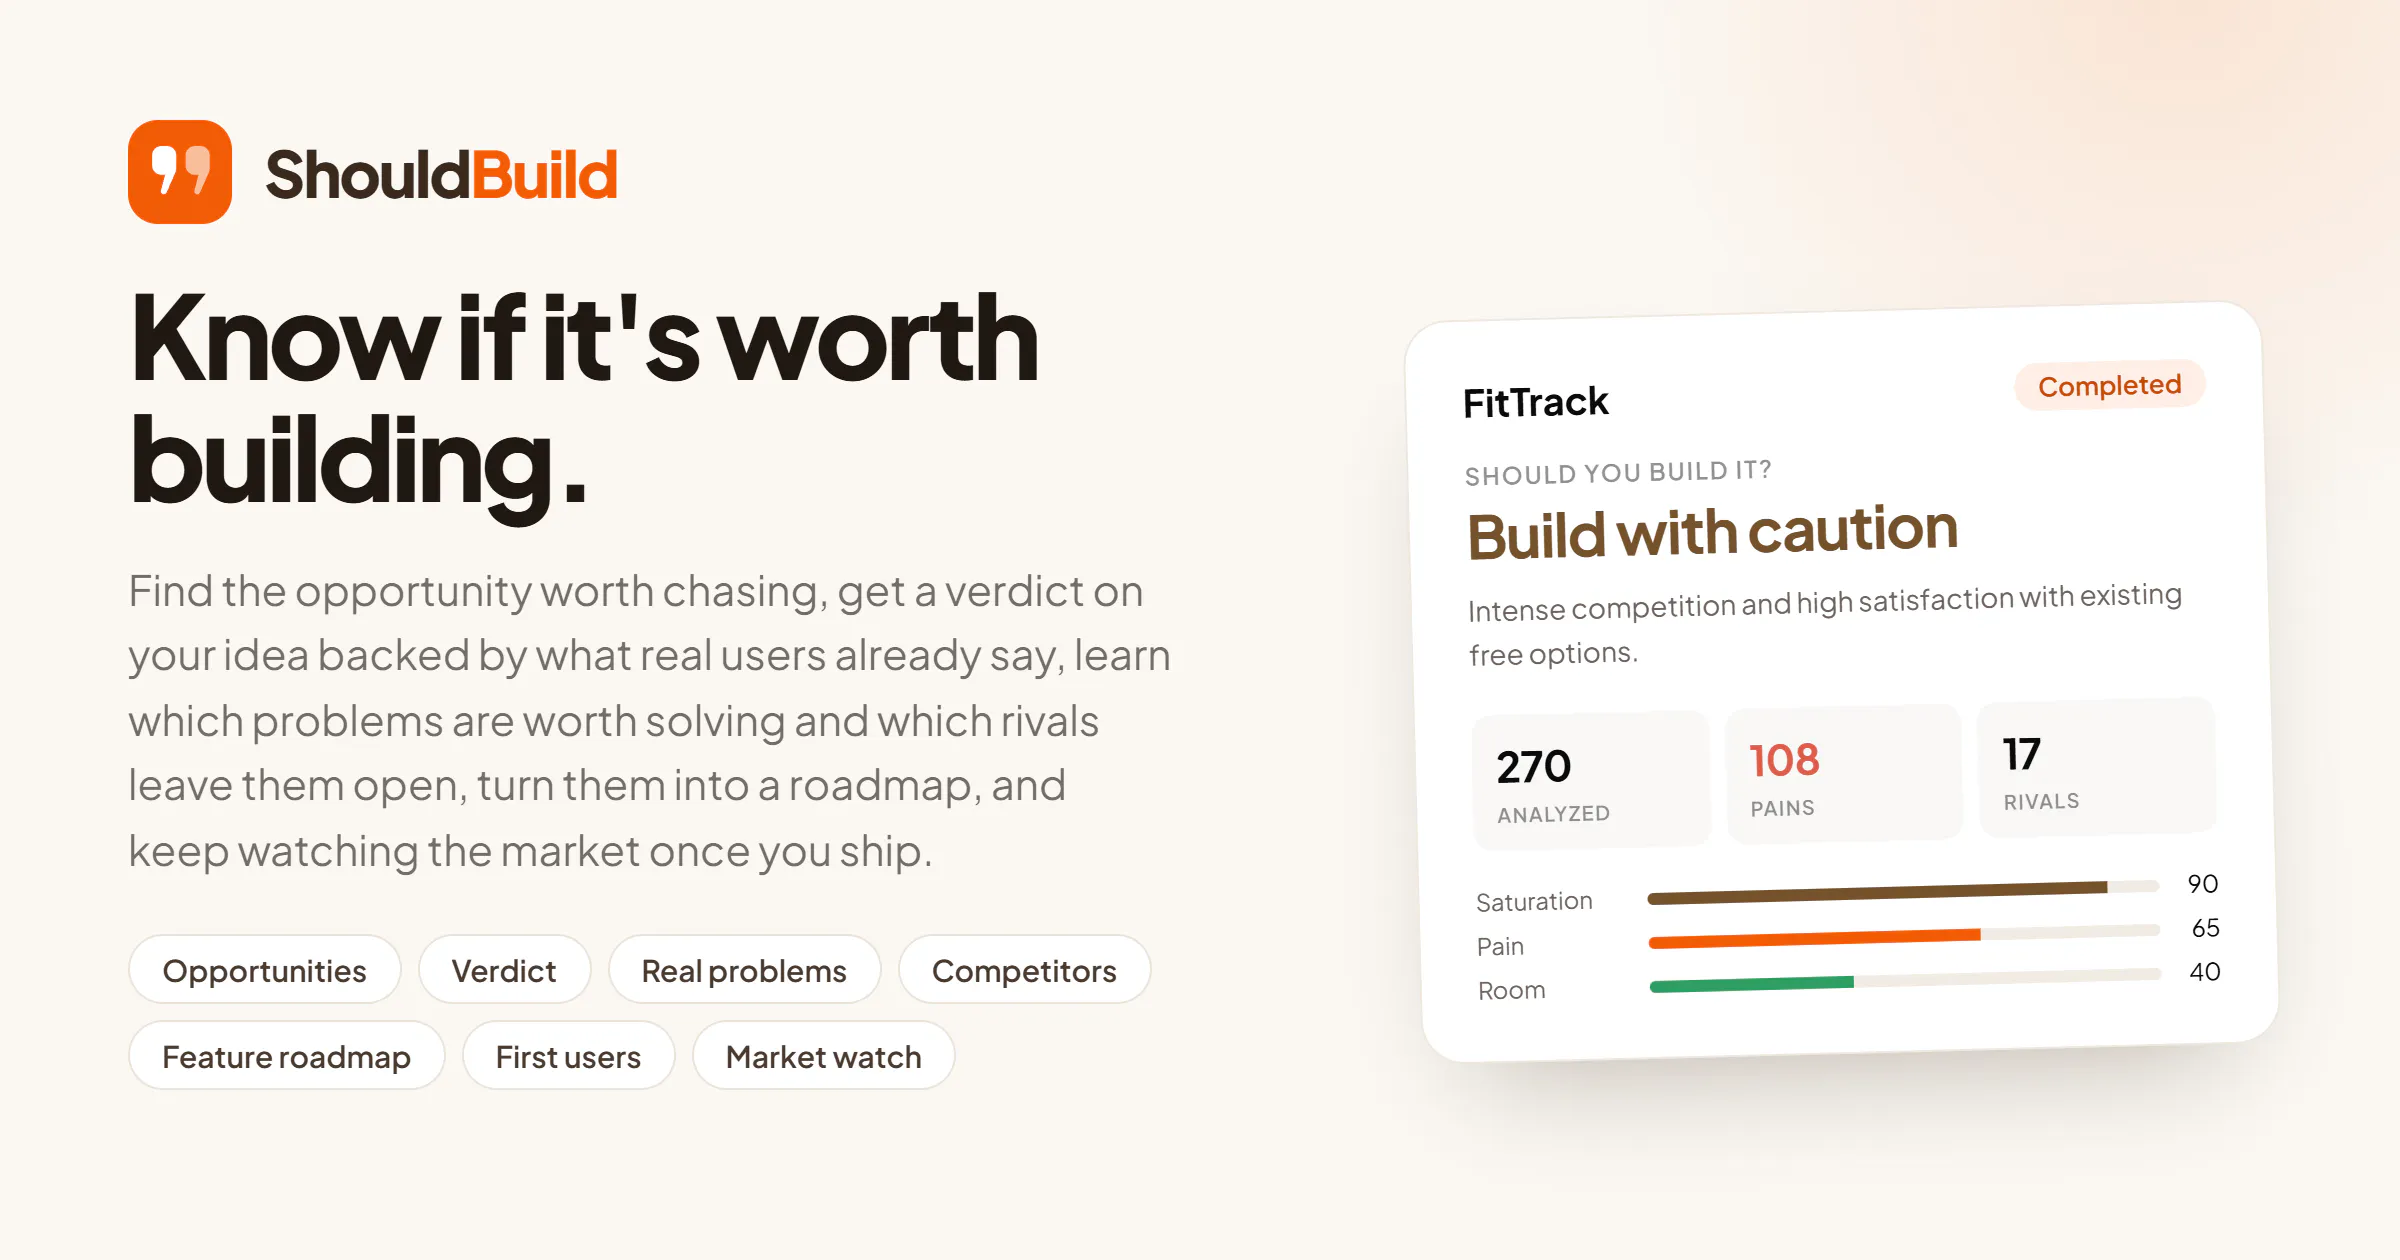
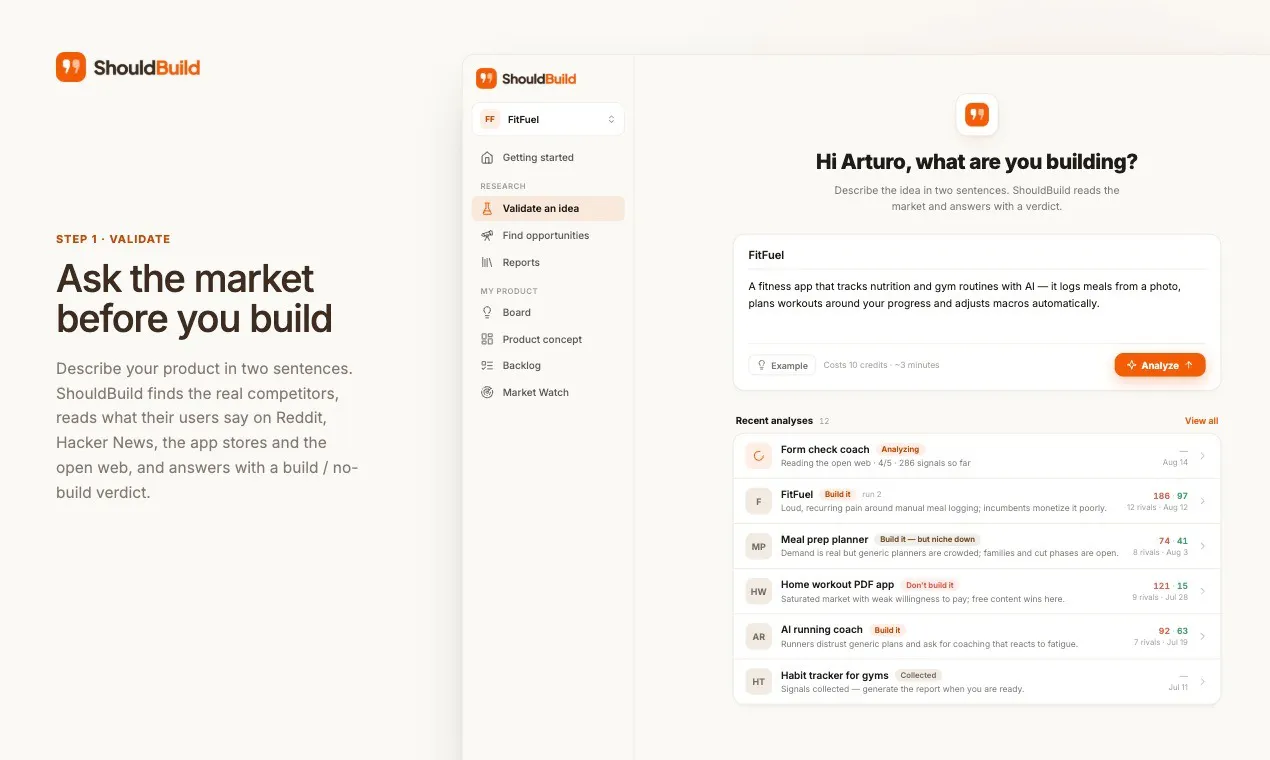
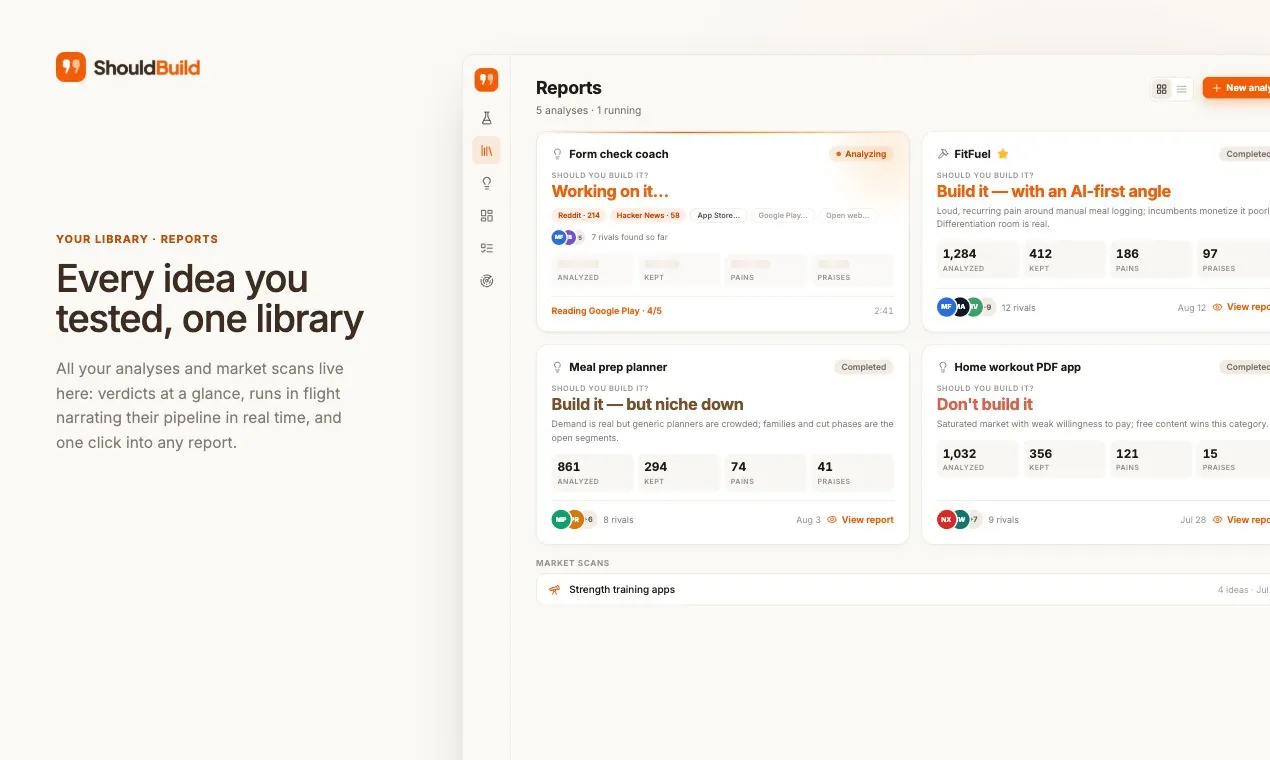
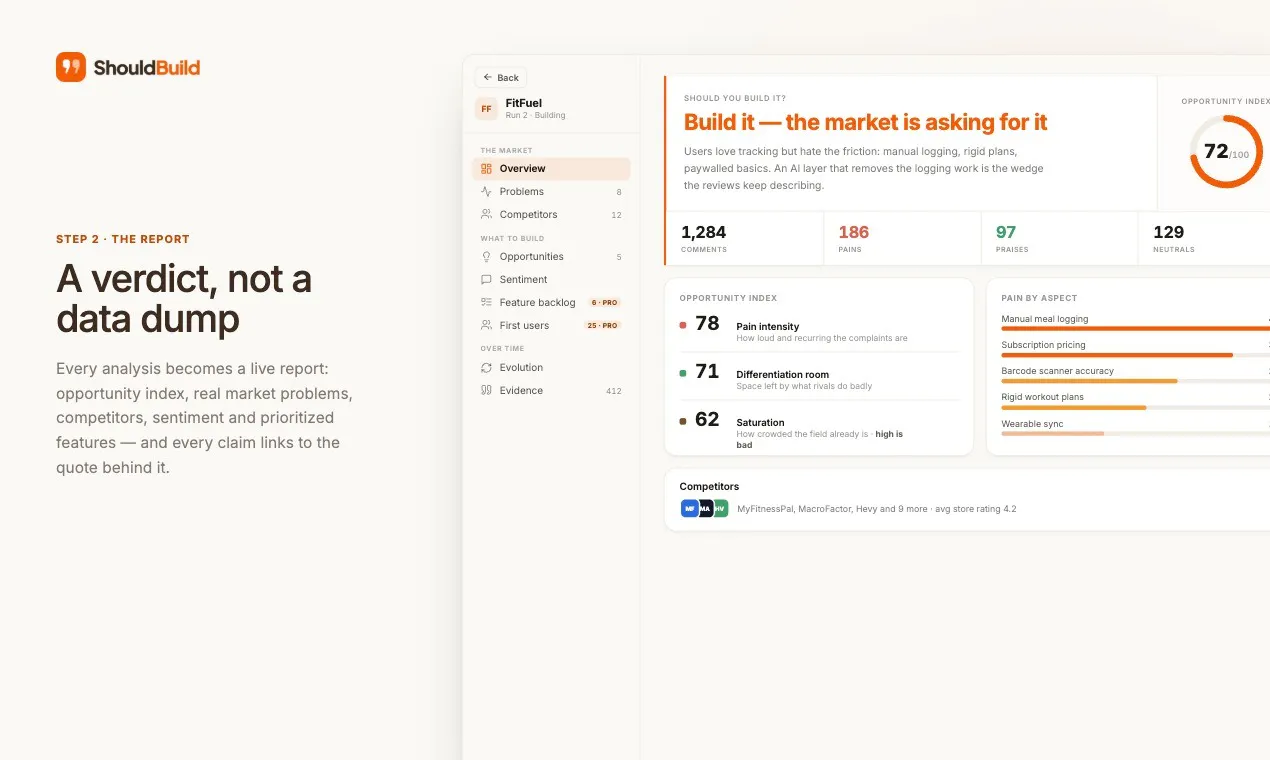
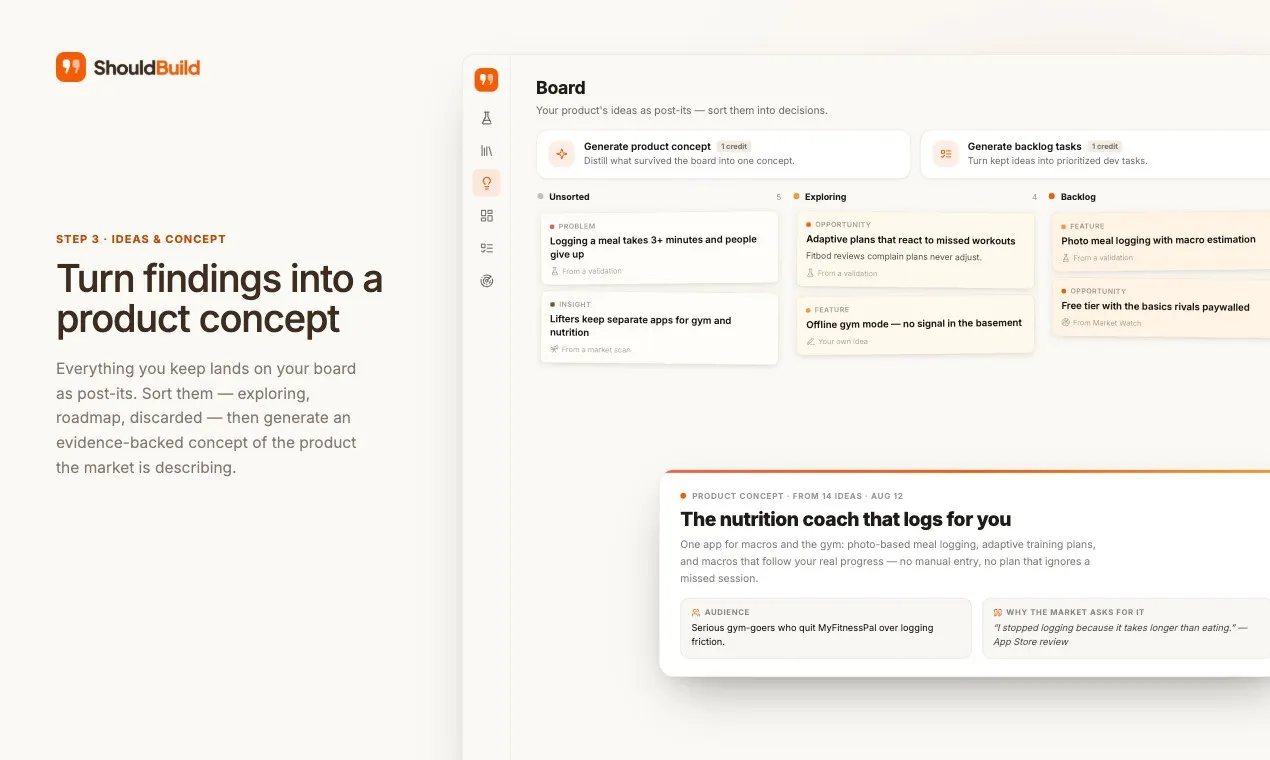
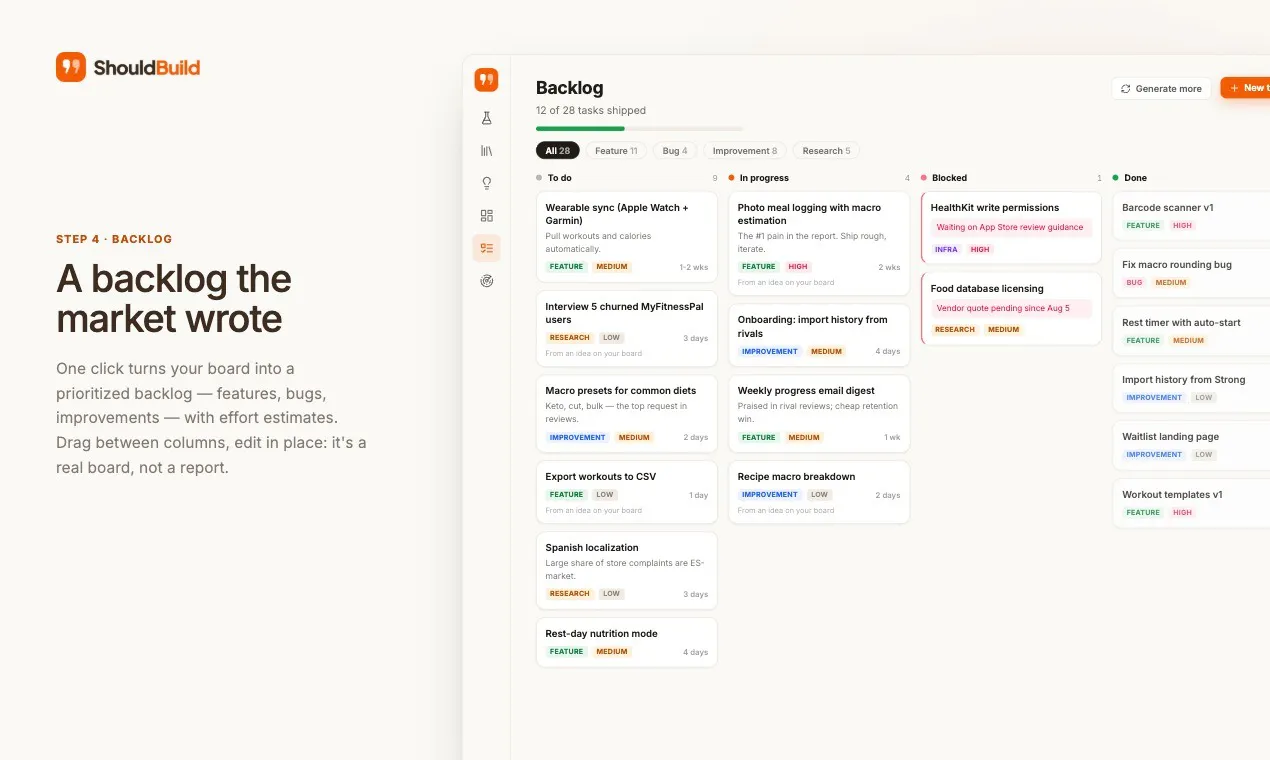
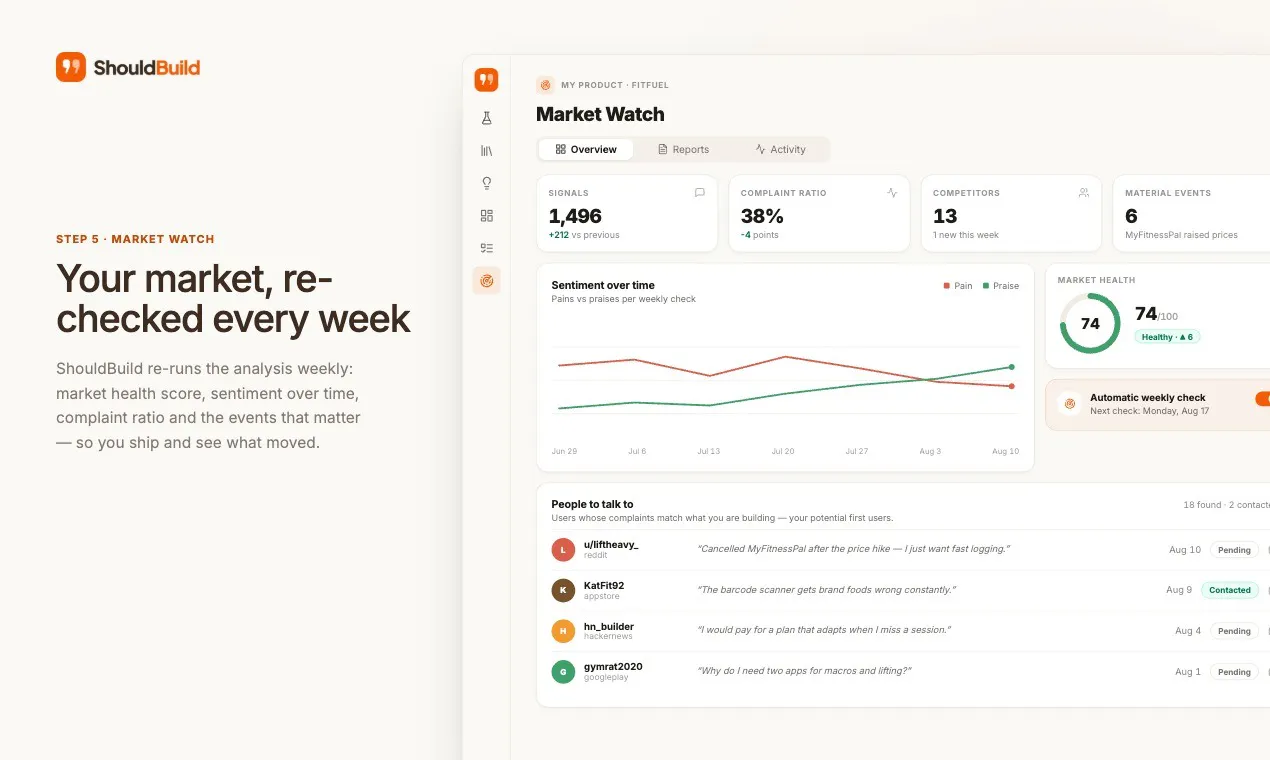
一句话介绍:ShouldBuild是一个AI市场验证工具,在你投入数月开发前,通过聚合App Store、Reddit、Hacker News及全网的真实用户抱怨,给出“该做/不该做”的决策依据,并附上可点击的原始引述,帮你避免在无人需要的产品上浪费生命。
Marketing
SaaS
Artificial Intelligence
市场验证
AI竞品分析
用户反馈挖掘
产品决策
需求验证
独立开发者
创业工具
SaaS
痛点分析
周一市场监控
用户评论摘要:用户Farid肯定其能帮新手少走弯路;核心批评来自试用户Tester:①报告存在“LLM帮助性偏差”,对明显违法/荒谬的点子仍给出冗长分析而非直接否决;②单份报告token成本极低(约$0.5),定价偏高;③建议增加快速非法性拦截,提升报告可信度与直率度。
AI 锐评
ShouldBuild踩中了当下AI创业最大的伪需求——把“验证”包装成一次性的数据快照。其核心壁垒根本不是技术,而是那个“每周一重读市场”的持续监控闭环,这确实比ChatGPT生成一份报告有深度。但很遗憾,产品当前暴露的缺陷恰好是其宣称要解决的头号问题:决策质量。
那位试用户用“核潜艇无人机送披萨”这个极端的反例,一针见血地戳穿了LLM的迎合性:即便报告结论是“不要做”,后续给出的“联系律师、做落地页”等步骤已构成误导性噪音。对真正犹豫不决的创业者,这种含糊其辞的“帮助性建议”比直接说“这想法愚蠢”危害更大——因为它会让用户产生“还有戏”的错觉,从而继续投入时间。
定价策略也显得精于算计而疏于诚意。单份报告成本不足一美元,7天免费试用后若按行业常规SaaS价格收费,本质是给“焦虑”定价,而非给“洞察”定价。用户不傻,尤其在Product Hunt这个聚集早期极客的平台上,毛利率一眼看穿。
但平心而论,产品形态是对的。在代码不再稀缺的时代,验证确实是第一痛点。若能做出三处调整:①引入金融风控式的“硬否决”逻辑(如违法、极高监管风险直接一票否决而不展开);②报告末尾强制附上“反对意见TOP3”以抵消LLM偏见;③定价按报告份数而非订阅,把毛利透明化——它将有机会从“聪明的工具”变成“可信赖的参谋”。否则,它最终只能成为又一个帮人把烂点子做得更精美的包装纸。
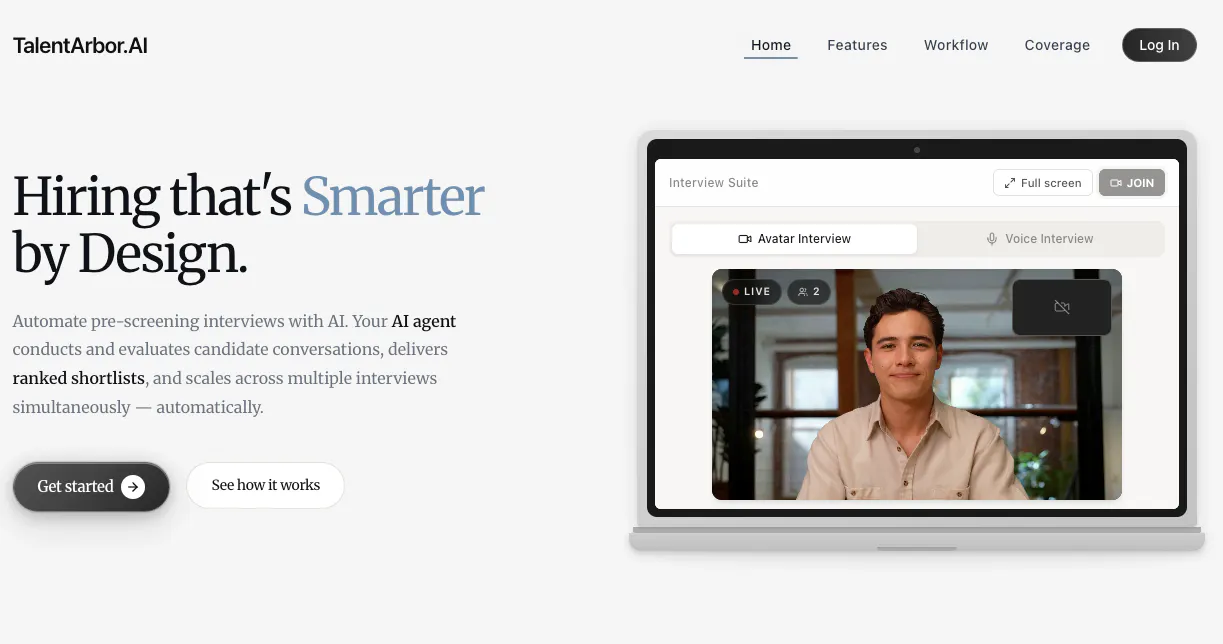
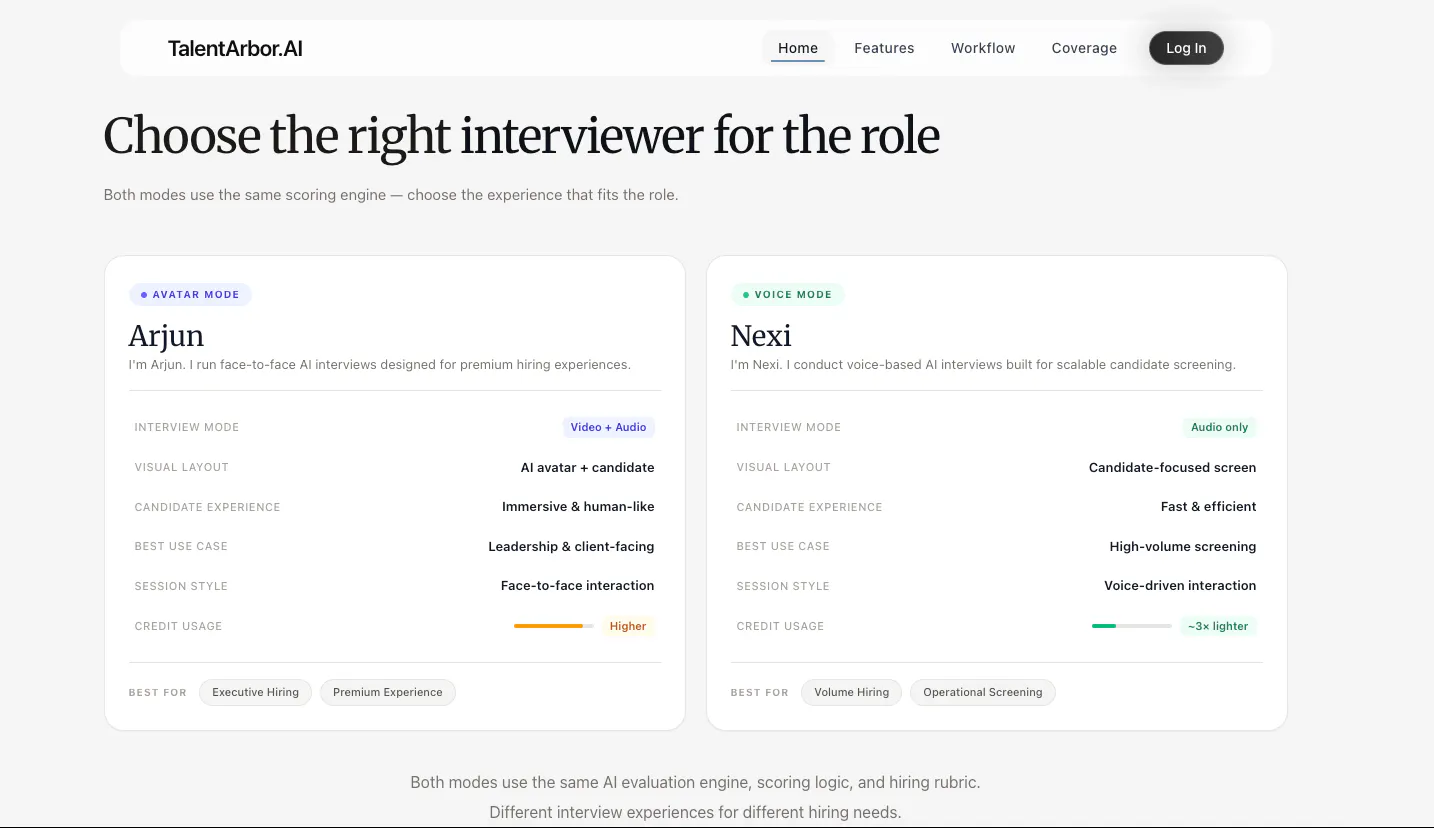
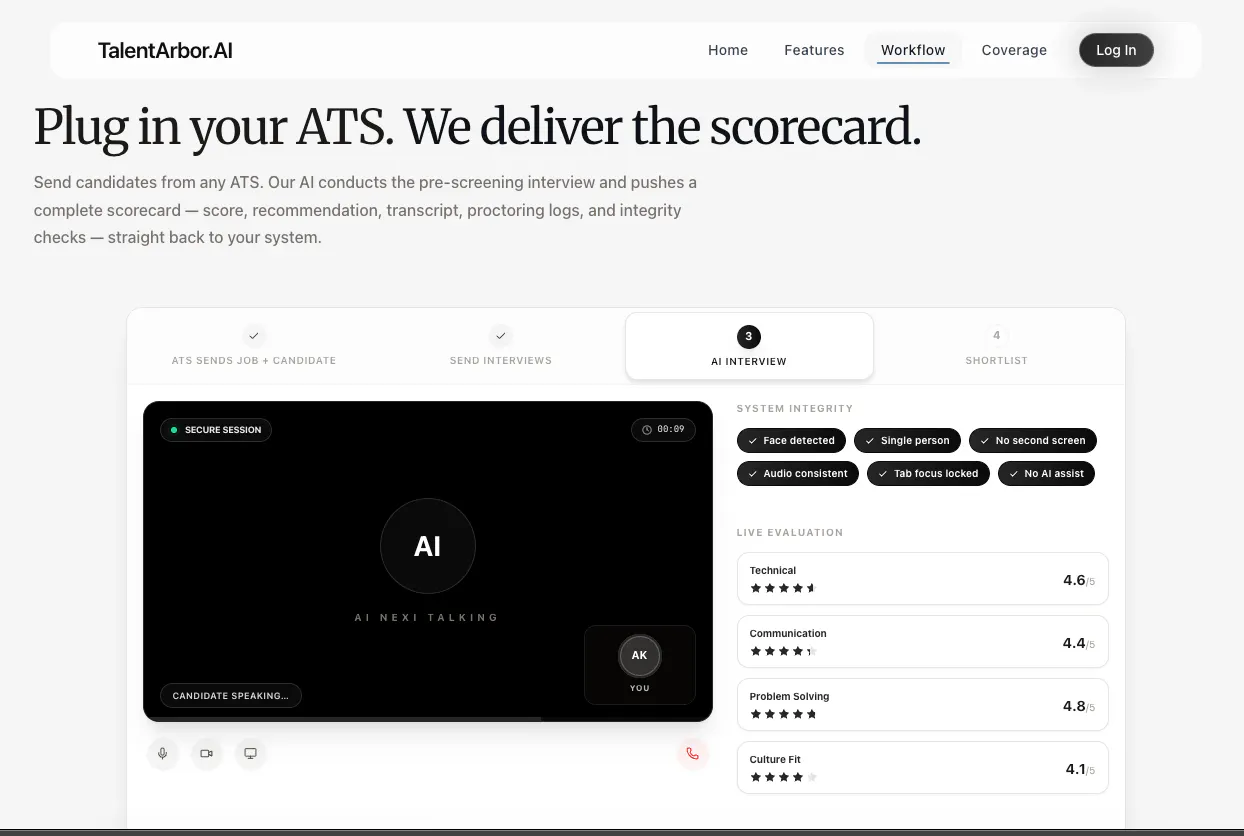
一句话介绍:Interview Agent by NexI 用AI面试官自动完成候选人初筛,通过“面试证据+评分卡”替代简历筛选,解决招聘初期效率低、评判标准不一致的痛点。
Hiring
SaaS
Artificial Intelligence
AI招聘
智能面试
候选人筛选
自动化HR
面试评估
招聘提效
反作弊识别
TalentArbor
语音/虚拟人面试
招聘SaaS
用户评论摘要:目前唯一有效评论来自开发者自述(16赞),核心诉求是征集HR与创始人对“AI面试证据”和“反AI作弊”功能的反馈。暂无第三方用户提出具体问题或改进建议,需警惕“自嗨式”发布。
AI 锐评
这又是一个典型的“技术自嗨”型产品。表面上它解决了招聘初筛的效率和一致性问题,但实质是用AI对话替代了“第一轮人工电话”,并叠加了“结构化评分”和“反AI作弊”的装饰性功能。其宣称的“比简历更有价值的面试证据”值得商榷——在生成式AI已能完美模拟人类应答的今天,所谓“识别AI辅助回答”只是猫鼠游戏的上半场,且算法误杀真实候选人的风险远高于防作弊收益。
真正的痛点不在“谁来提问”,而在“问题本身是否有效”。如果面试题库和评估维度仍由HR拍脑袋定制,AI只是把低效的流程跑得更快,而非更准。TalentArbor技术并无创新性壁垒,可被ChatGPT套壳一周复制。6个投票、0条第三方评论的数据,说明其尚未获得市场初步验证,连早期种子用户都未激活。
建议团队先回答三个问题:1)AI评分与资深HR人工评分的相关性系数是多少?2)如何防止候选人用更高级的AI对抗“反AI”算法?3)当面试证据在法律层面成为雇佣决策依据时,谁来承担歧视或误判的责任?否则,这只是一款“演示精美、落地存疑”的招聘玩具,而非改变行业生产力的工具。
一句话介绍:
Design Tools
SaaS
No-Code
一句话介绍:AlsonAI Poetry 是一款将诗歌、口语诗等非叙事类文本自动转化为精美插画书的 AI 创作助手,核心解决“AI 在诗歌场景下乱加内容、破坏节奏与留白”的痛点,让创作者保留原声的同时获得出版级视觉呈现。
Kids
Artificial Intelligence
Books
AI写作辅助
诗歌生成
插画书制作
口语诗
文学创作工具
创意辅助
排版设计
独立出版
文本可视化
创作者工具
用户评论摘要:唯一有效评论来自创始人,详细说明了产品转向诗歌赛道的动机:原有故事叙事模型不匹配诗歌的留白与重复结构,因此新版本强化了“何时不生成”的克制能力。未见用户建议或批评,目前缺乏第三方真实反馈,属于早期拉新阶段。
AI 锐评
AlsonAI Poetry 的定位很聪明,但也很危险。聪明在于,它精准切入了一个被大模型普遍忽视的细分场景——诗歌和非线性文本的结构尊重。绝大多数 AI 写作工具(如 ChatGPT、Jasper)默认输出“完整段落”和“因果叙事”,这在诗歌创作中是灾难性的:AI 会本能地填满留白、解释隐喻、破坏节奏。AlsonAI 提出“学会不写”,本质上是在对抗大模型的生成惯性,这个技术方向和产品哲学是成立的。
危险在于,它把“克制”作为卖点,但“克制”恰恰是最难量化和变现的。用户无法像看到“生成 500 字”那样直观感知“AI 少写了什么”,除非最后呈现的插画书足够惊艳。目前投票数仅5,评论为零真实用户反馈,说明产品尚在冷启动,所谓的“最受请求功能”缺乏外部证据支持,更像自我叙事。
更值得警惕的是,诗歌 + 插画书的组合,市场天花板极低。诗歌创作者本身是窄众,愿意付费将诗歌制作成精装插画书的人更少,且这类需求更多是“纪念品”而非“工具”。AlsonAI 真正的对手不是其他 AI 写作工具,而是设计师(如为诗集配画的插画师)和自助出版平台(如 Blurb)。AI 若只停留在“生成配图 + 排版”,则价值有限;若能做到“理解诗歌情感核心,自动匹配视觉隐喻”,才有差异化,但这也意味着它需要进入图像生成与语义对齐的深水区,技术难度远超文本约束。
一句话:方向是对的,但当前更像一个 demo,而非可持续的产品。建议先跑通 100 位真实诗人的付费验证,再谈“尊重创作者声音”。否则,这股“克制”的清风,很快会被大厂功能集成的洪流淹没。
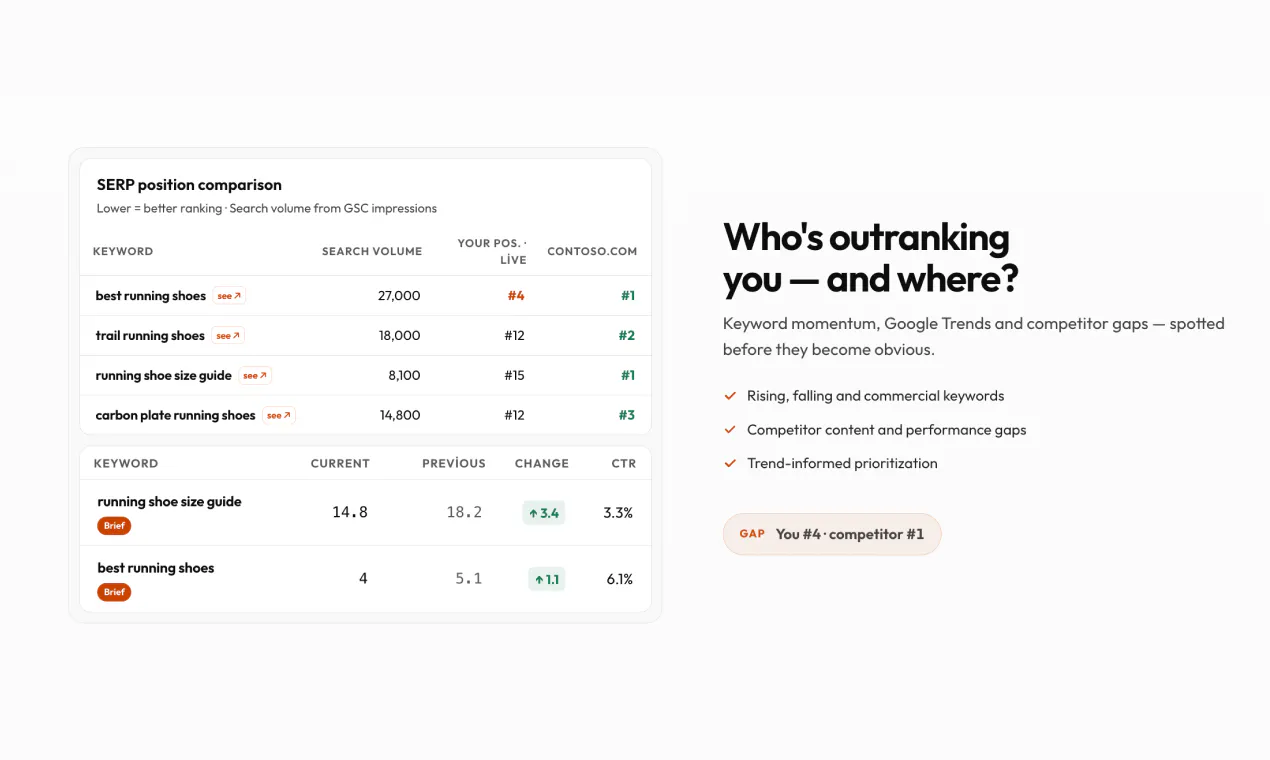
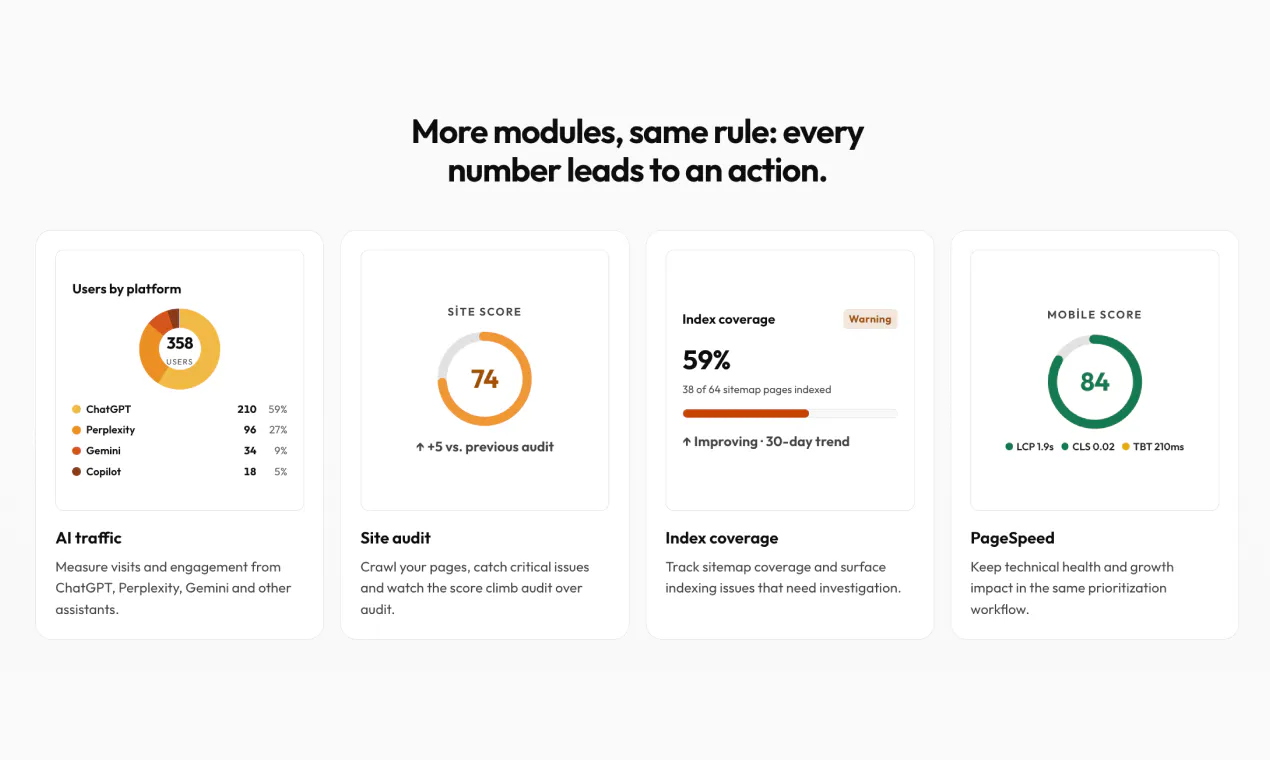
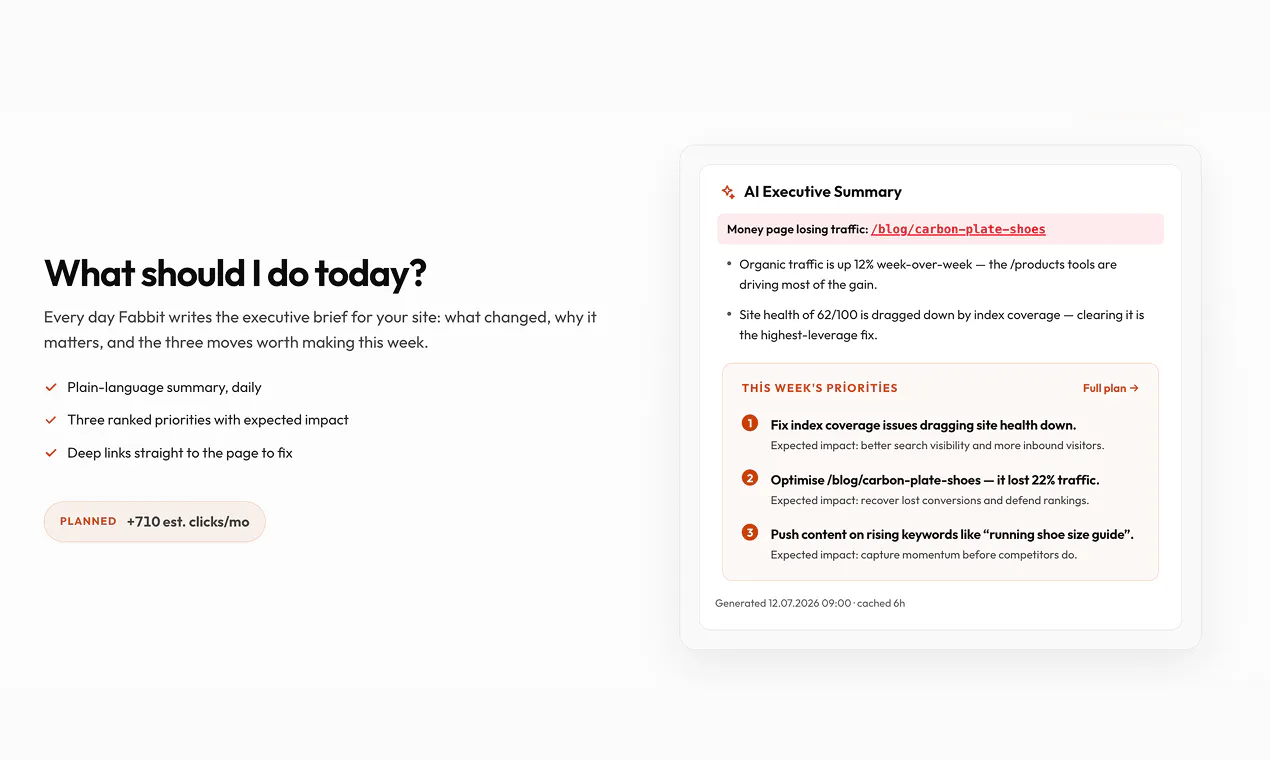
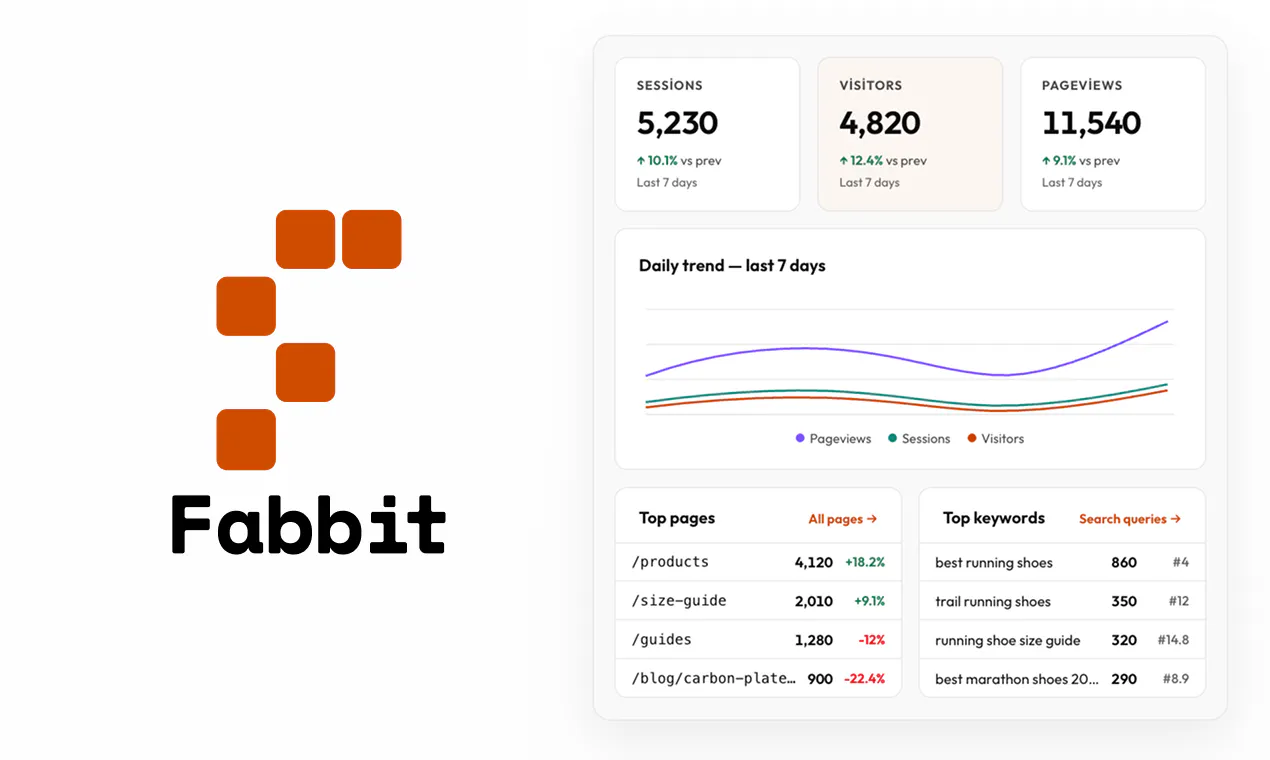
一句话介绍:Fabbit是一款将SEO、数据分析、竞品监控、CRM和网站审计整合于一体的增长智能平台,通过每日生成一条明确行动建议,解决增长团队在多个工具间切换、面对海量数据不知如何下手、错失市场机会的痛点。
Analytics
Marketing
SEO
增长智能平台
SEO工具
数据分析
竞品监控
网站审计
CRM集成
AI行动建议
效率工具
SaaS
营销自动化
用户评论摘要:目前仅有创始人发布的官方介绍评论,无第三方用户反馈。评论重点阐述了产品构建初衷(数据噪音与行动迟缓问题),但缺少真实用户对产品功能、易用性及有效性验证的有效建议或批评。
AI 锐评
Fabbit踩中了当前SaaS工具泛滥与AI效率焦虑的双重风口。其“统一看板+每日行动指令”的定位切中要害——增长团队的确烦透了在GA、Ahrefs、CRM之间反复横跳,也厌倦了只看报表无法落地的无力感。从战略上讲,将“数据洞察”转化为“任务清单”是极具价值的跃迁,这相当于给增长负责人配了一个AI运营助理。
然而,产品面临的挑战显而易见:第一,整合工具易,整合数据难。将不同类型数据源统一并提炼出有效“唯一动作”需要极强数据清洗和业务规则建模能力,稍有不慎就会沦为一堆错误建议的合订本。第二,5票的低热度及仅有官方自述的评论,表明产品尚处于早期验证阶段,缺乏外部真实使用场景背书。第三,“每天一条建议”是产品亮点也是死穴——如果建议质量不稳定(如建议删除一个实际上带来高转化长尾词的关键词),信任崩塌速度将比工具迭代更快。
Fabbit真正的价值不在于“多合一”,而在于其决策引擎的准确度。如果它能在“为何建议”上提供足够的透明度和证据链,让用户可信赖地执行,则有机会成为增长中台的水电煤;反之,若只是一层AI皮肤缝合了多个API数据,它将很快被同类产品(如Ahrefs的AI功能、Semrush的Copilot)吞噬。现阶段,Fabbit需要迅速找到一批高活跃的种子用户,用真实案例证明其“每日行动”的采纳率和ROI,方能在拥挤赛道中撕开一道口子。
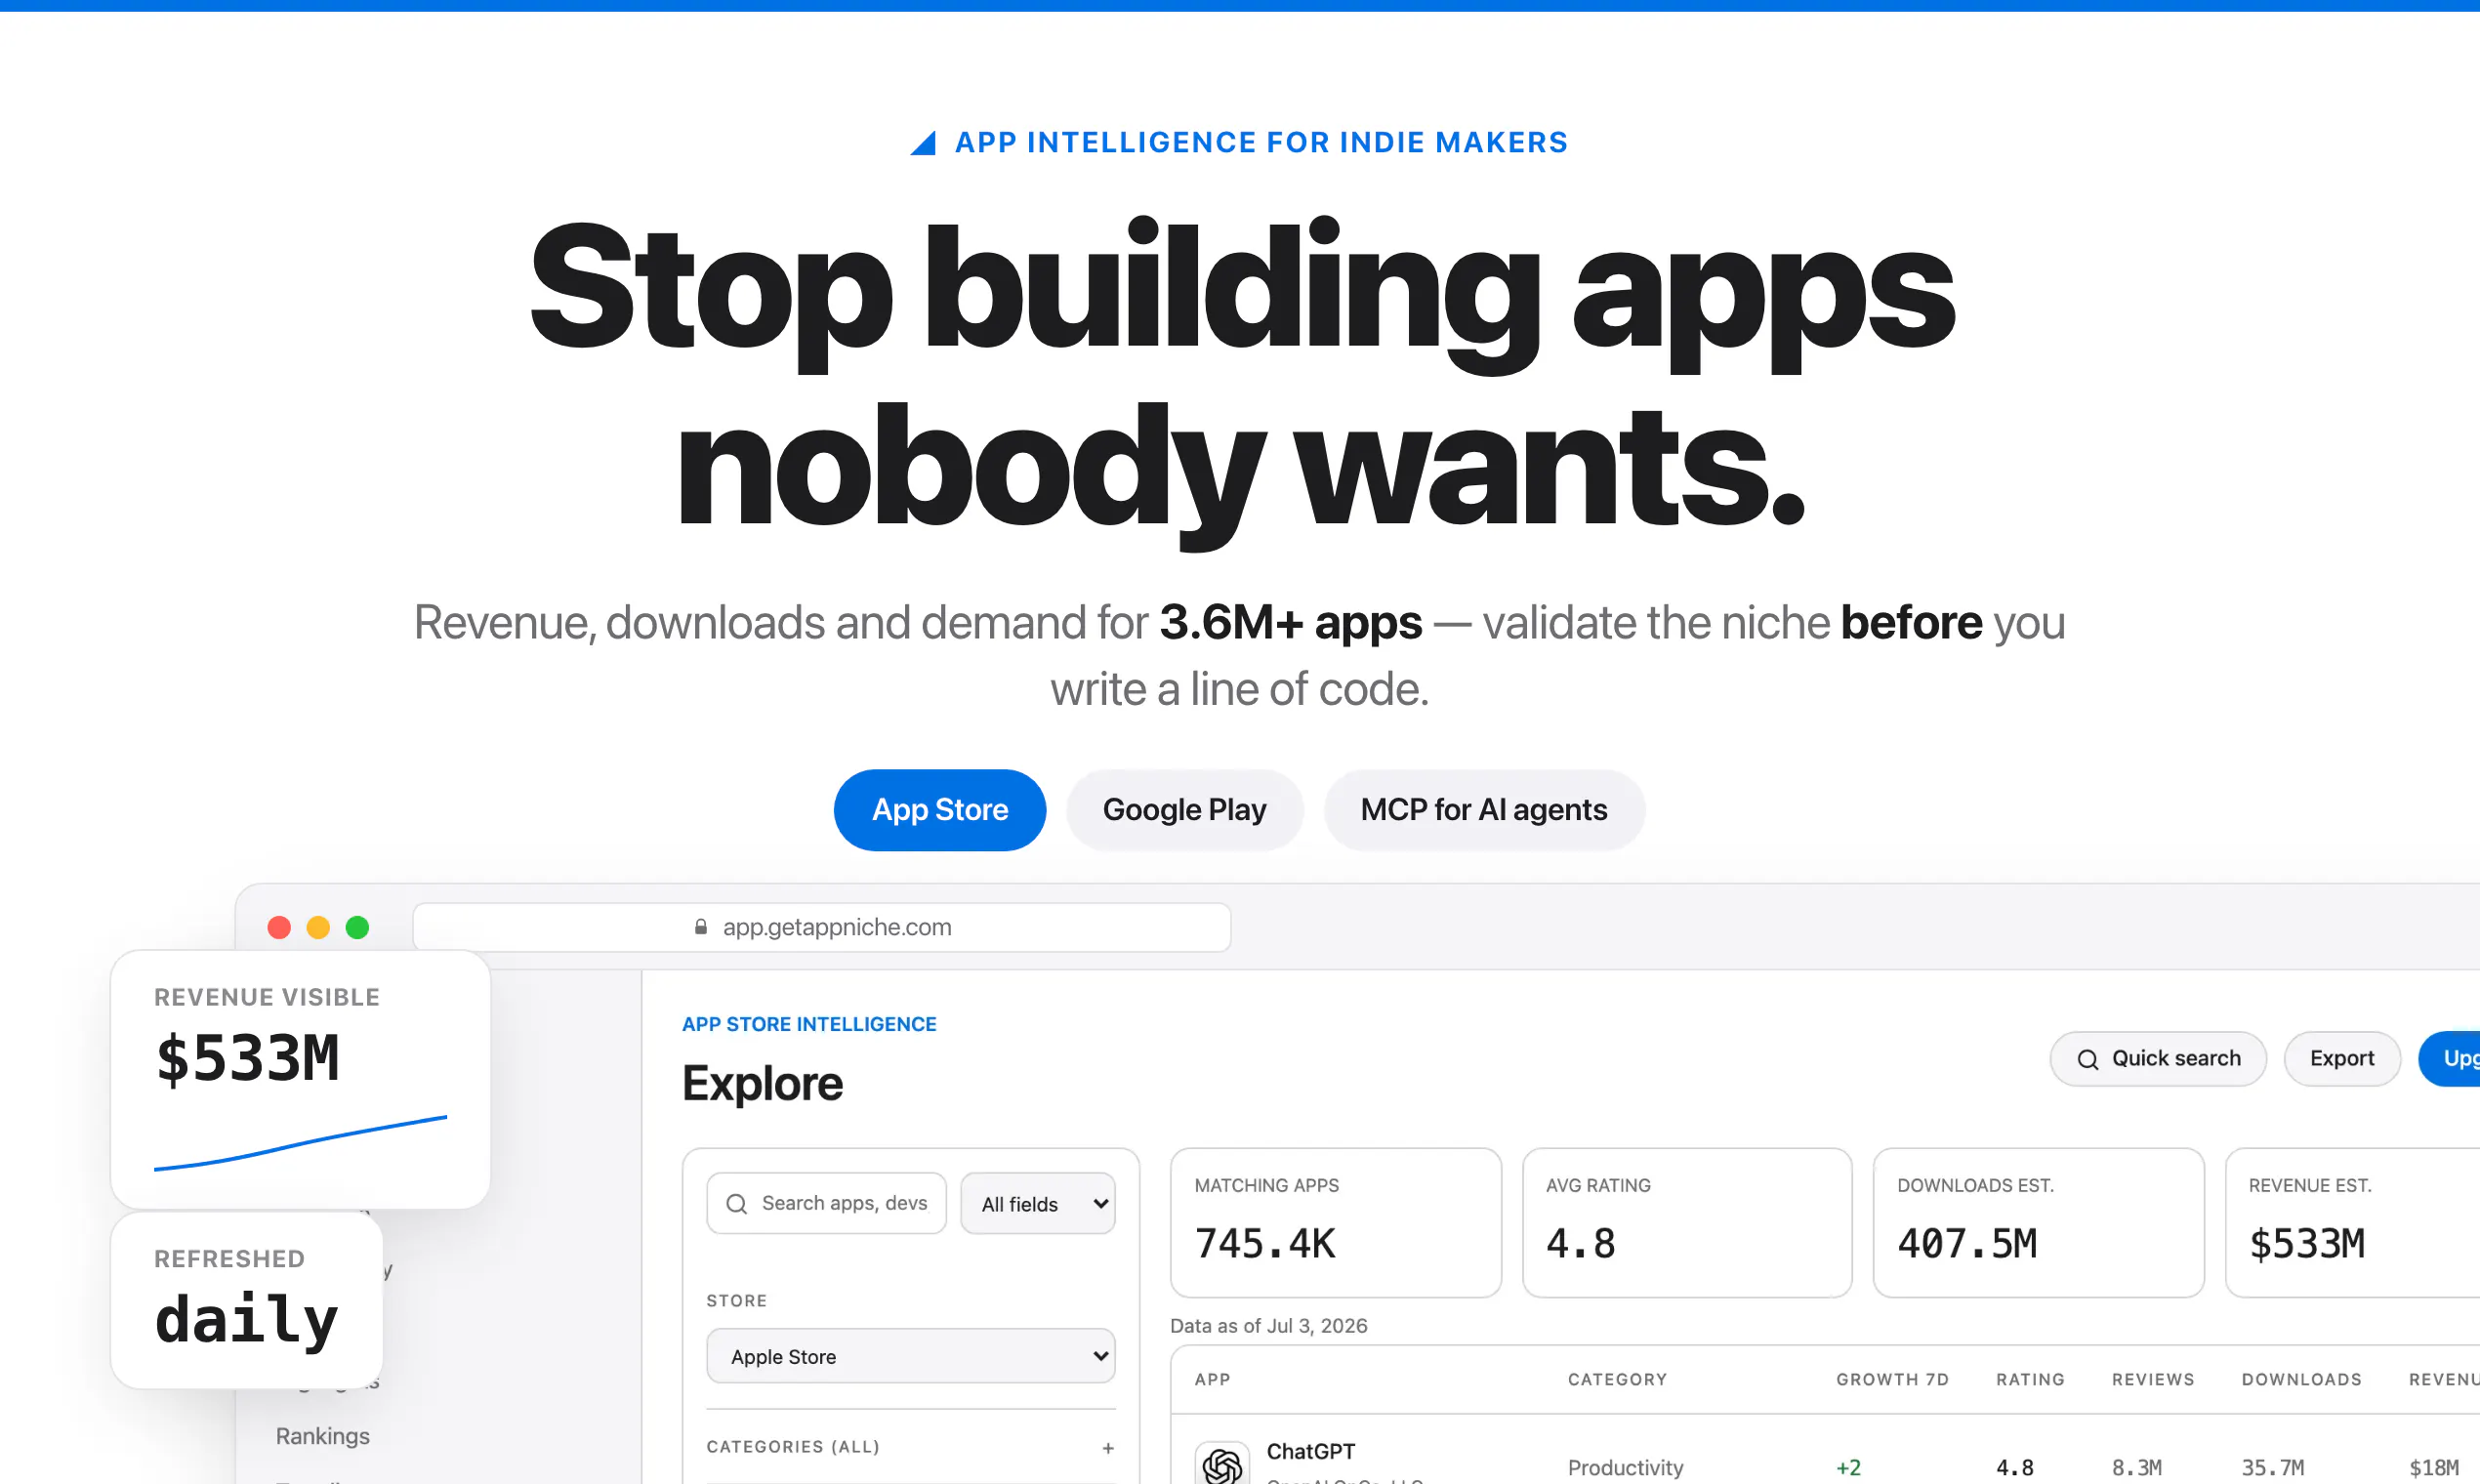
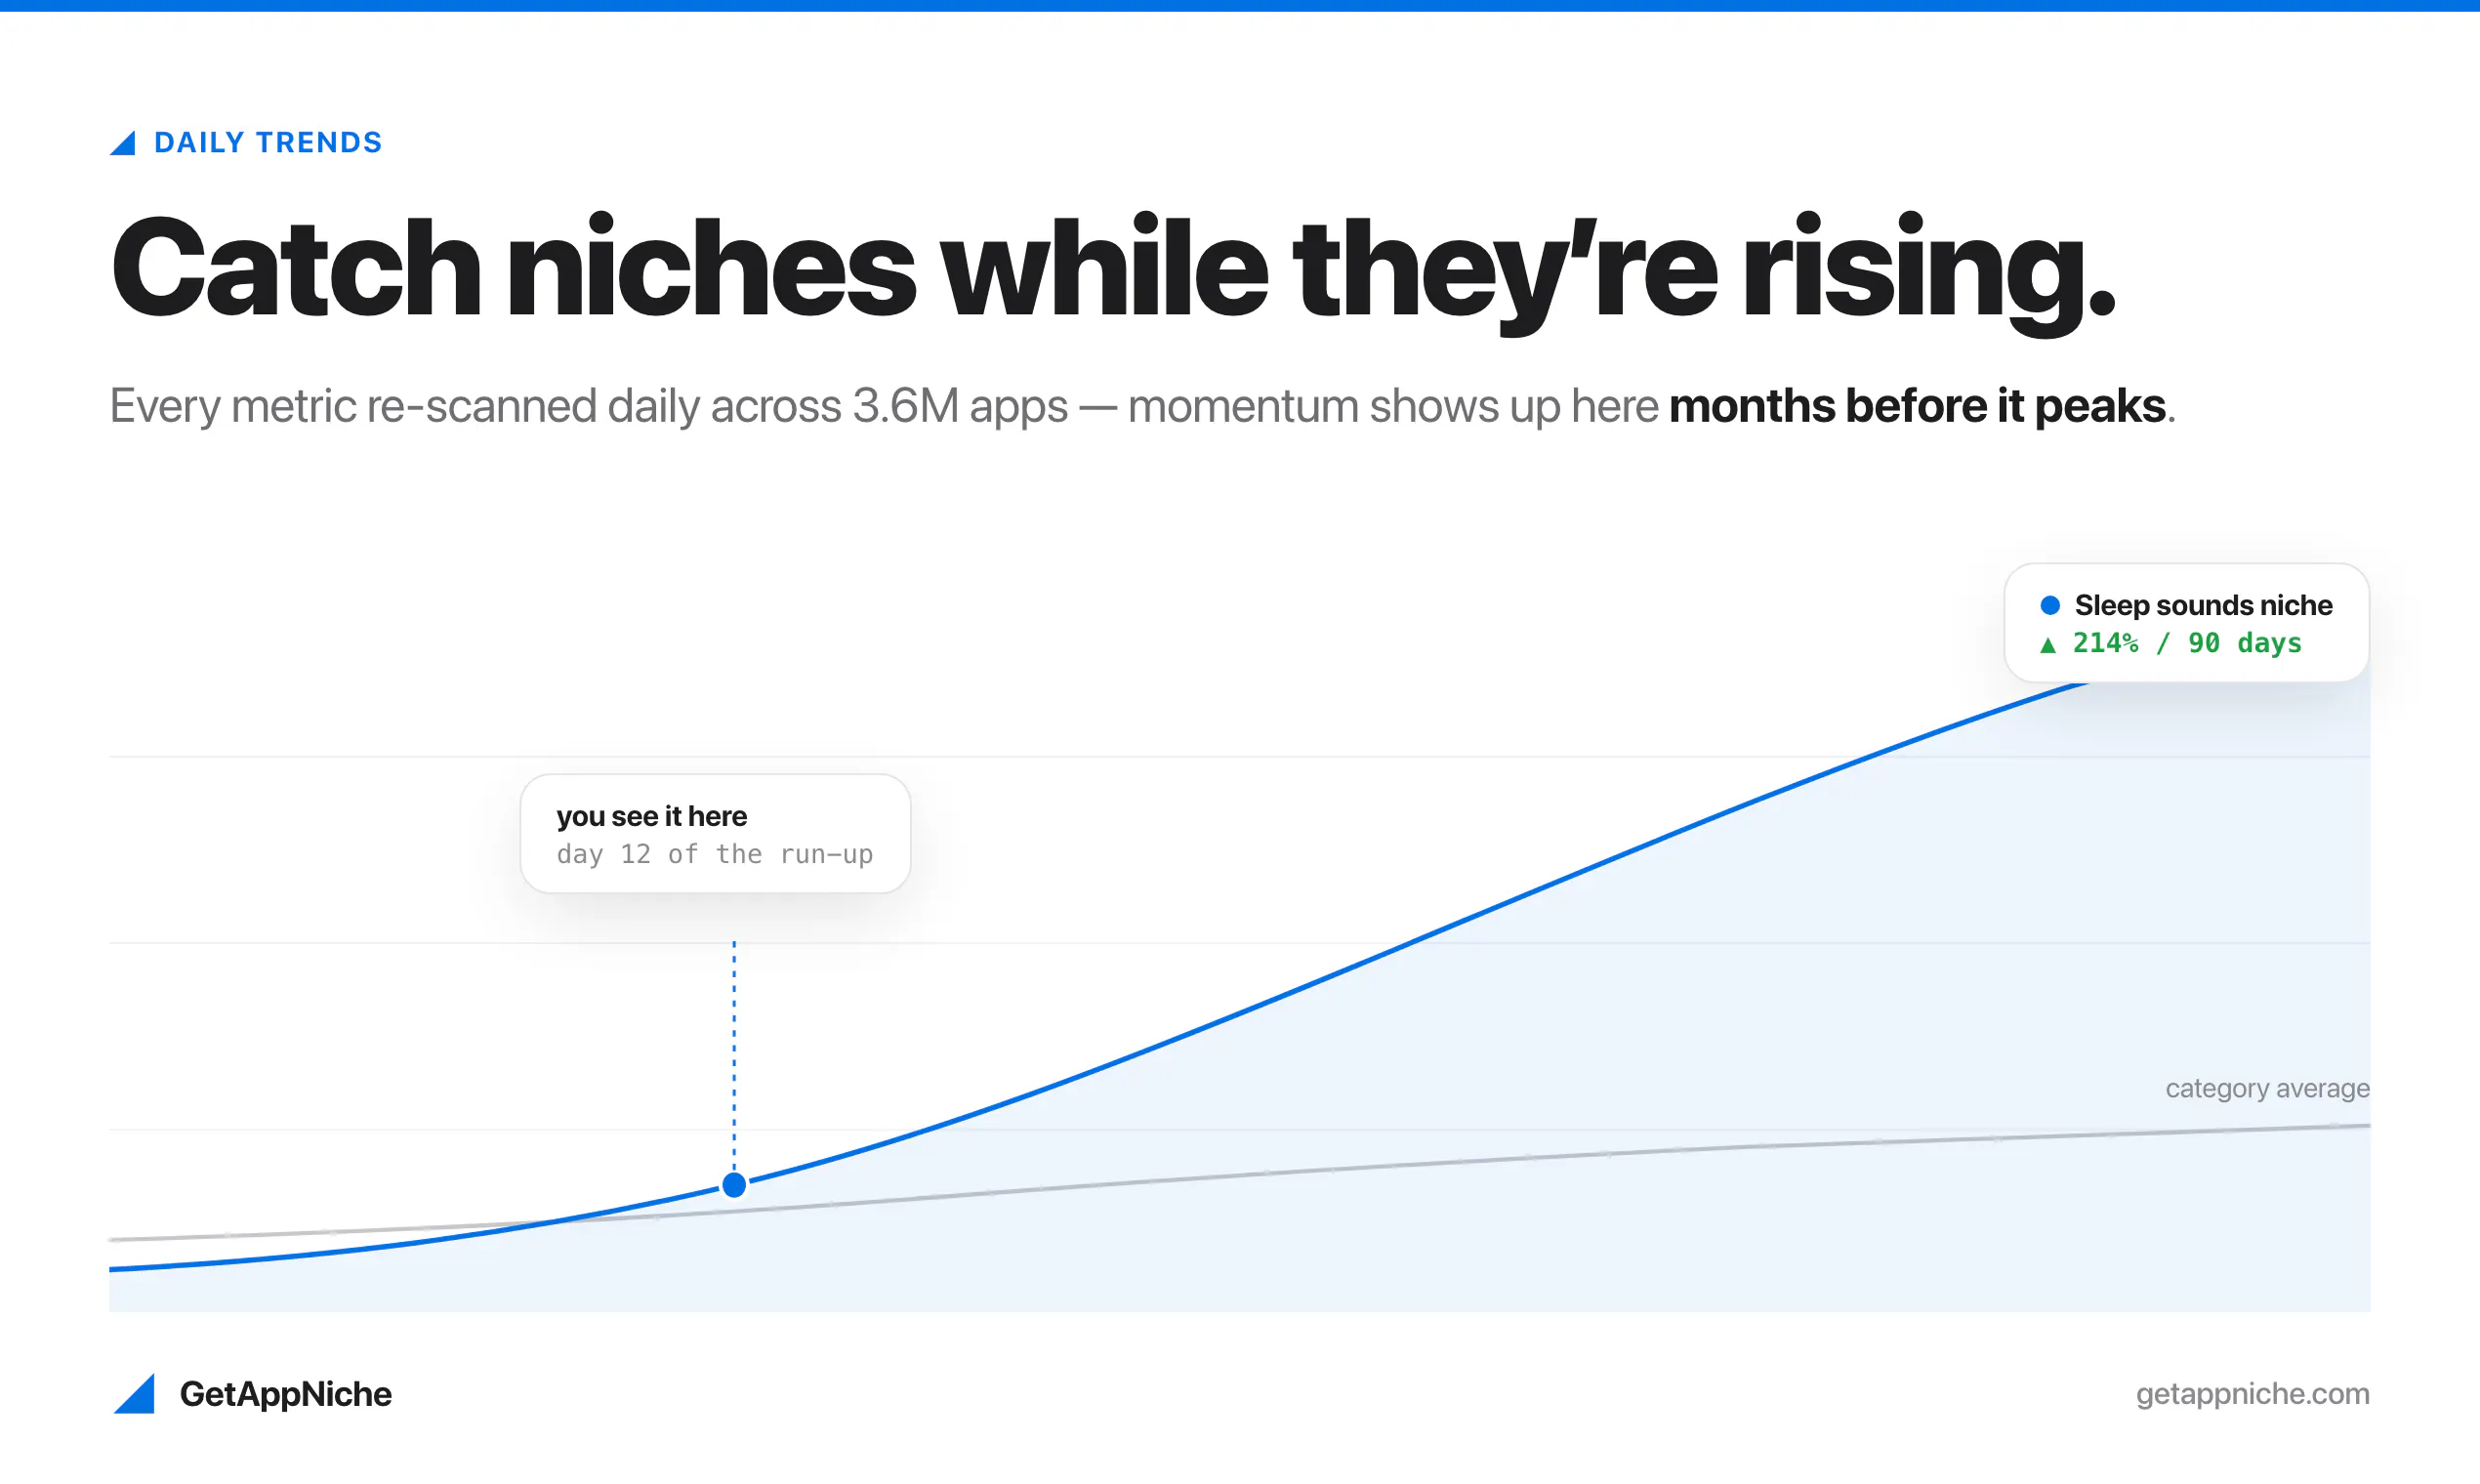
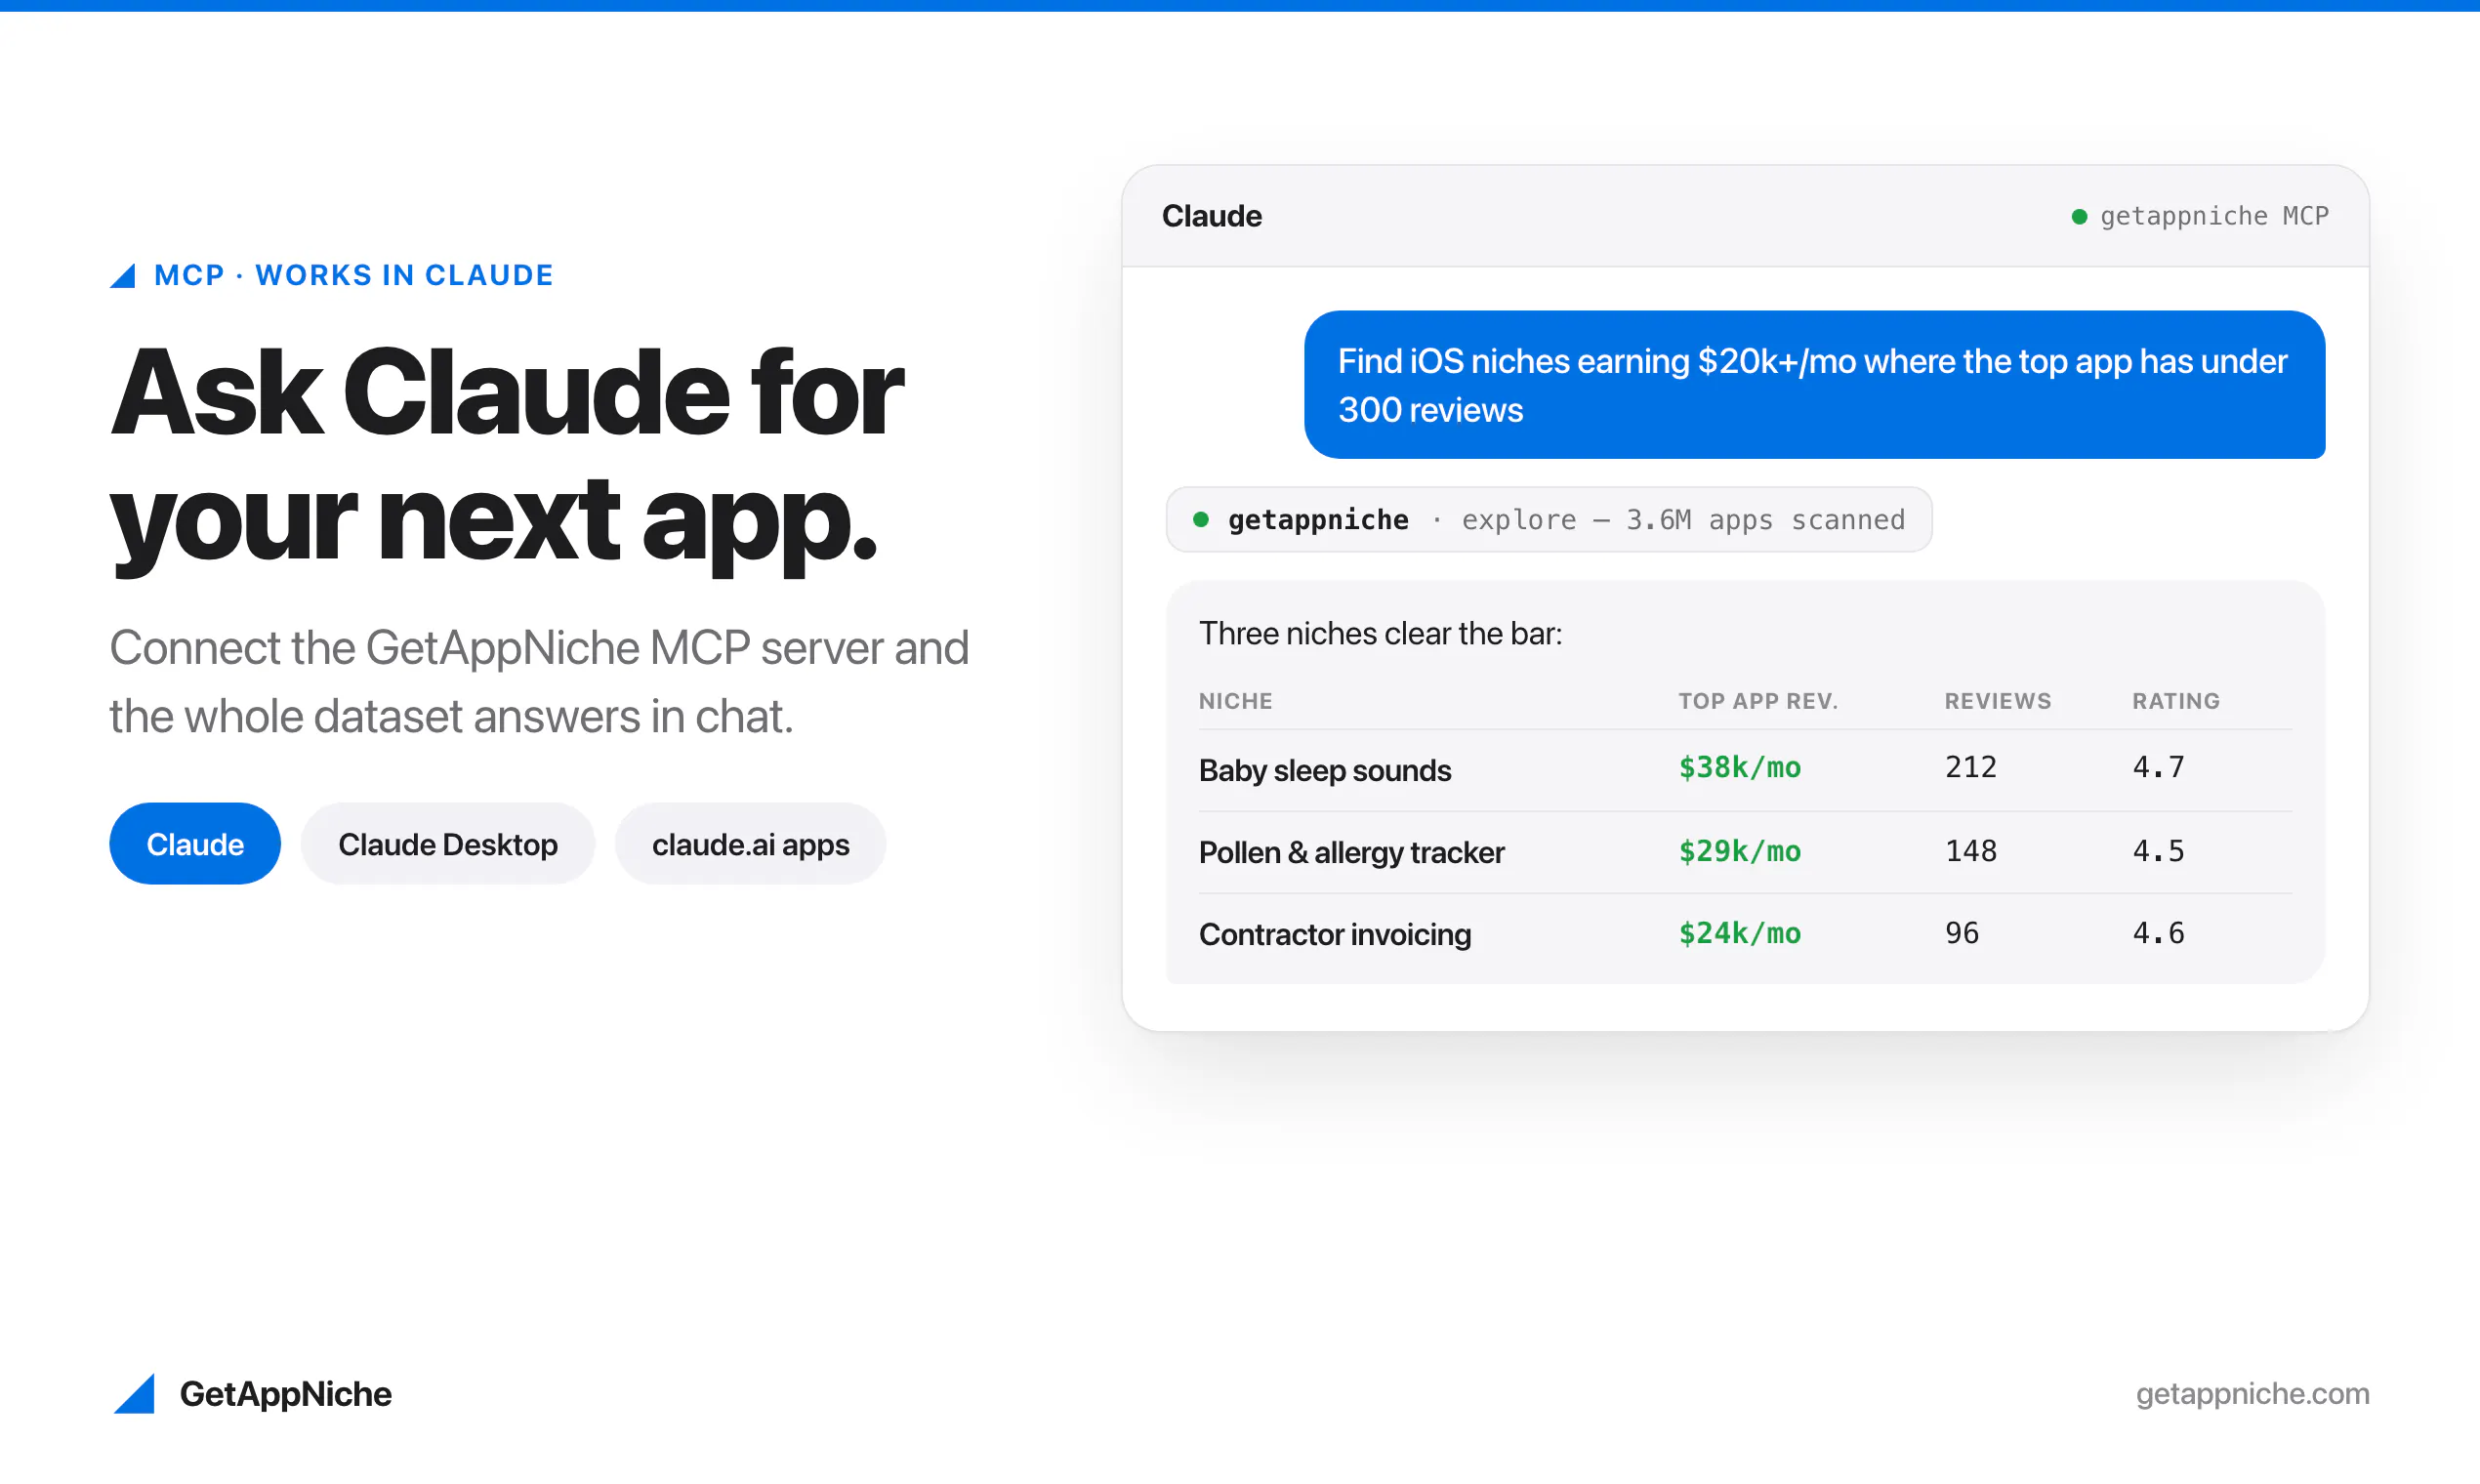
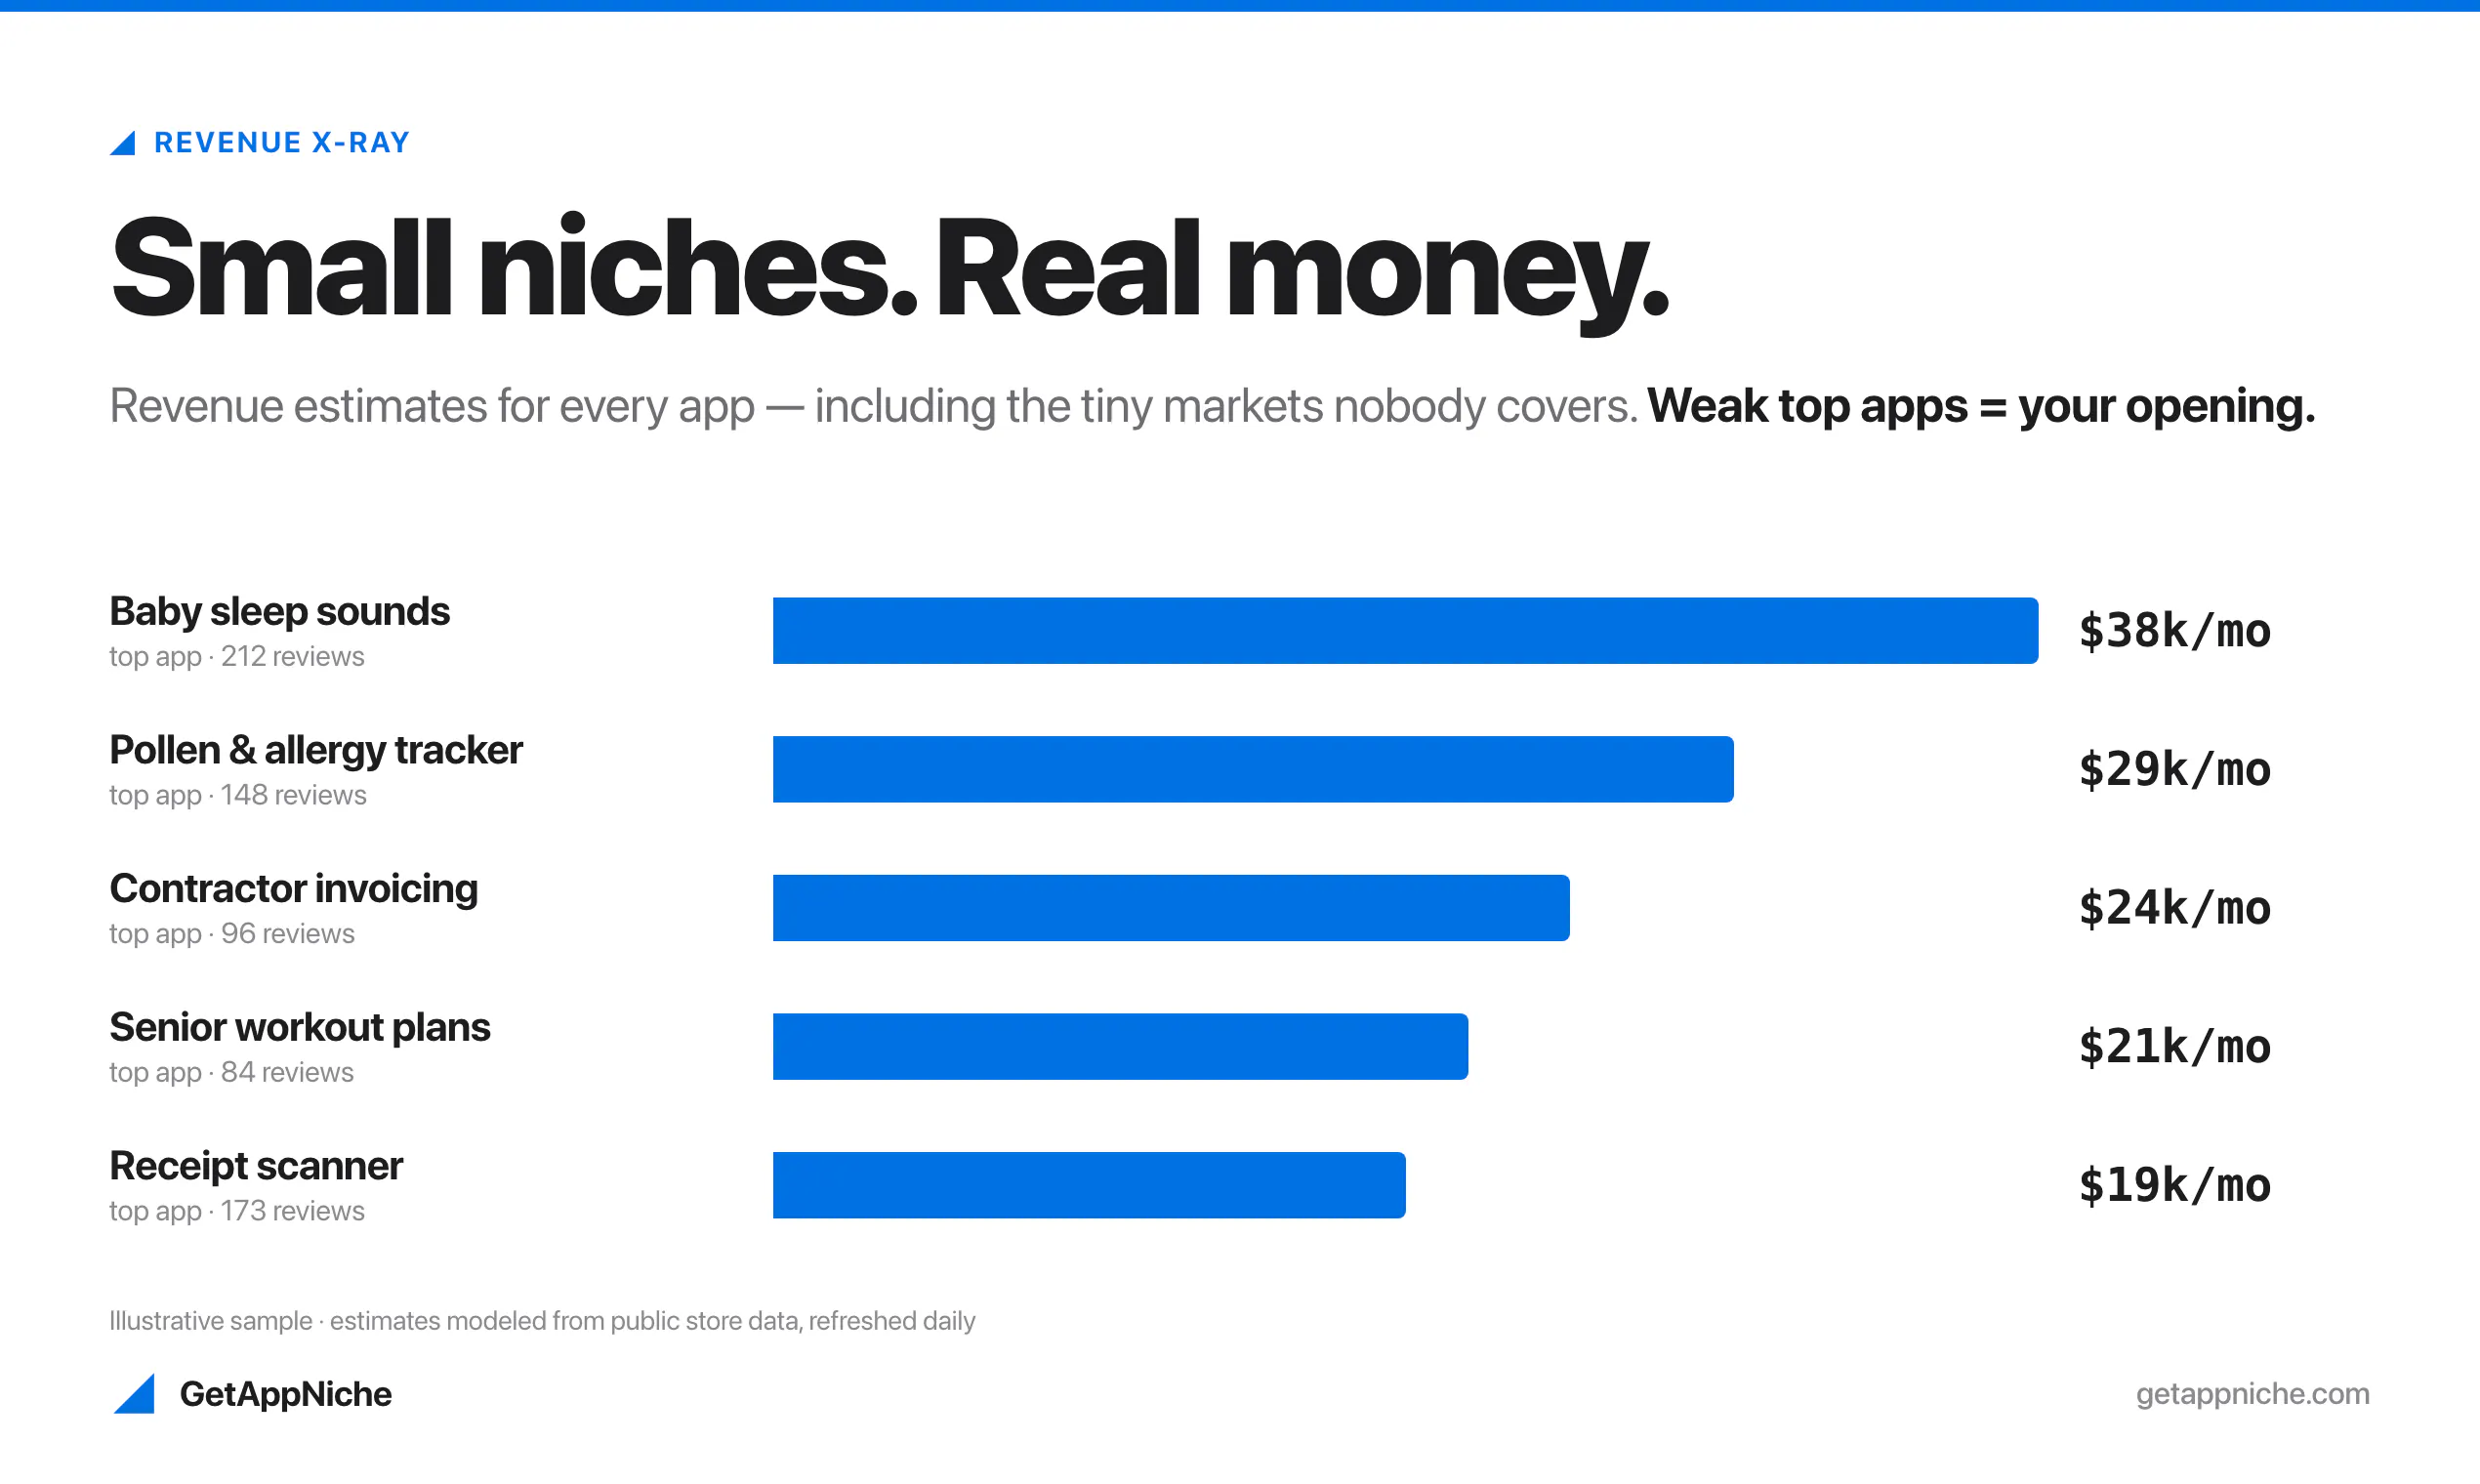
一句话介绍:GetAppNiche 是一款应用市场情报分析工具,通过提供 360 万+应用的收入与下载量估算数据,帮助独立开发者在构思阶段验证应用创意,避免盲目开发无人问津的产品。
Analytics
SaaS
Developer Tools
应用市场分析
收入估算
下载量预估
ASO关键词
竞品分析
市场验证
应用数据库
独立开发者工具
API接口
利基市场挖掘
用户评论摘要:创始人Yaro在评论中未收到用户反馈,而是自述产品动机:曾因缺乏需求数据而开发失败。他坦诚收入数据为估算值,且目前仅支持App Store关键词排名追踪,Google Play排名功能尚在开发中,并征集用户对后续功能优先级的意见。
AI 锐评
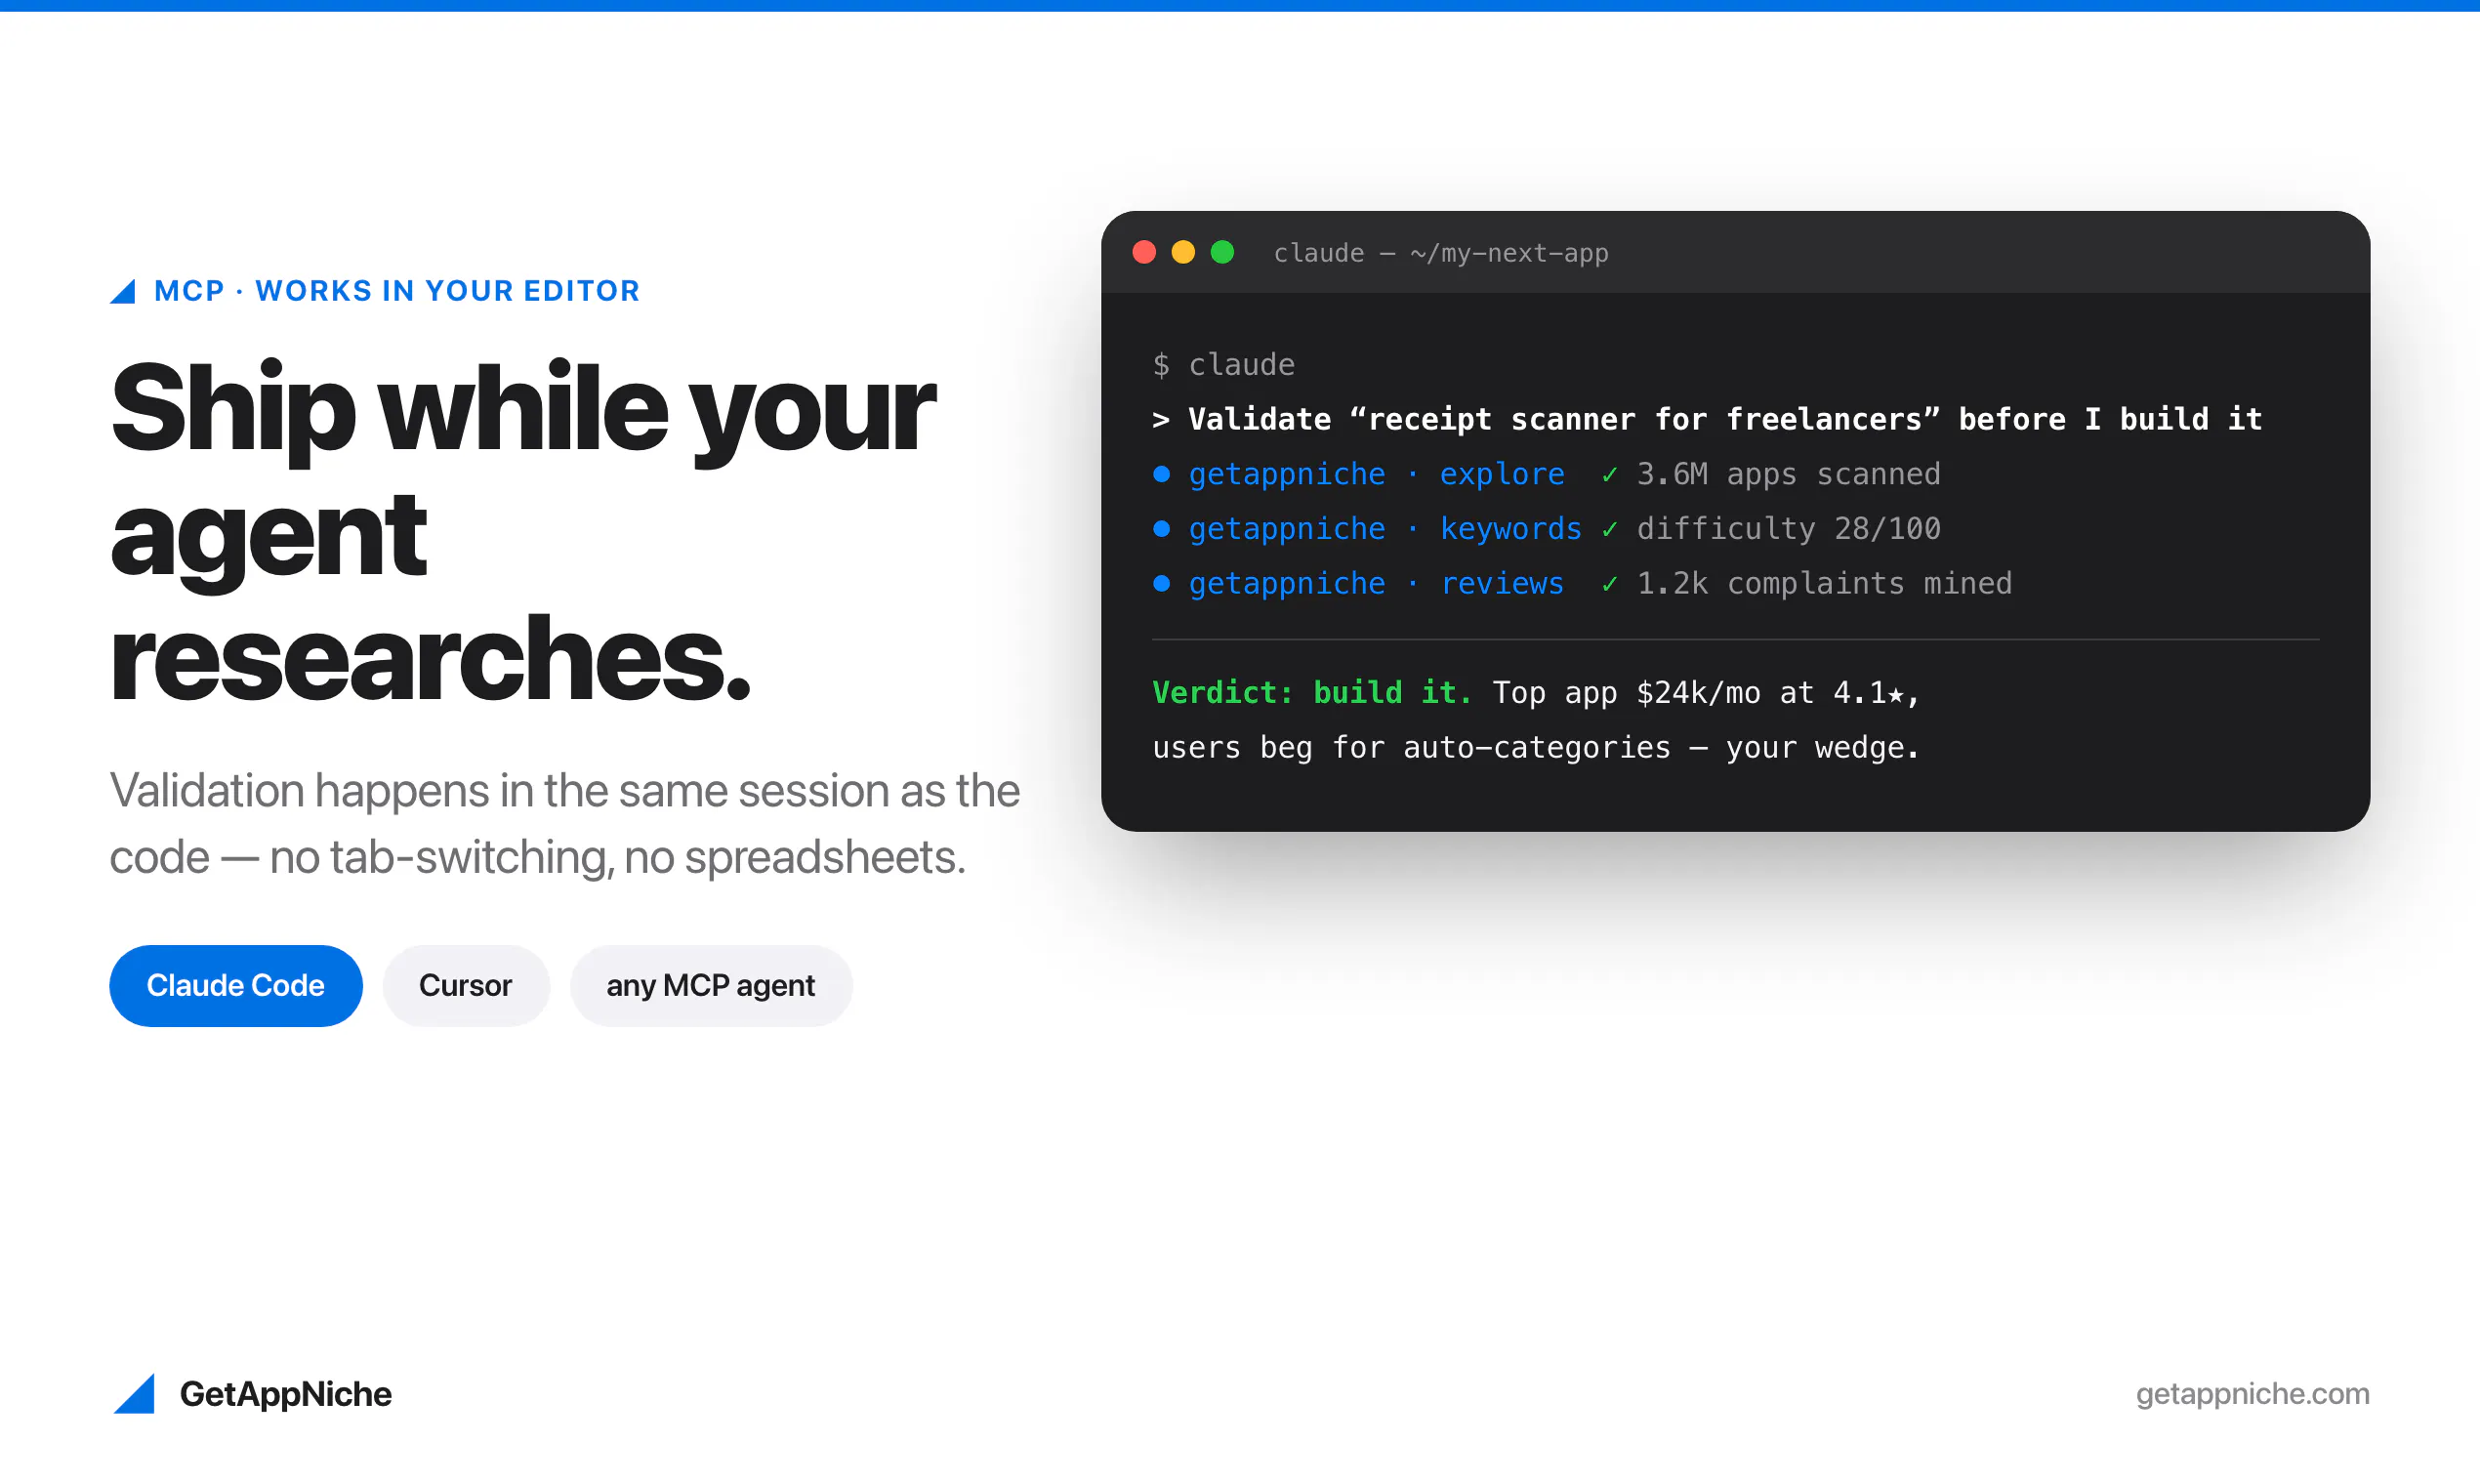
GetAppNiche切入的是独立开发者最痛的“验证前移”环节,用数据替代直觉,这比大多数空谈AI生成App的工具务实得多。其核心卖点“收入+下载估算”本质上是将Sensor Tower、App Annie等昂贵企业级服务下沉到个人开发者可负担的价位,MCP服务器的集成更是聪明地拥抱了AI编程助手生态,让Cursor或Claude能直接驱动数据查询,降低了使用门槛。
但必须冷静看待两个硬伤:其一,收入估算模型天然存在误差,尤其是对IAP内购和订阅制应用,数据只能作为方向参考而非决策依据;其二,评论中创始人承认Google Play排名追踪缺失,这意味着在Android主导的全球市场(尤其新兴市场)数据维度严重残缺,削弱了“双商店数据库”的宣称。此外,3.6M应用听来庞大,但实际有效样本需打问号——大量长尾应用数据稀疏,估算可信度存疑。
真正价值在于它把“发现利基市场”从玄学变成了可操作的查询语句。如果后续能将用户评论情感分析(差评聚类)和广告素材情报做深,与APIRank、Data.ai形成差异化,有机会成为独立开发者数据工具链的标配。但目前版本更像一个“够用但不够深”的MVP,距离“让所有开发者不再盲目”的口号还有一段路。价格方面,50%折扣说明团队清楚首批用户是价格敏感的独立开发者,后续能否留存取决于数据准确率和更新频率能否持续赢得信任。
the maker of @Ultracite keeps cooking.
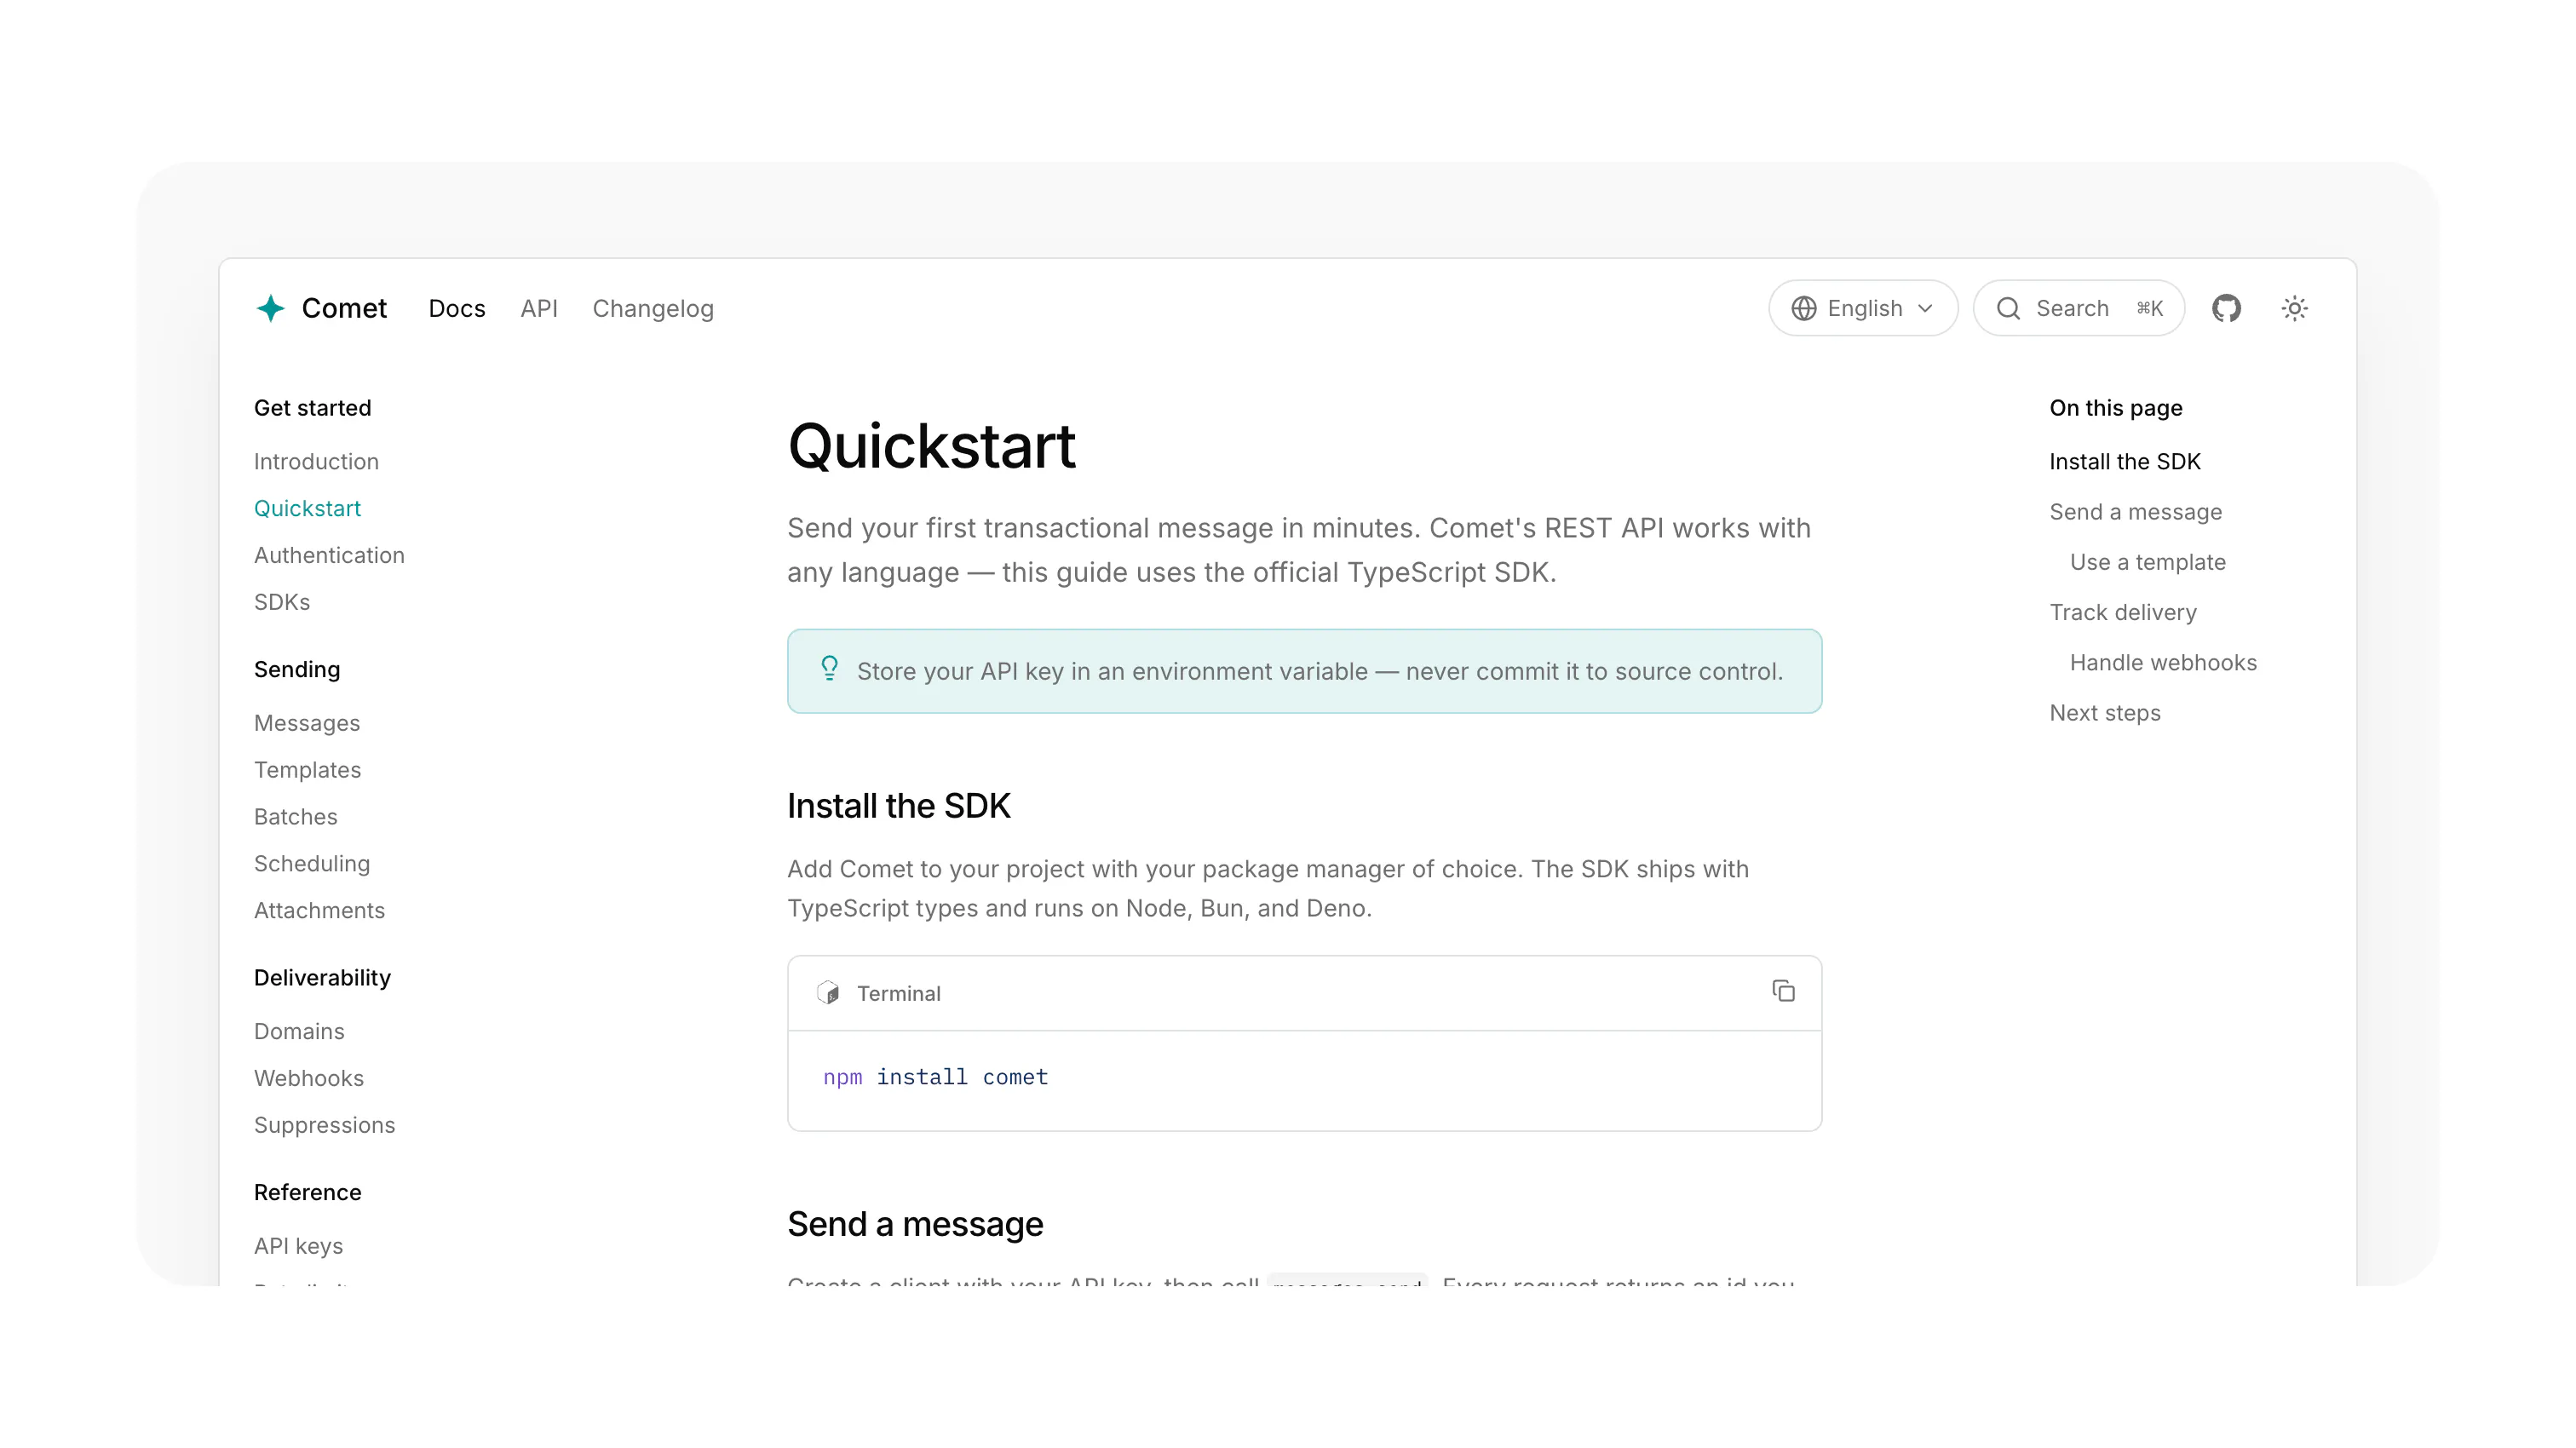
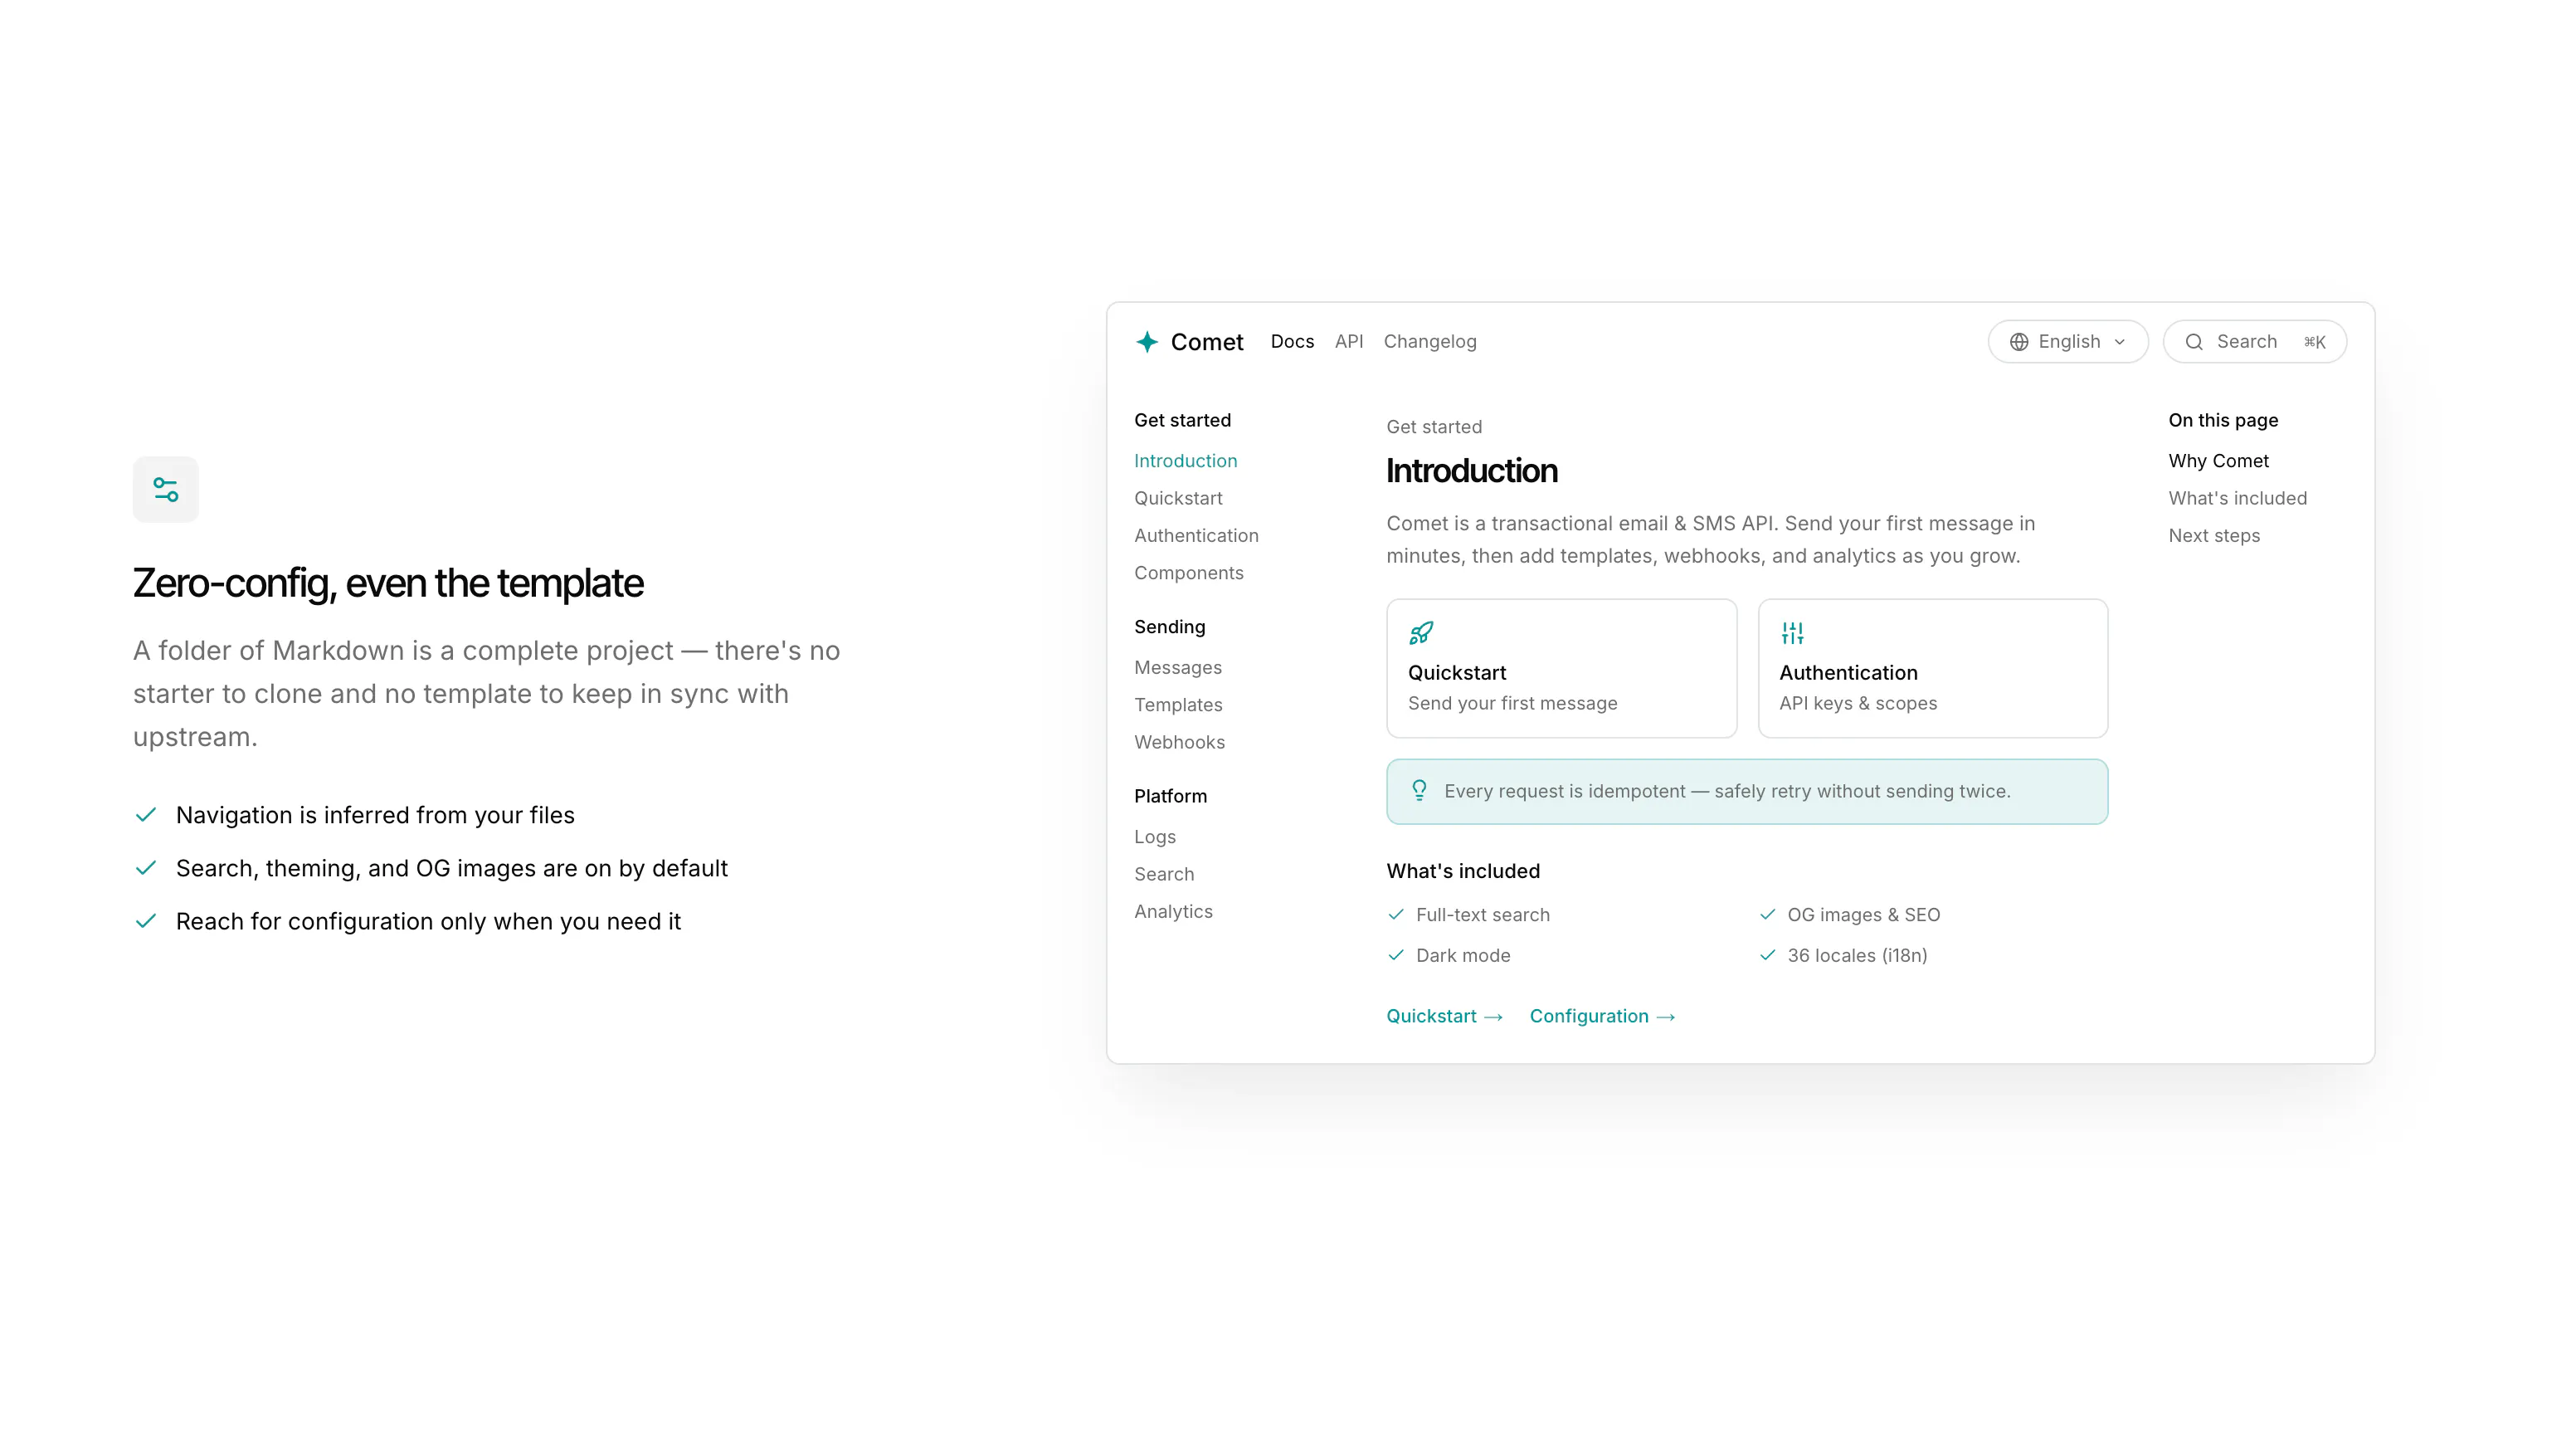
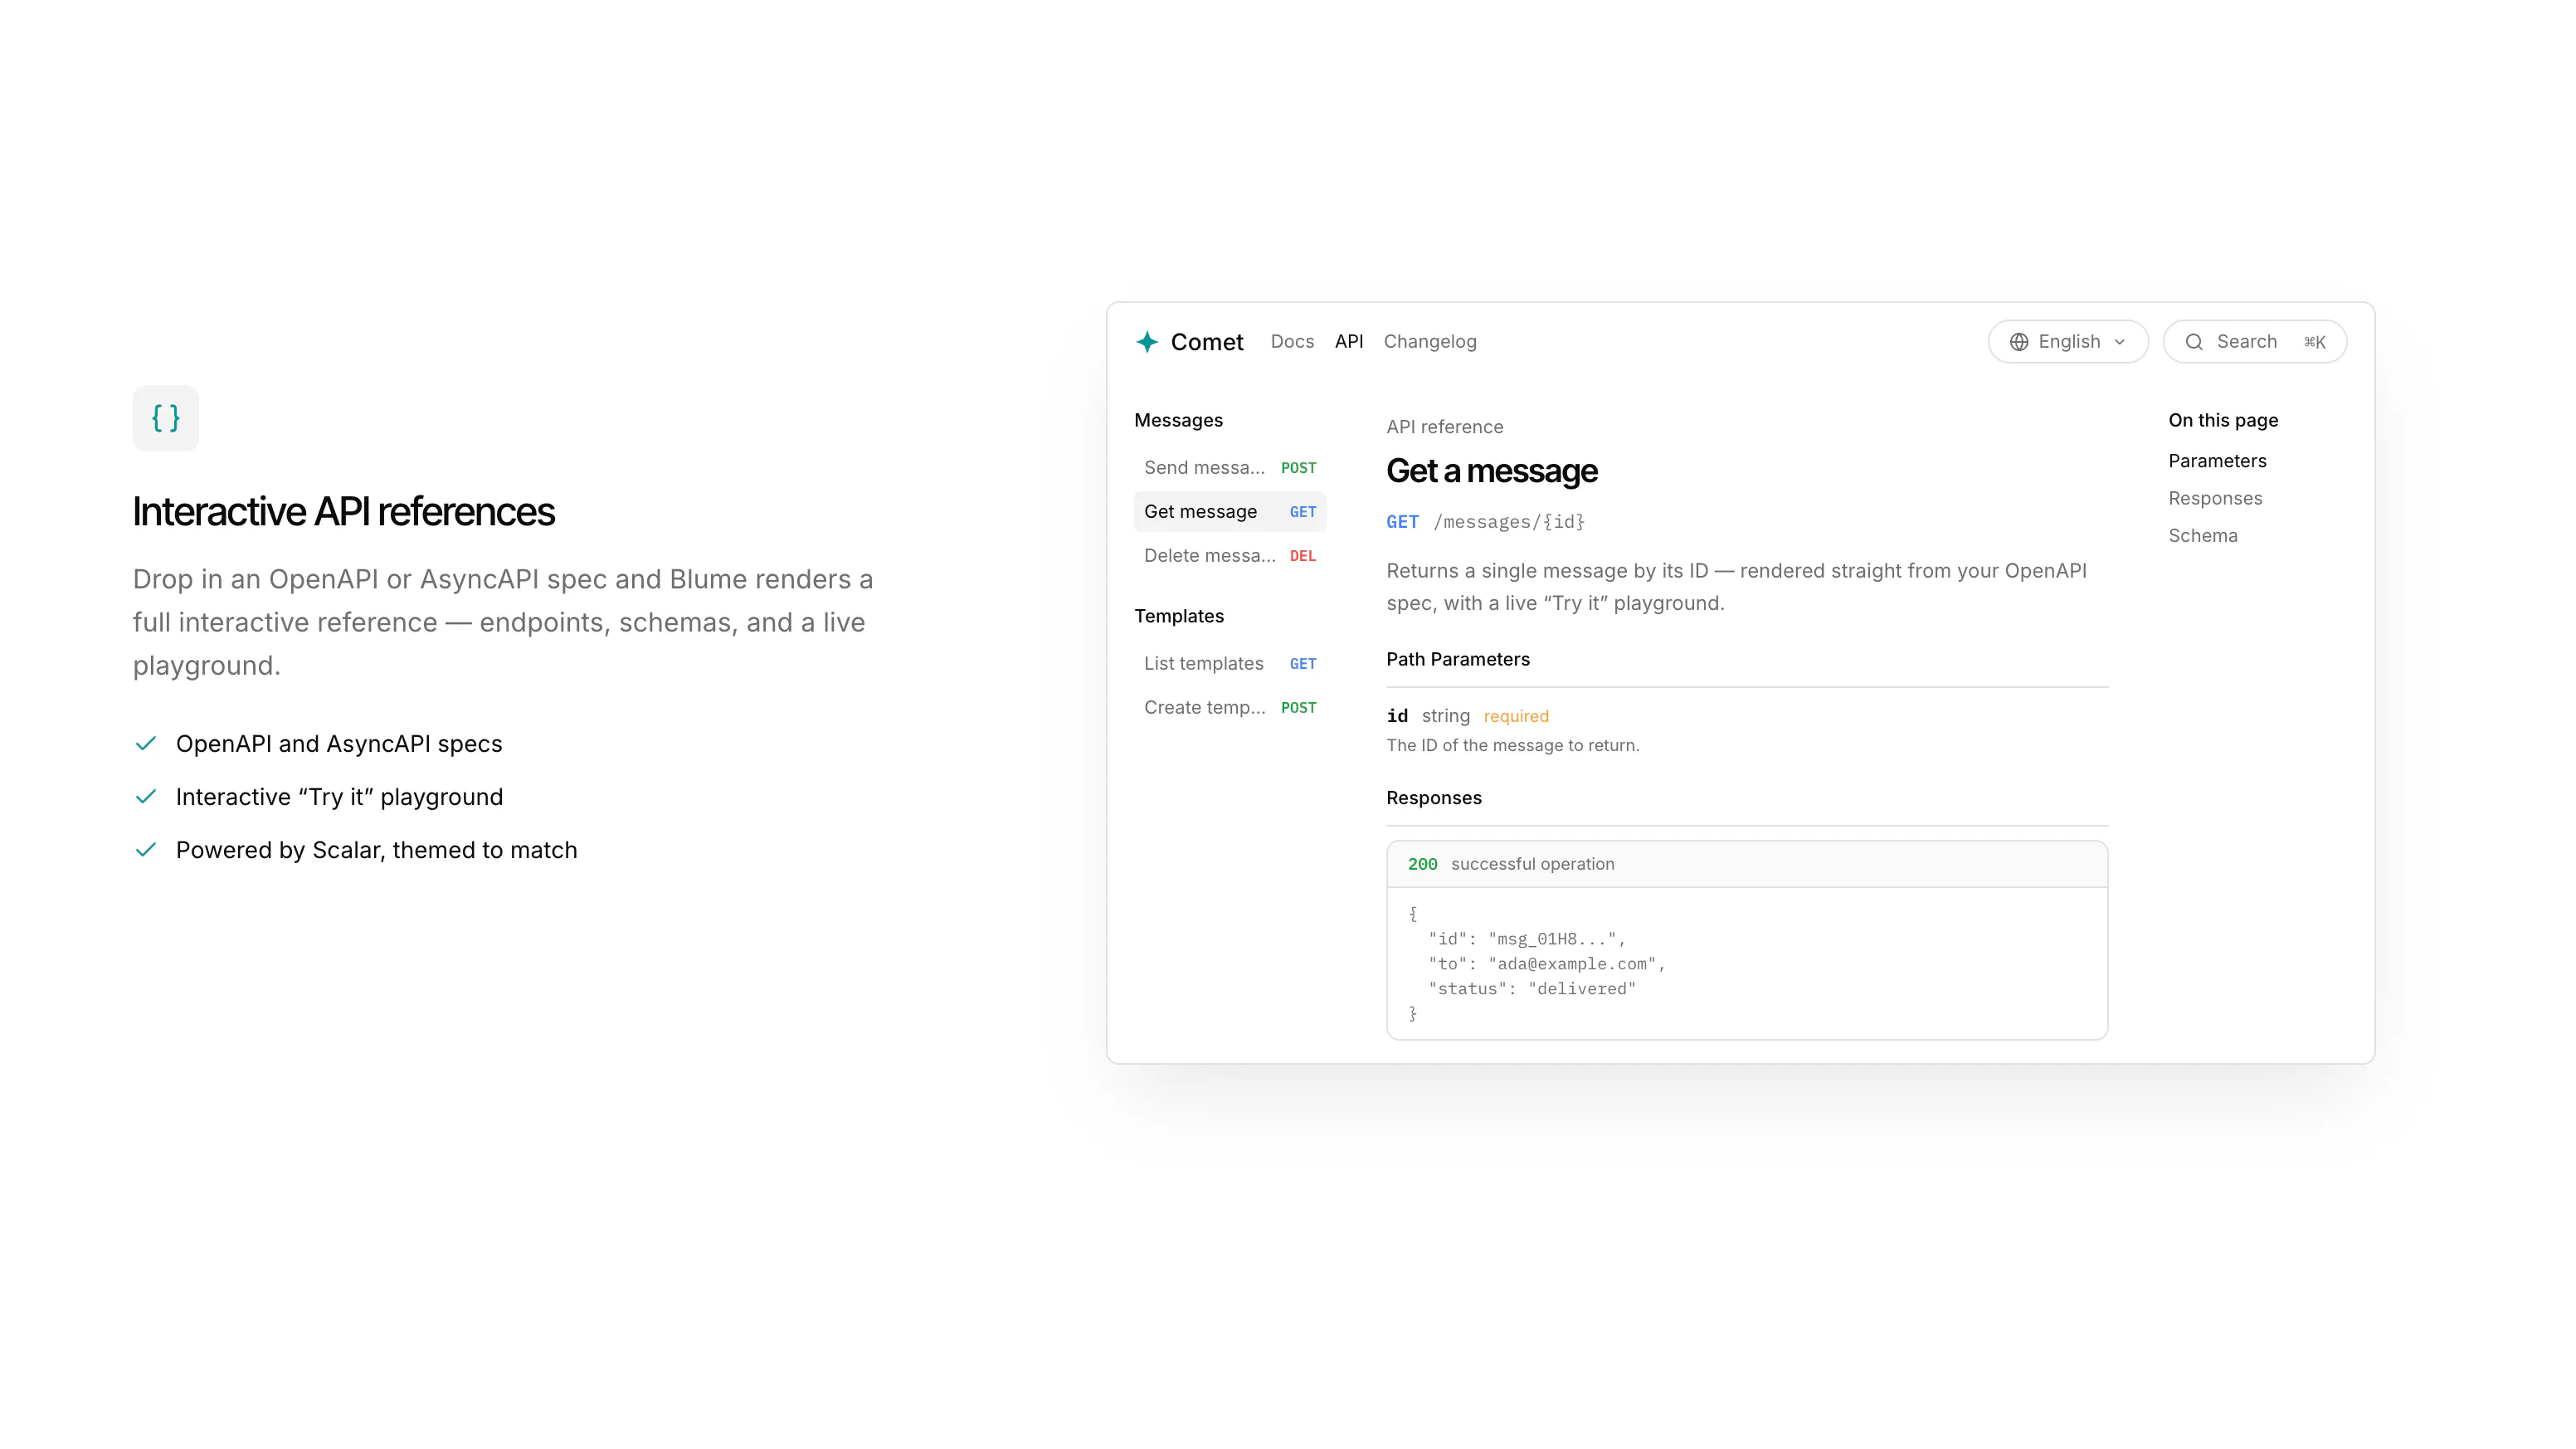
@haydenbleasel just introduced @Blume, an open-source alternative to @Mintlify and @Fumadocs that is fast, AI-ready, and zero-config.
view source code here
curious what "AI-ready" means concretely here - is it generating something like an llms.txt under the hood, or is it more about the markdown being cleanly chunked/structured for retrieval. the docs tools I've seen that use this label usually just mean well-formed markdown, but the actual pain point for me has always been staleness - docs drifting from the real API surface over time. does blume do anything to flag that drift, or is it purely a generation/theming layer on top of whatever markdown you feed it
Congrats on the Launch!
I have built a quick demo for you
https://app.livedemo.ai/livedemos/6a81d97a73073a505dd64fa5